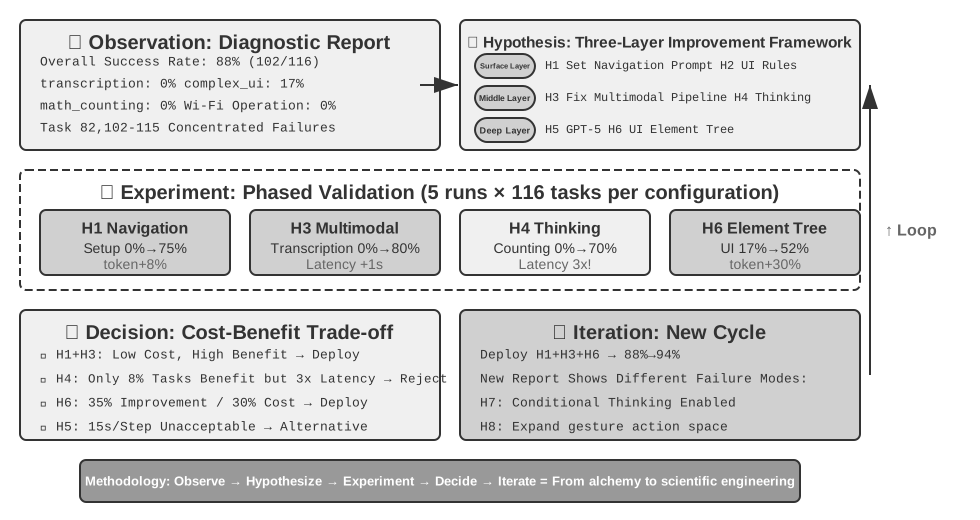
İlk altı bölüm tek bir Agent’ın nasıl inşa edileceğini açtı: context, bilgi, araçlar, coding yeteneği ile gözlem ve eylem uzayları. Ancak inşanın tamamlanmış olması doğru yapıldığı anlamına gelmez; sonraki model eğitimi ve sistem evrimi ancak sonuçlar istikrarlı biçimde ölçülebildiğinde güvenilir bir yön kazanır.
Bir Agent sistemi kurarken geliştiriciler, çoğu zaman apaçık bir doğru yanıtı olmayan çok sayıda tasarım seçimiyle karşılaşır:
Hangi model kullanılmalı?
Modelin hangi araçları çağırabilmesi gerekir?
Bilgi tabanı hangi veriyi saklamalı, hangi yapıyla kurulmalı?
Kullanıcı belleği nasıl yapılmalı?
Modelin prompt’ları ve Skills’i nasıl organize edilmeli?
Harness’e hangi kısıtlar eklenmeli?
Değerlendirme sonuçları, Agent’ın sürekli evrimi için nasıl öğrenme sinyaline dönüştürülür?
Değerlendirme, bu kararlara bilimsel bir dayanak sağlar: sistematik karşılaştırmalı deneylerle (tek bir değişkeni değiştirip etkideki değişimi gözlemlemek) ve ablation deneyleriyle (bileşenleri teker teker kapatıp genel performansın nasıl değiştiğini gözlemleyerek o bileşenin gerçek katkısını ölçmek), gerçek yetenek artışlarını yüzeysel dalgalanmalardan ayırabilir, küçük bir kazanç uğruna büyüğünü kaçırmaktan kurtulabilirsiniz. Yazılım mühendisliğindeki “ölçmediğinizi iyileştiremezsiniz” sözünde olduğu gibi, tekrarlanabilir bir değerlendirme sistemi kurulmadıkça Agent’ın yineleme yönü yalnızca sezgiye kalır.
Bölüm 1’de tanıtılan Harness engineering perspektifinden bakıldığında, değerlendirme Harness içinde “doğrulama” işlevinin merkezi rolünü üstlenir. Kilit kavrayış şudur: değerlendirmenin nesnesi yalnızca model değil, modelle Harness’in bileşimi olmalıdır. Aynı model farklı Harness’lerde çarpıcı biçimde farklı sonuçlar verebilir — bazı ekipler yalnızca Harness’i iyileştirerek aynı modelin terminal türü görevlerdeki performansını belirgin biçimde yükseltti (ayrıntılar için bkz. Bölüm 5). Bu şu anlama gelir: Agent değerlendirmede kötü performans gösterdiğinde iyileştirme yönü modeli değiştirmek değil, Harness’in bir bileşenini (prompt’lar, araç tasarımı, geri bildirim döngüleri) iyileştirmek olabilir. Sağlam bir değerlendirme sistemi, “model yeteneğinin yetersizliği” ile “Harness tasarım kusuru” gibi özünde farklı iki sorunu birbirinden ayırabilmelidir. Bu iki sorunu ayırmanın yaygın yolu model değiştirme deneyidir (model swap): Harness sabit tutulur, yalnızca daha güçlü ya da daha zayıf bir model takılır ve puanın ne kadar oynadığına bakılır. Daha güçlü modelle puan yükselmiyorsa darboğaz Harness’tedir. Daha zayıf modelle puan sert biçimde düşüyor ve sonuçlar model yeteneğiyle birlikte büyük dalgalanmalar gösteriyorsa, en doğrudan okuma darboğazın modelin kendi yeteneğinde olduğu ve mevcut performansı esas olarak modelin belirlediğidir (bunun görevin doğası gereği zor olmasından mı, yoksa Harness’in modelin ön bilgisine aşırı yaslanmasından mı kaynaklandığı ayrıca incelenmelidir). Bunun, yukarıda anılan “ablation deneyi”nden farklı bir yöntem olduğuna dikkat edin: ablation Harness’in bir bileşenini kapatıp genel performansın nasıl değiştiğine bakar, model değiştirme ise Harness’i sabit tutup yalnızca modeli değiştirir — ilki Harness’in içinde hangi parçanın önemli olduğunu bulur, ikincisi darboğazın modelde mi Harness’te mi olduğunu ayırt eder.
Bir değerlendirme sisteminin değeri, modellerin hızla evrildiği bir çağda daha da belirginleşir. Model yetenekleri hızla ilerlemeye devam ediyor, ama yeni bir modelin kamuya açık benchmark’larda daha iyi sonuç vermesi, sizin özel göreviniz üzerinde de daha iyi olacağı anlamına gelmez — tam tersine performans gerilemesi (regression, yani yeni sürümün bazı yönlerden eskisinin gerisinde kalması) ortaya çıkabilir. Yalnızca kendi değerlendirme veri kümenizde yapılan eksiksiz bir test, veriye dayalı bir yükseltme kararı vermenizi sağlar. Dahası, sağlam bir değerlendirme sistemi “gelecekteki modeller için ürün geliştirmeyi” uygulanabilir bir stratejiye dönüştürür: mevcut model ticari kullanımı taşıyacak güçte olmasa bile, ürün geliştirmesini şimdiden tamamlayıp değerlendirme kümesini kurabilir, yeni modellerin performansını sürekli izleyebilir ve eşiği aşan ilk modelle hemen yayına çıkabilirsiniz.
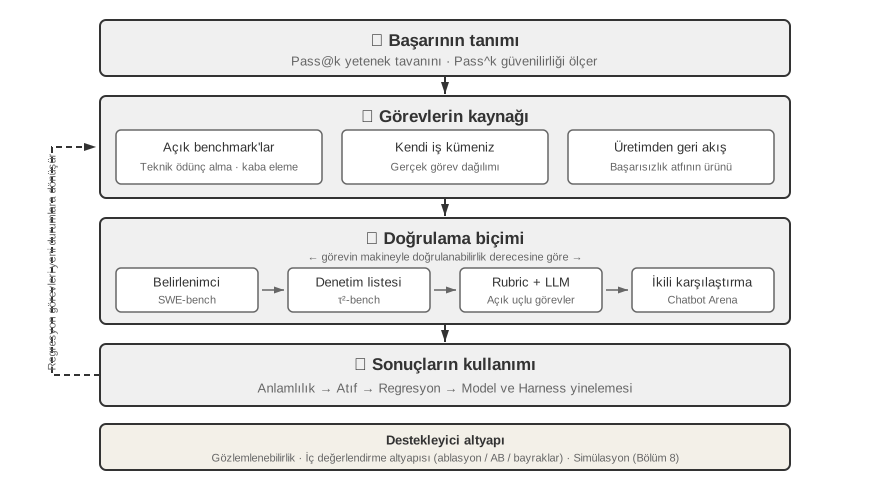
Bir değerlendirme sistemi dört halkaya ayrılabilir: neyin başarı sayıldığı, görevlerin nereden geldiği, kimin doğruladığı ve puanın nasıl karara dönüştüğü. Şekil 7-1’de gösterilmiştir.
Şekil 7-1: Agent Değerlendirme Sisteminin Dört Halkası · Kaynak şekil
Bir değerlendirme görevinin anatomisi: τ²-bench’in telecom alanı
Önce τ²-bench’in telecom alanından gerçek bir görevi baştan sona inceleyelim. τ²-bench, Sierra’nın açık kaynaklı projesidir; chapter7/tau2-bench-eval/README.md dosyasındaki komutla yerel makinenize klonlayın, ardından data/tau2/domains/telecom/tasks_small.json görev dosyasını açın.
Görev tanımının dört bileşeni
Aşağıda o dosyadaki görevlerden biri, okumayı kolaylaştırmak için kısaltılarak verilmiştir.
{ "id": "[mobile_data_issue]airplane_mode_on|user_abroad_roaming_enabled_off", // Agent'a verilen çağrı kaydı "ticket": "Kullanıcının telefonu internete bağlanamıyor ve durum çubuğunda 'No Service' yazıyor. Müşteri John Smith, numara 555-123-2002, şu anda Fransa'da. Sorun ancak hız testi excellent verirse çözülmüş sayılır. Tarife değiştirmek istemiyor, ama gerekirse 2,0 GB veri yüklemeyi kabul ediyor.", // Kullanıcı simülatörüne verilen davranış kuralları "user_scenario": { "instructions": { "known_info": "You are John Smith with phone number 555-123-2002. You are currently abroad in France.", "unknown_info": null, "task_instructions": "…express mild frustration after the first unsuccessful attempt. You will consider the issue resolved only when speed test returns excellent internet speed and nothing else. If it returns poor, fair or good, you will not consider the issue resolved. Whenever the agent asks you about your device, always ground your responses on the results of tool calls. … Never make up the results of tool calls." }}, // Çalıştırmadan önce her iki taraf aynı başlangıç noktasına sıfırlanır "initial_state": { "initialization_actions": [ { "env_type": "user", "func_name": "turn_airplane_mode_on" }, { "env_type": "user", "func_name": "turn_roaming_off" }, { "env_type": "assistant", "func_name": "enable_roaming", "arguments": { "customer_id": "C1001", "line_id": "L1002" } } ]}, // Puanlama ölçütleri "evaluation_criteria": { "actions": [ { "requestor": "user", "name": "toggle_airplane_mode" }, { "requestor": "user", "name": "toggle_roaming" } ], "env_assertions": [ { "func_name": "assert_mobile_data_status", "expected_status": true }, { "func_name": "assert_internet_speed", "expected_speed": 200, "expected_desc": "excellent" } ], "communicate_info": null, "nl_assertions": null, "reward_basis": ["ENV_ASSERTION"] }}
Bu tanımda açılması gereken dört tasarım kararı var.
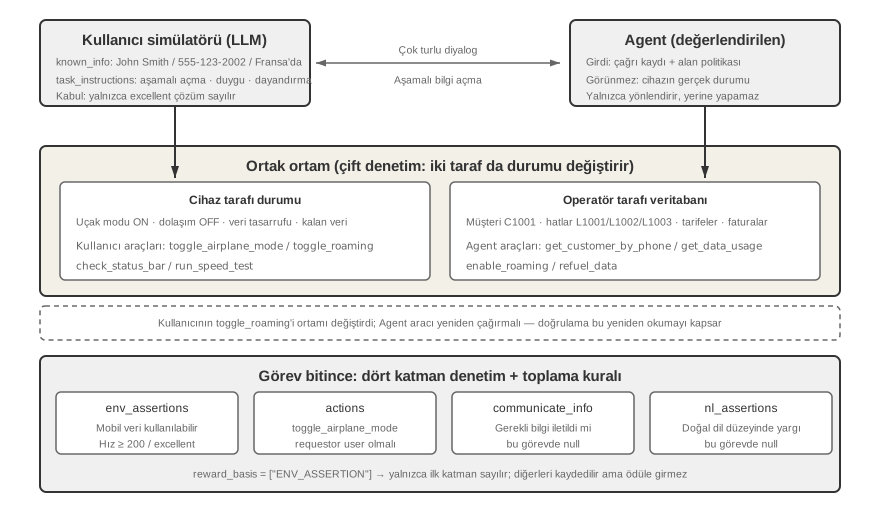
Kullanıcının bilgi sınırı açıkça modellenmiştir.known_info yalnızca üç şey içerir: ad, telefon numarası ve bulunulan ülke. Arızanın asıl iki nedeni — uçak modunun açık, veri dolaşımının kapalı olması — orada yoktur. Kullanıcı bunları bilmediği için kendiliğinden söyleyemez; Agent bunlara ancak soru sorarak ve kullanıcıdan kontrol etmesini isteyerek ulaşabilir. Aşamalı bilgi açığa çıkarma (Progressive Information Disclosure) görev tanımı düzeyinde işte böyle uygulanır: simülatörü “hepsini birden söyleme” gibi bir istemle bağlayarak değil, kullanıcının bilgi kapsamını ayrı bir alan olarak modelleyerek. Çoğu benchmark görevin başında tam gereksinimi ortaya koyar; oysa gerçek bir kullanıcının ilk cümlesi genellikle “internete giremiyorum” kadardır. Talebi uygulanabilir hale getirecek kadar netleştirmek, Agent’ın yapabilmesi gereken işin bir parçasıdır.
Simülatör replik değil, davranış kuralı alır.task_instructions üç tür kısıtı bir arada barındırır: duygu ayarı (ilk başarısız denemeden sonra hafif bir memnuniyetsizlik göstermek), kabul ölçütü (sorun ancak hız testi excellent verirse çözülmüş sayılır; poor, fair ve good kabul edilmez) ve olguya dayandırma (Grounding) koşulu: cihaz durumuna dair her yanıt bir araç çağrısının döndürdüğü değere dayanmalıdır — “Never make up the results of tool calls”. Üçüncüsü en kritik olanıdır: dayandırma kısıtı olmadan simüle kullanıcı Agent’ın yönlendirmesine uyup sorunun çözüldüğünü onaylar ve değerlendirme, iki modelin birbirini teyit etmesine dönüşür.
Başlangıç durumu, denetleyen tarafa göre bölünmüştür.env_type iki değer alır, user ve assistant: uçak modu ile dolaşım anahtarı kullanıcı tarafına, operatör tarafındaki enable_roaming ise Agent tarafına aittir. Arızanın biçimini belirleyen tam da bu ayrımdır: operatör tarafında dolaşım açıktır ama kullanıcının cihazında kapalıdır, dolayısıyla Agent veritabanına baktığında yalnızca “yapılandırma normal” sonucuna varır. Arıza, veritabanının göremediği taraftadır ve ancak kullanıcıdan kontrol etmesi istenerek ortaya çıkar.
Puanlama ölçütleri dört katmana ayrılır ve bu görev bunlardan yalnızca birini kullanır.env_assertions son durumu denetler (mobil veri kullanılabilir, hız 200 Mbps ve üzeri ve derece excellent), actions kilit eylemlerin gerçekleşip gerçekleşmediğini ve hangi tarafın yaptığını denetler, communicate_info ile nl_assertions ise gerekli bilginin kullanıcıya iletilip iletilmediğini denetler. Bu görevin reward_basis alanında yalnızca ENV_ASSERTION bildirilmiştir; kalan katmanlar her zamanki gibi hesaplanıp kaydedilir ama nihai ödüle girmez. Puanlama dayanağı her görev için ayrı bildirilir, genel olarak sabitlenmez.
Gerçek bir çalıştırmanın trajectory’si
Şimdi okurdan τ²-bench telecom alanının değerlendirme görevlerini kendisinin çalıştırmasını, görev tasarımını, kullanıcı simülatörünü, süreç ve sonuç doğrulama mantığını gözlemlemesini, ayrıca Agent’ın yürütme trajectory’sine bakarak neden başarısız olduğunu çözümlemesini istiyoruz.
Deney 7-1 ★: τ²-bench’i çalıştırmak ve τ-bench’ten evrimini karşılaştırmak
Bu deney, insan-bilgisayar etkileşimi türündeki değerlendirme ortamının tasarım noktalarını anlamak için τ²-bench değerlendirme çerçevesini çalıştırır. Önce görev tanım dosyasını bu bölümdeki güzergâhı izleyerek okuyun: her görev dört bölümden oluşur — bilinen bilgi, görev yönergesi, başlangıç durumu ve başarı koşulları. Ardından tam değerlendirme akışını çalıştırın, kullanıcı simülatörü ile Agent arasındaki çok turlu diyaloğu gözlemleyin ve tipik başarısızlık kiplerini (politika ihlali, bilgi atlama, aşırı insan temsilciye aktarma vb.) çözümleyin.
Şekil 7-3: τ²-bench'te çift denetimli ortam ve katmanlı doğrulama · Kaynak şekil
Eşlik eden depoda bir çalıştırma kaydı saklanmaktadır (chapter7/tau2-bench-eval). Aşağıda bunlardan başarılı olan bir çalıştırmayı çözümlüyoruz.
İlk on küsur tur hesap belirleme aşamasıdır. Agent numaradan C1001 müşterisini bulur, ardından L1001, L1002 ve L1003 hatlarının veri kullanımını tek tek sorgular ve kullanıcının Fransa’da gerçekte hangi numarayı kullandığını yeniden sorar. 17. mesajda yanlış bir sonuca varır:
Agent (17): 555-123-2002 numarası etkin hatlarınız arasında yok; en yakını 555-123-2001…
Bu sonuç yalnızca tek bir hattın, L1001’in sorgusuna dayanır. Kullanıcı numaranın doğru olduğunda ısrar edince Agent L1002’yi sorgular ve ancak o zaman eşleştirir. Belirleyici dönüm 30. mesajda gelir:
Aracın döndürdüğü (31): Airplane Mode: ON | Cellular Connection: no_service | Mobile Data Enabled: Yes | Data Roaming Enabled: No
Kullanıcı (33): telefonun şu an uçak modunda olduğunu görüyorum, sinyal olmamasının nedeni bu. Mobil veri açık ama veri dolaşımı kapalı. Uçak modunu kapatıp deneyeyim mi?
Araç çağrısını yapan taraf Agent değil, kullanıcıdır. Çift denetim (Dual-Control) mekanizması budur: simüle kullanıcının check_status_bar, toggle_airplane_mode, reseat_sim_card ve run_speed_test gibi kendine ait bir araç kümesi vardır.
Sonraki teşhis sorunsuz ilerler: Agent kullanıcıdan uçak modunu kapatıp dolaşımı açmasını ister, kullanıcı her iki işlemi de yapar (35, 37) ve durum çubuğu tam çekim 5G’ye döner; Agent hız testi ister, sonuç 275 Mbps ve derece Excellent gelir (46) ve kullanıcı sorunun çözüldüğünü onaylar. İki env_assertions da geçer ve reward = 1.0 olur.
Bu tam puanlı trajectory’de doğrulayıcının yakalayamadığı bir sorun da vardır. Telecom Agent politikasının ilk paragrafı “You should only make one tool call at a time” der; oysa 4. mesajda Agent get_customer_by_phone ile get_customer_by_name çağrılarını bir arada göndermiştir. Doğrulayıcı bunu hata saymamıştır, çünkü bu görevin reward_basis alanı yalnızca son durumu dikkate alır. Bu, τ²-bench’in bir ihmali değil, ikili ödülün doğasında olan bedeldir: süreç ayrıntısını, modeller arasında karşılaştırılabilir tek bir sayıyla takas eder. Ne var ki üretim ortamındaki değerlendirme sistemleri çoğu zaman daha fazlasını ister: yalnızca doğru mu yanlış mı demeyi değil, sorunun nerede olduğunu da göstermeyi.
Başarısız olan görev de çözümlemeye değer. Kullanıcının numarası 555-123-2002’dir ama Agent L1001 hattını seçmiş ve o hattın 3,2/5 GB kullanımını dayanak alarak ilerlemiştir. Yol boyunca get_details_by_id(L1001) o hattın numarasının 555-123-2001 olduğunu açıkça döndürmüştür; Agent bu sonucu okumuş ama yargısını düzeltmemiş, ardından ilgisiz teşhislere onlarca mesaj harcamış ve sonunda insan temsilciye aktarmıştır. Aslında görevin yarısını tamamlamıştır: kullanıcıya veri tasarrufu modunu kapattırmış ve kullanıcı tarafındaki bu eylem gerçekten gerçekleşip ortam tarafından doğrulanmıştır. Ama hat seçimindeki hata yüzünden gereken 2 GB yükleme hiç yapılmamış ve üç son durum savı da başarısız olmuştur. Bu başarısızlığın biçimi, ileride “Başarısızlık atfı” bölümünde ele alınan AndroidWorld örneğine çok benzer: yargıyı düzeltmek için gereken kanıt bağlama çoktan girmiştir, ama Agent buna dayanarak geri dönmemiştir.
Tek bir görev bile, bir değerlendirme kümesinin yanıtlaması gereken bütün soruları ortaya koyar: neyin başarı sayıldığı, görevlerin nereden geldiği, kimin doğruladığı ve puanın nasıl karara dönüştüğü. İzleyen bölümler bunları sırayla ele alıyor.
Değerlendirme metrikleri: başarının tanımı
Bir önceki bölümün değerlendirme sonucu beş görevden dördünün geçmesiydi. Yalnızca 0,8 sayısına bakarak sistemin kullanılabilir olup olmadığına karar verilemez. Bu bir iade müşteri hizmetleri Agent’ıysa, beş kullanıcıdan birinin hak ettiği iadeyi alamaması demektir; açık arayan bir güvenlik Agent’ıysa, beşte dört isabet epeyce iyidir. Fark, iş senaryosunun ne kadar yüksek bir başarı oranı talep ettiğindedir.
Teknik harika: Pass@k ile yetenek tavanı
Bugünkü modellerin ve Agent’ların çoğu hâlâ “teknik harika” diyebileceğimiz bir aşamada. Buradaki harika, çok sayıda deneme, bol zaman bütçesi ve insan eliyle ayıklama altında sergilenen yetenek tavanıdır: içlerinden biri tutarsa “bu iş ilkesel olarak yapılabiliyor” demeye yeter. Pass@k mantığı tam olarak budur — aynı görev k kez çalıştırılır, en az biri geçerse görev geçmiş sayılır; çıktı sürekli bir puansa en iyi koşu alınır ve buna Best@k denir.
Anthropic’in uzun süre çalışan Agent’lar üzerine tartışması bu tavanı iyi örnekler: Agent’a bir hafta boyunca kendi başına çalıştırıp sıfırdan bir C derleyicisi yazdırmak; önemli bir matematiksel sanıya karşı örnek bulana dek aramaya devam ettirmek; ya da açık kaynak yazılımı tekrar tekrar tarayıp onlarca yıldır orada duran ciddi bir güvenlik açığını ortaya çıkarmak.
Bu tür mühendislik ve araştırma keşiflerinde gösterilen şey genellikle “her seferinde doğru yapmak” değil, keşif bütçesi yeterince uzatıldığında nihayet beliren tek bir çığır açıcı yörüngedir. Bilimsel keşif, açık avcılığı ve açık uçlu üretim gibi görevlerde bu tavanın kendisi değerlidir: insan, k aday yörünge arasından en iyisini seçebilir.
Temel model laboratuvarlarının dışında birçok uygulama şirketi de “teknik harika” stratejisini kullanıyor. Manus’un geniş ilgi görmesinin nedeni, insanların eline sanal bir bilgisayar vermesiydi: Agent kavramına dair sezgisi olmayan kitle, yapay zekânın da tıpkı bir insan gibi bilgisayar kullanabildiğini, yarım saat hatta bir saat boyunca çalışıp karmaşık bir görevi adım adım tamamladığını gördü.
OpenClaw ise pek çok kişiye bir Agent’ın “canlı biri” gibi hissettirdiği ilk deneyimi yaşattı. Kullanıcı, gerçek bir kişiye iş verir gibi anlık mesajlaşma uygulaması üzerinden ona görev atayabiliyor; bilgisayardaki tüm dosyalara ve çevrimiçi servislere erişebiliyor, belli bir aşamaya gelince kendiliğinden geri bildirim veriyor ya da yeni bilgi istiyor, hatta e-postayı kontrol edip işlemek için kendi kendini uyandırabiliyor.
İlk dönem Manus ve OpenClaw karmaşık görevlerde yüksek başarı oranına sahip değildi, token maliyetleri de çok yüksekti. Ama bu Agent çerçeveleri genel amaçlı olduğundan, en güçlü modellerle birlikte karmaşık görevlerde Pass@k genellikle yüksek çıkıyor ve yüksek bir teknik tavan ortaya koyuyor. Bu “teknik harikalar”ın sosyal ağlarda yoğun biçimde paylaşılması, bu ürünlerin başarısının anahtarı oldu.
İş güvenilirliği: Pass^k
Gerçek iş dünyası genellikle bunun tersini önemser: birden çok denemede tek bir hata bile olmaması. Bu hedefe Pass^k diyoruz (Pass consecutive k diye okunur): aynı görev art arda k kez çalıştırılır, her seferinde geçmesi ve güvenlik, uyumluluk ya da halüsinasyon gibi bir veto maddesini hiç tetiklememesi istenir. “Agent istikrarlı ve güvenilir biçimde teslim edebiliyor mu” sorusuna yanıt verir, “arada bir mucize yaratabiliyor mu” sorusuna değil.
Koşular birbirinden bağımsızsa ve tek koşunun başarı oranı p ise, iki ölçütün ilişkisi sezgiseldir:
Pass@k=1−(1−p)k,Passk=pk.
Örneğin p=0.6 ve k=5 için: Pass@5 =1−0.45≈99.0%; “en az bir kez başarmak” neredeyse hep mümkün görünür. Oysa Pass consecutive@5 =0.65≈7.8%, yani beş kez üst üste hatasız geçmek hâlâ zordur. İlk sayı keşif sırasındaki yetenek tavanını ölçmeye uygundur; ödeme, iade, yetki değişikliği ve üretim dağıtımı gibi senaryoların güvenilirlik beklentisine yaklaşan ise ikinci sayıdır.
Değerlendirme raporu k denemenin ne olduğunu açıkça yazmalıdır: aynı görevin k bağımsız örneklemi mi, yoksa üretim hattındaki ardışık k görev mi. Yan etkisi olan işlemlerde “başarana kadar yeniden dene” denemez; örnekleme bir kum havuzunda ya da geri alınabilir bir ortamda yapılmalı ve her başarısızlık güvenilirlik ölçütüne işlenmelidir.
Değerlendirme ortamı
Metrik dayanağı belirlendikten sonraki soru nerede ölçüleceğidir. Değerlendirme ortamı, yinelenebilir biçimde çalıştırılabilen bir düzenektir: aynı başlangıç durumu verildiğinde aynı Agent karşılaştırılabilir sonuçlar üretmelidir.
Beş bileşen
Yukarıda incelenen telecom görevine dönelim. Onu ölçüt alırsak, yinelenebilir bir değerlendirme ortamının gerektirdiği her şey zaten mevcuttur.
Veri kümesi (Dataset), görev dosyasının kendisidir: başlangıç durumu, Agent için çağrı kaydı, simülatör için davranış kuralları ve kabul ölçütleri tek bir kayıtta paketlenir; bir kayıt bir test durumudur.
Ortam durumu (Environment State), görev yürütülürken değişebilen bilgidir: veritabanındaki müşteriler, hatlar, tarifeler ve faturalar ile cihaz tarafındaki uçak modu, dolaşım, veri tasarrufu anahtarı ve kalan veri. Sıfırlanabilir olmalıdır ve initialization_actions tam da bu sıfırlama betiğidir. Gerçekçilik, durum değişimlerinin iş mantığına uymasını; denetlenebilirlik ise her çalıştırmadan önce aynı başlangıç noktasına dönülebilmesini gerektirir.
Araç arayüzü (Tools) iki tarafa bölünmüştür. Agent müşteri sorgulama, kullanım sorgulama, veri yükleme, insan temsilciye aktarma gibi operatör tarafı işlemleri çağırabilir; kullanıcı ise cihazındaki anahtarları kullanabilir. Her iki araç kümesi de atomik işlemlerdir; “kullanıcının internet sorununu çöz” gibi üst düzey bir soyutlama yoktur — soyutlama düzeyi fazla yükselirse değerlendirme tek bir işlev çağrısının denetimine iner, planlama ve akıl yürütme aracın kendisine soğurulur.
Puanlama ölçütü (Rubric), evaluation_criteria içindeki dört katman denetim ile reward_basis toplama kuralıdır.
Yürütme protokolü (Interaction Protocol), etkileşim sırasını ve bitiş koşullarını belirler. Buradaki normal bitiş sinyali, simüle kullanıcının ###STOP### çıktısı vermesidir; ayrıca tur üst sınırı vardır ve simüle kullanıcı sabrı tükendiğinde konuşmayı kendisi de bitirebilir — iletişim verimliliğinin fazla düşük olması başlı başına başarısızlık sayılır.
Beş bileşenden biri eksilirse değerlendirme yinelenebilir bir döngü oluşturmaz. Aşağıda başka benchmark’ları incelerken de bu beş maddeyi karşılaştırma çerçevesi olarak kullanacağız.
İnsan-bilgisayar etkileşimi ve araç çağrısı türündeki değerlendirme ortamları
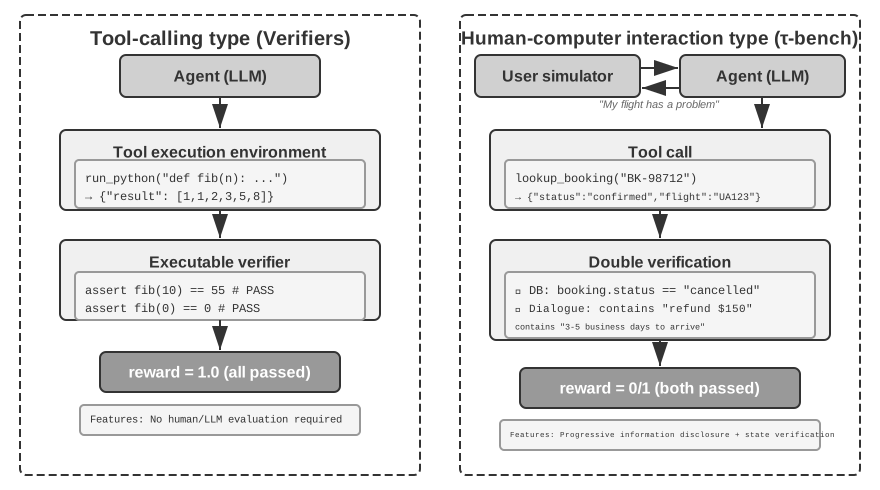
Telecom gibi görevlerin mutlaka bir muhatabı olmalıdır ve beş bileşen içindeki kullanıcı simülasyonu kısmı vazgeçilmezdir. Bir de hiç muhatabı olmayan büyük bir görev sınıfı vardır: kod üretimi, veri çözümlemesi, matematik problemi çözme gibi görevlerde Agent baştan sona yalnızca araçlarla etkileşir, doğruluk yürütme doğrulamasından geçip geçmemesiyle belirlenir ve ne insan etiketlemesi ne de model yargısı gerekir. Bu tür ortamlar kullanıcı simülatörünü atlar; kalan dört bileşen yine vardır, yalnızca biçimleri yalınlaşır: ortam durumu bir dosya sistemi ya da veritabanıdır, puanlama ölçütü bir parça test kodudur ve yürütme protokolü “bir yanıt verene ya da tur hakkı bitene dek araç çağırmayı sürdür”e iner.
Verifiers çerçevesi bu tür ortamları iki boyuta göre katmanlar: görevin turlar arası durum tutması gerekip gerekmediği ve yalıtım gerekip gerekmediği. SingleTurnEnv bir matematik sorusu sorup yanıtı doğrudan doğrulamaya; ToolEnv birkaç web sayfasında arayıp derli toplu yanıt verdikten sonra nihai sonucu doğrulamaya; StatefulToolEnv veritabanı kaydını değiştirip durum değişimini doğrulamaya; SandboxEnv ise sandbox’ta kod çalıştırıp çıktı dosyalarını denetlemeye uygundur. Tablo 7-1 bu dört türü özetler; görev durumu, araç çağrısı ve yalıtım gereksinimlerine göre seçim yapmayı kolaylaştırır.
Çerçeve paralel örnekleme ve trajectory önbelleğini destekler; her değerlendirmenin tam trajectory’si (gözlem, eylem, ödül) saklanır, böylece sonradan çözümlemek ve yeniden oynatmak kolaylaşır. Ayrıca bir aracın yürütme etkisi o anki duruma bağlı olduğundan, başarısızlık halinde yalın bir başarısızlık bayrağı yerine açık bir hata iletisi döndürülmeli ve Agent buna göre stratejisini ayarlayabilmelidir.
Araç çağrısı türündeki değerlendirme, gözlemlenebilir durum değişimlerinin doğruluğunu sınar; insan-bilgisayar etkileşimi türündeki değerlendirme ise iletişim stratejisinin yerindeliğini sınar — ilki eylemi, ikincisi yönlendirmeyi doğrular. İki ortam türünün yapısal karşılaştırması için bkz. Şekil 7-2.
Şekil 7-2: Araç Çağrısı ve İnsan-Bilgisayar Etkileşimi Değerlendirme Ortamları · Kaynak şekil
Değerlendirme veri kümesinin tasarımı
Değerlendirme ortamı sahne ise veri kümesi senaryodur. Aynı beş bileşenle, görev sınıfı değişince doldurma biçimi tümüyle farklılaşabilir: görevlerin nereden geldiği, doğrulayıcının ne kadar derine inebildiği ve ezberlenmenin nasıl önlendiği. Bu bölüm birkaç açık benchmark’ın tasarım pratiğinden yola çıkar ve daha pratik bir soruyla biter: kendi kurduğunuz değerlendirme kümesinin görevleri nereden gelmelidir?
Benchmark tasarım tercihlerinin yatay karşılaştırması
Önceki bölümde ayırt edilen muhatabın varlığı ya da yokluğu, yalnızca ortam düzeyindeki ilk katman farktır; veri kümesi düzeyindeki ayrışmalar tasarım ödünleşimlerini daha iyi gösterir. Tablo 7-2 sık anılan birkaç benchmark’ı yan yana koyar.
Tablo 7-2 Birkaç Agent benchmark’ının temel tasarım tercihleri
Benchmark
Sınanan yetenek
Görev kaynağı
Ortamı canlandıran
Doğrulayıcı
τ²-bench
Müşteri hizmetlerinde insan-bilgisayar etkileşimi ve araç çağrısı
Elle yazım + birleşimsel üretim
Kullanıcı simülatörü + iş veritabanı
Dört katman denetim reward_basis ile ikiliye toplanır
SWE-bench Verified
Yazılım geliştirme, coding
Gerçek GitHub issue’ları, elle elenmiş
Kod deposu + test paketi
FAIL_TO_PASS / PASS_TO_PASS çift doğrulama
AndroidWorld
Android telefon GUI’sini kullanma
Parametreli şablonların örneklenmesi
Gerçek Android öykünücüsü
Nihai UI durumu savları
OSWorld
Linux masaüstü GUI’sini kullanma
Önceden ayarlanmış ara durumdan başlar
Gerçek sanal makine
134 bağımsız değerlendirme işlevi
Terminal-Bench
Linux terminalini kullanma, coding
Elle yazım
Docker kapsayıcısı
Dosya sistemi denetimi + gerçek yürütme
GAIA
Bilgi toplayan genel amaçlı AI asistanı
Elle yazım + özel ekler
Açık internet
Tam dizgi eşleşmesi
Doğrulayıcılar
Bir Agent, görevi tamamen bitirdiğini söyleyen uzun bir rapor yazmakta hiç zorlanmaz; oysa gerçekte hiçbir şey bitmemiş olabilir. Değerlendirme çerçevesi, Agent’ın kendi beyanını değil, makinenin bağımsız olarak doğrulayabileceği olguları denetlemelidir.
SWE-bench Verified “düzeltme tamam”ı iki bağımsız önermeye ayırır. Biri FAIL_TO_PASS’tır: düzeltmeden önce başarısız, sonra başarılı; bu, sorunun gerçekten çözüldüğünü kanıtlar. Diğeri PASS_TO_PASS’tır: düzeltmeden önce de sonra da başarılı; bu, yeni bir kusur sokulmadığını kanıtlar. Yalnızca ilkini denetlerseniz Agent, yolunu kesen savları silip değiştirerek sıyrılabilir; yalnızca ikincisini denetlerseniz hiç denetlememişsiniz demektir. Ancak ikisini birden denetlemek “düzeltildi” ile “hiçbir şey bozulmadı”yı ayrı ayrı kanıtlanabilir iki sonuca dönüştürür. Ayrıca testlerin kendi kararlılığını da doğrular ve kimi zaman geçip kimi zaman kalan kararsız testleri (flaky test) eler.
OSWorld’ün doğrulayıcısı, dışarıdan tamamlanmış görünen ama özünde yanlış olan durumları yakalayabilir. 134 bağımsız değerlendirme işlevi ve işletim sistemine tam erişimle donatılmıştır; dosya sistemi yapısını, süreç durumlarını, ağ bağlantılarını ve uygulamaların iç durumunu denetleyebilir. Veritabanı görevlerinde değerlendirme betiği yalnızca rapor dosyasının varlığını doğrulamakla kalmaz, veritabanına bağlanıp SQL’in gerçekten çalışıp çalışmadığını da denetler; tarayıcı görevlerinde DOM ağacını çözümler, cookie ile localStorage’ı inceler ve formun gerçekten işleyip işlemediğini doğrulamak için arka uca istek gönderir.
Terminal-Bench’in build-linux-kernel-qemu görevi, Linux 6.9 çekirdeğinin kaynaktan derlenmesini, start_kernel içine özel bir printk eklenmesini, bir initramfs üretilmesini ve bunun QEMU’da çalıştırılmasını ister; başarı ölçütü, açılış günlüğünde o özel iletinin görünmesidir. Agent çıktıyı sahteleyemez; bütün süreci gerçekten tamamlamaktan başka yolu yoktur.
Görevlerin zorluk düzeylerine ayrılması
Bir değerlendirme görev kümesi farklı zorluktaki görevleri içermelidir. Böylece model yetenekleri arttığında küme çabucak eskimez.
GAIA’nın 466 sorusu üç zorluk düzeyine ayrılmıştır: Level 1 bir iki araçla halledilir (insanlar %93,9, GPT-4 %30,3), Level 2 çok adımlı düşünmeyi gerektirir (%91,8’e %9,7) ve Level 3 karmaşık birleşimleri gerektirir (%87,3’e %0). Bu katmanlama yalnızca zorluk etiketlemez, tanısal değeri de vardır: Level 1’deki başarısızlık temel araç kullanımına, Level 2 çok adımlı planlama ve bilgi bütünleştirmeye, Level 3 ise uzun diziler boyunca düşünme ve karmaşıklık yönetimine işaret eder; üçü farklı iyileştirme yönlerine karşılık gelir.
Terminal-Bench basit bir mlflow model kaydından orta zorlukta 7z parola kırmaya, zor bir git sunucusu ile web sunucusunun çok bileşenli tümleştirilmesine ve en ağır olan FEAL diferansiyel kriptanalizine kadar uzanır.
τ²-bench ayrıca özel olarak tuzak görevler tasarlar: kullanıcı “müşteri hizmetleri iptali zaten onayladı” der ama bu aslında politikaya uygun değildir; böylece Agent’ın baskı ve yanıltma altında doğru yargısını koruyup koruyamadığı sınanır.
Veri sızıntısının önlenmesi
GAIA yanıtlarının internetten doğrudan aranmasını olanaksız kılar. Görevleri kavramsal olarak yalın ama yolu açıktır: örneğin belirli bir tarihteki NASA Günün Astronomi Fotoğrafı’ndan yola çıkıp fotoğraftaki astronotu tanımak, mensup olduğu astronot grubunu bulmak, o grupta uzayda en kısa süre kalanı hesaplamak ve sonucu “soyadı, noktalı virgülle ayrılmış, binlik ayırıcılı” biçiminde tam olarak vermek. Yanıt son derece özgüldür ve doğruluğu tam dizgi eşleşmesiyle belirlenir. Sızıntı önleme iki şeye dayanır: birincisi, soruya ancak birkaç bilgi kaynağı birleştirilerek yanıt verilebilir ve tek bir web sayfası yanıtı doğrudan vermez; ikincisi, bazı görevlere özel olarak üretilmiş ekler iliştirilmiştir (internette bulunmayan PDF, ses ve görseller).
AndroidWorld tek bir şablondan çok sayıda örnek türetir. Görevleri durağan metin değil, dinamik olarak örneklenebilen şablonlardır; örneğin “[CONTACT_NAME] kişisinin telefonunu [NEW_PHONE] yap” gibi, parametre değerleri her değerlendirmede rastgele üretilir. Bunun üç yararı vardır: parametreler her seferinde farklı olduğundan sabit bir işlem dizisini yeniden oynatmak işe yaramaz; tek bir şablon neredeyse sınırsız örnek üretebilir; bazı parametreler sabitlenip geri kalanlar değiştirilerek belirli bir etkenin etkisi kesin biçimde ölçülebilir.
Terminal-Bench soru metnine kanarya tanımlayıcısı gömer. Her soru bir canary GUID taşır; bir model o GUID’i içeren içerik üretebiliyorsa benchmark verisi eğitim kümesine girmiş demektir. Sızıntıyı engellemez ama saptanabilir kılar.
Kalite denetimi ve uzun vadeli bakım
Yüksek kaliteli bir değerlendirme kümesi hazırlamak çok zordur. Yukarıdaki benchmark’ların çoğunun bugünkü hali, ilk sürümleri kullanıma girip sorunları açığa çıktıktan sonra tur tur onarılmasının ürünüdür. Örneğin τ-bench’ten τ²-bench’e beş yer yeniden tasarlanmıştır.
Birincisi, görev yönergeleri fazla genel olduğundan yanıt tahmin edilebiliyordu. İlk sürümün yönergeleri geniş yazılmıştı, bu yüzden modelin talebi gerçekten netleştirmesine gerek kalmıyor, sağduyuyla bir prosedür tahmin etmek geçmeye yetiyordu. τ²-bench senaryoyu known_info ve task_instructions diye iki alana böldü: ilki kullanıcının bildiklerinin sınırını çizer, ikincisi açığa çıkarma biçimini belirler. Kullanıcının bilmediğini Agent tahmin edemez, ancak sorgulayarak öğrenebilir.
İkincisi, başarı koşulları yeterince kesin olmadığından doğrulama yanlış hüküm veriyordu. “Ağ düzeldi” gibi bir koşulun denetlenebilir bir sınırı yoktur. τ²-bench bunu “yalnızca hız testi excellent verirse çözülmüş sayılır; poor, fair ve good kabul edilmez” olarak değiştirdi. Bu değişiklik, belirtiyi bastırıp kök nedeni gidermeyen göstermelik onarımları hedefler.
Üçüncüsü, kullanıcı simülatörünün davranışı fazla mekanikti. İlk sürümün simüle kullanıcısı yalnızca edilgen yanıt veriyordu. τ²-bench ona duygu (ilk onarım başarısız olunca hoşnutsuzluk göstermek), sabır sınırı (iletişim çok verimsizse konuşmayı kesmek) ve olguya dayandırma koşulunu ekledi. Üçü birlikte, simülatörü gerçek kullanıcıya yaklaştırırken yinelenebilirliği de korur.
Dördüncüsü, kullanıcı yalnızca konuşmaya değil, işleme de katılır. Telecom alanı çift denetimli ortamı getirdi. Daha önceki değerlendirmelerde ortamı yalnızca Agent değiştirebiliyordu; oysa teknik destek gibi senaryolarda eylemlerin epeyce bir bölümünü aslında kullanıcının kendi cihazında yapması gerekir. Çift denetim, doğrulamaya bir boyut daha katar: kullanıcı durumu değiştirdikten sonra Agent sonucu ancak aracı yeniden çağırarak öğrenebilir, dolayısıyla doğrulama artık “Agent kullanıcı tarafındaki işlemin sonucunu gerçekten okudu mu” sorusunu da kapsar.
Beşincisi, görev örnekleri dinamik olarak üretilir. τ²-bench’in somut örnekleri (kullanıcı adları, numaralar, arıza birleşimleri) parametreleştirilip toplu üretilebilir; bu hem kapsamı hem de sızıntıya direnci iyileştirir.
SWE-bench Verified: yayımlanmadan önce özgün görevlerin %71’i elendi. OpenAI, özgün 2.294 görevten 1.699’unu rastgele seçip insan değerlendirmesine soktu ve Python’a hâkim 93 geliştirici toplayarak her birini tek tek denetletti: sorun açıklaması net mi, test durumları sınır koşullarını kapsıyor mu, testler kararlı mı, referans patch yeni hata sokuyor mu, zorluk makul mü. Sonunda yalnızca 500’ü geçti. Yüksek eleme oranı daha iyi bir sinyal-gürültü oranı getirir ve değerlendirme maliyeti de yaklaşık %80 düşer. Karmaşık Agent görevleri sıklıkla dakikalardan saatlere sürer ve öncü bir modelle bir değerlendirme veri kümesini baştan sona koşturmak çoğu zaman binlerce dolarlık token maliyeti getirir; bu yüzden değerlendirme maliyetini düşürmek son derece önemlidir.
OSWorld: yayımlandıktan sonraki 15 ayda 300’den fazla sorun açığa çıktı. Nisan 2024’te yayımlandıktan kısa süre sonra çok kipli Agent değerlendirmesinin önemli bir benchmark’ı oldu; ancak sonraki yaygın kullanım dört tür sorunu ortaya çıkardı: ortam sorunları (sitelerin kazıma karşıtı önlemleri, CAPTCHA, dinamik içerik değişimi), görev açıklaması sorunları (belirsiz ifadeler), doğrulama mantığı sorunları (fazla katı ya da fazla gevşek) ve başlangıç durumu sorunları (eksik yapılandırma). Hong Kong Üniversitesi’nden yaklaşık 10 kişilik bir ekip iki ay boyunca MoonShot AI, OpenAI, ByteDance Seed TARS, Anthropic, Simular ve diğerleriyle yakın çalışarak sistematik bir onarım yürüttü: ortam sorunları sürüm sabitleme ve çevrimdışı yedeklerle, açıklama sorunları belirsiz ifadelerin yeniden yazılmasıyla, doğrulama sorunları elle doğru bir taban çizgisi kurulup koşulların ayarlanmasıyla, başlangıç durumu sorunları ise bütünlük denetimleri eklenerek hafifletildi.
Deney 7-2 ★: Benchmark görevlerini elle yapmak
GAIA, AndroidWorld, SWE-Bench Verified, Terminal-Bench ve OSWorld-Verified’dan görevler seçip kendi elinizle tamamlayın; her veri kümesi için bir kolay, bir orta ve bir zor görev önerilir. “Zor” düzey insanlar için de meydan okuyucudur.
Bitirdikten sonra iki soruyu yanıtlayın. Görev açıklaması birden çok makul yorum barındırıyor mu; barındırıyorsa doğrulayıcı hangisini kabul ediyor? İşi yapmadan sıyrılmaya kalksanız en ucuz yol ne olurdu ve doğrulayıcı bunu engelleyebilir mi?
Değerlendirme kümesinin üç kaynağı
Yaygın bir görüş, açık benchmark’ların model sıralaması için olduğunu ve gerçek işle pek ilgisi bulunmadığını söyler. Açık benchmark puanlarının ürün kararlarını doğrudan yönlendirmesinin güç olduğu doğrudur, ama tasarım teknikleri fazlasıyla aktarılabilir. Yukarıda tartışılan doğrulama derinliği, parametreli üretim, sızıntı önleme ve kalite bakımı, kendi kurduğunuz değerlendirme kümesinde en kolay atlanan noktalardır.
Üretim ortamındaki bir değerlendirme kümesinin genellikle üç kaynağı vardır.
Açık benchmark’lar modelleri kabaca elemek ve tasarım tekniklerini ödünç almak için kullanılır, genelde ürün kararları için değil. Görev dağılımları gerçek işin görev dağılımıyla örtüşmez; GAIA’da iki puan yükselmenin iade başarı oranıyla zorunlu bir ilişkisi yoktur.
Kendi kurduğunuz iş kümesi gerçek görev dağılımını kapsar ve model seçimi ile Harness tasarım kararlarına dayanak olabilir. Örneğin τ²-bench, simüle kullanıcı gerektiren herhangi bir değerlendirme sisteminin iskeleti olarak doğrudan kullanılabilir; yalnızca alan verilerini ve araç kümesini değiştirmek yeterlidir.
Üretim trajectory’lerinin geri akışı sahadaki gerçek başarısızlıklardan gelir: kullanıcının açık düzeltmeleri, kullanıcının olumsuz oyları ve sonradan durum denetimi, kural tabanlı doğrulayıcı ya da LLM incelemesiyle bulunan sorun örnekleri. Başarısızlık atfından geçtikten sonra regresyon durumlarına dönüşürler. Somut yöntem ileride “Başarısızlık atfı” ile “Uçtan uca regresyon görevleri ve trajectory prefix regresyon görevleri” bölümlerinde anlatılır. Bu kaynak en pahalı olduğu kadar en isabetlisidir de, çünkü doğrudan kullanıcıların gerçekten karşılaştığı sorunlardan gelir.
Başlangıç aşamasında genellikle yalnızca açık benchmark’lar ve elle yazılmış küçük bir iş kümesi bulunur; sistem üretimde bir süre çalıştıktan sonra üretim trajectory’lerinden geri akan durumlar ana gövdeyi oluşturur.
Otomatik değerlendirme yöntemleri
Önceki bölümlerde ele alınan benchmark’ların ortak bir yanı vardır: doğrulayıcıları neredeyse tümüyle belirlenimcidir. SWE-bench bir test paketi çalıştırır, AndroidWorld nihai UI durumunu savlar, GAIA tam dizgi eşleşmesi yapar ve τ²-bench’in dört katman denetimi de aynı biçimde bütünüyle kodla yürütülür. Bu seçimin sağlam gerekçeleri vardır: belirlenimci doğrulama ek model maliyeti getirmez, sonuç tümüyle yinelenebilirdir, birim testi gibi sürekli tümleştirmeye katılabilir ve modeller arası sıralamayı kolaylaştırır.
Bedeli, yalnızca nihai sonucun doğru olup olmadığını değerlendirebilmesi, hatanın nedenini verememesidir. τ²-bench’in başarısız görevi sonuçta 0 puan almıştır ve bu 0, Agent’ın hat seçiminde mi yanıldığını yoksa veri yükleme adımını mı atladığını söylemez; bir sonraki adımda neyin değiştirileceğini hiç göstermez. Sıralama için kullanılan açık bir benchmark açısından bu bir kusur değildir; sürekli iyileştirme gerektiren bir üretim sistemi açısından ise en çok ihtiyaç duyulan bilgi tam da budur.
Üretim ortamında bir ikinci güçlük daha vardır: birçok yargı, kodla denetlenebilen bir sava hiç dönüştürülemez. Bir şikâyet yanıtının yerinde olup olmadığı, bir araştırma raporunun kilit bir bilgiyi atlayıp atlamadığı, bir bellek erişiminin kişiler arasındaki ilişkiyi karıştırıp karıştırmadığı — bunların ne sorgulanacak tek bir nihai durumu vardır ne de anahtar sözcük eşleşmesiyle karara bağlanabilirler.
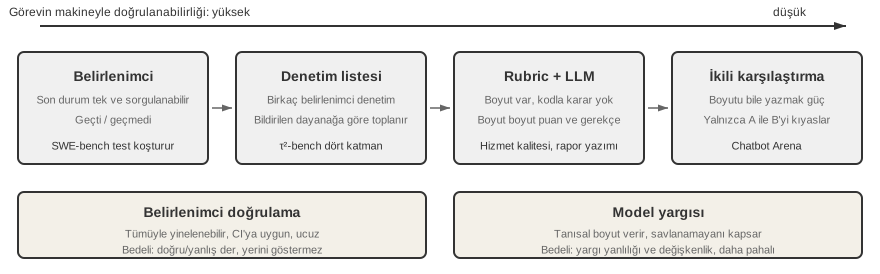
Bu nedenle açık benchmark’lardan üretim ortamındaki değerlendirmeye geçerken doğrulama biçiminin, yatay ekseni görevin makineyle doğrulanabilirlik derecesi olan bir tayf boyunca sağa kayması gerekir; Şekil 7-4’te gösterilmiştir.
Şekil 7-4: Doğrulama biçimlerinin tayfı — belirlenimci doğrulamadan model yargısına · Kaynak şekil
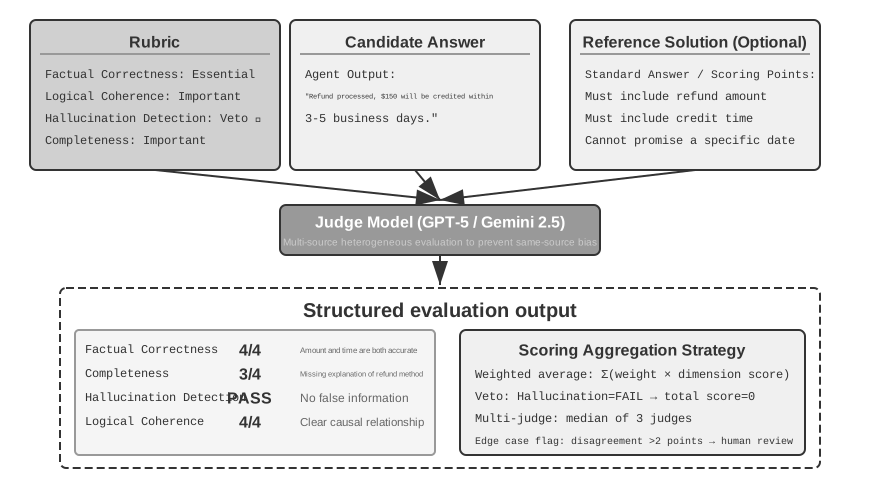
Tayfın sağ yanındaki iki araç böylece üretim değerlendirmesinin gövdesi olur: Rubric bulanık “iyi mi kötü mü” sorusunu ayrı ayrı puanlanabilir birkaç boyuta ayırır, LLM-as-a-Judge ise belirlenimci bir ölçüt bulunmadığında puanlamayı üstlenir. Ancak ikisi birlikte, bulanık bir başarısızlık oranını üzerinde çalışılabilir somut sorunlara indirgeyebilir; bu bölümün ikinci yarısındaki başarısızlık atfı ile birleştiğinde üretim Agent’ı değerlendirmesinin tam kapalı çevrimi oluşur.
Şunu belirtmek gerekir: sağa kaymak sol yanı bırakmak demek değildir. Program savı olarak yazılabilen her denetim sav olarak kalmalı, LLM yargısı yalnızca gerçekten makineyle karara bağlanamayan boyutlar için kullanılmalıdır. Belirlenimci denetimler daha ucuz ve daha kararlıdır, uzun soluklu regresyon testi olarak koşturulmaya da daha uygundur.
LLM-as-a-Judge: Otomatik Değerlendirmenin Çekirdeği
Şekil 7-5: LLM-as-a-Judge Boru Hattı · Kaynak şekil
LLM-as-a-Judge’a neden ihtiyaç var? Açık uçlu görevlerde (rapor üretme, müşteri şikâyetlerini ele alma, yaratıcı içerik gibi) otomatik karşılaştırma yapılabilecek standart bir yanıt yoktur; insan değerlendirmesi ise pahalıdır ve ölçeklenmesi zordur. LLM-as-a-Judge, dil modelinin uzmanlarca tanımlanmış puanlama ölçütlerine (Rubric) göre değerlendirme yapmasını sağlayarak otomasyonun ölçeğiyle insan uzmanlığının yargısı arasında bir denge kurar. Ama bu yöntemin bilinen sınırları da var: değerlendirici modelin kendi önyargıları olabilir (en tipik olanı uzunluk yanlılığıdır — içerik daha doğru olmasa bile daha uzun ve daha ayrıntılı yanıtlara yüksek puan verme eğilimi) ve aynı girdi birden çok kez değerlendirildiğinde sonuçlar dalgalanabilir. Özellikle uzunluk yanlılığına karşı ayrıca önlem almaya değer; üç yaygın yöntem vardır: Rubric’te uzun uzadıya anlatımı açıkça cezalandırmak ve aynı tür görevler için yanıt uzunluğuna üst sınır koymak; ikili karşılaştırma yaparken iki adayın uzunluğunu önce birbirine yaklaştırıp sonra değerlendirmek; ve puanlarla yanıt uzunluğu arasındaki ilişkiyi düzenli olarak denetlemek — yüksek puanlar neredeyse her zaman uzun yanıtlara gidiyorsa, değerlendirme uzunluğun etkisine kapılmış demektir ve Rubric elden geçirilmelidir. Bu zorluklarla sistematik biçimde başa çıkmak için Rubric tasarımı aşağıdaki ilkelere uymalıdır:
Rubric’in Dört İlkesi (Scale AI, “Rubrics as Rewards”):
(1) Uzman rehberliğine dayanma — Rubric alan bilgisini yansıtmalı, temel olguları ve akıl yürütme adımlarını yakalamalıdır. Örneğin tıbbi soru-yanıt için hazırlanan bir Rubric’in tanı ölçütlerini ve kaçınılması gereken tıbbi hataları içermesi gerekir; uzmanlık temeli olmayan bir Rubric yalnızca dilin akıcılığı gibi yüzeysel özellikleri yakalayabilir.
(2) Kapsayıcı olma — olgusal doğruluğu, mantıksal tutarlılığı, eksiksizliği ve güvenliği kapsamalıdır; üstelik yalnızca olumlu ölçütleri tanımlamakla kalmayıp tuzakları (Pitfall) da açıkça belirtmelidir — yani yüksek riskli yaygın hataları; tıbbi tavsiyede doğrulanmamış bir tedaviyi önermek gibi.
(3) Ölçütlerin önem ağırlıklandırması — ölçütler zorunlu (Essential), önemli, isteğe bağlı ve tuzak maddeleri olarak sınıflandırılır. Bu yapı tek oyla veto mekanizmasını (Veto) destekler: örneğin müşteri hizmetleri senaryosunda halüsinasyon (yanlış bilgi uydurma) tipik bir veto boyutudur — diğer boyutlardaki performans ne kadar üstün olursa olsun, yanlış bilgi ortaya çıktığı anda sonuç veto edilmelidir. Bu aynı zamanda anahtar kelime yığma biçimindeki reward hacking’e karşı da korur.
(4) Kendi kendine yeten değerlendirme — her değerlendirme maddesi bağımsız olarak uygulanabilir olmalı, değerlendiricinin alan bilgisine bağlı olmamalıdır. “Yanıt derin bir kavrayış sergiliyor” gibi soyut ölçütlerden kaçınılmalı, bunun yerine “en az iki otoriter kuramdan alıntı yapıyor ve bunların sonucu nasıl desteklediğini doğru biçimde açıklıyor” gibi doğrulanabilir ölçütler kullanılmalıdır.
Kilit pratik: her boyut için nesnel biçimde doğrulanabilir puan basamakları tanımlamak, belirsiz durumları ayırt etmeye yardımcı olacak somut örnekler ve sınır vakaları vermek. Reward hacking’e — yani Agent’ın görevi gerçekten tamamlamadan yüksek puana giden bir “kestirme yol” bulmasına — karşı proaktif önlem alınmalı; halüsinasyon, kullanıcıya yaranma, anahtar kelime yığma ve zor sorulardan kaçınma açıkça cezalandırılmalıdır. Rubric yinelemeli bir üründür — deneme kullanımıyla değerlendiriciler arasındaki görüş ayrılıkları toplanır, ölçüt adım adım iyileştirilir ve soyut ilkelerden ayrıntılı bir emsal derlemesine doğru evrilir.
Aşağıda, kullanıcı belleği Agent’ı örneği üzerinden dört ilkeye uyan eksiksiz bir Rubric gösteriliyor. Test sorusu: “Kızımın çocuk doktoru kim?” (Yanıt, iki ayrı konuşma arasında ilişki kurmayı gerektirir: ilk konuşmada “kızımın adı Lily” denmiş, ikincisinde “Lily’yi Dr. Chen’e götürdüm” denmiştir.)
rubric:
  dimensions:
    - name: Olgusal doğruluk
      weight: essential        # Zorunlu madde
      scoring:
        4_Mükemmel: "Dr. Chen yanıtını doğru verir ve kızı Lily ile ilişkilendirir"
        3_İyi: "Dr. Chen yanıtını doğru verir ama Lily'nin doktoru olduğunu belirtmez"
        2_Geçer: "Doğru doktoru söyler ama yanında belirsiz ek bilgiler verir"
        1_Başarısız: "Yanlış doktor adı verir veya bilmediğini söyler"

    - name: Bilgi eksiksizliği
      weight: important        # Önemli madde
      scoring:
        4_Mükemmel: "İlgili bilgileri kendiliğinden ekler (son muayene tarihi, tanı sonucu gibi)"
        3_İyi: "Temel soruyu eksiksiz yanıtlar"
        2_Geçer: "Temel soruyu yanıtlar ama elindeki ilişkili bilgileri atlar"
        1_Başarısız: "Kritik bilgi eksik"

    - name: Düşünme doğruluğu
      weight: important
      scoring:
        4_Mükemmel: "'kızı = Lily' ve 'Lily için doktor = Dr. Chen' bilgilerini oturumlar arasında doğru ilişkilendirir"
        3_İyi: "İlişkilendirme doğru ama düşünme yolu yeterince açık değil"
        2_Geçer: "İlişkilendirmenin bir kısmı doğru"
        1_Başarısız: "Yanlış ilişkilendirme (kullanıcının kendi doktorunu kızının doktoru sanmak gibi)"

    - name: Halüsinasyon tespiti
      weight: veto             # Veto maddesi: tetiklendiği anda toplam puan sıfırlanır
      scoring:
        pass: "Tüm bilgiler geçmiş konuşma kayıtlarına kadar izlenebilir"
        fail: "Konuşmada geçmeyen bilgi uydurulmuş (hayali muayene tarihi, tanı sonucu gibi)"

  edge_cases:
    - "Kullanıcının birden fazla kızı varsa ve ayrı doktorlara gidiyorlarsa, hangi kızı olduğu sorulmalı"
    - "Bellekte hem 'Dr. Chen' hem de '陈医生' (aynı adın Çince yazılışı) varsa, ikisi aynı kişi olarak tanınmalı"
İyi Rubric ile kötü Rubric: yukarıdaki her puan basamağı, “belleğe dair derin bir kavrayış sergiliyor” gibi nesnel olarak yargılanamayacak betimlemeler yerine doğrulanabilir somut davranışlar (“Dr. Chen yanıtını doğru verir”) tanımlıyor. Veto maddesi ise alt sınırı net çiziyor: diğer boyutların hepsi tam puan alsa bile, halüsinasyon görüldüğü anda sonuç doğrudan sıfırdır.
Rubric ile Agent’ın yanıtını birlikte hakem modele verin; model her boyutu puanlayıp gerekçesini yazsın. Onlarca vakanın sonuçlarını boyutlara göre topladığınızda ve düşük puanlı trajectory’leri yeniden oynattığınızda, genel bir “başarı düştü” bulgusu somut bir teşhise dönüşür: retrieval bir olguyu kaçırmış olabilir, model kişi ya da olayları yanlış ilişkilendirmiş olabilir veya dayanağı olmayan bir iddia eklemiş olabilir. İyi bir Rubric yalnızca sistemin kaç puan aldığını değil, bir sonraki incelemenin nereye yönelmesi gerektiğini de gösterir.
Aşağıda kullanıcı belleğini somut bir örnek olarak alıp, bu genel yöntemin çalıştırılabilir bir değerlendirme kümesine ve doğrulayıcıya nasıl indirgendiğini gösteriyoruz.
Deney 7-3 ★★: Rubric Tabanlı Bir Kullanıcı Belleği Değerlendirme Sistemi Kurmak
Ön koşul: Bölüm 3’teki kullanıcı belleği deneyinin (chapter3/user-memory-evaluation) tamamlanmış olması gerekir.
Bu deney, Bölüm 3’teki chapter3/user-memory-evaluation çerçevesini dönüştürmenizi ve basit LLM-as-a-Judge’a dayanan mevcut puanlama mekanizmasını yapılandırılmış, çok boyutlu bir Rubric değerlendirme sistemine yükseltmenizi ister. Mevcut sistem tek bir LLM çağrısıyla geçti/kaldı sonucunu ve değerlendirme gerekçesini döndürür; yapılandırılmış teşhis yeteneğinden yoksundur.
Üç görev katmanının tamamına uygulanabilecek birleşik, çok boyutlu bir Rubric çerçevesi tasarlayın. Değerlendirme boyutları şunlardır: olgusal doğruluk (Precision, kesinlik — verilen bilgilerin ne kadarı doğru) sayıların/tarihlerin/adların bellekteki bilgiyle tutarlı olup olmadığını doğrular; olgusal eksiksizlik (Recall, geri çağırma — verilmesi gereken bilgilerin ne kadarı anıldı) ilgili bilgilerin tamamının verilip verilmediğini, kritik içeriğin atlanıp atlanmadığını doğrular; düşünme doğruluğu, bilgiler arasındaki ilişkilerin ve örtük mantığın doğru kavranıp kavranmadığını denetler; düşünme inisiyatifi, uygun anlarda doğrudan yanıtın ötesinde öneri veya risk uyarısı verilip verilmediğini değerlendirir; halüsinasyon tespiti ise bellekte bulunmayan bilgilerin uydurulmadığını güvenceye alır.
Dört basamaklı puanlama (Mükemmel/İyi/Geçer/Başarısız) kullanın; her basamağa soyut betimlemeler yerine somut karar ölçütleri koyun. Halüsinasyon boyutunu tek oyla veto maddesi yapın. Her boyut için örnekler ve sınır vakaları verin.
Deney 7-4 ★★: Advanced JSON Cards ile RAG’ın Karşılaştırmalı Değerlendirmesi
Ön koşul: Bölüm 3’teki kullanıcı belleği ve RAG deneylerinin (chapter3/user-memory, chapter3/agentic-rag-for-user-memory) tamamlanmış olması gerekir.
Amaç: Yapılandırılmış bellek ile yapılandırılmamış retrieval’ın üstünlük sınırlarını aynı değerlendirme kümesi üzerinde adil biçimde karşılaştırmak. Bölüm 3’teki iki projeyi yeniden kullanın ve chapter3/user-memory-evaluation içindeki 60 test durumu üzerinde üç yapılandırmayı karşılaştırın — saf Advanced JSON Cards (yapılandırılmış kartlar sürekli context’te durur, retrieval gerekmez), saf RAG (konuşmalar parçalara ayrılıp vektör veritabanına konur, retrieval zorunludur) ve hibrit sistem (temel olgular sürekli context’te + özgün konuşmalar ihtiyaç halinde retrieval ile).
Kabul ölçütü: Üç karmaşıklık katmanında (temel hatırlama / çok oturumlu belirsizlik giderme / oturumlar arası gizli ilişkilendirme) başarı oranını, ortalama adım sayısını, tool calling sayısını, gecikmeyi ve maliyeti kaydedin; her yaklaşımın nerede çöktüğünü net biçimde anlatın — yapılandırma neyi kaybetti, retrieval neyi kaçırdı, hibrit gerçekten bir sinerji sağlıyor mu. Yapılandırma ayrıntıları ve test durumları için eşlik eden depoya bakın.
Eşlik eden deney, üç sistemi aynı 60 soru üzerinde çalıştırdı ve 180 gerçek API trajectory’sini sakladı. Tablo 7-3 yüzdelerin yanında başarılı vaka sayılarını da gösteriyor.
Tablo 7-3 Bellek Sistemine ve Görev Düzeyine Göre Başarı Oranı
Sistem
Temel hatırlama
Çok oturumlu belirsizlik giderme
Oturumlar arası gizli ilişkiler
Toplam
Advanced JSON Cards
95%
60%
50%
68.3% (41/60)
RAG
90%
40%
15%
48.3% (29/60)
Hibrit
80%
70%
50%
66.7% (40/60)
En dikkate değer olan, melez çözümün kendiliğinden kazanmamasıdır. Üç soruda iki tekil çözümün de başaramadığını başardı, ama başka sekiz soruda daha iyi olan tekil çözümün gerisinde kaldı; her sorudaki en iyi tekil çözümle karşılaştırıldığında ortalama başarı oranı tersine daha düşük çıktı. Saf RAG temel hatırlama sorularında yapılandırılmış kartlardan pek farklı değildi; ama oturumlar arası ilişkilendirme sorularına gelince başarı oranı %15’e düştü. Kolayca gözden kaçan bir başka sayı: 180 yargı içinde halüsinasyon vetosu 28 kez devreye girdi — tek bir veto maddesinin önemi buradan görülüyor.
Aynı aileden model sorunu ve çok kaynaklı değerlendirme.
Agent ile değerlendirici model aynı model ailesinden geldiğinde, Agent değerlendirici modelin tercihlerini ve kör noktalarını kullanmayı öğrenebilir.
Goodhart Yasası’nın (Goodhart’s Law) söylediği tam olarak budur: bir ölçüt optimizasyon hedefi haline geldiğinde, iyi bir ölçüt olmaktan çıkar. Agent belirli bir puanlama sistemi üzerinde ne kadar çok eğitilir veya ayarlanırsa, gerçekten yetenek kazanmak yerine o sistemin açıklarını kullanmaya o kadar eğilimli olur.
Daha da sinsi olanı: Agent zamanla, değerlendirici modelin saptamakta iyi olmadığı hata türlerinden kaçınmayı öğrenir ve puanlama sisteminde her şey yolundaymış gibi görünür.
Hafifletme stratejisi çok kaynaklı ve heterojen değerlendirmedir — farklı model ailelerinden birden çok LLM ayrı ayrı değerlendirme yapar (örneğin Agent Claude ile çalışıyorsa değerlendirme GPT-5 ve Gemini ile yapılır). Farklı ailelerin önyargıları çoğu zaman birbirine diktir, dolayısıyla Agent’ın bütün değerlendiricileri aynı anda “kandırması” çok zordur. Herkesin aynı hedefi değerlendirdiğinden emin olmak için aynı Rubric kullanılır ve sonuçlar ağırlıklı ortalama veya tutarlılık denetimiyle birleştirilir. Dağıtım aşamasında hızlı değerlendirme için tek bir model kullanılabilir, ama kalite denetimi düzenli aralıklarla eksiksiz çok kaynaklı değerlendirmeyle yapılmalıdır.
Çok kaynaklı değerlendirme “hangi modelle değerlendirileceği” sorusunu çözer; sırada “hangi modalitelerin değerlendirileceği” sorusu var — LLM-as-a-Judge’ın yeteneğini metinden sese, görüntüye ve videoya genişletmek, değerlendirme kapsamının bir başka boyutudur.
Çok modlu LLM-as-a-Judge.
Çok modlu değerlendirme, LLM-as-a-Judge’ı ses, görüntü ve video alanlarına genişletir; yaygın dört yön aşağıdadır.
TTS değerlendirmesi (TTS, yani Text-to-Speech, metinden konuşmaya): doğruluk, doğallık, ses tınısı tutarlılığı ve duygu ifadesi değerlendirilir. Bu boyutlar, geleneksel WER’in (Word Error Rate, kelime hata oranı) yakalamakta zorlandığı ezgi (prozodi) sorunlarını ortaya çıkarabilir.
ASR değerlendirmesi (ASR, yani Automatic Speech Recognition, konuşma tanıma): anlamsal etki değerlendirmesi yapılır — “bugünkü hava” ifadesinin yanlış tanınması zararsızdır, ama “bin lira gönder” ifadesinin “on bin” olması ciddi sonuçlar doğurabilir.
UI değerlendirmesi: Proposer-Reviewer (önerici-inceleyici) mekanizması kullanılarak metin taşması, renk kontrastı, düğme konumu gibi sorunlar denetlenir. Buradaki Proposer-Reviewer bir değerlendirme yöntemi olarak kullanılır; Bölüm 5’teki üretim sistemi bileşeni kullanımından farklıdır, ama temel mekanizma aynıdır — bir model üretir, başka bir model bağımsız olarak inceler.
Video kurgu değerlendirmesi: anahtar kareler üzerinden kesme başlangıç/bitiş noktalarının ve efekt uygulamalarının doğru olup olmadığı doğrulanır.
Deney 7-5 ★★: Tam Otomatik Bir TTS Kalite Değerlendirme Boru Hattı Kurmak
Bu deney, eksiksiz bir çok modlu LLM-as-a-Judge TTS kalite değerlendirme sistemini sıfırdan tasarlayıp uygulamanızı ister.
Çok boyutlu bir TTS Rubric’i tasarlayın: doğruluk boyutu bütün metnin doğru okunup okunmadığını doğrular (atlama/yanlış okuma/ekleme yok); doğallık boyutu konuşmanın akıcı olup olmadığını değerlendirir (makine hissi ve doğal olmayan duraklamalar var mı, ezgi insan alışkanlıklarına uyuyor mu); duygu ifadesi boyutu tonun metnin duygusal rengine uyup uymadığını denetler (soru cümlelerinde tonun yükselmesi, ünlem cümlelerinde vurgu, hüzünlü içerikte yavaş tempo ve alçak ton); ses tınısı tutarlılığı boyutu ise elde referans bir kayıt varsa konuşmacı benzerliğini değerlendirir (çok modlu model, karşılaştırma için referans kaydı ve sentezlenen kaydı aynı anda alır).
Çeşitlilik içeren bir test derlemi oluşturun: farklı uzunluklar (tek cümle → uzun paragraf), türler (haber/öykü/diyalog), duygular (nötr/heyecanlı/hüzünlü) ve özel zorluklar (sayılar/özel adlar/çok sesletimli karakterler/ağız sözcükleri). TTS üretim modülünü yaygın servislere bağlayın (OpenAI, ElevenLabs, Fish Audio, Minimax, Doubao); sentezlenen kaydı, özgün metni, referans kaydı ve Rubric’i sesi doğrudan kabul edebilen çok modlu bir hakeme verin. Her puanın denetlenebilmesi için hakem modeliyle birlikte aday ve referans kayıtların hash’lerini de saklayın.
Eşlik eden depoda küçük bir doğrudan dinleme çalışması saklanıyor. OpenAI ve Fish Audio; sayı, çok sesletimli Çince karakter, uzun metin ve heyecanlı anlatım içeren dörder kayıt üretti; Voxtral sekiz kaydın tamamını dört boyutta değerlendirdi. İki sistem de doğrulukta 5.00, doğallıkta 4.00 ortalama aldı. Fish Audio duygu ve ses tutarlılığında 4.00/3.00, OpenAI ise 3.75/2.75 aldı. Rubric’i boyutlara ayırmak, basit bir “doğru okudu mu?” kontrolünün göremediği farkları ortaya çıkardı.
Bu puanlar bir sağlayıcı kazananı belirlemez. Her sağlayıcıdan yalnızca dört kayıt vardı; daha önemlisi, sabit referans kaydı Fish S1’den geldiği için ses benzerliği boyutu doğası gereği Fish Audio’yu kayırıyordu. Genel TTS karşılaştırmasında bu boyut kaldırılmalı ya da her adaya uygun bir hedef konuşmacı verilmelidir. Ses klonlama karşılaştırmasında ise bütün sistemler aynı konuşmacıyı taklit etmeli ve model hakemi kör insan dinleme sonuçlarıyla kalibre edilmelidir. Referans yanıtı, görseli veya sesi seçmek değerlendirme tasarımının parçasıdır; tarafsız bir hazırlık işi değildir.
Elle yazılmış Rubric’ler bu tür teşhis boyutlarını hızla kurmayı sağlar. Ölçek büyüdüğünde değerlendirmeyi otomatikleştirmek için özel üretken ödül modelleri eğitilebilir; eğitim yöntemi Bölüm 8’de ele alınacaktır.
Yargılayıcı modelin verdiği puan yalnızca sonucun iyi mi kötü mü olduğunu söyler; sonucu onarılabilir bir soruna dönüştürmek için başarısızlığın tam olarak hangi adımda başladığını da saptamak gerekir.
Hata atfı: Trajectory’deki ilk hatanın yerini belirleme
Uçtan uca değerlendirme çoğu zaman yalnızca “başarılı/başarısız” der. Sonucu düzeltmeye dönüştürmek için her başarısız trajectory’de kategori, kabul edilemez davranışın ilk adımı, ilgili araç çağrısı veya model çıktısı ve denetlenebilir kanıt kaydedilmelidir. Bad case’ler kullanıcı düzeltmesi, olumsuz geri bildirim veya sonradan yapılan durum/kural kontrolünden gelebilir. LLM yardımcı olur, ancak kök neden genellikle ürün sorunu da olabileceğinden insan analizi gereklidir.
Coding Agent için başlangıç sınıfları süreç/depo kuralı eksikliği, araç/biçim hatası, anormal sonlanma ve tamamlama/mantık hatasıdır. Adım numarası, araç, gözlem, kök neden ve sonuç, kurtarılabilirlik ve güveni JSON/YAML olarak; ortam durumu, sürümler ve tam trajectory ile birlikte saklayın.
Bir hata atfı sistemi kurmak, geliştiricinin üretimdeki sorunlu yörüngeleri sabırla okumasını ve çözümlemesini gerektirir. LLM bu işte yardımcı olur ama insanın yerini alamaz; çünkü hata atfı çoğu zaman yalnızca teknik değil, ürün sorunlarını da açığa çıkarır.
Ürün olgunlaştıkça hata sınıflandırması birkaç ana sınıfa, her birinin altında alt sınıflara ayrılır ve sonunda yüzlerce kaleme ulaşabilir. Bu sınıflar ve atıf yöntemleri, sonrasında bir atıf etiketleme Agent’ının prompt’u ya da Skill’i hâline gelir.
Coding Agent örneğinde işe yarar bir başlangıç sınıflandırması şöyledir.
Hata sınıfı
Tipik belirti
İlk hata nasıl bulunur
Gereksinim anlama ve belirsizlik
Ortaya çıkan şey kullanıcının istediği değildir: gereksinimdeki bir koşul atlanır, kapsam fazla geniş ya da fazla dar okunur; depoda aynı adı taşıyan iki yapılandırma dosyası varken biri açıklama da soru da olmadan seçilir
Özgün gereksinimi, Agent’ın gerçekte yaptığıyla (eylem dizisiyle) bir LLM aracılığıyla madde madde karşılaştırın; önce sonuç düzeyindeki ilk sapmayı bulun, sonra onu doğuran araç çağrısına ya da yanıta geri gidin
Süreç veya kural eksikliği
Birim testleri çalıştırmadan commit atmak; Plan yazmadan koda dokunmak; depoda dahili eşdeğeri varken dış bağımlılık getirmek; yerleşik mimari kuralı atlamak
Geliştirme süreci kuralını çiğneyen ilk eylemi bulun — ilk git commit, ilk dosya yazımı — ve öncesinde kuralın kaynağını okuyup okumadığına bakın
Araç çağrısı hataları
Aynı dosyadaki düzenlemenin defalarca başarısız olması; bozuk JSON/schema ya da argüman biçimi; özel karakterlerin aktarmayı, kaçışı veya yazmayı bozması
İlk başarısız düzenlemeyi/aracı, özgün istek ve dönen hatayla birlikte kaydedin; tekrarlayan başarısızlıklar sonraki belirtilerdir
Doğrulama ortamını hacklemek
Bir assertion’ı düzenlemek, skip eklemek, test edilen mantığı mock’lamak; hiç çalıştırılmamış bir test için “testler geçti” demek
Testi ya da doğrulama mantığını ilk değiştiren message’ı alın; ardından tamamlandı bildirimini yörüngede gerçekten çalıştırılmış komutlarla karşılaştırıp gerçekten koşup koşmadığını doğrulayın
Eksik değişiklik
İşlev imzası değişti, üç çağrı noktası güncellendi, ama dördüncüsü — bir dinamik çağrı, başka bir dildeki binding ya da bir schema — atlandı
Agent’ın iddia ettiği etki alanıyla gerçek etki alanının farkını alın, ilk atlamayı seçin ve aramada hangi anahtar sözcükleri kullandığına bakın
Kullanıcıya yanlış bilgi bildirmek
Araç çağrıları ve son durum tümüyle doğruyken kullanıcıya söylenen yanlıştır: tutar, durum veya saat yanlıştır; kısmen bitmiş iş tamamen bitmiş gibi anlatılır; bildirilmesi zorunlu bir husus atlanır
Yanıttaki her olgusal iddiayı araç dönüş değerleriyle tek tek hizalayın ve izi sürülemeyen ya da dönüşle çelişen ilk iddiayı alın
İşlevsel olmayan gerileme
Genel bir API ya da schema migration betiği olmadan değişir; bir kontrol geçsin diye doğrulama silinir
Değişikliği yapan ilk message’ı alın ve genel bir arayüze ya da migration gerektiren bir yapıya dokunduğunun farkında olup olmadığına bakın
Modelin anormal sonlanması
Çıktının ortada kesilmesi, sebepsiz durması, zaman aşımına uğraması ya da kapanış eylemi yapılmadan bitmesi
İlk anormal sonlanmayı bulun ve model durması, Harness zaman aşımı ile araç servisi arızasını birbirinden ayırın
Görevi çok erken bırakmak
Çok hedefli görevin yalnızca bir kısmı biter; makul seçenekler tüketilmeden bir şeyin imkânsız olduğu ilan edilir
Bir hedefi düşüren ya da aramayı bırakan ilk kararı bulun ve bunu son doğrulama başarısızlığından ayrı kaydedin
Atıf etiketleme Agent’ı, çok sayıda üretim yörüngesi üzerinde kök neden analizini LLM ile ölçekli biçimde yürütebilir, ancak tek cümlelik bir “başarısızlık nedeni” üretmekle yetinemez. Atıf kaydı yapılandırılmış olmalıdır: JSON ya da YAML biçiminde, somut adım numaralarına, araç adlarına ve gözlenen kanıtlara atıfla; ayrıca kök nedenle sonucu ayırmalı, kurtarılabilirliği değerlendirmeli ve bir güven düzeyi vermelidir. Örneğin edit_file bir old_string uyuşmazlığı döndürüyor ve Agent ardından üç kez yeniden deneyip dosyayı yine yazamıyorsa, asıl neden dosya düzenleme ve araç çağrısı hatasıdır; üç deneme sonuçtur, üç bağımsız kök neden değil. Birden çok sınıf aynı anda göründüğünde asıl nedeni “en erken olan ve sonraki başarısızlıkları açıklayan” ölçütüyle seçin, kalanları ikincil olarak saklayın. Yukarıdaki tablodaki en az üç sınıf, ilk hatayı LLM’e buldurmadan önce kurallarla ön elemeye tabi tutulabilir: tamamlandı bildiriminin gerçekten çalıştırılmış komutlarla karşılaştırılması; diff’in test assertion’larına ve skip işaretlerine dokunup dokunmadığı; diff’in migration dosyası olmadan genel bir API’yi ya da schema’yı değiştirip değiştirmediği. Önce kuralla elemek, sonra LLM’e yer buldurmak, bütün yörüngeleri LLM’e yığmaktan hem ucuz hem isabetlidir.
Atıf kaydını saklarken yalnızca LLM’in çıktısı yetmez: görev hedefini, ortam durumunu, Agent sürümünü, araç seti sürümünü ve tam Agent yörüngesini de birlikte saklayın ki vaka bir regresyon testine dönüştürülebilsin.
Aşağıda üç tipik hata sınıfı örnek alınarak ayrıntılandırılıyor.
“Doğru yaptı, yanlış bildirdi” sorunu
“Doğru yaptı, yanlış bildirdi” genel başarı oranının en kolay sakladığı sınıftır, çünkü çoğu değerlendirme yalnızca ortam durumunu denetler. τ²-bench bunu ayrı puanlar: yayımlanan temel koşulardan görevi bir bilgilendirme gereksinimi taşıyan 704 koşuda 240 başarısızlık yaşandı; bunların 162’si bilgilendirme kontrolünden kaldı ve 80’i — tüm başarısızlıkların üçte biri — ortam durumu doğruyken bildirimi yanlıştı.
Eşlik eden depoda buna karşılık gelen bir vaka var. expenses.jpg içindeki harcamaları bir muhasebe uygulamasına girme görevinde Agent, izin verme, arama, görseli açma, her satırı doldurma ve kaydetme işlerini 32 adımda yaptı; hiçbir adım hata döndürmedi ve sonunda görevi tamamlandı ilan etti. Oysa doğrulayıcı, yazılması gereken satırın — Dress, ¥436,35 — bulunmadığını bildirdi; bu satırın girilen dördüyle hiçbir ilgisi yok. 8. adımda kendi akıl yürütmesi şöyle diyor: “I cannot actually see the content/details of the expenses in the image”. Veriyi alamadığını kendisi biliyordu, ne durdu ne bildirdi; 11. adımda notlarına uydurma dört harcama girdi ve sonraki her girdi bu uydurma veriyi sadakatle uyguladı. İlk hata 8. adımdır ve o adım ne hata verdi ne de bir araç çağrısıydı. Kök nedeni de kolayca yanlış dosyalanır: T3A, gözlem uzayında yalnızca öğe ağacı bulunan, görüntü pikseli hiç olmayan salt metin bir Agent’tır; dolayısıyla neden “model OCR yapamıyor” değil, eksik bir gözlem kanalı ve “bilgi elde edilemiyor” diyebilecek meşru bir çıkış eyleminin yokluğudur. Bunu model yeteneği sorunu diye kaydederseniz sıradaki hamle model değiştirmek veya OCR eğitmek olur; gerçek çözüm kanalı ve çıkışı eklemektir.
Deney 7-6 ★★: AndroidWorld yörüngelerinde hata atfı
Bu deney, bu bölümdeki atıf yöntemini gerçek yörüngeler üzerinde çalıştırır; emülatör de model API’si de gerekmez. Malzeme chapter7/android-world içinde saklanan T3A çalıştırmasıdır: t3a.md tüm görevlerin adım adım Action/Reason/Summary kayıtlarını, t3a_failed.md ise sonunda doğrulayıcının nesnel kararını taşıyan elliden fazla başarısız yörüngeyi içerir.
Adım 1: Örnekleme. t3a_failed.md içinden hiçbir araç hatası içermeyen en az on sessiz başarısızlık seçin. Hiçbir araç çağrısı hata döndürmemiş olmalı, Agent ya tamamlandı demeli ya da adım sınırını tüketmeli, ve başarısızlığı yalnızca kapanıştaki doğrulayıcı kararı işaretlemelidir.
Adım 2: İlk hatayı bulun. Her yörünge için ilk hatanın adım numarasını kaydedin ve bu adımın bir araç çağrısı mı yoksa bir assistant message mı olduğunu belirtin. Sessiz başarısızlıklar iki teknik ister: olgu çıpası karşılaştırması, Agent’ın ifadelerini araç dönüş değerleriyle karşılaştırıp ilk sapmayı alır; yörünge öneki ikili araması, yörüngeyi k adımında kesip devreder — hâlâ kurtarılabiliyorsa hata k’den sonradır. Hata anahtar sözcüğü aramak ikisinin de yerine geçmez.
Adım 3: Yapılandırılmış kayıt yazın. Her yörünge için görev adı, ilk hata adımı, hata kategorisi, kök neden sorumlusu ve destekleyici alıntıları içeren, ana nedeni sonuçtan ayıran bir JSON ya da YAML kaydı üretin.
Adım 4: Mevcut notlarla karşılaştırın. Sonuçlarınızı t3a_failed_analysis.md ile madde madde karşılaştırın ve her uyuşmazlığı kaydedin. Kök neden atfına özellikle dikkat edin: bu notlar görüntü çevirimi başarısızlığını “görme modelinde OCR yok” diye kaydetmişti, oysa T3A’nın gözlem uzayında hiç görüntü pikseli yoktur; gerçek kök neden eksik bir gözlem kanalıdır. Hazır bir atıf notu cevap anahtarı değildir.
Adım 5: Regresyon görevine dönüştürün. İlk hatası bir assistant message olan üç yörünge seçin, öneki tam o hatadan önce kesin ve kabul edilebilir eylem kümesiyle yasak eylemleri yazarak yörünge öneki regresyon görevleri oluşturun.
Kapsama duyarlı belge biçimi hataları
Kullanıcı “tırnak biçimi yanlış” dediğinde bunu genel bir karakter değiştirmeye dönüştüremezsiniz. En azından ASCII düz tırnakları (", '), Çince kıvrık tırnakları (“”, ‘’) ve Markdown ters tırnaklarını (`) ayırmak gerekir. Aynı karakter; Çince düzyazıda, alıntılanan İngilizce kaynakta, satır içi kodda, kod bloklarında, kod yorumlarında, JSON’da ve yollarda farklı bir sözdizimsel rol üstlenir.
Değerlendirme verisi önce belgeyi kapsamlı parçalara ayrıştırmalıdır: örneğin ZH_PROSE, EN_PROSE, QUOTED_SOURCE, INLINE_CODE, CODE_BLOCK, CODE_COMMENT ve JSON_OR_SCHEMA. Her parça, izin verilen dönüşüm kümesini, korunması zorunlu karakterleri ve düzenleme sonrası doğrulayıcı sonucunu saklar. Aşağıdaki üç durum tek bir değiştirme kuralıyla ele alınamaz:
Çince düzyazı: `reset()` metodunu çağır.Alıntılanan İngilizce kaynak: “Please restart the service.”# aşağıdaki kod bloğu yalnızca korunan bir kapsamı göstermek içindir# Çince yorum: "geçerli durum" göstername = "status"
Trajectory-prefix regresyonu modelden en küçük düzenlemeyi istemeli; aynı anda Çince belge üslubunu, alıntılanan İngilizce kaynağın korunma oranını, kod ve JSON sözdizimini ve hedef dışı metindeki düzenleme mesafesini denetlemelidir. Kurallar kapsamı belirleyemediğinde, özgün metni koruyup açıklama istemek izin verilen bir eylem sayılmalı; tahmine dayalı bir düzenlemenin tesadüfen geçmesi kabul edilmemelidir.
Bir old_string hatası da yalnızca “model yanlış kopyaladı” diye atfedilemez. Aynı dize için ham byte özetini, Unicode code point dizisini ve tokenizer token ID dizisini saklayın; ardından ilk farkı şu zincir boyunca arayın:
original file bytes → tool return → Harness serialization → model context→ model token output → decoded string → JSON/tool-call parsing → tool matching
Asgari değerlendirme probları; doğrudan yineleme, uzun bağlamdan çıkarma, tool argümanına yerleştirme, benzer dizeler arasından seçim ile boşluk, satır sonu, ters bölü, Unicode birleştirici karakterler ve düşük frekanslı token’ları kapsar. Metrikler byte-exact match, code-point-exact match, token-exact match, ilk farkın konumu ve gerçek tool başarı oranıdır. Model doğrudan probda doğruyken tool çağrısı yine de başarısız oluyorsa tokenizer’ı, serileştirmeyi, Harness’ı veya tool protokolünü düzeltin; ilk fark yalnızca modelin kendi çıktısında belirdiğinde bu vaka 7. Bölüm’ün kopyalama eğitim verisine dönüştürülmelidir.
Uçtan uca regresyon görevleri ve trajectory-prefix regresyon görevleri
Hata atfı ilk hatayı ve sınıfını belirledikten sonra sıra, düzeltme hedefini yeniden çalıştırılabilir bir test durumuna, yani regresyon görevine (regression task) dökmeye gelir. Burada birbirini tamamlayan iki katman gerekir: uçtan uca regresyon görevleri değişikliğin bütün iş akışını bozmadığını doğrular; yörünge öneki (trajectory prefix) regresyon görevleri ise ilk hatadan hemen önceki durumu kesip yalnızca o karar sınırının düzelip düzelmediğini sınar.
Uçtan uca regresyon görevleri başlangıç durumundan ve kullanıcı isteğinden yola çıkar, Agent’ın görevin tamamını bitirmesini sağlar, ardından son durumu, gerekli çıktıyı ve güvenlik koşullarını denetler. Üretim sonucuna en yakın olan bunlardır, ama hatanın hangi adımda oluştuğunu anlamayı zorlaştırırlar. Genel olarak uçtan uca görevler, Agent’ın her alandaki yeteneğinin beklentiyi karşılayıp karşılamadığını doğrulamak için kullanılır. Bu bölümde anılan standart değerlendirme setleri — OSWorld, AndroidWorld, tau-bench — hepsi uçtan uca regresyon görevidir.
Yörünge öneki regresyon görevleri var olan bağlamı, diyaloğu, araç dönüşlerini ve ortam durumunu dondurur; Agent’tan yalnızca bir sonraki ya da birkaç gözlemlenebilir eylemi düşünüp yapmasını ister. Maliyeti düşüktür ve tek bir politika ya da araç sorununu yalıtabilir. Yüksek güvenilirlik gerektiren üretim düzeyi bir Agent için önek görev setini kurmak çoğu zaman uçtan uca setten daha önemlidir ve bir önceki bölümde anlatılan hata sınıflandırmasıyla atıf sistemini sabırla kurmayı gerektirir.
Önek görevinin yanıtı tek bir eylem ya da tek bir cevap olarak değil, kabul edilebilir eylemler kümesi olarak tanımlanmalıdır: “önce depo kurallarını oku”, “önce kullanıcıya sor” ya da “tehlikeli işlemi reddet” istenebilir; yasak eylemler de aynı anda sıralanır.
Hata atfı bittiğinde, hem uçtan uca hem yörünge öneki regresyon görevlerini kapsayan bir değerlendirme veri kümesi kurulabilir. Coding Agent örneğinde: süreç eksikliği, plan belgesi ve test kabul koşulları taşıyan uçtan uca bir regresyon görevi üretmelidir; araç çağrısı hatası, hatalı öneğin kesilip sınır göreve dönüştürülmesiyle modelin biçimi düzeltip düzeltemediğini, özel karakterleri kaçırıp kaçıramadığını ya da uygun araca geçip geçemediğini sınamalıdır; anormal sonlanma, kesilme, zaman aşımı ve araç arızasından kurtulma senaryoları eklemelidir; tamamlanma ve mantık hataları, çok hedefli kontrol listeleri, kalan iş hatırlatmaları ve “henüz imkânsız olduğu kanıtlanmadı” sınırını eklemelidir; gereksinim anlama ve belirsizlik sınıfı, birden çok makul okuması olan görevleri önek olarak dondurup “önce netleştir”i kabul edilebilir eylemler kümesine koymalıdır; belirti yamama ve doğrulama sahteciliği sınıfı, kabul koşullarına iki sert kısıt eklemelidir: “test assertion’ları değiştirilemez” ve “tamamlandı bildirimi gerçekten çalıştırılmış bir komutun çıktısını taşımalıdır”; bilgi bildirme sınıfı ise yalnızca ortam durumunu değil, yanıtın içeriğinin kendisini de assertion’a bağlamalıdır.
Değerlendirme veri kümesi, 8. bölümdeki post-training’in ve 9. bölümdeki Agent öz-evriminin temelidir.
Deney 7-7 ★★: Birden çok gösterimle trajectory-prefix sınır değerlendirmesi
Modele bilinen kullanıcı belleği, güncel talimat, trajectory prefix, araç dönüşleri ve ortam durumu verilir; yalnızca sonraki gözlemlenebilir eylem istenir. 11 vaka JSON Cards, Markdown ve Python-like biçimlerinde kodlanıp deterministik kurallarla denetlendi. 33/33 hücre API hatasız tamamlandı ve her gösterim 6/11 geçti; gösterimi değiştirmek tek başına kullanım politikasını düzeltmez.
Gerçek model seçimlerinde sık karşılaştığımız soru şudur: “A mı daha iyi, B mi?” İkili karşılaştırma, mutlak puanlara dayanmayan bir değerlendirme yolu sunar.
İkili Karşılaştırma ve Model Sıralaması
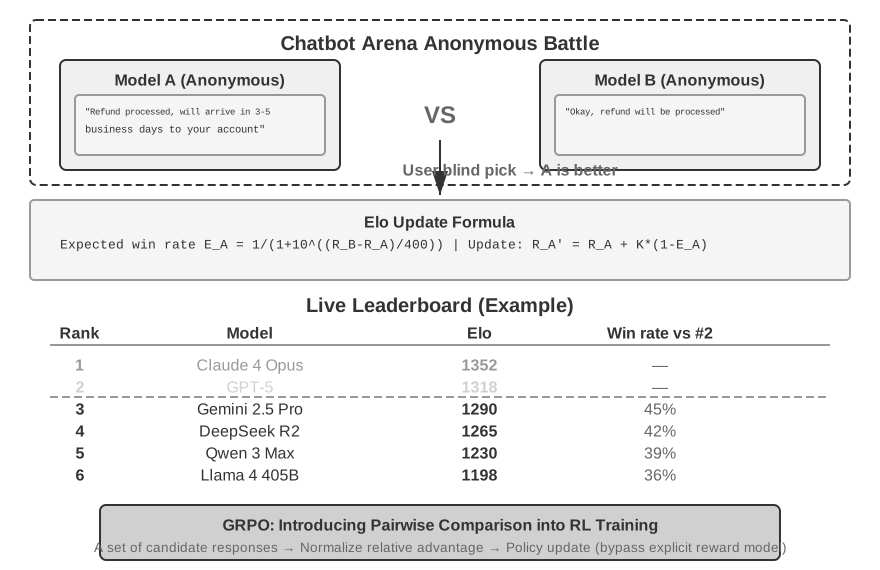
Şekil 7-6: Elo Puanlaması ve İkili Karşılaştırmayla Sıralama · Kaynak şekil
Elo puanlaması (aslen satranç için tasarlanmış bir sıralama sistemi), çok sayıda ikili karşılaşma üzerinden modellerin göreli yeteneğini niceler: puan farkı ne kadar büyükse, güçlü olanın beklenen kazanma oranı o kadar yüksektir. Örneğin model A’nın puanı 1.200, model B’nin puanı 1.000 ise Elo sistemi A’nın kazanma oranını yaklaşık %76 olarak öngörür. B beklenmedik biçimde kazanırsa B daha çok puan kazanır, A daha çok puan kaybeder — sürpriz sonuçlar daha büyük bir düzeltme getirir ve bu mekanizma sıralamanın gerçek seviyeye hızla yakınsamasını sağlar. Arkasındaki istatistiksel temel Bradley-Terry modelidir: her model gizli bir “güç puanı” olarak soyutlanır ve ikili karşılaşmanın kazanma olasılığı iki puan arasındaki farkla belirlenir; Elo ise bu modelin çevrimiçi güncelleme biçimindeki mühendislik uygulamasıdır.
Chatbot Arena anonim rastgele karşılaşmalar kullanır — kullanıcılar modelin kimliğini bilmeden daha iyi yanıtı körlemesine seçer ve sıralama milyonlarca oydan çıkarılır. Bu yöntemin üstünlüğü “mutlak bir ölçüt” tanımlamayı gerektirmemesidir; yalnızca insanın “A mı daha iyi, B mi?” yargısına ihtiyaç duyar. Ama bir sınırı da vardır: sıralama sonucu kullanıcıların ne sorduğuna bağlıdır — çok sayıda kullanıcı denk gelip programlama sorusu sorarsa, programlamada güçlü modeller sıralamada yükselir; bu da onların diğer görevlerdeki gerçek seviyesini yansıtmayabilir.
İkili yargılama insan oyu yerine bir LLM tarafından yapıldığında ayrıca konum yanlılığına (Position Bias) karşı önlem almak gerekir — yargıç model, belirli bir konumda (genellikle önce) görünen adayı sistematik biçimde kayırır ve iki adayın içeriği tamamen yer değiştirse bile karar değişmeyebilir. Standart azaltma yöntemi sırayı değiştirerek iki kez değerlendirmektir: bir kez A önde, bir kez B önde değerlendirilir ve iki sonucun ortalaması alınır; daha katı bir yaklaşım ise yalnızca iki kararın uyuştuğu durumları saymak, uyuşmayanları beraberlik olarak kaydetmek veya insan incelemesine göndermektir. Chatbot Arena’nın yaptığı da özünde aynıdır — iki yanıtın gösterim konumu rastgeleleştirilir, böylece konum yanlılığı büyük örneklemde birbirini götürür.
Deney 7-8 ★★: İkili Karşılaştırma Verisinden Model Sıralaması Oluşturmak
Bu deney, sıfırdan bir Elo rating hesaplama sistemi kurarak Bradley-Terry modelinin çok sayıda ikili karşılaştırmadan göreli yetenek puanlarını nasıl çıkardığını derinlemesine anlamayı amaçlar. Chatbot Arena’nın açık kaynak gerçek oy veri kümesi kullanılır (milyonlarca kullanıcı kör oyu içerir).
Elo rating yinelemeli güncelleme algoritmasını uygulayın: başlangıçta tüm modellerin puanı 1.000 olsun, oy kayıtları zaman sırasına göre işlensin. Her karşılaşmada, iki modelin mevcut puan farkına göre beklenen kazanma oranı hesaplanır, gerçek sonuç beklentiyle karşılaştırılır ve sabit bir öğrenme hızıyla ayarlanır — kazanan puan alır, kaybeden puan verir; ayarlamanın büyüklüğü beklentiden sapmayla orantılıdır (sürpriz bir yenilgi daha büyük bir puan değişimine yol açar). Nihai puana göre azalan sırada sıralayın ve ikili kazanma oranı matrisini hesaplayın; resmî sıralamayla karşılaştırıp sıralamanın kabaca tutarlı olduğunu doğrulamak yeterlidir. Puan puan örtüşme aramayın: Chatbot Arena resmî olarak Bradley-Terry en büyük olabilirlik uyarlaması kullanır (tüm karşılaşmalar için tek seferde çözüm üretir, oyların sırasından bağımsızdır); burada uygulanan ise çevrimiçi artımlı güncellemeli Elo’dur (sonuç, öğrenme hızı K faktöründen ve işleme sırasından etkilenir). İki algoritmanın genel sıralamada örtüşmesi beklenir, ama tek tek puanlar tam olarak aynı olmayacaktır.
Deneyin ikinci kısmında tarihsel sıralama evrimi animasyonu oluşturun: oy verisini zamana göre dilimleyin (haftalık veya aylık) ve her zaman noktası için bir Elo puanı anlık görüntüsü hesaplayın. D3.js ile çubuk grafik yarışı animasyonu uygulayın (yatay çubuk uzunluğu = puan, dikey konum = sıra; zamanla yumuşak biçimde değişir). Animasyonu izleyerek teknolojik atılım anlarını (bir modelin puanının aniden fırlaması), rekabet ortamının evrimini ve model yaşam döngülerini tespit edin.
Değerlendirme Güdümlü Model Seçimi
Model seçimi basitçe “en güçlü modeli seçmek” değildir; uygulama senaryosuna göre birden çok boyut arasında değerlendirme güdümlü bir denge kurmaktır.
Seçimin Kilit Boyutları
Throughput (verim) ile gecikme, birbirine karıştırılması kolay iki metrik ailesidir; ayrımı görmek için büyük model çıkarımının iki aşamada yürüdüğünü bilmek yeterlidir. Prefill (ön doldurma) tüm context’i tek seferde okur ve kullanıcının Enter’a basmasıyla ilk karakterin görünmesi arasındaki ilk yanıt gecikmesini belirler (sektörde TTFT, Time To First Token — İlk Token’a Kadar Geçen Süre — ile ölçülür): context uzadıkça prefill yavaşlar, TTFT büyür. Decode (kod çözme) ardından yanıtı token token üretir ve sonraki karakterlerin çıkış hızını (token/saniye) belirler; bu da doğrudan düşünme süresini belirler: saniyede 50 token üreten bir model 2.000 düşünme token’ı ürettiğinde yalnızca düşünmek için 40 saniye harcar.
Bu iki aşamanın etrafında şekillenen başlıca throughput ve gecikme metrikleri şunlardır:
Girdi throughput’u / çıktı throughput’u: sırasıyla Prefill ve Decode hızına karşılık gelir.
Düşünme gecikmesi: modellerin ürettiği düşünme token’ı sayısı arasında kat kat fark olabilir ve düşünme uzunluğu görev başarısıyla mutlaka doğru orantılı değildir — her modelin düşünme token’ı kullanımını ve karşılığında sağladığı faydayı yalnızca genel sıralamalara bakarak çıkarsamak yerine kendi iş yükünüzde ölçün.
p95 kuyruk gecikmesi: isteklerin %95’inin aşmayacağı gecikme. Gerçek kullanıcı deneyimini ortalamadan daha iyi yansıtır; ortalama, çok sayıda hızlı istekle aşağı çekilerek azınlıktaki kullanıcıların yaşadığı ciddi takılmaları gizler.
Maliyet: girdi/çıktı/önbellek token’larının fiyatlandırması. Maliyet tek başına değerlendirilmemelidir — ucuz ama başarı oranı düşük bir model, sık sık yeniden denemek gerektiği için gerçekte daha pahalıya gelebilir. Görev başına ortalama maliyeti ve maliyet-performans oranını hesaplamak gerekir.
Performans: Pass@1, Pass^k, Pass@k ve Best@k metriklerinin kesin tanımları önceki “Değerlendirme Metrikleri Sistemi” bölümünde verildi; burada yalnızca model seçimi bağlamında nasıl tercih yapılacağına değiniyoruz. Gündelik senaryolarda en çok kullanılan Pass@1’e (tek denemedeki ortalama başarı oranı) bakılır; kritik işlem senaryolarında Pass^k öne çıkar, çünkü orada “hiçbir seferinde hata yapmama” kararlılığı izlenir; keşif ağırlıklı görevlerde Pass@k veya Best@k tercih edilir, çünkü yeterli fırsat verildiğinde ulaşılan yetenek tavanı ölçülür; açık uçlu görevlerde ise çok boyutlu Rubric puanlaması kullanılır.
Hız limitleri ve güvenilirlik: RPM (dakika başına istek) / TPM (dakika başına token) limitleri eşzamanlılık kapasitesini etkiler; bazı API’ler yoğun saatlerde kotayı dinamik olarak da değiştirir. Sağlamlık tarafında dağılım dışı veriye, düşmanca girdilere ve uzun süreli çalışma kararlılığına (mod çökmesi, dikkat dağılması gibi sorunların çıkıp çıkmadığına) dikkat edilmelidir.
Bütçe—yetenek eğrileri: sabit bir bütçedeki tek bir puan, bir Agent’ın uzun soluklu işlerin altından kalkıp kalkamayacağına karar vermeye yetmez. Başarı oranının yanı sıra performansın duvar saati süresine, token’a, araç çağrısı sayısına veya hesaplama bütçesine göre nasıl değiştiğini gösteren eğriler de raporlanmalıdır. RE-Bench’in insan-makine karşılaştırması sorunu somutlaştırır: her ortam için 2 saatlik toplam bütçede en iyi Agent, insan uzmanların yaklaşık 4 katı puan almıştır; ama insanlar ek zamandan daha çok kazanmış, 8 saatte en iyi Agent’ı kıl payı geçmiş ve birden çok denemeye yayılan toplam 32 saatte onun yaklaşık 2 katı puan toplamıştır1. Bu nedenle kısa bütçedeki üstünlük, doğrudan uzun süreli çalışma yeteneğine genellenemez; model seçiminde gerçek görev süresine yakın birkaç bütçe noktasında karşılaştırma yapmak zorunludur.
Pratikte çok modelli bir iş birliği stratejisi benimsenebilir: maliyeti düşürmek için basit istekleri hafif modellere, kaliteyi güvenceye almak için karmaşık görevleri güçlü modellere vermek; ya da belirli alt görevleri (görüntü anlama, kod üretimi gibi) özel modellere bırakıp alt Agent mekanizmasıyla iş birliği kurmak. Bu tür heterojen bileşimlerin toplam faydasının, eklediği sistem karmaşıklığını aşıp aşmadığı değerlendirmeyle doğrulanmalıdır (örneğin “9,9 mu büyük, 9,11 mi?” ya da “arabayı yıkatacağım, yıkamacı evden 50 metre uzakta—yürüsem mi arabayla mı gitsem?” gibi soruları basit sayıp hafif bir modele devretmek ve böylece yanlış karara varmak).
Model Davranışı: Okumayı Ne Zaman Bırakıp Düzenlemeye Başlamalı?
Model seçimi yalnızca bir modelin görevi tamamlayıp tamamlayamadığını değil, varsayılan olarak nasıl davrandığını da karşılaştırır. Coding Agent’larda kolayca gözlenen farklardan biri eylem eşiğidir. Aynı kodlama görevi verildiğinde bazı modeller depoyu genişçe keşfeder, mimariyi, çağrı noktalarını ve testleri doğruladıktan sonra düzenleme yapar. Bazıları ise daha az kanıtla değişiklik yerini belirler, erken düzenler ve test geri bildirimini anlayışını tamamlamak için kullanır. İlki erken düzenlemenin maliyetini, ikincisi bir dosya daha okumanın fırsat maliyetini daha yüksek görür.
Agent’ın bu eğiliminin iki kaynağı vardır: Harness’taki sistem promptu ve modelin davranış politikası. Sonrası eğitim, modelin davranış politikasının kilit kaynağıdır: SFT yörüngeleri “işe girişmeden önce ne kadar okunacağını” gösterir, süreç ödülü belirli bir araç güzergâhını ödüllendirir ya da cezalandırır, sonuç ödülü ise başarıyla biten stratejinin tamamını pekiştirir. Zamanla modelin öğrendiği yalnızca kod yazmak değil, mühendislik alışkanlıklarıdır da.
Deney 7-9 ★★: Sabit Bir Coding Harness İçinde Model Eylem Eşiklerini Ölçmek
Amaç: model etkenini yalıtmak, Coding modellerinin bilgi toplamaya devam etmekle düzenlemeye başlamak arasındaki varsayılan tercihini nicelleştirmek ve yol verimliliğini sonuç kalitesiyle birlikte değerlendirmek.
Yöntem: chapter6/model-action-threshold/experiment.py dosyasını çalıştırın. Varsayılan olarak GPT-5.6-sol ve Claude Sonnet 5 aynı OpenRouter OpenAI-compatible endpoint’i üzerinden çağrılır; sistem prompt’u, araç Schema’ları, görev depoları, test komutları ve tur sınırı sabit tutulur. Tarafsız prompt okunacak asgari dosya sayısını veya hızlı düzenleme zorunluluğunu belirtmez. Üç görev kategorisinin her birini en az üç kez tekrarlayın ve model sırasını dönüşümlü kullanın. İlk düzenlemeden önceki araç çağrılarını, okunan dosyaları, aramaları ve duvar saati süresini; ilk test edilen yamanın kabulünü, test sonrası yeniden çalışmayı, son başarıyı, değişen dosyaları ve Token kullanımını kaydedin.
Nedensel yorum: tarafsız kampanya aynı Harness içinde davranışın modelle birlikte değişip değişmediğini sorar. Harness’in düzenleyici etkisini ölçmek için --policy explore-first ile ayrı bir kampanya çalıştırın; iki policy’yi tek bir model karşılaştırmasında karıştırmayın. Model değişiminde farklılaşıp aynı model için Harness’ler arasında korunan davranış, model etkisine daha güçlü kanıttır; tersi Harness etkisini daha güçlü destekler.
Kabul ölçütleri: tüm çevrimdışı birim testleri geçer; her görev fixture’ının başlangıçta testleri başarısız kıldığı önce doğrulanır; resmi sonuç bütün model × görev × tekrar hücrelerini, sıfır API hatasını, bağımsız bir son testi ve denetlenebilir yörüngeleri içerir; manifest.json yapılandırma, gözlemler ve özetin hash’lerini doğrular. Proje dizininde 18/18 hücrelik tamamlanmış bir gerçek çalıştırma bulunur. Okurlar bu küçük depoların sayılarını kalıcı bir liderlik tablosu saymak yerine, önem verdikleri model sürümleri ve gerçek iş yükleri üzerinde deneyi yeniden çalıştırmalıdır.
Agent Sistemlerinin Maliyet Analizi
Bir önceki bölüm maliyeti model seçiminin kilit boyutlarından biri olarak saydı; ancak Agent senaryolarında maliyet, basit token fiyatlandırmasından çok daha karmaşıktır — çok turlu çıkarım, araç çağrıları ve context birikimi maliyeti doğrusal olmayan biçimde büyütür. Sistematik maliyet analizi, değerlendirme sisteminin vazgeçilmez bir parçası ve üretime alma için zorunlu bir ön koşuldur.
Maliyetin bileşenleri.
Bir Agent sisteminin maliyeti üç katmana ayrılabilir:
Model çıkarım maliyeti en doğrudan bileşendir ve girdi token’ları ile çıktı token’larının tüketimiyle belirlenir. Ne var ki Agent senaryolarında sıkça gözden kaçan iki büyütücü etken vardır. Birincisi context birikimi etkisidir: Agent, LLM’i her çağırdığı turda önceki tüm konuşma geçmişini ve araç sonuçlarını birlikte gönderir (model ancak böyle context’i anlayabilir). KV Cache iyi kullanılmazsa (yani daha önce işlenmiş context önbelleğe alınıp yeniden hesaplama önlenmezse) maliyet çok hızlı artar: 1. turda 1.000 token, 2. turda 2.000 token, 3. turda 3.000 token gönderilir; toplam 3×1.000=3.000 değil, 1.000+2.000+3.000=6.000 olur ve tur sayısı arttıkça fark açılır. İkincisi düşünme token’ı maliyetidir: düşünmeyi destekleyen modeller çok sayıda düşünme token’ı üretir; bu token’lar kullanıcıya gösterilmese de faturaya aynen yansır.
Araç çağırma maliyeti, dış API ücretlerini (arama motorları çağrı başına ücretlendirir, veritabanı sorguları hesaplama kaynağı tüketir), kod yürütmenin sandbox kaynaklarını ve kolayca gözden kaçan dolaylı bir kalemi kapsar: araç sonuçları context’e enjekte edildiğinde doğan token ücreti. Tek bir web aramasının döndürdüğü içerik 2.000-5.000 token yer kaplayabilir ve sonraki her çıkarım turunda girdi olarak tekrar tekrar faturalanır.
Altyapı maliyeti, vektör veritabanı (RAG retrieval için), mesaj kuyrukları, ilişkisel veritabanları, log ve trace depolaması (observability için) gibi işletme giderlerini kapsar.
Maliyetin nereden geldiğini görmek için eşlik eden deney sabit, sekiz turluk bir iade iş akışı kullandı: sipariş, kargo, iade politikası ve bilgi tabanı sorgulandı; ardından risk denetimi, iade, bildirim ve dosya kapatma tamamlandı. Gerçek gpt-4o-mini çağrıları iki anahtarın dört bileşiminde çalıştırıldı: kararlı/kararsız ön ek ve tam/sıkıştırılmış geçmiş. İş akışı her grupta aynıydı. Tablo 7-4, o çalışmada kaydedilen token sayıları ve fiyatları kullanıyor.
Tablo 7-4 Sekiz Turluk Agent İş Akışının Ölçülen Maliyeti
Yapılandırma
Girdi token
Önbellekteki token
Toplam maliyet
Temel çizgiye göre tasarruf
Önbellek yok, sıkıştırma yok
20,700
0
$0.003776
—
Yalnızca kararlı ön ek
20,386
13,568
$0.002707
28.3%
Yalnızca geçmiş sıkıştırma
16,177
0
$0.003115
17.5%
Kararlı ön ek + sıkıştırma
16,035
6,144
$0.002643
30.0%
Temel çizgide girdi ilk turdaki 1,113 token’dan son turdaki 3,668 token’a çıktı. Araç sonuçları sonraki isteklere tekrar tekrar taşındı ve çalışma boyunca 9,544 girdi token’ı oluşturdu. İki optimizasyon birlikte açıldığında bu sayı 5,248’e, toplam maliyet de 30% aşağı indi.
Kazançlar toplanabilir değildi. Kararlı ön ek tek başına 28.3%, sıkıştırma tek başına 17.5% tasarruf sağladı; birlikte 45.8% değil, 30% sağladılar. Geçmişi sıkıştırmak, önbellekten yeniden kullanılabilecek ön eki de kısalttı. Context optimizasyonlarını birleştirirken tüm iş akışını ölçün; tekil tasarruf oranlarını asla birbirine eklemeyin. Model, fiyat tarifesi veya görev uzunluğu değiştiğinde 30% da değişir. Genellenebilir bulgu yüzde değil, dört gruplu deney tasarımıdır.
Maliyet optimizasyonu stratejileri.
Girdi tarafında önce denenmesi gereken üç kaldıraç şunlardır: KV Cache yeniden kullanımı (ön eki kararlı tutmak), context sıkıştırma (eski trajectory’leri ve uzun araç sonuçlarını kısaltmak) ve katmanlı model yönlendirmesi (basit istekleri hafif, zor akıl yürütmeyi güçlü modellere vermek). Uygulama ayrıntıları Bölüm 2’de anlatıldı. İşletme açısından önemli olan, her kaldıracın ayrı bir anahtarının bulunmasıdır; böylece hem tek başına etkisi hem de diğerleriyle birlikte kullanıldığındaki etkileşim ölçülebilir. Değerlendirme ve işletmeyle doğrudan ilgili iki yöntem daha vardır.
Asenkron toplu işleme, gerçek zamanlı olmayan görevleri biriktirip toplu olarak işler ve API sağlayıcılarının toplu iş indirimlerinden yararlanır; kendi altyapınızda çalıştırıyorsanız düşük yoğunluklu saatlerde GPU kullanımını da artırır.
Maliyet izleme ve bütçe denetimi.
Üretim ortamında gerçek zamanlı bir maliyet izleme düzeni kurulmalıdır: token tüketimi ve API ücretleri görev türü, model, kullanıcı gibi boyutlara göre takip edilir. Aynı zamanda her görev için bir maliyet üst sınırı konmalıdır — Agent bir döngüye takıldığında veya fazla derine daldığında otomatik olarak sonlandırılır ve tek bir görevin anormal derecede yüksek ücret üretmesi engellenir.
Deney 7-10 ★: Agent Görevlerinin Uçtan Uca Maliyet Analizi
Deney amacı: Yukarıdaki sekiz turluk maliyet ayrıştırmasını yeniden üretmek, ardından aynı optimizasyon kaldıraçlarını kendi iş yükünüzde sınamak.
Teknik yaklaşım: Önce eşlik eden depodaki sabit görevi yeniden üretin, sonra kendi tipik görevlerinizden birkaçını seçin. LangSmith’i veya kendi trace sisteminizi kullanarak her LLM çağrısının girdi/çıktı ve düşünme token’larını, araç çağrısı sayısını ve sonuç boyutunu, ayrıca uçtan uca gecikmeyi kaydedin. Görev türü başına ortalama maliyeti, p50/p95/p99 değerlerini ve maliyet bileşimini hesaplayın.
Kabul ölçütü: Maliyet raporu üretip ana sürücüleri belirleyin. Dört anahtar bileşiminin tamamını çalıştırın; her optimizasyonu tek başına ve ikisini birlikte ölçün. Model değiştiğinde, saklanan trajectory’deki tasarruf oranını taşımak yerine deneyi yeniden çalıştırın.
Değerlendirme Güdümlü Sürekli Yineleme
Model seçimi tek seferlik bir karar değil, modeller evrildikçe dinamik olarak ayarlanması gereken sürekli bir süreçtir. Bölümün başında “bir değerlendirme sistemine sahip olmak, model evrimine hızla ayak uydurmayı sağlar” temel fikri ortaya konmuştu; şimdi somut bir model değiştirme vakasıyla bu sistemin gerçek bir kararda nasıl işlediğini gösterelim.
Diyelim ki Agent sisteminiz şu anda Claude üzerine kurulu ve tool calling ile karmaşık orkestrasyonda çok iyi çalışıyor. Bir gün Gemini yeni bir model yayımlıyor; kamuya açık benchmark’lar birçok metrikte Claude’u geçtiğini ve üstelik daha ucuz olduğunu gösteriyor. Bu noktada karşınızdaki soru “Gemini, Claude’dan güçlü mü?” değil, “benim özgül görevlerimde Gemini, Claude’dan iyi mi? Ne kadar iyi? Geçiş maliyeti nedir?” sorusudur.
Sağlam bir değerlendirme sistemine sahip bir ekip yanıtı birkaç saat içinde verebilir: yeni modeli kendi değerlendirme veri kümesinde çalıştırır; görev başarı oranını, tool calling doğruluğunu, gecikmeyi ve maliyeti karşılaştırır. Yeni modelin basit görevlerde gerçekten daha iyi ve daha ucuz olduğunu, ama karmaşık çok turlu araç orkestrasyonu içeren çekirdek senaryolarda başarı oranının %5 düştüğünü görebilirsiniz. Bu farkın gürültü bandını aştığını doğruladıktan sonra (aşağıdaki “Değerlendirme Sonuçlarının İstatistiksel Anlamlılığı” bölümüne bakın), kararınız körlemesine bir toptan geçiş değil, “maliyeti düşürmek için basit görevleri yeni modele taşı, kaliteyi güvenceye almak için karmaşık görevleri eski modelde tut” biçiminde farklılaştırılmış bir stratejiye dönüşür. Bu incelikte, veri güdümlü kararlar ancak önceden kurulmuş bir değerlendirme sistemiyle mümkündür.
Deney 7-11 ★★: Çok Boyutlu Model Performans Kıyaslaması
Yaygın LLM’ler ve farklı API sağlayıcıları üzerinde kapsamlı bir benchmark çalışması yaparak çok boyutlu bir model seçimi karar veritabanı oluşturun.
Test kapsamını seçin: GPT serisi, Claude serisi, Gemini serisi, Doubao serisi gibi kapalı kaynak SOTA modeller ve Qwen, Kimi, DeepSeek gibi açık kaynak modeller. Aynı modeli farklı API sağlayıcılarında (örneğin DeepSeek resmî API’si ile Siliconflow) test ederek üçüncü taraf performans izleme platformlarının (örneğin Artificial Analysis) sonuçlarını doğrulayın.
Standartlaştırılmış test iş yükleri tasarlayın: girdi throughput’u testi sabit uzunlukta context kullanır (8K/32K/128K token), çıktı throughput’u testi sabit uzunlukta yanıt üretimi ister (512/2048 token). Gecikme testi TTFT’yi (ilk token’ın üretilme süresi) ve uçtan uca gecikmeyi kapsar; düşünmeyi destekleyen modeller için düşünme uzunluğu ve düşünme gecikmesi ayrıca ölçülür. Her yapılandırma için en az 100 istek yapın ve standart sapma/p50/p95/p99 hesaplayın — yüksek gecikme varyansı, kullanıcı deneyiminin kararsız olduğu anlamına gelir.
API’nin erişilebilirliğini ve kararlılığını değerlendirin: bir hafta boyunca saatte bir yoklama yapın; başarı oranını, hata türlerini ve arıza sürelerini kaydedin. Arıza oranını, MTTR’yi (ortalama kurtarma süresi) ve en uzun kesintisiz erişilebilirlik süresini hesaplayın. Hız limitlerinin gerçek eşiklerini test edin — eşzamanlılığı kademeli olarak artırarak kısıtlama noktasını bulun ve RPM/TPM üst sınırlarını kaydedin. Bileşik maliyeti hesaplayın: fiyatlandırma bilgilerini toplayın (girdi/çıktı/önbellek token’larının birim fiyatları), KV Cache’in etkisini göz önüne alın ve tipik çok turlu Agent görevlerinin ortalama maliyetini hesaplayın.
Deney 7-12 ★★: Kullanıcı Bellek Sistemlerinin Uçtan Uca Seçim Değerlendirmesi
Ön koşul: Bölüm 3’teki bağlamsal retrieval veya agentic RAG deneyinin tamamlanmış olması gerekir.
Amaç: Bir kullanıcı belleği retrieval Agent’ı üzerinde baştan sona seçim değerlendirmesi yapmak; embedding modeli, reranker ve Agent’ın ana modeli olmak üzere üç seçim noktasının retrieval kalitesini, gecikmeyi ve maliyeti birlikte nasıl etkilediğini görmek. chapter3/contextual-retrieval-for-user-memory veya chapter3/agentic-rag-for-user-memory yeniden kullanılır ve 60 test durumu üzerinde karşılaştırma yapılır.
Kabul: Üç seçim noktasını sırayla tarayın — embedding modeli (BGE-M3 / OpenAI / Doubao vb.; top-5 retrieval doğruluğunu, gecikmeyi ve maliyeti kaydedin), reranker (“reranker kullanmama” temel çizgisi dahil; marjinal değerini nicelleştirin) ve ana model (aynı retrieval yapılandırmasında başarı oranını ve araç kullanım verimliliğini karşılaştırın). Asıl mesele bileşenler arasındaki etkileşimi okuyabilmektir: daha güçlü bir embedding reranker’i gereksiz kılabilir, daha güçlü bir ana model retrieval’daki eksikliği telafi edebilir — seçim, tek tek en güçlüyü almak değil, sistemsel bir dengedir. Yapılandırma ayrıntıları eşlik eden depodadır.
Değerlendirme kümesi sınırlıdır, modelin çıktısı da rastgeledir; dolayısıyla puan farkı sadece örnekleme gürültüsü olabilir. n vaka üzerinde p başarı oranı ölçtüyseniz, standart hata kabaca şöyle kestirilebilir:
SE(p)≈np(1−p)
Örneğin 100 vaka ve %70 başarı oranında %95 güven aralığı yaklaşık 70%±9 yüzde puandır; “yeni model %73’e karşı eski model %70” geçişi desteklemeye yetmez.
Aynı görev kümesinde iki yapılandırmayı karşılaştırırken önceliği eşleştirilmiş analize vermek gerekir: her soruda kimin kazandığını kaydedin ve farkı McNemar testiyle ya da eşleştirilmiş bootstrap ile yargılayın; iki bağımsız başarı oranını doğrudan çıkarmakla değil. Agent’ın her koşusu da farklılaşabildiğinden, her yapılandırmayı birkaç rastgele tohumla (örneğin 3–5 kez) çalıştırıp ortalamayı dalgalanma aralığıyla birlikte raporlamak en iyisidir; tek bir koşu yalnızca yön elemek için kullanılabilir. Beklenen kazanç sadece 2–3 puansa ve değerlendirme kümesinde birkaç düzine soru varsa, önce örneklemi büyütün; standart hata 1/n ile küçülür.
for task in paired_tasks: for seed in fixed_seeds: a = run(config_a, task, seed) b = run(config_b, task, seed) record_paired_delta(verifier(a), verifier(b))return paired_bootstrap_or_mcnemar(all_deltas)
Eşleştirme, iki grubun aynı görevleri ve aynı rastgele koşulları paylaşması demektir; iki ayrı örneklem alıp ortalamalarını karşılaştırmak değil.
Birden çok hipotezi paralel doğrularken çoklu karşılaştırmayı da hesaba katmak gerekir: anlamlılık eşiğini sıkılaştırın ya da olumlu sonuçları bağımsız olarak yeniden koşturun. Pratikteki ölçüt basittir: puan farkı gürültüyü aşmalı, eşleştirilmiş analizde de geçerli olmalı ve yeniden üretilebilmelidir; ancak o zaman model değiştirmeye veya değişikliği yayımlamaya değer.
Agent’ın Observability’si
Değerlendirme güdümlü kararlar (ister model seçimi ister sürekli yineleme olsun) yüksek kaliteli çalışma verisine dayanır. Aşağıda önce bu verinin sistematik olarak nasıl toplandığını (observability), ardından değerlendirme sonuçlarının sistem iyileştirmelerine nasıl dönüştürüleceğini ele alıyoruz.
Şekil 7-7: Observability Teknoloji Yığını · Kaynak şekil
Observability (gözlemlenebilirlik) kavramı dağıtık sistemler alanından ödünç alınmıştır: sistemin içini açıp ne yaptığını doğrudan göremezsiniz, yalnızca ürettiği loglardan, metriklerden ve trace verisinden ne olduğunu çıkarsayabilirsiniz — tıpkı hastanın içini doğrudan göremeyen bir hekimin ateş, tansiyon, görüntüleme gibi dışsal sinyallerden teşhis koyması gibi. Agent sistemleri bu işi daha da zorlaştırır: aynı girdi farklı çıktılar üretebilir, çok turlu çıkarım ve araç çağrıları yürütme yollarını son derece karmaşıklaştırır ve modelin “düşünme” süreci dışarıdan tamamen saydamsızdır.
Observability’nin değeri önce sorun teşhisindedir: eksiksiz trajectory’ler geliştiricinin tüm süreci tahmine dayanmadan yeniden oynatmasına imkân verir. İkinci olarak sürekli optimizasyonun temelidir — hangi görevlerin çok turlu yineleme gerektirdiğini, hangi araçların başarı oranının en düşük olduğunu, hangi retrieval sorgularının hep boş sonuç döndürdüğünü görebilirsiniz. Maliyet yönetiminde ise Agent’ın çalışma maliyeti görevden göreve bir iki büyüklük mertebesi değişebildiğinden, trace verisi anormal derecede pahalı vakaları ortaya çıkarır. Son olarak biriken trajectory verisi, sonraki sistem optimizasyonları ve model iyileştirmeleri için de zemin sağlar.
Agent observability’sinin veri temeli trace’tir (izleme kaydı) ve veri yapısı doğrudan dağıtık sistemlerin span ağacı modelinden gelir: bir görev yürütmesi bir trace’e karşılık gelir; içindeki her LLM çağrısı, her araç çağrısı ve her retrieval bir span’dir (girdi/çıktıyı, başlangıç-bitiş zamanını, token tüketimini ve hata bilgisini kaydeden yürütme birimi). Span’ler arasındaki ebeveyn-çocuk ilişkileri bir yürütme ağacı oluşturur — örneğin “Agent ana döngüsü” span’inin altında birkaç “LLM çağrısı” ve “araç çağrısı” alt span’i asılıdır. Bu katman için standartlaşmış protokoller hâlihazırda mevcuttur: OpenTelemetry genel amaçlı dağıtık trace standardıdır, OpenInference gibi belirtimler ise bunun üzerine LLM uygulamalarına özgü semantik kuralları tanımlar (prompt’ların, model parametrelerinin, token kullanımının vb. nasıl kaydedileceği). Standart protokol kullanmanın faydası toplama ile analizin birbirinden ayrılmasıdır — aynı trace verisi farklı analiz arka uçlarına bağlanabilir ve tek bir platforma kilitlenmekten kaçınılır.
LangSmith bu alanın temsilci platformlarından biridir (benzer konumdaki Langfuse, Arize Phoenix gibi platformlar da vardır) ve observability, değerlendirme ile optimizasyonu kapalı bir döngüde birleştirir. Her yürütme bir trace oturumu oluşturur; içindeki model çağrıları, araç kullanımları ve bilgi retrieval’ları bağımsız yürütme birimleri olarak kaydedilir ve nedensellik ilişkileriyle bağlanarak bir yürütme ağacı oluşturur. Her birim eksiksiz girdi/çıktıyı, zaman bilgisini, maliyet verisini ve hata bilgisini kaydeder. Platform asenkron toplu veri toplama kullanır, böylece trace’in kendisi Agent’ın yanıt gecikmesini etkilemez.
Platform ayrıca A/B testini (kullanıcı trafiğinin bir bölümünü yeni sürüme yönlendirir, metrikleri otomatik karşılaştırır, hızlı geri alma veya kademeli yaygınlaştırmayı destekler), prompt sürüm yönetimini (her sürüm çalışma zamanı performans verisiyle ilişkilendirilir) ve iş birliğine dayalı geliştirmeyi (ekip üyeleri trace verisini ve sorunlu vakaları paylaşabilir) destekler. Üretim ortamındaki devasa gerçek veri, sürekli iyileştirme için bir altın madenidir — beklenmedik senaryoları ortaya çıkarır ve en çok optimizasyona muhtaç işlevleri belirler.
Observability verisinin en değerli varış noktası, değerlendirme varlığına geri dönüşmesidir. Pratik bir kapalı döngü şudur: üretim trajectory’lerinden başarısız ve şüpheli vakaları süzün → maskeleyin (kullanıcı gizliliği, anahtar gibi hassas alanları temizleyin) → değerlendirme kümesinin yeni test durumlarına ve regresyon testlerine dönüştürün. Böylece değerlendirme kümesi tek seferde kurulmuş statik bir derleme olmaktan çıkar; ürünle birlikte evrilen ve gerçek kullanıcı dağılımına yakın durmayı sürdüren canlı bir varlığa dönüşür — bugün canlıda açığa çıkan başarısızlık kalıbı, yarın o eşiği koruyan regresyon testi olur. Observability ile bu bölümün ana ekseni tam da burada birleşir: observability gerçek dünyada ne olduğunu “görmekten”, değerlendirme ise bu gözlemleri tekrar tekrar sınanabilir ölçütlere sabitlemekten sorumludur.
Eksiksiz bir değerlendirme sistemi ve veri kümesi kurulduktan sonra kilit mesele, değerlendirme sonuçlarını somut sistem iyileştirmelerine dönüştürmektir.
Benchmark Raporlarından Sistem İyileştirmelerine
Aşağıdaki vaka, eşlik eden depodaki gerçek fakat bilinçli olarak dar tutulmuş bir AndroidWorld yinelemesinden geliyor. API 35 emülatöründe dört Wi-Fi ayarı görevi vardır ve görev başına bir eşleştirilmiş koşu yapılmıştır. Bu, 116 görevlik tam benchmark değildir ve API 33 referans ortamında yeniden çalıştırmanın yerini tutmaz. Değeri genel bir puanda değil, bir sonuçtan diğerine giden karar dizisindedir.
Şekil 7-8: Benchmark'tan İyileştirmeye Kapalı Döngü · Kaynak şekil
Harness mühendisliği açısından bakıldığında bu bölüm özünde Harness’in yinelemeli optimizasyonunun yöntemini anlatır — değerlendirme verisiyle Harness’teki zayıf halkalar saptanır (context yetersiz mi? kısıt eksik mi? doğrulama yeterli değil mi? geri bildirim zamanında değil mi?), hedefli iyileştirmeler yapılır ve yeniden değerlendirilir; böylece Harness’in sürekli evrimini sağlayan kapalı bir döngü oluşur.
Benchmark raporunu incelemeye başlamadan önce kolayca gözden kaçan bir ilke var: Agent’ın performansı düştüğünde önce değerlendirme sisteminin kendisini kontrol edin, sonra Agent’a dokunun. Yaygın bir yanılgı, puan düşer düşmez Agent kodunu değiştirmeye girişmek ve değerlendirme sisteminin kendisinin önce bozulmuş olabileceğini göz ardı etmektir — bozuk bir sinyale bakarak yön ayarlamak, daha ilk adımdan yanlış yöne gitmek demektir. Değerlendirme sistemindeki yaygın hata kaynakları şunlardır: çalışma ortamındaki kaynak yetersizliği yüzünden süreçlerin öldürülmesi (rastgele başarısızlık gibi görünür), doğrulayıcının kendisindeki bir bug’ın doğru yanıtları başarısız sayması ve test durumlarının üretim senaryolarından kopması. Bunların hepsi sonuç rakamlarında modelin gerilemesiyle birebir aynı görünür; ancak eksiksiz trajectory’ler incelenerek ayırt edilebilirler.
Benchmark Raporunu Okumak: Sorun Keşfetme Sanatı
Başlangıç raporunda 116 görevin her biri bir kez çalıştırılmış ve toplam başarı yaklaşık 88% ölçülmüştü. Hatalar rastgele dağılmıyordu: dört SystemWifiTurn* görevinin üçü başarısızdı ve trajectory’ler Agent’ın son durumu doğrulamadan ileri geri dolaştığını gösteriyordu. Kanıtla uyumlu iki açıklama vardı: Agent nereye gideceğini bilmiyordu ya da aldığı UI temsili eksikti.
88%‘lik toplam puan, küçük ama tutarlı bu hata kümesini gizler. Adım sınırını artırmak da yanıltıcı olur; “Agent denetimi göremiyor” sorununu “daha ısrarcı olmalı” diye yeniden adlandırabilir. Raporu ters yönde okuyun: görev ve yetenek etiketine göre kümeleri bulun, trajectory’leri oynatın, hatanın gözlemde mi, akıl yürütmede mi, eylemde mi yoksa doğrulamada mı oluştuğunu saptayın; ancak sonra değiştirilecek tek değişkeni seçin. Wi-Fi dilimi sistem çapındaki performansı tahmin etmek için değil, mekanizmayı ucuza teşhis etmek için kullanıldı.
Veriden Hipoteze: İyileştirme Yol Haritası Kurmak
İlk tur en ucuz açıklamayı sınadı. H1 bir gezinme bilgisi eksiği varsaydı; bu yüzden yalnızca deney koluna Wi-Fi sayfasına gitme ve son durumu denetleme talimatları verildi. Başarı değişmedi; darboğaz prompt değildi.
İkinci tur, Agent’ın aslında “neyi gördüğünü” incelemeye geçti. Diyelim ki H5, API 35 ile uyumsuz olan accessibility feed yerine AndroidWorld’ün zaten desteklediği UIAutomator öğe ağacını koyuyor. Başarı oranı gerçekten arttı; ama tam öğe ağacı fazla uzun olduğundan token kullanımı belirgin biçimde yükseldi. Bu yüzden üçüncü tur H5C artık yeni bilgi eklemiyor: yalnızca öğe ağacındaki görünmez, metinsiz ve işletilemeyen kapsayıcı düğümleri siliyor; böylece başarı oranı korunurken gürültünün atılıp atılamayacağına bakılıyor.
Üç turda da model, görev parametreleri, seed, adım sınırı ve emülatör sabit tutuldu; kolların sırası dönüşümlüydü. Bu aşamalı tasarımda bir turun kalan sorunu ya da yan etkisi, sonraki turun tek değişkeni oldu.
Sonuçtan Karara: Veri Güdümlü Dengeler
Tablo 7-5 ölçülen sonuçları özetliyor. Kol başına yalnızca dört görev olduğundan bu sayılar daha büyük bir koşunun değerli olup olmadığına karar verebilir; AndroidWorld genelindeki başarıyı tahmin edemez.
Tablo 7-5 AndroidWorld Wi-Fi Dilimindeki Üç Tur
Deney
Tek değişiklik
Kontrol → deney başarısı
Deney / kontrol token
Sonraki adım
H1
Gezinme talimatı ekleme
25% → 25%
0.47×
Başarı artmadı; özgün prompt’u koru
H5
Accessibility feed → UIAutomator
25% → 100%
2.498×
Güçlü artış, fakat pahalı; optimize et
H5C
UIAutomator ağacını sıkıştırma
100% → 100%
0.506×
Başarıyı koruyup token’ı yarıya indir; tam koşuya geçir
Dizinin kendisi tek tek yüzdelerden daha önemlidir. Ayrıntılı talimatlar, Agent’ın hiç almadığı bilgiyi geri getiremez; prompt’u büyütmeden önce gözlem hatalarını inceleyin. Öte yandan daha çok girdi her zaman daha iyi değildir. Tam öğe ağacı görünürlük sorununu çözerken context’i gürültüye boğdu. Anlamsız düğümleri kaldırmak dört başarılı koşuyu korudu ve token’ı yaklaşık yarıya indirdi. Model değişmedi: Harness’in UI temsili önce görevin yapılıp yapılamayacağını, sonra da bunu yapmanın ekonomik olup olmadığını belirledi.
Sürekli Yineleme: İlk İyileştirmeden Sistem Evrimine
H5C’nin dört görevde başarılı olması yalnızca daha büyük bir testi hak eder; dağıtımı değil. Sonraki kapı, Pixel 6 / API 33 referans ortamında ve tam üçüncü taraf uygulama kümesiyle 116 görevin tümünü beş seed ile çalıştırmaktır. Başarı aşağı kalmamalı, token oranı ≤0.75 ve gecikme oranı ≤1.5 olmalıdır. Bu çalışma bitene kadar dilimdeki 4/4 sonuç, sistem çapında 100% başarı diye raporlanamaz.
Sürekli yineleme pratikte budur: bir turun kanıtı yalnızca kapsamının desteklediği sonraki eyleme izin verir. H1 daha fazla prompt yığmayı durdurdu; H5 doğru mekanizmayı bulup bir maliyet sorunu açığa çıkardı; H5C bu sorunu çözdü ve daha geniş teste hak kazandı. İyi bir benchmark raporu yalnızca puan vermez; sonucun nerede geçerli olduğunu, hangi guardrail’lerin başarısız olduğunu ve sırada neyin sınanacağını söyler.
Deney 7-13 ★★★: AndroidWorld’de Değerlendirme ve İyileştirme
Bu deney, değerlendirme raporundan sistem iyileştirmesine kadar olan yolu uygular. chapter6/android-world içindeki tarihsel rapor ve saklanmış üç eşleştirilmiş koşuyla başlayın.
Birinci adım: teşhis. Görev bazlı tabloyu ve yetenek etiketi matrisini çapraz çözümleyerek yüzeydeki görev başarısızlıklarını derindeki yetenek eksikliklerine eşleyin. Başarı oranı beklenenin altında kalan yetenek etiketlerini ve başarısızlığın yoğunlaştığı görev bölgelerini belirleyin.
İkinci adım: hipotez kurma. Üç katmanlı çerçeveye göre (yüzey → orta → derin) iyileştirme hipotezleri oluşturun; her hipotez için beklenen başarı oranı artışı hedefini ve doğrulama yöntemini açıkça belirtin.
Üçüncü adım: aşamalı deney. Her turda tek değişkenle H1, H5 ve H5C’yi yeniden üretin. Başarının yanında token, gecikme ve gerilemeleri kaydedin.
Dördüncü adım: veri güdümlü karar. Dağıtım kararını maliyet-fayda oranına göre verin — işe yarayan bütün iyileştirmeleri toptan benimsemek yerine, her iyileştirmenin uygulanma kapsamını, gecikme etkisini ve maliyet yükünü tartın. Düşük maliyetli ve yüksek getirili iyileştirmeler öncelikle devreye alınır, yüksek maliyetli olanlar kritik senaryolarla sınırlandırılır.
Beşinci adım: yineleme. Dilim deneyi geçerse yalnızca tam koşuya ilerler. Dağıtımı ancak referans ortamındaki 116×5 çalışmadan sonra tartışın; ortam farklarını, örneklem büyüklüğünü ve eksik kapsamı raporda koruyun.
Dış Değerlendirmeden İç Değerlendirmeye: Üretim Düzeyinde Agent’lar için Değerlendirme Altyapısı
Önceki bölümler Agent sistemlerinin dışarıdan nasıl değerlendirileceğini tartıştı — değerlendirme ortamı kurmak, veri kümesi tasarlamak, benchmark raporlarını çözümlemek. Ama en iyi Agent ürünleri yalnızca dışarıdan değerlendirilmekle kalmaz, sürekli öz değerlendirme altyapısını da içlerine gömer. Aşağıda, Bölüm 5’te tanıtılan açık kaynak genel amaçlı Agent OpenClaw örnek alınarak ve önde gelen Kodlama Agent’ı ürünlerine dair kamuya açık teknik çözümlemelerle sektör paylaşımları harmanlanarak örnek alınmaya değer bir iç değerlendirme sistemi sunuluyor — ML araştırmasının deney yöntemini sistematik biçimde ürün mühendisliğine gömen bir sistem.
Ablation Altyapısı: Her Özelliğin Gerçek Katkısını Anlamak
ML araştırmacıları modelin hangi bileşenlerinin gerçekten önemli olduğunu anlamak için uzun süredir ablation study’den (ablasyon çalışması) yararlanır — ablasyon, bir bileşeni tek tek “sökmek” ve toplam performansın ne kadar düştüğüne bakmaktır. OpenClaw bu yöntemi ürün mühendisliğine taşır: sistemde, birçok ana özelliği (düşünme modu, context sıkıştırma, otomatik bellek, arka plan görevleri vb.) aynı anda devre dışı bırakabilen bir ana anahtar yerleşiktir ve böylece bir “çıplak model” temel çizgisi yaratılır. Bu, ekibin kilit bir soruyu yanıtlamasını sağlar: bir özellik kullanıcı deneyimini gerçekten iyileştiriyor mu, yoksa yalnızca faydalı mı hissettiriyor?
Ablasyonu tek seferlik bir araştırma faaliyeti değil de rutin bir mühendislik pratiği hâline getirmenin birkaç pratik sonucu vardır. Birincisi, ablasyon anahtarı başlatma yolunun çok erken bir noktasında enjekte edilmelidir — herhangi bir modül düzeyi sabit yapılandırma değerini yakalamadan önce — ki bu da ablasyon altyapısının sonradan takılan bir eklenti değil, en baştan sistem mimarisine tasarlanması gerektiği anlamına gelir. İkincisi, ablasyon deneylerini düzenli olarak çalıştırmak (örneğin her büyük sürümden önce) “özellik borcunu” ortaya çıkarır — bir zamanlar işe yarayan, ama modeller evrildikçe artık gerekmeyen özellikleri. Üretim Agent’ı geliştiren her ekip için önerilen pratik şudur: her ana özellik bağımsız olarak kapatılabilir olmalı ve ekip her özelliğin gerçek katkısını düzenli olarak doğrulamalıdır.
AB Testi Yöntemi: Mekanizmayı Hedeften Ayırmak
Olgun Agent ürünleri kendi davranışları üzerinde titiz AB testleri yürütür (yani kullanıcılar rastgele iki gruba ayrılır, bir grup eski sürümü, diğeri yeni sürümü kullanır ve iki grubun gerçek verisi karşılaştırılarak değişikliğin işe yarayıp yaramadığına karar verilir). İyi tasarlanmış bir Agent AB testi vakası, birkaç kilit yöntem ilkesini gösterir:
İkili değil, çok kollu. Yalnızca “var” ile “yok”u karşılaştırmak yerine kademeli birden çok varyant tasarlanır (örneğin farklı sıkılıktaki prompt kısıtları test edilirken bir kontrol grubu ve giderek daha katı üç deney grubu kurulur). Bu tasarım doz-etki ilişkisini açığa çıkarır ve en uygun noktayı bulmaya yardım eder.
Mekanizma metriklerini hedef metriklerden ayırmak. En kolay yapılan hata budur: değiştirdiğiniz şeyi optimizasyon hedefi sanmak. Örneğin “Agent’ın plan dosyasını kısaltmayı” test ediyorsanız, plan uzunluğu bir mekanizma metriğidir (doğrudan değiştirdiğiniz şey), ama hedef değildir. Gerçek hedef muhtemelen “oturum düzeyinde maliyeti düşürmektir”. Plan dosyasını kısaltmak maliyeti düşürebilir, ama plan yeterince ayrıntılı olmadığı için daha çok düzenle-kontrol et-düzenle döngüsüne yol açıp toplam çıktı hacmini artırabilir de. Kendinize hep şunu sorun: değiştirdiğim şey (mekanizma) ile gerçekten önemsediğim şey (hedef) aynı mı? Değilse hedefi esas alın.
Guardrail metrikleri koymak. Hedef metrik iyileşse bile kullanıcı memnuniyeti düşüyorsa, işlem sayısı artıyorsa veya hata oranı yükseliyorsa deney durdurulmalıdır. Guardrail metrikleri “kötüleşmemesi gereken alt sınırdır”.
Temel çizgi istatistiklerini kaydetmek. Örneklem büyüklüğü, dağılım yüzdelikleri ve korelasyon çözümlemesi (örneğin “ret oranı plan boyutuyla birlikte tek yönlü artıyor”) deney sonuçlarının yorumlanması için gereken bağlamı sağlar. Temel çizgi olmadan deney sonucunun istatistiksel olarak anlamlı olup olmadığına karar veremezsiniz.
İki Katmanlı Feature Flag Sistemi
Agent ürünleri daha ilk günden Feature Flag (özellik anahtarı) altyapısını tasarlamalıdır — özellik anahtarı, bir işlevin kullanıcıya açık mı kapalı mı olduğuna kodu yeniden dağıtmadan uzaktan karar veren bir anahtardır. Aynı anda üç amaca hizmet eder: deney, kademeli yayın ve acil durum sigortası.
Derleme zamanı anahtarları, ilgili kodu derleme aşamasında ürünün içinden fiziksel olarak çıkarır. Yalnızca içeride kullanılan özellikler dış derlemelerde hiç var olmaz — tersine mühendislikle bile çıkarılmış işlev keşfedilemez. Bu aynı zamanda temiz bir ablasyon mekanizmasıdır: bir özelliği kapatmak, çalışma zamanında mantığı atlamak değildir; karşılık gelen kod fiziksel olarak yoktur.
Çalışma zamanı anahtarlarının yapılandırması sunucudan indirilir ve yerel diskte bir kopyası önbelleğe alınır. Tasarım gereği, Agent’ın bir ağ isteğini bekleyip başlangıçta bloke olmasındansa biraz eski bir önbellek yapılandırmasının okunması yeğlenir. Somut gruplama kararları AB testi gruplarını atamak için bir deney platformu (örneğin GrowthBook) üzerinden verilir. Kilit bir tasarım ayrıntısı şudur: her özelliğin görülme olayı her oturumda en fazla bir kez kaydedilir; böylece yinelenen kayıtların deney verisini kirletmesi önlenir.
Agent geliştiricileri için çıkarılacak ders: özellik anahtarları bir hata ayıklama aracı değil, birinci sınıf vatandaş düzeyinde mimari bileşenlerdir.
Prompt Duyarlılığı Değerlendirmesi
System prompt, Agent davranışının çekirdek “kodudur”, ama çoğu zaman sıradan kodla eşdeğer bir sürüm denetiminden ve regresyon testinden yoksundur. OpenClaw’ın yaklaşımı, belirtilen bir git sürümünde eksiksiz render edilmiş system prompt’u çıkarabilen özel bir araç sunmaktır — tüm dinamik koşullar açıldıktan sonraki nihai metni içerir. Bu, ekibin şu soruları kesin biçimde yanıtlamasını sağlar: hangi commit prompt’u değiştirdi? Değerlendirme kümesine etkisi ne oldu?
Her Agent ekibi için önerilen pratikler: (1) system prompt deterministik biçimde render edilebilir olmalıdır (aynı yapılandırma girdisi her zaman aynı çıktıyı üretmelidir); (2) prompt’lar için sürümlenmiş anlık görüntü mekanizması kurulmalıdır; (3) her prompt değişikliğinde değerlendirme kümesi üzerinde regresyon testi çalıştırılmalıdır — tıpkı kod değişikliklerinin CI’dan geçmesi gerektiği gibi.
Değerlendirmenin Temeli Olarak Gizlilik Duyarlı Analitik
Değerlendirme iyi veriye dayanır, ama Agent ürünlerinin işlediği şey çoğu zaman kullanıcının hassas içeriğidir. OpenClaw bu çelişkiyi tip sistemi üzerinden çözer: analitik arayüzü yalnızca özel bir tiple sarmalanmış değerleri kabul eder ve tip adının kendisi bir denetim izidir — açıkça “bunun kod ya da dosya yolu olmadığını doğruladım” beyanında bulunur. Bu tasarım, gizlilik kısıtını dokümante edilmiş bir kuraldan derleme zamanında zorlanan bir tip denetimine dönüştürür.
Temel ilke şudur: gizlilik kısıtlarını en baştan tasarıma koyun, sonradan takmayın. Analitik sisteminiz veriyi güvenle toplayamıyorsa etkili bir değerlendirme de yapamazsınız. Gizlilik ile değerlendirme birbirine karşıt değildir — gizlilik duyarlı tasarım, gerçekte neyi ölçmeniz gerektiğini ciddi ciddi düşünmeye zorlar ve bu da daha isabetli değerlendirme metrikleri doğurur.
Dıştan İçe: Değerlendirme Düşüncesindeki Dönüşüm
Bu bölümün özü şudur: önceki bölümler size bir Agent’ı dışarıdan nasıl değerlendireceğinizi öğretti; bu bölüm ise en iyi Agent ürünlerinin kendilerini içeriden nasıl değerlendirdiğini gösteriyor. Dış değerlendirme “Agent ne kadar iyi” sorusunu yanıtlar; iç değerlendirme altyapısı ise “onu hangi değişiklik iyileştirdi” sorusunu. Ablasyon deneyleri hangi özelliklerin gerçekten önemli olduğunu bulur, AB testleri her değişikliğin etkisini nicelleştirir, özellik anahtarları deney ve geri alma altyapısını sağlar, prompt duyarlılığı değerlendirmesi system prompt’u CI sistemine dahil eder, gizlilik duyarlı analitik ise veri toplamanın mevzuata uygunluğunu güvenceye alır. Bu beş bileşen birlikte değerlendirme güdümlü ürün mühendisliğini oluşturur — ara sıra bir değerlendirme yapmak değil, değerlendirmeyi her ürün kararının içine gömmek.
Simülasyon Ortamları: Değerlendirmeden Post-Training’e Uzanan Köprü
Değerlendirmenin varış noktası puan vermek değil, iyileştirmedir. Bu bölüm iyileştirmenin iki yolunu şimdiden gösterdi: Harness’i ayarlamak (benchmark raporundan sistem iyileştirmesine) ve değerlendirmeyi ürün mühendisliğine gömmek (iç değerlendirme altyapısı). İyileştirmenin en güçlü biçimi ise eğitimdir — hedef “mevcut yeteneği ölçmekten” “yeni yetenek yetiştirmeye” genişlediğinde, özellikle Bölüm 8’de tartışılan post-training teknikleriyle, değerlendirme ortamının bir simülasyon ortamına evrilmesi gerekir: Agent’ın tekrar tekrar alıştırma yapabileceği ve otomatik olarak puanlanacağı sanal bir oyun alanı. Simülasyon ortamının değerlendirme ortamından temel farkları şunlardır: etkileşim sıklığı çok daha yüksektir (milyonlarca kez, binlerce kez değil), rastgeleleştirme gerekir (belirli yapılandırmaların ezberlenmesini önlemek için) ve anlık geri bildirim vermek zorundadır. Uygulama alanı açısından simülasyon ortamları dijital ortamlar (bilgi işleme görevleri) ve bedenlenmiş ortamlar (fiziksel dünyayı algılama ve manipüle etme) olmak üzere iki büyük gruba ayrılır.
Bu köprünün iki ucu şöyle birleşir. Değerlendirme tarafında biriken varlıklar neredeyse kusursuz biçimde eğitim sinyaline dönüşebilir: açıkça tanımlanmış bir Rubric ya da doğrulayıcı, özünde bir doğrulanabilir ödül (RLVR, Reinforcement Learning with Verifiable Rewards) ödül fonksiyonudur — puanlama betiği doğrudan ödül betiğidir; testin geçip geçmediği, durumun ölçüte uyup uymadığı hem değerlendirmenin ölçütü hem de pekiştirmeli öğrenmenin getirisidir. Ama eğitim, değerlendirme aşamasında hiç dert edilmeyen yeni gereksinimler ortaya çıkarır. Birincisi güvenilir reset semantiğidir: eğitim milyonlarca episode koşar (bir episode, başlangıç durumundan görev sonuna kadarki eksiksiz bir etkileşim turudur) ve her episode ortamı belirli, temiz bir başlangıç durumuna sıfırlayabilmelidir; yoksa gradyan sinyali önceki turdan kalan artık durumla kirlenir. İkincisi değerlendirmeninkinden çok daha yüksek throughput’tur: değerlendirmede sonuca varmak için birkaç bin koşu yeterken, eğitimde kabul edilebilir bir duvar saati süresi içinde modele milyonlarca etkileşim beslenmelidir; ortamın paralellik derecesi ve tek örnek başına yükü, eğitimin yapılabilir olup olmadığını doğrudan belirler. Bu iki nokta — ödül fonksiyonuna dönüşen doğrulayıcılar ile eğitim ölçeğinde reset ve throughput — Bölüm 8’de açılacak.
Şekil 7-9: Simülasyon Sadakati Spektrumu · Kaynak şekil
Dijital ortamlar tarafında AWorld çerçevesi, GAIA görevleri için denetlenebilir bir MCP sunucu sandbox’ı kurar; 26 MCP sunucusu ve 126 araç fonksiyonu sağlayarak gerçek API’lere doğrudan erişmenin getirdiği yasaklanma ve denetlenemeyen yan etkilerden kaçınır. Tüm araç çağrıları yeniden oynatılabilir ve denetlenebilir. AWorld’ün dağıtık mimarisi, geleneksel seri yürütmedeki 7.695 saniyeyi 525 saniyeye indirir (14,6 kat hızlanma); ortamın durumsuz tasarımı sayesinde her örnek tamamen bağımsızdır ve verimli paralellik desteklenir.
Bedenlenmiş ortamlar tarafında RoboTwin2, bir fizik motoru üzerine çift kollu manipülasyon görevleri kurar; genelleme yeteneğini artırmak için nesnelerin konumunu, yönelimini ve görünümünü rastgeleleştirir. Gözlem alanı çok kameralı görüntüyü ve eklem durumlarını içerir; gerçek zamanlı denetim, eylem parçalama (Action Chunking) ile — yani modelin birden çok ardışık eylemi tek seferde planlamasıyla — gerçekleştirilir (ayrıntısı Bölüm 6’da). OSWorld sanal makine anlık görüntüleriyle sıfırlanabilirliği sağlar, AndroidWorld ise mobil uygulama otomasyonuna odaklanır. İster dijital ister bedenlenmiş olsun, simülasyon ortamları da Bölüm 4’te tartışılan izole yürütme ortamlarına ve sanal kimlik mekanizmalarına (VM/konteyner izolasyonu, konut proxy’leri, Human-in-the-Loop kimlik doğrulama, paylaşılan dosya sistemleri) ihtiyaç duyar; burada tekrarlanmayacak.
Deney 7-14 ★★: OpenVLA ve RoboTwin2 ile Bedenlenmiş Zeka Ortamını Yapılandırmak
Robot manipülasyonu için bir simülasyon ortamı kurun. ch7/SimpleVLA-RL ile OpenVLA belgelerini okuyup görme-dil-eylem modelinin mimarisini anlayın (görme kodlayıcı + dil modeli + eylem kod çözücünün uçtan uca bütünleştirilmesi; görüntü ve metin ortak bir semantik uzaya izdüşürülür). RoboTwin2 ortamını yapılandırın; gözlem alanını (üç açılı RGB + 14 boyutlu eklem durumu) ve eylem alanını (14 boyutlu denetim vektörü) kavrayın. move_can_pot içindeki ortam rastgeleleştirme mekanizmasını ve uzamsal kısıt mantığını inceleyin. Önceden eğitilmiş modeli çalıştırıp değerlendirin; başarı oranını, tamamlanma süresini ve başarısızlık biçimlerini kaydedin, özellikle eylem parçalama mekanizmasının etkisine odaklanın.
Şekil 7-10: OpenVLA ve RoboTwin2 Bedenlenmiş Zeka Ortamı · Kaynak şekil
Sadakat Dengeleri ve Alan Rastgeleleştirme
Yüksek sadakatli ortamlar gerçek dünyaya daha iyi aktarılır, ama hesaplama yükleri büyüktür. Sadakatin bir başka boyutu rastgeleleştirme derecesidir: ölçülü rastgeleleştirme genelleme yeteneğini artırır, aşırısı ise görevi fazla zorlaştırır. Alan rastgeleleştirme (Domain Randomization), simülasyon ile gerçeklik arasındaki farkı (sim-to-real gap) daraltmanın kilit tekniğidir: fiziksel parametrelerde, görsel görünümde, sensör gürültüsünde vb. geniş aralıklı rastgele değişimler devreye sokulur — tıpkı her türlü ışık ve açıda kavrama alıştırması yapmış olmak gibi; gerçek ortamda ışık değişti diye elden kaçırmazsınız. Dijital ortamlarda sim-to-real farkı arayüz render’i, yanıt süresi gibi noktalarda kendini gösterir ve gecikme ile başarısızlıkların rastgeleleştirilmesiyle hafifletilebilir.
Bölüm Özeti
Bu bölüm tek bir temel soru etrafında döndü: bir Agent’ın gerçekten iyileştiğine nasıl karar veririz? Zincir dört halkadan oluşur: önce neyin başarı sayıldığını netleştirmek (Pass@k, Best@k ve Pass consecutive@k dayanaklarının farkı), sonra görevlerin nereden geldiğini belirlemek (açık benchmark’lar, kendi iş kümeniz ve üretim trajectory’lerinin geri akışı), ardından doğrulama biçimini seçmek (belirlenimci doğrulayıcılardan denetim listelerine, Rubric ile LLM yargısına ve ikili karşılaştırmaya kadar) ve son olarak puanları karara dönüştürmek (istatistiksel anlamlılık, başarısızlık atfı, regresyon görevleri ve model seçimi). Her halka sonucun güvenilirliğini etkiler. Ölçülen vakalar dört somut uyarı ekledi: yapılandırılmış bellek ile RAG’ı birleştirmek sinerjiyi garanti etmez; cache ve sıkıştırma tasarrufları toplanamaz; referans ses seçimi çok modlu puanın anlamını değiştirir; Harness’in girdi temsili hem görev başarısını hem token maliyetini belirleyebilir. Model seçiminde tek bir puan yerine farklı kaynak bütçelerindeki yetenek eğrileri karşılaştırılmalıdır. Üretim düzeyinde değerlendirme, ara sıra girilen bir sınav değil, her ürün kararına gömülü sürekli doğrulamadır.
Kitabın bütünsel yapısı açısından bu bölüm, Bölüm 1’deki keşif döngüsünün kanıt kesitini kurar: hata atfı, sonraki önerilerin dayanacak sağlam bir zemini olup olmadığını belirler.
Yörünge ön eki sınır değerlendirmesi bir adım daha ileri gider: bir bilgiyi elde etmekle onu mevcut kararda doğru biçimde kullanmak iki ayrı yetenektir. Uçtan uca regresyon temel görevlerin gerilemediğini güvence altına alır; trajectory prefix sınır kümesi ise kapsam yargısını, güncel yönergeyle geçersiz kılmayı, açıklama istemeyi ve tehlikeli eylemler öncesi onayı doğrudan denetler. Kullanıcı belleği bu genel yöntemin yalnızca bir örneğidir. Üretim düzeyindeki Agent değerlendirmesi ara sıra yapılan bir sınav değil, gerçek sorun vakalarından sürekli olarak regresyon ve sınır görevleri üreten bir doğrulama sistemidir.
Temel yöntem: gözlem → hipotez → deney → doğrulama → yeni kavrayış → yeni hipotez. Bu döngü, Agent mühendisliğini deneyim güdümlü bir “simyadan” veri güdümlü bir bilimsel mühendisliğe taşır.
Bu bölümde tanıtılan değerlendirme sistemi eksiksiz bir kapalı döngü oluşturur: değerlendirme ortamı otomatik test altyapısını sağlar → değerlendirme veri kümesi test durumlarını tanımlar → otomatik değerlendirme yöntemleri (LLM-as-a-Judge ve Rubric) Agent’ın performansını puanlar → benchmark çözümlemesi iyileştirme yönlerini ortaya çıkarır → sistem iyileştirmeleri sorunları giderir → değerlendirme ortamı ve veri kümesi güncellenir ve yeni bir tur başlar.
Bu bölümde kurulan değerlendirme sistemi yalnızca mevcut sistemin optimizasyonuna hizmet etmez, sonraki iki bölüme de kilit bir zemin sağlar. Bölüm 8, değerlendirme ortamlarını ve verisini modelin post-training’i için girdiye çevirir; SFT ve RL ile etkileşim politikasını parametrelere yazar. Bölüm 9 ise üretim trajectory’lerinin çok boyutlu değerlendirmelerini bilgi, talimat, program veya parametre güncelleme adaylarına dönüştürür.
Düşünce Soruları
★★ LLM-as-a-Judge, bir dil modelinin çıktısını yine bir dil modeliyle değerlendirir. Bu “öz değerlendirmenin” sistematik kör noktaları var mıdır — örneğin model, belirli bir üsluptaki yanıtlara tutarlı biçimde yüksek puan verip bu tercih insan yargısıyla uyuşmayabilir mi? Böyle bir yanlılık nasıl tespit edilir ve düzeltilir?
★★★ Değerlendirme veri kümelerinin “sızıntıya dayanıklı” tasarımı kritik önemdedir. Ama açık kaynak ekosisteminde benchmark verisi bir kez kamuya açıldığında hızla eğitim verisine dahil edilir. Bu “kedi-fare oyununun” bir sonu var mı? Veri sızıntısına kökten direnen bir değerlendirme yöntemi tasarlayın.
★★ Scale AI’ın dört ölçütü (uzman rehberliğine dayanma, kapsamlı kapsama, standartlaştırılmış önem ağırlıkları, kendi kendine yeten değerlendirme) değerlendirmedeki öznelliği ortadan kaldırmayı amaçlar. Ne var ki bazı görev boyutları (“yanıt faydalı mı”, “ton uygun mu” gibi) doğası gereği özneldir. Bu öznel boyutlar için güvenilir bir Rubric nasıl tasarlanır?
★★ τ-bench, gerçek kullanıcı davranışını simüle ederek Agent’ları değerlendirir. Ama simüle edilen kullanıcının kendisi de bir LLM’dir — bazı uç senaryoları (duygusal olarak taşkın ya da kendini net ifade edemeyen kullanıcılar gibi) sistematik biçimde hafife alabilir. Simüle edilen kullanıcının kalitesi nasıl doğrulanır?
★★ İkili karşılaştırma (Bradley-Terry modeli), tercihlerin geçişli olduğunu varsayar (A > B ve B > C ise A > C). Oysa insan tercihleri geçişliliği sıkça ihlal eder. Agent değerlendirmesinde geçişsiz tercihler hangi senaryolarda ortaya çıkabilir? Bu, sıralamanın güvenilirliğini nasıl etkiler?
★★ Bu bölüm, yetenek tavanı olarak Pass@k ile iş güvenilirliği ölçüsü olarak Pass consecutive@k arasında ayrım yapar. Tek seferlik başarı oranı yalnızca %60 olan bir Agent için, hangi metriği raporlayacağınıza ve k değerini ne kadar alacağınıza karar verirken görevin başarısızlık maliyetini, yeniden deneme maliyetini ve yan etkilerini nasıl bir araya getirirsiniz?
★★ Bu bölüm “gözlem → hipotez → deney → doğrulama” biçiminde bilimsel bir yöntem öneriyor. Ama pratikte Agent’ın davranış uzayı devasadır ve tek bir hipotezi doğrulamak yüzlerce değerlendirme koşusu gerektirebilir. Sınırlı bir hesaplama bütçesi altında değerlendirmeden elde edilen bilgi miktarı nasıl en üst düzeye çıkarılır?
★ AndroidWorld pilotunda tam öğe ağacı başarıyı 25%‘ten 100%‘e çıkarırken token kullanımını kontrolün 2.498 katına yükseltti; budama 100% başarıyı koruyup token kullanımını 0.506 kata indirdi. Erişilebilirlik, durum doğrulama veya sonraki eylemler için gerekli bilgileri atmadan anlamsal olarak boş UI düğümlerini kaldıracak otomatik budama kurallarını nasıl tasarlardınız?
★★ τ-bench’in kullanıcı simülasyonu “kademeli bilgi açıklama” kullanır — bütün bilgi tek seferde verilmez, Agent’ın sorularına göre adım adım açıklanır. Bu tasarım değerlendirme sonuçlarını nasıl etkiler? Simüle edilen kullanıcının bilgi açıklama stratejisi gerçek kullanıcılardan belirgin biçimde farklıysa, değerlendirme sonuçları hâlâ güvenilir midir?
Dipnotlar
Wijk, Hjalmar, et al. RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts. arXiv:2411.15114, 2025. ↩
Uygulamaya geçin
Eşlik eden deneyler
Bölüme eşlik eden deneyleri keşfedin ve bu fikirlerin kodla nasıl uygulandığını görün.