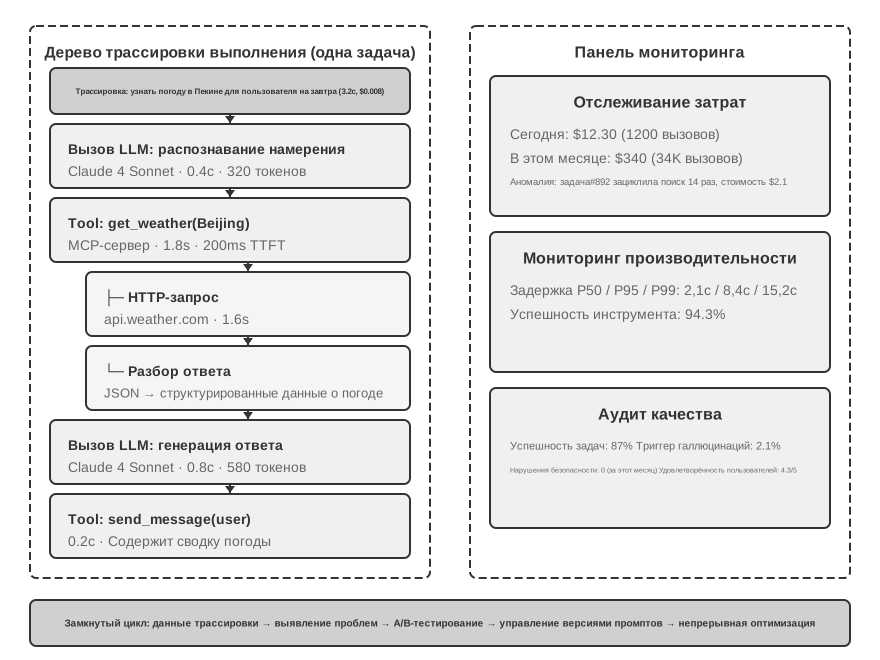
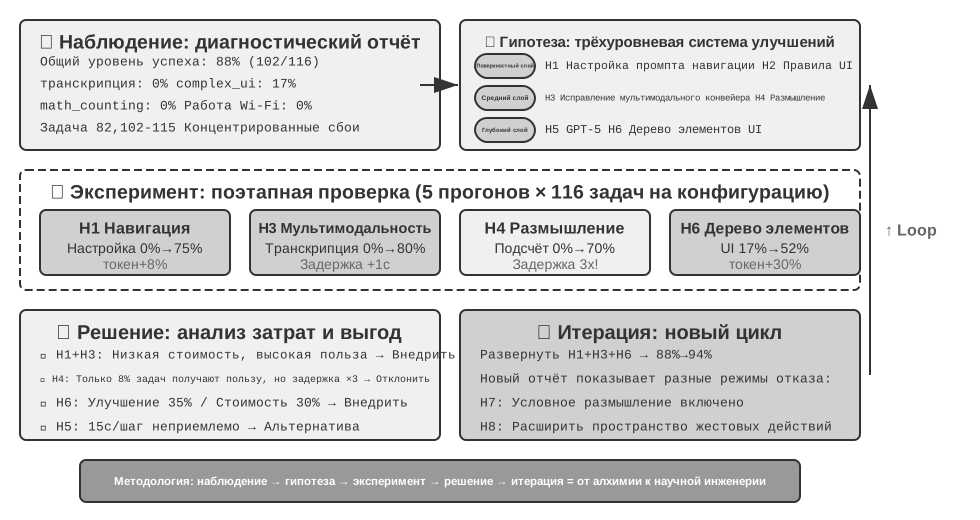
Первые шесть глав раскрыли построение одиночного агента: его контекст, знания, инструменты, способность писать код, а также пространства наблюдений и действий. Но завершить построение — ещё не значит построить правильно; только стабильные измерения дают последующему обучению модели и эволюции системы надёжное направление.
При построении систем агентов разработчики сталкиваются с множеством проектных решений, у которых зачастую нет очевидно правильного ответа:
Какую модель использовать?
Какие инструменты модель должна уметь вызывать?
Какие данные и в какой структуре хранить в базе знаний?
Как организовать память пользователя?
Как структурировать промпты модели и Skills?
Какие ограничения нужно заложить в Harness?
Как преобразовать результаты оценки в обучающие сигналы для непрерывной эволюции агента?
Оценка даёт нам научную основу для принятия решений: с помощью систематических сравнительных экспериментов (меняем одну переменную и смотрим на изменение результата) и абляционных исследований (по очереди отключаем компоненты и смотрим, как меняется общая производительность, чтобы понять реальный вклад каждого компонента) мы отличаем настоящий прирост возможностей от поверхностных колебаний, избегая ситуации «выиграли по мелочи, потеряли по-крупному». Как говорят в разработке ПО: «нет измерения — нет улучшения». Без воспроизводимой системы оценки направление итерации агента можно определять только интуитивно.
С точки зрения Harness-инженерии, введённой в первой главе, оценка выполняет в Harness ключевую функцию «проверки». Важно понимать: объектом оценки должна быть не модель сама по себе, а комбинация модели и Harness. Одна и та же модель в разных Harness может показывать резко различающиеся результаты — некоторые команды, оптимизируя только Harness, значительно улучшили результаты одной и той же модели на терминальных задачах (подробнее в главе 5). Это значит, что когда агент показывает слабый результат на оценке, направление улучшения может быть не в смене модели, а в оптимизации какого-то компонента Harness (промпта, проектирования инструментов, цикла обратной связи). Полноценная система оценки должна уметь различать два принципиально разных типа проблем: «недостаточные возможности модели» и «дефекты проектирования Harness». Обычный способ разделить эти два типа проблем — эксперимент с заменой модели (model swap): фиксируем Harness и меняем только модель на более сильную или более слабую, наблюдая за амплитудой изменения оценки. Если замена на более сильную модель не даёт прироста — узкое место в Harness; если замена на более слабую модель сильно роняет оценку и результат сильно колеблется в зависимости от возможностей модели, самая прямая интерпретация — узкое место в самих возможностях модели, а текущий результат в основном определяется моделью (хотя объясняется ли это тем, что задача действительно сложна, или тем, что Harness чрезмерно полагается на априорные знания модели — требует дополнительного анализа). Обратите внимание: это отличается от упомянутого выше «абляционного исследования» — это два разных метода. Абляция — это отключение отдельного компонента Harness и наблюдение за изменением общей производительности; замена модели — это фиксация Harness при смене модели. Первый метод определяет, какой компонент внутри Harness важен, второй — различает, находится ли узкое место в модели или в Harness.
Ценность системы оценки становится ещё более очевидной в эпоху быстрой эволюции моделей. Возможности моделей продолжают быстро развиваться, но то, что новая модель лучше показывает себя на публичных бенчмарках, не значит, что она лучше и на вашей конкретной задаче — может произойти даже регресс (regression, то есть новая версия хуже прежней в некоторых аспектах). Только полное тестирование на собственном наборе данных для оценки позволяет принимать решения об обновлении на основе данных. Более того, полноценная система оценки делает возможной стратегию «разработки продукта под будущие модели» — даже если текущая модель ещё не дотягивает до уровня коммерческого использования, можно уже завершить разработку продукта и создать набор для оценки, непрерывно отслеживая результаты новых моделей, и запустить продукт сразу, как только будет достигнут нужный порог.
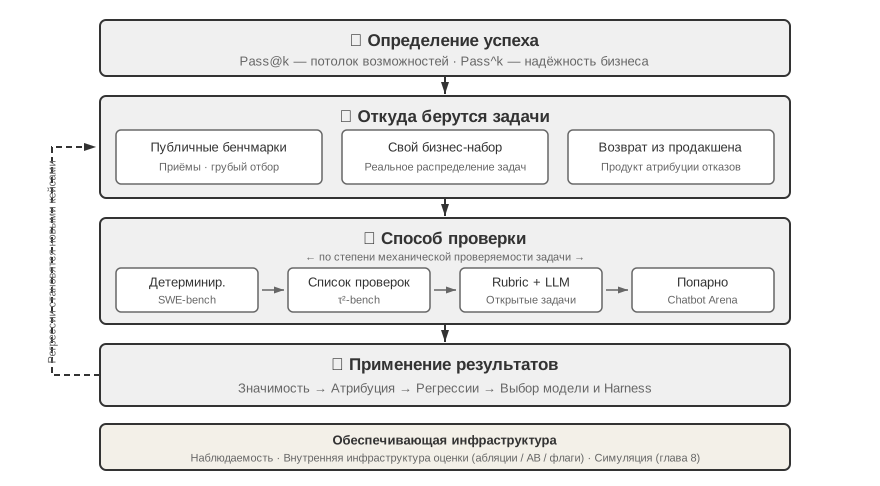
Систему оценки можно разложить на четыре звена: что считать успехом, откуда берутся задачи, кто проверяет и как оценка превращается в решение. Это показано на рис. 7-1.
Разбор одной задачи оценки: домен telecom в τ²-bench
Начнём с того, что целиком разберём одну настоящую задачу из домена telecom в τ²-bench. τ²-bench — открытый проект Sierra; склонируйте его локально командой из chapter7/tau2-bench-eval/README.md и откройте файл задач data/tau2/domains/telecom/tasks_small.json.
Четыре составные части определения задачи
Ниже приведена одна задача из этого файла, сокращённая для удобства чтения.
{ "id": "[mobile_data_issue]airplane_mode_on|user_abroad_roaming_enabled_off", // Тикет, который получает Agent "ticket": "У пользователя телефон не выходит в интернет, в строке состояния показано 'No Service'. Клиент John Smith, номер 555-123-2002, сейчас во Франции. Проблема считается решённой только если тест скорости даёт excellent. Тариф менять не хочет, но при необходимости готов пополнить 2.0 ГБ трафика.", // Регламент поведения, который получает симулятор пользователя "user_scenario": { "instructions": { "known_info": "You are John Smith with phone number 555-123-2002. You are currently abroad in France.", "unknown_info": null, "task_instructions": "…express mild frustration after the first unsuccessful attempt. You will consider the issue resolved only when speed test returns excellent internet speed and nothing else. If it returns poor, fair or good, you will not consider the issue resolved. Whenever the agent asks you about your device, always ground your responses on the results of tool calls. … Never make up the results of tool calls." }}, // Перед запуском обе стороны сбрасываются в одну и ту же точку "initial_state": { "initialization_actions": [ { "env_type": "user", "func_name": "turn_airplane_mode_on" }, { "env_type": "user", "func_name": "turn_roaming_off" }, { "env_type": "assistant", "func_name": "enable_roaming", "arguments": { "customer_id": "C1001", "line_id": "L1002" } } ]}, // Критерии оценивания "evaluation_criteria": { "actions": [ { "requestor": "user", "name": "toggle_airplane_mode" }, { "requestor": "user", "name": "toggle_roaming" } ], "env_assertions": [ { "func_name": "assert_mobile_data_status", "expected_status": true }, { "func_name": "assert_internet_speed", "expected_speed": 200, "expected_desc": "excellent" } ], "communicate_info": null, "nl_assertions": null, "reward_basis": ["ENV_ASSERTION"] }}
В этом определении есть четыре проектных решения, которые стоит разобрать подробнее.
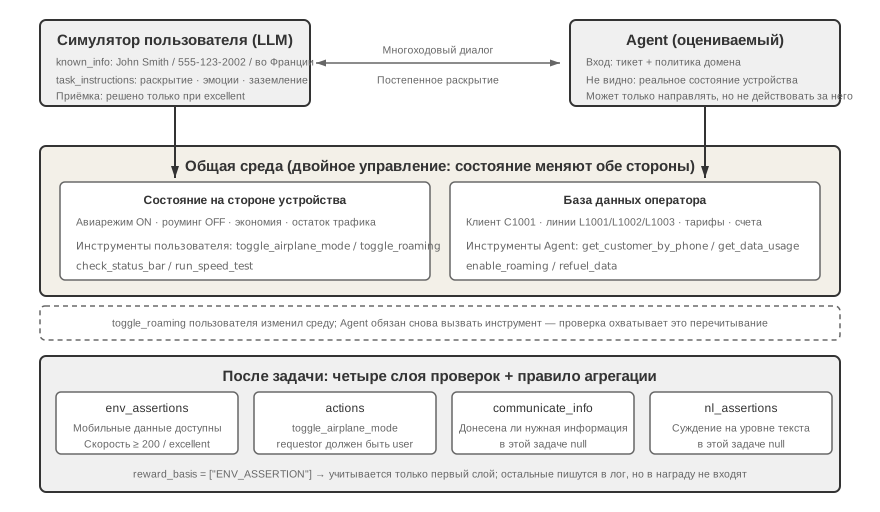
Граница знаний пользователя смоделирована явно. В known_info всего три факта: имя, номер телефона и страна пребывания. Двух настоящих причин сбоя — включённого авиарежима и выключенного роуминга — там нет. Пользователь о них не знает, а значит не может сам о них сообщить; Agent способен получить их только задавая вопросы и прося пользователя проверить. Так постепенное раскрытие информации (Progressive Information Disclosure) реализуется на уровне определения задачи: не через промпт «не выкладывай всё сразу», ограничивающий симулятор, а через моделирование границы знаний пользователя отдельным полем. Большинство бенчмарков выдают полное требование в самом начале задачи, тогда как реальный пользователь начинает обычно со слов «у меня не работает интернет». Довести требование до исполнимого вида — само по себе часть того, что должен уметь Agent.
Симулятор получает регламент поведения, а не реплики. В task_instructions смешаны три вида ограничений: эмоциональная установка (после первой неудачной попытки выразить лёгкое недовольство), критерий приёмки (задача считается решённой только когда тест скорости даёт excellent; poor, fair и good отвергаются) и требование фактического заземления (Grounding) — любой ответ о состоянии устройства должен опираться на возвращаемое значение инструмента: «Never make up the results of tool calls». Последнее особенно важно: без требования заземления симулируемый пользователь пойдёт за подсказкой Agent и подтвердит, что проблема решена, а оценка выродится во взаимное подтверждение двух моделей.
Начальное состояние разделено по управляющей стороне. Поле env_type принимает два значения — user и assistant: авиарежим и переключатель роуминга принадлежат стороне пользователя, а enable_roaming на стороне оператора — стороне Agent. Именно это разделение задаёт форму сбоя: на стороне оператора роуминг подключён, а на устройстве пользователя выключен, поэтому запрос Agent к базе данных даёт лишь вывод «настройки в порядке». Сбой находится на той стороне, которую база данных не видит, и обнаружить его можно только попросив пользователя проверить.
Критерии оценивания разделены на четыре слоя, и эта задача использует лишь один из них.env_assertions проверяет конечное состояние (мобильные данные доступны, скорость не ниже 200 Мбит/с и оценка excellent), actions проверяет, произошли ли ключевые действия и какая сторона их выполнила, а communicate_info и nl_assertions проверяют, была ли донесена до пользователя необходимая информация. В reward_basis этой задачи объявлен только ENV_ASSERTION; остальные слои по-прежнему вычисляются и записываются, но в итоговую награду не входят. Основание оценивания объявляется для каждой задачи отдельно, а не фиксируется глобально.
Траектория одного реального запуска
Дальше мы предлагаем читателю самому запустить задачи оценки домена telecom в τ²-bench, понаблюдать за устройством задач, за симулятором пользователя, за логикой проверки процесса и результата, а также за траекторией выполнения Agent и разобрать, почему Agent потерпел неудачу.
Эксперимент 7-1 ★: Запустить τ²-bench и сравнить его развитие относительно τ-bench
Этот эксперимент запускает фреймворк оценки τ²-bench, чтобы понять ключевые моменты устройства среды оценки человеко-машинного типа. Сначала прочитайте файл определения задач по тому же маршруту, что и в этом разделе: каждая задача состоит из четырёх частей — известная информация, инструкции задачи, начальное состояние и условия успеха. Затем прогоните полный цикл оценки, понаблюдайте за многоходовым диалогом симулятора пользователя и Agent и разберите типичные режимы отказа (нарушение политики, пропуск информации, чрезмерная передача оператору и т. п.).
Рис. 7-3 Среда с двойным управлением и послойная проверка в τ²-bench · Исходный рисунок
В сопутствующем репозитории сохранена одна запись прогона (chapter7/tau2-bench-eval). Разберём из неё один успешный запуск.
Первые десять с лишним ходов — этап идентификации аккаунта. Agent по номеру находит клиента C1001, затем последовательно запрашивает расход трафика по трём линиям L1001, L1002 и L1003 и снова спрашивает, какой номер пользователь реально использует во Франции. В сообщении 17 он делает ошибочный вывод:
Agent (17): номер 555-123-2002 отсутствует среди ваших активных линий, ближайший — 555-123-2001…
Этот вывод опирается на запрос лишь по одной линии L1001. После того как пользователь настаивает, что номер верен, Agent запрашивает L1002 и только тогда находит соответствие. Ключевой перелом наступает в сообщении 30:
Пользователь (30) → вызывает check_network_status(), check_status_bar()
Ответ инструмента (31): Airplane Mode: ON | Cellular Connection: no_service | Mobile Data Enabled: Yes | Data Roaming Enabled: No
Пользователь (33): вижу, что телефон сейчас в авиарежиме, поэтому сигнала нет. Мобильные данные включены, но роуминг выключен. Выключить авиарежим и попробовать?
Вызов инструмента исходит от пользователя, а не от Agent. Это и есть механизм двойного управления (Dual-Control): у симулируемого пользователя есть собственный набор инструментов — check_status_bar, toggle_airplane_mode, reseat_sim_card, run_speed_test и другие.
Дальше диагностика идёт гладко: Agent просит выключить авиарежим и включить роуминг, пользователь выполняет оба действия (35, 37), строка состояния показывает полный 5G; Agent просит замерить скорость, приходит 275 Мбит/с с оценкой Excellent (46), и пользователь подтверждает, что проблема решена. Обе проверки env_assertions пройдены, reward = 1.0.
В этой траектории с максимальным баллом есть и проблема, которую верификатор не поймал. В первом же абзаце политики Agent для telecom написано «You should only make one tool call at a time», однако в сообщении 4 Agent выпустил сразу два вызова: get_customer_by_phone и get_customer_by_name. Верификатор не счёл это ошибкой, потому что reward_basis этой задачи учитывает лишь конечное состояние. Это не упущение τ²-bench, а неизбежная цена бинарной награды: она меняет детальность процесса на единственное число, сопоставимое между моделями. Но системе оценки в продакшене обычно нужно больше: не только вердикт «верно или неверно», но и указание на то, где именно проблема.
Провалившаяся задача не менее интересна для разбора. Номер пользователя — 555-123-2002, но Agent выбрал линию L1001 и продолжил рассуждать, опираясь на её расход 3,2/5 ГБ. По ходу дела get_details_by_id(L1001) явно вернул, что номер этой линии — 555-123-2001; Agent прочитал результат, но вывод не исправил, затем потратил десятки сообщений на посторонние проверки и в итоге передал диалог оператору. Половину задачи он всё же выполнил: заставил пользователя выключить режим экономии трафика, и это действие на стороне пользователя действительно произошло и было проверено средой. Но из-за неверно выбранной линии необходимое пополнение на 2 ГБ так и не было выполнено, и все три проверки конечного состояния провалились. Форма этого отказа очень похожа на случай AndroidWorld, разбираемый ниже в разделе «Атрибуция отказов»: доказательства, нужные для исправления вывода, уже были в контексте, но Agent не вернулся к ним.
Одна эта задача уже ставит все вопросы, на которые должен отвечать набор оценки: что считать успехом, откуда берутся задачи, кто проверяет и как оценка превращается в решение. Следующие разделы разбирают их по порядку.
Метрики оценки: определение успеха
Результат оценки из предыдущего раздела — четыре пройденные задачи из пяти. По одному числу 0,8 нельзя судить, пригодна ли система. Если это Agent поддержки по возвратам, то один пользователь из пяти не получит причитающийся ему возврат; если это Agent безопасности, ищущий уязвимости, то четыре попадания из пяти — весьма достойно. Разница в том, какой уровень успешности требует конкретный бизнес-сценарий.
Техническое чудо: потолок возможностей по Pass@k
Многие нынешние модели и агенты всё ещё находятся на стадии, которую можно назвать «техническим чудом». Чудо здесь — это потолок возможностей, показанный при большом числе попыток, щедром запасе времени и человеческом отборе: достаточно одного удачного прогона, чтобы доказать, что дело в принципе выполнимо. Это ровно логика Pass@k: одну и ту же задачу запускают k раз и считают пройденной, если прошёл хотя бы один запуск; если выход — непрерывная оценка, берут лучший запуск и называют это Best@k.
Рассуждения Anthropic о долго работающих агентах хорошо показывают такой потолок: дать агенту неделю автономной работы, чтобы он с нуля написал компилятор C; заставить его искать, пока не найдётся контрпример к важной математической гипотезе; или раз за разом проверять открытое ПО, пока не всплывёт серьёзная уязвимость, пролежавшая там десятилетия.
В такого рода инженерном и научном поиске демонстрируют обычно не «каждый раз правильно», а единственную прорывную траекторию, которая наконец появляется, когда бюджет поиска растянут достаточно далеко. Для научных открытий, поиска уязвимостей и открытого творчества этот потолок ценен сам по себе: человек может выбрать лучшую из k траекторий-кандидатов.
Помимо разработчиков базовых моделей, стратегию «технического чуда» используют и многие прикладные компании. Manus привлёк широкое внимание тем, что дал людям виртуальный компьютер: те, у кого до этого не было интуитивного представления об агентах, увидели, что ИИ умеет работать за компьютером как человек — полчаса или час подряд, шаг за шагом доводя сложную задачу до конца.
OpenClaw впервые дал многим ощущение, что агент — «живой». Задачу ему поручают через мессенджер так же, как поручили бы живому сотруднику; он имеет доступ ко всем файлам на компьютере и к онлайн-сервисам, на определённом этапе сам отчитывается или запрашивает недостающие сведения и даже способен разбудить себя, чтобы проверить и разобрать почту.
Ранние Manus и OpenClaw не отличались высокой долей успеха на сложных задачах, а расход токенов был очень велик. Но поскольку эти агентские фреймворки универсальны, в связке с сильнейшими моделями сложные задачи нередко дают высокий Pass@k, то есть высокий технический потолок. Именно массовое распространение этих «технических чудес» в социальных сетях стало ключом к успеху таких продуктов.
Надёжность бизнеса: Pass^k
Реальный бизнес обычно волнует обратное: не допустить ни одной ошибки за серию попыток. Эту цель мы называем Pass^k (читается Pass consecutive k): одну и ту же задачу запускают k раз подряд, требуя, чтобы прошёл каждый запуск и чтобы ни разу не сработал вето-пункт по безопасности, комплаенсу или галлюцинациям. Он отвечает на вопрос «способен ли агент стабильно и надёжно выдавать результат», а не «может ли он изредка сотворить чудо».
Если запуски независимы, а вероятность успеха одного равна p, связь двух метрик очевидна:
Pass@k=1−(1−p)k,Passk=pk.
Например, при p=0.6 и k=5: Pass@5 =1−0.45≈99.0% — кажется, что «хотя бы раз получится» почти всегда; но Pass consecutive@5 =0.65≈7.8%, то есть пройти пять раз подряд без осечки по-прежнему трудно. Первое число годится для измерения потолка возможностей на этапе поиска; к требованиям надёжности платежей, возвратов, изменения прав и продакшен-развёртываний близко только второе.
В отчёте об оценке нужно чётко указывать, что означают k попыток: k независимых выборок одной задачи или k подряд идущих задач в продакшен-конвейере. Для операций с побочными эффектами нельзя просто «повторять, пока не выйдет»: выборку следует делать в песочнице или в среде с откатом, а каждый отказ заносить в метрику надёжности.
Среда оценки
Когда основание метрики определено, следующий вопрос — где измерять. Среда оценки — это установка, которую можно запускать повторно: при одном и том же начальном состоянии один и тот же Agent должен давать сопоставимые результаты.
Пять составляющих
Вернёмся к разобранной выше задаче telecom. Если взять её за образец, всё необходимое для повторно запускаемой среды оценки уже есть.
Набор данных (Dataset) — это сам файл задач: начальное состояние, тикет для Agent, регламент поведения для симулятора и критерии приёмки упакованы в одну запись, и одна запись — это один тест-кейс.
Состояние среды (Environment State) — изменяемая информация во время выполнения задачи: клиенты, линии, тарифы и счета в базе данных плюс авиарежим, роуминг, переключатель экономии трафика и остаток трафика на стороне устройства. Оно должно сбрасываться, и initialization_actions — это и есть скрипт сброса. Реалистичность требует, чтобы изменения состояния подчинялись бизнес-логике; управляемость требует, чтобы перед каждым запуском можно было вернуться в одну и ту же точку.
Интерфейс инструментов (Tools) разделён на две стороны. Agent может вызывать операции на стороне оператора: запрос клиента, запрос расхода, пополнение трафика, передачу оператору. Пользователь может переключать настройки на устройстве. Оба набора инструментов атомарны, и высокоуровневой абстракции вроде «решить проблему пользователя с интернетом» не существует: слишком высокий уровень абстракции превращает оценку в проверку одного вызова функции, а планирование и рассуждение поглощаются самим инструментом.
Критерий оценивания (Rubric) — это четыре слоя проверок в evaluation_criteria плюс правило агрегации reward_basis.
Протокол выполнения (Interaction Protocol) задаёт порядок взаимодействия и условия завершения. Нормальный сигнал завершения здесь — вывод симулируемым пользователем ###STOP###; кроме того, есть предел числа ходов, а симулируемый пользователь может и сам прервать диалог, исчерпав терпение: низкая эффективность общения сама по себе засчитывается как отказ.
Убери любую из пяти составляющих — и оценка перестанет быть повторяемым циклом. Разбирая дальше другие бенчмарки, мы по-прежнему пользуемся этими пятью пунктами как системой отсчёта.
Среды оценки человеко-машинного и инструментального типов
Задачам вроде telecom обязательно нужен собеседник, и часть с симуляцией пользователя из пяти составляющих здесь незаменима. Но есть и другой большой класс задач, где собеседника нет вовсе: в генерации кода, анализе данных, решении математических задач Agent от начала до конца взаимодействует только с инструментами, правильность определяется прохождением проверки исполнением, и ни ручная разметка, ни суждение модели не требуются. Такие среды обходятся без симулятора пользователя, остальные четыре составляющие остаются, только в более простой форме: состояние среды — файловая система или база данных, критерий оценивания — кусок тестового кода, а протокол выполнения вырождается в «вызывать инструменты, пока не будет получен ответ или не исчерпан лимит ходов».
Фреймворк Verifiers расслаивает такие среды по двум измерениям: нужно ли задаче сохранять состояние между ходами и нужна ли изоляция. SingleTurnEnv подходит, когда задают математическую задачу и сразу проверяют ответ; ToolEnv — когда ищут по нескольким веб-страницам, обобщают ответ и проверяют итог; StatefulToolEnv — когда меняют запись в базе и проверяют изменение состояния; SandboxEnv — когда запускают код в песочнице и проверяют выходные файлы. В табл. 7-1 сведены эти четыре типа, чтобы выбирать по требованиям к состоянию задачи, вызову инструментов и изоляции.
Таблица 7-1 Сравнение типов сред Verifiers
Тип среды
Сохранение состояния
Вызов инструментов
Типичный сценарий
SingleTurnEnv
нет
нет
Одноходовые вопросы, математика
ToolEnv
нет
многоходовый
Поиск + обобщение информации
StatefulToolEnv
да
многоходовый
Изменение записей в базе данных
SandboxEnv
да + изоляция
многоходовый
Исполнение кода и тесты
Фреймворк поддерживает параллельное семплирование и кэширование траекторий; полная траектория каждой оценки (наблюдения, действия, награды) сохраняется, что упрощает последующий анализ и воспроизведение. Кроме того, эффект выполнения инструмента зависит от текущего состояния, поэтому при сбое следует возвращать понятное сообщение об ошибке, а не одинокий флаг неудачи, — тогда Agent сможет скорректировать стратегию.
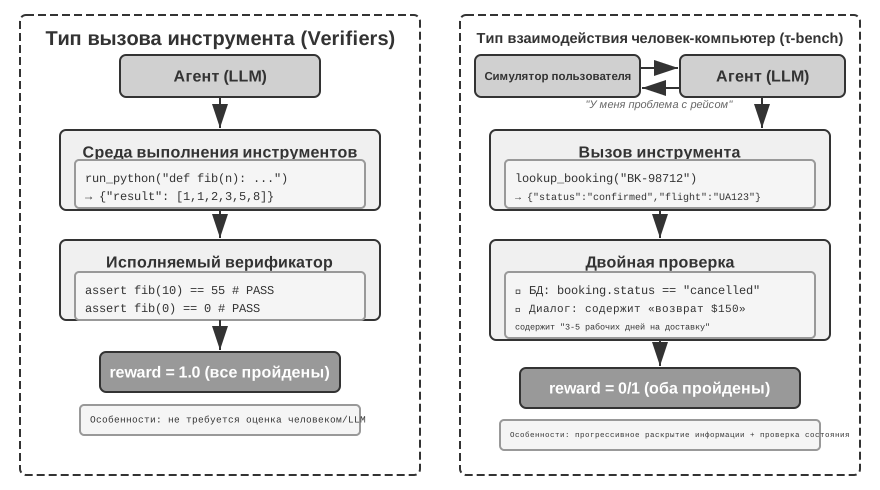
Оценка инструментального типа проверяет правильность наблюдаемых изменений состояния, а оценка человеко-машинного типа — обоснованность стратегии общения: первая проверяет действие, вторая — ведение диалога. Сопоставление структуры двух типов сред приведено на рис. 7-2.
Рис. 7-2 Среды оценки инструментального и человеко-машинного типов · Исходный рисунок
Проектирование набора данных для оценки
Если среда оценки — сцена, то набор данных — сценарий. Те же пять составляющих при смене класса задач могут заполняться совершенно иначе: откуда берутся задачи, насколько глубоко может проверить верификатор, как не дать их запомнить. Этот раздел отталкивается от проектной практики нескольких публичных бенчмарков и завершается более практическим вопросом — откуда должны браться задачи в собственном наборе оценки.
Различие по наличию собеседника, проведённое в предыдущем разделе, — лишь первый слой различий на уровне среды; расхождения на уровне набора данных полнее отражают проектные компромиссы. В табл. 7-2 несколько часто цитируемых бенчмарков поставлены рядом.
Таблица 7-2 Ключевые проектные решения нескольких бенчмарков для Agent
Бенчмарк
Проверяемая способность
Источник задач
Кто играет среду
Верификатор
τ²-bench
Человеко-машинное взаимодействие и вызов инструментов в поддержке
Ручное написание + комбинаторная генерация
Симулятор пользователя + бизнес-БД
Четыре слоя проверок, агрегируемые в бинарную оценку через reward_basis
SWE-bench Verified
Разработка ПО, coding
Реальные issue с GitHub, отобранные вручную
Репозиторий кода + набор тестов
Двойная проверка FAIL_TO_PASS / PASS_TO_PASS
AndroidWorld
Работа с GUI телефона на Android
Инстанцирование параметризованных шаблонов
Реальный эмулятор Android
Утверждения о конечном состоянии UI
OSWorld
Работа с GUI рабочего стола Linux
Старт из заранее настроенного промежуточного состояния
Реальная виртуальная машина
134 независимые функции оценивания
Terminal-Bench
Работа с терминалом Linux, coding
Ручное написание
Контейнер Docker
Проверка файловой системы + реальное исполнение
GAIA
Универсальный ИИ-ассистент, собирающий информацию
Ручное написание + собственные вложения
Открытый интернет
Точное совпадение строк
Верификаторы
Agent запросто напишет пространный отчёт о том, что задача полностью выполнена, хотя на деле не выполнено ничего. Фреймворк оценки обязан проверять факты, которые машина может подтвердить независимо, а не собственные заявления Agent.
SWE-bench Verified раскладывает «исправление завершено» на два независимых утверждения. Первое — FAIL_TO_PASS: до исправления падает, после исправления проходит, что доказывает, что проблема действительно решена. Второе — PASS_TO_PASS: проходит и до, и после, что доказывает, что новых дефектов не внесено. Если проверять только первое, Agent может проскочить, удалив или переписав мешающие утверждения; если только второе — это всё равно что не проверять. Лишь проверка обоих делает «исправлено» и «ничего не сломано» двумя самостоятельно доказуемыми выводами. Дополнительно подтверждается устойчивость самих тестов, чтобы исключить нестабильные тесты (flaky test), которые то проходят, то падают.
Верификатор OSWorld способен обнаружить случаи, когда снаружи всё выполнено, а по сути неверно. Он оснащён 134 независимыми функциями оценивания и полным доступом к операционной системе, что позволяет проверять структуру файловой системы, состояние процессов, сетевые соединения и внутреннее состояние приложений. В задачах работы с базой данных скрипт оценки не только подтверждает наличие файла отчёта, но и подключается к базе, чтобы проверить, действительно ли выполнился SQL. В задачах с браузером он разбирает DOM-дерево, смотрит cookie и localStorage, отправляет проверочные запросы на бэкенд и убеждается, что форма реально применилась.
Задача build-linux-kernel-qemu в Terminal-Bench требует собрать ядро Linux 6.9 из исходников, добавить собственный printk в start_kernel, сгенерировать initramfs и запустить всё это в QEMU; критерий успеха — появление этого собственного сообщения в логе загрузки. Подделать вывод Agent не может — остаётся только по-настоящему пройти весь путь.
Разделение задач по сложности
В наборе задач оценки должны быть задачи разной сложности. Тогда при росте возможностей моделей набор не устареет слишком быстро.
Все 466 вопросов GAIA разделены на три уровня сложности: Level 1 требует одного-двух инструментов (люди 93,9%, GPT-4 30,3%), Level 2 — многошагового рассуждения (91,8% против 9,7%), Level 3 — сложной композиции (87,3% против 0%). Такое расслоение не просто маркирует сложность, у него есть диагностическая ценность: провал на Level 1 указывает на базовое использование инструментов, Level 2 — на многошаговое планирование и интеграцию информации, Level 3 — на длинные цепочки рассуждений и управление сложностью, и всем трём соответствуют разные направления улучшений.
Terminal-Bench охватывает всё — от простой регистрации модели в mlflow до взлома пароля 7z средней сложности, сложной интеграции git-сервера и веб-сервера из нескольких компонентов и самого трудного дифференциального криптоанализа FEAL.
Кроме того, в τ²-bench специально спроектированы задачи-ловушки: пользователь утверждает, что «служба поддержки уже одобрила отмену», хотя на деле это не соответствует политике, — так проверяется, сохранит ли Agent верное суждение под давлением и в условиях дезинформации.
Защита от утечки данных
GAIA делает ответы недоступными для прямого поиска в интернете. Задачи там концептуально просты, но путь открыт: например, отталкиваясь от «Астрономической картины дня» NASA за конкретную дату, опознать на снимке астронавта, найти его отряд астронавтов, вычислить, кто из этого отряда провёл в космосе меньше всего времени, и строго вывести результат в формате «фамилия, разделение точкой с запятой, разделители разрядов». Ответ предельно конкретен, а правильность определяется точным совпадением строк. Защита от утечки держится на двух вещах: во-первых, ответить на вопрос можно только скомбинировав несколько источников, и ни одна отдельная веб-страница ответа не даёт; во-вторых, к части задач приложены специально изготовленные файлы (PDF, аудио, изображения, которых нет в интернете).
AndroidWorld порождает множество экземпляров из одного шаблона. Её задачи — не статический текст, а динамически инстанцируемые шаблоны, например «изменить телефон контакта [CONTACT_NAME] на [NEW_PHONE]», причём значения параметров генерируются случайно при каждой оценке. Это даёт три выигрыша: параметры каждый раз разные, поэтому воспроизведение фиксированной последовательности действий бесполезно; из одного шаблона можно получить почти неограниченное число экземпляров; зафиксировав часть параметров и меняя остальные, можно точно измерить влияние конкретного фактора.
Terminal-Bench вшивает в текст задачи «канареечный» идентификатор. Каждая задача несёт canary GUID; если модель способна выдать содержимое с этим GUID, значит данные бенчмарка попали в обучающую выборку. Утечку это не предотвращает, но делает её обнаружимой.
Контроль качества и долгосрочное сопровождение
Сделать качественный набор оценки очень трудно. Нынешний вид большинства перечисленных бенчмарков — результат многократных доработок после того, как первая версия пошла в дело и вскрылись проблемы. Например, от τ-bench к τ²-bench переработаны пять мест.
Во-первых, инструкции задач были слишком общими, из-за чего ответ можно было угадать. Инструкции первой версии писались широко, поэтому модели не требовалось по-настоящему уточнять запрос — достаточно было угадать процедуру из здравого смысла. τ²-bench разделил сценарий на две графы, known_info и task_instructions: первая очерчивает, что пользователь знает, вторая задаёт порядок раскрытия. То, чего пользователь не знает, Agent угадать не может и вынужден выяснять запросами.
Во-вторых, условия успеха были недостаточно точны, что приводило к ошибкам проверки. У условия вроде «сеть восстановилась» нет проверяемой границы. τ²-bench заменил его на «решённой задача считается только при результате теста скорости excellent; poor, fair и good не принимаются». Это изменение нацелено на формальные починки, которые подавляют симптом, не устраняя первопричину.
В-третьих, поведение симулятора пользователя было слишком механическим. Симулируемый пользователь первой версии лишь пассивно отвечал. τ²-bench добавил ему эмоции (после первой неудачной починки выразить недовольство), предел терпения (прервать диалог, если общение слишком неэффективно) и требование фактического заземления. Вместе эти три вещи делают симулятор ближе к реальному пользователю, сохраняя воспроизводимость.
В-четвёртых, пользователь участвует не только в диалоге, но и в действиях. В домене telecom введена среда с двойным управлением. Раньше среду мог менять только Agent, тогда как в сценариях техподдержки значительную часть действий по-хорошему должен выполнять сам пользователь на своём устройстве. Двойное управление добавляет проверке ещё одно измерение: после того как пользователь изменил состояние, Agent обязан снова вызвать инструмент, чтобы узнать результат, — и проверка теперь охватывает вопрос «действительно ли Agent прочитал итог действий на стороне пользователя».
В-пятых, экземпляры задач генерируются динамически. Конкретные экземпляры τ²-bench (имена пользователей, номера, комбинации неисправностей) можно параметризовать и порождать пакетно, что улучшает и покрытие, и устойчивость к утечкам.
SWE-bench Verified: до публикации отсеяно 71% исходных задач. OpenAI случайно отобрал 1699 задач из исходных 2294 для ручной оценки и привлёк 93 разработчиков, хорошо знающих Python, чтобы проверить каждую: ясно ли описана проблема, покрывают ли тесты граничные условия, стабильны ли тесты, не вносит ли эталонный patch новых ошибок, разумна ли сложность. В итоге прошло всего 500. Высокий отсев даёт лучшее соотношение сигнал/шум, а стоимость оценки падает примерно на 80%. Сложные задачи Agent сплошь и рядом занимают от минут до часов, а полный прогон набора оценки на передовой модели нередко стоит тысячи долларов в токенах, поэтому снижение стоимости оценки крайне важно.
OSWorld: за 15 месяцев после публикации вскрылось более 300 проблем. Выпущенный в апреле 2024 года, он быстро стал важным бенчмарком для оценки мультимодальных Agent, но в ходе широкого применения обнажились четыре класса проблем: проблемы среды (защита сайтов от парсинга, CAPTCHA, изменение динамического контента), проблемы описания задач (двусмысленные формулировки), проблемы логики проверки (слишком строгая или слишком мягкая) и проблемы начального состояния (неполная конфигурация). Команда Университета Гонконга собрала группу примерно из 10 человек и два месяца тесно работала с MoonShot AI, OpenAI, ByteDance Seed TARS, Anthropic, Simular и другими над системным исправлением: проблемы среды решались фиксацией версий и офлайн-резервированием, проблемы описаний — переписыванием двусмысленных формулировок, проблемы проверки — ручным построением правильной базовой линии и подстройкой условий, проблемы начального состояния — добавлением проверок полноты.
Эксперимент 7-2 ★: Выполнить задачи бенчмарка вручную
Выберите задачи из GAIA, AndroidWorld, SWE-Bench Verified, Terminal-Bench и OSWorld-Verified и выполните их своими руками; по каждому набору рекомендуется взять одну лёгкую, одну среднюю и одну трудную. Уровень «трудный» бросает вызов и человеку.
По завершении ответьте на два вопроса. Допускает ли описание задачи несколько разумных толкований, и если да, какое из них признаёт верификатор? Если попытаться проскочить, не делая работу, каков самый дешёвый путь и сможет ли верификатор его перекрыть?
Три источника набора оценки
Распространено мнение, что публичные бенчмарки служат ранжированию моделей и мало связаны с реальным бизнесом. Действительно, оценки публичных бенчмарков трудно напрямую превратить в продуктовые решения, но их проектные приёмы вполне переносимы. Глубина проверки, параметризованная генерация, защита от утечек и поддержание качества — именно то, что чаще всего упускают в собственном наборе оценки.
У набора оценки в продакшене обычно три источника.
Публичные бенчмарки используются для грубого отбора моделей и заимствования проектных приёмов и, как правило, не для продуктовых решений. Их распределение задач не совпадает с распределением задач вашего бизнеса: прибавка двух процентных пунктов на GAIA не связана необходимым образом с успешностью возвратов.
Собственный бизнес-набор покрывает реальное распределение задач и может служить основанием для выбора модели и решений по устройству Harness. Например, τ²-bench годится как каркас для любой системы оценки, которой нужен симулируемый пользователь: достаточно заменить доменные данные и набор инструментов.
Возврат производственных траекторий приходит из реальных отказов на проде: явные исправления со стороны пользователя, дизлайки пользователя, а также случаи, найденные постфактум проверкой состояния, верификатором на правилах или ревью LLM. После атрибуции отказов они оседают в виде регрессионных кейсов. Конкретный порядок действий описан ниже в разделах «Атрибуция отказов» и «Сквозные регрессионные задачи и регрессионные задачи по префиксу траектории». Этот источник самый дорогой и одновременно самый точный, потому что он приходит прямо из того, с чем реально столкнулись пользователи.
На старте обычно есть только публичные бенчмарки и небольшой набор написанных вручную бизнес-кейсов; после того как система какое-то время поработает в продакшене, основную массу составляют кейсы, вернувшиеся из производственных траекторий.
Автоматизированные методы оценки
У бенчмарков, разобранных в предыдущих разделах, есть общая черта: их верификаторы почти всегда детерминированы. SWE-bench запускает набор тестов, AndroidWorld проверяет конечное состояние UI, GAIA сверяет строки на точное совпадение, а четыре слоя проверок τ²-bench точно так же исполняются кодом. У этого выбора есть веские основания: детерминированная проверка не добавляет расходов на модель, результат полностью воспроизводим, её можно встроить в непрерывную интеграцию как юнит-тест, и она удобна для ранжирования моделей.
Цена — в том, что она способна оценить лишь правильность конечного результата, но не назвать причину ошибки. Провалившаяся задача τ²-bench получила 0 баллов, но этот 0 не объясняет, ошибся ли Agent на этапе выбора линии или пропустил шаг пополнения трафика, и тем более не подсказывает, что менять дальше. Для публичного бенчмарка, используемого для ранжирования, это не изъян; для продакшен-системы, которой нужны непрерывные улучшения, это как раз самая нужная информация.
В продакшене есть и вторая трудность: многие суждения в принципе не записываются как проверяемые кодом утверждения. Уместен ли ответ на жалобу, не упущена ли в отчёте ключевая информация, не перепутал ли поиск по памяти родственные связи людей — у всего этого нет единственного конечного состояния, которое можно запросить, и нельзя определить его совпадением ключевых слов.
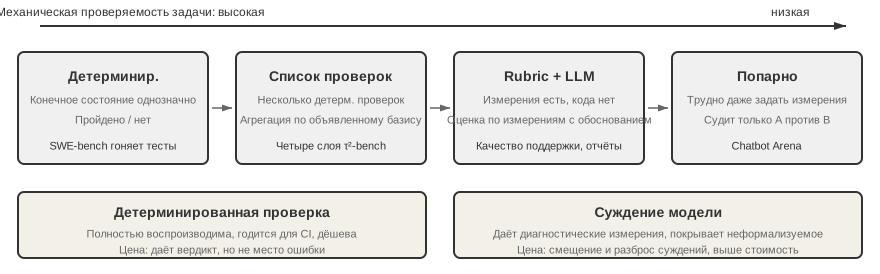
Поэтому при переходе от публичных бенчмарков к оценке в продакшене способ проверки нужно сдвигать вправо по спектру, горизонтальная ось которого — степень механической проверяемости задачи, как показано на рис. 7-4.
Рис. 7-4 Спектр способов проверки: от детерминированной проверки к суждению модели · Исходный рисунок
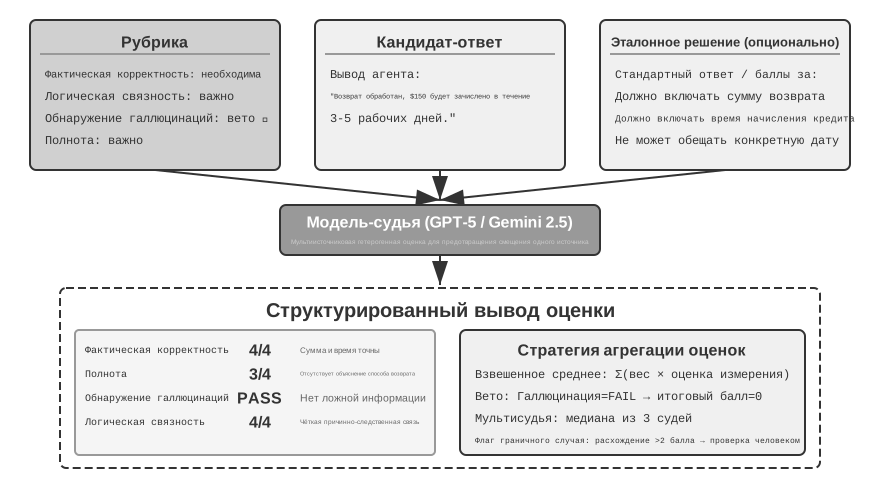
Именно поэтому два инструмента с правой стороны спектра становятся основой продакшен-оценки: Rubric разбивает расплывчатое «хорошо или плохо» на несколько отдельно оцениваемых измерений, а LLM-as-a-Judge выставляет оценку там, где детерминированного критерия нет. Только вместе они позволяют превратить общий процент отказов обратно в конкретные проблемы, за которые можно взяться; вместе с атрибуцией отказов из второй половины этого раздела они образуют полный замкнутый контур оценки продакшен-Agent.
Стоит оговорить: сдвиг вправо не означает отказа от левой части. Всякая проверка, которую можно записать программным утверждением, должна утверждением и остаться, а суждение LLM применяется только к тем измерениям, которые действительно нельзя определить механически. Детерминированные проверки дешевле и стабильнее и лучше подходят для длительного прогона в качестве регрессионных тестов.
Зачем нужен LLM-as-a-Judge? Для открытых задач (например, генерация отчётов, обработка жалоб клиентов, творческий контент) нет эталонного ответа для автоматического сравнения, а оценка человеком дорога и плохо масштабируется. LLM-as-a-Judge позволяет языковой модели выносить оценку по критериям, определённым экспертами (рубрика), достигая баланса между масштабом автоматизации и качеством человеческого профессионального суждения. Но у этого метода есть известные ограничения: модель-судья может иметь собственные предубеждения (наиболее типичное — смещение к длине, склонность ставить более высокую оценку более длинным, подробным ответам, даже если содержание при этом не более верно), а повторная оценка одного и того же входа может давать разные результаты. Смещение к длине заслуживает отдельного внимания; есть три распространённых способа борьбы с ним: явно штрафовать многословность в рубрике и задавать верхний предел длины ответа для однотипных задач; при парном сравнении предварительно выравнивать длину двух кандидатов до сопоставимой; и регулярно проверять корреляцию между оценкой и длиной ответа — если высокие оценки почти всегда сопровождаются длинными ответами, значит, оценка смещена длиной и рубрику нужно пересмотреть. Чтобы системно противостоять этим вызовам, проектирование рубрики должно следовать следующим принципам:
Рубрика (критерии оценки): основа для суждения LLM.
Четыре принципа рубрики (Scale AI, «Rubrics as Rewards»):
(1) Опора на экспертное знание — рубрика должна отражать предметные знания, фиксировать ключевые факты и шаги рассуждения. Например, рубрика для медицинских вопросов-ответов должна включать диагностические критерии и медицинские ошибки, которых нужно избегать; рубрика без профессиональной основы способна уловить лишь поверхностные признаки вроде беглости языка.
(2) Полнота охвата — рубрика должна охватывать фактическую точность, логическую связность, полноту, безопасность, причём определять не только положительные критерии, но и явно фиксировать ловушки (Pitfall) — то есть высокорисковые распространённые ошибки, например рекомендация непроверенных методов лечения в медицинском совете.
(3) Взвешивание по важности критериев — критерии делятся на обязательные (Essential), важные, опциональные и «ловушки». Поддерживается механизм права вето (Veto): например, в сценарии поддержки клиентов галлюцинация (выдумывание ложной информации) — типичный отклоняющий критерий: независимо от того, насколько хорошо агент показал себя по остальным измерениям, при появлении ложной информации оценка обязана быть отклонена. Это также помогает предотвратить обман вознаграждения за счёт нагромождения ключевых слов.
(4) Самодостаточность оценки — каждый пункт оценки должен быть независимо применимым, не полагаясь на предметные знания оценивающего. Нужно избегать абстрактных критериев вроде «ответ демонстрирует глубокое понимание», заменяя их проверяемыми формулировками вроде «сослался как минимум на две авторитетные теории и точно объяснил, как они подтверждают вывод».
Ключевая практика: для каждого измерения определить объективно проверяемые градации оценки, привести конкретные примеры и пограничные случаи, помогающие различать неоднозначные ситуации. Нужно активно предотвращать обман вознаграждения (Reward Hacking) — то есть ситуации, когда агент находит «лазейку» для получения высокой оценки, реально не выполнив задачу — явно штрафуя галлюцинации, угодничество перед пользователем, нагромождение ключевых слов, уклонение от сложных вопросов. Рубрика — продукт итеративной доработки: через пробное применение собираются случаи расхождения между оценивающими, рубрика постепенно совершенствуется, эволюционируя от абстрактных принципов к подробному своду прецедентов.
Возьмём агента памяти пользователя как пример и покажем полную рубрику, соответствующую всем четырём принципам. Тестовый вопрос: «Кто педиатр моей дочери?» (ответ требует связать информацию из двух разных диалогов: в первом диалоге упоминается, что «дочь зовут Lily», во втором — что «водили Lily к Dr. Chen»).
rubric:
  dimensions:
    - name: Фактическая точность
      weight: essential        # обязательный пункт
      scoring:
        4_отлично: "Точно назван Dr. Chen, с привязкой к дочери Lily"
        3_хорошо: "Точно назван Dr. Chen, но не упомянуто, что это врач именно Lily"
        2_удовлетворительно: "Указан верный врач, но с добавлением неуверенной лишней информации"
        1_неудовлетворительно: "Указано неверное имя врача, либо ответ 'не знаю'"

    - name: Полнота информации
      weight: important        # важный пункт
      scoring:
        4_отлично: "Проактивно дополняет релевантную информацию (например, дату последнего визита, диагноз)"
        3_хорошо: "Отвечает на основной вопрос без пропусков"
        2_удовлетворительно: "Отвечает на основной вопрос, но упускает доступную связанную информацию"
        1_неудовлетворительно: "Отсутствует ключевая информация"

    - name: Правильность рассуждения
      weight: important
      scoring:
        4_отлично: "Верно связаны два межсессионных факта: 'дочь = Lily' и 'врач Lily = Dr. Chen'"
        3_хорошо: "Связь верна, но путь рассуждения недостаточно ясен"
        2_удовлетворительно: "Частично верная связь"
        1_неудовлетворительно: "Неверная связь (например, принял собственного врача пользователя за врача дочери)"

    - name: Обнаружение галлюцинаций
      weight: veto             # отклоняющий пункт: при срабатывании общая оценка обнуляется
      scoring:
        pass: "Вся информация прослеживается до истории диалогов"
        fail: "Выдумана информация, отсутствующая в диалогах (например, вымышленная дата визита, диагноз)"

  edge_cases:
    - "Если у пользователя несколько дочерей, наблюдающихся у разных врачей, следует уточнить, о какой дочери речь"
    - "Если в памяти одновременно встречаются 'Dr. Chen' и 'доктор Чен', их следует распознать как одно и то же лицо"
Хорошая рубрика против плохой рубрики: в каждой градации оценки выше указано проверяемое конкретное поведение («точно назван Dr. Chen»), а не описание вроде «продемонстрировано глубокое понимание памяти», которое невозможно объективно оценить. Отклоняющий пункт чётко фиксирует нижнюю границу: даже при максимальных баллах по всем остальным измерениям появление галлюцинации сразу обнуляет оценку.
Рубрику и ответ агента передают модели-судье вместе: она оценивает каждое измерение и объясняет решение. Если сгруппировать результаты десятков случаев по измерениям и воспроизвести траектории с низкими баллами, расплывчатое «успешность снизилась» превращается в конкретный диагноз: поиск пропустил факт, модель неверно связала людей или события либо добавила утверждение без опоры на данные. Хорошая рубрика показывает не только итоговый балл, но и направление следующего расследования.
Ниже мы возьмём пользовательскую память как конкретный случай и покажем, как перевести этот общий метод в исполняемый набор оценки и верификатор.
Эксперимент 7-3 ★★: Построение системы оценки памяти пользователя на основе рубрики
Предварительные требования: необходимо завершить эксперимент с памятью пользователя из главы 3 (chapter3/user-memory-evaluation).
В этом эксперименте требуется модифицировать фреймворк chapter3/user-memory-evaluation из главы 3, обновив текущий механизм оценки, основанный на простом LLM-as-a-Judge, до структурированной многомерной системы оценки на основе рубрики. Существующая система использует единственный вызов LLM, возвращающий пройдено/не пройдено плюс обоснование оценки, и не обладает структурированными диагностическими возможностями.
Спроектируйте единый многомерный фреймворк рубрики, применимый ко всем трём уровням задач. Измерения оценки включают: фактическую точность (Precision — какая доля из всей приведённой информации верна) — проверяет соответствие цифр/дат/имён информации из памяти; фактическую полноту (Recall — какая доля из всей информации, которая должна была быть приведена, действительно упомянута) — проверяет, была ли дана вся релевантная информация, а не только её часть; правильность рассуждения — проверяет, верно ли понята связь между фрагментами информации и подразумеваемая логика; проактивность рассуждения — оценивает, предлагает ли агент в подходящих случаях советы или предупреждения о рисках сверх прямого ответа; обнаружение галлюцинаций — гарантирует отсутствие выдуманной информации, которой нет в памяти.
Используйте четырёхуровневую шкалу оценки (отлично/хорошо/удовлетворительно/неудовлетворительно), каждый уровень с конкретными проверяемыми критериями, а не абстрактным описанием. Измерение галлюцинаций должно быть отклоняющим пунктом с правом вето. Для каждого измерения приведите примеры и пограничные случаи.
Эксперимент 7-4 ★★: Сравнительная оценка Advanced JSON Cards и RAG
Предварительные требования: необходимо завершить эксперименты с памятью пользователя и RAG из главы 3 (chapter3/user-memory, chapter3/agentic-rag-for-user-memory).
Цель: на одном и том же наборе для оценки честно сравнить границы преимуществ структурированной памяти и неструктурированного поиска. Используйте оба проекта из главы 3, на 60 тестовых случаях из chapter3/user-memory-evaluation сравните три конфигурации — чистые Advanced JSON Cards (структурированные карточки постоянно в контексте, без необходимости поиска), чистый RAG (диалоги разбиты на фрагменты и загружены в векторную базу, поиск обязателен), гибридная система (ключевые факты постоянно в контексте + оригинальные диалоги извлекаются по требованию).
Критерии приёмки: на трёх уровнях сложности (базовое воспроизведение / устранение неоднозначности между сессиями / скрытая связь между сессиями) зафиксируйте долю успеха, среднее число шагов, число вызовов инструментов, задержку и стоимость, чётко опишите границы отказа каждого подхода — что теряет структурированный подход, что упускает поиск, есть ли реальная синергия у гибридного варианта. Детали конфигурации и тестовые случаи — в прилагаемом репозитории.
В сопутствующем эксперименте все три системы прошли одни и те же 60 вопросов; сохранено 180 реальных траекторий API. В таблице 7-3 проценты приведены вместе с числом успешных случаев.
Таблица 7-3. Успешность систем памяти по уровням задач
Система
Базовое воспроизведение
Неоднозначность между сессиями
Скрытые связи между сессиями
Итого
Advanced JSON Cards
95%
60%
50%
68.3% (41/60)
RAG
90%
40%
15%
48.3% (29/60)
Гибрид
80%
70%
50%
66.7% (40/60)
Больше всего заслуживает внимания то, что гибридное решение не победило само собой. В 3 вопросах оно сделало то, чего не смогло ни одно из двух одиночных решений, но ещё в 8 вопросах уступило лучшему из них; по сравнению с лучшим одиночным решением на каждом вопросе его средняя доля успеха оказалась даже ниже. Чистый RAG не сильно отставал от структурированных карточек в вопросах базового припоминания, но на вопросах о связях между сессиями его доля успеха падала до 15%. Ещё одна легко упускаемая цифра: из 180 суждений вето по галлюцинациям сработало 28 раз — видно, насколько важен пункт абсолютного вето.
Проблема одноисточниковой модели и многоисточниковое суждение.
Когда агент и модель-судья принадлежат к одному и тому же семейству, агент может научиться использовать предпочтения и слепые зоны модели-судьи.
Это именно то, о чём говорит закон Гудхарта (Goodhart’s Law): когда метрика становится целью оптимизации, она перестаёт быть хорошей метрикой. Чем сильнее агент обучается или настраивается по конкретной системе оценки, тем сильнее он склонен искать лазейки в этой системе вместо реального улучшения возможностей.
Ещё более незаметно то, что агент может постепенно научиться избегать типов ошибок, которые модель-судья плохо распознаёт, из-за чего система оценки будет выглядеть так, будто всё в порядке.
Стратегия смягчения — многоисточниковое гетерогенное суждение: используются несколько LLM разных семейств моделей для независимой оценки (например, если агент построен на Claude, для судейства используются GPT-5 и Gemini) — предубеждения разных семейств моделей часто ортогональны, и агенту сложно одновременно «обмануть» всех судей. Одна и та же рубрика используется для всех, чтобы гарантировать оценку по единой цели, а итоговый результат агрегируется через взвешенное усреднение или проверку согласованности. На этапе развёртывания можно использовать одну модель для быстрой оценки, но следует регулярно проводить аудит качества с полным многоисточниковым суждением.
Многоисточниковое суждение решает вопрос «какой моделью судить»; следующий вопрос — «какие модальности оценивать»: расширение возможностей LLM-as-a-Judge с текста на речь, изображения, видео — ещё одно измерение полноты оценки.
Мультимодальный LLM-as-a-Judge.
Мультимодальное суждение расширяет LLM-as-a-Judge на области речи, изображений, видео; ниже приведены четыре распространённых направления.
Оценка TTS (TTS — Text-to-Speech, синтез речи из текста): оценивается точность, естественность, согласованность тембра, эмоциональная выразительность. Эти измерения выявляют проблемы просодии, которые традиционный WER (Word Error Rate, доля ошибок в словах) не способен уловить.
Оценка ASR (ASR — Automatic Speech Recognition, распознавание речи): выполняется оценка семантического воздействия ошибки — ошибка распознавания «сегодня погода» не критична, но если «перевести тысячу» распозналось как «перевести десять тысяч», последствия могут быть серьёзными.
Оценка UI: используется механизм предложитель-рецензент (Proposer-Reviewer) для проверки таких проблем, как переполнение текста, контраст цветов, расположение кнопок. Здесь предложитель-рецензент применяется как метод оценки, в отличие от использования в главе 5 в качестве компонента генерирующей системы, но базовый механизм тот же — одна модель генерирует, другая независимо проверяет.
Оценка видеомонтажа: по ключевым кадрам проверяется правильность точек начала/конца монтажа и применения эффектов.
Эксперимент 7-5 ★★: Построение полностью автоматизированного конвейера оценки качества TTS
В этом эксперименте требуется с нуля спроектировать и реализовать полную систему оценки качества TTS на базе мультимодального LLM-as-a-Judge.
Спроектируйте многомерную рубрику для TTS: измерение точности проверяет, правильно ли озвучен весь текст (без пропусков/неверного произношения/добавлений), измерение естественности оценивает плавность речи (наличие механического звучания, неестественных пауз, соответствие просодии человеческим нормам), измерение эмоциональной выразительности проверяет, соответствует ли интонация эмоциональной окраске текста (повышение тона в вопросительных предложениях, акцент в восклицательных, замедленный темп и пониженный тон для грустного содержания), измерение согласованности тембра при наличии референсной записи оценивает степень схожести говорящего (мультимодальная модель одновременно получает референсную запись и синтезированную речь для сравнения).
Постройте разнообразный тестовый корпус по длине, жанру, эмоциям и особым трудностям. Подключите TTS-модуль к основным сервисам (OpenAI, ElevenLabs, Fish Audio, Minimax, Doubao), затем передайте синтезированную запись, исходный текст, референс и рубрику мультимодальному судье, который способен принимать аудио напрямую. Сохраняйте модель-судью и хэши референсной и кандидатной записей, чтобы каждую оценку можно было проверить.
В сопутствующем репозитории сохранён небольшой опыт прямого прослушивания. OpenAI и Fish Audio создали по четыре записи: числа, многозначные китайские иероглифы, длинный текст и эмоциональная подача; Voxtral оценил все восемь записей по четырём измерениям. Обе системы получили 5.00 за точность и 4.00 за естественность. Fish Audio набрал 4.00/3.00 за эмоцию и согласованность голоса, OpenAI — 3.75/2.75. Раздельные измерения выявили различия, которые не видны из простого вопроса «текст прочитан верно?».
Эти оценки не определяют лучшего провайдера. На каждого пришлось всего четыре записи, а фиксированный референс был создан Fish S1, что изначально благоприятствовало Fish Audio по сходству голоса. В общем сравнении TTS этот критерий следует убрать или дать каждому кандидату подходящий целевой голос. При сравнении клонирования все системы должны имитировать одного говорящего, а модель-судью нужно калибровать по слепому человеческому прослушиванию. Выбор эталонного ответа, изображения или аудио — часть дизайна оценки, а не нейтральная подготовка.
Ручные рубрики быстро задают такие диагностические измерения. В большем масштабе оценку можно автоматизировать специализированной генеративной моделью вознаграждения; её обучение рассматривается в главе 8.
Оценка, которую даёт судейская модель, говорит лишь о том, хорош результат или плох; чтобы превратить результат в исправимую проблему, нужно ещё определить, с какого именно шага началась неудача.
Атрибуция отказов: локализация первой ошибки в траектории
Сквозная оценка часто сообщает лишь «успех» или «отказ». Чтобы результат приводил к исправлению, для каждой неудачной траектории запишите категорию, первый неприемлемый шаг, связанный вызов инструмента или вывод модели и проверяемое доказательство. Источниками bad case служат явное исправление пользователя, отрицательная реакция или последующая проверка состояния и правил. LLM может помочь, но человеческий разбор обязателен: причина нередко лежит в продукте, а не только в коде.
Для Coding Agent начальная классификация включает пропущенный процесс или правила репозитория, ошибки инструмента/формата, аномальное завершение и ошибки логики или полноты. Сохраняйте JSON/YAML с номером шага, инструментом, наблюдением, корнем и последствиями, восстановимостью и уверенностью, а также состоянием, версиями и полной траекторией.
Чтобы построить систему атрибуции отказов, разработчику придётся терпеливо читать и разбирать проблемные траектории из продакшена. LLM в этой работе помогает, но не заменяет человека: атрибуция отказов часто вскрывает продуктовые проблемы, а не только технические.
По мере доработки продукта классификация ошибок обрастает несколькими крупными классами, под каждым — подклассы, и в итоге счёт идёт на сотни. Эти классы и способы атрибуции затем становятся промптом или Skill для агента-разметчика атрибуций.
Для Coding Agent рабочая начальная классификация выглядит так.
Класс ошибки
Типичное проявление
Как найти первую ошибку
Понимание требований и неоднозначность
Сделано не то, о чём просил пользователь: потеряно одно из условий требования, объём понят шире или уже нужного; в репозитории два конфигурационных файла с одинаковым именем, и один выбран без пояснений и без вопроса
С помощью LLM сопоставьте исходное требование с тем, что Агент сделал на самом деле (последовательностью действий), пункт за пунктом; найдите первое расхождение на уровне результата и вернитесь к вызову инструмента или к ответу, который его породил
Отсутствие процесса или соглашений
Коммит без прогона юнит-тестов; правка кода до написания плана; внешняя зависимость там, где в репозитории уже есть внутренний аналог; обход принятого архитектурного соглашения
Найдите первое действие, нарушающее соглашение о процессе разработки, — первый git commit, первую запись файла — и проверьте, читал ли Агент до этого источник соглашения
Ошибки вызова инструментов
Повторно неудачные правки одного и того же файла; неверный формат JSON/schema или аргументов; спецсимволы, ломающие перенос, экранирование или запись
Зафиксируйте первую неудачную правку или инструмент вместе с исходным запросом и возвращённой ошибкой; повторные неудачи — это последующие симптомы
Взлом среды проверки
Правка утверждения, добавление skip, подмена тестируемой логики моками; заявление «тесты прошли» без единого запуска
Возьмите первое сообщение, изменившее тест или логику проверки, а затем сверьте заявление о завершении с командами, реально выполненными в траектории, чтобы убедиться, запускались ли они
Неполная правка
Изменена сигнатура функции, обновлены три места вызова, а четвёртое — динамический вызов, привязка на другом языке, schema — пропущено
Возьмите разность между заявленной Агентом областью влияния и фактической, выберите первый пропуск и посмотрите, по каким ключевым словам он искал
Неверная информация, сообщённая пользователю
Вызовы инструментов и конечное состояние верны, а сказанное пользователю — нет: не та сумма, статус или время; частичное выполнение выдано за полное; пропущено обязательное уведомление
Сопоставьте каждое фактическое утверждение ответа со значениями, возвращёнными инструментами, и возьмите первое, которое нельзя проследить или которое противоречит возврату
Нефункциональная регрессия
Публичный API или schema изменены без скрипта миграции; валидация удалена, чтобы проверка прошла
Возьмите первое сообщение, внёсшее это изменение, и посмотрите, осознавал ли Агент, что трогает публичный интерфейс или структуру, требующую миграции
Аномальное завершение модели
Вывод обрывается на середине, останов без причины, тайм-аут или завершение без финального действия
Найдите первое аномальное завершение и разделите останов модели, тайм-аут Harness и сбой сервиса инструмента
Слишком раннее прекращение задачи
Выполнена лишь часть многоцелевой задачи; объявление невозможности без перебора разумных вариантов
Найдите первое решение, отбросившее цель или прекратившее поиск, и зафиксируйте его отдельно от финального провала проверки
Агент-разметчик может с помощью LLM в промышленных масштабах проводить анализ первопричин по множеству продакшен-траекторий, но выдавать одну фразу «причина отказа» недопустимо. Запись атрибуции должна быть структурированной: JSON или YAML со ссылками на конкретные номера шагов, имена инструментов и наблюдаемые свидетельства; кроме того, она обязана разделять первопричину и следствие, оценивать восстановимость и указывать уверенность. Например, edit_file возвращает несовпадение old_string, после чего Агент трижды повторяет попытку и так и не записывает файл: главная причина — ошибка правки файла и вызова инструмента, а три повтора суть следствия, а не три независимые первопричины. Если сразу проявляется несколько классов, главный выбирают по правилу «самый ранний и объясняющий последующие отказы», остальные оставляют второстепенными. Как минимум три класса из таблицы выше можно предварительно отфильтровать правилами, прежде чем поручать LLM локализацию первой ошибки: сверка заявления о завершении с реально выполненными командами; затрагивает ли diff тестовые утверждения и метки skip; меняет ли diff публичный API или schema без файла миграции. Сначала правила, затем LLM — это и дешевле, и точнее, чем скармливать модели все траектории подряд.
Сохраняя запись атрибуции, храните не только вывод LLM: приложите цель задачи, состояние среды, версию Агента, версию набора инструментов и полную траекторию — тогда случай можно будет превратить в регрессионный тест.
Ниже подробнее разобраны три характерных класса ошибок.
Проблема «сделал верно, доложил неверно»
«Сделал верно, доложил неверно» — категория, которую общая доля успеха скрывает лучше всего, потому что большинство оценок проверяет только состояние среды. τ²-bench оценивает её отдельно: из 704 опубликованных базовых прогонов, чья задача несёт требование информирования, 240 провалились, 162 из них не прошли проверку информирования, а 80 — треть всех отказов — имели верное состояние среды и неверный доклад.
В сопутствующем репозитории есть соответствующий случай. Получив задание внести расходы из expenses.jpg в приложение учёта, Агент потратил 32 шага на выдачу разрешений, поиск, открытие изображения, заполнение каждой строки и сохранение, и ни один шаг не вернул ошибку, после чего объявил задачу выполненной; валидатор сообщил, что строка, которую следовало записать, — Dress, ¥436,35 — отсутствует и не имеет отношения к четырём внесённым. На шаге 8 в его собственном рассуждении написано: «I cannot actually see the content/details of the expenses in the image». Он уже знал, что данных нет, не остановился и не сообщил об этом, а к шагу 11 в его записях появились четыре выдуманных расхода, которые каждый последующий ввод исполнял в точности. Первая ошибка — шаг 8, и этот шаг не породил ошибки и не был вызовом инструмента. Её первопричину тоже легко записать не туда: T3A — чисто текстовый Агент, в пространстве наблюдения которого есть только дерево элементов и нет пикселей изображения, поэтому причина не в том, что «модель не умеет OCR», а в отсутствующем канале наблюдения и отсутствии legального выхода «информация недоступна». Записав это как проблему способностей модели, дальше меняют модель или учат OCR; настоящее исправление — добавить канал и выход.
Эксперимент 7-6 ★★: атрибуция отказов на трассах AndroidWorld
Эксперимент отрабатывает метод атрибуции из этого раздела на реальных трассах: ни эмулятор, ни API модели не нужны. Материал — сохранённый прогон T3A в chapter7/android-world: t3a.md содержит пошаговые Action/Reason/Summary по всем задачам, а t3a_failed.md собирает более пятидесяти неудачных трасс, каждая из которых заканчивается объективным вердиктом валидатора.
Шаг 1: выборка. Возьмите из t3a_failed.md не менее десяти тихих отказов — трасс, где нет ни одной ошибки инструмента. Ни один вызов не вернул ошибку, Агент либо объявил задачу выполненной, либо исчерпал шаги, и только финальный вердикт валидатора фиксирует провал.
Шаг 2: локализация первой ошибки. Для каждой трассы зафиксируйте номер шага первой ошибки и укажите, вызов это инструмента или assistant message. Тихие отказы требуют двух приёмов: сверка с фактическими якорями сопоставляет утверждения Агента со значениями, возвращёнными инструментами, и берёт первое расхождение; бинарный поиск по префиксу траектории обрезает траекторию на шаге k и передаёт её дальше — если её ещё можно спасти, ошибка лежит после k. Поиск ключевых слов об ошибке ни одного из них не заменяет.
Шаг 3: структурированные записи. Для каждой трассы выпустите запись JSON или YAML с именем задачи, шагом первой ошибки, категорией ошибки, ответственной стороной, подтверждающими цитатами и разделением первопричины и следствия.
Шаг 4: сверка с готовыми заметками. Сравните результат с t3a_failed_analysis.md и запишите все расхождения. Особое внимание — атрибуции первопричины: в заметках сбой распознавания изображения был записан как «зрительная модель не умеет OCR», однако в пространстве наблюдения T3A вообще нет пикселей изображения, так что настоящая причина — отсутствующий канал наблюдения. Готовая заметка об атрибуции не является эталонным ответом.
Шаг 5: преобразование в регрессионные задачи. Выберите три трассы, где первая ошибка приходится на assistant message, обрежьте префикс непосредственно перед ней и опишите множество допустимых действий и запрещённые действия — получатся регрессионные задачи по префиксу траектории.
Ошибки форматирования документа, зависящие от области
Когда пользователь говорит «кавычки неправильные», это нельзя превращать в глобальную замену символов. Как минимум нужно различать прямые кавычки ASCII (", '), китайские типографские кавычки (“”, ‘’) и обратные апострофы Markdown (`). Один и тот же символ играет разную синтаксическую роль в китайской прозе, в цитируемом английском оригинале, во встроенном коде, в блоках кода, в комментариях, в JSON и в путях.
Данные оценки следует сначала разобрать на фрагменты с областью действия — например ZH_PROSE, EN_PROSE, QUOTED_SOURCE, INLINE_CODE, CODE_BLOCK, CODE_COMMENT и JSON_OR_SCHEMA. Для каждого фрагмента сохраняются множество допустимых преобразований, символы, которые обязаны быть защищены, и результат валидатора после правки. Три случая ниже нельзя обработать одним правилом замены:
Китайская проза: вызвать метод `reset()`.Цитируемый английский оригинал: “Please restart the service.”# блок кода ниже лишь иллюстрирует защищённую область# Китайский комментарий: показать "текущее состояние"name = "status"
Регрессия по префиксу траектории должна требовать от модели минимальной правки и одновременно проверять стиль китайского документа, долю сохранённого английского оригинала, синтаксис кода и JSON, а также редакционное расстояние на нецелевом тексте. Когда правила не позволяют определить область, сохранение исходного текста и запрос уточнения должны считаться разрешённым действием, а не догадкой, которая случайно прошла проверку.
Ошибки точного копирования: от old_string mismatch к послойной локализации
Сбой old_string тоже нельзя списывать лишь на «модель переписала неверно». Для одной и той же строки следует сохранять хеш исходных байтов, последовательность code point Unicode и последовательность token ID токенизатора, а затем искать первое расхождение по этой цепочке:
Минимальный набор оценочных проб покрывает прямое воспроизведение, извлечение из длинного контекста, помещение в аргументы инструмента, выбор среди похожих строк, а также пробелы, переводы строк, обратные слэши, комбинирующие символы Unicode и низкочастотные токены. Метрики — byte-exact match, code-point-exact match, token-exact match, позиция первого расхождения и реальная доля успешных вызовов инструмента. Если на прямой пробе модель отвечает верно, а вызов инструмента всё равно падает, чинить нужно токенизатор, сериализацию, Harness или протокол инструмента; и только когда первое расхождение появляется в выводе самой модели, случай следует превращать в данные для обучения копированию из главы 8.
Сквозные регрессионные задачи и регрессионные задачи по префиксу траектории
Атрибуция определила первую ошибку и её класс; следующий шаг — записать цель исправления как воспроизводимый тест, то есть регрессионную задачу (regression task). Здесь нужны два взаимодополняющих слоя. Сквозные регрессионные задачи проверяют, что правка не сломала весь рабочий процесс; регрессионные задачи по префиксу траектории (trajectory prefix) вырезают состояние прямо перед первой ошибкой и проверяют только, исправлена ли эта граница решения.
Сквозные регрессионные задачи начинаются с исходного состояния и запроса пользователя, дают Агенту выполнить задачу целиком и проверяют конечное состояние, необходимый вывод и условия безопасности. Они ближе всего к продакшен-результату, но по ним трудно понять, на каком шаге произошёл отказ. Как правило, сквозные задачи проверяют, что способности Агента в каждой области соответствуют ожиданиям. Описанные в этой главе стандартные наборы — OSWorld, AndroidWorld, tau-bench — все являются сквозными регрессионными задачами.
Регрессионные задачи по префиксу траектории замораживают уже имеющийся контекст, диалог, ответы инструментов и состояние среды и требуют от Агента лишь обдумать и выполнить следующее наблюдаемое действие или несколько. Они дешевле и позволяют изолировать проблему одной политики или одного инструмента. Для продакшен-Агента, которому нужна высокая надёжность, набор префиксных задач нередко важнее сквозного, и он требует терпеливо выстроить описанные в предыдущем разделе классификацию отказов и систему атрибуции.
Ответ префиксной задачи следует определять как множество допустимых действий, а не как единственное действие или единственный ответ: можно требовать «сначала прочитать правила репозитория», «сначала спросить пользователя» или «отказаться от опасной операции», одновременно перечисляя запрещённые действия.
После завершения атрибуции можно собрать набор данных для оценки, включающий и сквозные, и префиксные регрессионные задачи. Для Coding Agent: отсутствие процесса должно порождать сквозную задачу с документом плана и условиями приёмки тестов; ошибка вызова инструмента — обрезаться по сбойному префиксу и превращаться в граничную задачу, проверяющую, сумеет ли модель исправить формат, экранировать спецсимволы или сменить инструмент; аномальное завершение — добавлять сценарии восстановления после обрыва, тайм-аута и сбоя инструмента; ошибки полноты и логики — добавлять многоцелевые чек-листы, напоминания об оставшейся работе и границу «ещё не доказано, что невозможно»; класс понимания требований и неоднозначности — замораживать в префикс задачи с несколькими разумными прочтениями и вносить «сначала уточнить» в множество допустимых действий; класс симптоматических правок и подделки проверки — добавлять в приёмку два жёстких ограничения: «тестовые утверждения изменять нельзя» и «заявление о завершении обязано сопровождаться выводом реально выполненной команды»; класс информирования пользователя — ставить утверждения на само содержание ответа, а не только на состояние среды.
Набор данных для оценки — основа постобучения из главы 8 и самоэволюции Агента из главы 9.
Эксперимент 7-7 ★★: Оценка границ префикса в нескольких представлениях
Модель получает известную память пользователя, текущую инструкцию, префикс траектории, ответы инструментов и состояние среды и выдаёт только следующее наблюдаемое действие. Одиннадцать случаев закодированы как JSON Cards, Markdown и Python-like и проверяются детерминированными правилами. Все 33 ячейки завершились без ошибок API; каждое представление прошло 6/11, поэтому одна смена формы контекста не исправляет политику его применения.
При практическом выборе модели часто встаёт вопрос: «Что лучше, A или B?» Парное сравнение даёт способ оценки, не зависящий от абсолютных оценок.
Парное сравнение и ранжирование моделей
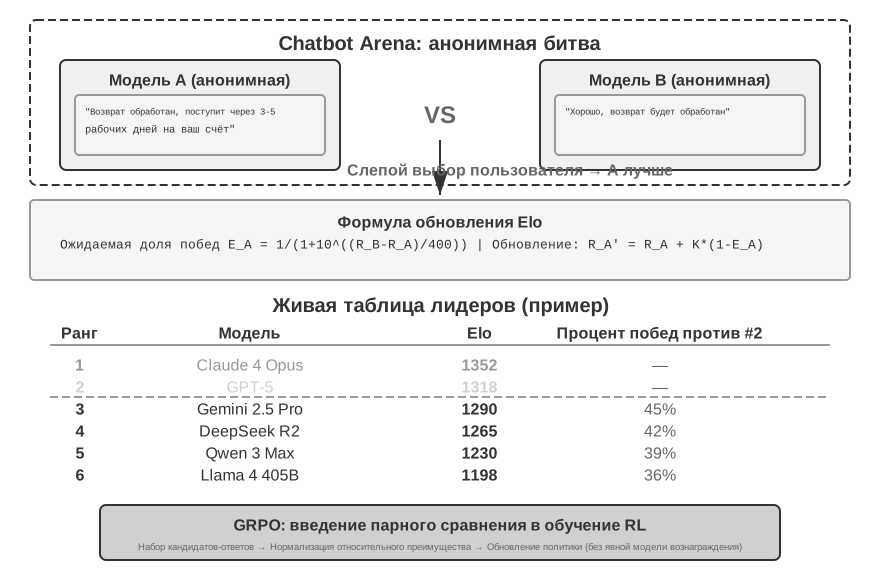
Рис. 7-6 Рейтинг Elo и ранжирование по парным сравнениям · Исходный рисунок
Рейтинг Elo (система ранжирования, изначально применявшаяся в шахматах) количественно оценивает относительные способности моделей через большое число попарных противостояний: чем больше разница в очках, тем выше ожидаемая доля побед у более сильной стороны. Например, если модель A набрала 1200 очков, а модель B — 1000, система Elo предскажет вероятность победы A примерно в 76%. Если B неожиданно побеждает, B получает больше очков, а A теряет больше — неожиданный результат вызывает более сильную корректировку очков, и этот механизм позволяет рейтингу быстро сходиться к реальному уровню сил. Статистической основой здесь служит модель Брэдли-Терри: каждая модель абстрактно представляется в виде скрытого «показателя силы», а вероятность победы в попарном противостоянии определяется разницей этих показателей; Elo — это инженерная реализация данной модели в форме онлайн-обновления.
Chatbot Arena использует анонимные случайные противостояния — пользователь, не зная, какой модели принадлежит каждый ответ, вслепую выбирает лучший вариант, и на основе миллионов таких голосований формируется рейтинг. Преимущество этого метода в том, что не требуется определять «абсолютный эталон» — достаточно человеческого суждения «что лучше, A или B». Но есть и ограничения: итоговый рейтинг зависит от того, какие вопросы задавали пользователи — если многие пользователи случайно задавали вопросы про программирование, модель, сильная в программировании, получит завышенный рейтинг, что не обязательно отражает её реальный уровень на других задачах.
Когда парное сравнение выполняет LLM, а не человек-голосующий, нужно дополнительно учитывать позиционное смещение (Position Bias) — модель-судья может систематически отдавать предпочтение кандидату, находящемуся в определённой позиции (обычно первому), даже если содержимое двух кандидатов полностью поменять местами, вердикт может не измениться. Стандартный способ смягчить это — оценивать дважды, меняя порядок местами: один раз A идёт первым, второй раз первым идёт B, а результат усредняется; более строгий подход — засчитывать только те случаи, когда оба вердикта совпадают, а при расхождении фиксировать ничью или отправлять на ручную проверку. По сути Chatbot Arena делает то же самое — случайным образом определяет позицию показа двух ответов, так что на больших выборках позиционное смещение взаимно компенсируется.
Эксперимент 7-8 ★★: построение рейтинга моделей на основе данных парных сравнений
Данный эксперимент реализует систему расчёта рейтинга Elo с нуля, что позволяет глубже понять, как модель Брэдли-Терри извлекает относительные оценки способностей из большого числа парных сравнений. Используется открытый набор реальных данных голосований Chatbot Arena (содержащий миллионы слепых голосований пользователей).
Реализуйте алгоритм итеративного обновления рейтинга Elo: изначально всем моделям присваивается 1000 очков, записи голосований обрабатываются в хронологическом порядке. Для каждого противостояния вычисляется ожидаемая доля побед на основе текущей разницы очков двух моделей, фактический результат сравнивается с ожидаемым, и по фиксированной скорости обучения происходит корректировка — победитель получает очки, проигравший теряет, причём величина корректировки пропорциональна отклонению от ожидания (неожиданное поражение приводит к более значительному изменению очков). Отсортируйте модели по убыванию итогового рейтинга и вычислите матрицу попарных вероятностей побед, сравните с официальным рейтингом — достаточно убедиться, что ранжирование в целом совпадает. Не стоит требовать точного совпадения баллов: официальный рейтинг Chatbot Arena использует метод максимального правдоподобия для модели Брэдли-Терри (решается за один проход по всем матчам, не зависит от порядка голосований), тогда как здесь реализуется онлайн-инкрементальное обновление Elo (результат зависит от коэффициента обучения K и порядка обработки) — оба алгоритма должны совпадать по общему ранжированию, но конкретные значения баллов не будут точно совпадать.
Во второй части эксперимента создайте анимацию эволюции исторического рейтинга: разбейте данные голосований по времени (по неделям или месяцам), для каждой временной точки вычислите снимок рейтинга Elo. Используйте D3.js для реализации анимации «гонки столбчатых диаграмм» (длина горизонтального столбца = рейтинг, вертикальная позиция = место в рейтинге, плавное изменение во времени). Наблюдая за анимацией, выявите моменты технологических прорывов (резкий скачок рейтинга у какой-либо модели), эволюцию конкурентной картины, жизненный цикл моделей.
Выбор модели на основе оценки
Выбор модели — это не простое «выбрать самую сильную», а компромисс, основанный на оценке, между несколькими измерениями в зависимости от сценария применения.
Ключевые измерения выбора
Пропускная способность и задержка — две группы показателей, которые легко перепутать; чтобы их разграничить, достаточно знать, что вывод больших моделей делится на два этапа. Prefill (предзаполнение) за один проход считывает весь контекст и определяет задержку до первого символа — от момента, когда пользователь нажимает Enter, до появления первого символа (в индустрии измеряется показателем TTFT, Time To First Token) — чем длиннее контекст, тем медленнее prefill и тем больше TTFT. Decode (декодирование) затем генерирует ответ токен за токеном и определяет скорость появления последующих символов (токенов в секунду), а также напрямую влияет на длительность размышления: модель со скоростью 50 токенов/с, генерирующая 2000 токенов размышления, потратит на одно только размышление 40 секунд.
Вокруг этих двух этапов строятся основные показатели пропускной способности и задержки:
Входная / выходная пропускная способность: соответствуют скорости Prefill и Decode соответственно.
TTFT: равен времени ожидания в очереди плюс время Prefill, отражает воспринимаемую пользователем «скорость реакции».
Задержка размышления: количество генерируемых токенов размышления у разных моделей может различаться в разы, причём длина размышления не всегда положительно коррелирует с качеством результата — стоит на своей реальной нагрузке измерять объём токенов размышления и соответствующую отдачу для каждой модели, а не полагаться только на публичные рейтинги.
Хвостовая задержка p95: задержка, которую не превышают 95% запросов. Она лучше отражает реальный пользовательский опыт, чем среднее значение — среднее занижается большим количеством быстрых запросов, скрывая серьёзные зависания у меньшинства пользователей.
Стоимость: цены за входные/выходные/кэшированные токены. Стоимость не следует оценивать изолированно — дешёвая, но малоуспешная модель, требующая частых повторных попыток, на практике может обходиться дороже. Нужно рассчитывать среднюю стоимость на задачу и соотношение стоимость-эффективность.
Производительность: точные определения показателей Pass@1, Pass^k, Pass@k, Best@k приведены ранее в разделе «Система метрик оценки», здесь речь только о том, как выбирать между ними в контексте выбора модели — для повседневных сценариев смотрят на самый распространённый Pass@1 (среднюю долю успеха за один прогон); для критически важных операций приоритет отдаётся Pass^k, который отслеживает стабильность «не ошибиться ни разу»; для исследовательских задач предпочтительнее Pass@k или Best@k, показывающие потолок возможностей при достаточном числе попыток; для открытых задач используется многомерная оценка по рубрикам (Rubric).
Лимиты скорости и надёжность: ограничения RPM (запросов в минуту) / TPM (токенов в минуту) влияют на возможности параллелизма, а некоторые API могут динамически менять лимиты в часы пик. С точки зрения устойчивости важно учитывать данные вне распределения, состязательные входы, стабильность при длительной работе (не возникает ли коллапс режима, рассеивание внимания и другие проблемы).
Кривая «бюджет—способность»: одной оценки при фиксированном бюджете недостаточно, чтобы понять, справится ли Agent с долгой задачей. Помимо доли успехов следует показывать, как результат меняется с реальным временем, числом токенов и вызовов инструментов или вычислительным бюджетом. RE-Bench наглядно демонстрирует различие: при суммарном бюджете в два часа на среду лучший Agent набрал примерно в четыре раза больше баллов, чем эксперты-люди; однако люди получили большую отдачу от дополнительного времени, немного обогнали лучший Agent за восемь часов и при 32 суммарных часах в нескольких попытках набрали примерно вдвое больше1. Поэтому лидерство на коротком бюджете нельзя напрямую переносить на длительную работу: при выборе модели нужно сравнивать несколько бюджетов, близких к реальной продолжительности задачи.
На практике можно применять стратегию совместного использования нескольких моделей: лёгкая модель обрабатывает простые запросы для снижения затрат, мощная модель — сложные задачи для обеспечения качества; либо использовать специализированные модели для конкретных подзадач (например, понимание изображений, генерация кода), координируя работу через механизм суб-агентов. Такая гетерогенная комбинация требует проверки через оценку, чтобы подтвердить, что общая выгода превышает добавленную сложность системы (например, вопросы вроде «что больше — 9,9 или 9,11?» или «хочу помыть машину, мойка в 50 метрах от дома — идти пешком или ехать?» сочли простыми и отдали лёгкой модели, из-за чего решение оказалось ошибочным).
Поведение модели: когда перестать читать и начать редактировать
При выборе модели важно сравнивать не только способность завершить задачу, но и то, как модель ведёт себя по умолчанию. Одно из легко наблюдаемых различий Coding Agent — порог действия. Получив одну и ту же задачу, одни модели широко исследуют репозиторий и проверяют архитектуру, места вызова и тесты до правки. Другие локализуют изменение по меньшему объёму данных, рано редактируют код и дополняют понимание обратной связью тестов. Первые выше оценивают цену преждевременной правки; вторые — альтернативную стоимость чтения ещё одного файла.
У такой склонности агента два источника: системный промпт в Harness и поведенческая политика модели. Ключевой источник этой политики — постобучение: траектории SFT показывают, «до какой степени читать, прежде чем браться за дело», процессная награда поощряет или наказывает тот или иной путь по инструментам, а итоговая награда подкрепляет всю стратегию, приведшую к успеху. Со временем модель усваивает не только то, как писать код, но и инженерные привычки.
Эксперимент 7-9 ★★: Измерение порога действия модели в фиксированном Coding Harness
Цель: изолировать фактор модели, количественно оценить выбор Coding-моделей между продолжением сбора информации и началом редактирования, а также совместно оценить эффективность пути и итоговое качество.
Метод: запустите chapter6/model-action-threshold/experiment.py. По умолчанию GPT-5.6-sol и Claude Sonnet 5 вызываются через один OpenRouter OpenAI-compatible endpoint при фиксированных системном промпте, схемах инструментов, репозиториях задач, командах тестирования и пределе ходов. Нейтральный промпт не задаёт ни минимального числа прочитанных файлов, ни требования редактировать быстро. Повторите каждую из трёх категорий задач не менее трёх раз и чередуйте порядок моделей. Записывайте вызовы инструментов, прочитанные файлы, поиски и фактическое время до первой правки, а также успешность первого протестированного патча, доработки после теста, финальный успех, изменённые файлы и расход Token.
Причинная интерпретация: нейтральная кампания проверяет, меняется ли поведение вместе с моделью внутри одного Harness. Чтобы измерить модифицирующее влияние Harness, отдельно запустите кампанию с --policy explore-first; не смешивайте две policy в одном сравнении моделей. Поведение, которое меняется при замене модели и сохраняется для той же модели между Harness, сильнее свидетельствует об эффекте модели; обратная картина сильнее указывает на эффект Harness.
Критерии приёмки: все автономные модульные тесты проходят; предварительно подтверждено, что каждый fixture задачи в исходном состоянии проваливает тесты; формальный результат содержит все ячейки модель × задача × повтор, ноль ошибок API, независимый финальный тест и проверяемые траектории; manifest.json подтверждает хеши конфигурации, наблюдений и сводки. В каталоге проекта сохранён полный прогон 18/18 ячеек. Читателям следует повторить его на нужных версиях моделей и реальных рабочих нагрузках, а не считать числа этих мини-репозиториев постоянным рейтингом.
Анализ стоимости системы агента
В предыдущем разделе стоимость была названа одним из ключевых измерений выбора модели, но в сценариях с агентами стоимость намного сложнее простого прайсинга по токенам — многошаговые рассуждения, вызовы инструментов и накопление контекста приводят к нелинейному росту затрат. Систематический анализ стоимости — неотъемлемая часть системы оценки и необходимая предпосылка для развёртывания в продакшене.
Составляющие стоимости.
Стоимость системы агента можно разложить на три уровня:
Стоимость вывода модели — самая непосредственная часть, определяемая расходом входных и выходных токенов. Но в сценариях с агентами есть два часто игнорируемых усиливающих фактора. Первый — эффект накопления контекста: при каждом вызове LLM агент отправляет вместе с запросом всю предыдущую историю диалога и результаты выполнения инструментов (чтобы модель могла понять контекст). Если не использовать KV Cache должным образом (то есть кэширование уже обработанного контекста во избежание повторных вычислений), рост стоимости может быть очень быстрым — на 1-м шаге отправляется 1000 токенов, на 2-м — 2000, на 3-м — 3000, суммарно 1000+2000+3000=6000, а не 3×1000=3000, и разрыв растёт с числом шагов. Второй — стоимость токенов размышления: модели с поддержкой размышления генерируют большое количество токенов размышления, которые хоть и не показываются пользователю, но также учитываются при оплате.
Стоимость вызова инструментов включает плату за внешние API (поисковые системы с оплатой за запрос, запросы к базам данных, потребляющие вычислительные ресурсы), ресурсы песочницы для выполнения кода, а также легко упускаемую косвенную статью — стоимость токенов, возникающую при внедрении результатов инструментов в контекст. Один результат веб-поиска может занимать 2000-5000 токенов, и эти токены будут учитываться повторно в каждом последующем шаге рассуждения как входные данные.
Инфраструктурная стоимость охватывает векторные базы данных (для RAG-поиска), очереди сообщений, реляционные базы данных, хранилища логов и трассировок (для наблюдаемости) и другие эксплуатационные расходы.
Чтобы увидеть реальные источники затрат, в сопутствующем эксперименте использован фиксированный восьмишаговый процесс возврата: запрос заказа, доставки, политики возврата и базы знаний, затем проверка риска, возврат, уведомление и закрытие обращения. Реальные вызовы gpt-4o-mini выполнялись во всех четырёх комбинациях двух переключателей: стабильный или нестабильный префикс, полная или сжатая история. Бизнес-процесс во всех ветвях был одинаков; таблица 7-4 использует сохранённые числа токенов и цены.
Таблица 7-4. Измеренная стоимость восьмишагового процесса агента
Конфигурация
Входные токены
Кэшированные токены
Общая стоимость
Экономия к базе
Без кэша и сжатия
20,700
0
$0.003776
—
Только стабильный префикс
20,386
13,568
$0.002707
28.3%
Только сжатие истории
16,177
0
$0.003115
17.5%
Стабильный префикс + сжатие
16,035
6,144
$0.002643
30.0%
В базовой ветви вход вырос с 1,113 токенов на первом шаге до 3,668 на последнем. Результаты инструментов повторно попадали в последующие запросы и дали 9,544 входных токена. С двумя оптимизациями это число снизилось до 5,248, а общая стоимость — на 30%.
Эффекты не складывались. Стабильный префикс отдельно сэкономил 28.3%, сжатие — 17.5%, но вместе они дали 30%, а не 45.8%. Сжатие истории сокращает и префикс, доступный для повторного использования кэша. Комбинации оптимизаций контекста нужно измерять на полном процессе; отдельные проценты складывать нельзя. При другой модели, цене или длине задачи изменится и 30%. Обобщается четырёхветочный метод, а не процент.
Стратегии оптимизации стоимости.
Сначала стоит проверить три входных рычага: повторное использование KV Cache со стабильным префиксом, сжатие контекста за счёт старых траекторий и длинных результатов инструментов и многоуровневую маршрутизацию моделей. Реализация описана в главе 2. Операционно важно иметь отдельный переключатель для каждого рычага, чтобы измерять и самостоятельный эффект, и взаимодействие в комбинации. Ещё два метода напрямую относятся к оценке и эксплуатации.
Асинхронная пакетная обработка накапливает нереального-временные задачи и обрабатывает их пакетами, используя скидки на пакетное ценообразование у провайдеров API; в сценариях с самостоятельным развёртыванием это также повышает использование GPU в периоды низкой нагрузки.
Мониторинг стоимости и контроль бюджета.
В продакшене следует выстроить систему мониторинга стоимости в реальном времени: отслеживать расход токенов и затраты на API в разрезе типа задачи, модели, пользователя и других измерений. Также нужно устанавливать лимит стоимости для каждой задачи — автоматически прерывать выполнение, когда агент попадает в цикл или заходит слишком глубоко в исследование, чтобы предотвратить аномально высокие затраты на одну задачу.
Эксперимент 7-10 ★: сквозной анализ стоимости задач агента
Цель эксперимента: воспроизвести восьмишаговую разбивку выше, затем проверить те же оптимизации на собственной нагрузке.
Техническое решение: сначала воспроизведите фиксированную задачу из сопутствующего репозитория, затем выберите свои типичные задачи. В LangSmith или собственной трассировке записывайте входные/выходные и мыслительные токены, вызовы инструментов и размеры результатов, а также сквозную задержку. Рассчитайте среднее, p50/p95/p99 и структуру стоимости.
Критерии приёмки: сформируйте отчёт и выявите основные факторы. Запустите все четыре комбинации переключателей, измерив оптимизации отдельно и вместе. После смены модели повторите эксперимент, не переносите процент из сохранённой траектории.
Непрерывная итерация на основе оценки
Выбор модели — это не разовое решение, а непрерывный процесс, требующий динамической корректировки по мере эволюции моделей. В начале главы уже была заявлена ключевая идея — «наличие системы оценки позволяет быстро адаптироваться к развитию моделей», далее на конкретном примере смены модели покажем, как эта система работает в реальном принятии решений.
Предположим, ваша система агента сейчас построена на Claude и показывает отличные результаты в вызове инструментов и сложной оркестрации. Однажды выходит новая модель Gemini, и публичные бенчмарки показывают, что она превосходит Claude по ряду показателей и при этом дешевле. В этот момент перед вами стоит не вопрос «сильнее ли Gemini, чем Claude», а вопрос «на моих конкретных задачах, лучше ли Gemini, чем Claude? Насколько лучше? Какова стоимость перехода?»
Команда с полноценной системой оценки способна дать ответ за считанные часы: прогнать новую модель на собственном наборе для оценки, сравнить долю успешных задач, точность вызова инструментов, задержку и стоимость. Может оказаться, что новая модель действительно лучше и дешевле на простых задачах, но в ключевых сценариях со сложной многошаговой оркестрацией инструментов доля успеха, наоборот, снижается на 5% — после подтверждения того, что это отличие выходит за пределы шумовой полосы (см. далее «Статистическая значимость результатов оценки»), ваше решение превращается в дифференцированную стратегию «перевести простые задачи на новую модель для снижения стоимости, а сложные задачи оставить на прежней модели для сохранения качества», а не в слепой полный переход. Такое точное решение, основанное на данных, возможно только при заранее выстроенной системе оценки.
Эксперимент 7-11 ★★: многомерное бенчмарк-тестирование производительности моделей
Проведите всестороннее бенчмарк-тестирование основных LLM и различных поставщиков API, создайте базу данных для многомерных решений по выбору модели.
Выберите объём тестирования: закрытые модели уровня SOTA — серии GPT, Claude, Gemini, Doubao и другие, а также открытые модели — Qwen, Kimi, DeepSeek и другие. Для одной и той же модели протестируйте разных поставщиков API (например, официальный DeepSeek против Siliconflow), проверьте результаты сторонних платформ мониторинга производительности (например, Artificial Analysis).
Спроектируйте стандартизированную тестовую нагрузку: для тестирования входной пропускной способности используйте контекст фиксированной длины (8K/32K/128K токенов), для тестирования выходной пропускной способности запрашивайте генерацию ответа фиксированной длины (512/2048 токенов). Тест задержки включает TTFT (время до генерации первого токена) и сквозную задержку, для моделей с поддержкой размышления отдельно измерьте длину размышления и задержку размышления. Для каждой конфигурации — не менее 100 запросов, рассчитайте стандартное отклонение / p50 / p95 / p99 — высокая дисперсия задержки означает нестабильный пользовательский опыт.
Оцените доступность и стабильность API: проверяйте раз в час в течение недели, фиксируйте долю успешных запросов, типы ошибок и продолжительность сбоев. Рассчитайте частоту сбоев, MTTR (среднее время восстановления) и максимальную непрерывную продолжительность доступности. Проверьте фактические пороги ограничения скорости — постепенно увеличивая параллелизм, найдите точку срабатывания лимита, зафиксируйте верхние границы RPM/TPM. Рассчитайте совокупную стоимость: соберите информацию о ценах (стоимость входных/выходных/кэшированных токенов), учтите влияние KV Cache, рассчитайте среднюю стоимость типичной многошаговой задачи агента.
Эксперимент 7-12 ★★: сквозная оценка выбора системы памяти пользователя
Предварительные требования: необходимо завершить эксперимент по поиску в контексте или агентному RAG из главы 3.
Цель: провести полную сквозную оценку выбора для агента поиска по памяти пользователя, посмотреть, как три точки выбора — модель эмбеддингов, reranker, основная модель агента — совместно влияют на качество поиска, задержку и стоимость. Повторно используйте chapter3/contextual-retrieval-for-user-memory или chapter3/agentic-rag-for-user-memory, сравните на 60 тестовых примерах.
Критерии приёмки: последовательно пройдите три точки выбора — модель эмбеддингов (BGE-M3 / OpenAI / Doubao и др., зафиксируйте точность поиска top-5, задержку, стоимость), reranker (включая базовый вариант «без reranker», оцените его предельную ценность), основную модель (при одинаковой конфигурации поиска сравните долю успеха и эффективность использования инструментов). Главное — выявить взаимодействие компонентов: более сильный эмбеддинг может сделать reranker избыточным, более сильная основная модель может компенсировать недостатки поиска — выбор модели — это системный компромисс, а не выбор самого сильного варианта по каждому пункту в отдельности. Детали конфигурации см. в сопроводительном репозитории.
Статистическая значимость результатов оценки
Набор для оценки конечен, а выход модели случаен, поэтому разница в баллах может быть всего лишь шумом выборки. Если на n случаях измерена доля успеха p, стандартную ошибку можно грубо оценить так:
SE(p)≈np(1−p)
Например, при 100 случаях и доле успеха 70% 95-процентный доверительный интервал составляет около 70%±9 процентных пунктов; «новая модель 73% против старой 70%» — недостаточное основание для перехода.
Сравнивая две конфигурации на одном и том же наборе задач, следует прежде всего делать парный анализ: по каждой задаче фиксировать, кто победил, и судить о разнице по критерию Мак-Немара или парному bootstrap, а не просто вычитать две независимые доли успеха. Поскольку и каждый запуск агента может отличаться, лучше прогонять каждую конфигурацию с несколькими случайными зёрнами (например, 3–5 раз) и сообщать среднее вместе с разбросом; единичный запуск годится лишь для отсева направления. Если ожидаемый выигрыш составляет всего 2–3 пункта, а в наборе для оценки лишь несколько десятков задач, сначала увеличьте выборку — стандартная ошибка убывает как 1/n.
for task in paired_tasks: for seed in fixed_seeds: a = run(config_a, task, seed) b = run(config_b, task, seed) record_paired_delta(verifier(a), verifier(b))return paired_bootstrap_or_mcnemar(all_deltas)
Парность означает, что обе группы делят одни и те же задачи и случайные условия, а не то, что берутся две отдельные выборки и сравниваются их средние.
При параллельной проверке нескольких гипотез нужно учитывать и множественные сравнения: ужесточить порог значимости либо независимо перезапустить положительные результаты. Практический критерий прост: разница в баллах заслуживает смены модели или выпуска изменения только тогда, когда она превышает шум, подтверждается в парном анализе и воспроизводится.
Наблюдаемость агента
Решения, основанные на оценке (будь то выбор модели или непрерывная итерация), зависят от качественных эксплуатационных данных. Сначала разберём, как систематически собирать эти данные (наблюдаемость), а затем — как превращать результаты оценки в системные улучшения.
Понятие наблюдаемости (Observability) заимствовано из области распределённых систем: вы не можете напрямую заглянуть внутрь системы и увидеть, что она делает, — вы можете лишь судить о происходящем по журналам, метрикам и данным трассировки, которые она выдаёт наружу, точно так же, как врач не может напрямую увидеть состояние органов пациента и судит о нём по внешним сигналам — температуре, давлению, снимкам. Системы агентов усложняют эту задачу ещё сильнее: одинаковый вход может дать разные выходы, многоходовые рассуждения и вызовы инструментов делают путь выполнения крайне сложным, а процесс «размышления» модели вообще непрозрачен для внешнего наблюдателя.
Ценность наблюдаемости состоит прежде всего в диагностике проблем: полная траектория позволяет разработчику воспроизвести весь процесс, а не гадать. Второе — это основа для непрерывной оптимизации: вы видите, какие задачи требуют нескольких итераций, у каких инструментов самая низкая доля успеха, какие поисковые запросы неизменно возвращают пустой результат. В части управления затратами стоимость выполнения агентом может различаться на порядок-два между разными задачами, и трассировка позволяет выявлять аномально дорогие случаи. Наконец, накопленные данные траекторий закладывают основу для дальнейшей оптимизации системы и улучшения модели.
Основа данных для наблюдаемости агента — это трассировка (Trace), структура данных которой напрямую заимствована из модели дерева span’ов в распределённых системах: одному запуску задачи соответствует одна трассировка (trace), в которой каждый вызов LLM, каждый вызов инструмента, каждый поиск — это span (единица выполнения, фиксирующая вход и выход, время начала и окончания, расход токенов, информацию об ошибках), а отношения родитель-потомок между span’ами образуют дерево выполнения — например, под span «основной цикл агента» висят несколько дочерних span’ов «вызов LLM» и «вызов инструмента». На этом уровне уже есть готовые стандартизованные протоколы: OpenTelemetry — общий стандарт распределённой трассировки, а спецификации вроде OpenInference определяют на его основе семантические соглашения, специфичные для LLM-приложений (как записывать промпты, параметры модели, расход токенов и т. д.). Преимущество использования стандартных протоколов — разделение сбора и анализа данных: одни и те же данные трассировки можно подключать к разным аналитическим бэкендам, избегая привязки к единственной платформе.
LangSmith — одна из показательных платформ в этой области (аналогичного назначения также Langfuse, Arize Phoenix и др.), объединяющая наблюдаемость, оценку и оптимизацию в единый замкнутый цикл. Каждое выполнение создаёт сессию трассировки, в которой вызовы модели, использование инструментов, поиск по знаниям фиксируются как отдельные единицы выполнения и связываются причинно-следственными связями, образуя дерево выполнения. Каждая единица фиксирует полный вход и выход, временную информацию, данные о стоимости и информацию об ошибках. Платформа использует асинхронный пакетный сбор данных, гарантируя, что сама трассировка не влияет на задержку ответа агента.
Платформа также поддерживает A/B-тестирование (направление части пользовательского трафика на новую версию с автоматическим сравнением показателей, поддержкой быстрого отката или постепенного расширения), управление версиями промптов (каждая версия связана с эксплуатационными данными о производительности) и совместную разработку (члены команды могут делиться данными трассировки и проблемными кейсами). Огромный объём реальных данных в продакшене — это золотая жила для непрерывного улучшения: он позволяет обнаруживать непредвиденные сценарии и выявлять функции, которые больше всего нуждаются в оптимизации.
Самое ценное направление для данных наблюдаемости — это вернуть их обратно и превратить в оценочные активы. Практичный замкнутый цикл выглядит так: отобрать из продакшн-траекторий неудачные и подозрительные случаи → обезличить их (убрать приватные данные пользователей, ключи и прочие чувствительные поля) → закрепить как новые кейсы и регрессионные тесты в наборе оценки. Тогда набор оценки перестаёт быть статичной подборкой, собранной однажды, и становится живым активом, который развивается вместе с продуктом и остаётся близким к реальному распределению пользователей. Сценарий отказа, вскрывшийся в проде сегодня, завтра становится регрессионным кейсом, охраняющим эту границу.
Имея полноценную систему оценки и датасеты, ключевая задача — превратить результаты оценки в конкретные системные улучшения.
От отчёта по Benchmark к системным улучшениям
Следующий пример взят из реальной, намеренно узкой итерации AndroidWorld в сопутствующем репозитории. Она охватывает четыре задачи настройки Wi-Fi на эмуляторе API 35, с одним парным запуском на задачу. Это не полный benchmark из 116 задач и не замена повторному запуску в эталонной среде API 33. Ценность примера — не общий балл, а последовательность решений от результата к результату.
Рис. 7-8 Замкнутый цикл от Benchmark к улучшениям · Исходный рисунок
С точки зрения Harness-инженерии, этот раздел, по сути, посвящён методологии итеративной оптимизации Harness — через данные оценки локализуются слабые места Harness (не хватает контекста? отсутствуют ограничения? недостаточно проверок? обратная связь запаздывает?), затем вносятся целевые улучшения и проводится повторная оценка, формируя замкнутый цикл непрерывной эволюции Harness.
Прежде чем начинать анализ отчёта по Benchmark, стоит помнить об одном принципе, о котором часто забывают: если видно снижение показателей агента, сначала проверьте саму систему оценки, и только потом трогайте агента. Распространённая ошибка — увидев падение оценки, сразу начать менять код агента, упуская из виду, что проблема могла быть изначально в самой системе оценки — если исправлять направление на основе искажённого сигнала, оно может оказаться неверным с самого начала. К типичным источникам ошибок в системе оценки относятся: нехватка ресурсов в среде выполнения, приводящая к принудительному завершению процесса (проявляется как случайные сбои), баги в самом верификаторе, которые засчитывают правильный ответ как неудачу, разрыв между тестовыми примерами и реальными продакшн-сценариями. Все эти проблемы выглядят в итоговых числах точно так же, как деградация модели, и различить их можно только изучив полные траектории.
Как читать отчёт по Benchmark: искусство находить проблемы
Исходный отчёт содержал по одному запуску каждой из 116 задач и около 88% общей успешности. Ошибки не были рассеяны: три из четырёх задач SystemWifiTurn* провалились, а их траектории многократно перемещались туда и обратно без подтверждения конечного состояния. С данными согласовались два объяснения: агент не знает, куда идти, либо получает неполное представление UI.
Итоговые 88% скрывают этот небольшой, но связный кластер. Увеличение лимита шагов тоже вводит в заблуждение: «агент не видит элемент» легко превращается в «агенту не хватает настойчивости». Ищите кластеры по задачам и меткам, воспроизводите траектории, определяйте, возникла ли ошибка в наблюдении, рассуждении, действии или проверке, и только затем меняйте одну переменную. Срез Wi-Fi использован для дешёвой диагностики механизма, а не оценки всей системы.
От данных к гипотезам: построение дорожной карты улучшений
Первый раунд проверял самое дешёвое объяснение. H1 предполагала нехватку навигационных знаний, поэтому только опытная ветвь получила инструкции по навигации к Wi-Fi и проверке конечного состояния. Успешность не выросла: узким местом был не промпт.
Второй раунд перешёл к проверке того, что агент вообще «видит». Пусть H5 заменяет несовместимый с API 35 accessibility feed на дерево элементов UIAutomator, которое AndroidWorld уже поддерживает. Доля успеха действительно выросла, но полное дерево элементов слишком длинное, и расход токенов заметно поднялся. Поэтому третий раунд, H5C, уже не добавляет новой информации: он лишь удаляет из дерева элементов невидимые, лишённые текста и неуправляемые узлы-контейнеры, чтобы посмотреть, удастся ли убрать шум, сохранив долю успеха.
Все три раунда неизменно использовали одну и ту же модель, параметры задач, случайные зёрна, предельное число шагов и симулятор, а порядок запуска двух групп чередовался. Такое пошаговое сужение круга проблем позволяет прояснить причинно-следственную связь куда лучше, чем нагромождение множества изменений сразу: проблема, вскрытая в предыдущем раунде, как раз и становится единственным изменением, которое проверяется в следующем.
От результатов к решению: компромиссы на основе данных
Таблица 7-5 суммирует измеренные результаты. Четырёх задач на ветвь достаточно, чтобы решить, стоит ли расширять запуск, но не для оценки всего AndroidWorld.
Таблица 7-5. Три раунда на Wi-Fi-срезе AndroidWorld
Эксперимент
Единственное изменение
Контроль → опыт
Токены опыт / контроль
Следующий шаг
H1
Инструкции навигации
25% → 25%
0.47×
Роста нет; оставить исходный промпт
H5
Accessibility feed → UIAutomator
25% → 100%
2.498×
Сильный рост, но дорого; оптимизировать
H5C
Сжатие дерева UIAutomator
100% → 100%
0.506×
Успех сохранён, токены вдвое ниже; полный запуск
Последовательность важнее отдельных процентов. Подробные инструкции не восстановят информацию, которую агент не получил; до расширения промпта исследуйте ошибки наблюдения. Но и больше входа не всегда лучше. Полное дерево решило видимость, одновременно засорив контекст. Удаление бессмысленных узлов сохранило четыре успешных запуска и примерно вдвое сократило токены. Модель не менялась: представление UI в Harness сначала определило выполнимость, затем экономичность.
Непрерывная итерация: от первого улучшения к эволюции системы
То, что H5C прошёл проверку на этих четырёх задачах, означает лишь, что он достоин следующего раунда, а не что его можно развёртывать. Дальше нужно добавить сторонние приложения и в эталонной среде Pixel 6 / API 33 прогнать все 116 задач по пять случайных зёрен каждую; помимо того, что доля успеха не должна упасть, требуется подтвердить, что расход токенов не превышает 75% от исходного варианта, а задержка — 1,5-кратной. До этого полного перезамера нельзя выдавать 4/4 на подмножестве за 100% по системе в целом.
Непрерывная итерация означает именно это: доказательство раунда разрешает лишь следующий шаг в пределах своего охвата. H1 остановил наращивание промпта; H5 нашёл механизм и выявил цену; H5C устранил цену и прошёл к широкому тесту. Хороший отчёт сообщает не только балл, но область вывода, нарушенные ограничения и следующий тест.
Эксперимент 7-13 ★★★: оценка и улучшение AndroidWorld
Этот эксперимент проходит весь путь от отчёта до улучшения. Начните с исторического отчёта и трёх сохранённых парных запусков в chapter6/android-world.
Шаг первый: диагностика. Проведите перекрёстный анализ таблицы результатов по задачам и матрицы меток способностей, чтобы отобразить поверхностные сбои задач на глубинные дефекты способностей. Определите метки способностей с успешностью ниже ожидаемой и области концентрации сбоев.
Шаг второй: построение гипотез. По трёхуровневой схеме (поверхностный → средний → глубинный) сформируйте гипотезы улучшений, для каждой явно укажите ожидаемый прирост успешности и метод проверки.
Шаг третий: поэтапные эксперименты. Воспроизведите H1, H5 и H5C, меняя по одной переменной за раунд. Помимо успеха фиксируйте токены, задержку и регрессии.
Шаг четвёртый: решения, управляемые данными. Принимайте решения о развёртывании исходя из соотношения затрат и выгод — не просто внедряйте все эффективные улучшения, а взвешивайте область применимости, влияние на задержку и накладные расходы каждого из них. Дешёвые и высокоэффективные улучшения внедряйте первыми, дорогостоящие ограничивайте ключевыми сценариями.
Шаг пятый: итерация. Успешный срез переходит только к полному запуску. Развёртывание обсуждается после 116×5 в эталонной среде; различия среды, размер выборки и неполный охват сохраняются в отчёте.
От внешней оценки к внутренней: инфраструктура оценки для промышленного агента
В предыдущих разделах обсуждалось, как оценивать систему агента извне — как построить среду оценки, спроектировать датасет, проанализировать отчёт benchmark. Но лучшие агентные продукты не только проходят внешнюю оценку — они встраивают инфраструктуру непрерывной самооценки. Ниже на примере открытого универсального агента OpenClaw, представленного в главе 5, а также с опорой на публичный технический анализ и опыт практиков ведущих кодинг-агент продуктов, показана достойная заимствования система внутренней оценки — она системно встраивает методологию экспериментов из ML-исследований в инженерию продукта.
Инфраструктура абляции: понимание реального вклада каждой функции
Исследователи ML давно используют абляционное исследование, чтобы понять, какие компоненты модели действительно важны — так называемая абляция состоит в том, чтобы поочерёдно «удалять» тот или иной компонент и смотреть, насколько упадёт общая производительность. OpenClaw переносит эту методологию в инженерию продукта: система встроила общий выключатель, позволяющий одновременно отключить несколько основных функций (режим размышления, сжатие контекста, автоматическую память, фоновые задачи и т. д.), создавая базовую линию «голой модели». Это позволяет команде ответить на ключевой вопрос: действительно ли данная функция улучшает пользовательский опыт, или она просто кажется полезной?
Превращение абляции в регулярную инженерную практику, а не разовое исследование, имеет несколько практических последствий. Во-первых, переключатель абляции должен внедряться на очень раннем этапе пути запуска — до того, как какие-либо константы уровня модуля зафиксируют значения конфигурации. Это значит, что инфраструктура абляции должна быть заложена в архитектуру системы с самого начала, а не добавлена задним числом. Во-вторых, регулярный запуск абляционных экспериментов (например, перед каждым крупным релизом) позволяет обнаружить «долг функций» — функции, которые когда-то были эффективны, но по мере эволюции модели перестали быть необходимыми. Для любой команды, создающей промышленного агента, рекомендуемая практика: каждая основная функция должна допускать независимое отключение, а команда должна регулярно проверять реальный вклад каждой функции.
Методология AB-тестирования: разделение механизма и цели
Зрелые агентные продукты проводят строгое AB-тестирование своего поведения (то есть случайно разбивают пользователей на две группы — одна использует старую версию, другая новую — и сравнивают реальные данные обеих групп, чтобы понять, эффективно ли изменение). Хорошо спроектированный кейс AB-тестирования агента демонстрирует несколько ключевых методологических принципов:
Многорукий, а не бинарный тест. Сравнивайте не просто «есть» и «нет», а спроектируйте несколько постепенных вариантов (например, при тестировании ограничений промпта разной строгости создайте контрольную группу и три экспериментальные группы с постепенно ужесточающимися ограничениями). Такой дизайн позволяет выявить зависимость доза-эффект и найти оптимальную точку.
Разделение метрики механизма и метрики цели. Это самая распространённая ошибка — принимать за цель оптимизации то, что вы непосредственно изменяете. Например, если вы тестируете «сокращение длины файла плана агента», длина плана — это метрика механизма (то, что вы напрямую меняете), но не цель. Настоящая цель может быть «снижение стоимости на сессию». Сокращение файла плана может снизить затраты, но может и увеличить общий объём выхода из-за менее детального плана, приводящего к большему числу циклов правка-проверка-правка. Всегда спрашивайте себя: то, что я меняю (механизм), и то, что меня действительно волнует (цель), — это одно и то же? Если нет — ориентируйтесь на цель.
Настройте метрики-ограждения. Даже если целевая метрика улучшилась, если удовлетворённость пользователей упала, число операций выросло или частота ошибок увеличилась, эксперимент следует остановить. Метрики-ограждения — это «нижняя граница, которая не должна ухудшаться».
Фиксируйте базовую статистику. Включая объём выборки, процентили распределения, корреляционный анализ (например, «отказ монотонно растёт с размером плана») — это даёт необходимый контекст для интерпретации результатов эксперимента. Без базовой линии вы не сможете судить, статистически ли значим результат эксперимента.
Двухуровневая система переключателей функций
Инфраструктуру переключателей функций (Feature Flag) агентному продукту нужно проектировать с первого дня — переключатель функции представляет собой удалённо управляемый выключатель, который решает, включена ли данная функция для пользователя, без необходимости повторного развёртывания кода. Он одновременно служит трём целям: эксперименты, постепенный релиз и экстренное аварийное отключение.
Переключатели времени сборки физически удаляют соответствующий код из продукта уже на этапе сборки. Функции, предназначенные только для внутреннего использования, вообще отсутствуют во внешних сборках — даже реверс-инжиниринг не обнаружит удалённую функцию. Это также чистый механизм абляции: отключение функции — это не пропуск логики во время выполнения, а физическое отсутствие соответствующего кода.
Переключатели времени выполнения конфигурируются на стороне сервера и кэшируются локально на диске. По замыслу лучше прочитать чуть устаревшую кэшированную конфигурацию, чем заставить агента ждать сетевой запрос и блокировать запуск. Конкретное решение о группировке принимается через экспериментальную платформу (например, GrowthBook) для распределения по группам AB-теста. Ключевая деталь дизайна: событие показа каждой функции регистрируется не более одного раза за сессию, чтобы избежать искажения экспериментальных данных повторными записями.
Вывод для разработчиков агентов: переключатели функций — это не инструмент отладки, а компонент архитектуры первого класса.
Оценка чувствительности к промпту
Системный промпт — это ключевой «код» поведения агента, но ему часто не хватает того же уровня контроля версий и регрессионного тестирования, что и обычному коду. Подход OpenClaw — предоставить специальный инструмент, способный извлечь полностью отрендеренный системный промпт на указанной версии git — включая итоговый текст после раскрытия всех динамических условий. Это позволяет команде точно ответить на вопрос: какой коммит изменил промпт? Каково влияние на оценочный набор?
Для любой команды, работающей с агентами, рекомендуемая практика: (1) системный промпт должен рендериться детерминированно (при одинаковых входных конфигурациях всегда выдаётся одинаковый результат); (2) должен быть создан механизм версионных снимков промпта; (3) каждое изменение промпта должно проходить регрессионное тестирование на оценочном наборе — так же, как изменения кода должны проходить CI.
Приватность-ориентированная аналитика как основа оценки
Оценка зависит от качественных данных, но агентные продукты часто работают с чувствительным содержимым пользователей. OpenClaw решает это противоречие через систему типов: интерфейс аналитики принимает только значения, обёрнутые в специальный тип, и само имя типа служит следом для аудита — оно прямо заявляет «я проверил, что это не код и не путь к файлу». Такой дизайн превращает ограничение приватности из задокументированной нормы в проверку типов, принудительно применяемую на этапе компиляции.
Основной принцип: заложить ограничения приватности в архитектуру с самого начала, а не добавлять задним числом. Если ваша система аналитики не может безопасно собирать данные, вы не сможете эффективно оценивать. Приватность и оценка не противоречат друг другу — дизайн, ориентированный на приватность, вынуждает всерьёз задуматься над тем, что действительно нужно измерять, а это в результате порождает более точные метрики оценки.
От внешнего к внутреннему: смена мышления об оценке
Основная мысль этого раздела: предыдущие разделы учили, как оценивать агента извне, этот раздел показывает, как лучшие агентные продукты оценивают себя изнутри. Внешняя оценка говорит вам, «насколько хорош агент», внутренняя инфраструктура оценки говорит, «какое именно изменение сделало его лучше». Абляционные эксперименты выявляют, какие функции действительно важны, AB-тесты количественно оценивают влияние каждого изменения, переключатели функций дают инфраструктуру для экспериментов и отката, оценка чувствительности к промпту встраивает системный промпт в систему CI, приватность-ориентированная аналитика обеспечивает соответствие норм при сборе данных. Эти пять компонентов вместе образуют инженерию продукта, управляемую оценкой, — оценка встраивается не время от времени, а в каждое решение по продукту.
Симуляционная среда: мост от оценки к постобучению
Конечная точка оценки — не выставление баллов, а улучшение. Эта глава уже показала два пути улучшения: настройка Harness (от отчёта benchmark к системному улучшению) и встраивание оценки в инженерию продукта (внутренняя инфраструктура оценки). А самая мощная форма улучшения — это обучение: когда цель расширяется от «оценки существующих способностей» до «воспитания новых способностей», особенно через технологии постобучения, обсуждаемые в главе 8, среда оценки должна эволюционировать в симуляционную среду: виртуальную площадку, где агент может многократно тренироваться и автоматически получать оценку. Ключевое различие между симуляционной средой и средой оценки: намного более высокая частота взаимодействий (миллионы против тысяч раз), потребность в рандомизации (чтобы предотвратить зубрёжку конкретных конфигураций) и необходимость мгновенной обратной связи. С точки зрения областей применения симуляционные среды делятся на две большие категории: цифровые среды (задачи обработки информации) и воплощённые среды (восприятие и манипулирование физическим миром).
Вот как соединяются два конца этого моста. Активы, уже накопленные на стороне оценки, можно почти без потерь превратить в обучающий сигнал: чётко определённая рубрика или верификатор по сути и есть функция вознаграждения для проверяемого вознаграждения (RLVR, Reinforcement Learning with Verifiable Rewards) — скрипт выставления оценки напрямую становится скриптом вознаграждения; прошёл ли тест, достигнуто ли нужное состояние — это одновременно и критерий оценки, и возврат для обучения с подкреплением. Но обучение выдвигает новые требования, о которых на стадии оценки не нужно было беспокоиться. Первое — надёжная семантика reset: обучение прогоняет миллионы эпизодов (эпизод — это один полный раунд взаимодействия от начального состояния до завершения задачи), и каждый эпизод должен быть способен сбросить среду в детерминированное, чистое начальное состояние, иначе сигнал градиента будет загрязнён остаточным состоянием предыдущего раунда. Второе — пропускная способность, значительно превышающая нужды оценки: для оценки достаточно нескольких тысяч прогонов, чтобы сделать вывод, а обучение требует передать модели миллионы взаимодействий за приемлемое время по настенным часам — степень параллелизма среды и накладные расходы на один экземпляр напрямую определяют, реализуемо ли обучение. Оба этих момента — превращение верификатора в функцию вознаграждения, а также reset и пропускная способность, ориентированные на обучение, — будут подробно раскрыты в главе 8.
Что касается цифровых сред, фреймворк AWorld для задач GAIA строит контролируемую песочницу серверов MCP, предоставляя 26 серверов MCP, охватывающих 126 функций-инструментов, что позволяет избежать блокировок и неконтролируемых побочных эффектов от прямого доступа к реальным API. Все вызовы инструментов можно воспроизвести и проверить. Распределённая архитектура AWorld сокращает традиционное последовательное выполнение с 7695 секунд до 525 секунд (ускорение в 14,6 раза), а stateless-дизайн среды делает каждый экземпляр полностью независимым, поддерживая эффективный параллелизм.
Что касается воплощённых сред, RoboTwin2 строит задачи манипулирования двумя руками на основе физического движка, среда рандомизирует положение объектов, ориентацию и внешний вид для повышения обобщаемости. Пространство наблюдений включает визуальные данные с нескольких камер и состояния суставов, а реальное время управления достигается через разбиение действий на блоки (Action Chunking) — модель планирует сразу несколько последовательных действий (подробнее в главе 6). OSWorld достигает возможности сброса через снимки виртуальной машины, AndroidWorld фокусируется на автоматизации мобильных приложений. Независимо от того, цифровая среда или воплощённая, симуляционная среда так же нуждается в обсуждавшихся в главе 4 механизмах изолированного выполнения и виртуальной идентичности (изоляция VM/контейнер, резидентные прокси, аутентификация Human-in-the-Loop, общая файловая система) — здесь это не повторяется.
Эксперимент 7-14 ★★: настройка воплощённой интеллектуальной среды с OpenVLA и RoboTwin2
Постройте симуляционную среду для манипулирования роботом. Прочитайте ch7/SimpleVLA-RL и документацию OpenVLA, поймите архитектуру модели «зрение-язык-действие» (визуальный кодировщик + языковая модель + декодер действий, интегрированные сквозным образом; изображение и текст проецируются в общее семантическое пространство). Настройте среду RoboTwin2, разберитесь в пространстве наблюдений (RGB с трёх ракурсов + 14-мерное состояние суставов) и пространстве действий (14-мерный вектор управления). Изучите механизм рандомизации среды и логику пространственных ограничений в move_can_pot. Запустите оценку предобученной модели, зафиксируйте успешность, время выполнения и режимы сбоя, уделив особое внимание влиянию механизма разбиения действий на блоки.
Среда высокой достоверности лучше переносится в реальный мир, но требует больших вычислительных затрат. Другое измерение достоверности — степень рандомизации: умеренная рандомизация повышает обобщаемость, а чрезмерная делает задачу слишком сложной. Рандомизация домена (Domain Randomization) — ключевая техника для сокращения разрыва между симуляцией и реальностью (sim-to-real gap): в физические параметры, визуальный вид, шум сенсоров и другие аспекты вносятся большие случайные вариации — подобно тому, как если тренироваться захватывать предмет при разном освещении и под разными углами, то и в реальной среде не подведёт изменение освещения. В цифровых средах sim-to-real проявляется как различия в рендеринге интерфейса, времени отклика и т. п., что можно смягчить, вводя случайные задержки и сбои.
Резюме главы
Глава отвечает на один вопрос: как понять, что агент действительно улучшился? Эта цепочка состоит из четырёх звеньев: сначала определить, что считать успехом (различие оснований Pass@k, Best@k и Pass consecutive@k), затем решить, откуда берутся задачи (три источника: публичные бенчмарки, собственный бизнес-набор, возврат производственных траекторий), потом выбрать способ проверки (от детерминированных верификаторов к спискам проверок, Rubric с суждением LLM и далее к попарному сравнению) и, наконец, превратить оценки в решения (статистическая значимость, атрибуция отказов, регрессионные задачи, выбор модели). Каждое звено влияет на достоверность. Измеренные случаи добавили четыре практических предостережения: структурированная память с RAG не гарантирует синергию; экономию кэша и сжатия нельзя складывать; выбор референсного аудио меняет смысл мультимодального балла; представление входа в Harness может определять и успех, и токены. Сравнивать нужно кривые возможностей при разных бюджетах, а в продакшене оценка должна быть непрерывной проверкой, а не редким экзаменом.
С точки зрения общей структуры книги эта глава строит отрезок свидетельства из цикла открытия главы 1: атрибуция отказов определяет, будет ли у последующих предложений твёрдая опора.
Оценка на границах префиксов траектории показывает ещё и то, что получить сведение и правильно применить его в текущем решении — это две разные способности: сквозная регрессия гарантирует, что базовые задачи не деградируют, а граничный набор по префиксам траектории напрямую проверяет суждение об области действия, перекрытие текущей инструкцией, уточняющий вопрос и подтверждение перед опасным действием. Пользовательская память — лишь один случай этого общего метода. Оценка агентов производственного уровня — не экзамен, который сдают время от времени, а система проверки, непрерывно порождающая регрессионные и граничные задачи из реальных проблемных случаев.
Основная методология: наблюдение → гипотеза → эксперимент → проверка → новое понимание → новая гипотеза — она превращает инженерию агентов из опытно-ориентированной «алхимии» в управляемую данными научную инженерию.
Система оценки, представленная в этой главе, образует полный замкнутый цикл: среда оценки предоставляет автоматизированную тестовую инфраструктуру → датасет для оценки определяет тестовые случаи → методы автоматизированной оценки (LLM-as-a-Judge и рубрики) выставляют оценку поведению агента → анализ benchmark раскрывает направление улучшений → улучшение системы устраняет проблемы → обновляются среда оценки и датасет, начинается новый раунд итерации.
Система оценки, построенная в этой главе, служит не только оптимизации текущей системы, но и предоставляет ключевую основу для двух последующих глав. Глава 8 превращает среду и данные оценки во входные данные для постобучения модели, записывая стратегии взаимодействия в параметры посредством SFT и RL; глава 9 преобразует многомерную оценку производственных траекторий в кандидатные обновления знаний, инструкций, программ или параметров.
Вопросы для размышления
★★ LLM-as-a-Judge использует языковую модель для оценки выходных данных языковой модели. Существуют ли в такой «самооценке» системные слепые зоны — например, модель может стабильно ставить высокие баллы ответам определённого стиля, а эта склонность может не совпадать с человеческими оценками? Как обнаружить и скорректировать такое смещение?
★★★ Дизайн «защиты от утечки» в оценочных датасетах критически важен. Но в открытой экосистеме данные benchmark, однажды опубликованные, быстро попадают в обучающие данные. Есть ли конец у этой «игры в кошки-мышки»? Спроектируйте метод оценки, который принципиально устойчив к утечке данных.
★★ Четыре критерия Scale AI (опора на экспертное руководство, полный охват, стандартизированные веса важности, самодостаточность оценки) призваны устранить субъективность оценки. Но некоторые измерения задачи (например, «был ли ответ полезным», «уместен ли тон») по своей природе субъективны. Как разработать надёжную рубрику для таких субъективных измерений?
★★ τ-bench оценивает агента, моделируя поведение реального пользователя. Но сам симулированный пользователь — это тоже LLM, которая может систематически недооценивать определённые пограничные сценарии (например, пользователей в эмоциональном возбуждении или с неясным выражением мысли). Как проверить качество самого симулированного пользователя?
★★ Парное сравнение (модель Брэдли-Терри) предполагает транзитивность предпочтений (если A > B и B > C, то A > C). Но человеческие предпочтения часто нарушают транзитивность. В каких сценариях оценки агента могут возникать нетранзитивные предпочтения? Как это влияет на надёжность ранжирования?
★★ В этой главе Pass@k как потолок возможностей отделён от Pass consecutive@k как меры бизнес-надёжности. Для агента, у которого вероятность успеха с одной попытки составляет всего 60%, как совместить стоимость отказа, стоимость повторной попытки и побочные эффекты задачи, чтобы решить, какую метрику докладывать и каким брать k?
★★ В этой главе предложен научный метод «наблюдение → гипотеза → эксперимент → проверка». Но на практике пространство поведения агента огромно, и для проверки одной гипотезы может потребоваться сотни прогонов оценки. Как максимизировать информативность оценки при ограниченном вычислительном бюджете?
★ В пилоте AndroidWorld полное дерево элементов подняло успех с 25% до 100%, но увеличило токены до 2.498× от контроля; обрезка сохранила 100% успеха и снизила токены до 0.506×. Как спроектировать автоматические правила обрезки, удаляющие семантически пустые узлы UI без потери данных для доступности, проверки состояния и последующих действий?
★★ Симуляция пользователя в τ-bench использует «прогрессивное раскрытие информации» — вся информация предоставляется не сразу, а постепенно, в зависимости от вопросов агента. Как этот дизайн влияет на результаты оценки? Если стратегия раскрытия информации симулированным пользователем значительно отличается от поведения реального пользователя, можно ли доверять выводам оценки?
Сноски
Wijk, Hjalmar, et al. RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts. arXiv:2411.15114, 2025. ↩
Примените на практике
Сопутствующие эксперименты
Изучите эксперименты к главе и увидьте, как эти идеи воплощаются в коде.