ששת הפרקים הראשונים פרשו כיצד לבנות סוכן יחיד: את ההקשר שלו, את הידע, את הכלים, את יכולות הקידוד ואת מרחבי התצפית והפעולה. אך השלמת בנייה אינה אומרת שהבנייה נכונה; רק מדידה יציבה יכולה להעניק לאימון המודל ולהתפתחות המערכת שלאחר מכן כיוון אמין.
בעת בניית מערכת סוכן, מפתחים ניצבים בפני החלטות עיצוב רבות שלעיתים קרובות אין להן תשובות נכונות מובנות מאליהן:
באיזה מודל יש להשתמש?
אילו כלים המודל צריך להיות מסוגל להפעיל?
אילו נתונים בסיס הידע צריך לאחסן, וכיצד יש לבנות אותם?
כיצד יש לממש זיכרון משתמש?
כיצד יש לארגן את הפרומפטים ואת ה‑Skills של המודל?
אילו אילוצים יש להוסיף ל‑Harness?
כיצד יש להפוך תוצאות הערכה לאותות למידה להתפתחות המתמשכת של הסוכן?
הערכה מעמידה את ההחלטות הללו על בסיס מדעי. באמצעות ניסויים השוואתיים שיטתיים (שינוי משתנה אחד בכל פעם ובחינת ההשפעה) וניסויי אבלציה (השבתת רכיב אחד בכל פעם ובחינת השינוי בביצועים הכוללים), ניתן להבחין בין שיפורי יכולת אמיתיים לבין תנודות שטחיות — ולהימנע מלהיות חכם בקטן וטיפש בגדול. בהנדסת תוכנה יש אמרה: אי אפשר לשפר את מה שאין מודדים. ללא מערכת הערכה בת‑שחזור, ניתן לבצע איטרציה על סוכן רק על סמך אינטואיציה.
מנקודת המבט של הנדסת Harness שהוצגה בפרק 1, ההערכה ממלאת את תפקיד הליבה של “אימות” בתוך ה‑Harness. תובנה מרכזית היא: מושא ההערכה אינו צריך להיות רק המודל, אלא הצירוף של המודל וה‑Harness. אותו מודל יכול לתפקד באופן שונה לחלוטין ב‑Harness שונים — צוותים אחדים שיפרו במידה ניכרת את ביצועי אותו מודל במשימות טרמינל אך ורק באמצעות אופטימיזציה של ה‑Harness (ראו פרק 5). לפיכך כשסוכן מקבל ציון נמוך בהערכה, התיקון עשוי שלא להיות מודל אחר אלא רכיב Harness טוב יותר (פרומפטים, עיצוב כלים, לולאות משוב). מערכת הערכה תקינה צריכה להיות מסוגלת להבחין בין שתי בעיות שונות מיסודן: “יכולת מודל בלתי מספקת” ו”פגמים בעיצוב ה‑Harness”. דרך נפוצה להבחין ביניהן היא ניסוי החלפת המודל: לקבע את ה‑Harness, להחליף למודל חזק או חלש יותר, ולראות בכמה זז הציון. אם מודל חזק יותר אינו מעלה את הציון, צוואר הבקבוק הוא ה‑Harness. אם מודל חלש יותר מפיל את הציון והתוצאות מתנדנדות בחדות עם יכולת המודל, הקריאה הישירה ביותר היא שהמודל עצמו הוא צוואר הבקבוק ושהביצועים הנוכחיים נשלטים על ידי המודל. האם זה משום שהמשימה קשה מטבעה או משום שה‑Harness נשען יתר על המידה על ידע קודם של המודל — הדבר דורש ניתוח נוסף. שימו לב שהדבר נבדל מניסוי האבלציה שלעיל: אבלציה משביתה רכיב Harness כדי לראות כיצד משתנים הביצועים הכוללים; החלפת מודל מקבעת את ה‑Harness ומשנה רק את המודל. הראשון מאתר איזה חלק בתוך ה‑Harness משנה; השני מגלה לכם האם צוואר הבקבוק הוא המודל או ה‑Harness.
מערכת הערכה שווה עוד יותר בעידן של התפתחות מודלים מהירה. מודלים ממשיכים להשתפר, אך מודל חדש שמקבל ציון גבוה יותר במדדי ביצועים ציבוריים לא בהכרח יתפקד טוב יותר במשימה שלכם — הוא עשוי אף לסגת (לתפקד גרוע יותר מהגרסה הישנה בהיבטים מסוימים). רק הרצה מלאה על מערך ההערכה שלכם מאפשרת לכם לקבל החלטת שדרוג מבוססת נתונים. מערכת הערכה איתנה אף הופכת את “בניית מוצרים למודלים עתידיים” לאסטרטגיה בת‑קיימא: אם המודל הנוכחי אינו טוב מספיק לפריסה מסחרית, סיימו את המוצר בכל זאת, בנו את מערך ההערכה, עקבו אחר ביצועיו של כל מודל חדש, והשיקו ברגע שאחד מהם עובר את הרף.
מערכת הערכה ניתנת לפירוק לארבע חוליות: מהי הצלחה, מהיכן מגיעות המשימות, מי מאמת, וכיצד ציון הופך להחלטה. איור 7‑1 מציג זאת.
איור 7‑1: ארבע החוליות של מערכת ההערכה של Agent · איור המקור
נתיחה של משימת הערכה אחת: תחום telecom ב‑τ²-bench
נתחיל בנתיחה מלאה של משימה אמיתית אחת מתחום telecom של τ²-bench. τ²-bench הוא פרויקט קוד פתוח של Sierra; שכפלו אותו מקומית באמצעות הפקודה שב-chapter7/tau2-bench-eval/README.md, ואז פתחו את קובץ המשימות data/tau2/domains/telecom/tasks_small.json.
ארבעת מרכיבי הגדרת המשימה
להלן אחת המשימות מאותו קובץ, מקוצרת לנוחות הקריאה.
{ "id": "[mobile_data_issue]airplane_mode_on|user_abroad_roaming_enabled_off", // הכרטיס הנמסר ל‑Agent "ticket": "הטלפון של המשתמש אינו מתחבר לאינטרנט, ובשורת המצב מופיע 'No Service'. הלקוח John Smith, מספר 555-123-2002, נמצא כעת בצרפת. הבעיה נחשבת פתורה רק אם בדיקת המהירות מחזירה excellent. אינו רוצה להחליף חבילה, אך מוכן לטעון 2.0 ג'יגה-בייט במידת הצורך.", // כללי ההתנהגות הנמסרים לסימולטור המשתמש "user_scenario": { "instructions": { "known_info": "You are John Smith with phone number 555-123-2002. You are currently abroad in France.", "unknown_info": null, "task_instructions": "…express mild frustration after the first unsuccessful attempt. You will consider the issue resolved only when speed test returns excellent internet speed and nothing else. If it returns poor, fair or good, you will not consider the issue resolved. Whenever the agent asks you about your device, always ground your responses on the results of tool calls. … Never make up the results of tool calls." }}, // לפני ההרצה שני הצדדים מאופסים לאותה נקודת פתיחה "initial_state": { "initialization_actions": [ { "env_type": "user", "func_name": "turn_airplane_mode_on" }, { "env_type": "user", "func_name": "turn_roaming_off" }, { "env_type": "assistant", "func_name": "enable_roaming", "arguments": { "customer_id": "C1001", "line_id": "L1002" } } ]}, // קריטריוני הניקוד "evaluation_criteria": { "actions": [ { "requestor": "user", "name": "toggle_airplane_mode" }, { "requestor": "user", "name": "toggle_roaming" } ], "env_assertions": [ { "func_name": "assert_mobile_data_status", "expected_status": true }, { "func_name": "assert_internet_speed", "expected_speed": 200, "expected_desc": "excellent" } ], "communicate_info": null, "nl_assertions": null, "reward_basis": ["ENV_ASSERTION"] }}
בהגדרה הזו יש ארבע החלטות תכנון שראוי לפרט.
גבול הידיעה של המשתמש ממודל במפורש.known_info מכיל שלושה פרטים בלבד: שם, מספר טלפון ומדינת השהות. שתי הסיבות האמיתיות לתקלה — מצב טיסה פעיל ונדידת נתונים כבויה — אינן שם. המשתמש אינו יודע עליהן ולכן אינו יכול למסור אותן מיוזמתו, וה‑Agent יכול להשיגן רק בשאלות ובהנחיית המשתמש לבדוק. כך מיושם גילוי מידע הדרגתי (Progressive Information Disclosure) ברמת הגדרת המשימה: לא בכבילת הסימולטור בפרומפט מסוג “אל תגלה הכול בבת אחת”, אלא במידול תחום הידיעה של המשתמש כשדה נפרד. רוב מבחני הייחוס מציגים את הדרישה המלאה כבר בפתיחת המשימה, בעוד שמשפט הפתיחה של משתמש אמיתי הוא בדרך כלל לא יותר מ”אני לא מצליח להיכנס לאינטרנט”. חידוד הבקשה עד שהיא ניתנת לביצוע הוא עצמו חלק ממה ש‑Agent צריך לדעת לעשות.
הסימולטור מקבל כללי התנהגות ולא תסריט דיאלוג.task_instructions מכיל שלושה סוגי אילוצים: כוונון רגשי (להביע מורת רוח קלה אחרי ניסיון התיקון הראשון שנכשל), קריטריון קבלה (הבעיה נחשבת פתורה רק אם בדיקת המהירות מחזירה excellent; poor, fair ו‑good נדחים כולם), ודרישת עיגון עובדתי (Grounding), כלומר שכל תשובה על מצב המכשיר תסתמך על הערך שהחזיר כלי: “Never make up the results of tool calls”. השלישי הוא הקריטי ביותר: בלי אילוץ העיגון, המשתמש המדומה ילך אחרי הכוונת ה‑Agent ויאשר שהבעיה נפתרה, וההערכה תידרדר לשני מודלים המאשררים זה את זה.
המצב ההתחלתי מחולק לפי הצד השולט.env_type מקבל שני ערכים, user ו‑assistant: מצב טיסה ומתג הנדידה שייכים לצד המשתמש, ו‑enable_roaming בצד המפעיל שייך לצד ה‑Agent. החלוקה הזו היא שקובעת את צורת התקלה: בצד המפעיל הנדידה מופעלת, אך במכשיר המשתמש היא כבויה, ולכן שאילתה של ה‑Agent אל מסד הנתונים מניבה רק את המסקנה “התצורה תקינה”. התקלה נמצאת בצד שמסד הנתונים אינו רואה, והיא נחשפת רק כשמנחים את המשתמש לבדוק.
קריטריוני הניקוד מחולקים לארבע שכבות, והמשימה הזו משתמשת רק באחת מהן.env_assertions בודק את המצב הסופי (נתונים סלולריים זמינים, מהירות של 200 Mbps ומעלה בדירוג excellent), actions בודק אם הפעולות המרכזיות התרחשו ואיזה צד ביצע אותן, ואילו communicate_info ו‑nl_assertions בודקים אם המידע ההכרחי נמסר למשתמש. ה‑reward_basis של המשימה הזו מצהיר רק על ENV_ASSERTION; יתר השכבות מחושבות ונרשמות כרגיל אך אינן נכנסות לתגמול הסופי. בסיס הניקוד מוצהר לכל משימה בנפרד ואינו מקובע גלובלית.
ה‑trajectory של הרצה אמיתית אחת
כעת אנו מזמינים את הקורא להריץ בעצמו את משימות ההערכה של תחום telecom ב‑τ²-bench, לצפות בתכנון המשימות, בסימולטור המשתמש, בלוגיקת האימות של התהליך ושל התוצאה, ולעקוב אחר ה‑trajectory של ה‑Agent כדי לנתח מדוע הוא נכשל.
ניסוי 7-1 ★: הרצת τ²-bench והשוואת ההתפתחות מ‑τ-bench
הניסוי מריץ את מסגרת ההערכה τ²-bench כדי להבין את נקודות התכנון המרכזיות של סביבת הערכה מסוג אינטראקציה אדם–מחשב. תחילה קראו את קובץ הגדרת המשימות לפי אותו מסלול שנקטנו בסעיף זה: כל משימה מורכבת מארבעה חלקים — מידע ידוע, הוראות משימה, מצב התחלתי ותנאי הצלחה. לאחר מכן הריצו את תהליך ההערכה המלא, צפו בדיאלוג רב‑תורי בין סימולטור המשתמש לבין ה‑Agent, ונתחו דפוסי כשל אופייניים (הפרת מדיניות, השמטת מידע, העברה מוגזמת לנציג אנושי וכדומה).
במאגר הנלווה שמור רישום הרצה אחד (chapter7/tau2-bench-eval). להלן ננתח ממנו הרצה מוצלחת אחת.
עשרה תורים ומשהו ראשונים הם שלב זיהוי החשבון. ה‑Agent מאתר לפי המספר את הלקוח C1001, ואז שולף בזה אחר זה את צריכת הנתונים של שלושת הקווים L1001, L1002 ו‑L1003, וחוזר לשאול באיזה מספר המשתמש משתמש בפועל בצרפת. בהודעה 17 הוא מגיע למסקנה שגויה:
Agent (17): המספר 555-123-2002 אינו נמצא בין הקווים הפעילים שלך, הקרוב ביותר הוא 555-123-2001…
המסקנה נשענת על שאילתה של קו אחד בלבד, L1001. לאחר שהמשתמש מתעקש שהמספר נכון, ה‑Agent שולף את L1002 ורק אז מוצא התאמה. נקודת המפנה המכריעה מגיעה בהודעה 30:
משתמש (30) ← קורא ל‑check_network_status(), check_status_bar()
החזרת הכלי (31): Airplane Mode: ON | Cellular Connection: no_service | Mobile Data Enabled: Yes | Data Roaming Enabled: No
משתמש (33): אני רואה שהטלפון כרגע במצב טיסה, ולכן אין קליטה. הנתונים הסלולריים דלוקים, אבל נדידת הנתונים כבויה. שאכבה את מצב הטיסה ואנסה?
הצד שהנפיק את קריאת הכלי הוא המשתמש, לא ה‑Agent. זהו מנגנון הבקרה הכפולה (Dual-Control): למשתמש המדומה יש ערכת כלים משלו, כגון check_status_bar, toggle_airplane_mode, reseat_sim_card ו‑run_speed_test.
האבחון שלאחר מכן מתנהל בחלקות: ה‑Agent מבקש מהמשתמש לכבות את מצב הטיסה ולהפעיל נדידה, המשתמש מבצע את שתיהן (35, 37), ושורת המצב עוברת ל‑5G בקליטה מלאה; ה‑Agent מבקש בדיקת מהירות, והתוצאה החוזרת היא 275 Mbps בדירוג Excellent (46), והמשתמש מאשר שהבעיה נפתרה. שתי בדיקות env_assertions עוברות, ו‑reward = 1.0.
ב‑trajectory הזה, שקיבל ציון מלא, מסתתרת גם בעיה שהמאמת לא תפס. הפסקה הראשונה במדיניות ה‑Agent של telecom קובעת “You should only make one tool call at a time”, ואילו בהודעה 4 ה‑Agent הנפיק בבת אחת את get_customer_by_phone ואת get_customer_by_name. המאמת לא ראה בכך שגיאה, משום שה‑reward_basis של המשימה מתחשב רק במצב הסופי. אין זו התרשלות של τ²-bench אלא המחיר הטבוע בתגמול בינארי: הוא ממיר את רזולוציית התהליך במספר יחיד הניתן להשוואה בין מודלים. אלא שמערכות הערכה בסביבת ייצור זקוקות בדרך כלל ליותר מזה: לא רק לפסוק נכון או לא נכון, אלא גם להצביע היכן הבעיה.
גם המשימה שנכשלה ראויה לניתוח. מספר המשתמש הוא 555-123-2002, אך ה‑Agent בחר בקו L1001 והמשיך להסיק על סמך צריכה של 3.2/5 ג’יגה-בייט בקו הזה. באמצע הדרך get_details_by_id(L1001) החזיר במפורש שמספר הקו הוא 555-123-2001; ה‑Agent קרא את התוצאה אך לא תיקן את שיפוטו, ואז בזבז עשרות הודעות על בדיקות לא רלוונטיות ולבסוף העביר לנציג אנושי. למעשה הוא ביצע חצי מהמשימה — הנחה את המשתמש לכבות את מצב חיסכון הנתונים, והפעולה הזו בצד המשתמש אכן התרחשה ואומתה על ידי הסביבה. אך בחירת הקו השגויה מנעה את טעינת 2 הג’יגה-בייט הנדרשת, ושלוש קביעות המצב הסופי נכשלו כולן. צורת הכשל הזו דומה מאוד למקרה AndroidWorld הנדון בהמשך בסעיף “ייחוס כשלים”: הראיה הנחוצה לתיקון השיפוט כבר נכנסה להקשר, וה‑Agent לא חזר אליה.
משימה אחת זו כבר מעלה את כל השאלות שעל מערך הערכה לענות עליהן: מהי הצלחה, מהיכן מגיעות המשימות, מי מאמת, וכיצד ציון הופך להחלטה. הסעיפים הבאים דנים בהן בזו אחר זו.
מדדי הערכה: הגדרת ההצלחה
תוצאת ההערכה בסעיף הקודם הייתה ארבע משימות שעברו מתוך חמש. מהמספר 0.8 לבדו אי אפשר לשפוט אם המערכת שמישה. אם מדובר ב‑Agent שירות לקוחות לזיכויים, פירושו שמשתמש אחד מכל חמישה אינו מקבל את הזיכוי המגיע לו; ואם מדובר ב‑Agent אבטחה המחפש פרצות, ארבע פגיעות מתוך חמש הן תוצאה נאה למדי. ההבדל טמון בשאלה איזה שיעור הצלחה תובע התרחיש העסקי.
פלאים טכניים: תקרות יכולת עם Pass@k
מודלים וסוכנים רבים נמצאים עדיין בשלב שאפשר לכנות ״פלא טכני״. הפלא כאן הוא תקרת היכולת המוצגת תחת ריבוי ניסיונות, תקציב זמן נדיב וסינון אנושי: די בהצלחה אחת כדי להוכיח שהדבר אפשרי עקרונית. זו בדיוק ההיגיון של Pass@k — מריצים את אותה משימה k פעמים ומחשיבים אותה כעוברת אם לפחות הרצה אחת עברה; אם הפלט הוא ציון רציף, לוקחים את ההרצה הטובה ביותר וקוראים לכך Best@k.
הדיון של Anthropic בסוכנים ארוכי־ריצה ממחיש תקרה מסוג זה: לתת לסוכן לעבוד באופן עצמאי שבוע שלם ולכתוב מאפס מהדר C; לתת לו לחקור עד שיימצא נגד־דוגמה להשערה מתמטית חשובה; או לסרוק תוכנת קוד פתוח שוב ושוב עד שתתגלה פרצת אבטחה חמורה שישבה שם עשרות שנים.
בחקירה הנדסית ומדעית מסוג זה, מה שמוצג הוא בדרך כלל לא ״לצדוק בכל פעם״ אלא מסלול פורץ־דרך יחיד שמופיע לבסוף אחרי שמותחים מספיק את תקציב החקירה. לגילוי מדעי, ציד פרצות ויצירה פתוחה, התקרה הזו יקרה כשלעצמה: אדם יכול לבחור את המסלול הטוב ביותר מתוך k מסלולים מועמדים.
מלבד מעבדות מודלי היסוד, חברות יישום רבות משתמשות אף הן באסטרטגיית ״הפלא הטכני״. Manus משך תשומת לב רחבה משום שהעמיד לרשות המשתמשים מחשב וירטואלי: מי שלא הייתה לו קודם תפיסה אינטואיטיבית של סוכנים ראה ש‑AI מסוגל להפעיל מחשב כמו אדם, לעבוד חצי שעה ואף שעה ולהשלים משימה מורכבת צעד אחר צעד.
OpenClaw נתן לרבים לחוש לראשונה שסוכן הוא ״מישהו חי״. המשתמש מטיל עליו עבודה דרך יישומון מסרים מיידיים בדיוק כפי שהיה מטיל על אדם אמיתי; הוא ניגש לכל הקבצים במחשב ולשירותים המקוונים, בשלב מסוים מדווח מיוזמתו או מבקש מידע נוסף, ואף מסוגל להעיר את עצמו כדי לבדוק ולטפל בדואר.
ל‑Manus ול‑OpenClaw המוקדמים לא היו שיעורי הצלחה גבוהים במשימות מורכבות, ועלות ה‑token הייתה גבוהה מאוד. אך מכיוון שמסגרות סוכן אלה כלליות, בשילוב עם המודלים החזקים ביותר משימות מורכבות מגיעות לא פעם ל‑Pass@k גבוה, וזו תקרה טכנית גבוהה. השיתוף ההמוני של אותם ״פלאים טכניים״ ברשתות החברתיות היה המפתח להצלחת המוצרים הללו.
אמינות עסקית: התמקדות ב‑Pass^k
עסקים אמיתיים מתעניינים בדרך כלל בהפך: לא לטעות אף לא פעם אחת לאורך ניסיונות חוזרים. ליעד הזה אנו קוראים Pass^k (נהגה Pass consecutive k): מריצים את אותה משימה k פעמים ברצף, דורשים שכל הרצה תעבור, ושלא ייגע באף סעיף וטו של בטיחות, ציות או הזיה. הוא עונה על ״האם הסוכן מסוגל לספק ביציבות ובאמינות״, ולא על ״האם הוא מסוגל לחולל נס מדי פעם״.
אם ההרצות בלתי תלויות וסיכוי ההצלחה בהרצה בודדת הוא p, הקשר בין שני המדדים אינטואיטיבי:
Pass@k=1−(1−p)k,Passk=pk.
למשל עבור p=0.6 ו‑k=5: Pass@5 =1−0.45≈99.0%, ונדמה כי ״לפחות הצלחה אחת״ מתקיימת כמעט תמיד; אבל Pass consecutive@5 =0.65≈7.8%, כלומר לעבור חמש פעמים ברצף בלי שגיאה עדיין קשה. המספר הראשון מתאים למדידת תקרת יכולת בשלב החקירה; רק המספר השני מתקרב לדרישות האמינות של תשלומים, החזרים, שינויי הרשאות ופריסה לייצור.
דוח ההערכה חייב לנסח במדויק מהן k ההרצות: k דגימות בלתי תלויות של אותה משימה, או k משימות עוקבות בקו ייצור. בפעולות בעלות תופעות לוואי אי אפשר פשוט ״לנסות שוב עד שמצליח״; יש לדגום בארגז חול או בסביבה הניתנת לשחזור לאחור, ולרשום כל כישלון במדד האמינות.
סביבת ההערכה
לאחר שבסיס המדד ברור, השאלה הבאה היא היכן למדוד. סביבת הערכה היא מתקן הניתן להרצה חוזרת: בהינתן אותו מצב התחלתי, אותו Agent אמור להניב תוצאות בנות השוואה.
חמשת המרכיבים
נחזור למשימת telecom שנותחה למעלה. אם ניקח אותה כאמת מידה, כל מה שדרוש לסביבת הערכה הניתנת להרצה חוזרת כבר קיים.
מערך נתונים (Dataset) הוא קובץ המשימות עצמו: המצב ההתחלתי, הכרטיס ל‑Agent, כללי ההתנהגות לסימולטור וקריטריוני הקבלה ארוזים ברשומה אחת, ורשומה אחת היא מקרה בדיקה אחד.
מצב הסביבה (Environment State) הוא המידע המשתנה במהלך ביצוע המשימה: לקוחות, קווים, חבילות וחשבוניות במסד הנתונים, ובנוסף מצב טיסה, נדידה, מתג חיסכון בנתונים ויתרת הנפח בצד המכשיר. הוא חייב להיות ניתן לאיפוס, ו‑initialization_actions הוא סקריפט האיפוס. האותנטיות דורשת ששינויי המצב יצייתו ללוגיקה העסקית, והשליטוּת דורשת שלפני כל הרצה אפשר יהיה לחזור לאותה נקודת פתיחה.
ממשק הכלים (Tools) מחולק לשני צדדים. ה‑Agent יכול לקרוא לפעולות בצד המפעיל — שאילתת לקוח, שאילתת צריכה, טעינת נתונים, העברה לנציג אנושי; המשתמש יכול להפעיל את המתגים במכשירו. שתי ערכות הכלים הן פעולות אטומיות, ואין הפשטה גבוהה מסוג “פתור את בעיית האינטרנט של המשתמש” — רמת הפשטה גבוהה מדי מורידה את ההערכה לבדיקה של קריאת פונקציה אחת, והתכנון וההסקה נבלעים בכלי עצמו.
קריטריון הניקוד (Rubric) הוא ארבע שכבות הבדיקה ב‑evaluation_criteria בתוספת כלל הצבירה reward_basis.
פרוטוקול הביצוע (Interaction Protocol) קובע את סדר האינטראקציה ואת תנאי הסיום. אות הסיום התקין כאן הוא שהמשתמש המדומה יפיק ###STOP###; בנוסף יש תקרת תורים, והמשתמש המדומה עשוי לסיים את השיחה מיוזמתו כשאוזלת סבלנותו — יעילות תקשורת נמוכה מדי נחשבת כשלעצמה לכישלון.
אם חסר אחד מחמשת המרכיבים, ההערכה חדלה להוות מחזור הניתן לחזרה. גם כשנבחן בהמשך מבחני ייחוס אחרים, נמשיך להשתמש בחמשת הסעיפים האלה כמסגרת השוואה.
סביבות הערכה מסוג אינטראקציה אדם–מחשב ומסוג קריאה לכלים
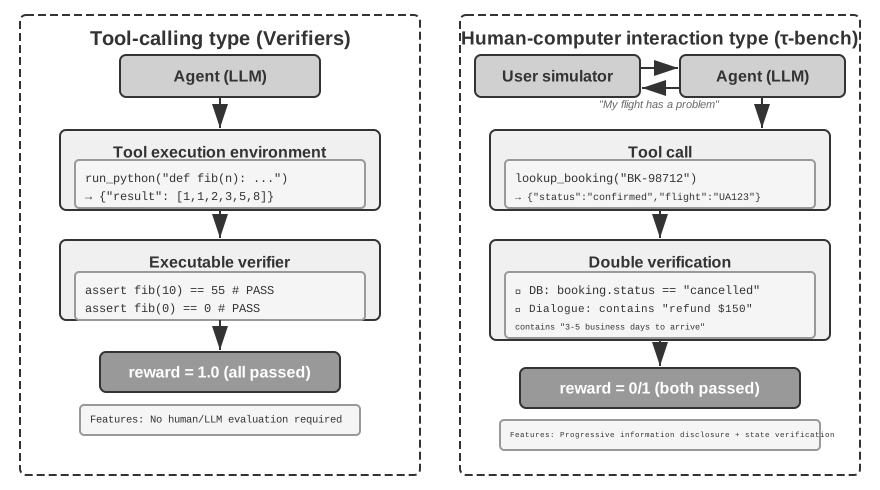
למשימות מסוג telecom חייב להיות בן שיח, ולכן חלק סימולציית המשתmash מבין חמשת המרכיבים הוא הכרחי. קיים גם מחלקת משימות גדולה אחרת שאין בה בן שיח כלל: בייצור קוד, בניתוח נתונים ובפתרון בעיות מתמטיות ה‑Agent מקיים אינטראקציה מתחילה ועד סוף רק עם כלים, הנכונות נקבעת לפי מעבר אימות בהרצה, ואין צורך לא בתיוג אנושי ולא בשיפוט של מודל. סביבות מסוג זה מוותרות על סימולטור המשתמש; ארבעת המרכיבים הנותרים עדיין קיימים, רק בצורה פשוטה יותר: מצב הסביבה הוא מערכת קבצים או מסד נתונים, קריטריון הניקוד הוא פיסת קוד בדיקה, ופרוטוקול הביצוע מצטמצם ל”המשך לקרוא לכלים עד שתינתן תשובה או ייגמרו התורים”.
מסגרת Verifiers מרבדת סביבות מסוג זה לפי שני ממדים: אם המשימה צריכה לשמור מצב בין תורים, ואם דרושה בידוד. SingleTurnEnv מתאים להצגת בעיה מתמטית ואימות התשובה ישירות; ToolEnv מתאים לחיפוש בכמה דפי אינטרנט, מתן תשובה מסכמת ואימות התוצאה הסופית; StatefulToolEnv מתאים לשינוי רשומה במסד נתונים ואימות שינוי המצב; ו‑SandboxEnv מתאים להרצת קוד בארגז חול ובדיקת קובצי הפלט. טבלה 7‑1 מסכמת את ארבעת הסוגים, כדי להקל על הבחירה לפי דרישות המצב, קריאת הכלים והבידוד.
טבלה 7‑1 השוואת סוגי סביבות Verifiers
סוג הסביבה
שמירת מצב
קריאת כלים
שימוש אופייני
SingleTurnEnv
אין
אין
שאלה ותשובה בתור אחד, מתמטיקה
ToolEnv
אין
רב‑תורי
חיפוש + סינתזת מידע
StatefulToolEnv
יש
רב‑תורי
שינוי רשומות במסד נתונים
SandboxEnv
יש + מבודד
רב‑תורי
הרצת קוד ובדיקות
המסגרת תומכת בדגימה מקבילית ובמטמון trajectory; ה‑trajectory המלא של כל הערכה (תצפית, פעולה, תגמול) נשמר, מה שמקל על ניתוח והרצה חוזרת בהמשך. כמו כן, אפקט ההרצה של כלי תלוי במצב הנוכחי, ולכן בכישלון ראוי להחזיר הודעת שגיאה ברורה ולא דגל כישלון חשוף, כדי שה‑Agent יוכל להתאים את האסטרטגיה בהתאם.
הערכה מסוג קריאה לכלים בוחנת את נכונות שינויי המצב הנצפים, והערכה מסוג אינטראקציה אדם–מחשב בוחנת את סבירות אסטרטגיית התקשורת: הראשונה מאמתת פעולה, השנייה מאמתת הכוונה. להשוואת המבנה של שני סוגי הסביבות ראו איור 7‑2.
איור 7‑2: סביבות הערכה לקריאה לכלים ולאינטראקציה אדם–מחשב · איור המקור
תכנון מערך הנתונים להערכה
אם סביבת ההערכה היא הבמה, מערך הנתונים הוא התסריט. עם אותם חמישה מרכיבים, מעבר למחלקת משימות אחרת עשוי לשנות לגמרי את אופן המילוי: מהיכן מגיעות המשימות, לאיזה עומק המאמת יכול לבדוק, וכיצד מונעים שינון. הסעיף יוצא מהפרקטיקה התכנונית של כמה מבחני ייחוס ציבוריים ומסתיים בשאלה מעשית יותר — מהיכן צריכות להגיע המשימות במערך ההערכה שאתם בונים בעצמכם.
השוואה רוחבית של החלטות תכנון בין מבחני ייחוס
קיומו או היעדרו של בן שיח, שהבחנו בו בסעיף הקודם, הוא רק שכבת ההבדל הראשונה ברמת הסביבה; הפערים ברמת מערך הנתונים משקפים טוב יותר את שיקולי התכנון. טבלה 7‑2 מציבה זו לצד זו כמה מבחני ייחוס המצוטטים לעיתים קרובות.
טבלה 7‑2 החלטות תכנון מרכזיות בכמה מבחני ייחוס ל‑Agent
מבחן ייחוס
היכולת הנבחנת
מקור המשימות
מי מגלם את הסביבה
מאמת
τ²-bench
אינטראקציה אדם–מחשב וקריאה לכלים בשירות לקוחות
כתיבה ידנית + יצירה קומבינטורית
סימולטור משתמש + מסד נתונים עסקי
ארבע שכבות בדיקה הנצברות לבינארי לפי reward_basis
SWE-bench Verified
פיתוח תוכנה, coding
issue אמיתיים מ‑GitHub, סוננו ידנית
מאגר קוד + חבילת בדיקות
אימות כפול FAIL_TO_PASS / PASS_TO_PASS
AndroidWorld
הפעלת ממשק GUI של טלפון Android
הנבטת תבניות פרמטריות
אמולטור Android אמיתי
קביעות על מצב ה‑UI הסופי
OSWorld
הפעלת ממשק GUI של שולחן עבודה Linux
מתחיל ממצב ביניים שהוגדר מראש
מכונה וירטואלית אמיתית
134 פונקציות הערכה עצמאיות
Terminal-Bench
הפעלת מסוף Linux, coding
כתיבה ידנית
מכולת Docker
בדיקת מערכת קבצים + הרצה אמיתית
GAIA
עוזר AI כללי לאיסוף מידע
כתיבה ידנית + קבצים מצורפים ייעודיים
האינטרנט הפתוח
התאמת מחרוזת מדויקת
מאמתים
קל ל‑Agent לכתוב דוח ארוך ומפורט הטוען שהמשימה הושלמה במלואה, בעוד שבפועל לא הושלם דבר. מסגרת ההערכה חייבת לאמת עובדות שמכונה יכולה לבדוק באופן עצמאי, ולא את ההצהרה של ה‑Agent על עצמו.
SWE-bench Verified מפרק את “התיקון הושלם” לשתי טענות עצמאיות. האחת היא FAIL_TO_PASS: נכשל לפני התיקון ועובר אחריו, מה שמוכיח שהבעיה אכן נפתרה. השנייה היא PASS_TO_PASS: עובר לפני התיקון ואחריו, מה שמוכיח שלא הוכנס פגם חדש. אם בודקים רק את הראשונה, ה‑Agent יכול לחמוק על ידי מחיקת קביעות מפריעות או שינוין; אם בודקים רק את השנייה, זה כמו לא לבדוק כלל. רק בדיקת שתיהן יחד הופכת את “תוקן” ואת “לא נשבר דבר” לשתי מסקנות הניתנות להוכחה בנפרד. בנוסף מאושרת יציבות הבדיקות עצמן, תוך סילוק בדיקות לא יציבות (flaky test) שפעם עוברות ופעם נכשלות.
המאמת של OSWorld מסוגל לגלות מצבים שנראים מושלמים כלפי חוץ אך שגויים במהותם. הוא מצויד ב‑134 פונקציות הערכה עצמאיות ובגישה מלאה למערכת ההפעלה, ולכן יכול לבדוק את מבנה מערכת הקבצים, מצבי תהליכים, חיבורי רשת ומצב פנימי של יישומים. במשימות מסד נתונים סקריפט ההערכה אינו מסתפק באישור קיומו של קובץ הדוח אלא מתחבר למסד הנתונים כדי לוודא שה‑SQL אכן רץ; במשימות דפדפן הוא מנתח את עץ ה‑DOM, בודק cookie ו‑localStorage ושולח בקשות אימות ל‑backend כדי לוודא שהטופס באמת נקלט.
המשימה build-linux-kernel-qemu של Terminal-Bench דורשת לבנות את ליבת Linux 6.9 מהמקור, להוסיף printk מותאם ב‑start_kernel, לייצר initramfs ולהריץ אותו ב‑QEMU; קריטריון ההצלחה הוא הופעת אותה הודעה מותאמת ביומן האתחול. ה‑Agent אינו יכול לזייף את הפלט, ואין לו ברירה אלא להשלים את כל התהליך באמת.
חלוקת רמות הקושי של המשימות
מערך משימות הערכה צריך לכלול משימות ברמות קושי שונות. כך, כשיכולות המודלים משתפרות, המערך אינו מתיישן במהירות.
כל 466 השאלות של GAIA מחולקות לשלוש רמות קושי: ב‑Level 1 די בכלי אחד או שניים (בני אדם 93.9%, GPT-4 30.3%), Level 2 דורש חשיבה רב‑שלבית (91.8% מול 9.7%), ו‑Level 3 דורש הרכבה מורכבת (87.3% מול 0%). הריבוד הזה אינו רק תיוג קושי אלא בעל ערך אבחוני: כישלון ב‑Level 1 מצביע על שימוש בסיסי בכלים, Level 2 על תכנון רב‑שלבי ושילוב מידע, ו‑Level 3 על חשיבה לאורך רצפים ארוכים וניהול מורכבות, וכל אחד מהם מתאים לכיוון שיפור אחר.
Terminal-Bench משתרע מרישום מודל mlflow פשוט, דרך פריצת סיסמת 7z בדרגת קושי בינונית, אינטגרציה קשה רבת‑רכיבים של שרת git ושרת אינטרנט, ועד לניתוח הצפנה דיפרנציאלי של FEAL — הקשה מכולם.
τ²-bench אף מתכנן במיוחד משימות מלכודת: המשתמש טוען ש”שירות הלקוחות כבר אישר את הביטול” בעוד שבפועל הדבר אינו תואם את המדיניות, כדי לבחון אם ה‑Agent שומר על שיפוט נכון תחת לחץ והטעיה.
מניעת דליפת נתונים
GAIA הופך את תשובותיו לבלתי ניתנות לחיפוש ישיר באינטרנט. משימותיו פשוטות מבחינה רעיונית אך פתוחות מבחינת הדרך: למשל, לצאת מתמונת האסטרונומיה היומית של נאס”א בתאריך מסוים, לזהות את האסטרונאוט בתצלום, לאתר את קבוצת האסטרונאוטים שאליה השתייך, לחשב מי מבני הקבוצה שהה בחלל הכי מעט זמן, ולהפיק את התוצאה בפורמט קפדני של “שם משפחה, מופרד בנקודה‑פסיק, עם מפרידי אלפים”. התשובה ספציפית מאוד, ונכונותה נקבעת בהתאמת מחרוזת מדויקת. מניעת הדליפה נשענת על שני דברים: ראשית, אפשר לענות על השאלה רק בשילוב כמה מקורות מידע, ואף דף אינטרנט בודד אינו מספק את התשובה ישירות; שנית, לחלק מהמשימות מצורפים קבצים שהוכנו במיוחד (קובצי PDF, שמע ותמונות שאינם קיימים באינטרנט).
AndroidWorld גוזר מספר רב של מופעים מתבנית אחת. משימותיו אינן טקסט סטטי אלא תבניות הניתנות להנבטה דינמית, כגון “שנה את מספר הטלפון של איש הקשר [CONTACT_NAME] ל‑[NEW_PHONE]”, כשערכי הפרמטרים נוצרים אקראית בכל הערכה. לכך שלוש תועלות: הפרמטרים שונים בכל פעם, ולכן הרצה חוזרת של רצף פעולות קבוע חסרת ערך; תבנית אחת יכולה לייצר מופעים כמעט בלתי מוגבלים; וקיבוע חלק מהפרמטרים ושינוי היתר מאפשר למדוד במדויק את השפעתו של גורם מסוים.
Terminal-Bench משבץ מזהה קנרית בגוף השאלה. כל שאלה נושאת canary GUID; אם מודל מסוגל להפיק תוכן המכיל את המזהה הזה, סימן שנתוני מבחן הייחוס נכנסו למערך האימון. הדבר אינו מונע דליפה אך הופך אותה לניתנת לגילוי.
בקרת איכות ותחזוקה ארוכת טווח
הכנת מערך הערכה איכותי היא משימה קשה מאוד. צורתם הנוכחית של רוב מבחני הייחוס לעיל היא תוצאה של סבבי תיקון חוזרים לאחר שהגרסה הראשונה נכנסה לשימוש ובעיותיה נחשפו. כך למשל, מ‑τ-bench ל‑τ²-bench תוכננו מחדש חמישה מקומות.
ראשית, הוראות המשימה היו כלליות מדי, ולכן אפשר היה לנחש את התשובה. הוראות הגרסה הראשונה נכתבו ברוחב יד, ולכן המודל לא נזקק לחדד באמת את הבקשה: די היה לנחש נוהל מתוך היגיון בריא כדי לעבור. τ²-bench פיצל את התסריט לשתי משבצות, known_info ו‑task_instructions: הראשונה מתחמת את מה שהמשתמש יודע, השנייה מסדירה את אופן החשיפה. את מה שהמשתמש אינו יודע אין ל‑Agent דרך לנחש, והוא יכול להשיגו רק בשאילתה.
שנית, תנאי ההצלחה לא היו מדויקים דיים, ולכן האימות שגה בשיפוט. לתנאי כמו “הרשת חזרה” אין גבול הניתן לבדיקה. τ²-bench שינה אותו ל”נחשב פתור רק אם בדיקת המהירות מחזירה excellent; poor, fair ו‑good אינם מתקבלים”. השינוי מכוון אל תיקוני למראית עין, המדכאים את הסימפטום בלי לפתור את שורש הבעיה.
שלישית, התנהגות סימולטור המשתמש הייתה מכנית מדי. המשתמש המדומה בגרסה הראשונה רק הגיב באופן פסיבי. τ²-bench הוסיף לו רגש (להביע אי‑שביעות רצון אחרי תיקון ראשון שנכשל), גבול סבלנות (לסיים את השיחה כשהתקשורת בלתי יעילה מדי) ואת דרישת העיגון העובדתי. שלושתם יחד מקרבים את הסימולטור למשתמש אמיתי תוך שמירה על יכולת שחזור.
רביעית, המשתמש משתתף לא רק בשיחה אלא גם בביצוע. תחום telecom הכניס את סביבת הבקרה הכפולה. בהערכות הקודמות רק ה‑Agent יכול היה לשנות את הסביבה, בעוד שבתרחישים כמו תמיכה טכנית חלק ניכר מהפעולות אמור להתבצע בידי המשתמש עצמו במכשירו. הבקרה הכפולה אף מוסיפה ממד לאימות: לאחר שהמשתמש משנה את המצב, ה‑Agent יכול לדעת את התוצאה רק בקריאה חוזרת לכלי, ולכן האימות מכסה כעת גם את השאלה “האם ה‑Agent אכן קרא את תוצאת הפעולה בצד המשתמש”.
חמישית, מופעי המשימות נוצרים דינמית. המופעים הקונקרטיים של τ²-bench (שמות משתמשים, מספרים, צירופי תקלות) ניתנים לפרמטריזציה וליצירה בכמות, וזה משפר גם את הכיסוי וגם את העמידות בפני דליפה.
SWE-bench Verified: לפני הפרסום נפסלו 71% מהמשימות המקוריות. OpenAI בחרה אקראית 1,699 מתוך 2,294 המשימות המקוריות להערכה אנושית, וגייסה 93 מפתחים הבקיאים ב‑Python לבדוק כל אחת בנפרד: אם תיאור הבעיה ברור, אם מקרי הבדיקה מכסים תנאי קצה, אם הבדיקות יציבות, אם ה‑patch הייחוס מכניס שגיאות חדשות, ואם הקושי סביר. בסופו של דבר עברו רק 500. שיעור הפסילה הגבוה מניב יחס אות לרעש טוב יותר, ועלות ההערכה יורדת בכ‑80%. משימות Agent מורכבות אורכות לא אחת מדקות ועד שעות, והרצת מערך הערכה שלם עם מודל חזית עולה פעמים רבות אלפי דולרים באסימונים, ולכן הפחתת עלות ההערכה חשובה מאוד.
OSWorld: ב‑15 החודשים שלאחר הפרסום נחשפו יותר מ‑300 בעיות. לאחר צאתו באפריל 2024 הפך במהירות למבחן ייחוס חשוב להערכת Agent רב‑מודלי, אך השימוש הרחב שלאחר מכן חשף ארבעה סוגי בעיות: בעיות סביבה (הגנת אתרים מפני גריפה, CAPTCHA, שינוי תוכן דינמי), בעיות בתיאור המשימות (ניסוח דו‑משמעי), בעיות בלוגיקת האימות (מחמירה או מקלה מדי) ובעיות במצב ההתחלתי (תצורה חסרה). צוות מאוניברסיטת הונג קונג הקים קבוצה של כעשרה אנשים ועבד חודשיים בשיתוף הדוק עם MoonShot AI, OpenAI, ByteDance Seed TARS, Anthropic, Simular ואחרים על תיקון שיטתי: בעיות הסביבה טופלו בנעילת גרסאות ובגיבויים לא‑מקוונים, בעיות התיאור בשכתוב ניסוחים דו‑משמעיים, בעיות האימות בהקמה ידנית של קו בסיס נכון ובכוונון התנאים, ובעיות המצב ההתחלתי בהוספת בדיקות שלמות.
ניסוי 7-2 ★: ביצוע ידני של משימות מבחני ייחוס
בחרו משימות מ‑GAIA, AndroidWorld, SWE-Bench Verified, Terminal-Bench ו‑OSWorld-Verified והשלימו אותן במו ידיכם; מומלץ לבצע מכל מערך אחת קלה, אחת בינונית ואחת קשה. הרמה “קשה” מאתגרת גם בני אדם.
בסיום ענו על שתי שאלות. האם תיאור המשימה סובל יותר מפרשנות סבירה אחת, ואם כן — באיזו מהן מכיר המאמת? ואם ינסה מישהו לחמוק בלי לעשות את העבודה, מהי הדרך הזולה ביותר, והאם המאמת יוכל לחסום אותה?
שלושת מקורותיו של מערך ההערכה
רווחת הדעה שמבחני ייחוס ציבוריים משרתים דירוג מודלים וקשורים מעט לעסק האמיתי. אכן, קשה שציוני מבחני ייחוס ציבוריים יכוונו ישירות החלטות מוצר, אך שיטות התכנון שלהם ניתנות להעברה במלואן. עומק האימות, יצירה פרמטרית, מניעת דליפה ותחזוקת איכות — כל מה שנדון לעיל — הם בדיוק הנקודות שקל ביותר לפספס במערך הערכה שבונים בעצמם.
למערך הערכה בסביבת ייצור יש בדרך כלל שלושה מקורות.
מבחני ייחוס ציבוריים משמשים לסינון גס של מודלים ולשאילת שיטות תכנון, ובדרך כלל לא להחלטות מוצר. התפלגות המשימות שלהם אינה חופפת להתפלגות המשימות של העסק האמיתי; עלייה של שתי נקודות אחוז ב‑GAIA אינה קשורה בהכרח לשיעור ההצלחה של זיכויים.
מערך עסקי שבונים בעצמם מכסה את התפלגות המשימות האמיתית, ויכול לשמש בסיס לבחירת מודל ולהחלטות תכנון של ה‑Harness. למשל, אפשר להשתמש ב‑τ²-bench כשלד לכל מערכת הערכה הזקוקה למשתמש מדומה; די להחליף את נתוני התחום ואת ערכת הכלים.
זרימה חוזרת של trajectory מהייצור מגיעה מכשלים אמיתיים בשטח: תיקונים מפורשים מצד המשתמש, דירוגים שליליים שלו, ומקרים שהתגלו בדיעבד בבדיקת מצב, במאמת מבוסס כללים או בסקירה של מודל שפה. לאחר שעברו ייחוס כשלים, הם משתקעים כמקרי רגרסיה. הדרך המפורטת מתוארת בהמשך בסעיפים “ייחוס כשלים” ו”משימות רגרסיה מקצה לקצה ומשימות רגרסיה של trajectory prefix”. המקור הזה הוא היקר ביותר וגם המדויק ביותר, משום שהוא מגיע ישירות ממה שהמשתמשים נתקלו בו בפועל.
בשלב הראשוני יש בדרך כלל רק מבחני ייחוס ציבוריים ומערך עסקי קטן שנכתב ידנית; לאחר שהמערכת פועלת זמן מה בייצור, המקרים שזרמו חזרה מה‑trajectory של הייצור הופכים לעיקר.
שיטות הערכה אוטומטיות
למבחני הייחוס שנדונו בסעיפים הקודמים יש מכנה משותף: המאמתים שלהם דטרמיניסטיים כמעט כולם. SWE-bench מריץ חבילת בדיקות, AndroidWorld קובע את מצב ה‑UI הסופי, GAIA מבצע התאמת מחרוזת מדויקת, וארבע שכבות הבדיקה של τ²-bench מורצות אף הן כולן בקוד. לבחירה הזו יש נימוקים טובים: אימות דטרמיניסטי אינו מוסיף עלות מודל, התוצאה ניתנת לשחזור מלא, אפשר לשלב אותו באינטגרציה רציפה כמו בדיקת יחידה, והוא מקל על דירוג בין מודלים.
מחירו הוא שהוא מסוגל להעריך רק אם התוצאה הסופית נכונה, אך אינו מספק את סיבת השגיאה. המשימה שנכשלה ב‑τ²-bench קיבלה בסופו של דבר 0 נקודות, ואותו 0 אינו מסביר אם ה‑Agent שגה בשלב בחירת הקו או פספס את שלב טעינת הנתונים, ובוודאי אינו מצביע על מה יש לשנות בשלב הבא. עבור מבחן ייחוס ציבורי המשמש לדירוג אין זה פגם; עבור מערכת ייצור הזקוקה לשיפור מתמיד זהו בדיוק המידע הנחוץ ביותר.
לסביבת הייצור יש קושי שני: הרבה שיפוטים אינם ניתנים כלל לניסוח כקביעה שקוד יכול לבדוק. אם מענה לתלונה הולם, אם דוח מחקר החסיר מידע מרכזי, אם אחזור זיכרון בלבל בין יחסי אנשים — לכל אלה אין מצב סופי יחיד שאפשר לשאול עליו, ואי אפשר להכריע בהם בהתאמת מילות מפתח.
לכן, במעבר ממבחני ייחוס ציבוריים להערכה בסביבת ייצור, יש להזיז את אופן האימות ימינה לאורך ספקטרום שצירו האופקי הוא מידת יכולת האימות המכנית של המשימה, כמוצג באיור 7‑4.
איור 7‑4: ספקטרום אופני האימות — מאימות דטרמיניסטי לשיפוט מודל · איור המקור
כך הופכים שני הכלים שבצד ימין של הספקטרום לעמוד השדרה של הערכת ייצור: Rubric מפרק את השאלה המעורפלת “טוב או לא” לכמה ממדים הניתנים לניקוד בנפרד, ו‑LLM-as-a-Judge מבצע את הניקוד היכן שאין קריטריון דטרמיניסטי. רק בשילובם אפשר להחזיר שיעור כישלון מעורפל לבעיות קונקרטיות שאפשר לגשת לתקנן; ובצירוף ייחוס כשלים שבמחצית השנייה של הסעיף נוצר המעגל הסגור המלא של הערכת Agent בייצור.
יש להדגיש: ההזזה ימינה אינה משמעה נטישת הצד השמאלי. כל בדיקה שאפשר לכתוב כקביעה תוכניתית צריכה להישאר קביעה, ושיפוט המודל מיועד רק לממדים שבאמת אינם ניתנים להכרעה מכנית. בדיקות דטרמיניסטיות זולות ויציבות יותר, ומתאימות יותר גם להרצה ארוכת טווח כבדיקות רגרסיה.
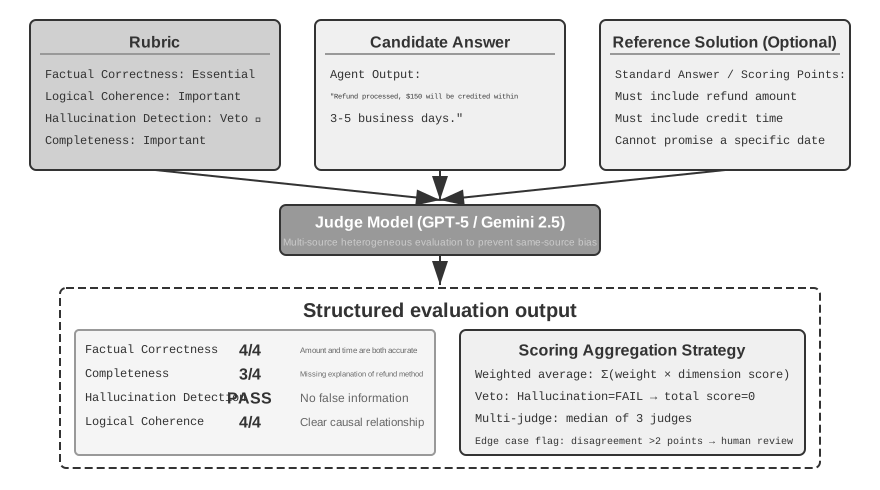
מדוע נדרש LLM‑as‑a‑Judge? עבור משימות פתוחות (למשל, יצירת דוחות, טיפול בתלונות לקוחות, תוכן יצירתי), אין תשובות תקן להשוואה אוטומטית, והערכה אנושית יקרה וקשה להרחבה. LLM‑as‑a‑Judge מאזן בין ניתנות ההרחבה של אוטומציה לבין שיפוט של מומחה אנושי בכך שהוא מאפשר למודל שפה להעריך פלטים אל מול קריטריוני ניקוד שהוגדרו על ידי מומחים (Rubric). לשיטה יש עם זאת מגבלות ידועות: למודל השופט יש הטיות משלו (הטיפוסית ביותר היא הטיית אורך — נטייה לנקד תגובות ארוכות ומפורטות יותר גבוה יותר גם כשהן אינן נכונות יותר), ושיפוטים חוזרים של אותו קלט יכולים להשתנות. הטיית אורך בפרט מצדיקה אמצעי נגד ספציפיים. שלוש הגנות נפוצות הן: להעניש מילוליות יתר במפורש ב‑Rubric ולהגביל את אורך התגובה לכל סוג משימה; בהשוואות זוגיות, להביא את שני המועמדים לאורכים דומים לפני השיפוט; ולבקר באופן קבוע את המתאם בין הציונים לבין אורך התגובה — אם ציונים גבוהים הולכים כמעט תמיד לתגובות ארוכות, השופט הוטה על ידי האורך וה‑Rubric דורש תיקון. כדי לטפל באתגרים אלה באופן שיטתי, עיצוב ה‑Rubric חייב לעקוב אחר העקרונות שלהלן:
Rubric (קריטריוני ניקוד): הבסיס לשיפוט ה‑LLM.
ארבעת עקרונות ה‑Rubric (Scale AI, “Rubrics as Rewards”):
(1) מבוסס הנחיית מומחים — Rubric חייב לשקף ידע תחומי, וללכוד את עובדות הליבה ואת שלבי ההיסק. Rubric לשאלות ותשובות רפואיות, למשל, זקוק לקריטריונים אבחנתיים ולשגיאות הרפואיות שיש להימנע מהן; Rubric ללא עיגון מומחים יכול ללכוד רק מאפיינים שטחיים כגון רהיטות.
(2) כיסוי מקיף — Rubric צריך לכסות דיוק עובדתי, קוהרנטיות לוגית, שלמות ובטיחות. עליו לא רק להגדיר תקנים חיוביים אלא גם לזהות במפורש מלכודות — כלומר שגיאות נפוצות בסיכון גבוה, כגון המלצה על טיפולים לא מאומתים בייעוץ רפואי.
(3) שקלול חשיבות מתוקנן — סווגו קריטריונים כחיוניים, חשובים, אופציונליים או פריטי מלכודת. הסכימה תומכת במנגנון וטו: לדוגמה, בתרחיש שירות לקוחות, הזיה (בדיית מידע כוזב) היא ממד וטו טיפוסי — ללא קשר לביצועים בממדים אחרים, אם מופיע מידע כוזב, יש להטיל וטו. הדבר גם מסייע למנוע reward hacking באמצעות מילוי במילות מפתח.
(4) הערכה עצמאית — כל פריט הערכה ניתן לפעולה באופן עצמאי ואינו נשען על ידע תחומי של המעריך. יש להימנע מתקנים מופשטים כגון “התגובה מפגינה הבנה עמוקה”, ולהחליפם בתקנים ניתנים לאימות כגון “מצטטת לפחות שתי תיאוריות סמכותיות ומסבירה במדויק כיצד הן תומכות במסקנה”.
הפרקטיקה המרכזית: הגדירו רמות ניקוד ניתנות לאימות אובייקטיבי לכל ממד, עם דוגמאות מוחשיות ומקרי קצה ליישוב מצבים עמומים. היזהרו באופן פעיל מ‑Reward Hacking — הסוכן מוצא “קיצור דרך” לציון גבוה מבלי להשלים בפועל את המשימה — באמצעות ענישה מפורשת של הזיה, חנפנות, מילוי במילות מפתח והתחמקות משאלות קשות. Rubric הוא תוצר איטרטיבי: שימוש ניסיוני חושף אי‑הסכמות בין מעריכים, וה‑Rubric מתפתח בהדרגה באמצעות משוב זה מעקרונות מופשטים לספר מקרים מפורט.
להלן Rubric שלם העוקב אחר ארבעת העקרונות, תוך שימוש בסוכן זיכרון משתמש כדוגמה. שאלת הבדיקה: “מי רופא הילדים של הבת שלי?” (התשובה דורשת קישור מידע בין שתי שיחות: השיחה הראשונה מזכירה “שם הבת שלי לילי”, השנייה מזכירה “לקחתי את לילי לד”ר חן”).
rubric:
  dimensions:
    - name: Factual Correctness
      weight: essential        # Essential item
      scoring:
        4_Excellent: "Correctly answers Dr. Chen, and links to daughter Lily"
         3_Good: "Correctly answers Dr. Chen but does not mention that Dr. Chen is Lily's doctor"
        2_Passable: "Gives the correct doctor but with additional uncertain information"
        1_Fail: "Gives an incorrect doctor's name, or answers 'I don't know'"

    - name: Information Completeness
      weight: important        # Important item
      scoring:
        4_Excellent: "Proactively supplements relevant information (e.g., last visit date, diagnosis)"
        3_Good: "Answers the core question without omission"
        2_Passable: "Answers the core question but omits available related information"
        1_Fail: "Key information is missing"

    - name: Reasoning Correctness
      weight: important
      scoring:
        4_Excellent: "Correctly links the two cross-session pieces of information: 'daughter=Lily' and 'Lily's doctor=Dr. Chen'"
        3_Good: "Correctly links but the reasoning path is not clear enough"
        2_Passable: "Partially correct linking"
        1_Fail: "Incorrect linking (e.g., mistaking the user's own doctor for the daughter's doctor)"

    - name: Hallucination Detection
      weight: veto             # Veto item: once triggered, total score is zero
      scoring:
        pass: "All information can be traced back to historical conversation records"
        fail: "Fabricated information not present in the conversation (e.g., fictitious visit dates, diagnoses)"

  edge_cases:
    - "If the user has multiple daughters who see different doctors, should ask which daughter"
    - "If the memory contains both 'Dr. Chen' and '陈医生' (the same name written in Chinese), should recognize them as the same person"
Rubric טוב מול Rubric גרוע: כל רמת ניקוד לעיל מציינת התנהגות מוחשית וניתנת לאימות (“עונה נכון ד”ר חן”) ולא תיאורים שאין לשפוט אובייקטיבית, כגון “מפגין הבנה עמוקה של זיכרון”. פריט הווטו קובע את הרף התחתון: גם אם כל ממד אחר מקבל ציון מלא, מקרה הזיה בודד מביא לאפס אוטומטי.
תנו לשופט הן את ה‑Rubric והן את תגובת הסוכן. הוא ינקד כל ממד ויסביר מדוע. ברגע שתוצאות מעשרות מקרים מקובצות לפי ממד והמסלולים בעלי הציון הנמוך משוחזרים, ירידה עמומה בשיעור ההצלחה הופכת לאבחנה מוחשית: האחזור החמיץ עובדה, המודל קישר את האנשים או האירועים השגויים, או שהוא הוסיף טענה בלתי נתמכת. Rubric שימושי מגלה לצוות לא רק כמה ניקדה המערכת, אלא היכן להסתכל הלאה.
בהמשך ניקח את זיכרון המשתמש כמקרה מוחשי, כדי להראות כיצד מורידים את השיטה הכללית הזו לכדי מערך הערכה ומעריך ברי-הרצה.
ניסוי 7‑3 ★★: בניית מערכת הערכת זיכרון משתמש מבוססת Rubric
תנאי מקדים: יש להשלים את ניסוי זיכרון המשתמש של פרק 3 (chapter3/user-memory-evaluation).
ניסוי זה דורש שינוי של מסגרת chapter3/user-memory-evaluation מפרק 3, ושדרוג מנגנון הניקוד הנוכחי הפשוט מסוג LLM‑as‑a‑Judge למערכת הערכת Rubric מובנית ורב‑ממדית. המערכת הקיימת משתמשת בקריאת LLM יחידה כדי להחזיר תוצאת עובר/נכשל בתוספת נימוקי הערכה, וחסרה יכולות אבחון מובנות.
עצבו מסגרת Rubric רב‑ממדית אחידה הישימה לכל שלוש רמות המשימה. ממדי ההערכה כוללים: נכונות עובדתית (דיוק: מכל המידע שניתן, כמה ממנו נכון — מאמת שמספרים/תאריכים/שמות עקביים עם הזיכרון המאוחסן); שלמות המידע (היזכרות: מכל המידע שהיה צריך להינתן, כמה ממנו מוזכר — מאמת שכל המידע הרלוונטי סופק ללא השמטת תוכן מרכזי); נכונות ההיסק (בודקת האם היחסים בין פריטי המידע והלוגיקה המשתמעת מובנים נכון); יזמות ההיסק (מעריכה האם ניתנות הצעות או אזהרות סיכון מעבר לתשובה ישירה כשמתאים); זיהוי הזיות (מבטיח שלא נבדה מידע שאינו קיים בזיכרון).
ניקוד בארבע רמות (מצוין/טוב/סביר/נכשל), עם קריטריוני שיפוט ספציפיים לכל רמה ולא תיאורים מופשטים. ממד ההזיות הוא פריט וטו. ספקו דוגמאות ומקרי גבול לכל ממד.
ניסוי 7‑4 ★★: הערכה השוואתית של Advanced JSON Cards מול RAG
תנאי מקדים: יש להשלים את ניסויי זיכרון המשתמש וה‑RAG של פרק 3 (chapter3/user-memory, chapter3/agentic-rag-for-user-memory).
מטרה: להשוות בהוגנות את היתרונות והגבולות של זיכרון מובנה מול אחזור בלתי מובנה על אותו מערך הערכה. עשו שימוש חוזר בשני הפרויקטים של פרק 3 והשוו שלוש תצורות על 60 מקרי הבדיקה מ‑chapter3/user-memory-evaluation — Advanced JSON Cards טהור (כרטיסים מובנים הנשמרים בהקשר, ללא צורך באחזור), RAG טהור (מקטעי שיחה משוכנים במאגר וקטורי, אחזור נדרש), מערכת היברידית (עובדות ליבה שוכנות בקביעות + שיחות מקוריות מאוחזרות לפי דרישה).
קריטריוני קבלה: תעדו שיעור הצלחה, מספר צעדים ממוצע, מספר קריאות לכלים, השהיה ועלות על פני שלוש רמות מורכבות (היזכרות בסיסית / פיזור עמימות רב‑סשני / קישורים נסתרים חוצי סשנים). תארו בבירור את גבולות הכשל של כל גישה — מה זיכרון מובנה מחמיץ, מה אחזור מחמיץ, והאם ההיברידי משיג באמת סינרגיה. זוהי שכבת רגרסיה מקצה לקצה: היא בודקת שהמשימה השלמה עדיין עובדת, אך אינה יכולה כשלעצמה להראות האם הסוכן תוחם נכון זיכרון לאחר שסופק לו. פרטי התצורה ומקרי הבדיקה זמינים במאגר הנלווה.
הניסוי הנלווה הריץ את שלוש המערכות על אותן 60 שאלות ושמר 180 מסלולי API אמיתיים. טבלה 7‑3 מדווחת הן את השיעורים והן את ספירות ההצלחה שבבסיסם.
טבלה 7‑3 שיעור הצלחה לפי מערכת זיכרון ורמת משימה
מערכת
היזכרות בסיסית
פיזור עמימות רב‑סשני
קישורים נסתרים חוצי סשנים
כולל
Advanced JSON Cards
95%
60%
50%
68.3% (41/60)
RAG
90%
40%
15%
48.3% (29/60)
היברידי
80%
70%
50%
66.7% (40/60)
הראוי ביותר לתשומת לב הוא שהפתרון ההיברידי לא ניצח מאליו. ב-3 שאלות הוא עשה מה ששני הפתרונות היחידים לא הצליחו, אך ב-8 שאלות אחרות נפל מן הפתרון היחיד הטוב יותר; בהשוואה לפתרון היחיד הטוב ביותר בכל שאלה, שיעור ההצלחה הממוצע שלו היה אף נמוך יותר. RAG טהור לא נבדל בהרבה מכרטיסים מובנים בשאלות היזכרות בסיסית, אך בשאלות קישור בין סשנים שיעור ההצלחה שלו צנח ל-15%. מספר נוסף שקל להתעלם ממנו: מתוך 180 שיפוטים, וטו ההזיות הופעל 28 פעמים — עדות לחשיבותו של סעיף וטו יחיד.
בעיית המודל מאותה משפחה ושיפוט רב‑מקורי.
כאשר הסוכן ומודל השיפוט מגיעים מאותה משפחה, הסוכן עשוי ללמוד לנצל את ההעדפות ואת נקודות העיוורון של מודל השיפוט.
זה בדיוק מה שחוק גודהארט קובע: כאשר מדד הופך ליעד אופטימיזציה, הוא חדל להיות מדד טוב. ככל שסוכן מאומן או מכוונן יותר על מערכת ניקוד מסוימת, כך הוא נוטה יותר לנצל פרצות במערכת זו במקום לשפר באמת את יכולותיו.
באופן ערמומי יותר, הסוכן ילמד בהדרגה להימנע מסוגי השגיאות שמודל השיפוט אינו טוב בזיהוין, וכך מערכת הניקוד תיראה תקינה לחלוטין.
ההקלה היא שיפוט הטרוגני רב‑מקורי — שופטים בלתי תלויים הנשאבים ממשפחות מודלים שונות (אם הסוכן רץ על Claude, שפטו עם GPT‑5 ועם Gemini). ההטיות של משפחות שונות הן לעיתים קרובות אורתוגונליות, כך שהסוכן יכול רק לעיתים נדירות להערים על כל השופטים בבת אחת. השתמשו באותו Rubric כדי שכולם ישפטו את אותו יעד, וצברו באמצעות ממוצע משוקלל או בדיקות עקביות. בפריסה, מודל יחיד יכול לטפל בהערכה מהירה, כשביקורות איכות תקופתיות מורצות אל מול המערך הרב‑מקורי המלא.
שיפוט רב‑מקורי מטפל בשאלה אילו מודלים צריכים לשמש כשופטים; השאלה הבאה היא אילו מודאליות יש להעריך — הרחבת LLM‑as‑a‑Judge מטקסט לדיבור, לתמונות ולווידאו היא ציר נוסף של כיסוי ההערכה.
LLM‑as‑a‑Judge רב‑מודאלי.
שיפוט רב‑מודאלי מרחיב את LLM‑as‑a‑Judge לתחומי הדיבור, התמונות והווידאו. ארבעה כיוונים נפוצים הם כדלקמן.
הערכת TTS (TTS הוא ראשי תיבות של Text-to-Speech): מעריכה דיוק, טבעיות, עקביות קול והבעה רגשית. ממדים אלה יכולים ללכוד בעיות פרוזודיות ש‑WER (Word Error Rate) מסורתי מתקשה לזהות.
הערכת ASR (ASR הוא ראשי תיבות של Automatic Speech Recognition): מבצעת הערכת השפעה סמנטית — זיהוי שגוי של “מזג האוויר היום” אינו מזיק, אך זיהוי שגוי של “העבר אלף” כ”עשרת אלפים” עלול לגרום להשלכות חמורות.
הערכת UI: משתמשת במנגנון מציע–סוקר כדי לבדוק בעיות כגון גלישת טקסט, ניגודיות צבעים ומיקום כפתורים. כאן, המציע–סוקר משמש כשיטת הערכה, בשונה משימושו כרכיב במערכת יצירה בפרק 5, אך מנגנון הליבה זהה — מודל אחד מייצר, אחר סוקר באופן עצמאי.
הערכת עריכת וידאו: מאמתת את נכונות נקודות ההתחלה/הסיום של הקטעים ואת יישום האפקטים באמצעות פריימי מפתח.
ניסוי 7‑5 ★★: בניית צינור הערכת איכות TTS אוטומטי לחלוטין
ניסוי זה דורש לעצב ולממש מאפס מערכת שלמה להערכת איכות TTS מסוג LLM‑as‑a‑Judge רב‑מודאלי.
עצבו Rubric רב‑ממדי ל‑TTS: ממד הדיוק מאמת האם כל הטקסט מוקרא נכון (ללא השמטות/קריאות שגויות/תוספות); ממד הטבעיות מעריך האם הדיבור נשמע טבעי ולא רובוטי, האם אין הפסקות בלתי טבעיות, והאם הפרוזודיה טבעית; ממד ההבעה הרגשית בודק האם הטון תואם לגוון הרגשי של הטקסט (אינטונציה עולה לשאלות, הדגשה לקריאות, קצב איטי יותר וגובה צליל נמוך יותר לתוכן עצוב); ממד עקביות הקול מעריך דמיון דובר כאשר קול ייחוס זמין (המודל הרב‑מודאלי מקבל בו זמנית את קול הייחוס ואת הקול המסונתז להשוואה).
בנו קורפוס בדיקה מגוון: אורכים משתנים (משפט יחיד ← פסקה ארוכה), ז’אנרים (חדשות/סיפור/דיאלוג), רגשות (ניטרלי/נרגש/עצוב), ואתגרים מיוחדים (מספרים/שמות עצם פרטיים/תווים רב‑הגייתיים/אוצר מילים דיאלקטי). חברו את מודול ה‑TTS לשירותים מרכזיים (OpenAI, ElevenLabs, Fish Audio, Minimax, Doubao), ואז שלחו את האודיו המסונתז, את טקסט המקור, את אודיו הייחוס ואת ה‑Rubric לשופט רב‑מודאלי בעל יכולת אודיו. תעדו את מודל השופט ואת הגיבובים של אודיו המועמד והייחוס כך שכל ציון יהיה ניתן לביקורת.
המאגר הנלווה משמר הרצת האזנה ישירה קטנה. OpenAI ו‑Fish Audio ייצרו כל אחד ארבעה קטעים המכסים מספרים, תווים סיניים רב‑הגייתיים, טקסט ארוך והגשה נרגשת; Voxtral השלים את כל שמונת השיפוטים הארבע‑ממדיים. שתי המערכות ממוצעו 5.00 בדיוק ו‑4.00 בטבעיות. Fish Audio קיבל 4.00/3.00 ברגש ובעקביות קול, בעוד ש‑OpenAI קיבל 3.75/2.75. פיצול ה‑Rubric לממדים חשף אפוא הבדלים שבדיקה פשוטה של “האם זה הוקרא נכון?” הייתה מחמיצה.
ציונים אלה אינם מבססים מנצח בין ספקים. היו רק ארבעה קטעים לכל ספק, וקטע הייחוס הקבוע הגיע מ‑Fish S1, מה שמעדיף באופן טבעי את Fish Audio בדמיון קול. השוואת TTS כללית צריכה להסיר את הממד הזה או לתת לכל מועמד דובר יעד מתאים. השוואת שיבוט קול צריכה לבקש מכל מערכת לחקות את אותו דובר ולכייל את שופט המודל אל מול האזנה אנושית מסונוורת. בחירת תשובת הייחוס, התמונה או האודיו היא חלק מעיצוב ההערכה, ולא עבודת הכנה ניטרלית.
Rubrics כתובים ביד הם דרך מהירה לבסס ממדים אבחנתיים כאלה. בקנה מידה גדול יותר, מודל תגמול גנרטיבי מתמחה יכול להפוך את השיפוט לאוטומטי; פרק 8 מכסה כיצד מודלי תגמול כאלה מאומנים.
הציון שנותן מודל השיפוט מעיד רק על טיב התוצאה; כדי להפוך את התוצאה לבעיה שניתן לתקן, יש עוד לאתר באיזה שלב הכישלון החל בפועל.
ייחוס כשלים: איתור השגיאה הראשונה במסלול
הערכה מקצה לקצה אומרת לעיתים קרובות רק “עבר” או “נכשל”. כדי שהתוצאות יניעו תיקונים, בצעו ייחוס כשל לכל מסלול כושל: תעדו את מחלקת השגיאה העיקרית, את הצעד הראשון שבו הופיעה התנהגות בלתי מקובלת, את קריאת הכלי או פלט המודל הרלוונטיים, וראיות הניתנות לביקורת. ייחסו את השגיאה הראשונה ששלחה את המשימה מהמסלול; שגיאות מאוחרות יותר הן לעיתים קרובות רק תגובת שרשרת.
מקרים רעים בייצור מגיעים בדרך כלל משלושה אותות: תיקון מפורש של המשתמש (“אל תעשה את זה”), הצבעת אגודל למטה או משוב שלילי אחר, או בדיקת מצב מאוחרת, מאמת כללים או שופט LLM המראים שהסוכן עשה משהו שלא היה צריך לעשות. מודלי LLM יכולים לסייע בעבודה זו, אך אינם יכולים להחליף קריאה אנושית קפדנית משום שייחוס כשלים חושף לעיתים קרובות בעיות מוצר, ולא רק באגים טכניים.
בניית מערכת לייחוס כשלים דורשת מהמפתח לקרוא ולנתח בסבלנות מסלולים בעייתיים מהייצור. LLM יכול לסייע בעבודה הזו, אך אינו מחליף את האדם, משום שייחוס כשלים חושף לא אחת בעיות מוצר, לא רק בעיות טכניות.
ככל שהמוצר מבשיל, סיווג השגיאות עשוי לכלול כמה מחלקות ראשיות, תחת כל אחת תת‑מחלקות, עד שהוא מגיע למאות פריטים. המחלקות הללו ודרכי הייחוס שלהן הופכות אחר כך לפרומפט או ל‑Skill של סוכן שמתייג ייחוסים.
עבור Coding Agent, סיווג התחלתי שימושי נראה כך.
מחלקת שגיאה
ביטוי אופייני
כיצד לאתר את השגיאה הראשונה
הבנת דרישות וטיפול בעמימות
מה שנבנה אינו מה שהמשתמש ביקש: תנאי מהדרישה נופל, או שההיקף נקרא רחב מדי או צר מדי; כשבמאגר יש שני קובצי תצורה בעלי אותו שם, אחד נבחר בלי הסבר ובלי שאלה
השוו בעזרת LLM, סעיף מול סעיף, בין הדרישה המקורית לבין מה שהסוכן עשה בפועל (רצף הפעולות); אתרו את הסטייה הראשונה ברמת התוצאה, ומשם חזרו אל קריאת הכלי או המשפט שגרמו לה
היעדר תהליך או מוסכמה
קומיט בלי להריץ בדיקות יחידה; שינוי קוד לפני כתיבת Plan; הכנסת תלות חיצונית כשלמאגר כבר יש מקבילה פנימית; עקיפה של מוסכמה ארכיטקטונית מקובעת
מצאו את הפעולה הראשונה המפרה את מוסכמת תהליך הפיתוח — ה‑git commit הראשון, כתיבת הקובץ הראשונה — ובדקו אם לפניה קרא את מקור המוסכמה
שגיאות קריאת כלי
עריכה של אותו קובץ נכשלת שוב ושוב; פורמט JSON/schema או ארגומנטים שגוי; תווים מיוחדים ששוברים העתקה, escaping או כתיבה
תעדו את העריכה או הכלי הראשונים שנכשלו יחד עם הבקשה המקורית והשגיאה שהוחזרה; כישלונות חוזרים הם תסמינים מאוחרים
פריצת סביבת האימות
עריכת assertion, הוספת skip, החלפת הלוגיקה הנבדקת במוק; הצהרה ש”הבדיקות עברו” בלי שהורצו כלל
קחו את ההודעה הראשונה ששינתה בדיקה או לוגיקת אימות; אחר כך הצליבו את הצהרת הסיום מול הפקודות שהורצו בפועל במסלול, כדי לוודא אם באמת רצו
שינוי חלקי
חתימת הפונקציה השתנתה ושלוש נקודות קריאה עודכנו, אך הרביעית — קריאה דינמית, binding בשפה אחרת או schema — נשמטה
חשבו את הפרש הקבוצות בין היקף ההשפעה שהסוכן טען לו לבין ההיקף האמיתי, קחו את ההשמטה הראשונה, ובדקו באילו מילות מפתח חיפש
דיווח מידע שגוי למשתמש
קריאות הכלים והמצב הסופי נכונים כולם, אך מה שנאמר למשתמש אינו נכון: סכום, סטטוס או שעה שגויים; עבודה שהושלמה חלקית מוצגת כמושלמת; גילוי חובה שנשמט
הצליבו כל טענה עובדתית בתשובה מול ערכי ההחזרה של הכלים, וקחו את הטענה הראשונה שאי אפשר להתחקות אחריה או שסותרת ערך שהוחזר
רגרסיה לא‑פונקציונלית
API ציבורי או schema משתנים בלי סקריפט מיגרציה; ולידציה נמחקת כדי שבדיקה תעבור
קחו את ההודעה הראשונה שביצעה את השינוי ובדקו אם היה מודע לכך שהוא נוגע בממשק ציבורי או במבנה הדורש מיגרציה
סיום חריג של המודל
הפלט נקטע באמצע, עצירה ללא סיבה, פקיעת זמן, או סיום בלי פעולת הסגירה
אתרו את הסיום החריג הראשון והפרידו בין עצירת המודל, פקיעת זמן של ה‑Harness, ותקלת שירות הכלי
עצירת המשימה מוקדם מדי
ממשימה רב‑יעדית מושלם רק חלק; הכרזה שדבר בלתי אפשרי בלי למצות את החלופות הסבירות
אתרו את ההחלטה הראשונה שזנחה יעד או ויתרה על חקירה, ותעדו אותה בנפרד מכישלון האימות הסופי
סוכן תיוג הייחוסים יכול להיעזר ב‑LLM כדי לבצע ניתוח שורש בקנה מידה גדול על מסלולי ייצור רבים, אך אסור לו להסתפק במשפט אחד על “סיבת הכישלון”. רשומת הייחוס חייבת להיות מובנית: ב‑JSON או ב‑YAML, תוך ציטוט מספרי צעדים ספציפיים, שמות כלים וראיות שנצפו; עליה גם להפריד בין שורש הבעיה לתוצאה, להעריך יכולת התאוששות ולתת רמת ביטחון. למשל, כאשר edit_file מחזיר אי‑התאמה של old_string והסוכן מנסה שוב שלוש פעמים ועדיין אינו כותב את הקובץ: הסיבה העיקרית היא שגיאת עריכת הקובץ וקריאת הכלי, ושלושת הניסיונות הם תוצאה ולא שלושה שורשים עצמאיים. כשמופיעות כמה מחלקות בבת אחת, בחרו את העיקרית לפי הכלל “המוקדמת ביותר שמסבירה את הכשלים שאחריה”, והשאירו את היתר כמשניות. לפחות שלוש מחלקות בטבלה שלמעלה ניתנות לסינון מוקדם באמצעות כללים לפני שמטילים על ה‑LLM לאתר את השגיאה הראשונה: הצלבת הצהרת הסיום מול הפקודות שהורצו בפועל; האם ה‑diff נוגע ב‑assertions של בדיקות ובסימוני skip; והאם ה‑diff משנה API ציבורי או schema בלי קובץ מיגרציה. סינון בכללים תחילה ואיתור ב‑LLM אחר כך זול ומדויק יותר מהזרמת כל המסלולים ל‑LLM.
בעת שמירת רשומת ייחוס אין להסתפק בפלט ה‑LLM: שמרו לצידו את מטרת המשימה, את מצב הסביבה, את גרסת הסוכן, את גרסת ערכת הכלים ואת המסלול המלא, כדי שאפשר יהיה להפוך את המקרה לבדיקת רגרסיה.
להלן שלוש מחלקות שגיאה אופייניות, בפירוט.
בעיית ״עשה נכון, דיווח לא נכון״
“עשה נכון, דיווח לא נכון” היא הקטגוריה שאחוז ההצלחה הכולל מסתיר בקלות רבה מכולן, משום שרוב ההערכות בודקות רק את מצב הסביבה. τ²-bench מנקד אותה בנפרד: מתוך 704 הרצות בסיס שפורסמו שמשימתן נושאת דרישת מסירת מידע, 240 נכשלו, 162 מהן נפלו בבדיקת מסירת המידע, ו‑80 — שליש מכלל הכשלים — היו עם מצב סביבה נכון ודיווח שגוי.
במאגר הנלווה שמור מקרה מקביל. במשימה להזין את ההוצאות מ‑expenses.jpg לאפליקציית הנהלת חשבונות, הסוכן השקיע 32 צעדים במתן הרשאות, חיפוש, פתיחת התמונה, מילוי כל שורה ושמירה, בלי שאף צעד יחזיר שגיאה, ואז הכריז שהמשימה הושלמה; אלא שהמאמת דיווח כי השורה שהיה עליו לכתוב — Dress, ¥436.35 — חסרה, ואין לה כל קשר לארבע שהזין. בצעד 8 כתוב בחשיבתו שלו: “I cannot actually see the content/details of the expenses in the image”. הוא כבר ידע שהנתונים לא הגיעו, לא עצר ולא דיווח, ועד צעד 11 הופיעו ארבע הוצאות מומצאות ברישומיו, שכל הזנה מאוחרת יותר ביצעה בנאמנות. השגיאה הראשונה היא צעד 8, ואותו צעד לא הרים שגיאה ואף לא היה קריאת כלי. גם את שורש הבעיה קל לתייק לא נכון: T3A הוא סוכן טקסט בלבד שמרחב התצפית שלו מכיל רק את עץ האלמנטים וללא פיקסלים של תמונה, ולכן הסיבה אינה “המודל לא יודע OCR” אלא ערוץ תצפית חסר, בתוספת היעדר יציאה לגיטימית של “המידע אינו זמין”. תיוק כבעיית יכולת של המודל מוביל בצעד הבא להחלפת מודל או לאימון OCR; התיקון האמיתי הוא להוסיף את הערוץ ואת היציאה.
ניסוי 7‑6 ★★: ייחוס כשלים על מסלולי AndroidWorld
ניסוי זה מתרגל את שיטת הייחוס של סעיף זה על מסלולים אמיתיים, ללא אמולטור וללא API של מודל. החומר הוא הרצת T3A השמורה ב‑chapter7/android-world: t3a.md מכיל Action/Reason/Summary צעד‑אחר‑צעד לכל המשימות, ו‑t3a_failed.md מרכז יותר מחמישים מסלולי כישלון, שכל אחד מהם מסתיים בפסיקה אובייקטיבית של המאמת.
שלב 1: דגימה. בחרו מתוך t3a_failed.md לפחות עשרה כשלים שקטים, כלומר מסלולים ללא שום שגיאת כלי. אף קריאת כלי לא החזירה שגיאה, הסוכן הכריז על סיום או מיצה את הצעדים, ורק פסיקת המאמת בסוף מסמנת כישלון.
שלב 2: איתור השגיאה הראשונה. לכל מסלול רשמו את מספר הצעד של השגיאה הראשונה וציינו אם אותו צעד הוא קריאת כלי או assistant message. כשלים שקטים דורשים שתי טכניקות: השוואה לעוגני עובדה, המצליבה את אמירות הסוכן מול הערכים שהכלים החזירו ולוקחת את הפער הראשון; וחצייה בינארית של קידומת המסלול, החותכת את המסלול בצעד k ומוסרת אותו — אם עדיין ניתן להציל, השגיאה נמצאת אחרי k. חיפוש מילות שגיאה אינו תחליף לאף אחת מהן.
שלב 3: כתיבת רשומות מובנות. הפיקו לכל מסלול רשומת JSON או YAML הכוללת את שם המשימה, צעד השגיאה הראשונה, קטגוריית השגיאה, הגורם האחראי לשורש הבעיה, ציטוטים תומכים והפרדה בין הסיבה העיקרית לתוצאה.
שלב 4: השוואה להערות הקיימות. השוו את התוצאות ל‑t3a_failed_analysis.md סעיף‑סעיף ותעדו כל אי‑הסכמה. שימו לב במיוחד לייחוס שורש הבעיה: אותן הערות תיעדו את כישלון תמלול התמונה כ”מודל הראייה חסר OCR”, אך במרחב התצפית של T3A אין כלל פיקסלים של תמונה, ולכן שורש הבעיה האמיתי הוא ערוץ תצפית חסר. הערת ייחוס קיימת אינה פתרון רשמי.
שלב 5: המרה למשימות רגרסיה. בחרו שלושה מסלולים שהשגיאה הראשונה בהם היא assistant message, חתכו את הקידומת בדיוק לפני אותה שגיאה, וכתבו את קבוצת הפעולות הקבילות ואת הפעולות האסורות כדי ליצור משימות רגרסיה על קידומת מסלול.
שגיאות עיצוב מסמכים רגישות‑תחום
כשמשתמש אומר “המרכאות שגויות”, אין להפוך זאת להחלפת תווים גלובלית. לכל הפחות עליכם להבחין בין מרכאות ישרות של ASCII (", '), מרכאות מסולסלות סיניות (“”, ‘’) וגרשי Markdown (`). אותו תו ממלא תפקיד תחבירי שונה בפרוזה סינית, במקור אנגלי מצוטט, בקוד מוטבע, בבלוקי קוד, בהערות קוד, ב‑JSON ובנתיבים.
נתוני הערכה צריכים תחילה לנתח את המסמך למקטעים תחומים — לדוגמה ZH_PROSE, EN_PROSE, QUOTED_SOURCE, INLINE_CODE, CODE_BLOCK, CODE_COMMENT ו‑JSON_OR_SCHEMA. כל מקטע מתעד את מערך ההמרות המותרות, את התווים שיש להגן עליהם, ואת תוצאת המאמת לאחר העריכה. שלושת המקרים שלהלן אינם ניתנים לטיפול בכלל החלפה אחד:
Chinese prose: call the `reset()` method.Quoted English source: “Please restart the service.”# the code block below only illustrates a protected scope# Chinese comment: display "current status"name = "status"
רגרסיה על קידומת מסלול צריכה לדרוש מהמודל לבצע את העריכה המינימלית, ולבדוק בו זמנית את סגנון המסמך הסיני, את שיעור השימור של המקור האנגלי המצוטט, את תחביר הקוד וה‑JSON, ואת מרחק העריכה על טקסט שאינו יעד. כאשר הכללים אינם יכולים לקבוע את התחום, שמירת הטקסט המקורי ובקשת הבהרה צריכות להיחשב לפעולה מותרת, ולא עריכה מנוחשת שבמקרה עוברת.
שגיאות העתקה מדויקת: מאי‑התאמת old_string לאיתור שכבה אחר שכבה
כשל של old_string גם אינו ניתן לייחוס פשוט ל”המודל העתיק שגוי”. עבור אותה מחרוזת, אחסנו את גיבוב הבתים הגולמי, את רצף נקודות הקוד של Unicode ואת רצף מזהי הטוקנים של הטוקנייזר, ואז חפשו את הסטייה הראשונה לאורך שרשרת זו:
original file bytes → tool return → Harness serialization → model context→ model token output → decoded string → JSON/tool-call parsing → tool matching
מערך מינימלי של גשושי הערכה מכסה חזרה ישירה, חילוץ מהקשר ארוך, השמה לתוך ארגומנטי כלים, בחירה בין מחרוזות דומות, ורווחים, שורות חדשות, לוכסנים אחוריים, תווי צירוף של Unicode וטוקנים בתדירות נמוכה. המדדים הם התאמה מדויקת ברמת הבתים, התאמה מדויקת ברמת נקודות הקוד, התאמה מדויקת ברמת הטוקנים, מיקום הסטייה הראשונה, ושיעור ההצלחה האמיתי של הכלי. אם המודל נכון בגשוש הישיר אך קריאת הכלי עדיין נכשלת, תקנו את הטוקנייזר, את הסריאליזציה, את ה‑Harness או את פרוטוקול הכלים; רק כאשר הסטייה הראשונה מופיעה בפלט של המודל עצמו יש להפוך את המקרה לנתוני אימון ההעתקה של פרק 8.
משימות רגרסיה מקצה לקצה ועל קידומת מסלול
לאחר שייחוס הכשלים קבע את השגיאה הראשונה ואת מחלקתה, הצעד הבא הוא לנסח את יעד התיקון כמקרה בדיקה בר‑הרצה חוזרת, כלומר משימת רגרסיה (regression task). כאן דרושות שתי שכבות משלימות: משימות רגרסיה מקצה לקצה מאמתות שהשינוי לא שבר את זרימת העבודה השלמה; משימות רגרסיה על קידומת מסלול (trajectory prefix) חותכות את המצב שלפני השגיאה הראשונה ובודקות רק אם אותו גבול החלטה תוקן.
משימות רגרסיה מקצה לקצה מתחילות ממצב התחלתי ומבקשת המשתמש, נותנות לסוכן להשלים את המשימה כולה, ואז בודקות את המצב הסופי, את הפלט הנדרש ואת תנאי הבטיחות. הן הקרובות ביותר לתוצאת הייצור, אך מקשות לקבוע באיזה צעד אירע הכישלון. ככלל הן משמשות לאמת שיכולת הסוכן בכל תחום עדיין עומדת בציפייה. מערכי ההערכה הסטנדרטיים המתוארים בפרק זה — OSWorld, AndroidWorld, tau-bench — כולם משימות רגרסיה מקצה לקצה.
משימות רגרסיה על קידומת מסלול מקפיאות את ההקשר, השיחה, החזרות הכלים ומצב הסביבה הקיימים, ומבקשות מהסוכן רק לחשוב ולבצע את הפעולה הנצפית הבאה או את הבאות. הן זולות יותר ומאפשרות לבודד בעיה של מדיניות אחת או כלי אחד. עבור סוכן ברמת ייצור הדורש אמינות גבוהה, בניית מערך הקידומות חשובה לא אחת יותר מהמערך מקצה לקצה, והיא דורשת לבנות בסבלנות את סיווג הכשלים ומערכת הייחוס שתוארו בסעיף הקודם.
את התשובה למשימת קידומת יש להגדיר כקבוצת פעולות קבילות, ולא כפעולה אחת או תשובה יחידה: אפשר לדרוש “קרא תחילה את כללי המאגר”, “שאל תחילה את המשתמש” או “סרב לפעולה מסוכנת”, ובה בעת לפרט את הפעולות האסורות.
לאחר השלמת ייחוס הכשלים אפשר לבנות מערך הערכה הכולל משימות רגרסיה מקצה לקצה ומשימות על קידומת מסלול כאחד. ל‑Coding Agent: היעדר תהליך צריך להוליד משימת רגרסיה מקצה לקצה הנושאת מסמך תכנון ותנאי קבלה של בדיקות; שגיאת קריאת כלי צריכה שהקידומת הכושלת תיחתך ותיערך למשימת גבול הבודקת אם המודל יודע לתקן את הפורמט, לבצע escaping לתווים מיוחדים או לעבור לכלי מתאים; סיום חריג צריך להוסיף תרחישי התאוששות מקטיעה, מפקיעת זמן ומתקלת כלי; שגיאות שלמות והיגיון צריכות להוסיף רשימות רב‑יעדיות, תזכורת למה שנותר, וגבול “עדיין לא הוכח שזה בלתי אפשרי”; מחלקת הבנת הדרישות והעמימות צריכה להקפיא כקידומת משימות שיש להן כמה קריאות סבירות, ולהכניס “הבהר תחילה” לקבוצת הפעולות הקבילות; מחלקת טלאי התסמינים וזיוף האימות צריכה להוסיף לקבלה שתי מגבלות קשיחות — “אין לשנות assertions של בדיקות” ו”הצהרת סיום חייבת לכלול פלט של פקודה שהורצה בפועל”; ומחלקת דיווח המידע צריכה להציב assertions על תוכן התשובה עצמה, ולא רק לבדוק את מצב הסביבה.
מערך ההערכה הוא הבסיס לאימון‑העל של פרק 8 ולהתפתחות העצמית של הסוכן בפרק 9.
ניסוי 7‑7 ★★: הערכת גבולות על קידומת מסלול עם קידודים מרובים
ניסוי זה מספק לסוכן זיכרון משתמש ידוע, את ההוראה הנוכחית, קידומת מסלול, החזרות כלים ומצב סביבה, ואז מבקש רק את הפעולה הנצפית הבאה. הוא מכסה מקרים רעים מייצור כגון התנגשויות תחום, העדפות מיושנות הדורסות הוראות נוכחיות, הסקות בביטחון נמוך, אישור לפני מחיקה בסיכון גבוה, ותצוגה מקדימה לפני פרסום חיצוני. אותם מקרים מקודדים כ‑JSON Cards, כ‑Markdown וכזיכרון בסגנון Python; בדיקות דטרמיניסטיות מנקדות את קטגוריית ההחלטה המותרת, את הבטיחות, את הראיות הנדרשות ואת הפעולות האסורות.
עם GPT-5.6-sol דרך OpenRouter, כל 33 התאים (11 מקרים × 3 קידודים) הושלמו ללא שגיאות API. כל קידוד עבר 6/11 מקרים, אך מיקומי הכשל שלהם נבדלו, מה שמראה ששינוי הייצוג לבדו אינו מתקן מדיניות יישום.
בבחירת מודלים בפועל, אנו ניצבים לעיתים קרובות בפני השאלה: “מה טוב יותר, A או B?” השוואה זוגית מספקת שיטת הערכה שאינה נשענת על ציונים מוחלטים.
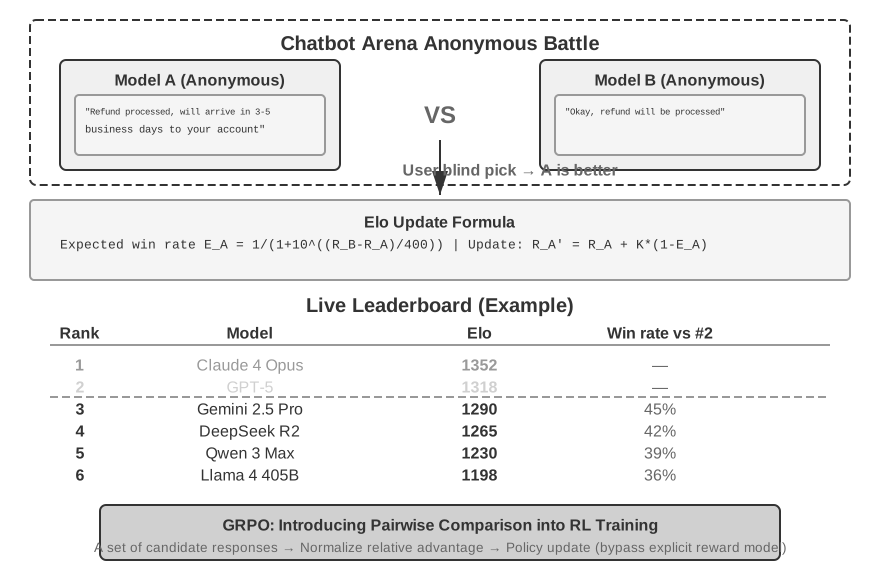
דירוג Elo (מערכת דירוג שתוכננה במקור לשחמט) מכמתת את היכולת היחסית של מודלים באמצעות מספר גדול של עימותים זוגיים: ככל שהפרש הדירוג גדול יותר, כך שיעור הניצחון הצפוי של המודל החזק יותר גבוה יותר. לדוגמה, אם למודל A דירוג של 1200 ולמודל B דירוג של 1000, מערכת Elo תחזה ששיעור הניצחון של A הוא כ‑76%. אם B מנצח באופן מפתיע, B צובר יותר נקודות ו‑A מפסיד יותר — הפתעה מפעילה תיקון גדול יותר, וזה מה שמאפשר לדירוגים להתכנס במהירות ליכולת האמיתית. הבסיס הסטטיסטי הוא מודל Bradley‑Terry: כל מודל מופשט כ”ציון עוצמה” סמוי, וההסתברות שאחד ינצח את האחר בעימות נקבעת על ידי ההפרש בין ציוניהם. Elo הוא המימוש ההנדסי של מודל זה בצורת עדכון מקוון.
Chatbot Arena משתמשת בעימותים אקראיים אנונימיים — משתמשים בוחרים בעיוורון את התגובה הטובה יותר מבלי לדעת את זהות המודל, והדירוגים נגזרים ממיליוני הצבעות. היתרון הוא שאין צורך להגדיר “תקן מוחלט”; כל הנדרש הוא שיפוט אנושי על “מה טוב יותר, A או B”. המגבלה: הדירוגים תלויים במה שמשתמשים במקרה שואלים. אם שיטפון של משתמשים שואל שאלות תכנות, מודלים חזקים בתכנות מדורגים גבוה יותר — מה שעשוי לומר מעט על רמתם במשימות אחרות.
כאשר שיפוט זוגי מבוצע על ידי LLM ולא על ידי הצבעה אנושית, יש להיזהר גם מהטיית מיקום — מודל השיפוט מעדיף באופן שיטתי את המועמד המופיע במיקום מסוים (בדרך כלל הראשון), והשיפוט עשוי להישאר ללא שינוי גם אם תוכן שני המועמדים מוחלף לחלוטין. שיטת ההקלה התקנית היא להעריך כל זוג פעמיים בסדר מוחלף: פעם אחת עם A ראשון, פעם אחת עם B ראשון, ולמצע את שתי התוצאות; גישה מחמירה יותר היא לספור רק מקרים שבהם שני השיפוטים עקביים, ולהתייחס לאי‑עקביות כתיקו או לשלוח אותה לסקירה אנושית. גישת Chatbot Arena היא במהותה זהה — אקראיזציה של מיקומי התצוגה של שתי התגובות כך שהטיית המיקום מתקזזת על פני מדגם גדול.
ניסוי 7‑8 ★★: בניית טבלת דירוג מודלים מנתוני השוואה זוגית
ניסוי זה נועד להבין לעומק כיצד מודל Bradley‑Terry מחלץ ציוני יכולת יחסית ממספר גדול של השוואות זוגיות, באמצעות מימוש מערכת חישוב דירוג Elo מאפס. השתמשו במערך נתוני ההצבעות האמיתי בקוד פתוח מ‑Chatbot Arena (המכיל מיליוני הצבעות עיוורות אנונימיות של משתמשים).
ממשו את אלגוריתם העדכון האיטרטיבי של דירוג Elo: אתחלו את כל המודלים בדירוג 1000. עבדו את רשומות ההצבעה בסדר כרונולוגי. עבור כל עימות, חשבו את שיעור הניצחון הצפוי על בסיס הפרש הדירוג הנוכחי בין שני המודלים, השוו את התוצאה בפועל לציפייה, והתאימו דירוגים בקצב למידה קבוע — המנצח צובר נקודות, המפסיד מאבד נקודות, כשעוצמת ההתאמה פרופורציונלית לסטייה מהציפייה (הפסד מפתיע מביא לשינוי דירוג גדול יותר). מיינו מודלים בסדר יורד לפי הדירוג הסופי וחשבו את מטריצת שיעורי הניצחון הזוגיים. השוו לטבלת הדירוג הרשמית כדי לאמת שהדירוגים עקביים בגדול. אין צורך בהתאמה מדויקת נקודה בנקודה: Chatbot Arena הרשמית משתמשת באמידת נראות מרבית של Bradley‑Terry (פתרון כל העימותים בו זמנית, ללא תלות בסדר ההצבעה), בעוד שמימוש זה משתמש בעדכוני Elo מצטברים מקוונים (התוצאות מושפעות מגורם ה‑K של קצב הלמידה ומסדר העיבוד). שני האלגוריתמים צריכים להניב דירוגים כוללים עקביים, אך הציונים הספציפיים לא יהיו זהים במדויק.
החלק השני של הניסוי יוצר אנימציית התפתחות דירוגים היסטורית: פרסו את נתוני ההצבעה לפי זמן (שבועי או חודשי) וחשבו תצלומי דירוג Elo לכל נקודת זמן. השתמשו ב‑D3.js כדי לממש אנימציית מרוץ תרשים עמודות (אורך העמודה האופקית = דירוג, מיקום אנכי = מיקום בדירוג, משתנה בחלקות לאורך זמן). באמצעות התבוננות באנימציה, זהו רגעי פריצת דרך טכנולוגית (דירוגו של מודל מזנק לפתע), התפתחות הנוף התחרותי, ומחזורי חיים של מודלים.
בחירת מודלים מונחית הערכה
בחירת מודלים אינה עוסקת פשוט ב”בחירת המודל החזק ביותר”; היא כרוכה בביצוע פשרות מונחות הערכה על פני ממדים מרובים על בסיס תרחיש היישום.
ממדי מפתח לבחירה
תפוקה והשהיה הן שתי משפחות מדדים שקל לבלבל ביניהן; התרתן דורשת עובדה אחת בלבד — הסקת LLM רצה בשני שלבים. Prefill קורא את ההקשר כולו בבת אחת וקובע את הזמן עד הטוקן הראשון (TTFT): העיכוב בין לחיצת המשתמש על Enter לבין הופעת התו הראשון. ככל שההקשר ארוך יותר, כך ה‑prefill איטי יותר וה‑TTFT גבוה יותר. Decode מייצר אז את התגובה טוקן אחר טוקן, וקובע את מהירות הייצור (טוקנים לשנייה) — שגם מכתיבה את זמן החשיבה: ב‑50 טוקנים לשנייה, מודל המפיק 2000 טוקני חשיבה מבלה 40 שניות רק בחשיבה.
סביב שני השלבים הללו, מדדי התפוקה וההשהיה העיקריים הם כדלקמן:
תפוקת קלט / תפוקת פלט: מתאימות למהירות של Prefill ושל Decode בהתאמה.
TTFT: שווה לזמן ההמתנה בתור בתוספת זמן ה‑Prefill; זו ה”תגובתיות” הנתפסת על ידי המשתמש.
השהיית חשיבה: מספר טוקני החשיבה שנוצרים יכול להשתנות פי כמה בין מודלים, ואורך החשיבה אינו בהכרח במתאם חיובי עם אפקטיביות המשימה — מדדו את צריכת טוקני החשיבה של כל מודל ואת התועלת המתאימה על עומס העבודה שלכם, ולא תסיקו מטבלאות דירוג ציבוריות בלבד.
השהיית זנב p95: ההשהיה ש‑95% מהבקשות לא יחרגו ממנה. היא מדד טוב יותר לחוויית המשתמש האמיתית מאשר הממוצע, שיכול להימשך מטה על ידי מספר גדול של בקשות מהירות, ובכך להסתיר האטות חמורות שחווה מיעוט של משתמשים.
עלות: תמחור לטוקני קלט/פלט/מטמון. אין להעריך עלות בבידוד — מודל זול בעל שיעור הצלחה נמוך עלול למעשה לגרור עלויות גבוהות יותר בשל ניסיונות חוזרים תכופים. יש לחשב את העלות הממוצעת למשימה ואת יחס העלות‑תועלת.
ביצועים: ההגדרות המדויקות של Pass@1, Pass^k, Pass@k ו‑Best@k ניתנו קודם ב”מערכת מדדי ההערכה”. כאן אנו דנים רק כיצד לבחור בהקשר של בחירת מודלים — לתרחישים יומיומיים, התמקדו ב‑Pass@1 (שיעור הצלחה ממוצע בניסיון יחיד); לפעולות קריטיות, תנו עדיפות ל‑Pass^k, והתמקדו ביציבות של “לעולם לא לטעות”; למשימות חקר, תנו עדיפות ל‑Pass@k או ל‑Best@k, והסתכלו על החסם העליון של היכולת בהינתן די הזדמנויות; למשימות פתוחות, השתמשו בניקוד Rubric רב‑ממדי.
מגבלות קצב ואמינות: מגבלות RPM (בקשות לדקה) / TPM (טוקנים לדקה) משפיעות על יכולות המקביליות, וממשקי API מסוימים מתאימים מכסות באופן דינמי בשעות שיא. מבחינת חסינות, שימו לב לנתונים מחוץ להתפלגות, לקלטים יריבותיים וליציבות בריצה ארוכה (האם מתרחשות בעיות כגון קריסת מודוס או סחיפת קשב).
עקומות תקציב–יכולת: ציון יחיד בתקציב קבוע אינו מספיק כדי לקבוע האם סוכן יכול להתמודד עם עבודה ארוכת אופק. בנוסף לשיעור ההצלחה, דווחו כיצד הביצועים משתנים עם זמן שעון, טוקנים, קריאות לכלים או תקציב חישוב. RE-Bench הופך את הבעיה למוחשית: עם תקציב כולל של שעתיים לכל סביבה, הסוכן הטוב ביותר קיבל ציון גבוה פי ארבעה בערך ממומחים אנושיים; בני האדם, לעומת זאת, הפיקו יותר תועלת מזמן נוסף, עקפו בקושי את הסוכן הטוב ביותר בשמונה שעות, וקיבלו ציון גבוה פי שניים בערך כשניתנו כמה ניסיונות ב‑32 שעות בסך הכול1. מובילות בתקציב קצר אינה ניתנת אפוא להסקה ישירה ליכולת ארוכת ריצה. בחירת מודלים צריכה להשוות כמה נקודות תקציב הקרובות למשך עומס העבודה האמיתי.
בפועל תוכלו לערבב מודלים: מודלים קלי משקל לבקשות פשוטות כדי לקצץ עלויות, מודלים עוצמתיים למשימות מורכבות כדי להגן על האיכות; או מודלים מתמחים לתת‑משימות מסוימות (הבנת תמונות, יצירת קוד), המשתפים פעולה באמצעות מנגנוני תת‑סוכנים. כל צירוף הטרוגני כזה חייב להיות מאומת בעצמו על ידי הערכה, כדי לאשר שהתועלת הכוללת גוברת על מורכבות המערכת הנוספת (למשל, לראות שאלות כמו “מה גדול יותר, 9.9 או 9.11?” או “אני רוצה לשטוף את הרכב, והמכונה נמצאת 50 מטר מהבית — ללכת ברגל או לנסוע?” כשאלות פשוטות ולהעבירן למודל קל, ומכאן החלטות שגויות).
התנהגות המודל: מתי להפסיק לקרוא ולהתחיל לערוך
בחירת מודלים משווה לא רק האם מודל יכול לסיים משימה, אלא גם כיצד הוא מתנהג כברירת מחדל. הבדל אחד הניתן לצפייה בקלות בסוכני קוד הוא סף הפעולה. בהינתן אותה משימת תכנות, מודלים מסוימים חוקרים את המאגר בהרחבה ומאשרים את הארכיטקטורה, את הקוראים ואת הבדיקות לפני העריכה. אחרים מאתרים מפחות ראיות, עורכים מוקדם, ומשתמשים במשוב הבדיקות כדי להשלים את הבנתם. הראשונים מייחסים עלות גבוהה יותר לעריכות מוקדמות מדי; האחרונים מייחסים עלות הזדמנות גבוהה יותר לקריאת קובץ נוסף.
לנטייה הזו של הסוכן שני מקורות: פרומפט המערכת שב-Harness, ומדיניות ההתנהגות של המודל. אימון־על הוא מקור מפתח למדיניות ההתנהגות: מסלולי SFT מדגימים “עד כמה לקרוא לפני שמתחילים לפעול”, תגמולי תהליך מתגמלים או מענישים מסלול כלים מסוים, ותגמולי תוצאה מחזקים את כל האסטרטגיה שהובילה להצלחה. עם הזמן, מה שהמודל לומד אינו רק כיצד לכתוב קוד, אלא גם הרגלי הנדסה.
ניסוי 7‑9 ★★: מדידת ספי פעולה של מודלים ב‑harness תכנות קבוע
מטרה: לבודד את גורם המודל, לכמת כיצד מודלי תכנות מבצעים פשרה בין המשך איסוף מידע לבין התחלת עריכה, ולהעריך יעילות מסלול יחד עם איכות התוצאה.
שיטה: הריצו את chapter6/model-action-threshold/experiment.py. כברירת מחדל הוא קורא ל‑GPT-5.6-sol ול‑Claude Sonnet 5 דרך אותה נקודת קצה תואמת OpenAI של OpenRouter תוך קיבוע הנחיית המערכת, סכימות הכלים, מאגרי המשימות, פקודות הבדיקה ומגבלת התורות. ההנחיה הניטרלית אינה מציינת לא מספר מינימלי של קבצים לקריאה ולא דרישה לערוך במהירות. חזרו על כל אחת משלוש קטגוריות המשימות לפחות שלוש פעמים והחליפו את סדר המודלים. תעדו קריאות לכלים, קבצים שנקראו, חיפושים וזמן שעון לפני העריכה הראשונה, יחד עם קבלת הטלאי הראשון שנבדק, עבודה חוזרת לאחר הבדיקות, הצלחה סופית, קבצים ששונו ושימוש בטוקנים.
פרשנות סיבתית: המסע הניטרלי שואל האם ההתנהגות משתנה עם המודל בתוך harness אחד. כדי למדוד את ה‑harness כגורם ממתן, הריצו מסע נפרד עם --policy explore-first; אל תערבבו את שתי המדיניויות בהשוואת מודלים אחת. התנהגות המשתנה עם החלפת מודל ונמשכת עבור אותו מודל בין harnesses שונים היא ראיה חזקה יותר להשפעת מודל; ההפך הוא ראיה חזקה יותר להשפעת harness.
קריטריוני קבלה: כל בדיקות היחידה הלא‑מקוונות עוברות; כל מתקן משימה מאושר תחילה ככושל בבדיקותיו; התוצאה הפורמלית מכילה כל תא model × task × trial, אפס שגיאות API, בדיקה סופית עצמאית, ומסלולים ניתנים לביקורת; ו‑manifest.json מאמת את הגיבובים של התצורה, התצפיות והסיכום. ספריית הפרויקט כוללת הרצה שלמה אחת של 18/18 תאים. הקוראים צריכים להריץ אותה מחדש על גרסאות המודלים ועומסי העבודה האמיתיים שמעניינים אותם ולא להתייחס למספרים אלה ממאגרים זעירים כאל טבלת דירוג קבועה.
ניתוח עלויות של מערכות סוכן
הסעיף הקודם מנה את העלות בין ממדי הבחירה המרכזיים, אך עלויות סוכן מורכבות הרבה יותר מתמחור טוקנים פשוט — היסק רב‑תורי, קריאות לכלים והצטברות הקשר גורמים לעלויות לגדול באופן לא לינארי. ניתוח עלויות שיטתי הוא חלק בלתי נפרד ממערכת ההערכה ותנאי מקדים לפריסת ייצור.
רכיבי העלות.
ניתן לפרק את עלות מערכת סוכן לשלוש רמות:
עלות הסקת המודל היא הרכיב הישיר ביותר, ונקבעת על ידי צריכת טוקני הקלט וטוקני הפלט. אולם בתרחישי סוכן, ישנם שני גורמי הגברה שלעיתים קרובות מוחמצים. הראשון הוא אפקט הצטברות ההקשר: בכל פעם שסוכן קורא ל‑LLM, הוא שולח את כל היסטוריית השיחה ופלטי הכלים הקודמים יחד (כדי שהמודל יוכל להבין את ההקשר). ללא ניצול יעיל של KV Cache (כלומר, שמירת הקשר שכבר עובד במטמון כדי להימנע מחישוב מיותר), העלות גדלה מהר מאוד — סבב 1 שולח 1000 טוקנים, סבב 2 שולח 2000 טוקנים, סבב 3 שולח 3000 טוקנים, בסך הכול 1000+2000+3000=6000 במקום 3×1000=3000. ככל שיש יותר סבבים, כך הפער גדול יותר. השני הוא עלות טוקני החשיבה: מודלים התומכים בחשיבה מייצרים מספר גדול של טוקני חשיבה. אף שטוקנים אלה אינם מוצגים למשתמש, הם עדיין מחויבים.
עלות קריאות הכלים כוללת דמי API חיצוניים (מנועי חיפוש גובים לפי שאילתה, שאילתות מסד נתונים צורכות משאבי חישוב), משאבי ארגז חול להרצת קוד, ועלות עקיפה שקל להחמיץ: עלות הטוקנים הנגרמת כאשר פלטי כלים מוזרקים להקשר. התוכן המוחזר מחיפוש רשת יחיד עשוי לתפוס 2000‑5000 טוקנים, והוא יחויב שוב ושוב כקלט בכל סבב הסקה עוקב.
עלות התשתית מכסה תקורה תפעולית עבור מסדי נתונים וקטוריים (המשמשים לאחזור RAG), תורי הודעות, מסדי נתונים רלציוניים, ואחסון יומנים ומעקב (ליכולת תצפית).
כדי לראות מהיכן העלויות הללו מגיעות בפועל, הניסוי הנלווה השתמש בזרימת עבודת החזר קבועה בת שמונה תורות: תשאול ההזמנה, הלוגיסטיקה, מדיניות ההחזר ובסיס הידע, ואז ביצוע בדיקות סיכון, הנפקת ההחזר, יידוע המשתמש וסגירת המקרה. קריאות gpt-4o-mini אמיתיות הורצו תחת כל ארבעת הצירופים של שני מתגים: קידומות יציבות מול לא יציבות, והיסטוריה מלאה מול דחוסה. זרימת העבודה העסקית הייתה זהה בכל זרוע. טבלה 7‑4 משתמשת בספירות הטוקנים ובמחירים שנרשמו באותה הרצה.
טבלה 7‑4 עלות מדודה של זרימת עבודת הסוכן בת שמונה התורות
תצורה
טוקני קלט
טוקנים במטמון
עלות כוללת
חיסכון מול קו הבסיס
ללא מטמון, ללא דחיסה
20,700
0
$0.003776
—
קידומת יציבה בלבד
20,386
13,568
$0.002707
28.3%
דחיסת היסטוריה בלבד
16,177
0
$0.003115
17.5%
קידומת יציבה + דחיסה
16,035
6,144
$0.002643
30.0%
בקו הבסיס, הקלט גדל מ‑1,113 טוקנים בתור הראשון ל‑3,668 בתור האחרון. תוצאות כלים נגררו שוב ושוב לבקשות מאוחרות יותר, והיוו 9,544 טוקני קלט לאורך ההרצה. עם שתי האופטימיזציות מופעלות, נתון זה ירד ל‑5,248 והעלות הכוללת ירדה ב‑30%.
התועלות לא היו חיבוריות. קידומת יציבה לבדה חסכה 28.3%, ודחיסה לבדה חסכה 17.5%, אך יחד הן חסכו 30%, ולא 45.8%. דחיסת ההיסטוריה גם קיצרה את הקידומת הזמינה לשימוש חוזר במטמון. כשאופטימיזציות הקשר משולבות, מדדו את זרימת העבודה השלמה; לעולם אל תחברו את החיסכונות המבודדים שלהן. מודל, לוח מחירים או אורך משימה שונים ישנו את נתון ה‑30%. התוצאה הניתנת לשימוש חוזר היא שיטת ארבע הזרועות, ולא האחוז עצמו.
אסטרטגיות אופטימיזציית עלות.
מנופי הקלט הראשונים שיש לבדוק הם שימוש חוזר ב‑KV Cache (שמירה על קידומת יציבה), דחיסת הקשר (קיצור מסלולים ישנים ופלטי כלים מילוליים) וניתוב מודלים מדורג (שליחת בקשות פשוטות למודלים קלי משקל והיסק קשה למודלים חזקים יותר). פרק 2 כיסה את המימושים. כאן הנקודה התפעולית היא שלכל מנוף צריך להיות מתג משלו, כדי שהצוות יוכל למדוד הן את השפעתו המבודדת והן את מה שקורה כשהוא משולב עם אחרים. שתי שיטות נוספות חשובות במיוחד להערכה ולתפעול.
עיבוד אצווה אסינכרוני צובר משימות שאינן בזמן אמת לעיבוד באצווה, וממנף הנחות תמחור אצווה מספקי API; בתרחישי פריסה עצמית, הוא גם משפר את ניצול ה‑GPU בשעות שפל.
ניטור עלויות ובקרת תקציב.
בסביבת ייצור, יש לבסס מערכת ניטור עלויות בזמן אמת: עקבו אחר צריכת טוקנים ועלויות API לפי סוג משימה, מודל, משתמש וכדומה. כמו כן, קבעו תקרת עלות לכל משימה — סיימו אוטומטית את הסוכן כשהוא נופל ללולאה או חוקר לעומק רב מדי, ובכך מנעו ממשימה אחת לגרור עלויות גבוהות באופן חריג.
ניסוי 7‑10 ★: ניתוח עלויות מקצה לקצה של משימות סוכן
מטרת הניסוי: לשחזר את פירוט העלויות בן שמונה התורות שלעיל, ואז לבדוק את אותם מנופי אופטימיזציה על עומס העבודה שלכם.
גישה טכנית: שחזרו תחילה את המשימה הנלווית הקבועה, ואז בחרו כמה משימות מייצגות משלכם. השתמשו ב‑LangSmith או במערכת מעקב שבניתם בעצמכם כדי לתעד טוקני קלט/פלט וחשיבה, מספרי קריאות לכלים וגדלי החזרה, והשהיה מקצה לקצה עבור כל קריאת LLM. חשבו עלות ממוצעת, p50/p95/p99, ואת פירוט העלויות לכל סוג משימה.
קריטריוני קבלה: הפיקו דוח עלויות וזהו את הגורמים העיקריים. הריצו את כל ארבעת צירופי המתגים, ומדדו כל אופטימיזציה לבדה ואת שתיהן יחד. הריצו את הניסוי מחדש לאחר החלפת מודלים ולא תגררו קדימה את אחוזי החיסכון מהמעקב השמור.
איטרציה מתמשכת מונחית הערכה
בחירת מודלים אינה החלטה חד‑פעמית אלא תהליך מתמשך, המותאם ככל שהמודלים מתפתחים. הפרק נפתח בטענה שמערכת הערכה מאפשרת לכם לעמוד בקצב התפתחות המודלים; מקרה מוחשי של החלפת מודל מראה כיצד הדבר מתבטא בהחלטה אמיתית.
נניח שמערכת הסוכן שלכם בנויה כרגע על Claude, ומצטיינת בקריאה לכלים ובתזמור מורכב. יום אחד, Gemini משחררת מודל חדש, ומדדי ביצועים ציבוריים מראים שהוא עולה על Claude בכמה מדדים במחיר נמוך יותר. בנקודה זו, השאלה שלכם אינה “האם Gemini טוב יותר מ‑Claude?” אלא “במשימות הספציפיות שלי, האם Gemini טוב יותר מ‑Claude? בכמה טוב יותר? מהי עלות המעבר?”
צוות בעל מערכת הערכה איתנה יכול לענות על כך בתוך שעות: להריץ את המודל החדש על מערך ההערכה שלו ולהשוות שיעור הצלחת משימה, דיוק קריאות לכלים, השהיה ועלות. אתם עשויים לגלות שהמודל החדש באמת טוב יותר וזול יותר במשימות פשוטות — אך בתרחישי הליבה הכרוכים בתזמור כלים רב‑סבבי מורכב, שיעור ההצלחה שלו יורד ב‑5%. ברגע שאתם מאשרים שההפרש חורג מרעש הדגימה המשוער (ראו “מובהקות סטטיסטית של תוצאות הערכה” בהמשך), ההחלטה שלכם הופכת לאסטרטגיה מובחנת — להעביר משימות פשוטות למודל החדש כדי לקצץ עלויות, לשמור על המודל המקורי במשימות מורכבות כדי להגן על האיכות — ולא מעבר גורף ועיוור. החלטות בגרעיניות ומבוססות נתונים כאלה אפשריות רק עם מערכת הערכה שנבנתה מראש.
ניסוי 7‑11 ★★: השוואת ביצועי מודלים רב‑ממדית
ערכו השוואת ביצועים מקיפה של מודלי LLM מרכזיים ושל ספקי API שונים כדי לבנות מסד נתונים רב‑ממדי להחלטות בחירת מודלים.
בחרו את היקף הבדיקה: מודלי SOTA בקוד סגור כגון סדרות GPT, Claude, Gemini, Doubao, ומודלים בקוד פתוח כגון Qwen, Kimi, DeepSeek. בדקו את אותו מודל עם ספקי API שונים (למשל, DeepSeek הרשמי מול Siliconflow) כדי לאמת תוצאות מפלטפורמות ניטור ביצועים של צד שלישי (למשל, Artificial Analysis).
עצבו עומסי בדיקה מתוקננים: בדיקות תפוקת קלט משתמשות בהקשרים באורך קבוע (8K/32K/128K טוקנים), בדיקות תפוקת פלט מבקשות תגובות באורך קבוע (512/2048 טוקנים). בדיקות ההשהיה כוללות TTFT (הזמן עד הטוקן הראשון) והשהיה מקצה לקצה. עבור מודלים התומכים בחשיבה, מדדו בנפרד את אורך החשיבה ואת השהיית החשיבה. עבור כל תצורה, בצעו לפחות 100 בקשות וחשבו את סטיית התקן, p50, p95 ו‑p99; שונות השהיה גבוהה מעידה על חוויית משתמש בלתי יציבה.
העריכו את זמינות ה‑API ואת יציבותו: גששו פעם בשעה במשך שבוע, ותעדו שיעור הצלחה, סוגי שגיאות ומשך כשלים. חשבו שיעור כשל, MTTR (זמן ממוצע להתאוששות) ואת זמן הפעילות הרציף הארוך ביותר. בדקו את הספים בפועל של מגבלות הקצב — הגדילו בהדרגה את המקביליות כדי למצוא את נקודת החניקה, ותעדו מגבלות RPM/TPM. חשבו עלות מקיפה: אספו מידע תמחור (מחירי יחידה לטוקני קלט/פלט/מטמון), שקלו את השפעת ה‑KV Cache, וחשבו את העלות הממוצעת למשימות סוכן רב‑סבביות טיפוסיות.
ניסוי 7‑12 ★★: הערכת בחירה מקצה לקצה של מערכות זיכרון משתמש
תנאי מקדים: יש להשלים את ניסוי האחזור המוקשר או ה‑agentic RAG מפרק 3.
מטרה: לבצע הערכת בחירת מודלים מקצה לקצה לסוכן אחזור זיכרון משתמש, ולבחון כיצד מודל השיכון, ה‑reranker והמודל הראשי של הסוכן משפיעים יחד על איכות האחזור, על ההשהיה ועל העלות. עשו שימוש חוזר ב‑chapter3/contextual-retrieval-for-user-memory או ב‑chapter3/agentic-rag-for-user-memory, והשוו את התצורות על 60 מקרי בדיקה.
קבלה: העריכו כל אחת משלוש נקודות הבחירה בתורה — מודל שיכון (BGE-M3 / OpenAI / Doubao וכדומה, תעדו דיוק אחזור top‑5, השהיה, עלות), reranker (כללו קו בסיס של “ללא reranker”, כמתו את ערכו השולי), והמודל הראשי (השוו שיעור הצלחה ויעילות שימוש בכלים תחת אותה תצורת אחזור). המפתח הוא לזהות סינרגיות בין הרכיבים: שיכון חזק יותר עשוי להפוך את ה‑reranker למיותר, ומודל ראשי חזק יותר עשוי לפצות על חסרונות אחזור. הבחירה היא פשרה מערכתית, ולא פשוט עניין של בחירת הרכיב החזק ביותר בבידוד. פרטי התצורה נמצאים במאגר הנלווה.
מובהקות סטטיסטית של תוצאות הערכה
מערך ההערכה מוגבל ופלט המודל אקראי, ולכן הפרש ציונים עשוי להיות רק רעש דגימה. אם מדדתם שיעור הצלחה p על n מקרים, ניתן להעריך את שגיאת התקן בקירוב כך:
SE(p)≈np(1−p)
למשל, ב-100 מקרים ושיעור הצלחה של 70%, רווח הסמך ל-95% הוא כ-70%±9 נקודות אחוז; “המודל החדש 73% מול הישן 70%” אינו מספיק כדי להצדיק מעבר.
בהשוואת שתי תצורות על אותה קבוצת משימות יש להעדיף ניתוח מזווג: רשמו לכל שאלה מי ניצח, והכריעו על ההפרש באמצעות מבחן McNemar או bootstrap מזווג, במקום לחסר שני שיעורי הצלחה בלתי תלויים. מכיוון שגם כל הרצה של הסוכן עשויה להשתנות, מוטב להריץ כל תצורה עם כמה זרעים אקראיים (למשל 3–5) ולדווח ממוצע לצד טווח התנודה; הרצה בודדת מתאימה רק לסינון כיוון. אם התועלת הצפויה היא 2–3 נקודות אחוז בלבד ומערך ההערכה מונה עשרות בודדות של משימות, הגדילו תחילה את המדגם — שגיאת התקן קטנה כ-1/n.
for task in paired_tasks: for seed in fixed_seeds: a = run(config_a, task, seed) b = run(config_b, task, seed) record_paired_delta(verifier(a), verifier(b))return paired_bootstrap_or_mcnemar(all_deltas)
משמעות הזיווג היא ששתי הקבוצות חולקות את אותן משימות ואת אותם תנאים אקראיים, ולא שנדגמות שתי קבוצות בנפרד ואז מושווים ממוצעיהן.
בבדיקת כמה השערות במקביל יש להביא בחשבון גם השוואות מרובות: להדק את סף המובהקות, או להריץ מחדש באופן עצמאי תוצאות חיוביות. אמת המידה המעשית פשוטה: הפרש ציונים ראוי להחלפת מודל או להשקת שינוי רק אם הוא עולה על הרעש, מחזיק בניתוח מזווג, וניתן לשחזור.
יכולת תצפית בסוכנים
החלטות מונחות הערכה (בין לבחירת מודלים ובין לאיטרציה מתמשכת) נשענות על נתוני הפעלה איכותיים. להלן נציג תחילה כיצד לאסוף נתונים אלה באופן שיטתי (יכולת תצפית), ואז נדון כיצד לתרגם תוצאות הערכה לשיפורי מערכת.
איור 7‑7: מחסנית הטכנולוגיה של יכולת התצפית · איור המקור
יכולת תצפית היא מושג שאול ממערכות מבוזרות: אינכם יכולים לפתוח את המערכת ולצפות בה עובדת; אתם מסיקים מה קורה מהיומנים, מהמדדים ומהמעקבים שהיא פולטת — כפי שרופא, שאינו יכול לראות בתוך המטופל, מאבחן מחום, מלחץ דם ומדימות. מערכות סוכן מקשות על כך עוד יותר: אותו קלט יכול להפיק פלטים שונים, היסק רב‑סבבי וקריאות לכלים הופכים את נתיבי הביצוע למורכבים ביותר, ו”החשיבה” של המודל אטומה לחלוטין מבחוץ.
ערכה של יכולת התצפית טמון תחילה באבחון בעיות: מעקבים מלאים מאפשרים למפתחים לשחזר את התהליך כולו במקום לנחש. שנית, היא הבסיס לאופטימיזציה מתמשכת — אתם יכולים לראות אילו משימות דורשות סבבי איטרציה מרובים, לאילו כלים שיעור ההצלחה הנמוך ביותר, ואילו שאילתות אחזור תמיד מחזירות תוצאות ריקות. בניהול עלויות, עלויות הפעלת סוכן יכולות להיבדל בסדר גודל או שניים בין משימות, והמעקב מציף את המקרים היקרים באופן חריג. לבסוף, נתוני מעקב שנצברו מהווים בסיס לאופטימיזציית מערכת ולשיפור מודלים בהמשך.
יכולת תצפית בסוכנים בנויה על יסוד המעקבים (traces), שמבנה הנתונים שלהם יורש ישירות את מודל עץ ה‑span ממערכות מבוזרות: ביצוע משימה אחד מתאים למעקב אחד, שבו כל קריאת LLM, כל קריאת כלי וכל אחזור הם span (יחידת ביצוע המתעדת קלט/פלט, זמני התחלה/סיום, צריכת טוקנים ומידע שגיאה). יחסי ההורה‑ילד בין spans יוצרים עץ ביצוע — לדוגמה, span של “לולאת הסוכן הראשית” עשוי להיות בעל כמה spans ילדים של “קריאת LLM” ו”קריאת כלי” תלויים מתחתיו. פרוטוקולים מתוקננים כבר זמינים לשכבה זו: OpenTelemetry הוא תקן המעקב המבוזר לשימוש כללי, בעוד שמפרטים כגון OpenInference מגדירים מעליו מוסכמות סמנטיות ייחודיות ל‑LLM (כיצד לתעד פרומפטים, פרמטרי מודל, שימוש בטוקנים וכדומה). היתרון באימוץ פרוטוקולים תקניים הוא ניתוק האיסוף מהניתוח — אותם נתוני מעקב יכולים להתחבר לצדדים אחוריים שונים לניתוח, ובכך להימנע מנעילת ספק.
LangSmith היא אחת הפלטפורמות המייצגות בתחום זה (פלטפורמות דומות כוללות את Langfuse, Arize Phoenix ואחרות), והיא משלבת יכולת תצפית, הערכה ואופטימיזציה ללולאה סגורה. כל ביצוע יוצר סשן מעקב, שבו קריאות מודל, שימוש בכלים ואחזור ידע מתועדים כיחידות ביצוע עצמאיות, המקושרות ביחסים סיבתיים ליצירת עץ ביצוע. כל יחידה מתעדת קלט/פלט מלאים, מידע תזמון, נתוני עלות ומידע שגיאה. הפלטפורמה משתמשת באיסוף נתונים אסינכרוני באצוות כדי להבטיח שהמעקב עצמו לא ישפיע על השהיית התגובה של הסוכן.
הפלטפורמה תומכת גם בבדיקות A/B (ניתוב חלק מתעבורת המשתמשים לגרסה חדשה, השוואת מדדים אוטומטית, ותמיכה בגלגול לאחור מהיר או בהרחבה הדרגתית), בניהול גרסאות פרומפטים (כל גרסה משויכת לנתוני ביצועים בזמן ריצה), ובפיתוח שיתופי (חברי צוות יכולים לחלוק נתוני מעקב ומקרי בעיה). כמות הנתונים העצומה מסביבות ייצור אמיתיות היא מכרה זהב לשיפור מתמשך — היא יכולה לחשוף תרחישים בלתי צפויים ולזהות את התכונות הזקוקות ביותר לאופטימיזציה.
השימוש בעל הערך הרב ביותר בנתוני יכולת התצפית הוא להפוך אותם לנכסי הערכה. לולאה מעשית: חלצו מקרים כושלים וחשודים ממעקבי ייצור ← אנונימיזציה שלהם (הסרת שדות רגישים כגון נתוני משתמשים ומפתחות) ← זיקוקם למקרי בדיקה חדשים ולבדיקות רגרסיה עבור מערך ההערכה. מערך ההערכה אז חדל להיות אוסף סטטי וחד‑פעמי והופך לנכס חי המתפתח עם המוצר וממשיך לשקף את התפלגות המשתמשים האמיתית — דפוסי הכשל שנחשפים בייצור היום הופכים לבדיקות הרגרסיה השומרות על קו הבסיס מחר. זהו בדיוק הממשק בין יכולת התצפית לנושא המרכזי של פרק זה: יכולת התצפית אחראית ל”ראות” מה קורה בעולם האמיתי, וההערכה אחראית לגבש תצפיות אלה לתקנים ברי‑חזרה.
לאחר שמערכת הערכה ומערך נתונים מקיפים במקומם, המפתח הוא לתרגם תוצאות הערכה לשיפורי מערכת מוחשיים.
מדוחות מדדי ביצועים לשיפורי מערכת
המקרה הבא מגיע מאיטרציית AndroidWorld אמיתית וצרה בכוונה מהמאגר הנלווה. הוא מכסה ארבע משימות הגדרות Wi‑Fi על אמולטור API 35, עם הרצה מותאמת אחת לכל משימה. אין זה מדד הביצועים המלא בן 116 המשימות ואין הוא מחליף הרצה חוזרת בסביבת הייחוס API 33. ערכו אינו ציון כולל; הוא רצף ההחלטות מתוצאה אחת לבאה.
מנקודת המבט של הנדסת Harness, סעיף זה עוסק במהותו במתודולוגיה לאופטימיזציה איטרטיבית של ה‑Harness — שימוש בנתוני הערכה כדי לזהות נקודות תורפה ב‑Harness (הקשר בלתי מספק? אילוצים חסרים? אימות בלתי הולם? משוב שאינו בזמן?), ביצוע שיפורים ממוקדים, ואז הערכה מחדש, ובכך יצירת לולאה סגורה להתפתחות מתמשכת של ה‑Harness.
לפני ניתוח דוח מדדי ביצועים כלשהו, שימו לב לעיקרון שקל להחמיץ: כשביצועי הסוכן יורדים, בדקו תחילה את מערכת ההערכה, ורק אז את הסוכן. הטעות הנפוצה היא להתחיל לערוך קוד סוכן ברגע שציון יורד, תוך התעלמות מהאפשרות שמערכת ההערכה נשברה תחילה — נווטו לפי אות מעוות והתיקון שגוי כבר מהצעד הראשון. כשלים טיפוסיים בצד ההערכה כוללים: לסביבת זמן הריצה נגמרים המשאבים והיא הורגת תהליכים (מה שמתבטא ככשלים אקראיים), באגים במנקד המסמנים תשובות נכונות ככשלים, ומקרי בדיקה הנסחפים מסנכרון עם תרחישי הייצור. במספרי הכותרת, כל אלה נראים זהים להתדרדרות מודל; רק סקירה של המסלולים המלאים יכולה להבחין ביניהם.
קריאת דוח מדדי ביצועים: אמנות גילוי הבעיות
דוח הפתיחה תיעד הרצה אחת בכל אחת מ‑116 משימות וכ‑88% הצלחה כוללת. הכשלים לא היו מפוזרים: שלוש מתוך ארבע משימות SystemWifiTurn* נכשלו, והמסלולים שלהן ניווטו שוב ושוב הלוך ושוב מבלי לאשר את המצב הסופי. שני הסברים מתאימים לראיות: הסוכן לא ידע לאן ללכת, או שייצוג ה‑UI שקיבל היה חלקי.
ציון כותרת של 88% מסתיר את אשכול הכשל הקטן אך הקוהרנטי הזה. העלאת מגבלת הצעדים הייתה מטעה באותה מידה — היא הייתה יכולה להפוך את “הסוכן אינו יכול לראות את הפקד” ל”הסוכן זקוק ליותר התמדה”. קראו דוחות בכיוון ההפוך: אתרו אשכולות לפי משימה ולפי תג יכולת, שחזרו את המסלולים, החליטו האם הכשל התעורר בתצפית, בהיסק, בפעולה או באימות, ורק אז בחרו משתנה לשנות. פרוסת ה‑Wi‑Fi שימשה לאבחון המנגנון בזול, ולא להערכת ביצועים ברמת המערכת כולה.
מנתונים להשערות: בניית מפת דרכים לשיפור
הסבב הראשון בדק את ההסבר הזול ביותר. H1 הניחה פער בידע ניווט, ולכן רק זרוע הטיפול קיבלה הוראות ניווט ב‑Wi‑Fi ובדיקת מצב סופי. ההצלחה לא השתפרה; הפרומפט לא היה צוואר הבקבוק.
הסבב השני שאל מה הסוכן יכול היה בפועל לראות. H5 החליפה את הזנת הנגישות שאינה תואמת ל‑API 35 בעץ ה‑UIAutomator הנתמך של AndroidWorld. ההצלחה השתפרה, אך העץ המלא גרם לזינוק בשימוש בטוקנים. H5C הוסיפה לפיכך אפס מידע חדש: היא פשוט הסירה צמתי מכולה בלתי נראים, חסרי טקסט ולא ניתנים לפעולה כדי לראות האם ניתן לשמר את אותה הצלחה בפחות רעש.
לאורך כל שלושת הסבבים, המודל, פרמטרי המשימה, הזרע, מגבלת הצעדים והאמולטור נשארו קבועים, וסדר הזרועות התחלף. עיצוב מדורג זה הפך את הייחוס לפשוט: הבעיה הנותרת או תופעת הלוואי מסבב אחד הפכה לשינוי היחיד בסבב הבא.
מתוצאות להחלטות: פשרות מבוססות נתונים
טבלה 7‑5 מסכמת את התוצאות שנמדדו. עם ארבע משימות בלבד לכל זרוע, מספרים אלה יכולים להכריע האם הרצה חוזרת גדולה יותר שווה את המאמץ; הם אינם יכולים להעריך הצלחה על פני AndroidWorld.
טבלה 7‑5 שלושה סבבים על פרוסת ה‑Wi‑Fi של AndroidWorld
ניסוי
השינוי היחיד
הצלחה: בקרה ← טיפול
טוקנים: טיפול / בקרה
הצעד הבא
H1
הוספת הוראות ניווט
25% ← 25%
0.47×
ללא רווח בהצלחה; שמרו על הפרומפט המקורי
H5
הזנת נגישות ← UIAutomator
25% ← 100%
2.498×
רווח חזק אך יקר מדי; המשיכו באופטימיזציה
H5C
דחיסת עץ ה‑UIAutomator
100% ← 100%
0.506×
שימור ההצלחה וחציית הטוקנים; התקדמו להרצה חוזרת מלאה
הרצף חשוב יותר מכל אחוז בודד. הוראות מפורטות יותר אינן יכולות לשחזר מידע שהסוכן מעולם לא קיבל; יש לחקור כשלי תצפית לפני שמרחיבים פרומפטים. אך יותר קלט אינו תמיד טוב יותר. עץ האלמנטים המלא תיקן את הנראות תוך שהוא מציף את ההקשר ברעש. הסרת צמתים לא סמנטיים שימרה ארבע הרצות מוצלחות וקיצצה את הטוקנים בכמחצית. שום מודל לא שונה: ייצוג ה‑UI של ה‑Harness קבע תחילה האם ניתן להשלים את המשימה ואז האם השלמתה כלכלית.
איטרציה מתמשכת: מהשיפור הראשון להתפתחות המערכת
מעבר של H5C בארבע משימות רק מזכה אותה בבדיקה גדולה יותר; הוא אינו מסמיך פריסה. השער הבא הוא הרצה בחמישה זרעים על כל 116 המשימות בסביבת הייחוס Pixel 6 / API 33 עם מערך יישומי הצד השלישי המלא. ההצלחה חייבת להיות לא נחותה, השימוש בטוקנים לא יותר מ‑75% מהמקורי, וההשהיה לא יותר מפי 1.5. עד להשלמת הרצה זו, אין לדווח על 4/4 בפרוסה כעל 100% הצלחה ברמת המערכת.
זו משמעותה של איטרציה מתמשכת בפועל: ראיות מסבב אחד צריכות להסמיך רק את הפעולה הבאה שהיקפן יכול לתמוך בה. H1 עצרה ערמת פרומפטים נוספת; H5 מצאה את המנגנון הנכון וחשפה בעיית עלות; H5C תיקנה את הבעיה הזו והוכשרה לבדיקה רחבה יותר. דוח מדדי ביצועים טוב מכיל יותר מציון. הוא מציין היכן המסקנה חלה, אילו מעקות בטיחות נכשלו, ומה יש לבדוק בהמשך.
ניסוי 7‑13 ★★★: הערכה ושיפור ב‑AndroidWorld
ניסוי זה מתרגל את המסלול המלא מדוח הערכה לשיפור מערכת. התחילו מהדוח ההיסטורי ומשלוש ההרצות המזווגות השמורות ב‑chapter6/android-world.
שלב 1: אבחון. נתחו בהצלבה את הטבלה לפי משימה ואת מטריצת תגי היכולת כדי למפות כשלי משימה שטחיים לחסרי יכולת עמוקים. זהו תגי יכולת בעלי שיעורי הצלחה נמוכים מהצפוי ותחומי משימות שבהם הכשלים מרוכזים.
שלב 2: בניית השערות. גבשו השערות שיפור לפי המסגרת התלת‑שכבתית (שטח ← ביניים ← עומק). כל השערה צריכה לציין את שיפור שיעור ההצלחה היעד ואת שיטת האימות.
שלב 3: ניסוי מדורג. שחזרו את H1, H5 ו‑H5C עם משתנה אחד המשתנה בכל סבב. תעדו טוקנים, השהיה ונסיגות בנוסף להצלחה.
שלב 4: קבלת החלטות מבוססת נתונים. קבלו החלטות פריסה על בסיס ניתוח עלות‑תועלת — לא פשוט לאמץ את כל השיפורים האפקטיביים, אלא לשקול את היקף היישום, את השפעת ההשהיה ואת תקורת העלות עבור כל שיפור. תנו עדיפות לפריסת שיפורים בעלות נמוכה ותועלת גבוהה; הגבילו שיפורים בעלות גבוהה לתרחישים קריטיים.
שלב 5: איטרציה. ניסוי פרוסה שעבר מתקדם רק להרצה החוזרת המלאה. דונו בפריסה רק לאחר ההרצה בסביבת הייחוס בת 116×5, ושמרו בדוח את הבדלי הסביבה, את גודל המדגם ואת ההיקף הבלתי שלם.
מהערכה חיצונית להערכה פנימית: תשתית הערכה לסוכנים ברמת ייצור
עד כה פרק זה העריך מערכות סוכן מבחוץ — בניית סביבת הערכה, עיצוב מערכי נתונים, ניתוח דוחות מדדי ביצועים. אך מוצרי הסוכן הטובים ביותר עושים יותר מלעבור הערכה חיצונית; הם בונים לתוך המוצר תשתית הערכה עצמית מתמשכת. להלן, תוך שימוש בסוכן הקוד הפתוח לשימוש כללי OpenClaw שהוצג בפרק 5 כדוגמה ותוך הסתמכות על ניתוחים טכניים פומביים של מוצרי סוכני קוד מובילים ועל תובנות מהשטח, אנו מציגים מערכת הערכה פנימית שכדאי לחקות: כזו המשבצת באופן שיטתי את המתודולוגיה הניסויית של מחקר ML בהנדסת מוצר.
תשתית אבלציה: הבנת התרומה האמיתית של כל תכונה
חוקרי ML משתמשים זה מכבר במחקרי אבלציה כדי ללמוד אילו רכיבים של מודל באמת חשובים — אבלציה פירושה “הסרת” רכיב אחד בכל פעם ובחינת מידת הירידה בביצועים הכוללים. OpenClaw מביא מתודולוגיה זו להנדסת מוצר: מתג ראשי מובנה יכול להשבית כמה תכונות מרכזיות בבת אחת (מצב חשיבה, דחיסת הקשר, זיכרון אוטומטי, משימות רקע ועוד), ובכך ליצור קו בסיס של “מודל חשוף”. הדבר מאפשר לצוות לענות על שאלה מרכזית: האם תכונה באמת משפרת את חוויית המשתמש, או שהיא רק מרגישה שימושית?
הפיכת האבלציה לפרקטיקה הנדסית שגרתית, ולא לפעילות מחקרית חד‑פעמית, נושאת כמה השלכות מעשיות. ראשית, מתג האבלציה חייב להיות מוזרק מוקדם מאוד בנתיב האתחול — לפני שקבוע כלשהו ברמת המודול לוכד ערכי תצורה — כלומר תשתית האבלציה חייבת להיות מעוצבת לתוך ארכיטקטורת המערכת מלכתחילה, ולא להיות מותקנת בדיעבד. שנית, הרצת ניסויי אבלציה באופן קבוע (למשל, לפני כל שחרור מרכזי) יכולה לחשוף “חוב תכונות” — תכונות שהיו פעם אפקטיביות אך שוב אינן נחוצות ככל שהמודלים מתפתחים. עבור כל צוות הבונה סוכן ייצור, הפרקטיקה המומלצת היא: כל תכונה מרכזית צריכה להיות ניתנת להשבתה באופן עצמאי, והצוות צריך לאמת באופן קבוע את התרומה בפועל של כל תכונה.
מתודולוגיית בדיקות A/B: הבחנה בין מנגנון למטרה
מוצרי סוכן בשלים עורכים בדיקות A/B קפדניות על התנהגותם שלהם (כלומר, חלוקה אקראית של משתמשים לשתי קבוצות, אחת המשתמשת בגרסה הישנה ואחת בחדשה, והשוואת נתונים בפועל משתי הקבוצות כדי לקבוע האם שינוי אפקטיבי). מקרה בדיקת A/B מעוצב היטב לסוכן ממחיש כמה עקרונות מתודולוגיים מרכזיים:
וריאנטים מרובים, ולא רק השוואה בינארית. במקום להשוות רק “עם” ו”בלי”, עצבו כמה וריאנטים מתקדמים (למשל, בעת בדיקת עוצמות שונות של אילוצי פרומפט, הקימו קבוצת בקרה ושלוש קבוצות ניסוי עם אילוצים מחמירים בהדרגה). עיצוב זה יכול לחשוף יחסי מנה‑תגובה ולסייע במציאת הנקודה האופטימלית.
הבחנה בין מדדי מנגנון למדדי מטרה. זו הטעות הקלה ביותר לעשות — התייחסות למה שאתם משנים כאל יעד האופטימיזציה. לדוגמה, אם אתם בודקים “קיצור אורך קובץ התוכנית של הסוכן”, אורך התוכנית הוא מדד מנגנון (משהו שאתם משנים ישירות), אך הוא אינו המטרה. המטרה האמיתית עשויה להיות “הפחתת עלות ברמת הסשן”. קיצור קובץ התוכנית עשוי להוריד עלויות, אך הוא גם עלול להוביל ליותר לולאות עריכה‑בדיקה‑עריכה בשל תוכניות שאינן מפורטות די הצורך, ובכך להגדיל את הפלט הכולל. שאלו את עצמכם תמיד: האם מה שאני משנה (המנגנון) זהה למה שבאמת אכפת לי ממנו (המטרה)? אם לא, תנו עדיפות למטרה.
קביעת מדדי מעקה בטיחות. גם אם מדד המטרה משתפר, יש לעצור את הניסוי אם שביעות רצון המשתמשים יורדת, מספר הפעולות גדל, או שיעור השגיאות עולה. מדדי מעקה בטיחות הם ספים שאינם ניתנים למשא ומתן שאסור להם לסגת.
תיעוד סטטיסטיקות קו בסיס. כללו גודל מדגם, אחוזוני התפלגות וניתוח מתאם (למשל, “שיעור הדחייה עולה מונוטונית עם גודל התוכנית”) כדי לספק את ההקשר הנחוץ לפרשנות תוצאות הניסוי. ללא קו בסיס, אינכם יכולים לקבוע האם תוצאות הניסוי מובהקות סטטיסטית.
מערכת דגלי תכונות דו‑שכבתית
מוצרי סוכן זקוקים לתשתית Feature Flag המעוצבת מהיום הראשון — דגל תכונה הוא מתג הניתן לשליטה מרחוק הקובע האם תכונה מופעלת או מושבתת עבור משתמשים, ללא צורך בפריסה חוזרת של הקוד. הוא משרת שלוש מטרות בו זמנית: ניסוי, השקה הדרגתית וניתוק חירום.
דגלי זמן הידור מסירים פיזית את הקוד הרלוונטי מתוצר הבנייה בשלב הבנייה. תכונות פנימיות בלבד פשוט אינן קיימות בבניות חיצוניות — אפילו הנדסה הפוכה אינה יכולה לגלות את הפונקציונליות שהוסרה. הדבר גם מספק מנגנון אבלציה נקי: השבתת תכונה אינה מדלגת על לוגיקה בזמן ריצה; הקוד המתאים נעדר פיזית.
דגלי זמן ריצה מקבלים את תצורתם מהשרת והיא נשמרת במטמון מקומי בדיסק. העיצוב מעדיף קריאת תצורה מעט מיושנת מהמטמון על פני חסימת אתחול הסוכן בהמתנה לבקשת רשת. החלטות קיבוץ ספציפיות מתקבלות באמצעות פלטפורמת ניסויים (למשל, GrowthBook) להקצאת קבוצות בדיקת A/B. פרט עיצובי מרכזי הוא שאירוע החשיפה של כל תכונה נרשם לכל היותר פעם אחת לכל סשן כדי להימנע מרשומות כפולות המזהמות את נתוני הניסוי.
הלקח למפתחי סוכנים: דגלי תכונות אינם כלי ניפוי; הם רכיבים ארכיטקטוניים ממדרגה ראשונה.
הערכת רגישות פרומפטים
הנחיית המערכת היא “הקוד” המרכזי של התנהגות הסוכן, ובכל זאת לעיתים קרובות חסרים לה ניהול הגרסאות ובדיקות הרגרסיה המוענקים לקוד רגיל. הגישה של OpenClaw היא לספק כלי ייעודי שיכול לחלץ את הנחיית המערכת המרונדרת במלואה ברוויזיה או בקומיט מסוימים של Git — לרבות הטקסט הסופי לאחר הרחבת כל התנאים הדינמיים. הדבר מאפשר לצוות לענות במדויק: איזה קומיט שינה את הפרומפט? מה הייתה ההשפעה על מערך ההערכה?
עבור כל צוות סוכנים, הפרקטיקות המומלצות הן: (1) הנחיית המערכת צריכה להיות ניתנת לרינדור דטרמיניסטי (בהינתן אותו קלט תצורה, היא תמיד מפיקה את אותו פלט); (2) בססו מנגנון תצלומים מנוהל‑גרסאות לפרומפטים; (3) כל שינוי פרומפט צריך להריץ בדיקות רגרסיה על מערך ההערכה — בדיוק כפי ששינויי קוד דורשים CI.
אנליטיקה מודעת פרטיות כבסיס להערכה
הערכה נשענת על נתונים טובים, אך מוצרי סוכן מטפלים לעיתים קרובות בתוכן משתמש רגיש. OpenClaw מיישב סתירה זו באמצעות מערכת טיפוסים: ממשק האנליטיקה מקבל רק ערכים העטופים בטיפוסים מיוחדים, כששם הטיפוס עצמו משמש כמסלול ביקורת — הוא מצהיר במפורש “אימתתי שזה אינו קוד או נתיב קובץ”. עיצוב זה הופך אילוצי פרטיות ממפרטים מתועדים לבדיקות טיפוסים הנאכפות בזמן הידור.
עקרון הליבה הוא: עצבו אילוצי פרטיות לתוך המערכת מלכתחילה; אל תתקינו אותם בדיעבד. אם מערכת האנליטיקה שלכם אינה יכולה לאסוף נתונים בבטחה, אינכם יכולים להעריך באופן אפקטיבי. פרטיות והערכה אינן כוחות מנוגדים — עיצוב מודע פרטיות מאלץ אתכם לחשוב בקפידה על מה באמת צריך להימדד, מה שמטפח בתורו מדדי הערכה מדויקים יותר.
מחיצוני לפנימי: שינוי בחשיבת ההערכה
המסר המרכזי של סעיף זה הוא: הסעיפים הקודמים לימדו אתכם כיצד להעריך סוכן מבחוץ; סעיף זה חושף כיצד מוצרי הסוכן הטובים ביותר מעריכים את עצמם מבפנים. הערכה חיצונית מגלה לכם “כמה טוב הסוכן”; תשתית הערכה פנימית מגלה לכם “איזה שינוי הפך אותו לטוב יותר”. ניסויי אבלציה מגלים אילו תכונות באמת חשובות, בדיקות A/B מכמתות את השפעת כל שינוי, דגלי תכונות מספקים את התשתית לניסוי ולגלגול לאחור, הערכת רגישות פרומפטים משלבת את הנחיית המערכת במערכת ה‑CI, ואנליטיקה מודעת פרטיות מבטיחה ציות באיסוף הנתונים. חמשת הרכיבים הללו מהווים יחד הנדסת מוצר מונחית הערכה — לא להעריך מדי פעם, אלא לשבץ הערכה בכל החלטת מוצר.
סביבות סימולציה: הגשר מהערכה לאימון־על
נקודת הסיום של ההערכה אינה ניקוד, אלא שיפור. פרק זה כבר הדגים שני מסלולים לשיפור: התאמת ה‑Harness (מדוחות מדדי ביצועים לשיפורי מערכת) ושיבוץ הערכה בהנדסת מוצר (תשתית הערכה פנימית). הצורה החזקה ביותר של שיפור היא אימון — כשהמטרה מתרחבת מ”הערכת יכולות קיימות” ל”טיפוח יכולות חדשות”, ובפרט באמצעות טכניקות אימון־העל הנדונות בפרק 8, סביבת ההערכה צריכה להתפתח לסביבת סימולציה: מגרש משחקים וירטואלי שבו הסוכן יכול להתאמן שוב ושוב ולקבל ניקוד אוטומטי. הבדלי הליבה בין סביבות סימולציה לסביבות הערכה הם: תדירות אינטראקציה גבוהה בהרבה (מיליונים מול אלפים), הצורך באקראיזציה (כדי למנוע שינון תצורות ספציפיות), והדרישה למשוב מיידי. מנקודת מבט יישומית, סביבות סימולציה מתחלקות לשתי קטגוריות: סביבות דיגיטליות (משימות עיבוד מידע) וסביבות מגולמות (תפיסה ומניפולציה של העולם הפיזי).
כך נפגשים שני קצות הגשר. נכסים שנצברו בצד ההערכה מומרים כמעט בחלקות לאותות אימון: Rubric או מאמת מוגדרים היטב הם במהותם פונקציית תגמול ללמידת חיזוק עם תגמולים ניתנים לאימות (RLVR) — סקריפט הניקוד הופך לסקריפט התגמול; האם בדיקה עוברת או האם מצב עומד בתקן משמש הן כקריטריון הערכה והן כתגמול בלמידת חיזוק. אך אימון מביא דרישות שההערכה מעולם לא הייתה צריכה לדאוג להן. הראשונה היא סמנטיקת איפוס אמינה: אימון מריץ מיליוני אפיזודות (אפיזודה היא סבב אינטראקציה שלם ממצב התחלתי ועד השלמת המשימה), וכל אפיזודה חייבת להיות מסוגלת לאפס את הסביבה למצב התחלתי דטרמיניסטי ונקי; אחרת, אות הגרדיאנט יזוהם על ידי מצבים שיוריים מהאפיזודה הקודמת. השנייה היא תפוקה החורגת הרבה מזו של הערכה: כמה אלפי הערכות די בהן כדי להסיק מסקנות, אך אימון דורש להזין למודל מיליוני אינטראקציות בתוך זמן שעון מקובל; מידת המקביליות של הסביבה והתקורה לכל מופע קובעות ישירות האם האימון בר‑ביצוע. שתי נקודות אלה — מאמתים ההופכים לפונקציות תגמול, ואיפוס ותפוקה ברמת אימון — יפורטו בפרק 8.
בצד הסביבה הדיגיטלית, מסגרת AWorld בונה ארגז חול נשלט של שרתי MCP למשימות GAIA, ומספקת 26 שרתי MCP המכסים 126 פונקציות כלים, ובכך נמנעת מחסימות ומתופעות לוואי בלתי נשלטות של גישה ישירה לממשקי API אמיתיים. כל קריאות הכלים ניתנות לשחזור ולביקורת. הארכיטקטורה המבוזרת של AWorld מצמצמת את זמן הביצוע הטורי המסורתי מ‑7695 שניות ל‑525 שניות (האצה פי 14.6), והעיצוב חסר המצב של הסביבה הופך כל מופע לעצמאי לחלוטין, ותומך במקביליות יעילה.
בצד הסביבה המגולמת, RoboTwin2 בונה משימות מניפולציה דו‑זרועיות על בסיס מנוע פיזיקה, ומאקראה מיקומי אובייקטים, כיוונים ומראה כדי לשפר הכללה. מרחב התצפית כולל תצוגות ממצלמות מרובות ומצבי מפרקים, ומשיג בקרה בזמן אמת באמצעות קיבוץ פעולות — שבו המודל מתכנן כמה פעולות עוקבות בבת אחת (מפורט בפרק 6). OSWorld מספק יכולת איפוס באמצעות תצלומי מכונות וירטואליות, ו‑AndroidWorld מתמקד באוטומציית יישומים ניידים. בין אם דיגיטליות ובין אם מגולמות, סביבות סימולציה דורשות גם את סביבות הביצוע המבודדות ואת מנגנוני הזהות הווירטואלית שנדונו בפרק 4 (בידוד מכונות וירטואליות/קונטיינרים, פרוקסי ביתי, אימות עם אדם בלולאה, מערכות קבצים משותפות), שלא נחזור עליהם כאן.
ניסוי 7‑14 ★★: הגדרת סביבת האינטליגנציה המגולמת עבור OpenVLA ו‑RoboTwin2
הקימו סביבת סימולציה למניפולציה רובוטית. קראו את ch7/SimpleVLA-RL ואת תיעוד OpenVLA כדי להבין את ארכיטקטורת מודל ה‑Vision-Language-Action (שילוב מקצה לקצה של מקודד ראייה, מודל שפה ומפענח פעולות, המקרין תמונות וטקסט למרחב סמנטי משותף). הגדירו את סביבת RoboTwin2, תוך הבנת מרחב התצפית (RGB בשלוש תצוגות + מצב מפרקים בן 14 ממדים) ומרחב הפעולה (וקטור בקרה בן 14 ממדים). למדו את מנגנון אקראיזציית הסביבה ואת לוגיקת האילוצים המרחביים ב‑move_can_pot. העריכו את המודל המאומן מראש, ותעדו את שיעור ההצלחה שלו, את זמן ההשלמה ואת אופני הכשל, תוך התמקדות בהשפעת מנגנון קיבוץ הפעולות.
איור 7‑10: סביבת האינטליגנציה המגולמת של OpenVLA ו‑RoboTwin2 · איור המקור
פשרות נאמנות ואקראיזציית תחום
סביבות בעלות נאמנות גבוהה תומכות במעבר טוב יותר לעולם האמיתי אך עלויות החישוב שלהן גבוהות. ממד נוסף של נאמנות הוא מידת האקראיזציה: אקראיזציה מתונה משפרת הכללה, בעוד שאקראיזציה מוגזמת יכולה להפוך משימות לקשות מדי. אקראיזציית תחום היא טכניקה מרכזית לצמצום פער הסימולציה‑למציאות: הכנסת טווח רחב של שינויים אקראיים בפרמטרים פיזיים, במראה חזותי, ברעש חיישנים וכדומה — בדיוק כמו תרגול תפיסה תחת תאורות וזוויות שונות, כך שלא תיכשלו בעולם האמיתי רק משום שהאור השתנה. בסביבות דיגיטליות, סימולציה‑למציאות מתבטאת בהבדלים ברינדור הממשק, בזמני התגובה וכדומה, שניתן להקל עליהם באמצעות הכנסת אקראיזציה בהשהיה ובכשלים.
סיכום הפרק
פרק זה נסב סביב שאלה אחת מרכזית: כיצד לקבוע אם סוכן השתפר או הידרדר? השרשרת מורכבת מארבע חוליות: תחילה לחדד מהי הצלחה (הבדלי הבסיס בין Pass@k, Best@k ו‑Pass consecutive@k), אחר כך לקבוע מהיכן מגיעות המשימות (מבחני ייחוס ציבוריים, מערך עסקי עצמי, וזרימה חוזרת של trajectory מהייצור), לאחר מכן לבחור את אופן האימות (ממאמתים דטרמיניסטיים לרשימות בדיקה, ל‑Rubric עם שיפוט LLM, ועד להשוואה זוגית), ולבסוף להפוך ציונים להחלטות (מובהקות סטטיסטית, ייחוס כשלים, משימות רגרסיה ובחירת מודל). כל חוליה משפיעה על מהימנות המסקנה.
במונחי המבנה הגדול של הספר, פרק זה בונה את מקטע הראיות של לולאת הגילוי מפרק 1: ייחוס כשלים קובע האם להצעות המאוחרות יותר יש על מה להישען.
הערכת גבולות על קידומות מסלול ממחישה עוד שקבלת פיסת מידע ויישומה הנכון בהחלטה הנוכחית הן שתי יכולות שונות: רגרסיה מקצה לקצה מבטיחה שמשימות הבסיס לא יידרדרו, ואילו מערך גבולות קידומת המסלול בודק ישירות שיפוט תחום, דריסה על ידי ההוראה הנוכחית, בקשת הבהרה ואישור לפני פעולות מסוכנות. זיכרון המשתמש הוא רק מקרה אחד של השיטה הכללית הזו. הערכה של סוכנים ברמת ייצור אינה בחינה שנערכת מדי פעם, אלא מערכת אימות שמייצרת ברציפות משימות רגרסיה ומשימות גבול מתוך מקרי בעיות אמיתיים.
מתודולוגיית ליבה: תצפית ← השערה ← ניסוי ← אימות ← הבנה חדשה ← השערה חדשה, ההופכת הנדסת סוכנים מ”אלכימיה” מונחית ניסיון להנדסה מדעית מונחית נתונים.
מערכת ההערכה המוצגת בפרק זה יוצרת לולאה סגורה שלמה: סביבת הערכה מספקת תשתית בדיקות אוטומטית ← מערך נתוני הערכה מגדיר מקרי בדיקה ← שיטות הערכה אוטומטיות (LLM‑as‑a‑Judge ו‑Rubric) מנקדות את ביצועי הסוכן ← ניתוח מדדי ביצועים חושף כיווני שיפור ← שיפורי מערכת מתקנים בעיות ← עדכון סביבת ההערכה ומערך הנתונים, והתחלת מחזור איטרציה חדש.
מערכת ההערכה שבוססה כאן תומכת לא רק באופטימיזציה של המערכת הנוכחית אלא גם מספקת יסוד קריטי לשני הפרקים הבאים. פרק 8 הופך סביבות ונתוני הערכה לקלטים לאימון־על של מודלים, תוך שימוש ב‑SFT וב‑RL כדי לכתוב מדיניות אינטראקציה לתוך הפרמטרים. פרק 9 הופך הערכות רב‑ממדיות של מסלולי ייצור לעדכונים מועמדים לידע, להוראות, לתוכניות או לפרמטרים.
שאלות למחשבה
★★ LLM‑as‑a‑Judge משתמש במודל שפה כדי להעריך את הפלט של מודל שפה. האם ל”הערכה עצמית” זו יש נקודות עיוורון שיטתיות — לדוגמה, המודל עשוי לתת באופן עקבי ציונים גבוהים לסגנון מסוים של תגובה, העדפה שאינה עקבית עם שיפוט אנושי? כיצד ניתן לזהות ולתקן הטיות כאלה?
★★★ העיצוב “מונע הדליפה” של מערכי נתונים להערכה הוא קריטי. אולם באקוסיסטם הקוד הפתוח, ברגע שנתוני מדד ביצועים מתפרסמים, הם משולבים במהירות בנתוני אימון. האם ל”משחק החתול והעכבר” הזה יש סוף? עצבו שיטת הערכה העמידה מיסודה לדליפת נתונים.
★★ ארבעת הקריטריונים של Scale AI (הנחיית מומחים, כיסוי מקיף, שקלול חשיבות מתוקנן, הערכה עצמאית) שואפים לבטל סובייקטיביות בהערכה. אולם ממדי משימה מסוימים (למשל, “האם התשובה מועילה?” “האם הטון הולם?”) הם סובייקטיביים מטבעם. כיצד ניתן לעצב Rubrics אמינים לממדים סובייקטיביים אלה?
★★ τ-bench מעריך סוכנים באמצעות דימוי התנהגות משתמש אמיתית. אך המשתמש המדומה עצמו הוא LLM — הוא עשוי להמעיט באופן שיטתי בהערכת מקרי קצה מסוימים (למשל, משתמשים נסערים רגשית או לא ברורים). כיצד ניתן לאמת את איכותו של המשתמש המדומה עצמו?
★★ השוואה זוגית (מודל Bradley‑Terry) מניחה שההעדפות טרנזיטיביות (אם A > B ו‑B > C, אז A > C). אולם העדפות אנושיות מפרות לעיתים קרובות טרנזיטיביות. בהערכת סוכנים, באילו תרחישים עשויות להופיע העדפות לא טרנזיטיביות? כיצד הדבר משפיע על אמינות הדירוגים?
★★ פרק זה מבחין בין Pass@k כתקרה על היכולת לבין Pass רצוף@k כמדד לאמינות עסקית. עבור סוכן ששיעור ההצלחה שלו בהרצה יחידה הוא 60% בלבד, כיצד הייתם משלבים את עלות הכשל של המשימה, את עלות הניסיון החוזר ואת תופעות הלוואי כדי להחליט באיזה מדד לדווח ומה צריך להיות גודלו של k?
★★ פרק זה מציע את השיטה המדעית של “תצפית ← השערה ← ניסוי ← אימות”. בפועל, לעומת זאת, מרחב ההתנהגות של הסוכן עצום, ואימות השערה בודדת עשוי לדרוש מאות הרצות הערכה. כיצד ניתן למקסם את המידע המופק מהערכה תחת תקציב חישובי מוגבל?
★ בפיילוט של AndroidWorld, עץ האלמנטים המלא העלה את ההצלחה מ‑25% ל‑100% אך הגדיל את השימוש בטוקנים לפי 2.498 מהבקרה; הגיזום שימר 100% הצלחה תוך צמצום השימוש בטוקנים ל‑0.506×. כיצד הייתם מעצבים כללי גיזום אוטומטיים המסירים צמתי UI ריקים סמנטית מבלי לזרוק מידע הנחוץ לנגישות, לאימות מצב או לפעולות מאוחרות יותר?
★★ דימוי המשתמש של τ-bench מעסיק “חשיפת מידע הדרגתית” — לא לספק את כל המידע בבת אחת, אלא לחשוף אותו בהדרגה על בסיס שאלות הסוכן. כיצד עיצוב זה משפיע על תוצאות ההערכה? אם אסטרטגיית חשיפת המידע של המשתמש המדומה נבדלת במידה ניכרת ממשתמשים אמיתיים, האם מסקנות ההערכה עדיין אמינות?
הערות שוליים
Wijk, Hjalmar, et al. RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts. arXiv:2411.15114, 2025. ↩
מהלכה למעשה
ניסויים נלווים
עיינו בניסויים הנלווים לפרק וראו כיצד הרעיונות האלה מתממשים בקוד.