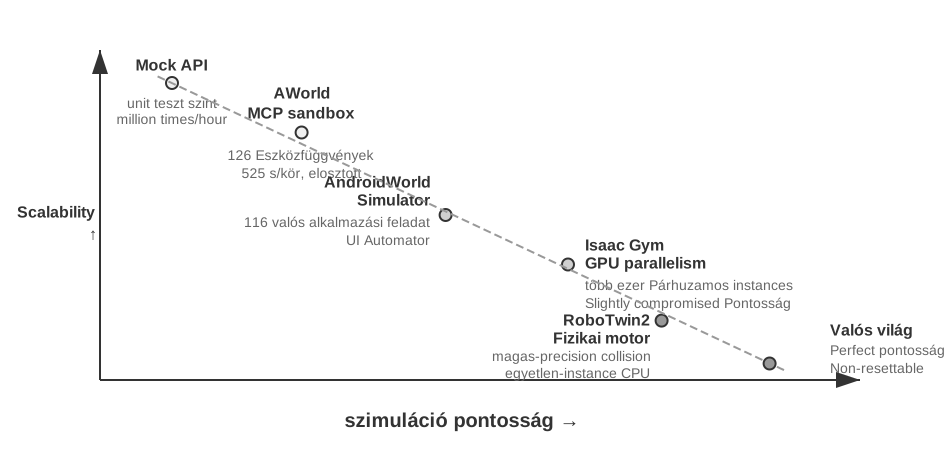
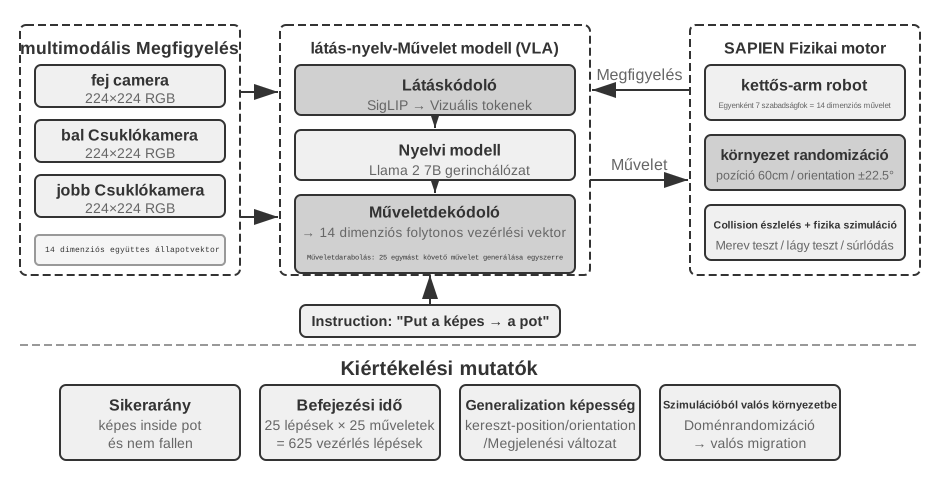
Az első hat fejezet bemutatta egyetlen Ágens felépítését: a kontextust, a tudást, az eszközöket, a kódolási képességet, valamint a megfigyelési és cselekvési teret. Az építés befejezése azonban nem jelenti azt, hogy a rendszer helyesen épült fel; csak a stabil mérés adhat megbízható irányt a későbbi modelltanításhoz és rendszerfejlődéshez.
Egy Ügynökrendszer építése során a fejlesztők számos tervezési döntéssel szembesülnek, amelyekre gyakran nincs nyilvánvaló helyes válasz:
Melyik modellt érdemes használni?
Milyen eszközöket hívhat a modell?
Milyen adatokat tároljon a tudásbázis, és hogyan strukturálja azokat?
Hogyan valósítsuk meg a felhasználói memóriát?
Hogyan szervezzük a modell utasításait és készségeit?
Milyen korlátozásokat kell hozzáadni a Harnesshoz?
Hogyan alakítsuk át a kiértékelési eredményeket tanulási jelekké az Ügynök folyamatos fejlődéséhez?
A kiértékelés tudományos alapokra helyezi ezeket a döntéseket. Szisztematikus összehasonlító kísérletekkel (egyszerre csak egy változó módosítása és a hatás megfigyelése) és ablációs kísérletekkel (egy összetevő kikapcsolása és az általános teljesítményváltozás megfigyelése) megkülönböztethetőek a valódi képességnövekedések a felszínes ingadozásoktól — elkerülve, hogy filléreskedők legyünk, miközben fontos dolgokon spórolunk. A szoftvermérnökségben van egy mondás: nem javíthatsz azon, amit nem mérsz. Megismételhető kiértékelő rendszer nélkül egy Ügynököt csak intuíció alapján lehet iterálni.
Az 1. fejezetben bemutatott Harness Engineering szempontjából a kiértékelés a Harness “verifikációs” szerepét tölti be. Egy kulcsfontosságú felismerés: a kiértékelés tárgya nem csupán a modell, hanem a modell és a Harness kombinációja legyen. Ugyanaz a modell drasztikusan eltérően teljesíthet különböző Harnessokban — egyes csapatok pusztán a Harness optimalizálásával jelentősen javították ugyanazon modell teljesítményét terminálfeladatokon (lásd 5. fejezet). Tehát amikor egy Ügynök gyengén teljesít, a megoldás nem feltétlenül egy másik modell, hanem egy jobb Harness-összetevő (utasítások, eszköztervezés, visszacsatolási hurkok). Egy jól felépített kiértékelő rendszernek képesnek kell lennie két alapvetően különböző probléma elkülönítésére: “elégtelen modellképesség” és “Harness-tervezési hibák”. “Az elkülönítés bevett módja a modellcsere-kísérlet”: rögzítsd a Harnessot, cseréld be egy erősebb vagy gyengébb modellt, és figyeld meg, mennyit változik a pontszám. Ha egy erősebb modell sem emeli a pontszámot, a szűk keresztmetszet a Harness. Ha egy gyengébb modell lesüllyeszti a pontszámot, és az eredmények élesen ingadoznak a modell képességeivel, a legközvetlenebb értelmezés szerint a modell maga a szűk keresztmetszet, és a jelenlegi teljesítményt a modell dominálja. Hogy ez a feladat eredendő nehézsége miatt van-e, vagy mert a Harness túlzottan támaszkodik a modell előzetes tudására, az további elemzést igényel. Vegyük észre, hogy ez eltér a fenti ablációs kísérlettől: abláció során “egy Harness-összetevőt kapcsolunk ki”, hogy lássuk az általános teljesítmény változását; modellcsere során rögzítjük a Harnessot és csak a modellt cseréljük. Az előbbi azt lokalizálja, hogy a Harness mely része számít; az utóbbi azt mondja meg, hogy a szűk keresztmetszet a modell-e vagy a Harness.
Egy kiértékelő rendszer még nagyobb értéket képvisel a gyors modellfejlődés korában. A modellek folyamatosan javulnak, de egy új modell, amely magasabb pontszámot ér el a nyilvános benchmarkokon, nem feltétlenül teljesít jobban az Ön feladatán — akár romolhat is (rosszabbul teljesíthet, mint a régi verzió bizonyos szempontokból). Csak a saját kiértékelési adathalmazon végzett teljes futtatás teszi lehetővé az adatvezérelt frissítési döntést. Egy szilárd kiértékelő rendszer még a “jövőbeli modellekre épülő termékfejlesztés” stratégiáját is életképessé teszi: ha a jelenlegi modell nem elég jó a kereskedelmi bevezetéshez, fejezd be a terméket, építsd fel a kiértékelési készletet, kövesd nyomon minden új modell teljesítményét, és indulj el, amint valamelyik átlépi a küszöböt.
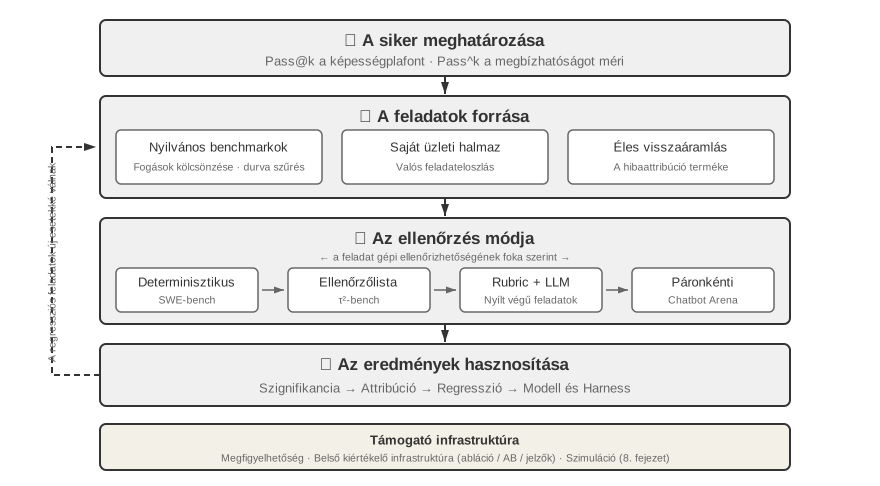
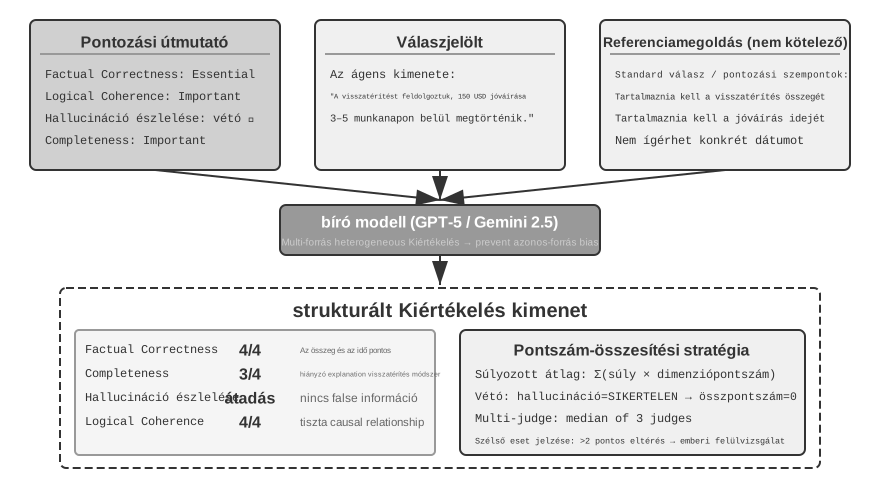
Egy kiértékelő rendszer négy szakaszra bontható: mi számít sikernek, honnan jönnek a feladatok, ki ellenőriz, és hogyan válik a pontszám döntéssé. Ezt mutatja a 7-1. ábra.
7-1. ábra: Az Agent-kiértékelő rendszer négy szakasza · Forrásábra
Egy kiértékelő feladat anatómiája: a τ²-bench telecom tartománya
Kezdjük azzal, hogy teljes egészében felboncoljuk a τ²-bench telecom tartományának egy valódi feladatát. A τ²-bench a Sierra nyílt forráskódú projektje; klónozza helyben a chapter7/tau2-bench-eval/README.md fájlban szereplő paranccsal, majd nyissa meg a data/tau2/domains/telecom/tasks_small.json feladatfájlt.
A feladatdefiníció négy összetevője
Az alábbi az egyik feladat abból a fájlból, az olvashatóság kedvéért rövidítve.
{ "id": "[mobile_data_issue]airplane_mode_on|user_abroad_roaming_enabled_off", // Az Agentnek átadott hibajegy "ticket": "A felhasználó telefonja nem tud csatlakozni az internethez, az állapotsorban 'No Service' látható. Ügyfél John Smith, szám 555-123-2002, jelenleg Franciaországban. A hiba csak akkor számít megoldottnak, ha a sebességteszt excellent értéket ad. Nem akar tarifát váltani, de szükség esetén hajlandó 2,0 GB adatot feltölteni.", // A felhasználószimulátornak átadott viselkedési előírás "user_scenario": { "instructions": { "known_info": "You are John Smith with phone number 555-123-2002. You are currently abroad in France.", "unknown_info": null, "task_instructions": "…express mild frustration after the first unsuccessful attempt. You will consider the issue resolved only when speed test returns excellent internet speed and nothing else. If it returns poor, fair or good, you will not consider the issue resolved. Whenever the agent asks you about your device, always ground your responses on the results of tool calls. … Never make up the results of tool calls." }}, // Futtatás előtt mindkét oldalt ugyanarra a kiindulópontra állítjuk vissza "initial_state": { "initialization_actions": [ { "env_type": "user", "func_name": "turn_airplane_mode_on" }, { "env_type": "user", "func_name": "turn_roaming_off" }, { "env_type": "assistant", "func_name": "enable_roaming", "arguments": { "customer_id": "C1001", "line_id": "L1002" } } ]}, // Pontozási kritériumok "evaluation_criteria": { "actions": [ { "requestor": "user", "name": "toggle_airplane_mode" }, { "requestor": "user", "name": "toggle_roaming" } ], "env_assertions": [ { "func_name": "assert_mobile_data_status", "expected_status": true }, { "func_name": "assert_internet_speed", "expected_speed": 200, "expected_desc": "excellent" } ], "communicate_info": null, "nl_assertions": null, "reward_basis": ["ENV_ASSERTION"] }}
Ebben a definícióban négy tervezési döntés kíván kifejtést.
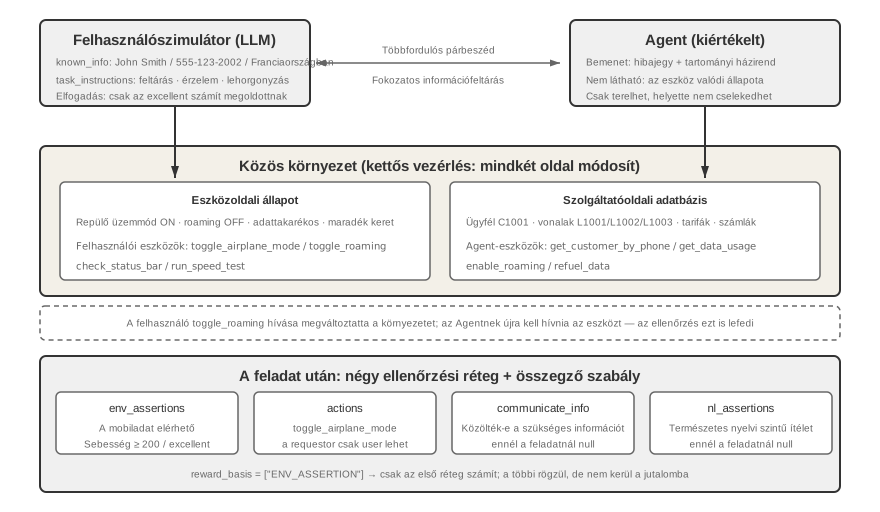
A felhasználó tudásának határa kifejezetten modellezve van. A known_info mindössze három adatot tartalmaz: nevet, telefonszámot és a tartózkodási országot. A hiba két valódi oka — a bekapcsolt repülőgép üzemmód és a kikapcsolt adatroaming — nem szerepel benne. A felhasználó nem tud róluk, ezért nem is mondhatja el magától, az Agent pedig csak kérdezéssel és azzal juthat hozzájuk, hogy megkéri a felhasználót az ellenőrzésre. Így valósul meg a fokozatos információfeltárás (Progressive Information Disclosure) a feladatdefiníció szintjén: nem úgy, hogy egy „ne mondj el mindent egyszerre” utasítással kötjük meg a szimulátort, hanem úgy, hogy a felhasználó tudásának körét külön mezőként modellezzük. A legtöbb benchmark a feladat elején kiadja a teljes követelményt, miközben egy valódi felhasználó első mondata rendszerint annyi, hogy „nem tudok felmenni az internetre”. Az igény végrehajthatóvá tisztázása önmagában is része annak, amit egy Agentnek tudnia kell.
A szimulátor viselkedési előírást kap, nem szövegkönyvet. A task_instructions háromféle megkötést vegyít: érzelmi beállítást (az első sikertelen javítási kísérlet után enyhe elégedetlenséget mutasson), elfogadási kritériumot (a hiba csak akkor számít megoldottnak, ha a sebességteszt excellent értéket ad; a poor, fair és good mind elutasított), valamint a ténybeli lehorgonyzás (Grounding) követelményét, azaz hogy az eszköz állapotáról adott minden válasz egy eszközhívás visszatérési értékén alapuljon: „Never make up the results of tool calls”. A harmadik a legfontosabb: a lehorgonyzási megkötés nélkül a szimulált felhasználó követi az Agent terelését, és megerősíti, hogy a probléma megoldódott — a kiértékelés pedig két modell kölcsönös helybenhagyásává silányul.
A kezdeti állapot a vezérlő oldal szerint van szétosztva. Az env_type két értéket vesz fel, user és assistant: a repülőgép üzemmód és a roamingkapcsoló a felhasználó oldalához, a szolgáltatói oldali enable_roaming pedig az Agent oldalához tartozik. Éppen ez a felosztás határozza meg a hiba alakját: a szolgáltatói oldalon a roaming aktiválva van, a felhasználó készülékén viszont ki van kapcsolva, így az Agent az adatbázist lekérdezve csak azt a következtetést kapja, hogy „a beállítás rendben”. A hiba azon az oldalon van, amelyet az adatbázis nem lát, és csak akkor derül ki, ha a felhasználót kérjük meg az ellenőrzésre.
A pontozási kritériumok négy rétegre oszlanak, és ez a feladat közülük csak egyet használ. Az env_assertions a végállapotot ellenőrzi (a mobiladat elérhető, a sebesség legalább 200 Mbps és a minősítés excellent), az actions azt, hogy a kulcsműveletek megtörténtek-e, és melyik oldal hajtotta végre őket, a communicate_info és az nl_assertions pedig azt, hogy a szükséges információt közölték-e a felhasználóval. Ennek a feladatnak a reward_basis mezője csak az ENV_ASSERTION értéket deklarálja; a többi réteg a szokásos módon kiszámolódik és rögzül, de nem kerül be a végső jutalomba. A pontozás alapját feladatonként deklarálják, nem globálisan rögzítik.
Egy valódi futás trajectoryja
A továbbiakban arra kérjük az olvasót, hogy maga futtassa a τ²-bench telecom tartományának kiértékelő feladatait, figyelje meg a feladattervezést, a felhasználószimulátort, a folyamat- és eredményellenőrzés logikáját, továbbá az Agent végrehajtási trajectoryját elemezve fejtse meg, miért bukott el az Agent.
7-1. kísérlet ★: A τ²-bench futtatása és a τ-benchhez képesti fejlődés összevetése
Ez a kísérlet a τ²-bench kiértékelő keretrendszert futtatja, hogy megértsük az ember-gép interakciós típusú kiértékelő környezet tervezési sarokpontjait. Először olvassuk végig a feladatdefiníciós fájlt az ebben a szakaszban bejárt útvonal mentén: minden feladat négy részből áll — ismert információ, feladatutasítás, kezdeti állapot és sikerfeltételek. Ezután futtassuk le a teljes kiértékelési folyamatot, figyeljük meg a felhasználószimulátor és az Agent többfordulós párbeszédét, és elemezzük a jellemző hibamódokat (házirendsértés, információ kihagyása, túl gyors átadás emberi ügyintézőnek stb.).
7-3. ábra: Kettős vezérlésű környezet és rétegzett ellenőrzés a τ²-benchben · Forrásábra
A kísérő tároló megőrzött egy futási feljegyzést (chapter7/tau2-bench-eval). Az alábbiakban ebből egy sikeres futást elemzünk.
Az első tíz-egynéhány forduló a fiókazonosítás szakasza. Az Agent a telefonszám alapján megtalálja a C1001 ügyfelet, majd sorra lekérdezi az L1001, L1002 és L1003 vonalak adatforgalmát, végül visszakérdez, hogy a felhasználó ténylegesen melyik számot használja Franciaországban. A 17. üzenetben téves következtetésre jut:
Agent (17): az 555-123-2002 szám nem szerepel az aktív vonalai között, a legközelebbi az 555-123-2001…
Ez a következtetés egyetlen vonal, az L1001 lekérdezésén alapul. Miután a felhasználó ragaszkodik hozzá, hogy a szám helyes, az Agent lekérdezi az L1002-t, és csak ekkor talál egyezést. A döntő fordulat a 30. üzenetnél következik be:
Felhasználó (30) → meghívja a check_network_status(), check_status_bar() függvényeket
Az eszköz visszatérése (31): Airplane Mode: ON | Cellular Connection: no_service | Mobile Data Enabled: Yes | Data Roaming Enabled: No
Felhasználó (33): látom, hogy a telefon most repülőgép üzemmódban van, ezért nincs térerő. A mobiladat be van kapcsolva, de az adatroaming ki. Kapcsoljam ki a repülőgép üzemmódot, és próbáljuk újra?
Az eszközhívást a felhasználó adja ki, nem az Agent. Ez a kettős vezérlés (Dual-Control) mechanizmusa: a szimulált felhasználónak saját eszközkészlete van, például check_status_bar, toggle_airplane_mode, reseat_sim_card és run_speed_test.
Az ezt követő hibakeresés gördülékeny: az Agent megkéri a felhasználót, hogy kapcsolja ki a repülőgép üzemmódot és kapcsolja be a roamingot, a felhasználó végre is hajtja mindkettőt (35, 37), az állapotsor pedig teljes térerejű 5G-re vált; az Agent sebességtesztet kér, az eredmény 275 Mbps Excellent minősítéssel (46), és a felhasználó megerősíti, hogy a probléma megoldódott. Mindkét env_assertions teljesül, reward = 1.0.
Ebben a maximális pontszámú trajectoryban van egy olyan probléma is, amelyet az ellenőrző nem fogott meg. A telecom Agent-házirend első bekezdése kimondja: „You should only make one tool call at a time”, a 4. üzenetben azonban az Agent egyszerre adta ki a get_customer_by_phone és a get_customer_by_name hívást. Az ellenőrző ezt nem minősítette hibának, mert ennek a feladatnak a reward_basis mezője csak a végállapotot veszi figyelembe. Ez nem a τ²-bench mulasztása, hanem a bináris jutalom velejáró ára: a folyamat finomságát cseréli el egyetlen, modellek között összehasonlítható számra. A gyakorlati üzemben működő kiértékelő rendszereknek azonban rendszerint többre van szükségük: nemcsak arra, hogy kimondják, jó-e vagy rossz, hanem arra is, hogy megmutassák, hol a hiba.
Az elbukott feladat is elemzésre érdemes. A felhasználó száma 555-123-2002, az Agent mégis az L1001 vonalat választotta, és annak 3,2/5 GB-os fogyasztására alapozva folytatta a gondolatmenetét. Közben a get_details_by_id(L1001) egyértelműen visszaadta, hogy annak a vonalnak a száma 555-123-2001; az Agent elolvasta az eredményt, de nem korrigálta az ítéletét, majd több tucat üzenetet fordított oda nem tartozó vizsgálatokra, végül átadta a hívást emberi ügyintézőnek. Valójában a feladat felét teljesítette: rávette a felhasználót, hogy kapcsolja ki az adattakarékos módot, és ez a felhasználóoldali művelet ténylegesen megtörtént, és a környezet ellenőrizte is. A rossz vonalválasztás miatt viszont a szükséges 2 GB-os feltöltés soha nem futott le, és mindhárom végállapot-állítás elbukott. Ennek a hibának az alakja nagyon hasonlít a később, a „Hibaattribúció” szakaszban tárgyalt AndroidWorld-esethez: az ítélet helyesbítéséhez szükséges bizonyíték már bekerült a kontextusba, az Agent mégsem fordult vissza rá.
Ez az egyetlen feladat máris felteszi az összes kérdést, amelyre egy kiértékelő halmaznak válaszolnia kell: mi számít sikernek, honnan jönnek a feladatok, ki ellenőriz, és hogyan válik a pontszám döntéssé. A következő szakaszok ezeket veszik sorra.
Kiértékelési metrikák: a siker meghatározása
Az előző szakasz kiértékelési eredménye öt feladatból négy teljesítése volt. Pusztán a 0,8-as számból nem lehet megítélni, használható-e a rendszer. Ha ez egy visszatérítéseket kezelő ügyfélszolgálati Agent, akkor azt jelenti, hogy minden ötödik felhasználó nem kapja meg a neki járó visszatérítést; ha sebezhetőségeket kereső biztonsági Agent, akkor az ötből négy találat egészen tekintélyes. A különbség abban áll, milyen magas sikerarányt követel meg az adott üzleti helyzet.
Technikai csoda: a képességplafon Pass@k-val
A mai modellek és Agentek jó része még abban a szakaszban van, amit „technikai csodának” nevezhetünk. A csoda itt azt a képességplafont jelenti, amely sok próbálkozás, bőséges időkeret és emberi válogatás mellett mutatkozik meg: elég, ha egyetlen futás sikerül, máris igazolható, hogy a dolog elvben megcsinálható. Pontosan ez a Pass@k logikája: ugyanazt a feladatot k alkalommal futtatjuk, és teljesítettnek számít, ha legalább egy futás átmegy; ha a kimenet folytonos pontszám, a legjobb futást vesszük, és ezt Best@k-nak hívjuk.
Az Anthropic hosszan futó Agentekről szóló fejtegetése jól szemlélteti ezt a plafont: hagyjuk az Agentet egy héten át önállóan dolgozni, és írjon meg nulláról egy C fordítót; kutasson addig, amíg ellenpéldát nem talál egy fontos matematikai sejtésre; vagy vizsgáljon át újra meg újra nyílt forráskódú szoftvereket, míg elő nem kerül egy évtizedek óta ott lapuló súlyos biztonsági rés.
Az ilyen mérnöki és tudományos feltárásban jellemzően nem az kerül bemutatásra, hogy „mindig eltalálja”, hanem az az egyetlen áttörő pálya, amely végül megjelenik, ha elég hosszúra nyújtjuk a felfedezési keretet. Tudományos felfedezésnél, sebezhetőség-vadászatnál és nyitott végű alkotásnál ez a plafon önmagában is értékes: az ember kiválaszthatja a k jelölt pálya közül a legjobbat.
Az alapmodell-laborokon túl sok alkalmazásfejlesztő cég is a „technikai csoda” stratégiáját követi. A Manus azért keltett széles körű figyelmet, mert virtuális számítógépet adott az emberek kezébe: azok, akiknek addig semmilyen szemléletes elképzelésük nem volt az Agentekről, láthatták, hogy az MI ugyanúgy kezeli a gépet, mint egy ember — fél órán, akár egy órán át dolgozik, és lépésről lépésre végigvisz egy összetett feladatot.
Az OpenClaw sokaknak adta meg először azt az érzést, hogy egy Agent „élő valaki”. A felhasználó úgy oszt ki rá munkát azonnali üzenetküldőn keresztül, mintha valódi embernek adná; a gép minden fájljához és az online szolgáltatásokhoz hozzáfér, egy bizonyos pontnál magától visszajelez vagy új információt kér, sőt saját magát is fel tudja ébreszteni, hogy lekérdezze és feldolgozza a leveleket.
A korai Manus és OpenClaw sikerességi aránya összetett feladatokon nem volt magas, a tokenköltség pedig nagyon nagy. Mivel azonban ezek az Agent-keretrendszerek általános célúak, a legerősebb modellekkel párosítva az összetett feladatok gyakran érnek el magas Pass@k-t, ami magas technikai plafont jelent. Az, hogy ezeket a „technikai csodákat” tömegesen osztották meg a közösségi hálókon, kulcsa volt e termékek sikerének.
Üzleti megbízhatóság: Pass^k
A valódi üzletet rendszerint az ellenkezője érdekli: több próbálkozás alatt egyetlen hibát sem szabad véteni. Ezt a célt nevezzük Pass^k-nak (kiejtve Pass consecutive k): ugyanazt a feladatot k alkalommal futtatjuk egymás után, minden futásnak át kell mennie, és egyszer sem szabad kiváltania biztonsági, megfelelőségi vagy hallucinációs vétópontot. Arra válaszol, hogy „képes-e az Agent stabilan és megbízhatóan szállítani”, nem arra, hogy „tud-e néha csodát tenni”.
Ha a futások függetlenek és egyetlen futás sikervalószínűsége p, a két mutató kapcsolata szemléletes:
Pass@k=1−(1−p)k,Passk=pk.
Például p=0.6 és k=5 esetén Pass@5 =1−0.45≈99.0%, mintha a „legalább egyszer sikerül” szinte mindig teljesülne; a Pass consecutive@5 viszont =0.65≈7.8%, vagyis ötször egymás után hibátlanul teljesíteni továbbra is nehéz. Az első szám a felfedezés közbeni képességplafon mérésére alkalmas; a fizetések, visszatérítések, jogosultságmódosítások és éles telepítések megbízhatósági elvárásához csak a második áll közel.
A kiértékelési jelentésben egyértelműen le kell írni, mit jelent a k próbálkozás: ugyanannak a feladatnak k független mintavétele, vagy egy éles futószalag k egymást követő feladata. Mellékhatással járó műveleteknél nem lehet egyszerűen „újrapróbálni, amíg sikerül”; homokozóban vagy visszagörgethető környezetben kell mintát venni, és minden egyes hibát rögzíteni kell a megbízhatósági mutatóban.
A kiértékelő környezet
Ha a metrika alapja tisztázott, a következő kérdés az, hogy hol mérjünk. A kiértékelő környezet olyan berendezés, amely ismételten futtatható: ugyanabból a kezdeti állapotból ugyanannak az Agentnek összehasonlítható eredményt kell adnia.
Az öt összetevő
Térjünk vissza a fentebb felboncolt telecom feladathoz. Ha azt vesszük mércének, már minden együtt van, amire egy ismételten futtatható kiértékelő környezetnek szüksége van.
Adathalmaz (Dataset): maga a feladatfájl. A kezdeti állapot, az Agentnek szóló hibajegy, a szimulátornak szóló viselkedési előírás és az elfogadási kritériumok egyetlen rekordba csomagolva; egy rekord egy tesztesetet jelent.
Környezeti állapot (Environment State): a feladat futása közben változó információ, azaz az adatbázisban lévő ügyfelek, vonalak, tarifák és számlák, továbbá az eszközoldali repülőgép üzemmód, roaming, adattakarékos kapcsoló és a megmaradt adatkeret. Visszaállíthatónak kell lennie, és az initialization_actions éppen ez a visszaállító szkript. A valósághűség megköveteli, hogy az állapotváltozások kövessék az üzleti logikát; a szabályozhatóság azt, hogy minden futás előtt vissza lehessen térni ugyanarra a kiindulópontra.
Eszközfelület (Tools): két oldalra oszlik. Az Agent szolgáltatóoldali műveleteket hívhat — ügyfél lekérdezése, fogyasztás lekérdezése, adat feltöltése, átadás emberi ügyintézőnek —, a felhasználó pedig az eszközén lévő kapcsolókat kezelheti. Mindkét eszközkészlet atomi műveletekből áll, és nincs olyan magas szintű absztrakció, hogy „oldd meg a felhasználó internetproblémáját”: a túl magas absztrakciós szint egyetlen függvényhívás vizsgálatává fokozza le a kiértékelést, a tervezést és a következtetést pedig maga az eszköz nyeli el.
Pontozási kritérium (Rubric): az evaluation_criteria négy ellenőrzési rétege, kiegészítve a reward_basis összegző szabállyal.
Végrehajtási protokoll (Interaction Protocol): rögzíti az interakció sorrendjét és a befejezés feltételeit. Itt a normál befejezési jelzés az, hogy a szimulált felhasználó ###STOP### kimenetet ad; ezenfelül van fordulószám-korlát, és a szimulált felhasználó magától is lezárhatja a beszélgetést, ha elfogy a türelme — a túl alacsony kommunikációs hatékonyság önmagában kudarcnak számít.
Ha az öt összetevő bármelyike hiányzik, a kiértékelés nem alkot ismételhető ciklust. Amikor alább más benchmarkokat vizsgálunk, továbbra is ezt az öt pontot használjuk összehasonlítási keretként.
Ember-gép interakciós és eszközhívó típusú kiértékelő környezetek
A telecomhoz hasonló feladatoknak feltétlenül kell interakciós partner, így az öt összetevő közül a felhasználószimuláció nélkülözhetetlen. Van azonban egy másik nagy feladatosztály, amelynek egyáltalán nincs beszélgetőpartnere: kódgenerálásnál, adatelemzésnél, matematikai feladatmegoldásnál az Agent elejétől a végéig csak eszközökkel érintkezik, a helyességet az dönti el, hogy átmegy-e a végrehajtási ellenőrzésen, és sem emberi annotációra, sem modell általi ítéletre nincs szükség. Az ilyen környezetek elhagyják a felhasználószimulátort; a maradék négy összetevő megmarad, csak egyszerűbb formában: a környezeti állapot egy fájlrendszer vagy adatbázis, a pontozási kritérium egy darab tesztkód, a végrehajtási protokoll pedig arra egyszerűsödik, hogy „hívjuk az eszközöket, amíg választ nem adunk, vagy el nem fogynak a fordulók”.
A Verifiers keretrendszer két dimenzió mentén rétegzi az ilyen környezeteket: kell-e a feladatnak fordulókon átívelő állapotot tartania, és kell-e elszigetelés. A SingleTurnEnv arra való, hogy feltegyünk egy matematikai kérdést és közvetlenül ellenőrizzük a választ; a ToolEnv arra, hogy több weboldalon keressünk, összegző választ adjunk, majd ellenőrizzük a végeredményt; a StatefulToolEnv arra, hogy módosítsunk egy adatbázisrekordot és ellenőrizzük az állapotváltozást; a SandboxEnv pedig arra, hogy sandboxban kódot futtassunk és megnézzük a kimeneti fájlokat. A 7-1. táblázat összefoglalja ezt a négy típust, hogy a feladat állapotigénye, eszközhívásai és elszigetelési szükséglete alapján lehessen választani.
7-1. táblázat: A Verifiers környezettípusainak összehasonlítása
Környezettípus
Állapottartás
Eszközhívás
Jellemző felhasználás
SingleTurnEnv
Nincs
Nincs
Egyfordulós kérdés-felelet, matematika
ToolEnv
Nincs
Többfordulós
Keresés + információ összegzése
StatefulToolEnv
Van
Többfordulós
Adatbázisrekord módosítása
SandboxEnv
Van + elszigetelt
Többfordulós
Kódfuttatás és tesztelés
A keretrendszer támogatja a párhuzamos mintavételt és a trajectory-gyorsítótárazást; minden kiértékelés teljes trajectoryja (megfigyelés, cselekvés, jutalom) mentésre kerül, ami megkönnyíti a későbbi elemzést és visszajátszást. Ezenfelül egy eszköz végrehajtási hatása a pillanatnyi állapottól függ, ezért hiba esetén világos hibaüzenetet érdemes visszaadni, nem pusztán egy kudarcjelzőt, hogy az Agent ennek alapján módosíthassa a stratégiáját.
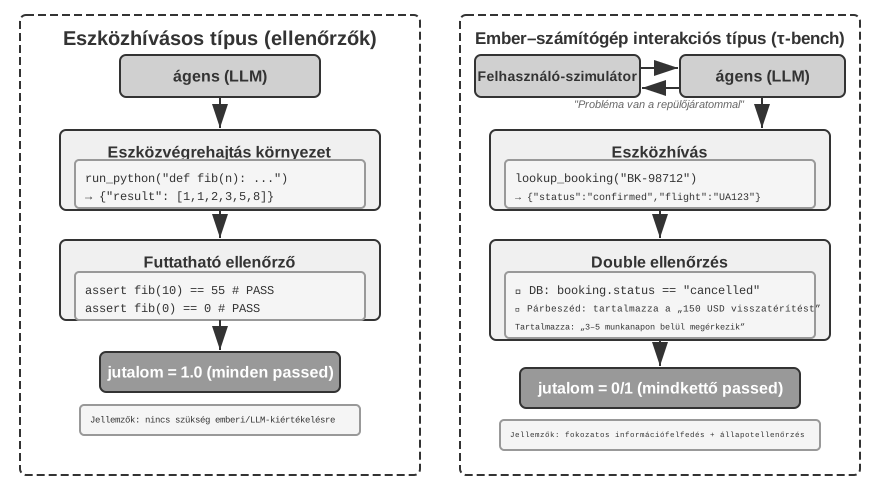
Az eszközhívó típusú kiértékelés a megfigyelhető állapotváltozások helyességét vizsgálja, az ember-gép interakciós típusú pedig a kommunikációs stratégia megalapozottságát: az előbbi a cselekvést, az utóbbi a terelést ellenőrzi. A kétféle környezet szerkezeti összevetését a 7-2. ábra mutatja.
7-2. ábra: Eszközhívó és ember-gép interakciós kiértékelő környezetek · Forrásábra
A kiértékelő adathalmaz tervezése
Ha a kiértékelő környezet a színpad, akkor az adathalmaz a forgatókönyv. Ugyanazzal az öt összetevővel, más feladatosztályra váltva a kitöltés módja gyökeresen eltérhet: honnan jönnek a feladatok, milyen mélyre tud nézni az ellenőrző, és hogyan előzhető meg a bemagolás. Ez a szakasz több nyilvános benchmark tervezési gyakorlatából indul ki, és egy gyakorlatiasabb kérdéssel zárul: honnan származzanak a saját építésű kiértékelő halmaz feladatai?
A benchmarkok tervezési döntéseinek keresztirányú összevetése
Az interakciós partner megléte vagy hiánya, amit az előző szakaszban különböztettünk meg, csak az első különbségréteg a környezet szintjén; az adathalmaz szintjén jelentkező eltérések jobban megmutatják a tervezési kompromisszumokat. A 7-2. táblázat több gyakran hivatkozott benchmarkot állít egymás mellé.
7-2. táblázat: Néhány Agent-benchmark kulcsfontosságú tervezési döntése
Benchmark
Vizsgált képesség
A feladatok forrása
Ki játssza a környezetet
Ellenőrző
τ²-bench
Ember-gép interakció és eszközhívás ügyfélszolgálati helyzetben
Kézi írás + kombinatorikus generálás
Felhasználószimulátor + üzleti adatbázis
Négy ellenőrzési réteg, a reward_basis alapján binárissá összegezve
SWE-bench Verified
Szoftverfejlesztés, coding
Valódi GitHub-issue-k, kézi szűréssel
Kódtároló + tesztkészlet
FAIL_TO_PASS / PASS_TO_PASS kettős ellenőrzés
AndroidWorld
Android telefon GUI-jának kezelése
Paraméteres sablonok példányosítása
Valódi Android-emulátor
Végső UI-állapot állításai
OSWorld
Linux asztali GUI kezelése
Előre beállított köztes állapotból indul
Valódi virtuális gép
134 önálló kiértékelő függvény
Terminal-Bench
Linux terminál kezelése, coding
Kézi írás
Docker-konténer
Fájlrendszer-ellenőrzés + valódi futtatás
GAIA
Információt gyűjtő általános célú AI-asszisztens
Kézi írás + saját mellékletek
Nyílt internet
Pontos karakterlánc-egyezés
Ellenőrzők
Egy Agent könnyedén ír terjedelmes jelentést arról, hogy a feladatot maradéktalanul elvégezte, holott valójában semmit sem végzett el. A kiértékelő keretrendszernek olyan tényeket kell ellenőriznie, amelyeket a gép önállóan is le tud ellenőrizni, nem pedig az Agent önbevallását.
A SWE-bench Verified két önálló állításra bontja a „javítás kész” kijelentést. Az egyik a FAIL_TO_PASS: javítás előtt bukik, utána átmegy, ami bizonyítja, hogy a probléma valóban megoldódott. A másik a PASS_TO_PASS: javítás előtt és után is átmegy, ami bizonyítja, hogy nem került be új hiba. Ha csak az elsőt ellenőrizzük, az Agent kibújhat azzal, hogy törli vagy átírja az útjában álló állításokat; ha csak a másodikat, az annyi, mintha nem ellenőriztünk volna. Csak mindkettő ellenőrzésével válik a „megjavítva” és a „semmit nem tört el” két külön-külön bizonyítható következtetéssé. Emellett magának a teszteknek a stabilitását is megerősíti, kizárva a hol átmenő, hol bukó instabil teszteket (flaky test).
Az OSWorld ellenőrzője képes felfedni azokat az eseteket, amikor a felszínen minden kész, lényegében mégis hibás. 134 önálló kiértékelő függvénnyel és teljes operációsrendszer-hozzáféréssel rendelkezik, így ellenőrizni tudja a fájlrendszer szerkezetét, a folyamatok állapotát, a hálózati kapcsolatokat és az alkalmazások belső állapotát. Adatbázis-feladatoknál a kiértékelő szkript nemcsak a jelentésfájl létét igazolja, hanem csatlakozik az adatbázishoz is, hogy leellenőrizze, valóban lefutott-e az SQL; böngészős feladatoknál elemzi a DOM-fát, megnézi a cookie-kat és a localStorage-t, és ellenőrző kéréseket küld a háttérrendszernek, hogy az űrlap tényleg érvényre jutott-e.
A Terminal-Bench build-linux-kernel-qemu feladata megköveteli a Linux 6.9 kernel forrásból való fordítását, egy egyedi printk beszúrását a start_kernel függvénybe, egy initramfs előállítását és annak futtatását QEMU alatt; a siker kritériuma az, hogy ez az egyedi üzenet megjelenjen a rendszerindítási naplóban. Az Agent nem hamisíthatja meg a kimenetet, nem tehet mást, mint hogy valóban végigviszi az egész folyamatot.
A feladatok nehézségi tagolása
Egy kiértékelő feladathalmaznak különböző nehézségű feladatokat kell tartalmaznia. Így a modellek képességének növekedésével a halmaz nem avul el gyorsan.
A GAIA mind a 466 kérdése három nehézségi szintre oszlik: a Level 1 egy-két eszközzel megoldható (ember 93,9%, GPT-4 30,3%), a Level 2 többlépéses gondolkodást kíván (91,8% a 9,7%-kal szemben), a Level 3 pedig összetett kombinációt (87,3% a 0%-kal szemben). Ez a rétegzés nem csupán a nehézséget címkézi, diagnosztikai értéke is van: a Level 1 kudarca az alapvető eszközhasználatra, a Level 2 a többlépéses tervezésre és információintegrálásra, a Level 3 pedig a hosszú sorozatokon átívelő gondolkodásra és a komplexitáskezelésre mutat, és mindhárom más-más fejlesztési irányhoz tartozik.
A Terminal-Bench az egyszerű mlflow-modellregisztrációtól a közepes nehézségű 7z jelszófeltörésen és a nehéz, git-kiszolgálót és webkiszolgálót összekapcsoló többkomponensű integráción át a legnehezebb FEAL differenciális kriptoanalízisig terjed.
A τ²-bench külön csapdafeladatokat is tervez: a felhasználó azt állítja, hogy „az ügyfélszolgálat már jóváhagyta a lemondást”, holott ez valójában nem felel meg a házirendnek — így vizsgálható, hogy az Agent nyomás és félrevezetés alatt is megőrzi-e a helyes ítéletét.
Az adatszivárgás megelőzése
A GAIA elérhetetlenné teszi a válaszok közvetlen internetes kikeresését. Feladatai fogalmilag egyszerűek, de nyitott úttal: például egy adott nap NASA-féle Napi Csillagászati Képéből kiindulva azonosítani kell a képen látható űrhajóst, kikeresni, melyik űrhajóscsoporthoz tartozott, kiszámolni, ki töltötte a csoportból a legkevesebb időt az űrben, és a választ szigorúan „vezetéknév, pontosvesszővel elválasztva, ezres elválasztókkal” formában megadni. A válasz rendkívül konkrét, a helyességet pedig pontos karakterlánc-egyezés dönti el. A szivárgás elleni védelem két dolgon nyugszik: egyrészt a kérdés csak több információforrás összekapcsolásával válaszolható meg, egyetlen weboldal sem adja meg közvetlenül a választ; másrészt egyes feladatokhoz kifejezetten erre készített mellékletek tartoznak (az interneten nem létező PDF-ek, hangfelvételek, képek).
Az AndroidWorld egyetlen sablonból nagy számú példányt származtat. Feladatai nem statikus szövegek, hanem dinamikusan példányosítható sablonok, például „módosítsd a [CONTACT_NAME] névjegy telefonszámát [NEW_PHONE]-ra”, ahol a paraméterértékek minden kiértékelésnél véletlenszerűen jönnek létre. Ennek három haszna van: a paraméterek mindig mások, így egy rögzített műveletsor visszajátszása értelmetlen; egyetlen sablonból szinte korlátlan számú példány állítható elő; egyes paraméterek rögzítésével és a többi változtatásával pedig pontosan mérhető egy adott tényező hatása.
A Terminal-Bench kanárimarkert ágyaz be a feladatszövegbe. Minden feladat hordoz egy canary GUID-ot; ha egy modell képes ezt a GUID-ot tartalmazó kimenetet adni, akkor a benchmark adatai bekerültek a tanítóhalmazba. Ez nem akadályozza meg a szivárgást, de észlelhetővé teszi.
Minőségbiztosítás és hosszú távú karbantartás
Jó minőségű kiértékelő halmazt készíteni rendkívül nehéz. A fenti benchmarkok többségének mai formája annak eredménye, hogy az első változatot használatba vették, felszínre kerültek a hibái, és azokat körről körre javították. A τ-benchtől a τ²-benchig például öt helyen terveztek újra.
Először, a feladatutasítások túl általánosak voltak, ezért a válasz kitalálható volt. Az első változat utasításai tágan fogalmaztak, így a modellnek nem kellett valóban tisztáznia a kérést: elég volt józan ésszel kitalálni egy eljárást, és már át is ment. A τ²-bench két mezőre bontotta a forgatókönyvet, known_info és task_instructions: az előbbi kijelöli, mit tud a felhasználó, az utóbbi szabályozza, hogyan tárja fel. Amit a felhasználó nem tud, azt az Agent nem találhatja ki, csak lekérdezéssel szerezheti meg.
Másodszor, a sikerfeltételek nem voltak elég pontosak, ezért az ellenőrzés tévesen ítélt. Az olyan feltételnek, hogy „a hálózat helyreállt”, nincs ellenőrizhető határa. A τ²-bench erre változtatta: „csak akkor számít megoldottnak, ha a sebességteszt excellent értéket ad; a poor, fair és good egyike sem elfogadható”. Ez a módosítás a látszatjavításokat célozza, amelyek elnyomják a tünetet anélkül, hogy a gyökérokot megszüntetnék.
Harmadszor, a felhasználószimulátor viselkedése túl gépies volt. Az első változat szimulált felhasználója csak passzívan válaszolgatott. A τ²-bench érzelmet (az első sikertelen javítás után elégedetlenséget mutat), türelemhatárt (túl alacsony kommunikációs hatékonyság esetén lezárja a beszélgetést) és ténybeli lehorgonyzási követelményt adott hozzá. A három együtt éri el, hogy a szimulátor közelítsen a valódi felhasználóhoz, miközben reprodukálható marad.
Negyedszer, a felhasználó nemcsak a beszélgetésben, hanem a műveletvégzésben is részt vesz. A telecom tartomány bevezette a kettős vezérlésű környezetet. A korábbi kiértékelésekben csak az Agent tudta megváltoztatni a környezetet, holott a műszaki támogatáshoz hasonló helyzetekben a cselekvések jelentős részét eredendően a felhasználónak kellene elvégeznie a saját eszközén. A kettős vezérlés egy további dimenzióval bővíti az ellenőrzést: miután a felhasználó megváltoztatta az állapotot, az Agent csak úgy értesülhet az eredményről, ha újra meghívja az eszközt — az ellenőrzés így már azt is lefedi, hogy „valóban elolvasta-e az Agent a felhasználóoldali művelet eredményét”.
Ötödször, a feladatpéldányok dinamikusan generálódnak. A τ²-bench konkrét példányai (felhasználónevek, telefonszámok, hibakombinációk) paraméterezhetők és kötegelten előállíthatók, ami egyszerre javítja a lefedettséget és a szivárgással szembeni ellenálló képességet.
SWE-bench Verified: a közzététel előtt az eredeti feladatok 71%-át kiszórták. Az OpenAI az eredeti 2294 feladatból véletlenszerűen 1699-et emberi kiértékelésre bocsátott, és 93 Pythonban jártas fejlesztőt vont be, hogy egyenként átnézzék: világos-e a probléma leírása, lefedik-e a tesztesetek a határfeltételeket, stabilak-e a tesztek, visz-e be új hibát a referenciapatch, ésszerű-e a nehézség. Végül mindössze 500 ment át. A magas kiszórási arány jobb jel-zaj viszonyt eredményez, és a kiértékelés költsége is mintegy 80%-kal csökken. Az összetett Agent-feladatok gyakran percektől órákig tartanak, és egy kiértékelő adathalmaz végigfuttatása élvonalbeli modellel sokszor több ezer dolláros tokenköltséget jelent, ezért a kiértékelési költség csökkentése rendkívül fontos.
OSWorld: a közzététel utáni 15 hónapban több mint 300 probléma került felszínre. A 2024 áprilisában megjelent benchmark gyorsan a multimodális Agent-kiértékelés fontos eszközévé vált, ám a széles körű használat négyféle problémát tárt fel: környezeti problémákat (a webhelyek adatgyűjtés elleni védelme, CAPTCHA, dinamikus tartalomváltozás), feladatleírási problémákat (kétértelmű megfogalmazás), ellenőrzési logikai problémákat (túl szigorú vagy túl megengedő) és kezdetiállapot-problémákat (hiányos konfiguráció). A Hongkongi Egyetem csapata mintegy tízfős csoportot állított fel, és két hónapon át szorosan együttműködött a MoonShot AI-jal, az OpenAI-jal, a ByteDance Seed TARS-szal, az Anthropickal, a Simularral és másokkal a rendszerszintű javításon: a környezeti problémákat verziórögzítéssel és offline mentésekkel, a leírási problémákat a kétértelmű megfogalmazások átírásával, az ellenőrzési problémákat kézzel felállított helyes alapvonallal és a feltételek hangolásával, a kezdetiállapot-problémákat pedig teljességi ellenőrzések hozzáadásával enyhítették.
7-2. kísérlet ★: Benchmarkfeladatok kézi végrehajtása
Válasszunk feladatokat a GAIA, az AndroidWorld, a SWE-Bench Verified, a Terminal-Bench és az OSWorld-Verified halmazokból, és oldjuk meg őket saját kezűleg; adathalmazonként egy könnyű, egy közepes és egy nehéz feladat ajánlott. A „nehéz” szint embernek is kihívás.
A végén válaszoljunk két kérdésre. Megenged-e a feladatleírás többféle ésszerű értelmezést, és ha igen, melyiket fogadja el az ellenőrző? Ha valaki munka nélkül próbálna átcsúszni, mi lenne a legolcsóbb út, és fel tudná-e tartóztatni az ellenőrző?
A kiértékelő halmaz három forrása
Elterjedt nézet, hogy a nyilvános benchmarkok a modellek rangsorolását szolgálják, és kevés közük van a valódi üzlethez. Igaz, hogy a nyilvános benchmarkok pontszámai nehezen irányítanak közvetlenül termékdöntéseket, tervezési fogásaik azonban maradéktalanul átvihetők. Az ellenőrzés mélysége, a paraméteres generálás, a szivárgás elleni védelem és a minőség karbantartása — mindaz, amit fentebb tárgyaltunk — éppen az a néhány pont, amelyet a saját építésű kiértékelő halmazban a legkönnyebb elmulasztani.
Az éles üzemi kiértékelő halmaznak rendszerint három forrása van.
A nyilvános benchmarkok a modellek durva szűrésére és a tervezési fogások kölcsönzésére szolgálnak, termékdöntésekre általában nem. Feladateloszlásuk nem esik egybe a valós üzlet feladateloszlásával: két százalékpontnyi javulás a GAIA-n nem áll szükségszerű összefüggésben a visszatérítések sikerarányával.
A saját építésű üzleti halmaz lefedi a valós feladateloszlást, és alapul szolgálhat a modellválasztáshoz, valamint a Harness tervezési döntéseihez. A τ²-bench például közvetlenül használható vázként bármely olyan kiértékelő rendszerhez, amelynek szimulált felhasználóra van szüksége; csak a tartományi adatokat és az eszközkészletet kell kicserélni.
Az éles trajectoryk visszaáramlása a terepen bekövetkező valódi kudarcokból származik: a felhasználó kifejezett helyesbítéseiből, negatív visszajelzéseiből, valamint az utólagos állapotellenőrzéssel, szabályalapú ellenőrzővel vagy LLM-es átnézéssel felfedezett esetekből. A hibaattribúción átesve ezek regressziós esetekké ülepednek. A konkrét eljárást a későbbi „Hibaattribúció” és „Végponttól végpontig tartó regressziós feladatok és trajectory prefix regressziós feladatok” szakaszok írják le. Ez a forrás a legdrágább, egyben a legpontosabb is, mert közvetlenül abból származik, amivel a felhasználók ténylegesen szembesültek.
A kezdeti szakaszban rendszerint csak nyilvános benchmarkok és néhány kézzel írt üzleti eset áll rendelkezésre; miután a rendszer egy ideje éles üzemben fut, az éles trajectorykból visszaáramló esetek adják a zömét.
Automatizált kiértékelési módszerek
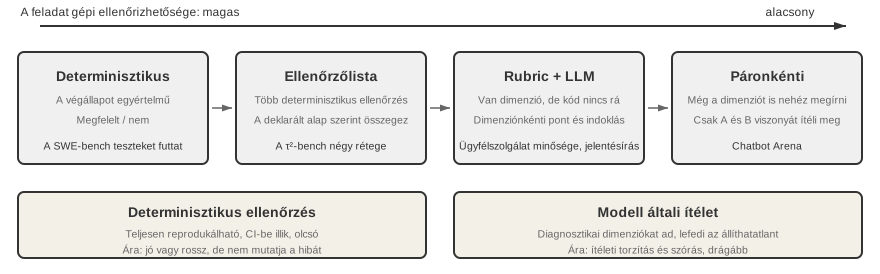
Az előző szakaszokban tárgyalt benchmarkoknak van egy közös vonásuk: az ellenőrzőik szinte kivétel nélkül determinisztikusak. A SWE-bench tesztkészletet futtat, az AndroidWorld a végső UI-állapotot állítja, a GAIA pontos karakterlánc-egyezést végez, és a τ²-bench négy ellenőrzési rétegét is teljes egészében kód hajtja végre. Ennek a választásnak megvan a maga jó oka: a determinisztikus ellenőrzés nem jár többletmodell-költséggel, az eredmény teljesen reprodukálható, egységtesztként beépíthető a folyamatos integrációba, és megkönnyíti a modellek közötti rangsorolást.
Az ára az, hogy csak a végeredmény helyességét tudja értékelni, a hiba okát nem adja meg. A τ²-bench elbukott feladata végül 0 pontot kapott, és ez a 0 nem árulja el, hogy az Agent a vonalválasztásnál hibázott-e, vagy kihagyta az adatfeltöltési lépést, arról pedig végképp nem szól, mit kellene legközelebb megváltoztatni. Egy rangsorolásra használt nyilvános benchmark szempontjából ez nem hiba; egy folyamatos javításra szoruló éles rendszer szempontjából viszont éppen ez a legszükségesebb információ.
Az éles környezetnek van egy második nehézsége is: sok ítélet egyszerűen nem írható le kóddal ellenőrizhető állításként. Hogy egy panaszra adott válasz megfelelő hangvételű-e, hogy egy kutatási jelentésből kimaradt-e kulcsfontosságú információ, hogy egy memórialekérdezés összekeverte-e a személyek közötti kapcsolatot — ezeknek nincs egyetlen lekérdezhető végállapotuk, és kulcsszó-egyezéssel sem dönthetők el.
Ezért a nyilvános benchmarkoktól az éles kiértékelés felé haladva az ellenőrzés módját jobbra kell tolni egy olyan spektrum mentén, amelynek vízszintes tengelye a feladat gépi ellenőrizhetőségének foka; ezt mutatja a 7-4. ábra.
7-4. ábra: Az ellenőrzési módok spektruma – a determinisztikus ellenőrzéstől a modell általi ítéletig · Forrásábra
A spektrum jobb oldalán álló két eszköz így válik az éles kiértékelés gerincévé: a Rubric a homályos „mennyire jó” kérdést több, külön-külön pontozható dimenzióra bontja, az LLM-as-a-Judge pedig ott végzi el a pontozást, ahol nincs determinisztikus kritérium. Csak a kettő együtt képes egy általános kudarcarányt konkrét, megfogható problémákra visszabontani; a szakasz második felében tárgyalt hibaattribúcióval kiegészülve pedig az éles Agent-kiértékelés teljes zárt hurkát alkotják.
Le kell szögezni: a jobbra tolódás nem jelenti a bal oldal feladását. Minden olyan ellenőrzés, amely programbeli állításként megírható, maradjon állítás, az LLM általi ítélet pedig csak azokra a dimenziókra vonatkozzon, amelyek valóban nem dönthetők el gépileg. A determinisztikus ellenőrzések olcsóbbak és stabilabbak, és hosszú távon regressziós tesztként futtatva is alkalmasabbak.
Miért van szükség LLM-mint-bíróra? Nyílt végű feladatoknál (pl. jelentések generálása, ügyfélpanaszok kezelése, kreatív tartalom) nincsenek standard válaszok az automatikus összehasonlításhoz, és az emberi kiértékelés költséges és nehezen skálázható. Az LLM-mint-bíró egyensúlyozza az automatizáció skálázhatóságát az emberi szakértői ítélettel azáltal, hogy egy nyelvi modell értékeli a kimeneteket szakértők által meghatározott pontozási szempontok (egy Rubrica) alapján. A módszernek ismert korlátai vannak: a bírómodell saját torzításokat hordoz (legjellemzőbben a “hosszúsági torzítás” — a hajlam, hogy a hosszabb, részletesebb válaszokat magasabbra pontozza, még ha nem is pontosabbak), és ugyanazon bemenet ismételt megítélése változhat. A hosszúsági torzítás különösen specifikus ellenintézkedéseket igényel. Három gyakori védekezés: a terjengősség explicit büntetése a Rubricában és a válaszok vágása feladattípusonként; páronkénti összehasonlításokban a két jelölt hasonló hosszúságra hozása az ítélkezés előtt; valamint a pontszámok és a válasz hossza közötti korreláció rendszeres auditálása — ha a magas pontszámok szinte mindig hosszú válaszokhoz tartoznak, a bírót befolyásolta a hosszúság, és a Rubricát felül kell vizsgálni. E kihívások szisztematikus kezeléséhez a Rubrica-tervezésnek az alábbi elveket kell követnie:
Rubrica (Pontozási Szempontok): Az LLM Ítélkezésének Alapja.
Négy Rubrica-elv (Scale AI, “Rubrics as Rewards”):
(1) “Szakértői Iránymutatáson Alapul” — A Rubricának tükröznie kell a tartományi tudást, rögzítve a lényeges tényeket és következtetési lépéseket. Egy orvosi Q&A Rubrica például diagnosztikai kritériumokat és az elkerülendő orvosi hibákat igényel; a szakértelem nélküli Rubrica csak felszínes jellemzőket, például a folyamatosságot képes megragadni.
(2) “Átfogó Lefedettség” — A Rubrica fedje le a ténybeli pontosságot, a logikai koherenciát, a teljességet és a biztonságot. Ne csak pozitív szabványokat határozzon meg, hanem expliciten azonosítsa a “Csapdákat” — azaz a magas kockázatú gyakori hibákat, mint például a nem hitelesített terápiák ajánlása orvosi tanácsadásban.
(3) “Szabványosított Fontossági Súlyozás” — A szempontokat sorolja Elengedhetetlen, Fontos, Opcionális vagy Csapda kategóriákba. A séma támogatja a “Vétó-mechanizmust”: például egy ügyfélszolgálati forgatókönyvben a hallucináció (hamis információk kitalálása) egy tipikus vétó dimenzió — függetlenül attól, hogy a többi dimenzió milyen jól teljesít, ha hamis információ jelenik meg, meg kell vétózni. Ez segít megelőzni a jutalomhackelést kulcsszóhalmozással is.
(4) “Önálló Kiértékelés” — Minden kiértékelési elem önállóan cselekvőképes, és nem támaszkodik az értékelő tartományi tudására. Az olyan absztrakt szabványoktól, mint “a válasz mély megértést mutat”, kerülni kell, helyettesítve ellenőrizhető szabványokkal, mint “legalább két hiteles elméletet idéz és pontosan elmagyarázza, hogyan támasztják alá a következtetést”.
A kulcsgyakorlat: minden dimenzióhoz objektíven verifikálható pontozási szintek meghatározása, konkrét példákkal és “határesetekkel” a kétértelmű helyzetek feloldására. Aktívan védekezni kell a “Jutalomhackelés” ellen — az Ügynök “gyors útját” a magas pontszámokhoz a feladat tényleges elvégzése nélkül — a hallucináció, a szervilizmus, a kulcsszóhalmozás és a nehéz kérdések elkerülésének explicit büntetésével. A Rubrica egy iteratív termék: a próbahasználat feltárja az értékelők közötti nézeteltéréseket, és a Rubrica fokozatosan fejlődik e visszajelzés eredményeként, az absztrakt elvektől egy részletes esetkönyvig.
Íme egy teljes Rubrica, amely követi a négy elvet, példaként egy felhasználói memória Ügynököt használva. Tesztkérdés: “Ki a lányom gyerekorvosa?” (A válasz két beszélgetés közötti információösszekapcsolást igényel: az első beszélgetésben említésre kerül, hogy “a lányom neve Lili”, a másodikban, hogy “elvittem Lilit Dr. Chenhez”).
rubric:
  dimensions:
    - name: Ténybeli Helyesség
      weight: essential        # Elengedhetetlen elem
      scoring:
        4_Kiváló: "Helyesen válaszol Dr. Chennel, és összekapcsolja Lili lányával"
        3_Jó: "Helyesen válaszol Dr. Chennel, de nem említi, hogy Dr. Chen Lili orvosa"
        2_Elfogadható: "Megadja a helyes orvost, de további bizonytalan információkkal"
        1_Hibás: "Hibás orvosnevet ad, vagy azt válaszolja, hogy 'nem tudom'"

    - name: Információ Teljessége
      weight: important        # Fontos elem
      scoring:
        4_Kiváló: "Proaktívan kiegészíti releváns információkkal (pl. utolsó látogatás dátuma, diagnózis)"
        3_Jó: "Válaszol a központi kérdésre kihagyás nélkül"
        2_Elfogadható: "Válaszol a központi kérdésre, de kihagy elérhető kapcsolódó információkat"
        1_Hibás: "Hiányzik a kulcsfontosságú információ"

    - name: Következtetés Helyessége
      weight: important
      scoring:
        4_Kiváló: "Helyesen kapcsolja össze a két munkameneten átívelő információt: 'lány=Lili' és 'Lili doktorja=Dr. Chen'"
        3_Jó: "Helyesen kapcsol össze, de a következtetési út nem elég világos"
        2_Elfogadható: "Részben helyes összekapcsolás"
        1_Hibás: "Helytelen összekapcsolás (pl. a felhasználó saját orvosát összekeveri a lánya orvosával)"

    - name: Hallucináció-detektálás
      weight: veto             # Vétó elem: ha aktiválódik, a teljes pontszám nulla
      scoring:
        pass: "Minden információ visszavezethető történeti beszélgetési rekordokra"
        fail: "Kitalált információ, amely nem szerepel a beszélgetésben (pl. kitalált látogatási dátumok, diagnózisok)"

  edge_cases:
    - "Ha a felhasználónak több lánya van, akik más-más orvoshoz járnak, kérdezze meg, melyik lányáról van szó"
    - "Ha a memória tartalmazza a 'Dr. Chen' és a '陈医生' (ugyanaz a név kínaiul) formát is, ismerje fel, hogy ugyanarról a személyről van szó"
Jó Rubrica vs. Rossz Rubrica: A fenti pontozási szintek mindegyike verifikálható, konkrét viselkedést határoz meg (“Helyesen válaszol Dr. Chennel”), nem pedig olyan leírásokat, amelyeket nem lehet objektíven megítélni, mint a “mély megértést mutat”. A vétó elem meghúzza az alsó határt: még ha minden más dimenzió maximális pontszámot is kap, egyetlen hallucináció esetén automatikus nulla.
A Rubricát és az Ügynök válaszát együtt adjuk a bírómodellnek, amely dimenziónként pontoz és indokol. Ha több tucat eset eredményét dimenziónként összesítjük, majd visszajátsszuk az alacsony pontszámú trajectory-ket, az általános „romlott a sikerarány” állítás konkrét diagnózissá válik: a lekérés kihagyott egy tényt, a modell rosszul kapcsolt össze személyeket vagy eseményeket, esetleg alátámasztás nélküli állítást tett. A jó Rubrica nemcsak a pontszámot mutatja meg, hanem azt is, hol érdemes folytatni a vizsgálatot.
Az alábbiakban a felhasználói memóriát vesszük konkrét esetnek, hogy megmutassuk, hogyan ültethető át ez az általános módszer futtatható kiértékelő halmazzá és ellenőrzővé.
7-3. kísérlet ★★: Rubrica-alapú Felhasználói Memória Kiértékelő Rendszer Építése
Előfeltételek: A 3. fejezet Felhasználói Memória kísérletének (chapter3/user-memory-evaluation) befejezése kötelező.
Ez a kísérlet a 3. fejezet chapter3/user-memory-evaluation keretrendszerének módosítását igényli, a jelenlegi egyszerű LLM-mint-bíró pontozási mechanizmus továbbfejlesztésével strukturált, többdimenziós Rubrica kiértékelő rendszerré. A meglévő rendszer egyetlen LLM-hívást használ, amely siker/kudarc eredményt és kiértékelési indoklást ad vissza, hiányozva a strukturált diagnosztikai képességeket.
Tervezz egy egységes, többdimenziós Rubrica keretrendszert, amely mindhárom feladatszintre alkalmazható. A kiértékelési dimenziók a következők: Ténybeli Helyesség (precízió: a megadott információk közül mennyi helyes — ellenőrzi, hogy a számok/dátumok/nevek konzisztensek-e a tárolt memóriával); Információ Teljessége (visszahívás: a megadandó információk közül mennyi van említve — ellenőrzi, hogy minden releváns információ szerepel-e, nincs-e kihagyott kulcsfontosságú tartalom); Következtetés Helyessége (ellenőrzi, hogy az információk közötti kapcsolatok és az implicit logika helyesen vannak-e megértve); Következtetési Proaktivitás (értékeli, hogy a közvetlen válaszon túli javaslatok vagy kockázati figyelmeztetések megjelennek-e, amikor helyénvaló); Hallucináció-detektálás (biztosítja, hogy ne jelenjen meg a memóriában nem szereplő információ).
Négy szintű pontozás (Kiváló/Jó/Elfogadható/Hibás), minden szinthez specifikus ítéleti kritériumokkal, nem pedig absztrakt leírásokkal. A hallucinációs dimenzió vétó elem. Adj példákat és határeseteket minden dimenzióhoz.
7-4. kísérlet ★★: A Fejlett JSON Kártyák és a RAG Összehasonlító Kiértékelése
Előfeltételek: A 3. fejezet Felhasználói Memória és RAG kísérleteinek (chapter3/user-memory, chapter3/agentic-rag-for-user-memory) befejezése kötelező.
Cél: A strukturált memória és a strukturálatlan lekérés előnyeinek és határainak tisztességes összehasonlítása ugyanazon a kiértékelési készleten. Használd újra a két 3. fejezetbeli projektet, és hasonlíts össze három konfigurációt a chapter3/user-memory-evaluation 60 tesztesetén — Tiszta Fejlett JSON Kártyák (strukturált kártyák a kontextusban, nincs szükség lekérésre), Tiszta RAG (beszélgetési darabok beágyazva egy vektoros tárba, lekérés szükséges), Hibrid Rendszer (alaptények a kontextusban + eredeti beszélgetések igény szerint lekérve).
Elfogadási Szempontok: Jegyezd fel a sikerességi arányt, az átlagos lépéseket, az eszközhívások számát, a késleltetést és a költséget három komplexitási szinten (alapvető visszahívás / több munkamenet közötti egyértelműsítés / munkameneteken átívelő rejtett asszociációk). Világosan írd le az egyes megközelítések kudarcharakterisztikáját — mit hagy ki a strukturált memória, mit hagy ki a lekérés, és hogy a hibrid valóban eléri-e a szinergiát. A konfigurációs részletek és tesztesetek elérhetők a kísérő tárolóban.
A kísérő vizsgálat mindhárom rendszert ugyanazon a 60 kérdésen futtatta, és 180 valódi API-trajectory-t őrzött meg. A 7-3. táblázat az arányok mellett a sikeres esetek számát is közli.
7-3. táblázat: Sikerarány memóriarendszer és feladatszint szerint
Rendszer
Alapvető felidézés
Több munkamenetes egyértelműsítés
Rejtett munkamenetközi kapcsolatok
Összesen
Advanced JSON Cards
95%
60%
50%
68.3% (41/60)
RAG
90%
40%
15%
48.3% (29/60)
Hibrid
80%
70%
50%
66.7% (40/60)
A legfigyelemreméltóbb, hogy a hibrid megoldás nem győzött magától. Három kérdésen olyat teljesített, amit egyik önálló megoldás sem, ám nyolc további kérdésen alulmaradt a jobbik önálló megoldással szemben; a kérdésenkénti legjobb önálló megoldáshoz mérve az átlagos sikeraránya éppenséggel alacsonyabb lett. A tiszta RAG az alapvető felidézési kérdéseken nem sokban maradt el a strukturált kártyáktól, a munkamenetek közötti összefüggéseket firtató kérdéseknél viszont a sikeraránya 15%-ra esett. Egy másik, könnyen elsikló szám: a 180 ítéletből a hallucinációs vétó 28 alkalommal lépett életbe — jól mutatva, mekkora súlya van egyetlen vétótételnek.
Az Azonos Család Modell Problémája és a Több Forrásból Származó Bíráskodás.
Amikor az Ügynök és a bírómodell ugyanabból a családból származik, az Ügynök megtanulhatja kihasználni a bírómodell preferenciáit és vakfoltjait.
Ez pontosan Goodhart törvénye: amikor egy metrika optimalizálási célponttá válik, megszűnik jó metrika lenni. Minél inkább egy adott pontozási rendszerre van edzve vagy hangolva egy Ügynök, annál inkább hajlik arra, hogy kiskapukat használjon ki a rendszerben, ahelyett, hogy valóban javítaná a képességeit.
Még álnokabb módon, az Ügynök fokozatosan megtanulja elkerülni azokat a hibatípusokat, amelyeket a bírómodell nem jól érzékel, így a pontozási rendszer tökéletesnek tűnik.
Az ellenszer a “több forrásból származó heterogén bíráskodás” — független bírók különböző modellcsaládokból (ha az Ügynök Claude-on fut, ítéljen GPT-5 és Gemini). A különböző családok torzításai gyakran ortogonálisak, így az Ügynök ritkán tudja egyszerre becsapni az összes bírót. Használják ugyanazt a Rubricát, hogy mindenki ugyanazt a célt ítélje meg, és aggregálják súlyozott átlagolással vagy konzisztencia-ellenőrzéssel. Éles környezetben egyetlen modell is elvégezheti a gyors kiértékelést, időszakos minőségi auditokkal a teljes több forrásból álló rendszerrel szemben.
A több forrásból származó bíráskodás arra a kérdésre ad választ, hogy mely modellek szolgáljanak bíróként; a következő kérdés az, hogy mely modalitásokat értékeljük — az LLM-mint-bíró kiterjesztése szövegről beszédre, képekre és videóra a kiértékelési lefedettség másik tengelye.
Multimodális LLM-mint-Bíró.
A multimodális bíráskodás az LLM-mint-bírót a beszéd, kép és videó tartományaira terjeszti ki. Négy gyakori irány a következő.
TTS Kiértékelés (TTS: Text-to-Speech, szöveg-beszéd átalakítás): Pontosság, természetesség, hangkonzisztencia és érzelmi kifejezés értékelése. Ezek a dimenziók képesek megragadni a prozódiai problémákat, amelyeket a hagyományos WER (Word Error Rate, szóhibaarány) nehezen érzékel.
ASR Kiértékelés (ASR: Automatic Speech Recognition, automatikus beszédfelismerés): Szemantikai hatásvizsgálat — a “mai időjárás” félreismerése ártalmatlan, de az “ezer átutalás” félreismerése “tízezerre” súlyos következményekkel járhat.
UI Kiértékelés: “Javaslattevő-Felülvizsgáló” mechanizmus használata olyan problémák észlelésére, mint a szövegtúlcsordulás, színkontraszt, gombelhelyezés. Itt a javaslattevő-felülvizsgáló “kiértékelési módszerként” szolgál, eltérően az 5. fejezetben “generációs rendszer-összetevőként” való használatától, de az alapmechanizmus ugyanaz — egy modell generál, egy másik függetlenül felülvizsgál.
Videószerkesztés Kiértékelése: A vágás kezdő/végpontjainak és a hatás alkalmazásának helyességét ellenőrzi kulcskockákon keresztül.
7-5. kísérlet ★★: Teljesen Automatizált TTS Minőségi Kiértékelő Csővezeték Építése
Ez a kísérlet egy teljes multimodális LLM-mint-bíró TTS minőségi kiértékelő rendszer tervezését és implementálását igényli a semmiből.
Tervezz egy többdimenziós TTS Rubricát: A Pontosság dimenzió ellenőrzi, hogy minden szöveg helyesen lett-e felolvasva (nincs kihagyás/félreolvasás/hozzáadás); a Természetesség dimenzió azt értékeli, hogy a beszéd természetes-e, nem robotikus, nincsenek-e természetellenes szünetek, és természetes a prozódia; az Érzelmi Kifejezés dimenzió ellenőrzi, hogy a hangszín illeszkedik-e a szöveg érzelmi tónusához (emelkedő intonáció kérdéseknél, hangsúly felkiáltásoknál, lassabb tempó és mélyebb hangmagasság szomorú tartalomnál); a Hangkonzisztencia dimenzió a beszélői hasonlóságot értékeli, ha rendelkezésre áll egy referenciabeszéd (a multimodális modell egyszerre kapja a referenciát és a szintetizált beszédet az összehasonlításhoz).
Építs sokszínű tesztkorpuszt különböző hosszúságokkal, műfajokkal, érzelmekkel és speciális kihívásokkal. A TTS-modult kapcsold a vezető szolgáltatásokhoz (OpenAI, ElevenLabs, Fish Audio, Minimax, Doubao), majd a szintetizált hangot, az eredeti szöveget, a referenciahangot és a Rubricát add egy közvetlen hangbemenetre képes multimodális bírónak. A pontszámok auditálhatóságához rögzítsd a bírómodellt, valamint a jelölt- és referenciahang hashét.
A kísérő tároló egy kis közvetlen hallgatási próbát is megőriz. Az OpenAI és a Fish Audio négy-négy felvételt készített számokkal, többféleképpen ejthető kínai karakterekkel, hosszú szöveggel és lelkes előadásmóddal; a Voxtral mind a nyolcat négy dimenzióban értékelte. Mindkét rendszer 5.00 pontot kapott pontosságra és 4.00-t természetességre. A Fish Audio érzelemre és hangkonzisztenciára 4.00/3.00, az OpenAI 3.75/2.75 pontot ért el. A dimenziók szétválasztása olyan különbségeket tett láthatóvá, amelyeket egy egyszerű „helyesen olvasta fel?” kérdés nem mutatna meg.
Ezek a pontok nem neveznek meg győztes szolgáltatót. Szolgáltatónként csak négy felvétel volt, ráadásul a fix referencia a Fish S1-ből származott, ami eleve a Fish Audiónak kedvez a hanghasonlóságban. Általános TTS-összevetésnél ezt a dimenziót el kell hagyni, vagy minden jelölthöz megfelelő célhangot kell adni. Hangklónozásnál minden rendszer ugyanazt a beszélőt utánozza, a modellbíró pontjait pedig vak emberi hallgatással kell kalibrálni. A referencia válasz, kép vagy hang kiválasztása a kiértékelés tervezésének része, nem semleges előkészítés.
A kézzel írt Rubricák gyorsan kialakítják ezeket a diagnosztikai dimenziókat. Nagyobb léptékben speciális „generatív jutalommodellek” automatizálhatják a bíráskodást; képzésüket a 8. fejezet tárgyalja.
A bíráló modell pontszáma csak azt mondja meg, jó vagy rossz lett az eredmény; ahhoz, hogy az eredményből javítható probléma legyen, azt is meg kell találni, melyik lépésnél kezdődött valójában a hiba.
Hibaattribúció: Az első hiba behatárolása a pályán
Az end-to-end kiértékelés gyakran csak „siker” vagy „kudarc” eredményt ad. A javításhoz minden hibás pályán rögzíteni kell a kategóriát, az első elfogadhatatlan lépést, az eszközhívást vagy modellkimenetet, valamint az auditálható bizonyítékot. A rossz esetek felhasználói korrekcióból, negatív visszajelzésből vagy későbbi állapotellenőrzésből származhatnak. Az LLM segíthet, de az emberi olvasás szükséges, mert a gyökér gyakran termékprobléma.
Egy Coding Agent kezdeti kategóriái: hiányzó folyamat vagy szabály, eszköz- és formátumhiba, rendellenes leállás, illetve logikai vagy teljességi hiba. JSON/YAML rekordban tárold a lépésszámot, eszközt, megfigyelést, okot és következményt, helyreállíthatóságot és bizalmat, továbbá a környezet állapotát és verzióit.
A hibaattribúciós rendszer felépítése azt kívánja, hogy a fejlesztő türelmesen elolvassa és elemezze az éles rendszer problémás pályáit. LLM segíthet a munkában, de nem helyettesíti az embert, mert a hibaattribúció gyakran termékproblémákat tár fel, nem csupán technikaiakat.
Ahogy a termék érik, a hibaosztályozás több nagy osztályra bomlik, mindegyik alatt további alosztályokkal, míg végül több száz tételre nő. Ezek az osztályok és attribúciós receptjeik lesznek később egy attribúciócímkéző Agent promptja vagy Skillje.
Coding Agent esetében egy használható kezdeti osztályozás így néz ki.
Hibaosztály
Jellemző tünet
Hogyan találjuk meg az első hibát
Követelményértés és többértelműség
Nem az készül el, amit a felhasználó kért: kiesik a követelmény egyik feltétele, vagy a hatókört túl tágan, illetve túl szűken értelmezi; ha a repóban két azonos nevű konfigurációs fájl van, egyszerűen kiválasztja az egyiket, szó és kérdés nélkül
LLM-mel vessük össze pontról pontra az eredeti követelményt azzal, amit az Agent valóban csinált (a műveletsorral); keressük meg az első eltérést az eredmény szintjén, majd menjünk vissza az azt okozó eszközhívásig vagy válaszig
Hiányzó folyamat vagy szabály
Commit egységtesztek futtatása nélkül; kódmódosítás Plan megírása előtt; külső függőség behozása, holott a repóban már van belső megfelelője; a rögzített architektúrarend megkerülése
Keressük meg az első műveletet, amely megsérti a fejlesztési folyamat szabályát — az első git commit-ot, az első fájlírást —, és nézzük meg, olvasta-e előtte a szabály forrását
Eszközhívási hibák
Ugyanannak a fájlnak a szerkesztése ismételten meghiúsul; hibás JSON/schema vagy argumentumformátum; a különleges karakterek elrontják az átmásolást, az escape-elést vagy az írást
Rögzítsük az első sikertelen szerkesztést vagy eszközt az eredeti kéréssel és a visszaadott hibával együtt; az ismétlődő hibák már következménytünetek
A verifikációs környezet meghackelése
Assertion átírása, skip hozzáadása, a vizsgált logika kimockolása; „a tesztek átmentek” állítás anélkül, hogy egyszer is lefuttatta volna őket
Vegyük az első üzenetet, amely tesztet vagy verifikációs logikát módosít; majd vessük össze a készre jelentést a pályán ténylegesen lefuttatott parancsokkal, hogy tényleg futott-e
Hiányos módosítás
A függvény szignatúrája megváltozott, három hívási pont frissült, de a negyedik — egy dinamikus hívás, egy másik nyelvi binding vagy egy schema — kimaradt
Képezzük az Agent által állított és a tényleges hatókör különbségét, vegyük az első kimaradt elemet, és nézzük meg, milyen kulcsszavakkal keresett
Hibás információ a felhasználónak
Az eszközhívások és a végállapot mind helyesek, de amit a felhasználónak mond, az nem: rossz összeg, állapot vagy időpont; a részben kész munka teljesként feltüntetve; kötelező tájékoztatás elhagyva
Vessük össze a válasz minden ténymegállapítását az eszközök visszatérési értékeivel, és vegyük az elsőt, amely nem visszakövethető vagy ellentmond a visszatérési értéknek
Nem funkcionális regresszió
Publikus API vagy schema változik migrációs szkript nélkül; egy validáció törlődik, hogy egy ellenőrzés átmenjen
Vegyük az első üzenetet, amely a változtatást elvégezte, és nézzük meg, tudatában volt-e, hogy publikus interfészhez vagy migrációt igénylő szerkezethez nyúl
A modell rendellenes leállása
A kimenet félbeszakad, ok nélkül megáll, időtúllépésbe fut, vagy a lezáró művelet nélkül ér véget
Keressük meg az első rendellenes leállást, és válasszuk szét a modell leállását, a Harness időtúllépését és az eszközszolgáltatás hibáját
A feladat túl korai lezárása
A többcélú feladatnak csak egy része készül el; valamit lehetetlennek nyilvánít anélkül, hogy kimerítette volna az ésszerű lehetőségeket
Keressük meg az első döntést, amely elejtett egy célt vagy feladta a feltárást, és rögzítsük külön a záró ellenőrzés bukásától
Az attribúciócímkéző Agent LLM segítségével nagy léptékben végezhet gyökérok-elemzést sok éles pályán, de nem elégedhet meg egyetlen mondatnyi „a hiba oka” válasszal. Az attribúciós rekordnak strukturáltnak kell lennie: JSON vagy YAML formában, konkrét lépésszámokra, eszköznevekre és megfigyelt bizonyítékokra hivatkozva; ezen felül el kell választania a gyökérokot a következménytől, meg kell ítélnie a helyreállíthatóságot, és megbízhatósági szintet kell adnia. Például az edit_fileold_string eltérést ad vissza, majd az Agent háromszor újrapróbálkozik, és a fájlt így sem írja ki: a fő ok a fájlszerkesztési és eszközhívási hiba, a három újrapróbálkozás pedig következmény, nem három független gyökérok. Ha több osztály egyszerre jelenik meg, a fő okot a „legkorábbi, és a rákövetkező hibákat is megmagyarázza” elv szerint válasszuk ki, a többit másodlagosként tartsuk meg. A fenti táblázat legalább három osztálya előszűrhető szabályokkal, mielőtt az LLM-re bíznánk az első hiba behatárolását: a készre jelentés összevetése a ténylegesen lefuttatott parancsokkal; érinti-e a diff a tesztek assertionjeit és a skip jelöléseket; módosít-e a diff publikus API-t vagy schemát migrációs fájl nélkül. Előbb szabállyal szűrni, aztán LLM-mel behatárolni olcsóbb és pontosabb is, mint minden pályát az LLM-re zúdítani.
Az attribúciós rekord mentésekor ne csak az LLM kimenetét őrizzük meg: mentsük mellé a feladat célját, a környezet állapotát, az Agent verzióját, az eszközkészlet verzióját és a teljes Agent-pályát, hogy az eset regressziós teszetté alakítható legyen.
Az alábbiakban három tipikus hibaosztályt tekintünk át közelebbről.
A „jól csinálta, rosszul jelentette” probléma
A „jól csinálta, rosszul jelentette” az a kategória, amelyet az összesített sikerarány a legkönnyebben elrejt, mert a legtöbb kiértékelés csak a környezet állapotát vizsgálja. A τ²-bench külön pontozza: a közzétett alapfutások közül abban a 704-ben, amelynek feladata információátadási követelményt hordoz, 240 bukott el; ebből 162 az információátadási ellenőrzésen, és 80 — az összes bukás harmada — helyes környezeti állapot mellett adott téves jelentést.
A kísérő repóban van egy megfelelő eset. Az expenses.jpg kiadásainak könyvelőalkalmazásba vitele során az Agent 32 lépésben adott engedélyt, keresett, megnyitotta a képet, kitöltötte a sorokat és mentett, úgy, hogy egyetlen lépés sem tért vissza hibával, majd késznek nyilvánította a feladatot; a validátor viszont azt jelentette, hogy a beírandó sor — Dress, ¥436,35 — hiányzik, és semmi köze a beírt négyhez. A 8. lépés saját gondolatmenete így szól: „I cannot actually see the content/details of the expenses in the image”. Már tudta, hogy nincs meg az adat, mégsem állt meg és nem jelentette, a 11. lépésre pedig négy kitalált kiadás jelent meg a feljegyzéseiben, amelyeket minden későbbi bevitel hűségesen végrehajtott. Az első hiba a 8. lépés, és az a lépés sem hibát nem dobott, sem eszközhívás nem volt. A gyökérokát is könnyű rossz helyre sorolni: a T3A csak szöveges Agent, amelynek megfigyelési terében kizárólag az elemfa van, képpont nincs, így az ok nem az, hogy „a modell nem tud OCR-t”, hanem egy hiányzó megfigyelési csatorna, plusz a „nem szerezhető meg az információ” legitim kilépés hiánya. Modellképesség-problémaként iktatva a következő lépés a modellcsere vagy az OCR-tanítás lesz; a valódi javítás a csatorna és a kilépés pótlása.
7-6. kísérlet ★★: Hibaattribúció AndroidWorld-nyomvonalakon
Ez a kísérlet a fejezet attribúciós módszerét gyakoroltatja valódi nyomvonalakon, emulátor és modell-API nélkül. Az anyag a chapter7/android-world mentett T3A-futása: a t3a.md az összes feladat lépésenkénti Action/Reason/Summary bejegyzéseit tartalmazza, a t3a_failed.md pedig több mint ötven sikertelen nyomvonalat gyűjt össze, mindegyik végén a validátor objektív ítéletével.
lépés: Mintavétel. Válasszon ki a t3a_failed.md fájlból legalább tíz néma hibát, azaz olyan nyomvonalat, amelyben egyetlen eszközhiba sincs. Egyetlen eszközhívás sem térhetett vissza hibával, az Agent vagy késznek nyilvánította a feladatot, vagy elfogytak a lépései, és csak a záró validátori ítélet jelzi a bukást.
lépés: Az első hiba lokalizálása. Minden nyomvonalnál jegyezze fel az első hiba lépésszámát, és jelölje, hogy az a lépés eszközhívás vagy assistant message. A néma hibákhoz két technika kell: a ténykohorgony-összevetés az Agent állításait veti össze az eszközök visszatérési értékeivel, és az első eltérést veszi; a pályaelőtag-felezés a k. lépésnél elvágja a pályát és átadja — ha még megmenthető, a hiba k után van. A hibakulcsszavak keresése egyiket sem pótolja.
lépés: Strukturált feljegyzés. Nyomvonalanként állítson elő egy JSON vagy YAML rekordot a feladat nevével, az első hiba lépésével, a hiba kategóriájával, a gyökérok felelősével és az alátámasztó idézetekkel, elkülönítve a fő okot a következménytől.
lépés: Összevetés a meglévő jegyzettel. Vesse össze eredményeit a t3a_failed_analysis.md tartalmával, és rögzítsen minden eltérést. Különösen figyeljen a gyökérok hozzárendelésére: a jegyzet eredetileg úgy rögzítette a képátírási hibát, hogy „a látómodellből hiányzik az OCR”, holott a T3A megfigyelési tere egyetlen képpontot sem tartalmaz, tehát a valódi gyökérok a hiányzó megfigyelési csatorna. Egy meglévő attribúciós jegyzet nem megoldókulcs.
lépés: Átalakítás regressziós feladattá. Válasszon ki három olyan nyomvonalat, ahol az első hiba assistant message, vágja el az előtagot közvetlenül a hiba előtt, majd írja meg az elfogadható műveletek halmazát és a tiltott műveleteket, így pálya-előtag regressziós feladatokat kap.
Hatókör-érzékeny dokumentumformázási hibák
Amikor a felhasználó azt mondja, hogy „rossz az idézőjel formátuma”, azt nem szabad globális karaktercserére fordítani. Legalább meg kell különböztetni az ASCII egyenes idézőjeleket (", '), a kínai íves idézőjeleket (“”, ‘’) és a Markdown visszaperjeleket (`). Ugyanaz a karakter más-más szintaktikai szerepet tölt be a kínai prózában, az idézett angol forrásban, a soron belüli kódban, a kódblokkokban, a kódmegjegyzésekben, a JSON-ban és az útvonalakban.
Az értékelési adatot előbb hatókörrel ellátott szakaszokra kell bontani — például ZH_PROSE, EN_PROSE, QUOTED_SOURCE, INLINE_CODE, CODE_BLOCK, CODE_COMMENT és JSON_OR_SCHEMA. Minden szakasz eltárolja az engedélyezett átalakítások halmazát, a kötelezően védendő karaktereket és a szerkesztés utáni ellenőrző eredményét. Az alábbi három eset nem kezelhető egyetlen cserélési szabállyal:
Kínai próza: hívd meg a `reset()` metódust.Idézett angol forrás: “Please restart the service.”# az alábbi kódblokk csak egy védett hatókört szemléltet# Kínai megjegyzés: jelenítsd meg az "aktuális állapot" szövegetname = "status"
A trajectory-prefix regressziónak a minimális szerkesztést kell megkövetelnie a modelltől, és egyszerre kell ellenőriznie a kínai dokumentumstílust, az idézett angol forrás megőrzési arányát, a kód és a JSON szintaxisát, valamint a nem célszövegen mért szerkesztési távolságot. Ha a szabályok nem tudják eldönteni a hatókört, az eredeti szöveg megőrzése és a pontosítás kérése engedélyezett műveletnek számítson, ne pedig véletlenül átmenő, találgatáson alapuló szerkesztésnek.
Pontos másolási hibák: az old_string mismatch-től a rétegenkénti behatárolásig
Egy old_string hiba sem tulajdonítható pusztán annak, hogy „a modell rosszul másolta le”. Ugyanarra a karakterláncra el kell menteni a nyers bájtok hash-ét, a Unicode code point sorozatot és a tokenizer token ID sorozatát, majd az alábbi lánc mentén kell megkeresni az első eltérést:
original file bytes → tool return → Harness serialization → model context→ model token output → decoded string → JSON/tool-call parsing → tool matching
A minimális értékelési szondakészlet lefedi a közvetlen visszamondást, a hosszú kontextusból való kinyerést, az eszközargumentumba helyezést, a hasonló karakterláncok közötti választást, valamint a szóközöket, sortöréseket, visszaperjeleket, Unicode kombináló karaktereket és a ritka tokeneket. A metrikák: byte-exact match, code-point-exact match, token-exact match, az első eltérés pozíciója és a valós eszközsiker-arány. Ha a modell a közvetlen szondán helyes, de az eszközhívás mégis elbukik, a tokenizert, a szerializálást, a Harness-t vagy az eszközprotokollt kell javítani; és csak akkor szabad az esetet a 8. fejezet másolási tréningadatává alakítani, ha az első eltérés magának a modellnek a kimenetében jelenik meg.
End-to-end regressziós feladatok és pálya-előtag regressziós feladatok
A hibaattribúció megállapította az első hibát és annak osztályát; a következő lépés a javítási célt megismételhető tesztesetté, azaz regressziós feladattá (regression task) írni. Itt két, egymást kiegészítő rétegre van szükség: az end-to-end regressziós feladatok azt igazolják, hogy a változtatás nem törte el a teljes munkafolyamatot; a pálya-előtag (trajectory prefix) regressziós feladatok pedig az első hiba előtti állapotot vágják ki, és csak azt vizsgálják, megjavult-e az a döntési határ.
Az end-to-end regressziós feladatok a kezdeti állapotból és a felhasználói kérésből indulnak, hagyják az Agentet végigvinni az egész feladatot, majd ellenőrzik a végállapotot, a szükséges kimenetet és a biztonsági feltételeket. Ezek állnak legközelebb az éles eredményhez, viszont nehéz belőlük megállapítani, melyik lépésnél történt a hiba. Általában arra valók, hogy igazolják: az Agent képessége az egyes területeken továbbra is megfelel az elvárásnak. Az e fejezetben ismertetett szabványos kiértékelő készletek — OSWorld, AndroidWorld, tau-bench — mind end-to-end regressziós feladatok.
A pálya-előtag regressziós feladatok befagyasztják a meglévő kontextust, párbeszédet, eszközválaszokat és környezeti állapotot, és csak annyit kérnek az Agenttől, hogy gondolja végig és hajtsa végre a következő egy vagy néhány megfigyelhető műveletet. Olcsóbbak, és képesek egyetlen házirend vagy eszköz problémáját elszigetelni. Nagy megbízhatóságot igénylő, éles szintű Agent esetében az előtagkészlet felépítése gyakran fontosabb, mint az end-to-end készleté, és megköveteli az előző szakaszban leírt hibaosztályozás és attribúciós rendszer türelmes kiépítését.
Az előtagfeladat válaszát elfogadható műveletek halmazaként kell meghatározni, nem egyetlen műveletként vagy egyetlen válaszként: megkövetelhető, hogy „előbb olvassa el a repó szabályait”, „előbb kérdezze meg a felhasználót”, vagy „utasítsa vissza a veszélyes műveletet” — a tiltott műveletek felsorolása mellett.
A hibaattribúció lezárása után összeállítható egy kiértékelő adathalmaz, amely end-to-end és pálya-előtag regressziós feladatokat egyaránt tartalmaz. Coding Agent esetében: a hiányzó folyamathoz tervdokumentumot és teszt-elfogadási feltételeket hordozó end-to-end regressziós feladatot kell generálni; az eszközhívási hibánál a hibás előtagot el kell vágni és határfeladattá szerkeszteni, amely azt teszteli, tudja-e a modell javítani a formátumot, escape-elni a különleges karaktereket, vagy megfelelő eszközre váltani; a rendellenes leállásnál a csonkolásból, időtúllépésből és eszközhibából való felépülés forgatókönyveit kell hozzáadni; a teljességi és logikai hibáknál többcélú ellenőrzőlistákat, a hátralévő munkára figyelmeztetést és a „még nincs bizonyítva, hogy lehetetlen” határt; a követelményértési és többértelműségi osztálynál a több észszerű olvasatot engedő feladatokat előtagként kell befagyasztani, és az „előbb tisztázd” lépést az elfogadható műveletek közé venni; a tünetfoltozás és a hamisított verifikáció osztályánál két kemény megkötést kell az elfogadáshoz adni: „a teszt-assertionök nem módosíthatók” és „a készre jelentéshez ténylegesen lefuttatott parancs kimenetét kell csatolni”; az információközlési osztálynál pedig magára a válasz tartalmára is állítást kell tenni, nem csak a környezet állapotát ellenőrizni.
A kiértékelő adathalmaz a 8. fejezet poszt-tréningjének és a 9. fejezet Agent-önfejlődésének alapja.
7-7. kísérlet ★★: Pálya-előtag határainak értékelése több kódolással
A modell ismert memóriát, aktuális utasítást, pálya-előtagot, eszközválaszokat és környezeti állapotot kap, és csak a következő megfigyelhető műveletet adhatja vissza. Tizenegy esetet JSON Cards, Markdown és Python-szerű formában kódoltunk; mindhárom 6/11-et teljesített, a 33 cella API-hiba nélkül futott. A reprezentáció megváltoztatása önmagában nem javítja az alkalmazási szabályt.
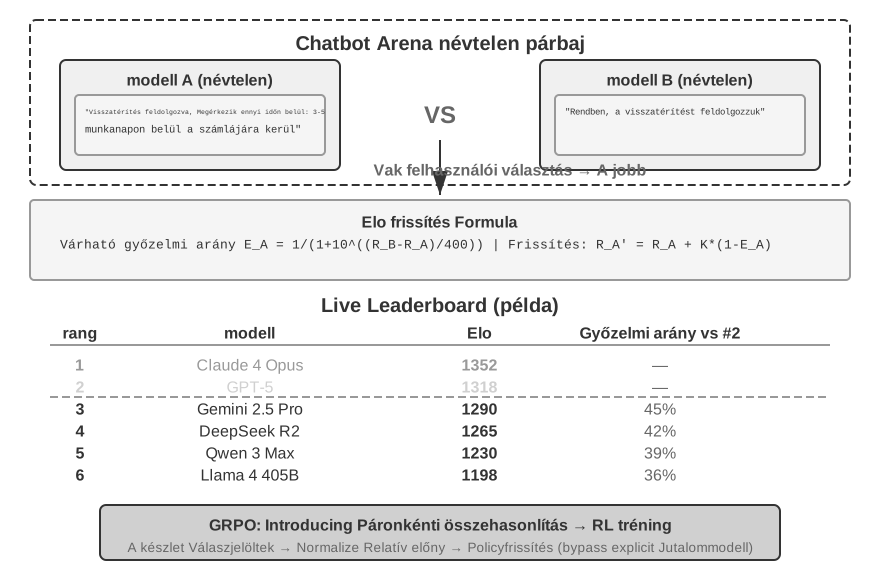
A gyakorlati modellválasztás során gyakran szembesülünk a kérdéssel: “Melyik jobb, A vagy B?” A páronkénti összehasonlítás olyan kiértékelési módszert kínál, amely nem támaszkodik abszolút pontszámokra.
Páronkénti Összehasonlítás és Modellrangsorolás
7-6. ábra: Elo Pontszámítás és Páronkénti Összehasonlítási Rangsor · Forrásábra
Az Elo Pontszámítás (egy eredetileg sakkra tervezett rangsorolási rendszer) a modellek relatív képességét számszerűsíti nagyszámú páronkénti mérkőzésen keresztül: minél nagyobb a pontszámkülönbség, annál magasabb a várható győzelmi arány az erősebb modell számára. Például, ha A modell pontszáma 1200, B modellé 1000, az Elo rendszer A győzelmi arányát körülbelül 76%-ra becsülné. Ha B váratlanul nyer, B több pontot szerez, A pedig többet veszít — a meglepetés nagyobb korrekciót vált ki, ami lehetővé teszi, hogy a rangsorok gyorsan konvergáljanak a valódi képességre. A statisztikai alap a “Bradley-Terry modell”: minden modell egy látens “erősségi pontszámként” van absztrahálva, és annak valószínűsége, hogy egy mérkőzésen legyőzi a másikat, a pontszámaik különbsége határozza meg. Az Elo ennek a modellnek a mérnöki implementációja online frissítési formában.
A Chatbot Arena névtelen véletlenszerű mérkőzéseket használ — a felhasználók vakon választják ki a jobb választ anélkül, hogy ismernék a modell kilétét, és a rangsorok milliónyi szavazatból származnak. Az előny, hogy nem kell “abszolút standardot” meghatározni; csak emberi ítéletre van szükség arról, hogy “melyik a jobb, A vagy B”. A korlátozás: a rangsorok attól függnek, mit kérdeznek a felhasználók. Ha sok felhasználó programozási kérdéseket tesz fel, a programozásban erős modellek magasabban rangsorolódnak — ami keveset mondhat a szintjükről más feladatokon.
Amikor a páronkénti bíráskodást LLM végzi emberi szavazás helyett, ügyelni kell a “Pozíciós Torzításra” is — a bírómodell szisztematikusan előnyben részesítheti az egy bizonyos pozícióban (általában az elsőben) megjelenő jelöltet, és az ítélet változatlan maradhat, ha a két jelölt tartalmát teljesen felcseréljük. A szokásos mérséklési módszer “mindegyik pár kiértékelése kétszer, felcserélt sorrendben”: egyszer A-val először, egyszer B-vel először, és a két eredmény átlaga; egy szigorúbb megközelítés csak azokat az eseteket veszi figyelembe, ahol a két ítélet konzisztens, és az inkonzisztenciákat döntetlenként kezeli vagy emberi felülvizsgálatra küldi. A Chatbot Arena megközelítése lényegében ugyanez — a két válasz megjelenítési pozíciójának véletlenszerűsítése, így a pozíciós torzítás kioltódik nagy mintán.
7-8. kísérlet ★★: Modellranglista építése páronkénti összehasonlítási adatokból
Ez a kísérlet nulláról valósít meg egy Elo-pontszámító rendszert, hogy alaposan megértsük, miként von ki a Bradley–Terry-modell relatív képességpontszámokat nagyszámú páronkénti összehasonlításból. A kísérlet a Chatbot Arena nyílt, valódi szavazási adathalmazát használja (több millió vak felhasználói szavazattal).
Valósítsd meg az Elo-pontszám iteratív frissítését: kezdetben minden modell 1000 pontot kap, a szavazatokat pedig időrendben dolgozod fel. Minden párharcnál a két modell aktuális pontkülönbségéből számítsd ki a várt győzelmi esélyt, vesd össze a tényleges eredménnyel, és igazíts rögzített tanulási rátával — a győztes kap, a vesztes veszít, az igazítás mértéke pedig arányos a várttól való eltéréssel (a meglepetésvereség nagyobb pontmozgást okoz). Rendezd a modelleket a végső pontszám szerint csökkenő sorrendbe, számold ki a páronkénti győzelmiarány-mátrixot, és vesd össze a hivatalos ranglistával — elég, ha a sorrend nagyjából egyezik. Ne várd el a pontról pontra egyezést: a Chatbot Arena hivatalosan Bradley–Terry maximum likelihood illesztést használ (az összes mérkőzést egyszerre oldja meg, a szavazatok sorrendjétől függetlenül), itt viszont online, inkrementálisan frissülő Elo készül (amelyet befolyásol a K tanulási tényező és a feldolgozási sorrend). A két algoritmusnak az összesített rangsorban egyeznie kell, a konkrét pontértékeknek viszont nem.
A kísérlet második része a ranglista történeti alakulását animálja: szeleteld a szavazási adatokat idő szerint (hetente vagy havonta), és minden időpontra számolj Elo-pillanatképet. D3.js-sel készíts oszlopdiagram-versenyt (a vízszintes oszlop hossza a pontszám, a függőleges pozíció a helyezés, és mindkettő simán változik az időben). Az animációt figyelve azonosítsd a technológiai áttörések pillanatait (amikor egy modell pontszáma hirtelen megugrik), a versenyhelyzet átrendeződését és a modellek életciklusát.
Értékelés-vezérelt modellválasztás
A modellválasztás nem egyszerűen a “legerősebb modell kiválasztásáról” szól; magában foglalja az értékelés által vezérelt kompromisszumot több dimenzióban az alkalmazási forgatókönyv alapján.
A kiválasztás kulcsfontosságú méretei
Az áteresztőképesség és a késleltetés két könnyen összekeverhető mérőszámcsalád. Szétválasztásukhoz elég tudni, hogy az LLM-következtetés két szakaszból áll. Az előtöltés (prefill) egyszerre dolgozza fel a teljes bemeneti kontextust, és meghatározza az első tokenig eltelt időt (TTFT): az Enter lenyomása és az első karakter megjelenése közötti késleltetést. Minél hosszabb a kontextus, annál lassabb az előtöltés és annál nagyobb a TTFT. Ezután a dekódolás tokenenként állítja elő a választ, meghatározva a generálási sebességet (token/másodperc) és ezzel a gondolkodási időt is: 50 token/s mellett 2000 gondolkodási token előállítása önmagában 40 másodperc.
E két szakasz körül a fő átviteli és késleltetési mutatók a következők:
Bemeneti/kimeneti áteresztőképesség: Az előtöltés, illetve a dekódolás sebessége.
TTFT: A sorban állási és az előtöltési idő összege; ez határozza meg a felhasználó által érzékelt válaszkészséget.
Gondolkodási késleltetés: A generált gondolkodási tokenek száma modellenként többszörösen változhat, és a gondolkodás hossza nem feltétlenül van pozitív korrelációban a feladat hatékonyságával – mérje meg az egyes modellek gondolkodási token-használatát és a megfelelő hasznot a saját munkaterhelésén, ahelyett, hogy pusztán a nyilvános ranglistákból következtetne.
p95 késleltetés: Az a várakozási idő, amelyet a kérések 95%-a nem halad meg. A valós felhasználói élményt jobban jellemzi az átlagnál, mert az átlagot a sok gyors kérés lefelé húzhatja, elfedve a felhasználók kisebb részét érintő súlyos lassulásokat.
Költség: A bemeneti/kimeneti/gyorsítótár tokenek ára. A költségeket nem szabad elkülönítve értékelni – az alacsony sikerarányú olcsó modellek esetében a gyakori újrapróbálkozások miatt magasabb költségek merülhetnek fel. Ki kell számolni az átlagos feladatonkénti költséget és a költség-teljesítmény arányt.
Teljesítmény: A Pass@1, Pass^k, Pass@k és Best@k pontos definícióit korábban az “Értékelési metrikarendszerben” adtuk meg. Itt csak azt tárgyaljuk, hogyan válasszunk a modellválasztással összefüggésben – napi forgatókönyvek esetén összpontosítson a Pass@1-re (egyetlen kísérlet átlagos sikerességi aránya); a kritikus műveleteknél a Pass^k prioritása, a “soha ne hibázzon” stabilitására összpontosítva; a feltáró feladatoknál adjon prioritást a Pass@k vagy a Best@k, figyelembe véve a képesség felső határát, amely elegendő lehetőséget biztosít; a nyílt végű feladatokhoz használjon többdimenziós Rubrika pontozást.
Sebességkorlátok és megbízhatóság: Az RPM (kérelmek percenkénti száma) / TPM (tokenek percenkénti száma) korlátok befolyásolják a párhuzamossági képességeket, és egyes API-k csúcsidőben dinamikusan módosítják a kvótákat. A robusztusság szempontjából ügyeljen a terjesztésen kívüli adatokra, az ellenséges bemenetekre és a hosszú távú stabilitásra (függetlenül attól, hogy előfordulnak-e olyan problémák, mint a mód összeomlása vagy a figyelem eltolódása).
Költségkeret–képesség görbék: Egyetlen, rögzített költségkeret mellett mért pontszám nem mutatja meg, hogy az Ügynök képes-e hosszú ideig tartó munkára. A sikerarány mellett azt is jelenteni kell, hogyan változik a teljesítmény a falióra szerinti idő, a tokenek, az eszközhívások vagy a számítási költségkeret függvényében. A RE-Bench jól szemlélteti ezt: környezetenként kétórás teljes keret mellett a legjobb Ügynök körülbelül négyszer annyi pontot ért el, mint az emberi szakértők. Az emberek azonban jobban hasznosították a többletidőt: nyolc óránál kis különbséggel felülmúlták a legjobb Ügynököt, több próbálkozásra kapott összesen 32 óránál pedig körülbelül kétszer annyi pontot szereztek.1 A rövid keret melletti előny tehát nem vetíthető ki közvetlenül a hosszú távú képességekre. Modellválasztáskor a valós munkaterhelés időtartamához igazodó több költségkeretpontot kell összehasonlítani.
A gyakorlatban a modellek keverhetők: könnyű modellek egyszerű kérésekre a költségek csökkentése érdekében, hatékony modellek összetett feladatokhoz a minőség védelme érdekében; vagy speciális modellek bizonyos részfeladatokra (képmegértés, kódgenerálás), al-ügynöki mechanizmusokon keresztül együttműködve. Minden ilyen heterogén kombinációt magát kiértékeléssel kell validálni, hogy megbizonyosodjon arról, hogy az általános előnyök felülmúlják a rendszer összetettségét (például ha az olyan kérdéseket, mint „melyik nagyobb, 9,9 vagy 9,11?” vagy „le akarom mosni az autót, a mosó 50 méterre van a háztól — gyalog menjek vagy kocsival?”, egyszerűnek minősítve egy könnyű modellhez irányítjuk, és emiatt hibás döntés születik).
Modellviselkedés: mikor hagyjuk abba az olvasást és kezdjük el a szerkesztést?
A modellválasztás nemcsak azt hasonlítja össze, hogy a modell képes-e befejezni a feladatot, hanem azt is, hogyan viselkedik alapértelmezés szerint. A Coding Agentek egyik könnyen megfigyelhető különbsége a cselekvési küszöb. Ugyanazon programozási feladatnál egyes modellek szélesen feltérképezik a tárolót, és szerkesztés előtt ellenőrzik az architektúrát, a hívási helyeket és a teszteket. Mások kevesebb bizonyítékból lokalizálják a módosítást, korán szerkesztenek, majd teszt-visszajelzéssel egészítik ki a megértésüket. Az előbbiek a túl korai módosítás, az utóbbiak még egy fájl elolvasásának alternatív költségét becsülik magasabbra.
Az Ágens ilyen hajlamának két forrása van: a Harness rendszerpromptja és a modell viselkedési stratégiája. A poszt-tréning ez utóbbinak kulcsforrása: az SFT-trajektóriák megmutatják, „meddig olvasson, mielőtt hozzáfog”, a folyamatjutalom valamely eszközútvonalat jutalmaz vagy büntet, az eredményjutalom pedig a sikerrel zárult teljes stratégiát erősíti meg. Idővel a modell nemcsak azt tanulja meg, hogyan írjon kódot, hanem mérnöki szokásokat is.
7-9. kísérlet ★★: A modell cselekvési küszöbének mérése rögzített Coding Harnessben
Cél: a modelltényező elkülönítése, annak számszerűsítése, hogyan választanak a Coding modellek alapértelmezés szerint a további információgyűjtés és a szerkesztés megkezdése között, valamint az útvonal-hatékonyság és a végső minőség együttes értékelése.
Módszer: futtassuk a chapter6/model-action-threshold/experiment.py programot. Alapértelmezés szerint ugyanazon OpenRouter OpenAI-compatible endpointon hívja a GPT-5.6-sol és a Claude Sonnet 5 modellt, miközben rögzíti a rendszerpromptot, az eszköz-Schemákat, a feladattárolókat, a tesztparancsokat és a körkorlátot. A semleges prompt nem ír elő minimális fájlolvasást vagy gyors szerkesztést. Mindhárom feladattípust legalább háromszor ismételjük meg, és váltogassuk a modellek sorrendjét. Rögzítsük az első szerkesztés előtti eszközhívásokat, olvasott fájlokat, kereséseket és falióra-időt, továbbá az első tesztelt javítás elfogadását, a teszt utáni átdolgozást, a végső sikert, a módosított fájlokat és a Token-használatot.
Oksági értelmezés: a semleges kampány azt kérdezi, változik-e a viselkedés a modellel ugyanabban a Harnessben. A Harness módosító hatásához külön kampányt futtassunk --policy explore-first beállítással; a két policyt ne keverjük egyetlen modell-összehasonlításban. A modellcserével változó, de ugyanazon modellnél több Harnessen át fennmaradó viselkedés erősebb bizonyíték a modellhatásra; az ellenkezője inkább Harness-hatást jelez.
Elfogadási feltételek: minden offline egységteszt sikeres; először igazoljuk, hogy minden feladat-fixture kezdeti állapotában elbukik a teszteken; a hivatalos eredmény tartalmazza az összes modell × feladat × ismétlés cellát, nulla API-hibát, független végső tesztet és auditálható trajektóriákat; a manifest.json ellenőrzi a konfiguráció, a megfigyelések és az összesítés hash-eit. A projektkönyvtár egy teljes, 18/18 cellás valós futást tartalmaz. Az olvasók a számukra fontos modellverziókon és valós munkaterhelésen ismételjék meg, ne tekintsék e miniatűr tárolók számait állandó ranglistának.
Ügynökrendszerek költségelemzése
Az előző szakasz a költségeket a kulcsfontosságú kiválasztási dimenziók között sorolta fel, de az ügynökköltségek sokkal összetettebbek, mint az egyszerű token-árazás – a többfordulós érvelés, az eszközhívások és a kontextus-felhalmozás miatt a költségek nem lineárisan növekednek. A szisztematikus költségelemzés az értékelési rendszer nélkülözhetetlen része és előfeltétele a termelés bevezetésének.
A költség összetevői.
Egy ügynökrendszer költsége három szintre bontható:
A Modell következtetési költség a legközvetlenebb összetevő, amelyet a bemeneti és kimeneti tokenek fogyasztása határoz meg. Az ügynök forgatókönyvekben azonban van két gyakran figyelmen kívül hagyott erősítő tényező. Az első a kontextus halmozási effektus: minden alkalommal, amikor egy ügynök meghív egy LLM-et, az összes korábbi beszélgetési előzményt és az eszköz kimeneteit együtt küldi (így a modell megértheti a kontextust). A KV gyorsítótár hatékony kihasználása nélkül (azaz a már feldolgozott kontextus gyorsítótárazása a redundáns számítások elkerülése érdekében) a költségek nagyon gyorsan nőnek – az 1. kör 1000 tokent küld, a 2. kör 2000 tokent, a 3. kör 3000 tokent, vagyis összesen 1000+2000+3000=6000 tokent a 3×1000=3000 helyett. Minél több kör, annál nagyobb a rés. A második a gondolkodási token költsége: a gondolkodást támogató modellek nagyszámú gondolkodási jelzőt generálnak. Bár ezek a tokenek nem jelennek meg a felhasználó számára, mégis kiszámlázzák őket.
Az eszközhívás költsége magában foglalja a külső API díjakat (a keresőmotorok lekérdezésenként díjat számítanak fel, az adatbázis-lekérdezések számítási erőforrásokat fogyasztanak), a kódvégrehajtáshoz szükséges sandbox-erőforrásokat, valamint egy könnyen figyelmen kívül hagyható közvetett költséget: az eszközkimenetek kontextusba való beillesztésekor felmerülő tokenköltséget. Az egyetlen webes keresésből visszaadott tartalom 2000-5000 tokent foglalhat el, és minden következő következtetési körben ismételten kiszámlázzák bemenetként.
Az infrastruktúra költsége magában foglalja a vektoradatbázisok (RAG-lekérdezéshez), az üzenetsorok, a relációs adatbázisok, valamint a naplózási és nyomkövetési tárolók (a megfigyelhetőség érdekében) működési többletköltségét.
A költség forrásainak feltárásához a kísérő vizsgálat egy rögzített, nyolcfordulós visszatérítési folyamatot használt: rendelés, szállítás, visszatérítési szabályzat és tudásbázis lekérdezése, majd kockázatellenőrzés, visszatérítés, értesítés és lezárás. Valódi gpt-4o-mini hívások futottak két kapcsoló mind a négy kombinációjával: stabil vagy instabil előtag, illetve teljes vagy tömörített előzmény. Az üzleti folyamat minden ágban azonos volt; a 7-4. táblázat a rögzített tokenadatokat és árakat használja.
7-4. táblázat: A nyolcfordulós Ügynök-folyamat mért költsége
Konfiguráció
Bemeneti token
Gyorsítótárazott token
Teljes költség
Megtakarítás az alaphoz képest
Nincs cache, nincs tömörítés
20,700
0
$0.003776
—
Csak stabil előtag
20,386
13,568
$0.002707
28.3%
Csak előzménytömörítés
16,177
0
$0.003115
17.5%
Stabil előtag + tömörítés
16,035
6,144
$0.002643
30.0%
Az alapkonfigurációban a körönkénti bemenet 1 113 tokenről egészen 3 668-ra nőtt. Az eszközök visszatérési értékei az előzményekkel együtt újra és újra bekerülnek a következő kérésekbe, és nyolc kör alatt összesen 9 544 bemeneti tokent tettek ki. A két optimalizálás egyidejű bekapcsolása után ez a szám 5 248-ra esett, az összköltség pedig 30%-kal csökkent.
A nyereségek nem adódtak össze. A stabil előtag önmagában 28.3%, a tömörítés 17.5% megtakarítást hozott, együtt azonban 45.8% helyett 30%-ot. A tömörítés a gyorsítótárban újrahasznosítható előtagot is rövidítette. Kombinált kontextusoptimalizálásnál a teljes folyamatot mérjük; az önálló megtakarításokat ne adjuk össze. Más modell, ár vagy feladathossz más százalékot ad. A négyágú módszer általánosítható, nem a 30%.
Költségoptimalizálási stratégiák.
Elsőként három bemeneti oldali eszközt érdemes próbálni: KV Cache újrafelhasználása stabil előtaggal, kontextustömörítés a régi trajectory-k és hosszú eszközeredmények rövidítésével, valamint rétegezett modellútválasztás. A 2. fejezet ismertette a megvalósítást. Működtetési szempontból mindegyikhez külön kapcsoló kell, hogy önálló és kombinált hatásuk is mérhető legyen. Két további módszer közvetlenül az értékeléshez és az üzemeltetéshez kapcsolódik.
Az Aszinkron kötegelt feldolgozás nem valós idejű feladatokat halmoz fel kötegelt feldolgozáshoz, kihasználva az API-szolgáltatók kötegelt árengedményeit; öntelepítési forgatókönyvek esetén a csúcsidőn kívüli GPU kihasználtságot is javítja.
Költségfigyelés és költségvetés-ellenőrzés.
Éles környezetben valós idejű költségfigyelő rendszert kell létrehozni: nyomon követni a token felhasználást és az API-költségeket feladattípus, modell, felhasználó stb. szerint. Ezenkívül minden feladathoz állítson be költségplafont – automatikusan leállítja az ügynököt, ha hurokba esik, vagy túl mélyre megy, így megakadályozva, hogy egyetlen feladat abnormálisan magas költségekkel járjon.
7-10. kísérlet ★: Az ügynöki feladatok végpontok közötti költségelemzése
Kísérlet célja: Ismételje meg a fenti nyolcfordulós költségbontást, majd vizsgálja meg ugyanezeket az optimalizálásokat a saját munkaterhelésén.
Technikai megközelítés: Először reprodukálja a kísérő tároló rögzített feladatát, majd válasszon saját tipikus feladatokat. LangSmithtel vagy saját nyomkövetéssel rögzítse az input/output és gondolkodási tokeneket, az eszközhívásokat és eredményméreteket, valamint a végpontok közötti késleltetést. Számítsa ki az átlagot, p50/p95/p99 értékeket és a költségösszetételt.
Elfogadási kritériumok: Készítsen költségjelentést és azonosítsa a fő hajtóerőket. Futtassa mind a négy kapcsolókombinációt, külön-külön és együtt is mérve az optimalizálásokat. Modellváltáskor ismételje meg a mérést, ne vigye tovább a mentett trajectory százalékát.
Értékelés-vezérelt folyamatos iteráció
A modellválasztás nem egyszeri döntés, hanem egy folyamatos folyamat, amely a modellek fejlődéséhez igazodik. A fejezet azzal az állítással kezdődött, hogy egy kiértékelő rendszer lehetővé teszi, hogy lépést tartson a modell fejlődésével; egy konkrét modellváltási eset megmutatja, hogy ez hogyan működik egy valós döntésben.
Tegyük fel, hogy az Ügynökrendszer jelenleg Claude-ra épül, és kiváló az eszközhívásokban, valamint az összetett vezénylésben. Egy napon megjelenik egy új Gemini-modell, amely a nyilvános benchmarkok szerint több mutatóban, alacsonyabb áron felülmúlja Claude-ot. A kérdés ekkor nem az, hogy „jobb-e a Gemini a Claude-nál?”, hanem ez: „Az én konkrét feladataimban jobb-e a Gemini? Mennyivel, és mekkora az átállás költsége?”
Egy megbízható kiértékelő rendszerrel rendelkező csapat órákon belül választ adhat: lefuttatja az új modellt a saját kiértékelési adatkészletén, majd összehasonlítja a feladatok sikerarányát, az eszközhívások pontosságát, a késleltetést és a költséget. Elképzelhető, hogy az új modell az egyszerű feladatoknál valóban jobb és olcsóbb, miközben az összetett, többfordulós eszközvezénylést igénylő alapforgatókönyvekben 5%-kal csökken a sikerarány. Ha a különbség meghaladja a becsült mintavételi zajt (lásd alább „A kiértékelési eredmények statisztikai szignifikanciája” című szakaszt), árnyalt stratégia választható: az egyszerű feladatokat az olcsóbb új modellre irányítjuk, az összetetteknél pedig a minőség megőrzése érdekében megtartjuk az eredetit. Az ilyen részletes, adatvezérelt döntéshez előre felépített kiértékelő rendszer szükséges.
7-11. kísérlet ★★: Többdimenziós modell teljesítmény-benchmarking
Végezze el a főbb LLM-ek és a különböző API-szolgáltatók átfogó összehasonlítását egy többdimenziós modellkiválasztási döntési adatbázis felépítéséhez.
Válasszon tesztkört: zárt SOTA modelleket, például a GPT-, Claude-, Gemini- és Doubao-sorozatot, valamint nyílt modelleket, például a Qwen, Kimi és DeepSeek modelljeit. Ugyanazt a modellt több API-szolgáltatónál is tesztelje – például a hivatalos DeepSeek API-n és a SiliconFlow szolgáltatásán –, így ellenőrizve a külső teljesítménymérő platformok, például az Artificial Analysis eredményeit.
Szabványosított tesztelési munkaterhelések tervezése: A bemeneti átviteli teljesítménytesztek rögzített hosszúságú kontextusokat használnak (8K/32K/128K token), a kimeneti teljesítménytesztek rögzített hosszúságú válaszokat kérnek (512/2048 token). A késleltetési tesztek közé tartozik a TTFT (Time to First Token) és a végpontok közötti késleltetés. A gondolkodást támogató modelleknél külön mérje meg a gondolkodási hosszt és a gondolkodási késleltetést. Minden konfigurációhoz készítsen legalább 100 kérést, és számítsa ki a szórást, p50, p95 és p99; a nagy késleltetési eltérés instabil felhasználói élményt jelez.
Értékelje az API rendelkezésre állását és stabilitását: Egy héten keresztül óránként egyszer vizsgálja meg, rögzíti a sikerarányt, a hibatípusokat és a hiba időtartamát. Számítsa ki a hibaarányt, az MTTR-t (átlagos helyreállítási időt) és a leghosszabb folyamatos üzemidőt. Tesztelje a sebességkorlátok tényleges küszöbértékeit – fokozatosan növelje az egyidejűséget a fojtópont megtalálásához, rögzítve az RPM/TPM határértékeket. Átfogó költség kiszámítása: Gyűjtse össze az árinformációkat (az input/output/cache tokenek egységárai), mérlegelje a KV Cache hatását, és számítsa ki a tipikus többfordulós ügynöki feladatok átlagos költségét.
7-12. kísérlet ★★: Felhasználói memóriarendszerek végpontok közötti kiválasztási kiértékelése
Előfeltételek: Be kell fejeznie a 3. fejezetben található kontextuális visszakeresési vagy ügynöki RAG-kísérletet.
Cél: Végezze el a felhasználói memória visszakereső ügynökének végpontok közötti modellkiválasztási kiértékelését, megvizsgálva, hogy a beágyazási modell, az átrendező és az ügynök fő modellje együttesen hogyan befolyásolja a visszakeresés minőségét, késleltetését és költségét. Használja újra a chapter3/contextual-retrieval-for-user-memory-t vagy a chapter3/agentic-rag-for-user-memory-t, és hasonlítsa össze a konfigurációkat 60 teszteseten.
Elfogadás: Értékelje sorban mindhárom kiválasztási pontot: a beágyazási modellt (BGE-M3 / OpenAI / Doubao stb.; rögzítse a top 5 visszakeresési pontosságot, a késleltetést és a költséget), az újrarangsorolót (legyen „nincs újrarangsoroló” alapvonal is, hogy számszerűsíthető legyen a hozzáadott értéke), valamint a fő modellt (azonos visszakeresési konfiguráció mellett hasonlítsa össze a sikerarányt és az eszközhasználat hatékonyságát). A kulcs az összetevők közötti kölcsönhatások felismerése: az erősebb beágyazás fölöslegessé teheti az újrarangsorolót, az erősebb főmodell pedig ellensúlyozhatja a visszakeresés hiányosságait. A választás rendszerszintű kompromisszum, nem az egyes komponensek külön-külön legerősebb változatának kiválasztása. A konfiguráció részletei a kísérő tárházban találhatók.
A Kiértékelési Eredmények Statisztikai Szignifikanciája
A kiértékelési halmaz véges, a modell kimenete pedig véletlenszerű, ezért a pontkülönbség lehet puszta mintavételi zaj is. Ha n eseten mérünk p sikerarányt, a standard hiba nagyjából így becsülhető:
SE(p)≈np(1−p)
Például 100 eset és 70%-os sikerarány mellett a 95%-os konfidenciaintervallum körülbelül 70%±9 százalékpont; „az új modell 73%, a régi 70%” tehát nem elég a váltás alátámasztásához.
Amikor ugyanazon a feladathalmazon hasonlítunk össze két konfigurációt, előbb páros elemzést végezzünk: jegyezzük fel feladatonként, melyik győz, és a különbséget McNemar-teszttel vagy páros bootstrappel ítéljük meg, ne két független sikerarány kivonásával. Mivel az Ágens minden futása is eltérhet, érdemes minden konfigurációt több véletlenmaggal (például 3–5 alkalommal) futtatni, és az átlagot az ingadozási tartománnyal együtt jelenteni; egyetlen futás csak az irány szűrésére jó. Ha a várt nyereség csupán 2–3 százalékpont, a kiértékelési halmaz pedig mindössze néhány tucat feladatból áll, előbb növeljük a mintát — a standard hiba 1/n szerint csökken.
for task in paired_tasks: for seed in fixed_seeds: a = run(config_a, task, seed) b = run(config_b, task, seed) record_paired_delta(verifier(a), verifier(b))return paired_bootstrap_or_mcnemar(all_deltas)
A párosítás azt jelenti, hogy a két csoport osztozik a feladatokon és a véletlen feltételeken, nem pedig azt, hogy külön-külön veszünk két mintát, és az átlagaikat hasonlítjuk össze.
Több hipotézis párhuzamos ellenőrzésekor a többszörös összehasonlítást is figyelembe kell venni: szigorítsuk a szignifikanciaküszöböt, vagy futtassuk le újra függetlenül a pozitív eredményeket. A gyakorlati mérce egyszerű: a pontkülönbség csak akkor ér modellváltást vagy változtatás kiadását, ha meghaladja a zajt, kiállja a páros elemzést, és reprodukálható.
Ügynök-megfigyelhetőség
A kiértékelés-vezérelt döntések (akár modellválasztáshoz, akár folyamatos iterációhoz) minőségi működési adatokra támaszkodnak. Az alábbiakban először azt mutatjuk be, hogyan gyűjtsünk szisztematikusan ilyen adatokat (megfigyelhetőség), majd azt tárgyaljuk, hogyan fordítsuk le a kiértékelési eredményeket rendszerfejlesztésekké.
A megfigyelhetőség egy elosztott rendszerekből kölcsönzött fogalom: nem nyithatod ki a rendszert, hogy lásd, hogyan működik; a naplókból, metrikákból és nyomkövetésekből következtetsz arra, mi történik — ahogy egy orvos, aki nem lát bele a betegbe, a hőmérsékletből, vérnyomásból és képalkotásból diagnosztizál. Az Ügynök-rendszerek ezt még nehezebbé teszik: ugyanaz a bemenet különböző kimeneteket produkálhat, a többfordulós következtetés és eszközhívások rendkívül összetetté teszik a végrehajtási utakat, és a modell “gondolkodása” kívülről teljesen átláthatatlan.
A megfigyelhetőség értéke először is a “problémadiagnosztikában” rejlik: a teljes nyomkövetések lehetővé teszik a fejlesztők számára, hogy visszajátsszák a teljes folyamatot ahelyett, hogy találgatnának. Másodszor, ez a “folyamatos optimalizálás” alapja — láthatod, mely feladatok igényelnek több iterációs kört, mely eszközöknek van a legalacsonyabb sikerességi aránya, és mely lekérdezések adnak vissza mindig üres eredményt. A “költséggazdálkodásban” az Ügynök működési költségei akár egy-két nagyságrenddel is eltérhetnek a feladatok között, és a nyomkövetés felszínre hozza a rendellenesen drága eseteket. Végül, a felhalmozott nyomkövetési adatok képezik a későbbi rendszeroptimalizálás és modellfejlesztés alapját.
Az Ügynök-megfigyelhetőség a “trajektóriák” alapjaira épül, amelyek adatstruktúrája közvetlenül örökli az elosztott rendszerekből származó spanfa modellt: egy feladat végrehajtása egy trajektóriának felel meg, ahol minden LLM-hívás, minden eszközhívás és minden lekérés egy “span” (egy végrehajtási egység, amely rögzíti a bemenetet/kimenetet, a kezdő/befejező időpontot, a tokenfogyasztást és a hiba információt). A spanok közötti szülő-gyerek kapcsolatok egy végrehajtási fát alkotnak — például egy “Ügynök Főhurok” span alatt több “LLM Hívás” és “Eszközhívás” gyermek span lehet. Szabványosított protokollok már rendelkezésre állnak ehhez a réteghez: az “OpenTelemetry” az általános célú elosztott nyomkövetési szabvány, míg az olyan specifikációk, mint az “OpenInference”, LLM-specifikus szemantikai konvenciókat definiálnak ezen felül (hogyan rögzítsünk utasításokat, modellparamétereket, tokenhasználatot stb.). A szabványos protokollok elfogadásának előnye a gyűjtés és az elemzés szétválasztása — ugyanaz a nyomkövetési adat különböző elemző háttérrendszerekhez csatlakoztatható, elkerülve a szállítói bezártságot.
A LangSmith az egyik reprezentatív platform ezen a területen (hasonló platformok: Langfuse, Arize Phoenix stb.), amely a megfigyelhetőséget, a kiértékelést és az optimalizálást zárt hurokba integrálja. Minden végrehajtás létrehoz egy nyomkövetési munkamenetet, ahol a modellhívások, az eszközhasználat és a tudáslekérés független végrehajtási egységként kerül rögzítésre, ok-okozati kapcsolatokkal összekötve, egy végrehajtási fát alkotva. Minden egység rögzíti a teljes bemenetet/kimenetet, időzítési információkat, költségadatokat és hibainformációt. A platform aszinkron kötegelt adatgyűjtést használ annak biztosítására, hogy a nyomkövetés maga ne befolyásolja az Ügynök válasz-késleltetését.
A platform támogatja továbbá az A/B tesztelést (a felhasználói forgalom egy részének átirányítása egy új verzióra, a metrikák automatikus összehasonlítása, gyors visszaállítás vagy fokozatos bővítés támogatása), az utasításverzió-kezelést (minden verzióhoz tartozó futásidejű teljesítményadatok) és az együttműködésen alapuló fejlesztést (a csapattagok megoszthatják egymás között a nyomkövetési adatokat és probléma-eseteket). A termelési környezetből származó hatalmas mennyiségű valós adat aranybánya a folyamatos fejlesztéshez — feltárhatja az előre nem látott forgatókönyveket és azonosíthatja a leginkább optimalizálásra szoruló funkciókat.
A megfigyelhetőségi adatok legértékesebb felhasználása “kiértékelési eszközökké alakításuk”. Egy gyakorlati hurok: a termelési trajektóriákból kivont hibás és gyanús esetek → anonimizálás (érzékeny mezők, például felhasználói adatok és kulcsok eltávolítása) → új tesztesetekké és regressziós tesztekké desztillálás a kiértékelési készletbe. A kiértékelési készlet ekkor megszűnik egyszeri, statikus gyűjtemény lenni, és élő eszközzé válik, amely a termékkel együtt fejlődik és továbbra is tükrözi a valós felhasználói eloszlást — a ma termelésben feltárt hibaminták holnap őrzik az alapvonalat regressziós tesztekként. Ez pontosan a megfigyelhetőség és a fejezet fő témája közötti interfész: a megfigyelhetőség felelős a valós világban történések “látásáért”, a kiértékelés pedig azért, hogy ezeket a megfigyeléseket ismételhető szabványokká szilárdítsa.
Egy átfogó kiértékelő rendszerrel és adathalmazzal a kulcs az, hogy a kiértékelési eredményeket kézzelfogható rendszerfejlesztésekké fordítsuk le.
A Benchmark Jelentésektől a Rendszerfejlesztésekig
A következő eset a kísérő tároló valós, szándékosan szűk AndroidWorld-iterációjából származik. Négy Wi-Fi-beállítási feladatot vizsgál API 35 emulátoron, feladatonként egy páros futással. Nem a teljes, 116 feladatos benchmark, és nem helyettesíti az API 33 referencia-környezetben végzett újrafuttatást. Értéke nem egy összpontszám, hanem az egymásra épülő döntések sora.
7-8. ábra: Benchmarktól a Fejlesztésig Hurok · Forrásábra
A Harness Engineering szempontjából ez a szakasz lényegében a Harness iteratív optimalizálásának módszertanáról szól — a kiértékelési adatok használata a Harness gyenge pontjainak (elégtelen kontextus? hiányzó korlátozások? elégtelen validálás? nem megfelelő időzítésű visszacsatolás?) azonosítására, célzott fejlesztések végrehajtása, majd újraértékelés, ami a Harness folyamatos fejlődésének zárt hurkát alkotja.
Mielőtt bármilyen benchmark jelentést elemeznénk, vegyünk észre egy könnyen figyelmen kívül hagyható elvet: amikor az Ügynök teljesítménye csökken, először a kiértékelő rendszert ellenőrizd, aztán az Ügynököt. A gyakori hiba az, hogy a pontszám esésekor azonnal az Ügynök kódját kezdik szerkeszteni, figyelmen kívül hagyva annak lehetőségét, hogy a kiértékelő rendszer romlott el először — egy torzított jel alapján kormányozni, és a korrekció az első lépéstől fogva rossz. Tipikus kiértékelés-oldali hibák: a futásidejű környezet kifogy az erőforrásokból és leállítja a folyamatokat (ami véletlenszerű hibákként jelentkezik), hibák az ellenőrzőben, amelyek helyes válaszokat jelölnek meg hibásként, és tesztesetek, amelyek eltolódtak a termelési forgatókönyvektől. A fő számokban mindezek azonosnak tűnnek a modellromlással; csak a teljes trajektóriák áttekintése különbözteti meg őket.
Benchmark Jelentés Olvasása: A Problémafelismerés Művészete
A kiinduló jelentés a 116 feladat mindegyikét egyszer futtatta, körülbelül 88%-os összesített sikerrel. A hibák nem szóródtak: a négy SystemWifiTurn* feladatból három elbukott, trajectory-jük pedig végállapot-ellenőrzés nélküli oda-vissza navigálást mutatott. Két magyarázat illett az adatokhoz: az Ügynök nem tudta, hová menjen, vagy hiányos UI-reprezentációt kapott.
A 88%-os főszám elrejti ezt a kis, koherens hibacsoportot. A lépéskorlát emelése is félrevezető: a „nem látja a vezérlőt” problémát „nem elég kitartóvá” nevezheti át. Előbb csoportosítsunk feladat és képességcímke szerint, játsszuk vissza a trajectory-ket, döntsük el, hogy megfigyelési, következtetési, cselekvési vagy ellenőrzési hibáról van-e szó, és csak utána változtassunk egy változót. A Wi-Fi-szelet az olcsó mechanizmusdiagnózist szolgálta, nem a rendszerszintű teljesítmény becslését.
Az Adatoktól a Hipotézisekig: Fejlesztési Ütemterv Építése
Az első kör a legolcsóbb magyarázatot tesztelte. H1 navigációs tudáshiányt feltételezett, ezért csak a kezelt ág kapott Wi-Fi-navigációs és végállapot-ellenőrzési utasítást. A siker nem javult: nem a prompt volt a szűk keresztmetszet.
A második kör arra tért át, hogy megvizsgálja, mit is „lát” valójában az Ágens. Tegyük fel, hogy a H5 az API 35-tel nem kompatibilis accessibility feed helyett az AndroidWorld által már támogatott UIAutomator elemfát használja. A sikerarány valóban javult, ám a teljes elemfa túl hosszú, és a tokenfelhasználás jelentősen megnőtt. Ezért a harmadik kör, a H5C, már nem tesz hozzá új információt: csupán kitörli az elemfából azokat a konténercsomópontokat, amelyek nem láthatók, nincs szövegük és nem is kezelhetők — hogy kiderüljön, eltávolítható-e a zaj a sikerarány megtartása mellett.
Mindhárom körben változatlan maradt a modell, a feladatparaméter, a seed, a lépéskorlát és az emulátor; az ágak sorrendje váltakozott. Így az egyik kör fennmaradó problémája lett a következő egyetlen változója.
Az Eredményektől a Döntésekig: Adatvezérelt Kompromisszumok
A 7-5. táblázat a mért eredményeket foglalja össze. Áganként négy feladat elegendő annak eldöntésére, érdemes-e nagyobb futást végezni, de nem becsüli az AndroidWorld egészének sikerét.
7-5. táblázat: Három kör az AndroidWorld Wi-Fi-szeletén
Kísérlet
Egyetlen változás
Kontroll → kezelés siker
Kezelés / kontroll token
Következő lépés
H1
Navigációs utasítás
25% → 25%
0.47×
Nincs sikerjavulás; eredeti prompt marad
H5
Accessibility feed → UIAutomator
25% → 100%
2.498×
Erős javulás, de drága; tovább optimalizálni
H5C
UIAutomator-fa tömörítése
100% → 100%
0.506×
Siker megmarad, token feleződik; teljes futásra tovább
A sorrend fontosabb bármely egyedi százaléknál. Részletesebb utasítás nem pótolja azt az információt, amelyet az Ügynök meg sem kapott; promptbővítés előtt vizsgáljuk a megfigyelési hibát. A több bemenet sem mindig jobb: a teljes fa megoldotta a láthatóságot, de zajjal árasztotta el a kontextust. A szemantika nélküli csomópontok eltávolítása megtartotta a négy sikert és körülbelül felezte a tokent. A modell nem változott; a Harness UI-reprezentációja döntötte el előbb a végrehajthatóságot, majd annak gazdaságosságát.
Folyamatos Iteráció: Az Első Fejlesztéstől a Rendszer Evolúciójáig
Az, hogy a H5C átment ezen a négy feladaton, csak annyit jelent, hogy megérdemli a következő kört — nem azt, hogy telepíthető. A következő lépésben pótolni kell a harmadik féltől származó alkalmazásokat, és a Pixel 6 / API 33 referencia-környezetben mind a 116 feladatot le kell futtatni öt-öt véletlenmaggal; a sikerarány romlásának kizárásán túl azt is igazolni kell, hogy a token nem haladja meg az eredeti megoldás 75%-át, a késleltetés pedig az 1,5-szeresét. E teljes újramérés előtt a részhalmazon elért 4/4-et nem szabad a rendszer egészére vonatkozó 100%-ként feltüntetni.
A folyamatos iteráció ezt jelenti: minden kör bizonyítéka csak a hatókörével igazolt következő lépést engedélyezi. H1 leállította a prompt további bővítését; H5 megtalálta a mechanizmust és feltárt egy költségproblémát; H5C megoldotta azt, így nagyobb tesztre jutott. A jó benchmark jelentés nemcsak pontszámot, hanem érvényességi kört, megsértett guardraileket és következő tesztet is közöl.
7-13. kísérlet ★★★: Kiértékelés és Fejlesztés AndroidWorldön
Ez a kísérlet a kiértékelési jelentéstől a rendszerfejlesztésig vezető teljes utat gyakorolja. Kezdd a történeti jelentéssel és a chapter6/android-world három mentett páros futásával.
lépés: Diagnózis. Elemezd keresztbe a feladatonkénti táblázatot és a képességcímke-mátrixot, hogy a felszíni feladathibákat mélyebb képességhiányokra vezesd vissza. Azonosítsd a vártnál alacsonyabb sikerességi arányú képességcímkéket és a koncentrált hibákkal rendelkező feladatterületeket.
lépés: Hipotézisek építése. Fogalmazz meg fejlesztési hipotéziseket a háromszintű keretrendszer (felszín → közép → mély) követésével. Minden hipotézis tartalmazza a várható javulást a sikerességi arányban és az ellenőrzési módszert.
lépés: Fázisos kísérletezés. Reprodukálja H1-et, H5-öt és H5C-t, körönként egyetlen változóval. A siker mellett rögzítse a tokent, késleltetést és regressziókat.
lépés: Adatvezérelt döntéshozatal. Hozz bevezetési döntéseket költség-haszon elemzés alapján — ne egyszerűen fogadj el minden hatékony fejlesztést, hanem mérlegeld az alkalmazási kört, a késleltetési hatást és a költségterhelést minden fejlesztésnél. Prioritásként vezesd be az alacsony költségű, magas hasznú fejlesztéseket; a magas költségű fejlesztéseket korlátozd a kritikus forgatókönyvekre.
lépés: Iteráció. A sikeres szeletkísérlet csak a teljes futásra léphet tovább. Telepítésről csak a referencia-környezet 116×5 futása után döntsünk; a jelentésben maradjon meg a környezetkülönbség, a mintaméret és a hiányos hatókör.
A Külső Kiértékeléstől a Belső Kiértékelésig: Kiértékelési Infrastruktúra Termelési Szintű Ügynökök Számára
Eddig ez a fejezet kívülről értékelte az Ügynök-rendszereket — kiértékelési környezet építése, adathalmazok tervezése, benchmark jelentések elemzése. De a legjobb Ügynök-termékek többet tesznek, mint hogy alávetik magukat a külső kiértékelésnek; “folyamatos önértékelési infrastruktúrát építenek a termékbe”. Az alábbiakban az 5. fejezetben bemutatott nyílt forráskódú általános célú Ügynök, az OpenClaw példáján, valamint a vezető Kódolási Ügynök termékek nyilvános technikai elemzéseire és gyakorlati szakemberek meglátásaira támaszkodva bemutatunk egy követésre méltó belső kiértékelő rendszert: amely szisztematikusan ágyazza be a ML kutatás kísérleti módszertanát a termékmérnökségbe.
Ablációs Infrastruktúra: Az Egyes Funkciók Valódi Hozzájárulásának Megértése
A ML kutatók régóta használnak ablációt annak megértésére, hogy egy modely mely összetevői számítanak valójában — az abláció “eltávolít” egy összetevőt egyszerre, és megfigyeli, mennyit csökken az általános teljesítmény. Az OpenClaw ezt a módszertant a termékmérnökségbe hozza: egy beépített főkapcsoló egyszerre több jelentős funkciót is letilthat (gondolkodási mód, kontextus-tömörítés, automatikus memória, háttérfeladatok stb.), létrehozva egy “csupasz modell” alapvonalat. Ez lehetővé teszi a csapat számára, hogy megválaszoljon egy kulcsfontosságú kérdést: egy funkció valóban javítja-e a felhasználói élményt, vagy csak hasznosnak tűnik?
Az abláció rutinszerű mérnöki gyakorlattá tétele, nem pedig egyszeri kutatási tevékenység, számos gyakorlati következménnyel jár. Először is, az abláció kapcsolóját nagyon korán, az indítási útvonalba kell beinjektálni — mielőtt bármilyen modul szintű konstans elkapja a konfigurációs értékeket — ami azt jelenti, hogy az abláció infrastruktúrát a rendszerarchitektúrába kell tervezni a kezdetektől, nem pedig utólag hozzáilleszteni. Másodszor, az abláció kísérletek rendszeres futtatása (pl. minden nagyobb kiadás előtt) feltárhatja a “funkció-adósságot” — olyan funkciókat, amelyek egykor hatékonyak voltak, de már nem szükségesek, ahogy a modellek fejlődnek. Bármely termelési Ügynököt építő csapat számára az ajánlott gyakorlat: Minden jelentős funkciónak függetlenül letilthatónak kell lennie, és a csapatnak rendszeresen ellenőriznie kell az egyes funkciók tényleges hozzájárulását.
A/B Tesztelési Módszertan: A Mechanizmus és a Cél Megkülönböztetése
Az érett Ügynök-termékek szigorú A/B tesztelést végeznek saját viselkedésükön (azaz véletlenszerűen két csoportra osztják a felhasználókat, az egyik a régi, a másik az új verziót használja, és összehasonlítják a tényleges adatokat a két csoportból, hogy megállapítsák, hatékony-e a változtatás). Egy jól megtervezett Ügynök A/B teszteset több kulcsfontosságú módszertani elvet illusztrál:
Több változat, nem csak bináris összehasonlítás. Ahelyett, hogy csak a “van” és “nincs” lehetőséget hasonlítanád össze, tervezz több progresszív változatot (pl. amikor az utasítás-megszorítások különböző erősségeit teszteled, állíts be egy kontrollcsoportot és három kísérleti csoportot fokozatosan szigorúbb megszorításokkal). Ez a tervezés feltárhatja a dózis-válasz kapcsolatokat és segíthet megtalálni az optimális pontot.
A mechanizmus metrikák és a célmetrikák megkülönböztetése. Ez a leggyakrabban elkövetett hiba — annak, amit változtatsz, a kezelése optimalizálási célként. Például, ha azt teszteled, hogy “csökkentsük az Ügynök tervfájl hosszát”, a tervhossz egy mechanizmus metrika (amit közvetlenül változtatsz), de nem a cél. A valódi cél lehet “az ülésszintű költség csökkentése”. A tervfájl lerövidítése csökkentheti a költségeket, de vezethet több szerkesztés-ellenőrzés-szerkesztés hurokhoz is a nem elég részletes tervek miatt, növelve a teljes kimenetet. Mindig tedd fel magadnak a kérdést: Amit változtatok (a mechanizmus), az ugyanaz, amit igazán érdekel (a cél)? Ha nem, részesítsd előnyben a célt.
Védőkorlát metrikák beállítása. Még ha a célmetrika javul is, a kísérletet le kell állítani, ha a felhasználói elégedettség csökken, a műveletek száma nő, vagy a hibaráta emelkedik. A védőkorlát metrikák nem tárgyalható küszöbértékek, amelyek nem romolhatnak.
Alapvonali statisztikák rögzítése. Tartalmazd a mintaméretet, az eloszlás percentiliseit és a korrelációs elemzést (pl. “az elutasítási arány monoton nő a tervmérettel”) a szükséges kontextus biztosításához a kísérleti eredmények értelmezéséhez. Alapvonal nélkül nem tudod megállapítani, hogy a kísérleti eredmények statisztikailag szignifikánsak-e.
Kétrétegű Funkciókapcsoló Rendszer
Az Ügynök-termékeknek szükségük van egy a kezdetektől fogva tervezett Funkciókapcsoló infrastruktúrára — a funkciókapcsoló egy távolról vezérelhető kapcsoló, amely meghatározza, hogy egy funkció engedélyezve vagy letiltva van-e a felhasználók számára, anélkül, hogy kód újratelepítésére lenne szükség. Három célt szolgál egyszerre: kísérletezés, fokozatos bevezetés és vészhelyzeti áramkör-megszakítás.
A fordítási idejű kapcsolók fizikailag eltávolítják a releváns kódot a buildből a fordítási fázis során. A csak belső használatra szánt funkciók egyszerűen nem léteznek a külső buildekben — még a visszafejtés sem fedezheti fel az eltávolított funkciót. Ez egy tiszta ablációs mechanizmust is biztosít: egy funkció letiltása nem hagyja ki a logikát futásidőben; a megfelelő kód fizikailag hiányzik.
A futásidejű kapcsolók konfigurációját a szerver szolgáltatja ki, és a rendszer helyileg, a lemezen gyorsítótárazza. A tervezés előnyben részesíti az enyhén elavult gyorsítótárazott konfiguráció olvasását azzal szemben, hogy az Ügynök indulását blokkolja, amíg egy hálózati kérésre vár. A specifikus csoportosítási döntések egy kísérleti platformon (pl. GrowthBook) keresztül történnek az A/B tesztcsoportok kiosztásához. Egy kulcsfontosságú tervezési részlet: minden funkció expozíciós eseménye munkamenetenként legfeljebb egyszer kerül naplózásra, hogy elkerüljük a duplikált rekordok által okozott kísérleti adatszennyezést.
A tanulság Ügynök-fejlesztők számára: a funkciókapcsolók nem hibakereső eszközök; “első osztályú architekturális összetevők”.
Utasítás-érzékenység Felmérése
A rendszerutasítás az Ügynök viselkedésének alapvető “kódja”, mégis gyakran hiányzik belőle a verziókezelés és regressziós tesztelés, ami a hagyományos kód esetében adott. Az OpenClaw megközelítése, hogy egy dedikált eszközt biztosít, amely képes kinyerni a teljesen renderelt rendszerutasítást egy adott Git revíziónál vagy commitnál — beleértve az összes dinamikus feltétel kibontása utáni végső szöveget. Ez lehetővé teszi a csapat számára, hogy pontosan megválaszolja: Melyik commit változtatta meg az utasítást? Mi volt a hatás a kiértékelési készleten?
Bármely Ügynök csapat számára az ajánlott gyakorlatok: (1) A rendszerutasítás legyen determinisztikusan renderelhető (ugyanaz a konfigurációs bemenet mindig ugyanazt a kimenetet produkálja); (2) Hozz létre verziózott pillanatkép mechanizmust az utasításokhoz; (3) Minden utasításváltoztatás fusson regressziós teszteket a kiértékelési készleten — ahogy a kódváltoztatások CI-t igényelnek.
Adatvédelmi Tudatos Analitika mint Kiértékelési Alap
A kiértékelés jó adatokra támaszkodik, de az Ügynök-termékek gyakran kezelnek érzékeny felhasználói tartalmat. Az OpenClaw ezt az ellentmondást egy típusrendszeren keresztül oldja fel: az analitikai interfész csak speciális típusokba csomagolt értékeket fogad el, ahol a típusnév maga naplózási nyomvonalként szolgál — expliciten deklarálja, hogy “ellenőriztem, hogy ez nem kód vagy fájlútvonal”. Ez a tervezés az adatvédelmi korlátozásokat dokumentált specifikációkból fordítási időben kikényszerített típusellenőrzésekké alakítja.
Az alapelv: Tervezd az adatvédelmi korlátozásokat a rendszerbe a kezdetektől; ne told hozzá utólag. Ha az analitikai rendszered nem képes biztonságosan adatokat gyűjteni, nem tudsz hatékonyan kiértékelni. Az adatvédelem és a kiértékelés nem ellentétes erők — az adatvédelmi tudatos tervezés arra kényszerít, hogy alaposan átgondold, mit kell valójában mérni, ami viszont pontosabb kiértékelési metrikákat eredményez.
A Külsőtől a Belsőig: Váltás a Kiértékelés Gondolkodásában
Ennek a szakasznak a központi üzenete: Az előző szakaszok megtanították, hogyan értékelj egy Ügynököt kívülről; ez a szakasz feltárja, hogy a legjobb Ügynök-termékek hogyan értékelik önmagukat belülről. A külső kiértékelés megmondja, “milyen jó az Ügynök”; a belső kiértékelési infrastruktúra megmondja, “melyik változtatás tette jobbá”. Az abláció kísérletek felfedezik, mely funkciók számítanak valójában, az A/B tesztelés számszerűsíti minden változtatás hatását, a funkciókapcsolók biztosítják a kísérletezés és visszaállítás infrastruktúráját, az utasítás-érzékenység felmérése integrálja a rendszerutasítást a CI rendszerbe, és az adatvédelmi tudatos analitika biztosítja a megfelelést az adatgyűjtésben. Ez az öt összetevő együtt alkotja a kiértékelés-vezérelt termékmérnökséget — nem alkalmankénti értékelést, hanem a kiértékelés beágyazását minden termékdöntésbe.
Szimulációs Környezetek: A Híd a Kiértékeléstől a Poszt-Tréningig
A kiértékelés végpontja nem a pontozás, hanem a fejlesztés. Ez a fejezet már bemutatott két utat a fejlesztéshez: a Harness módosítása (a Benchmark jelentésektől a rendszerfejlesztésekig) és a kiértékelés beágyazása a termékmérnökségbe (belső kiértékelési infrastruktúra). A legerősebb fejlesztési forma a tréning — amikor a cél a “meglévő képességek kiértékeléséről” az “új képességek fejlesztésére” bővül, különösen a 8. fejezetben tárgyalt poszt-tréning technikákon keresztül, a kiértékelési környezetnek “szimulációs környezetté” kell fejlődnie: egy virtuális játszótérré, ahol az Ügynök ismételten gyakorolhat és automatikusan pontozható. A szimulációs és kiértékelési környezetek közötti alapvető különbségek: sokkal magasabb interakciós gyakoriság (milliók vs. ezrek), a randomizálás szükségessége (a specifikus konfigurációk memorizálásának megelőzésére), és az azonnali visszajelzés követelménye. Alkalmazási szempontból a szimulációs környezetek két kategóriába sorolhatók: digitális környezetek (információfeldolgozási feladatok) és megtestesült környezetek (fizikai világ észlelése és manipulációja).
Íme, hogyan találkozik a híd két vége. A kiértékelési oldalon felhalmozott eszközök szinte zökkenőmentesen alakíthatók át tréning jelekké: egy jól definiált Rubrica vagy validátor lényegében egy jutalomfüggvény a “Verifikálható Jutalmú Megerősítéses Tanuláshoz (RLVR)” — a pontozó szkriptből jutalom szkript lesz; hogy egy teszt sikeres-e vagy egy állapot megfelel-e a szabványnak, az egyszerre szolgál kiértékelési szempontként és megerősítéses tanulási jutalomként. De a tréning olyan követelményeket támaszt, amelyekről a kiértékelésnek soha nem kellett gondoskodnia. Az első a “megbízható visszaállítási szemantika”: a tréning több millió epizódot futtat (egy epizód egy teljes interakciós kör a kezdeti állapottól a feladat befejezéséig), és minden epizódnak képesnek kell lennie a környezet determinisztikus, tiszta kezdeti állapotba való visszaállítására; különben a gradiens jelet szennyezik az előző epizód maradék állapotai. A második az átviteli sebesség, amely messze meghaladja a kiértékelését: néhány ezer kiértékelés elegendő a következtetések levonásához, de a tréning megköveteli, hogy a modellt több millió interakcióval tápláljuk elfogadható falon lévő óra időn belül; a környezet párhuzamosításának foka és a példányonkénti többletterhelés közvetlenül meghatározza, hogy a tréning megvalósítható-e. Ezt a két pontot — a validátorokból jutalomfüggvényekké alakítását, valamint a tréning szintű visszaállítást és átviteli sebességet — a 8. fejezet részletezi.
A “digitális környezet” oldalán az AWorld keretrendszer egy irányítható MCP szerver sandboxot épít a GAIA feladatokhoz, 26 MCP szervert biztosítva 126 eszközfunkcióval, elkerülve a valós API-k közvetlen elérésének tiltásait és irányíthatatlan mellékhatásait. Minden eszközhívás visszajátszható és auditálható. Az AWorld elosztott architektúrája a hagyományos soros végrehajtási időt 7695 másodpercről 525 másodpercre csökkenti (14,6-szeres gyorsulás), és a környezet állapotmentes kialakítása minden példányt teljesen függetlenné tesz, támogatva a hatékony párhuzamosítást.
A “megtestesült környezet” oldalán a RoboTwin2 egy fizikai motoron alapuló kétkaros manipulációs feladatokat épít, véletlenszerűsítve az objektumok pozícióit, orientációit és megjelenését az általánosítás javítására. A megfigyelési tér többkamerás vizuális és ízületi állapotokat tartalmaz, valós idejű vezérlést érve el az “Akció Darabolás” révén — ahol a modell egyszerre több egymást követő akciót tervez (részletesen a 6. fejezetben). Az OSWorld visszaállítási képességet biztosít virtuális gép pillanatképeken keresztül, az AndroidWorld pedig a mobil alkalmazás-automatizálásra összpontosít. Akár digitális, akár megtestesült, a szimulációs környezeteknek szükségük van a 4. fejezetben tárgyalt izolált végrehajtási környezetekre és virtuális identitás mechanizmusokra is (VM/konténer izoláció, rezidens proxy-k, Human-in-the-Loop hitelesítés, megosztott fájlrendszerek), amelyeket itt nem ismétlünk meg.
7-14. kísérlet ★★: A Megtestesült Intelligencia Környezet Konfigurálása OpenVLA és RoboTwin2 Számára
Állíts be egy szimulációs környezetet robotmanipulációhoz. Olvasd el a ch7/SimpleVLA-RL fájlt és az OpenVLA dokumentációt a Vízió-Nyelv-Akció modell architektúrájának megértéséhez (végpontok közötti integrációja egy vízió kódolónak, nyelvi modellnek és akció dekódolónak, amely a képeket és szövegeket egy közös szemantikai térbe vetíti). Konfiguráld a RoboTwin2 környezetet, értsd meg a megfigyelési teret (háromnézetű RGB + 14-dimenziós ízületi állapot) és az akcióteret (14-dimenziós vezérlővektor). Tanulmányozd a környezet randomizálási mechanizmusát és a térbeli korlátok logikáját a move_can_pot-ban. Értékeld az előre tanított modellt, rögzítve a sikerességi arányát, befejezési idejét és hibamódjait, különös figyelemmel az akció darabolás mechanizmusának hatására.
7-10. ábra: OpenVLA és RoboTwin2 Megtestesült Intelligencia Környezet · Forrásábra
Hűség Kompromisszumok és Tartomány Randomizálás
A nagy hűségű környezetek jobb átvitelt támogatnak a valós világba, de magas számítási költségekkel járnak. A hűség másik dimenziója a randomizáció mértéke: a mérsékelt randomizáció javítja az általánosítást, míg a túlzott randomizáció túl nehézzé teheti a feladatokat. A “Tartomány Randomizálás” egy kulcsfontosságú technika a szimuláció-valóság szakadékának csökkentésére: a fizikai paraméterek, vizuális megjelenés, érzékelői zaj stb. széles skálájának véletlenszerű bevezetése — mintha különböző megvilágítások és szögek alatt gyakorolnánk a megfogást, hogy a valós világban ne bukjunk el csak azért, mert a fény megváltozott. Digitális környezetekben a szimuláció-valóság a felület renderelésének, válaszidőknek stb. különbségeiben nyilvánul meg, ami a késleltetés és hibák randomizálásának bevezetésével csökkenthető.
Fejezet Összefoglaló
Ez a fejezet egy kérdés köré épült: honnan tudjuk, hogy egy Ügynök valóban javult? A lánc négy szakaszból áll: előbb tisztázzuk, mi számít sikernek (a Pass@k, a Best@k és a Pass consecutive@k eltérő alapjai), majd eldöntjük, honnan jönnek a feladatok (nyilvános benchmarkok, saját üzleti halmaz, éles trajectoryk visszaáramlása), ezután megválasztjuk az ellenőrzés módját (a determinisztikus ellenőrzőktől az ellenőrzőlistákon és a Rubric melletti LLM-ítéleten át a páronkénti összehasonlításig), végül pontszámokból döntést csinálunk (statisztikai szignifikancia, hibaattribúció, regressziós feladatok, modellválasztás). Minden szakasz befolyásolja a következtetés megbízhatóságát. A mért esetek négy gyakorlati figyelmeztetést adnak: a strukturált memória és a RAG együtt sem garantál szinergiát; a cache és tömörítés megtakarítása nem adható össze; a referenciahang megváltoztatja a multimodális pont jelentését; a Harness bemeneti reprezentációja pedig egyszerre dönthet sikerről és tokenköltségről. A modellválasztásnál több erőforráskeret képességgörbéit hasonlítsuk össze. Éles rendszerben a kiértékelés folyamatos validálás, nem alkalmi vizsga.
A könyv egészének szerkezete felől nézve ez a fejezet az 1. fejezet felfedezési hurkának bizonyíték szakaszát építi: a hibaokolás dönti el, hogy a későbbi javaslatoknak van-e mire támaszkodniuk.
A trajektóriaelőtag-határok kiértékelése tovább mutatja, hogy egy információ megszerzése és annak helyes felhasználása a jelenlegi döntésben két különböző képesség: a végponttól végpontig tartó regresszió biztosítja, hogy az alapfeladatok ne romoljanak, a trajektóriaelőtag-határhalmaz pedig közvetlenül a hatókör megítélését, az aktuális utasítás felülírását, a tisztázást és a veszélyes műveletek előtti megerősítést vizsgálja. A felhasználói memória csak egy esete ennek az általános módszernek. Az éles szintű Ágensek kiértékelése nem alkalmi vizsga, hanem olyan ellenőrző rendszer, amely valós problémaesetekből folyamatosan állít elő regressziós és határfeladatokat.
Alapmódszertan: Megfigyelés → Hipotézis → Kísérlet → Validálás → Új Megértés → Új Hipotézis, az Ügynök-mérnökség átalakítása tapasztalatvezérelt “alkímiából” adatvezérelt tudományos mérnökséggé.
Az ebben a fejezetben bemutatott kiértékelő rendszer egy teljes zárt hurkot alkot: “Kiértékelési Környezet” automatizált tesztinfrastruktúrát biztosít → “Kiértékelési Adathalmaz” teszteseteket definiál → “Automatizált Kiértékelési Módszerek” (LLM-mint-bíró és Rubrica) pontozzák az Ügynök teljesítményét → “Benchmark Elemzés” feltárja a fejlesztési irányokat → “Rendszerfejlesztések” kijavítják a problémákat → A kiértékelési környezet és adathalmaz frissítése, új iterációs ciklus kezdődik.
Az itt létrehozott kiértékelő rendszer nemcsak a jelenlegi rendszer optimalizálását támogatja, hanem kritikus alapot is biztosít a következő két fejezethez. A 8. fejezet a kiértékelési környezeteket és adatokat a modell poszt-tréning bemeneteivé alakítja, az SFT és RL segítségével az interakciós politikákat paraméterekbe írva. A 9. fejezet a termelési trajektóriák többdimenziós kiértékeléseit a tudás, utasítások, programok vagy paraméterek jelölt frissítéseivé alakítja.
Elgondolkodtató Kérdések
★★ Az LLM-mint-bíró egy nyelvi modell segítségével értékel egy nyelvi modell kimenetét. Vannak-e ennek az “önértékelésnek” szisztematikus vakfoltjai — például a modell következetesen magas pontszámot adhat egy bizonyos válaszstílusra, ami nem egyezik az emberi ítélettel? Hogyan lehet az ilyen torzításokat észlelni és korrigálni?
★★★ A kiértékelési adathalmazok “szivárgásbiztos” tervezése kulcsfontosságú. A nyílt forráskódú ökoszisztémában azonban, amint a benchmark adatok nyilvánossá válnak, gyorsan bekerülnek a tanítási adatokba. Van-e végjátéka ennek a “macska-egér játéknak”? Tervezz egy kiértékelési módszert, amely alapvetően ellenáll az adatszivárgásnak.
★★ A Scale AI négy szempontja (szakértői iránymutatás, átfogó lefedettség, szabványosított fontossági súlyozás, önálló kiértékelés) a szubjektivitás kiiktatását célozza a kiértékelésből. Bizonyos feladatdimenziók (pl. “Hasznos a válasz?” “Megfelelő a hangnem?”) azonban eredendően szubjektívek. Hogyan tervezhetők megbízható Rubricák ezekre a szubjektív dimenziókra?
★★ A τ-bench valós felhasználói viselkedés szimulálásával értékeli az Ügynököket. De a szimulált felhasználó maga is egy LLM — lehet, hogy szisztematikusan alulbecsüli bizonyos határeseteket (pl. érzelmileg izgatott vagy homályos felhasználók). Hogyan lehet magának a szimulált felhasználónak a minőségét validálni?
★★ A páronkénti összehasonlítás (Bradley-Terry modell) feltételezi a preferenciák tranzitivitását (ha A > B és B > C, akkor A > C). Az emberi preferenciák azonban gyakran megsértik a tranzitivitást. Az Ügynök-kiértékelésben milyen forgatókönyvekben jelenhetnek meg nem tranzitív preferenciák? Hogyan befolyásolja ez a rangsorolások megbízhatóságát?
★★ Ez a fejezet megkülönbözteti a képesség felső korlátját jelző Pass@k-t az üzleti megbízhatóságot mérő Pass consecutive@k-tól. Egy olyan Ágensnél, amelynek egyszeri futásra vett sikeraránya csak 60%, hogyan vonnád össze a feladat hibaköltségét, újrapróbálkozási költségét és mellékhatásait annak eldöntéséhez, hogy melyik metrikát jelentsd és mekkora k-t válassz?
★★ Ez a fejezet a “Megfigyelés → Hipotézis → Kísérlet → Validálás” tudományos módszert javasolja. A gyakorlatban azonban az Ügynök viselkedési tere hatalmas, és egyetlen hipotézis validálásához több száz kiértékelési futtatásra lehet szükség. Hogyan maximalizálható a kiértékelésből nyert információ korlátozott számítási költségkeret mellett?
★ Az AndroidWorld-pilotban a teljes elemfa 25%-ról 100%-ra emelte a sikert, de a tokenhasználatot a kontroll 2.498-szorosára növelte; a metszés megtartotta a 100%-os sikert, miközben 0.506-szorosra csökkentette a tokenhasználatot. Hogyan terveznél automatikus metszési szabályokat, amelyek eltávolítják a szemantikailag üres UI-csomópontokat anélkül, hogy elveszne az akadálymentességhez, állapotellenőrzéshez vagy későbbi műveletekhez szükséges információ?
★★ A τ-bench felhasználó-szimulációja “progresszív információfeltárást” alkalmaz — nem biztosít minden információt egyszerre, hanem fokozatosan tárja fel az Ügynök kérdései alapján. Hogyan befolyásolja ez a tervezés a kiértékelési eredményeket? Ha a szimulált felhasználó információfeltárási stratégiája jelentősen eltér a valós felhasználókétól, a kiértékelési következtetések még mindig megbízhatók?
Lábjegyzetek
Wijk, Hjalmar, et al. RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts. arXiv:2411.15114, 2025. ↩
Ültesd át a gyakorlatba
Kapcsolódó kísérletek
Fedezd fel a fejezethez tartozó kísérleteket, és nézd meg ezeket az ötleteket kódban.