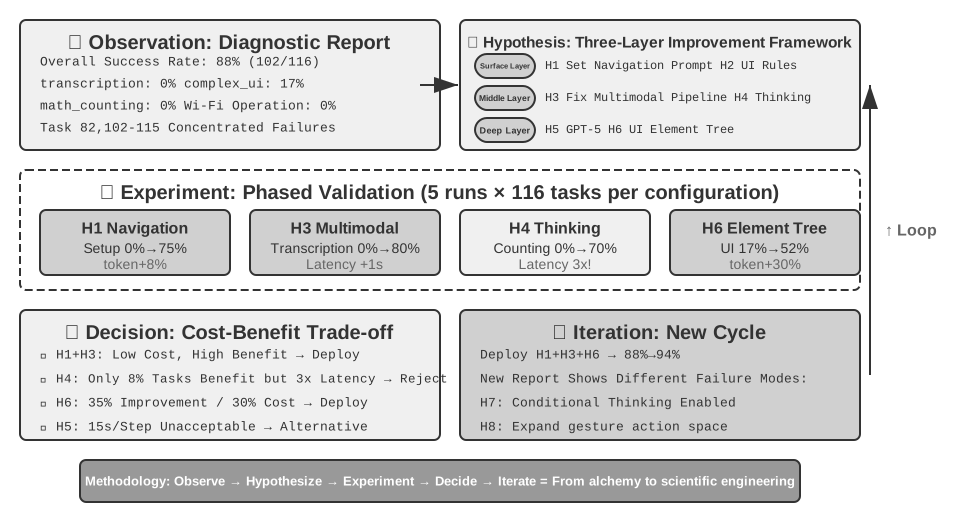
முதல் ஆறு அத்தியாயங்கள் ஒரு ஒற்றை Agent-ஐ எவ்வாறு கட்டமைப்பது என்பதை விரித்துரைத்தன: context, அறிவு, Tools, coding திறன், observation space மற்றும் action space. ஆனால் கட்டமைப்பு முடிந்துவிட்டது என்பதாலேயே அது சரியாகக் கட்டமைக்கப்பட்டது என்று பொருளல்ல; நிலையான அளவீடு இருந்தால்தான் அடுத்தடுத்த மாதிரி training மற்றும் அமைப்பின் பரிணாமத்துக்கு நம்பகமான திசை கிடைக்கும்.
ஒரு ஏஜெண்ட் (Agent) அமைப்பை உருவாக்கும் போது, டெவலப்பர்கள் பல வடிவமைப்புத் தேர்வுகளை எதிர்கொள்கின்றனர், அவற்றில் பெரும்பாலும் தெளிவான சரியான பதில்கள் இல்லை:
எந்த மாதிரியைப் பயன்படுத்துவது?
மாதிரி எந்தக் கருவிகளை அழைக்க அனுமதிப்பது?
அறிவுத் தளத்தில் என்ன தரவைச் சேமிக்க வேண்டும், எந்தக் கட்டமைப்பில் அதை உருவாக்க வேண்டும்?
பயனர் நினைவகத்தை எவ்வாறு செயல்படுத்துவது?
மாதிரியின் Prompt-களையும் Skills-ஐயும் எவ்வாறு ஒழுங்கமைப்பது?
Harness-இல் என்ன கட்டுப்பாடுகளைச் சேர்க்க வேண்டும்?
மதிப்பீட்டு முடிவுகளை Agent-இன் தொடர்ச்சியான பரிணாமத்திற்கான கற்றல் சமிக்ஞைகளாக எவ்வாறு மாற்றுவது?
மதிப்பீடு (Evaluation) நமக்கு முடிவெடுப்பதற்கான ஒரு அறிவியல் அடிப்படையை வழங்குகிறது: முறையான ஒப்பீட்டு பரிசோதனைகள் (ஒரு மாறியை மாற்றி, விளைவைக் கவனித்தல்) மற்றும் நீக்கம் பரிசோதனைகள் (ablation experiments - ஒரு கூறுகளை ஒரு நேரத்தில் முடக்கி, ஒட்டுமொத்த செயல்திறன் மாற்றத்தைக் கவனித்து, அந்தக் கூறின் உண்மையான பங்களிப்பைத் தீர்மானித்தல்) மூலம், உண்மையான திறன் மேம்பாடுகளை மேலோட்டமான ஏற்ற இறக்கங்களிலிருந்து வேறுபடுத்தி அறியலாம்; சிறு செலவைச் சேமிக்கப் போய்ப் பெரும் நட்டம் அடையும் தவறையும் தவிர்க்கலாம். மென்பொருள் பொறியியலில் சொல்வது போல், “நீங்கள் அளவிடாததை மேம்படுத்த முடியாது” — மீண்டும் செய்யக்கூடிய மதிப்பீட்டு அமைப்பு இல்லாமல், ஏஜெண்டின் மறுசெயல் திசையானது உள்ளுணர்வை மட்டுமே நம்பியிருக்க முடியும்.
அத்தியாயம் 1-ல் அறிமுகப்படுத்தப்பட்ட Harness பொறியியலின் கண்ணோட்டத்தில், மதிப்பீடு (evaluation) Harness-க்குள் “சரிபார்ப்பின்” (verification) மையப் பங்கை வகிக்கிறது. ஒரு முக்கியமான நுண்ணறிவு: மதிப்பீட்டின் பொருள் வெறும் மாதிரி (model) மட்டுமல்ல, மாதிரி மற்றும் Harness-இன் கலவையாகும். ஒரே மாதிரி வெவ்வேறு Harness-களில் முற்றிலும் மாறுபட்ட செயல்திறனை வெளிப்படுத்தலாம் — சில குழுக்கள், Harness-ஐ மேம்படுத்துவதன் மூலம் மட்டுமே, அதே மாதிரியின் முனையப் பணிகளில் (terminal tasks) செயல்திறனை கணிசமாக மேம்படுத்தியுள்ளன (விவரங்களுக்கு அத்தியாயம் 5-ஐப் பார்க்கவும்). இதன் பொருள், ஒரு ஏஜெண்ட் (Agent) மதிப்பீட்டில் மோசமாக செயல்படும்போது, மேம்பாட்டுத் திசை மாதிரியை மாற்றுவதாக இருக்க வேண்டியதில்லை, மாறாக Harness-இன் சில கூறுகளை (prompts, tool design, feedback loops) மேம்படுத்துவதாக இருக்கலாம். ஒரு நல்ல மதிப்பீட்டு அமைப்பு, அடிப்படையில் வேறுபட்ட இரண்டு வகையான சிக்கல்களை வேறுபடுத்திக் காட்ட வேண்டும்: “போதுமான மாதிரித் திறன் இல்லாமை” மற்றும் “Harness வடிவமைப்புக் குறைபாடுகள்”. இந்த இரண்டு வகையான சிக்கல்களையும் வேறுபடுத்துவதற்கான ஒரு பொதுவான முறை மாதிரி மாற்றுப் பரிசோதனை (model swap experiment) ஆகும் — Harness-ஐ நிலைப்படுத்தி, மாதிரியை மட்டும் வலிமையான/பலவீனமான ஒன்றாக மாற்றி, மதிப்பெண் மாற்றத்தின் அளவைக் கவனிக்கவும்; வலிமையான மாதிரிக்கு மாற்றியும் மதிப்பெண் அதிகரிக்கவில்லை என்றால், தடை Harness-இல் உள்ளது; பலவீனமான மாதிரிக்கு மாற்றும்போது மதிப்பெண் பெரிதும் குறைந்து, மதிப்பெண் மாதிரித் திறனுடன் கணிசமாக ஏற்ற இறக்கமாக இருந்தால், மிக நேரடியான விளக்கம் என்னவென்றால், தடை மாதிரியின் சொந்தத் திறனில் உள்ளது மற்றும் தற்போதைய செயல்திறன் முதன்மையாக மாதிரியால் தீர்மானிக்கப்படுகிறது (இது பணியே கடினமாக இருப்பதாலா அல்லது Harness மாதிரியின் முன் அறிவை (prior knowledge) அதிகமாக நம்பியிருப்பதாலா என்பதை மேலும் பகுப்பாய்வு செய்ய வேண்டும்). முன்பு குறிப்பிடப்பட்ட “நீக்கம் பரிசோதனையிலிருந்து” (ablation experiment) இது வேறுபட்டது என்பதைக் கவனத்தில் கொள்ளவும்: நீக்கம் என்பது Harness-இன் ஒரு கூறுகளை முடக்கி, ஒட்டுமொத்த செயல்திறன் எவ்வாறு மாறுகிறது என்பதைப் பார்ப்பது, அதேசமயம் மாதிரி மாற்றம் என்பது Harness-ஐ நிலைப்படுத்தி, மாதிரியை மட்டும் மாற்றுவது — முந்தையது Harness-இன் உள்ளே எந்தப் பகுதி முக்கியமானது என்பதை அடையாளம் காட்டுகிறது, பிந்தையது தடை மாதிரியிலா அல்லது Harness-இலா என்பதை வேறுபடுத்துகிறது.
மாதிரி பரிணாமம் வேகமாக நிகழும் இந்தக் காலகட்டத்தில் மதிப்பீட்டு அமைப்பின் மதிப்பு மேலும் முக்கியத்துவம் பெறுகிறது. மாதிரித் திறன்கள் இன்னும் வேகமாக வளர்ந்து வருகின்றன, ஆனால் பொது அளவுகோல்களில் (public benchmarks) ஒரு புதிய மாதிரி சிறப்பாக செயல்படுவது, அது உங்கள் குறிப்பிட்ட பணியிலும் சிறப்பாக செயல்படும் என்பதற்கு உத்தரவாதம் அளிக்காது — உண்மையில், செயல்திறன் பின்னடைவு (performance regression) (புதிய பதிப்பு பழையதை விட சில அம்சங்களில் மோசமாக இருப்பது) ஏற்படலாம். உங்கள் சொந்த மதிப்பீட்டுத் தரவுத் தொகுப்பில் (evaluation dataset) முழுமையாகச் சோதித்தால்தான், தரவு சார்ந்த மேம்படுத்தல் முடிவுகளை (data-driven upgrade decisions) எடுக்க முடியும். மேலும், ஒரு விரிவான மதிப்பீட்டு அமைப்பு, “எதிர்கால மாதிரிகளுக்கான தயாரிப்புகளை உருவாக்குதல்” என்பதை ஒரு சாத்தியமான உத்தியாக மாற்றுகிறது — தற்போதைய மாதிரி வணிக ரீதியான பயன்பாட்டிற்கு (commercial deployment) போதுமானதாக இல்லாவிட்டாலும், நீங்கள் தயாரிப்பு மேம்பாட்டை முடித்து, ஒரு மதிப்பீட்டுத் தொகுப்பை நிறுவலாம், புதிய மாதிரிகளின் செயல்திறனைத் தொடர்ந்து கண்காணிக்கலாம், மற்றும் வரம்பு (threshold) எட்டப்பட்டவுடன் உடனடியாக வெளியிடலாம்.
ஒரு மதிப்பீட்டு அமைப்பை நான்கு கண்ணிகளாகப் பிரிக்கலாம்: எது வெற்றி, பணிகள் எங்கிருந்து வருகின்றன, யார் சரிபார்க்கிறார், மதிப்பெண் எப்படி முடிவாக மாறுகிறது. படம் 7-1 இதைக் காட்டுகிறது.
படம் 7-1: ஏஜெண்ட் மதிப்பீட்டு அமைப்பின் நான்கு கண்ணிகள் · மூலப் படம்
ஒரு மதிப்பீட்டுப் பணியின் உள்ளமைப்பு: τ²-bench இன் telecom களம்
முதலில் τ²-bench இன் telecom களத்திலிருந்து ஒரு உண்மையான பணியை முழுமையாகப் பிரித்து ஆய்வோம். τ²-bench என்பது Sierra வெளியிட்ட திறந்த மூலத் திட்டம்; chapter7/tau2-bench-eval/README.md இல் உள்ள கட்டளையைப் பயன்படுத்தி அதை உங்கள் கணினியில் குளோன் செய்த பிறகு, data/tau2/domains/telecom/tasks_small.json எனும் பணிக் கோப்பைத் திறக்கவும்.
பணி வரையறையின் நான்கு கூறுகள்
கீழே அந்தக் கோப்பிலிருந்து ஒரு பணி, படிப்பதற்கு எளிதாகச் சுருக்கப்பட்டுள்ளது.
{ "id": "[mobile_data_issue]airplane_mode_on|user_abroad_roaming_enabled_off", // ஏஜெண்டுக்கு வழங்கப்படும் டிக்கெட் "ticket": "பயனரின் கைபேசி இணையத்தில் இணைய முடியவில்லை; நிலைப்பட்டையில் 'No Service' காட்டப்படுகிறது. வாடிக்கையாளர் John Smith, எண் 555-123-2002, தற்போது பிரான்ஸில் உள்ளார். வேகச் சோதனை excellent எனத் திரும்பினால் மட்டுமே சரிசெய்யப்பட்டதாகக் கருதுவார். திட்டத்தை மாற்ற விரும்பவில்லை; தேவைப்பட்டால் 2.0 GB தரவு நிரப்பச் சம்மதம்.", // பயனர் உருவகப்படுத்தியிடம் வழங்கப்படும் நடத்தை விதிகள் "user_scenario": { "instructions": { "known_info": "You are John Smith with phone number 555-123-2002. You are currently abroad in France.", "unknown_info": null, "task_instructions": "…express mild frustration after the first unsuccessful attempt. You will consider the issue resolved only when speed test returns excellent internet speed and nothing else. If it returns poor, fair or good, you will not consider the issue resolved. Whenever the agent asks you about your device, always ground your responses on the results of tool calls. … Never make up the results of tool calls." }}, // இயக்குவதற்கு முன் இரு பக்க நிலையும் ஒரே தொடக்கப் புள்ளிக்கு மீட்டமைக்கப்படும் "initial_state": { "initialization_actions": [ { "env_type": "user", "func_name": "turn_airplane_mode_on" }, { "env_type": "user", "func_name": "turn_roaming_off" }, { "env_type": "assistant", "func_name": "enable_roaming", "arguments": { "customer_id": "C1001", "line_id": "L1002" } } ]}, // மதிப்பெண் அளவுகோல்கள் "evaluation_criteria": { "actions": [ { "requestor": "user", "name": "toggle_airplane_mode" }, { "requestor": "user", "name": "toggle_roaming" } ], "env_assertions": [ { "func_name": "assert_mobile_data_status", "expected_status": true }, { "func_name": "assert_internet_speed", "expected_speed": 200, "expected_desc": "excellent" } ], "communicate_info": null, "nl_assertions": null, "reward_basis": ["ENV_ASSERTION"] }}
இந்த வரையறையில் விரிவாகச் சொல்ல வேண்டிய நான்கு வடிவமைப்பு முடிவுகள் உள்ளன.
பயனரின் அறிவெல்லை வெளிப்படையாக மாதிரியாக்கப்பட்டுள்ளது.known_info இல் பெயர், தொலைபேசி எண், தங்கியிருக்கும் நாடு — மூன்றே தகவல்கள் மட்டுமே உள்ளன. கோளாற்றின் உண்மையான இரு காரணங்கள் — விமானப் பயன்முறை இயக்கத்தில் இருப்பதும் தரவு ரோமிங் நிறுத்தப்பட்டிருப்பதும் — அதில் இல்லை. பயனருக்கு அவை தெரியாததால் அவரே சொல்ல முடியாது; ஏஜெண்ட் கேள்வி கேட்டும் பயனரைச் சரிபார்க்கச் சொல்லியும் மட்டுமே அவற்றை அறிய முடியும். இதுவே படிப்படியான தகவல் வெளிப்படுத்தல் (Progressive Information Disclosure) பணி வரையறை நிலையில் செயல்படுத்தப்படும் விதம்: “எல்லாவற்றையும் ஒரே முறையில் சொல்லிவிடாதே” என்ற ப்ராம்ப்ட்டால் உருவகப்படுத்தியைக் கட்டுப்படுத்துவதன் மூலம் அல்ல, பயனரின் அறிவெல்லையையே தனி புலமாக மாதிரியாக்குவதன் மூலம். பெரும்பாலான தரவரிசைச் சோதனைகள் பணியின் தொடக்கத்திலேயே முழுத் தேவையையும் தந்துவிடுகின்றன; ஆனால் உண்மையான பயனரின் முதல் வாக்கியம் பொதுவாக “இணையம் வேலை செய்யவில்லை” என்பதற்கு மேல் இருப்பதில்லை. கோரிக்கையைச் செயல்படுத்தக்கூடிய அளவுக்குத் தெளிவுபடுத்துவதே ஏஜெண்ட் அறிந்திருக்க வேண்டிய திறனின் ஒரு பகுதி.
உருவகப்படுத்தி பெறுவது வசனம் அல்ல, நடத்தை விதி.task_instructions இல் மூன்று வகைக் கட்டுப்பாடுகள் கலந்துள்ளன: உணர்வு அமைப்பு (முதல் சரிசெய்தல் முயற்சி தோல்வியடைந்த பின் லேசான அதிருப்தி காட்ட வேண்டும்), ஏற்பு அளவுகோல் (வேகச் சோதனை excellent எனத் திரும்பினால் மட்டுமே தீர்க்கப்பட்டதாகக் கருத வேண்டும்; poor, fair, good அனைத்தும் ஏற்கப்படாது), மற்றும் உண்மைநிலை நங்கூரமிடல் (Grounding) தேவை — சாதன நிலை பற்றிய எந்தப் பதிலும் கருவி திருப்பியளித்த மதிப்பை அடிப்படையாகக் கொண்டிருக்க வேண்டும்: “Never make up the results of tool calls”. மூன்றாவதே மிக முக்கியமானது: நங்கூரக் கட்டுப்பாடு இல்லாவிட்டால், உருவகப்படுத்தப்பட்ட பயனர் ஏஜெண்டின் வழிநடத்தலைப் பின்பற்றிச் சிக்கல் தீர்ந்துவிட்டதாக உறுதிப்படுத்திவிடுவார்; மதிப்பீடு இரு மாதிரிகள் ஒன்றையொன்று அங்கீகரிப்பதாகச் சரிந்துவிடும்.
தொடக்க நிலை கட்டுப்படுத்தும் பக்கத்தின்படி பிரிக்கப்பட்டுள்ளது.env_typeuser, assistant என இரு மதிப்புகளை எடுக்கிறது: விமானப் பயன்முறையும் ரோமிங் சுவிட்சும் பயனர் பக்கத்துக்கும், சேவை வழங்குநர் பக்கத்தின் enable_roaming ஏஜெண்ட் பக்கத்துக்கும் உரியவை. இந்தப் பிரிவே கோளாற்றின் வடிவத்தை நிர்ணயிக்கிறது: வழங்குநர் பக்கத்தில் ரோமிங் இயக்கப்பட்டுள்ளது, ஆனால் பயனர் சாதனத்தில் நிறுத்தப்பட்டுள்ளது; எனவே ஏஜெண்ட் தரவுத்தளத்தை வினவினால் “அமைப்பு சரியாக உள்ளது” என்ற முடிவுதான் கிடைக்கும். கோளாறு தரவுத்தளத்துக்குத் தெரியாத பக்கத்தில் உள்ளது; பயனரைச் சரிபார்க்கச் சொன்னால் மட்டுமே அது வெளிப்படும்.
மதிப்பெண் அளவுகோல்கள் நான்கு அடுக்குகளாகப் பிரிக்கப்பட்டுள்ளன; இந்தப் பணி அவற்றுள் ஒன்றை மட்டுமே பயன்படுத்துகிறது.env_assertions இறுதி நிலையைச் சரிபார்க்கிறது (மொபைல் தரவு கிடைக்கிறது, வேகம் 200 Mbps க்கு மேல், தரம் excellent), actions முக்கிய செயல்கள் நிகழ்ந்தனவா என்பதையும் எந்தப் பக்கம் செய்தது என்பதையும் சரிபார்க்கிறது, communicate_info மற்றும் nl_assertions தேவையான தகவல் பயனருக்குத் தெரிவிக்கப்பட்டதா எனச் சரிபார்க்கின்றன. இந்தப் பணியின் reward_basisENV_ASSERTION ஐ மட்டுமே அறிவிக்கிறது; மற்ற அடுக்குகள் வழக்கம்போல் கணக்கிடப்பட்டுப் பதிவாகின்றன, ஆனால் இறுதி வெகுமதியில் சேர்வதில்லை. மதிப்பெண் அடிப்படை ஒவ்வொரு பணிக்கும் தனித்தனியே அறிவிக்கப்படுகிறது; உலகளாவிய நிலையில் நிலைநிறுத்தப்படுவதில்லை.
ஒரு உண்மையான இயக்கத்தின் trajectory
இனி வாசகர் τ²-bench இன் telecom களத்தின் மதிப்பீட்டுப் பணிகளைத் தாமே இயக்கி, பணி வடிவமைப்பு, பயனர் உருவகப்படுத்தி, செயல்முறை மற்றும் முடிவு சரிபார்ப்பு தர்க்கம் ஆகியவற்றைக் கவனித்து, ஏஜெண்டின் செயலாக்க trajectory ஐப் பார்த்து அது ஏன் தோல்வியடைந்தது என்பதை ஆய்வு செய்யுமாறு கேட்டுக்கொள்கிறோம்.
சோதனை 7-1 ★: τ²-bench ஐ இயக்கி τ-bench இலிருந்து அதன் வளர்ச்சியை ஒப்பிடுதல்
இச்சோதனை τ²-bench மதிப்பீட்டுக் கட்டமைப்பை இயக்கி, மனித-கணினி இடைவினை வகை மதிப்பீட்டுச் சூழலின் வடிவமைப்பு முக்கியப் புள்ளிகளைப் புரிந்துகொள்கிறது. முதலில் இப்பகுதியில் கடந்த அதே பாதையில் பணி வரையறைக் கோப்பை முழுமையாகப் படியுங்கள்: ஒவ்வொரு பணியும் அறியப்பட்ட தகவல், பணி வழிமுறைகள், தொடக்க நிலை, வெற்றி நிபந்தனைகள் என நான்கு பகுதிகளைக் கொண்டது. பின்னர் முழு மதிப்பீட்டு ஓட்டத்தையும் இயக்கி, பயனர் உருவகப்படுத்திக்கும் ஏஜெண்டுக்கும் இடையிலான பல சுற்று உரையாடலைக் கவனித்து, வழக்கமான தோல்வி வடிவங்களை (கொள்கை மீறல், தகவல் விடுபடல், மனித முகவரிடம் அதிகமாக மாற்றுதல் போன்றவை) ஆய்வு செய்யுங்கள்.
படம் 7-3: τ²-bench இல் இரட்டைக் கட்டுப்பாட்டுச் சூழலும் அடுக்குவாரிச் சரிபார்ப்பும் · மூலப் படம்
இணைக் களஞ்சியத்தில் ஒரு இயக்கப் பதிவு (chapter7/tau2-bench-eval) சேமிக்கப்பட்டுள்ளது. அதிலிருந்து வெற்றி பெற்ற ஒரு இயக்கத்தை இங்கே ஆய்வு செய்வோம்.
முதல் பத்துக்கும் மேற்பட்ட சுற்றுகள் கணக்கு அடையாளம் காணும் கட்டம். ஏஜெண்ட் எண்ணிலிருந்து வாடிக்கையாளர் C1001 ஐக் கண்டறிந்து, பின் L1001, L1002, L1003 ஆகிய மூன்று இணைப்புகளின் தரவுப் பயன்பாட்டை ஒவ்வொன்றாக வினவி, பயனர் பிரான்ஸில் உண்மையில் எந்த எண்ணைப் பயன்படுத்துகிறார் எனத் திரும்பக் கேட்கிறது. 17-ஆவது செய்தியில் அது தவறான முடிவுக்கு வருகிறது:
ஏஜெண்ட் (17): 555-123-2002 எண் உங்கள் செயலிலுள்ள இணைப்புகளில் இல்லை; மிக நெருக்கமானது 555-123-2001…
இந்த முடிவு L1001 என்ற ஒரே இணைப்பின் வினவலை மட்டுமே சார்ந்தது. எண் சரியானதுதான் என்று பயனர் உறுதியாகச் சொன்ன பிறகு, ஏஜெண்ட் L1002 ஐ வினவி அப்போதுதான் பொருத்திப் பார்க்கிறது. தீர்க்கமான திருப்பம் 30-ஆவது செய்தியில் வருகிறது:
பயனர் (30) → check_network_status(), check_status_bar() ஐ அழைக்கிறார்
கருவியின் திருப்பம் (31): Airplane Mode: ON | Cellular Connection: no_service | Mobile Data Enabled: Yes | Data Roaming Enabled: No
பயனர் (33): கைபேசி இப்போது விமானப் பயன்முறையில் இருப்பதைப் பார்க்கிறேன்; அதனால்தான் சிக்னல் இல்லை. மொபைல் தரவு இயக்கத்தில் உள்ளது, ஆனால் தரவு ரோமிங் நிறுத்தப்பட்டுள்ளது. விமானப் பயன்முறையை நிறுத்திப் பார்க்கவா?
கருவி அழைப்பை வெளியிட்டது பயனர், ஏஜெண்ட் அல்ல. இதுவே இரட்டைக் கட்டுப்பாடு (Dual-Control) எனும் நுட்பம்: உருவகப்படுத்தப்பட்ட பயனரிடம் check_status_bar, toggle_airplane_mode, reseat_sim_card, run_speed_test போன்ற தனி கருவித் தொகுப்பு உள்ளது.
அதன் பிறகான ஆய்வு சுமூகமாக நகர்கிறது: ஏஜெண்ட் பயனரை விமானப் பயன்முறையை நிறுத்தி ரோமிங்கை இயக்கச் சொல்கிறது, பயனர் இரண்டையும் செய்கிறார் (35, 37), நிலைப்பட்டை முழு சிக்னலுடன் 5G ஆக மாறுகிறது; ஏஜெண்ட் வேகச் சோதனை கேட்க, 275 Mbps, தரம் Excellent எனத் திரும்புகிறது (46), பயனர் சிக்கல் தீர்ந்ததை உறுதிப்படுத்துகிறார். இரண்டு env_assertions ம் தேறுகின்றன; reward = 1.0.
முழு மதிப்பெண் பெற்ற இந்த trajectory இல் சரிபார்ப்பான் பிடிக்காத ஒரு சிக்கலும் உள்ளது. telecom ஏஜெண்ட் கொள்கையின் முதல் பத்தியே “You should only make one tool call at a time” எனக் குறிப்பிடுகிறது; ஆனால் 4-ஆவது செய்தியில் ஏஜெண்ட் get_customer_by_phone, get_customer_by_name ஆகிய இரு அழைப்புகளையும் ஒரே முறையில் வெளியிட்டது. சரிபார்ப்பான் அதைப் பிழையெனக் கருதவில்லை; காரணம், இந்தப் பணியின் reward_basis இறுதி நிலையை மட்டுமே கணக்கில் கொள்கிறது. இது τ²-bench இன் கவனக்குறைவு அல்ல; இருநிலை வெகுமதியின் இயல்பான விலை: மாதிரிகளுக்கிடையே ஒப்பிடத்தக்க ஒற்றை எண்ணுக்காகச் செயல்முறையின் நுட்பத்தை அது பரிமாறிக்கொள்கிறது. ஆனால் உற்பத்திச் சூழலின் மதிப்பீட்டு அமைப்புகளுக்கு வழக்கமாக இதற்கு மேலும் தேவைப்படுகிறது: சரியா தவறா என்று தீர்ப்பதோடு நில்லாமல், சிக்கல் எங்கே இருக்கிறது என்பதையும் சுட்ட வேண்டும்.
தோல்வியடைந்த பணியும் ஆய்வுக்கு உரியது. பயனரின் எண் 555-123-2002; ஆனால் ஏஜெண்ட் L1001 இணைப்பைத் தேர்ந்தெடுத்து, அதன் 3.2/5 GB பயன்பாட்டை அடிப்படையாகக் கொண்டு தொடர்ந்து ஊகித்தது. இடையில் get_details_by_id(L1001) அந்த இணைப்பின் எண் 555-123-2001 என்று தெளிவாகத் திருப்பியது; ஏஜெண்ட் அந்த முடிவைப் படித்தும் தன் தீர்ப்பைத் திருத்தவில்லை, பின் தொடர்பற்ற ஆய்வுகளில் பல பத்து செய்திகளைச் செலவிட்டு, இறுதியில் மனித முகவரிடம் மாற்றியது. உண்மையில் பணியின் பாதியைச் செய்துவிட்டது — பயனரைத் தரவுச் சிக்கனப் பயன்முறையை நிறுத்தச் செய்தது, அந்தப் பயனர் பக்கச் செயல் உண்மையில் நிகழ்ந்து சூழலால் சரிபார்க்கப்பட்டது. ஆனால் இணைப்புத் தேர்வுப் பிழையால் தேவைப்பட்ட 2 GB நிரப்புதல் நிகழவில்லை; மூன்று இறுதி நிலை உறுதிமொழிகளும் தோல்வியடைந்தன. இந்தத் தோல்வியின் வடிவம் பின்னால் “தோல்விக் காரணம் கண்டறிதல்” பகுதியில் விவாதிக்கப்படும் AndroidWorld வழக்குடன் மிகவும் ஒத்திருக்கிறது: தீர்ப்பைத் திருத்தத் தேவையான சான்று ஏற்கெனவே சூழலுக்குள் வந்துவிட்டது, ஆனால் ஏஜெண்ட் அதை வைத்துத் திரும்பிப் பார்க்கவில்லை.
இந்த ஒரே பணி, ஒரு மதிப்பீட்டுத் தொகுப்பு பதிலளிக்க வேண்டிய அனைத்துக் கேள்விகளையும் ஏற்கெனவே எழுப்பிவிட்டது: எது வெற்றி, பணிகள் எங்கிருந்து வருகின்றன, யார் சரிபார்க்கிறார், மதிப்பெண் எப்படி முடிவாக மாறுகிறது. அடுத்த பகுதிகள் இவற்றை வரிசையாக விரிக்கின்றன.
மதிப்பீட்டு அளவீடுகள்: வெற்றியின் வரையறை
முந்தைய பகுதியின் மதிப்பீட்டு முடிவு ஐந்து பணிகளில் நான்கு தேறியது. 0.8 என்ற எண்ணை மட்டும் வைத்து அந்த அமைப்பு பயன்படுத்தக்கூடியதா என்று தீர்மானிக்க முடியாது. அது பணத்தைத் திரும்பத் தரும் வாடிக்கையாளர் சேவை ஏஜெண்ட் என்றால், ஐந்து பயனர்களில் ஒருவருக்குச் சேர வேண்டிய தொகை சேராது என்பது பொருள்; பாதுகாப்புக் குறைபாடுகளைத் தேடும் ஏஜெண்ட் என்றால், ஐந்தில் நான்கு வெற்றி என்பது நன்றாகவே இருக்கிறது. வேறுபாடு, அந்த வணிகச் சூழல் எவ்வளவு உயர்ந்த வெற்றி விகிதத்தைக் கோருகிறது என்பதில் உள்ளது.
தொழில்நுட்ப அதிசயம்: Pass@k மூலம் திறன் உச்சம்
இன்றைய பல மாதிரிகளும் Agent-களும் “தொழில்நுட்ப அதிசயம்” என்று அழைக்கத்தக்க நிலையிலேயே உள்ளன. இங்கு அதிசயம் என்பது ஏராளமான முயற்சிகள், தாராளமான கால அவகாசம், மனிதத் தேர்வு ஆகியவற்றின் கீழ் வெளிப்படும் திறன் உச்சவரம்பு: அவற்றுள் ஒரு முறை வெற்றி பெற்றாலே “இது கொள்கையளவில் சாத்தியம்” என்பதை நிறுவப் போதும். இதுவே Pass@k இன் தர்க்கம் — ஒரே பணியை k முறை இயக்கி, குறைந்தது ஒரு முறை தேறினால் பணி தேறியதாகக் கொள்ளப்படுகிறது; வெளியீடு தொடர் மதிப்பெண்ணாக இருந்தால் சிறந்த ஒன்றை எடுத்து அதை Best@k என்கிறோம்.
நீண்ட நேரம் இயங்கும் Agent-கள் குறித்த Anthropic-இன் விவாதம் இத்தகைய உச்சவரம்பை நன்கு காட்டுகிறது: Agent-ஐ ஒரு வாரம் தன்னிச்சையாக வேலை செய்யவிட்டு பூஜ்யத்திலிருந்து ஒரு C தொகுப்பியை எழுதச் செய்வது; ஒரு முக்கிய கணிதக் கருதுகோளுக்கு எதிர் உதாரணம் கிடைக்கும் வரை தேடலைத் தொடரச் செய்வது; அல்லது திறந்த மூல மென்பொருளை மீண்டும் மீண்டும் ஆய்வு செய்து, பல பத்தாண்டுகளாக அங்கேயே இருந்த ஒரு பெரும் பாதுகாப்பு ஓட்டையைக் கண்டறியச் செய்வது.
இத்தகைய பொறியியல் மற்றும் ஆய்வு ரீதியான தேடலில் காட்டப்படுவது பொதுவாக “ஒவ்வொரு முறையும் சரியாகச் செய்வது” அல்ல; தேடல் நிதி போதுமான அளவு நீட்டப்பட்ட பிறகு இறுதியில் தோன்றும் ஒரே ஒரு திருப்புமுனைத் தடமே ஆகும். அறிவியல் கண்டுபிடிப்பு, பாதிப்பு வேட்டை, திறந்தநிலை படைப்பு போன்ற பணிகளுக்கு இந்த உச்சவரம்பே மதிப்புமிக்கது: k வேட்பாளர் தடங்களில் சிறந்த ஒன்றை மனிதர் தேர்ந்தெடுக்க முடியும்.
அடிப்படை மாதிரி ஆய்வகங்களைத் தவிர, பல செயலி நிறுவனங்களும் “தொழில்நுட்ப அதிசய” உத்தியைப் பயன்படுத்துகின்றன. Manus பரவலான கவனத்தை ஈர்த்ததற்குக் காரணம், அது ஒரு மெய்நிகர் கணினியை மக்கள் கையில் கொடுத்ததுதான்: Agent பற்றி நேரடி உணர்வே இல்லாதவர்கள், AI-யும் மனிதனைப் போலவே கணினியை இயக்கி, அரை மணி நேரம் அல்லது ஒரு மணி நேரம் தொடர்ந்து வேலை செய்து, சிக்கலான பணியைப் படிப்படியாக முடிக்க முடியும் என்பதைக் கண்டனர்.
OpenClaw பலருக்கு முதன்முறையாக ஒரு Agent-இன் “உயிரோட்டத்தை” உணரச் செய்தது. நிஜ மனிதருக்கு வேலை ஒப்படைப்பது போலவே பயனர் உடனடித் தகவல் செயலி வழியாக அதற்குப் பணி ஒதுக்கலாம்; கணினியிலுள்ள அனைத்துக் கோப்புகளையும் இணையச் சேவைகளையும் அது அணுக முடியும், ஒரு கட்டத்தை அடைந்ததும் தானாகவே பின்னூட்டம் தரும் அல்லது புதிய தகவலைக் கேட்கும், மேலும் தானே விழித்தெழுந்து மின்னஞ்சலைப் பார்த்துக் கையாளவும் கூடும்.
தொடக்கக் கால Manus-உம் OpenClaw-ம் சிக்கலான பணிகளில் உயர்ந்த வெற்றி விகிதத்தைக் கொண்டிருக்கவில்லை, token செலவும் மிக அதிகமாக இருந்தது. ஆனால் இந்த Agent கட்டமைப்புகள் பொதுநோக்கு கொண்டவை என்பதால், வலிமையான மாதிரிகளுடன் சேரும்போது சிக்கலான பணிகளில் Pass@k உயர்வாகவே அமைவது வழக்கம்; அதுவே உயர்ந்த தொழில்நுட்ப உச்சவரம்பைக் காட்டுகிறது. இந்த “தொழில்நுட்ப அதிசயங்கள்” சமூக வலைத்தளங்களில் பரவலாகப் பகிரப்பட்டதே இந்தத் தயாரிப்புகளின் வெற்றிக்கு முக்கியக் காரணம்.
வணிக நம்பகத்தன்மை: Pass^k
நிஜமான வணிகம் பொதுவாக அதற்கு நேர்மாறானதைப் பற்றியே கவலைப்படுகிறது: பல முயற்சிகளில் ஒரு முறை கூட தவறு நேரக்கூடாது. இந்த இலக்கை நாம் Pass^k (Pass consecutive k என்று படிக்கலாம்) என்கிறோம்: ஒரே பணியைத் தொடர்ச்சியாக k முறை இயக்கி, ஒவ்வொரு முறையும் தேற வேண்டும், மேலும் பாதுகாப்பு, இணக்கம் அல்லது மாயத்தோற்றம் போன்ற எந்த ஒரு தடுப்புரிமை உருப்படியையும் தூண்டக் கூடாது. “Agent நிலையாகவும் நம்பகமாகவும் வழங்க முடியுமா” என்பதற்கே இது பதிலளிக்கிறது; “அவ்வப்போது அற்புதம் நிகழ்த்த முடியுமா” என்பதற்கு அல்ல.
ஒவ்வொரு இயக்கமும் ஒன்றையொன்று சாராமல் இருந்து, ஒரு முறை வெற்றி விகிதம் p எனில், இரு அளவீடுகளின் உறவு நேரடியானது:
Pass@k=1−(1−p)k,Passk=pk.
உதாரணமாக ஒரு முறை வெற்றி விகிதம் p=0.6, k=5 எனும்போது: Pass@5 =1−0.45≈99.0% — “குறைந்தது ஒரு முறையாவது வெற்றி” எப்போதும் கிட்டுவது போலத் தோன்றும். ஆனால் Pass consecutive@5 =0.65≈7.8%; அதாவது ஐந்து முறை தொடர்ச்சியாகத் தவறின்றித் தேறுவது இன்னும் கடினம். முதல் எண் தேடல் கட்டத்தின் திறன் உச்சவரம்பை அளக்கப் பொருத்தமானது; கட்டணம், பணத் திரும்பப் பெறுதல், அனுமதி மாற்றம், உற்பத்திச் சூழல் வெளியீடு போன்றவற்றின் நம்பகத்தன்மைத் தேவைக்கு நெருக்கமானது இரண்டாவது எண் மட்டுமே.
k முயற்சிகள் என்பதன் பொருளை மதிப்பீட்டு அறிக்கை தெளிவாக எழுத வேண்டும்: ஒரே பணியின் k தனித்தனி மாதிரிகளா, அல்லது உற்பத்தி வழித்தடத்தில் தொடர்ச்சியான k பணிகளா என்பதை. பக்கவிளைவுகளை ஏற்படுத்தும் செயல்களுக்கு “வெற்றி பெறும் வரை மீண்டும் முயலுதல்” என்பது ஏற்புடையது அல்ல; sandbox அல்லது பின்னோக்கி மீட்கக்கூடிய சூழலில் மாதிரி எடுக்க வேண்டும், ஒவ்வொரு தோல்வியையும் நம்பகத்தன்மை அளவீட்டில் பதிவு செய்ய வேண்டும்.
மதிப்பீட்டுச் சூழல்
அளவீட்டு அடிப்படை தெளிவானதும், அடுத்த கேள்வி எங்கே அளப்பது. மதிப்பீட்டுச் சூழல் என்பது மீண்டும் மீண்டும் இயக்கக்கூடிய ஒரு அமைவு: ஒரே தொடக்க நிலை கொடுக்கப்பட்டால், அதே ஏஜெண்ட் ஒப்பிடத்தக்க முடிவுகளைத் தர வேண்டும்.
ஐந்து கூறுகள்
மேலே பிரித்து ஆய்ந்த telecom பணிக்குத் திரும்புவோம். அதை அளவுகோலாகக் கொண்டால், மீண்டும் இயக்கக்கூடிய மதிப்பீட்டுச் சூழலுக்குத் தேவையானவை ஏற்கெனவே முழுமையாக உள்ளன.
தரவுத்தொகுப்பு (Dataset) என்பது பணிக் கோப்பே: தொடக்க நிலை, ஏஜெண்டுக்கான டிக்கெட், உருவகப்படுத்திக்கான நடத்தை விதிகள், ஏற்பு அளவுகோல்கள் — அனைத்தும் ஒரே பதிவாகத் தொகுக்கப்பட்டுள்ளன; ஒரு பதிவே ஒரு சோதனை வழக்கு.
சூழல் நிலை (Environment State) என்பது பணி இயங்கும்போது மாறும் தகவல்: தரவுத்தளத்தில் உள்ள வாடிக்கையாளர்கள், இணைப்புகள், திட்டங்கள், கட்டணப் பட்டியல்கள்; அத்துடன் சாதனப் பக்கத்தில் விமானப் பயன்முறை, ரோமிங், தரவுச் சிக்கன சுவிட்ச், மீதமுள்ள தரவு. இது மீட்டமைக்கக்கூடியதாக இருக்க வேண்டும்; initialization_actions தான் அந்த மீட்டமைப்பு ஸ்கிரிப்ட். உண்மைத்தன்மை நிலை மாற்றங்கள் வணிக தர்க்கத்தைப் பின்பற்ற வேண்டும் எனக் கோருகிறது; கட்டுப்படுத்தல் ஒவ்வொரு இயக்கத்துக்கும் முன் அதே தொடக்கப் புள்ளிக்குத் திரும்ப முடிய வேண்டும் எனக் கோருகிறது.
கருவி இடைமுகம் (Tools) இரு பக்கங்களாகப் பிரிந்துள்ளது. ஏஜெண்ட் வாடிக்கையாளர் வினவல், பயன்பாட்டு வினவல், தரவு நிரப்புதல், மனித முகவரிடம் மாற்றுதல் போன்ற வழங்குநர் பக்கச் செயல்களை அழைக்க முடியும்; பயனர் தன் சாதனத்தின் சுவிட்சுகளை இயக்க முடியும். இரு கருவித் தொகுப்புகளும் அணு அளவிலான செயல்கள்; “பயனரின் இணையச் சிக்கலைத் தீர்” போன்ற உயர்நிலைச் சுருக்கம் இல்லை — சுருக்க நிலை மிக உயர்ந்தால் மதிப்பீடு ஒற்றைச் செயற்கூறு அழைப்பைச் சோதிப்பதாகச் சுருங்கிவிடும், திட்டமிடலும் ஊகமும் கருவிக்குள்ளேயே உள்வாங்கப்பட்டுவிடும்.
மதிப்பெண் அளவுகோல் (Rubric) என்பது evaluation_criteria இன் நான்கு அடுக்குச் சோதனைகளும், reward_basis எனும் தொகுப்பு விதியும் சேர்ந்தது.
செயலாக்க நெறிமுறை (Interaction Protocol) இடைவினையின் வரிசையையும் நிறைவு நிபந்தனைகளையும் வரையறுக்கிறது. இங்கு இயல்பான நிறைவுச் சமிக்ஞை உருவகப்படுத்தப்பட்ட பயனர் ###STOP### ஐ வெளியிடுவது; அத்துடன் சுற்று வரம்பும் உண்டு, மேலும் பொறுமை தீர்ந்தால் உருவகப் பயனர் உரையாடலைத் தானே முடித்துக்கொள்ளலாம் — தொடர்பு திறன் மிகக் குறைவாக இருப்பதே தோல்வியாகக் கணக்கிடப்படுகிறது.
ஐந்து கூறுகளில் ஒன்று குறைந்தாலும் மதிப்பீடு மீண்டும் இயக்கக்கூடிய சுழற்சியாக அமையாது. கீழே பிற தரவரிசைச் சோதனைகளை ஆராயும்போதும் இந்த ஐந்து அம்சங்களையே ஒப்பீட்டுச் சட்டகமாகக் கொள்வோம்.
மனித-கணினி இடைவினை மற்றும் கருவி அழைப்பு வகை மதிப்பீட்டுச் சூழல்கள்
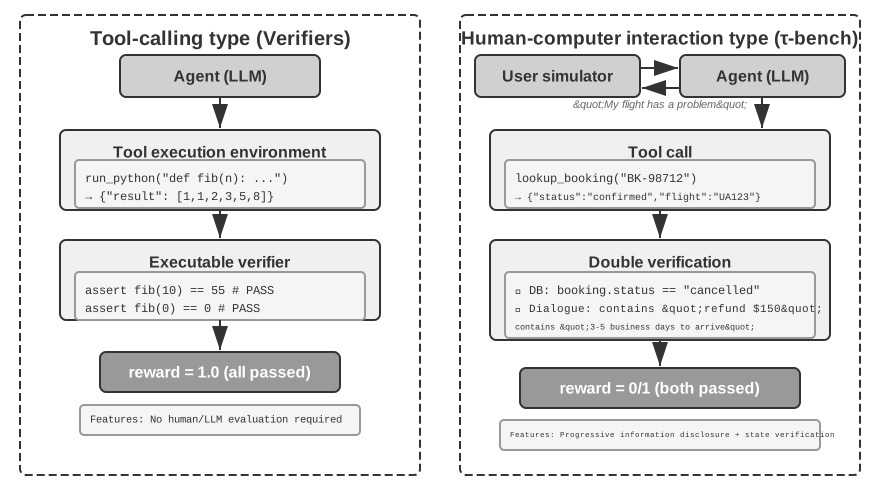
telecom போன்ற பணிகளுக்கு இடைவினைத் துணை கட்டாயம் தேவை; எனவே ஐந்து கூறுகளில் பயனர் உருவகப்படுத்தல் பகுதி இன்றியமையாதது. உரையாடல் துணையே இல்லாத மற்றொரு பெரும் பணி வகையும் உண்டு: குறியீடு உருவாக்கம், தரவுப் பகுப்பாய்வு, கணிதத் தீர்வு போன்றவற்றில் ஏஜெண்ட் தொடக்கம் முதல் இறுதி வரை கருவிகளுடன் மட்டுமே இடைவினைபுரிகிறது; சரியா தவறா என்பதைச் செயலாக்கச் சரிபார்ப்பில் தேறுகிறதா என்பதே தீர்மானிக்கிறது; மனித விளக்கக்குறிப்போ மாதிரியின் தீர்ப்போ தேவையில்லை. இவ்வகைச் சூழல்கள் பயனர் உருவகப்படுத்தியைத் தவிர்க்கின்றன; மீதமுள்ள நான்கு கூறுகள் இன்னும் இருக்கின்றன, வடிவம் மட்டுமே எளிமையானது: சூழல் நிலை என்பது கோப்பு முறைமையோ தரவுத்தளமோ, மதிப்பெண் அளவுகோல் என்பது ஒரு துண்டு சோதனைக் குறியீடு, செயலாக்க நெறிமுறை “பதில் தரும் வரை அல்லது சுற்றுகள் தீரும் வரை கருவிகளைத் தொடர்ந்து அழை” எனச் சுருங்குகிறது.
Verifiers கட்டமைப்பு இவ்வகைச் சூழல்களை இரு பரிமாணங்களில் அடுக்குகிறது: பணி சுற்றுகளுக்கு இடையே நிலையைத் தக்கவைக்க வேண்டுமா, தனிமைப்படுத்தல் தேவையா. SingleTurnEnv ஒரு கணிதக் கேள்வி கேட்டு விடையை நேரடியாகச் சரிபார்க்கப் பொருந்தும்; ToolEnv பல வலைப்பக்கங்களைத் தேடித் தொகுத்துப் பதிலளித்து இறுதி முடிவைச் சரிபார்க்கப் பொருந்தும்; StatefulToolEnv தரவுத்தளப் பதிவை மாற்றி நிலை மாற்றத்தைச் சரிபார்க்கப் பொருந்தும்; SandboxEnv மணற்பெட்டியில் குறியீட்டை இயக்கி வெளியீட்டுக் கோப்புகளைச் சோதிக்கப் பொருந்தும். அட்டவணை 7-1 இந்நான்கு வகைகளையும் தொகுக்கிறது; பணி நிலை, கருவி அழைப்பு, தனிமைப்படுத்தல் தேவைகளுக்கேற்பத் தேர்ந்தெடுக்க உதவும்.
அட்டவணை 7-1 Verifiers சூழல் வகைகளின் ஒப்பீடு
சூழல் வகை
நிலை தக்கவைப்பு
கருவி அழைப்பு
வழக்கமான பயன்பாடு
SingleTurnEnv
இல்லை
இல்லை
ஒரு சுற்றுக் கேள்வி-பதில், கணிதம்
ToolEnv
இல்லை
பல சுற்று
தேடல் + தகவல் தொகுப்பு
StatefulToolEnv
உண்டு
பல சுற்று
தரவுத்தளப் பதிவு மாற்றம்
SandboxEnv
உண்டு + தனிமை
பல சுற்று
குறியீடு இயக்கமும் சோதனையும்
இந்தக் கட்டமைப்பு இணைச் சாம்பிளிங்கையும் trajectory தேக்ககத்தையும் ஆதரிக்கிறது; ஒவ்வொரு மதிப்பீட்டின் முழு trajectory (கவனிப்பு, செயல், வெகுமதி) சேமிக்கப்படுகிறது; பிற்பாடு ஆய்வும் மறுஇயக்கமும் எளிதாகும். மேலும், கருவியின் செயலாக்க விளைவு தற்போதைய நிலையைச் சார்ந்தது; எனவே தோல்வியின்போது வெறும் தோல்விக் கொடி அல்லாமல் தெளிவான பிழைச் செய்தியைத் திருப்ப வேண்டும் — அப்போதுதான் ஏஜெண்ட் தன் உத்தியை அதற்கேற்ப மாற்ற முடியும்.
கருவி அழைப்பு வகை மதிப்பீடு கவனிக்கக்கூடிய நிலை மாற்றங்களின் சரித்தன்மையை ஆராய்கிறது; மனித-கணினி இடைவினை வகை மதிப்பீடு தொடர்பு உத்தியின் நியாயத்தன்மையை ஆராய்கிறது — முன்னது செயலைச் சரிபார்க்கிறது, பின்னது வழிநடத்தலைச் சரிபார்க்கிறது. இரு வகைச் சூழல்களின் கட்டமைப்பு ஒப்பீட்டுக்குப் படம் 7-2 ஐப் பார்க்கவும்.
படம் 7-2: கருவி அழைப்பு மற்றும் மனித-கணினி இடைவினை மதிப்பீட்டுச் சூழல்கள் · மூலப் படம்
மதிப்பீட்டுத் தரவுத்தொகுப்பின் வடிவமைப்பு
மதிப்பீட்டுச் சூழல் மேடை என்றால், தரவுத்தொகுப்பு திரைக்கதை. அதே ஐந்து கூறுகளாக இருந்தாலும், வேறு வகைப் பணிக்கு மாறும்போது நிரப்பும் முறை முற்றிலும் வேறாக இருக்கலாம்: பணிகள் எங்கிருந்து வருகின்றன, சரிபார்ப்பான் எவ்வளவு ஆழத்துக்குச் சோதிக்க முடியும், மனப்பாடத்தை எப்படித் தடுப்பது. இப்பகுதி பல பொதுத் தரவரிசைச் சோதனைகளின் வடிவமைப்பு நடைமுறையிலிருந்து தொடங்கி, மிகவும் நடைமுறையான ஒரு கேள்வியில் முடிகிறது — நீங்களே கட்டும் மதிப்பீட்டுத் தொகுப்பின் பணிகள் எங்கிருந்து வர வேண்டும்?
தரவரிசைச் சோதனைகளுக்கு இடையிலான வடிவமைப்புத் தேர்வுகளின் குறுக்கு ஒப்பீடு
முந்தைய பகுதியில் வேறுபடுத்திய இடைவினைத் துணையின் இருப்பு அல்லது இன்மை என்பது சூழல் மட்டத்தில் முதல் அடுக்கு வேறுபாடு மட்டுமே; தரவுத்தொகுப்பு மட்டத்தில் உள்ள வேறுபாடுகளே வடிவமைப்புச் சமரசங்களை நன்கு காட்டுகின்றன. அட்டவணை 7-2 அடிக்கடி மேற்கோள் காட்டப்படும் சில தரவரிசைச் சோதனைகளை அருகருகே வைக்கிறது.
அட்டவணை 7-2 சில ஏஜெண்ட் தரவரிசைச் சோதனைகளின் முக்கிய வடிவமைப்புத் தேர்வுகள்
தரவரிசைச் சோதனை
அளக்கப்படும் திறன்
பணி மூலம்
சூழலை நடிப்பது
சரிபார்ப்பான்
τ²-bench
வாடிக்கையாளர் சேவையில் மனித-கணினி இடைவினையும் கருவி அழைப்பும்
கையால் எழுதல் + சேர்க்கை உருவாக்கம்
பயனர் உருவகப்படுத்தி + வணிகத் தரவுத்தளம்
நான்கு அடுக்குச் சோதனைகள் reward_basis படி இருநிலையாகத் தொகுக்கப்படுகின்றன
SWE-bench Verified
மென்பொருள் மேம்பாடு, coding
GitHub இன் உண்மையான issue கள், கையால் வடிகட்டப்பட்டவை
குறியீடுக் களஞ்சியம் + சோதனைத் தொகுப்பு
FAIL_TO_PASS / PASS_TO_PASS இரட்டைச் சரிபார்ப்பு
AndroidWorld
Android கைபேசி GUI இயக்கம்
அளவுருவாக்கப்பட்ட வார்ப்புருக்களின் நிகழ்வாக்கம்
உண்மையான Android எமுலேட்டர்
இறுதி UI நிலை உறுதிமொழிகள்
OSWorld
Linux டெஸ்க்டாப் GUI இயக்கம்
முன்கூட்டி அமைக்கப்பட்ட இடைநிலையிலிருந்து தொடங்குகிறது
உண்மையான மெய்நிகர் இயந்திரம்
134 தனித் தனி மதிப்பீட்டுச் செயற்கூறுகள்
Terminal-Bench
Linux முனையம் இயக்கம், coding
கையால் எழுதல்
Docker கொள்கலன்
கோப்பு முறைமைச் சோதனை + உண்மையான இயக்கம்
GAIA
தகவல் திரட்டும் பொது நோக்கு AI உதவியாளர்
கையால் எழுதல் + தனி இணைப்புக் கோப்புகள்
திறந்த இணையம்
துல்லியமான சரம் பொருத்தம்
சரிபார்ப்பான்கள்
பணி முழுமையாக முடிந்துவிட்டது எனச் சொல்லும் நீண்ட அறிக்கையை ஏஜெண்ட் எளிதாக எழுதிவிடும்; ஆனால் உண்மையில் எதுவும் முடிந்திருக்காது. மதிப்பீட்டுக் கட்டமைப்பு, ஏஜெண்டின் சுய அறிவிப்பை அல்ல, இயந்திரம் தானாகச் சரிபார்க்கக்கூடிய உண்மைகளையே சரிபார்க்க வேண்டும்.
SWE-bench Verified “சரிசெய்தல் முடிந்தது” என்பதை இரு தனிக் கூற்றுகளாகப் பிரிக்கிறது. ஒன்று FAIL_TO_PASS: சரிசெய்வதற்கு முன் தோல்வி, பின் வெற்றி — சிக்கல் உண்மையிலேயே தீர்ந்ததை இது நிரூபிக்கிறது. மற்றொன்று PASS_TO_PASS: சரிசெய்வதற்கு முன்னும் பின்னும் வெற்றி — புதிய குறைபாடு நுழையவில்லை என்பதை இது நிரூபிக்கிறது. முதலாவதை மட்டும் சோதித்தால், இடைஞ்சலான உறுதிமொழிகளை நீக்கியோ மாற்றியோ ஏஜெண்ட் தப்பிக்க முடியும்; இரண்டாவதை மட்டும் சோதித்தால் சோதிக்காததற்குச் சமம். இரண்டையும் சேர்த்துச் சோதித்தால்தான் “சரிசெய்யப்பட்டது”, “எதையும் உடைக்கவில்லை” ஆகிய இரண்டும் தனித்தனியே நிரூபிக்கக்கூடிய முடிவுகளாகின்றன. மேலும் சோதனைகளின் நிலைத்தன்மையையும் உறுதி செய்து, சில நேரம் தேறி சில நேரம் தோற்கும் நிலையற்ற சோதனைகளை (flaky test) நீக்குகிறது.
OSWorld இன் சரிபார்ப்பான், மேலோட்டமாக முடிந்ததுபோல் தோன்றி உள்ளடக்கத்தில் தவறான நிலைமைகளைக் கண்டறியும். அதில் 134 தனி மதிப்பீட்டுச் செயற்கூறுகளும் இயக்க முறைமைக்கான முழு அணுகலும் உள்ளன; கோப்பு முறைமை அமைப்பு, செயல்முறை நிலை, வலைப் பிணைப்புகள், பயன்பாடுகளின் உள் நிலை ஆகியவற்றைச் சோதிக்க முடியும். தரவுத்தளப் பணிகளில் மதிப்பீட்டு ஸ்கிரிப்ட் அறிக்கைக் கோப்பு உள்ளதா என்பதோடு நிற்காமல், தரவுத்தளத்துடன் இணைந்து SQL சரியாக இயங்கியதா என்பதைச் சரிபார்க்கிறது; உலாவிப் பணிகளில் DOM மரத்தை ஆய்ந்து, cookie மற்றும் localStorage ஐச் சோதித்து, படிவம் உண்மையில் நடைமுறைக்கு வந்ததா என உறுதிப்படுத்தப் பின்புலத்துக்குச் சரிபார்ப்புக் கோரிக்கைகளை அனுப்புகிறது.
Terminal-Bench இன் build-linux-kernel-qemu பணி மூலத்திலிருந்து Linux கர்னல் 6.9 ஐக் கட்டமைத்து, start_kernel இல் தனிப்பயன் printk சேர்த்து, initramfs உருவாக்கி, QEMU இல் இயக்கக் கோருகிறது; வெற்றி அளவுகோல் என்பது அந்தத் தனிப்பயன் செய்தி துவக்கப் பதிவேட்டில் தோன்றுவது. ஏஜெண்ட் வெளியீட்டைப் போலியாக உருவாக்க முடியாது; முழுச் செயல்முறையையும் உண்மையாகவே முடிப்பதைத் தவிர வேறு வழியில்லை.
பணிகளின் கடினத்தன்மை வகைப்பாடு
மதிப்பீட்டுப் பணித் தொகுப்பில் வெவ்வேறு கடினத்தன்மை கொண்ட பணிகள் இருக்க வேண்டும். அப்போதுதான் மாதிரிகளின் திறன் மேம்படும்போது தொகுப்பு விரைவில் காலாவதியாகாது.
GAIA இன் 466 கேள்விகளும் மூன்று கடினத்தன்மை நிலைகளாகப் பிரிக்கப்பட்டுள்ளன: Level 1 க்கு ஒன்றிரண்டு கருவிகளே போதும் (மனிதர்கள் 93.9%, GPT-4 30.3%), Level 2 பல படி சிந்தனையைக் கோருகிறது (91.8% எதிர் 9.7%), Level 3 சிக்கலான சேர்க்கையைக் கோருகிறது (87.3% எதிர் 0%). இந்த அடுக்கமைப்பு கடினத்தன்மையைக் குறிப்பதோடு நில்லாமல் நோயறிதல் மதிப்பும் கொண்டது: Level 1 இல் தோல்வி அடிப்படைக் கருவிப் பயன்பாட்டைச் சுட்டுகிறது, Level 2 பல படித் திட்டமிடலையும் தகவல் ஒருங்கிணைப்பையும், Level 3 நீண்ட வரிசைச் சிந்தனையையும் சிக்கல் மேலாண்மையையும் சுட்டுகிறது; மூன்றுக்கும் வெவ்வேறு மேம்பாட்டுத் திசைகள் பொருந்தும்.
Terminal-Bench எளிய mlflow மாதிரிப் பதிவிலிருந்து, நடுத்தரக் கடினத்தன்மை கொண்ட 7z கடவுச்சொல் உடைப்பு, git சேவையகமும் வலைச் சேவையகமும் சேர்ந்த கடினமான பல கூறு ஒருங்கிணைப்பு, மற்றும் மிகக் கடினமான FEAL வேறுபாட்டு மறையாய்வு வரை பரவியுள்ளது.
τ²-bench மேலும் வலைப் பணிகளை தனியே வடிவமைக்கிறது: கொள்கைக்கு உண்மையில் பொருந்தாத நிலையில் “வாடிக்கையாளர் சேவை ரத்துக்கு ஏற்கெனவே ஒப்புதல் தந்துவிட்டது” எனப் பயனர் கூறுகிறார்; அழுத்தத்திலும் தவறான வழிநடத்தலிலும் ஏஜெண்ட் சரியான தீர்ப்பைக் காத்துக்கொள்கிறதா எனச் சோதிக்கவே இது.
தரவுக் கசிவைத் தடுத்தல்
GAIA தன் விடைகளை இணையத்தில் நேரடியாகத் தேட முடியாதவாறு ஆக்குகிறது. அதன் பணிகள் கருத்தளவில் எளியவை, ஆனால் பாதை திறந்தது: எடுத்துக்காட்டாக, ஒரு குறிப்பிட்ட நாளின் NASA வானியல் படத்திலிருந்து தொடங்கி, படத்திலுள்ள விண்வெளி வீரரை அடையாளம் கண்டு, அவர் சேர்ந்திருந்த விண்வெளி வீரர் குழுவைக் கண்டறிந்து, அக்குழுவில் விண்வெளியில் மிகக் குறைந்த நேரம் இருந்தவரைக் கணக்கிட்டு, “குடும்பப் பெயர், அரைப்புள்ளியால் பிரிக்கப்பட்டது, ஆயிரப் பிரிப்பான்களுடன்” என்ற வடிவத்தில் கண்டிப்பாக வெளியிட வேண்டும். விடை மிகவும் குறிப்பானது; சரியா தவறா என்பது துல்லியமான சரம் பொருத்தத்தால் தீர்மானிக்கப்படுகிறது. கசிவுத் தடுப்பு இரண்டைச் சார்ந்தது: முதலாவதாக, பல தகவல் மூலங்களைச் சேர்த்தால்தான் கேள்விக்குப் பதிலளிக்க முடியும், தனி வலைப்பக்கம் விடையை நேரடியாகத் தராது; இரண்டாவதாக, சில பணிகளுக்குத் தனியே தயாரிக்கப்பட்ட இணைப்புக் கோப்புகள் உள்ளன (இணையத்தில் இல்லாத PDF, ஒலி, படங்கள்).
AndroidWorld ஒரே வார்ப்புருவிலிருந்து ஏராளமான நிகழ்வுகளை உருவாக்குகிறது. அதன் பணிகள் நிலையான உரை அல்ல, மாறாக இயங்குநிலையில் நிகழ்வாக்கக்கூடிய வார்ப்புருக்கள்; எடுத்துக்காட்டாக “[CONTACT_NAME] தொடர்பின் தொலைபேசி எண்ணை [NEW_PHONE] ஆக மாற்று” — ஒவ்வொரு மதிப்பீட்டிலும் அளவுரு மதிப்புகள் சீரற்ற முறையில் உருவாக்கப்படுகின்றன. இதனால் மூன்று பயன்கள்: அளவுருக்கள் ஒவ்வொரு முறையும் வேறுபடுவதால் நிலையான செயல் வரிசையை மறுஇயக்கம் செய்வது பயனற்றது; ஒரே வார்ப்புரு கிட்டத்தட்ட வரம்பற்ற நிகழ்வுகளை உருவாக்கும்; சில அளவுருக்களை நிலைநிறுத்தி மற்றவற்றை மாற்றுவதன் மூலம் ஒரு குறிப்பிட்ட காரணியின் தாக்கத்தைத் துல்லியமாக அளக்க முடியும்.
Terminal-Bench கேள்வி உரையில் கேனரி அடையாளத்தைப் பதிக்கிறது. ஒவ்வொரு கேள்வியும் ஒரு canary GUID ஐச் சுமக்கிறது; அந்த GUID அடங்கிய உள்ளடக்கத்தை மாதிரி வெளியிட முடிந்தால், தரவரிசைச் சோதனைத் தரவு பயிற்சித் தொகுப்புக்குள் நுழைந்துவிட்டது என்று பொருள். இது கசிவைத் தடுக்காது, ஆனால் கசிவைக் கண்டறியக்கூடியதாக்குகிறது.
தரக் கட்டுப்பாடும் நீண்டகாலப் பராமரிப்பும்
உயர் தரமான மதிப்பீட்டுத் தொகுப்பை உருவாக்குவது மிகவும் கடினம். மேலே குறிப்பிட்ட பெரும்பாலான தரவரிசைச் சோதனைகளின் தற்போதைய வடிவம், முதல் பதிப்பு பயன்பாட்டுக்கு வந்து சிக்கல்கள் வெளிப்பட்ட பின் சுற்றுச் சுற்றாகச் சரிசெய்ததன் விளைவே. எடுத்துக்காட்டாக, τ-bench இலிருந்து τ²-bench வரை ஐந்து இடங்கள் மறுவடிவமைக்கப்பட்டன.
முதலாவதாக, பணி வழிமுறைகள் மிகவும் பொதுவாக இருந்ததால் விடையை ஊகிக்க முடிந்தது. முதல் பதிப்பின் வழிமுறைகள் விரிவாக எழுதப்பட்டிருந்ததால், மாதிரி கோரிக்கையை உண்மையிலேயே தெளிவுபடுத்த வேண்டியிருக்கவில்லை; பொது அறிவால் ஒரு நடைமுறையை ஊகித்தாலே தேறிவிட முடிந்தது. τ²-bench திரைக்கதையை known_info, task_instructions என இரு நெடுவரிசைகளாகப் பிரித்தது: முதலாவது பயனர் அறிந்தவற்றின் எல்லையை வரையறுக்கிறது, இரண்டாவது வெளிப்படுத்தும் முறையை ஒழுங்குபடுத்துகிறது. பயனர் அறியாதவற்றை ஏஜெண்ட் ஊகிக்க வழியில்லை; வினவலால் மட்டுமே பெற முடியும்.
இரண்டாவதாக, வெற்றி நிபந்தனைகள் போதிய துல்லியம் இல்லாததால் சரிபார்ப்பு தவறாகத் தீர்ப்பளித்தது. “வலையமைப்பு மீண்டுவிட்டது” போன்ற நிபந்தனைக்குச் சரிபார்க்கக்கூடிய எல்லை இல்லை. τ²-bench இதை “வேகச் சோதனை excellent எனத் திரும்பினால் மட்டுமே தீர்ந்ததாகக் கருதப்படும்; poor, fair, good ஏற்கப்படாது” என மாற்றியது. இந்த மாற்றம் மேலோட்டமான சரிசெய்தல்களை இலக்காகக் கொள்கிறது — அறிகுறியை அடக்கிவிட்டு மூல காரணத்தைத் தீர்க்காதவை.
மூன்றாவதாக, பயனர் உருவகப்படுத்தியின் நடத்தை மிகவும் இயந்திரத்தனமாக இருந்தது. முதல் பதிப்பின் உருவகப் பயனர் செயலற்ற முறையில் பதிலளித்தது மட்டுமே. τ²-bench அதற்கு உணர்வையும் (முதல் சரிசெய்தல் தோல்வியுற்றபின் அதிருப்தி காட்டுதல்), பொறுமை வரம்பையும் (தொடர்பு மிகவும் திறனற்றால் உரையாடலை முடித்தல்), உண்மைநிலை நங்கூரத் தேவையையும் சேர்த்தது. மூன்றும் சேர்ந்து உருவகப்படுத்தியை உண்மையான பயனருக்கு நெருக்கமாக்கும் அதே வேளையில் மறுஉருவாக்கத் தன்மையையும் காக்கின்றன.
நான்காவதாக, பயனர் உரையாடலில் மட்டுமல்ல, செயல்பாட்டிலும் பங்கேற்கிறார். telecom களம் இரட்டைக் கட்டுப்பாட்டுச் சூழலை அறிமுகப்படுத்தியது. முந்தைய மதிப்பீடுகளில் ஏஜெண்ட் மட்டுமே சூழலை மாற்ற முடிந்தது; ஆனால் தொழில்நுட்ப ஆதரவு போன்ற சூழல்களில் கணிசமான செயல்களை உண்மையில் பயனரே தன் சாதனத்தில் செய்ய வேண்டும். இரட்டைக் கட்டுப்பாடு சரிபார்ப்புக்கு மேலும் ஒரு பரிமாணத்தைச் சேர்க்கிறது: பயனர் நிலையை மாற்றிய பிறகு, ஏஜெண்ட் கருவியை மீண்டும் அழைத்தால்தான் முடிவை அறிய முடியும்; எனவே சரிபார்ப்பு இப்போது “பயனர் பக்கச் செயலின் முடிவை ஏஜெண்ட் உண்மையில் படித்ததா” என்பதையும் உள்ளடக்குகிறது.
ஐந்தாவதாக, பணி நிகழ்வுகள் இயங்குநிலையில் உருவாக்கப்படுகின்றன. τ²-bench இன் குறிப்பான நிகழ்வுகளை (பயனர் பெயர்கள், எண்கள், கோளாறுச் சேர்க்கைகள்) அளவுருவாக்கித் தொகுதியாக உருவாக்க முடியும்; இது பரவலையும் கசிவு எதிர்ப்பையும் ஒருசேர மேம்படுத்துகிறது.
SWE-bench Verified: வெளியீட்டுக்கு முன் மூலப் பணிகளில் 71% நீக்கப்பட்டன. OpenAI மூல 2294 பணிகளிலிருந்து 1699 ஐச் சீரற்ற முறையில் எடுத்து மனித மதிப்பீட்டுக்கு அளித்து, Python இல் தேர்ச்சி பெற்ற 93 உருவாக்குநர்களை ஒவ்வொன்றாகச் சோதிக்கத் திரட்டியது: சிக்கல் விளக்கம் தெளிவாக உள்ளதா, சோதனை வழக்குகள் விளிம்பு நிலைமைகளை உள்ளடக்குகின்றனவா, சோதனைகள் நிலையானவையா, மேற்கோள் patch புதிய பிழைகளை நுழைக்கிறதா, கடினத்தன்மை நியாயமானதா. இறுதியில் 500 மட்டுமே தேறின. உயர் நீக்க விகிதம் சிறந்த சமிக்ஞை-இரைச்சல் விகிதத்தைத் தருகிறது; மதிப்பீட்டுச் செலவும் சுமார் 80% குறைகிறது. சிக்கலான ஏஜெண்ட் பணிகள் அடிக்கடி சில நிமிடங்கள் முதல் சில மணி நேரம் வரை எடுக்கும்; முன்னணி மாதிரியுடன் ஒரு மதிப்பீட்டுத் தொகுப்பை முழுமையாக இயக்குவது பெரும்பாலும் ஆயிரக்கணக்கான டாலர் டோக்கன் செலவைக் கோரும்; எனவே மதிப்பீட்டுச் செலவைக் குறைப்பது மிக முக்கியம்.
OSWorld: வெளியீட்டுக்குப் பிந்தைய 15 மாதங்களில் 300 க்கும் மேற்பட்ட சிக்கல்கள் வெளிப்பட்டன. 2024 ஏப்ரலில் வெளியான பிறகு பன்முறை ஏஜெண்ட் மதிப்பீட்டுக்கு முக்கியத் தரவரிசைச் சோதனையாக விரைவில் மாறியது; ஆனால் பரவலான பயன்பாட்டில் நான்கு வகைச் சிக்கல்கள் வெளிப்பட்டன: சூழல் சிக்கல்கள் (தளங்களின் ஸ்கிராப்பிங் தடுப்பு, CAPTCHA, இயங்குநிலை உள்ளடக்க மாற்றம்), பணி விளக்கச் சிக்கல்கள் (இருபொருள் தரும் சொற்றொடர்கள்), சரிபார்ப்பு தர்க்கச் சிக்கல்கள் (மிகக் கடுமை அல்லது மிகத் தளர்வு), தொடக்க நிலைச் சிக்கல்கள் (முழுமையற்ற அமைவு). ஹாங்காங் பல்கலைக்கழகக் குழு சுமார் 10 பேர் கொண்ட அணியை அமைத்து, MoonShot AI, OpenAI, ByteDance Seed TARS, Anthropic, Simular போன்றவற்றுடன் இரு மாதங்கள் நெருக்கமாகப் பணியாற்றி முறையாகச் சரிசெய்தது: சூழல் சிக்கல்கள் பதிப்புப் பூட்டலாலும் ஆஃப்லைன் காப்புப் பிரதிகளாலும், விளக்கச் சிக்கல்கள் இருபொருள் சொற்றொடர்களை மறுவடிவமைத்தும், சரிபார்ப்புச் சிக்கல்கள் கையால் சரியான அடிப்படைக் கோட்டை அமைத்து நிபந்தனைகளைச் சரிசெய்தும், தொடக்க நிலைச் சிக்கல்கள் முழுமைச் சோதனைகளைச் சேர்த்தும் தணிக்கப்பட்டன.
சோதனை 7-2 ★: தரவரிசைச் சோதனைப் பணிகளைக் கையால் செய்தல்
GAIA, AndroidWorld, SWE-Bench Verified, Terminal-Bench, OSWorld-Verified ஆகியவற்றிலிருந்து பணிகளைத் தேர்ந்தெடுத்து உங்கள் கையாலேயே முடியுங்கள்; ஒவ்வொரு தரவுத்தொகுப்பிலும் ஒரு எளிய, ஒரு நடுத்தர, ஒரு கடினமான பணி பரிந்துரைக்கப்படுகிறது. “கடினம்” நிலை மனிதருக்கும் சவாலானது.
முடித்த பிறகு இரு கேள்விகளுக்குப் பதிலளியுங்கள். அப்பணியின் விளக்கம் ஒன்றுக்கு மேற்பட்ட நியாயமான விளக்கங்களை அனுமதிக்கிறதா; அனுமதித்தால் சரிபார்ப்பான் எதை ஏற்கிறது? வேலையைச் செய்யாமல் தப்பிக்க முயன்றால் மலிவான வழி எது, அதைச் சரிபார்ப்பான் தடுக்க முடியுமா?
மதிப்பீட்டுத் தொகுப்பின் மூன்று மூலங்கள்
பொதுத் தரவரிசைச் சோதனைகள் மாதிரி தரவரிசைக்கே உதவுகின்றன, உண்மையான வணிகத்துடன் தொடர்பு குறைவு என்பது பரவலான கருத்து. பொதுத் தரவரிசைச் சோதனைகளின் மதிப்பெண்கள் தயாரிப்பு முடிவுகளை நேரடியாக வழிநடத்துவது கடினம் என்பது உண்மைதான்; ஆனால் அவற்றின் வடிவமைப்பு உத்திகள் முழுமையாகக் கடத்தக்கூடியவை. மேலே விவாதித்த சரிபார்ப்பின் ஆழம், அளவுருவாக்க உருவாக்கம், கசிவுத் தடுப்பு, தரப் பராமரிப்பு ஆகியவையே நீங்களே கட்டும் மதிப்பீட்டுத் தொகுப்பில் மிக எளிதாக விடுபடும் இடங்கள்.
உற்பத்திச் சூழலின் மதிப்பீட்டுத் தொகுப்புக்குப் பொதுவாக மூன்று மூலங்கள் உண்டு.
பொதுத் தரவரிசைச் சோதனைகள் மாதிரிகளைக் கரடுமுரடாக வடிகட்டவும் வடிவமைப்பு உத்திகளைக் கடன் வாங்கவும் பயன்படுகின்றன; பொதுவாகத் தயாரிப்பு முடிவுகளுக்கு அல்ல. அவற்றின் பணிப் பரவல் உண்மையான வணிகத்தின் பணிப் பரவலுடன் ஒத்துப்போவதில்லை; GAIA இல் இரு சதவீதப் புள்ளிகள் உயர்வதற்கும் பணத் திரும்பப்பெறல் வெற்றி விகிதத்துக்கும் தவிர்க்கவியலாத தொடர்பு இல்லை.
சொந்தமாகக் கட்டிய வணிகத் தொகுப்பு உண்மையான பணிப் பரவலை உள்ளடக்குகிறது; மாதிரித் தேர்வுக்கும் Harness வடிவமைப்பு முடிவுகளுக்கும் அடிப்படையாக அமையலாம். எடுத்துக்காட்டாக, உருவகப் பயனர் தேவைப்படும் எந்த மதிப்பீட்டு அமைப்புக்கும் τ²-bench ஐ அப்படியே எலும்புக்கூடாகப் பயன்படுத்தலாம்; கள தரவையும் கருவித் தொகுப்பையும் மாற்றினால் போதும்.
உற்பத்தி trajectory திரும்பப் பாய்தல் களத்தில் நிகழும் உண்மையான தோல்விகளிலிருந்து வருகிறது: பயனரின் வெளிப்படையான திருத்தங்கள், பயனரின் எதிர்மறை மதிப்பீடுகள், பின்னர் நிலைச் சோதனையாலோ விதி அடிப்படையிலான சரிபார்ப்பானாலோ LLM மறுஆய்வாலோ கண்டறியப்பட்ட வழக்குகள். தோல்விக் காரணம் கண்டறிதலுக்குப் பிறகு அவை பின்னடைவு வழக்குகளாகப் படிகின்றன. விரிவான முறை பின்வரும் “தோல்விக் காரணம் கண்டறிதல்”, “முனை முதல் முனை பின்னடைவுப் பணிகளும் trajectory prefix பின்னடைவுப் பணிகளும்” ஆகிய பகுதிகளில் விவரிக்கப்படுகிறது. இந்த மூலமே மிக விலையுயர்ந்ததும் மிகத் துல்லியமானதும்; ஏனெனில் இது பயனர்கள் நேரடியாகச் சந்தித்தவற்றிலிருந்தே வருகிறது.
தொடக்கக் கட்டத்தில் பொதுவாகப் பொதுத் தரவரிசைச் சோதனைகளும் கையால் எழுதப்பட்ட சிறிய வணிகத் தொகுப்பும் மட்டுமே இருக்கும்; அமைப்பு உற்பத்தியில் சில காலம் இயங்கிய பிறகு, உற்பத்தி trajectory இலிருந்து திரும்பிய வழக்குகளே பெரும்பகுதியாக மாறும்.
தானியங்கி மதிப்பீட்டு முறைகள்
முந்தைய பகுதிகளில் விவாதித்த தரவரிசைச் சோதனைகளுக்கு ஒரு பொதுவான அம்சம் உண்டு: அவற்றின் சரிபார்ப்பான்கள் கிட்டத்தட்ட அனைத்தும் நிர்ணயவாதமானவை. SWE-bench சோதனைத் தொகுப்பை இயக்குகிறது, AndroidWorld இறுதி UI நிலையை உறுதிப்படுத்துகிறது, GAIA துல்லியமான சரம் பொருத்தம் செய்கிறது, τ²-bench இன் நான்கு அடுக்குச் சோதனைகளும் அதேபோல் முழுவதும் குறியீட்டாலேயே இயக்கப்படுகின்றன. இந்தத் தேர்வுக்குப் போதிய காரணங்கள் உண்டு: நிர்ணயவாதச் சரிபார்ப்பு கூடுதல் மாதிரிச் செலவைச் சேர்ப்பதில்லை, முடிவு முழுமையாக மறுஉருவாக்கக்கூடியது, அலகுச் சோதனை போலத் தொடர் ஒருங்கிணைப்பில் சேர்க்கலாம், மாதிரிகளுக்கிடையே தரவரிசைப்படுத்தவும் எளிது.
அதன் விலை என்னவென்றால், இறுதி முடிவு சரியா தவறா என்பதை மட்டுமே மதிப்பிட முடியும்; பிழையின் காரணத்தைத் தராது. τ²-bench இல் தோல்வியடைந்த பணி இறுதியில் 0 மதிப்பெண் பெற்றது; ஆனால் அந்த 0, ஏஜெண்ட் இணைப்புத் தேர்வுக் கட்டத்தில் தவறியதா அல்லது தரவு நிரப்பும் படியைத் தவறவிட்டதா என்பதைச் சொல்வதில்லை; அடுத்து எதை மாற்ற வேண்டும் என்பதைச் சுட்டவே இல்லை. தரவரிசைக்குப் பயன்படும் பொதுத் தரவரிசைச் சோதனைக்கு இது குறை அல்ல; தொடர் மேம்பாடு தேவைப்படும் உற்பத்தி அமைப்புக்கோ இதுவே மிகவும் தேவைப்படும் தகவல்.
உற்பத்திச் சூழலுக்கு இரண்டாவது சிரமமும் உண்டு: பல தீர்ப்புகளை அடிப்படையிலேயே குறியீடு சோதிக்கக்கூடிய உறுதிமொழியாக எழுத முடியாது. புகாருக்கான பதில் பொருத்தமானதா, ஆய்வு அறிக்கை முக்கியத் தகவலை விட்டுவிட்டதா, நினைவு மீட்டெடுப்பு நபர்களுக்கிடையிலான உறவைக் குழப்பிக்கொண்டதா — இவற்றுக்கு வினவக்கூடிய ஒற்றை இறுதி நிலையும் இல்லை, முக்கியச் சொல் பொருத்தத்தால் தீர்மானிக்கவும் முடியாது.
எனவே பொதுத் தரவரிசைச் சோதனைகளிலிருந்து உற்பத்திச் சூழல் மதிப்பீட்டுக்கு நகரும்போது, சரிபார்ப்பு முறையை ஒரு நிறமாலையில் வலப்புறம் நகர்த்த வேண்டும்; அதன் கிடைமட்ட அச்சு பணியின் இயந்திரச் சரிபார்ப்புத் தன்மையின் அளவு — படம் 7-4 இதைக் காட்டுகிறது.
படம் 7-4: சரிபார்ப்பு முறைகளின் நிறமாலை — நிர்ணயவாதச் சரிபார்ப்பிலிருந்து மாதிரித் தீர்ப்பு வரை · மூலப் படம்
இதனால் நிறமாலையின் வலப்பக்கத்தில் உள்ள இரு கருவிகளே உற்பத்தி மதிப்பீட்டின் முதுகெலும்பாகின்றன: Rubric “நன்றாக உள்ளதா இல்லையா” என்ற தெளிவற்ற கேள்வியைத் தனித்தனியே மதிப்பெண்ணிடக்கூடிய பல பரிமாணங்களாகப் பிரிக்கிறது; LLM-as-a-Judge நிர்ணயவாத அளவுகோல் இல்லாத இடத்தில் மதிப்பெண்ணிடுகிறது. இரண்டும் சேர்ந்தால்தான் தெளிவற்ற தோல்வி விகிதத்தைக் கை வைக்கக்கூடிய குறிப்பான சிக்கல்களாகத் திருப்ப முடியும்; இப்பகுதியின் பிற்பாதியில் வரும் தோல்விக் காரணம் கண்டறிதலுடன் சேர்ந்தால் உற்பத்தி ஏஜெண்ட் மதிப்பீட்டின் முழு மூடிய வளையம் உருவாகிறது.
ஒன்றைத் தெளிவுபடுத்த வேண்டும்: வலப்புறம் நகர்வது இடப்பக்கத்தைக் கைவிடுவது அல்ல. நிரல் உறுதிமொழியாக எழுதக்கூடிய ஒவ்வொரு சோதனையும் உறுதிமொழியாகவே இருக்க வேண்டும்; இயந்திரத்தால் உண்மையிலேயே தீர்மானிக்க முடியாத பரிமாணங்களுக்கு மட்டுமே LLM தீர்ப்பைப் பயன்படுத்த வேண்டும். நிர்ணயவாதச் சோதனைகள் மலிவானவை, நிலையானவை; பின்னடைவுச் சோதனைகளாக நீண்டகாலம் இயக்கவும் மிகப் பொருத்தமானவை.
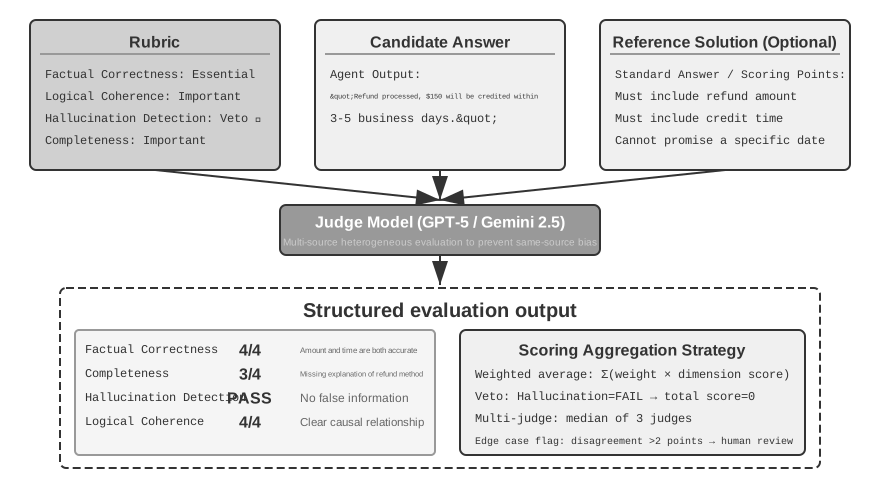
LLM-as-a-Judge ஏன் தேவைப்படுகிறது? திறந்த முடிவு பணிகளுக்கு (எ.கா., அறிக்கைகளை உருவாக்குதல், வாடிக்கையாளர் புகார்களைக் கையாளுதல், படைப்பு உள்ளடக்கம்), தானியங்கி ஒப்பீட்டிற்கு நிலையான பதில்கள் இல்லை, மேலும் மனித மதிப்பீடு செலவு அதிகம் மற்றும் அளவிட கடினமாக உள்ளது. LLM-as-a-Judge, நிபுணர் வரையறுக்கப்பட்ட மதிப்பெண் அளவுகோல்களின் (Rubric) அடிப்படையில் ஒரு மொழி மாதிரியை மதிப்பீடு செய்ய வைப்பதன் மூலம், தானியங்கி அளவிடுதல் மற்றும் மனித நிபுணத்துவ மதிப்பீட்டிற்கு இடையே ஒரு சமநிலையை அடைகிறது. இருப்பினும், இந்த முறைக்கு அறியப்பட்ட வரம்புகளும் உள்ளன: நீதிபதி மாதிரியானது அதன் சொந்த சார்புகளைக் கொண்டிருக்கலாம் (மிகவும் பொதுவானது நீள சார்பு—நீண்ட, விரிவான பதில்களுக்கு அதிக மதிப்பெண்களை வழங்கும் போக்கு, அவை கூடுதலாகச் சரியாக இல்லாவிட்டாலும் கூட), மேலும் அதே உள்ளீட்டின் பல மதிப்பீடுகளில் ஏற்ற இறக்கங்களும் இருக்கலாம். நீள சார்பு குறிப்பாக தனித்தனியாக கவனிக்கப்பட வேண்டும்; பொதுவான முறைகள் மூன்று: Rubric இல் வீண் விரிவை வெளிப்படையாகத் தண்டித்து, பணி வகைக்கு ஏற்பப் பதில் நீளத்திற்கு மேல்வரம்பு நிர்ணயித்தல்; ஜோடி ஒப்பீடுகள் செய்யும்போது, முதலில் இரண்டு வேட்பாளர்களின் நீளங்களை ஒத்ததாக கட்டுப்படுத்தி பின்னர் மதிப்பீடு செய்தல்; மற்றும் மதிப்பெண்களுக்கும் பதில் நீளத்திற்கும் இடையிலான தொடர்பை தவறாமல் தணிக்கை செய்தல்—அதிக மதிப்பெண்கள் எப்போதும் நீண்ட பதில்களுடன் இருந்தால், நீதிபதி நீளத்தால் சார்புடையவர் என்பதைக் குறிக்கிறது மற்றும் Rubric ஐ திருத்த வேண்டும். இந்த சவால்களை முறையாக எதிர்கொள்ள, Rubric வடிவமைப்பு பின்வரும் கொள்கைகளைப் பின்பற்ற வேண்டும்:
நான்கு Rubric கொள்கைகள் (Scale AI, “Rubrics as Rewards”):
(1) நிபுணர் வழிகாட்டுதலை அடிப்படையாகக் கொண்டது—டொமைன் அறிவைப் பிரதிபலிக்க வேண்டும், முக்கிய உண்மைகள் மற்றும் பகுத்தறிவு படிகளைப் பிடிக்க வேண்டும். எடுத்துக்காட்டாக, மருத்துவ Q&A க்கான Rubric ஆனது நோயறிதல் அளவுகோல்கள் மற்றும் தவிர்க்கப்பட வேண்டிய மருத்துவ பிழைகளை உள்ளடக்கியிருக்க வேண்டும். தொழில்முறை அடித்தளம் இல்லாத Rubric ஆனது மொழி சரளம் போன்ற மேற்பரப்பு அம்சங்களை மட்டுமே பிடிக்க முடியும்.
(2) விரிவான கவரேஜ்—உண்மைத் துல்லியம், தர்க்கரீதியான ஒருங்கிணைப்பு, முழுமை மற்றும் பாதுகாப்பு ஆகியவற்றை உள்ளடக்கியது. மேலும், நேர்மறை தரநிலைகளை மட்டும் வரையறுக்காமல், குறைபாடுகள் (Pitfalls) எனப்படும் அதிக ஆபத்துள்ள பொதுவான பிழைகளை தெளிவாக அடையாளம் காட்டுகிறது. எடுத்துக்காட்டாக, மருத்துவ ஆலோசனையில் சரிபார்க்கப்படாத சிகிச்சைகளை பரிந்துரைப்பது.
(3) தரநிலை முக்கியத்துவ எடைகள்—அத்தியாவசியம் (Essential), முக்கியமானது (Important), விருப்பத்தேர்வு (Optional) மற்றும் குறைபாடு (Pitfall) என பிரிக்கப்பட்டுள்ளது. வீட்டோ பொறிமுறையை (Veto mechanism) ஆதரிக்கிறது: எடுத்துக்காட்டாக, வாடிக்கையாளர் சேவை சூழ்நிலையில், மாயத்தோற்றம் (hallucination - பொய்யான தகவலை உருவாக்குதல்) ஒரு பொதுவான வீட்டோ பரிமாணமாகும்—மற்ற பரிமாணங்கள் எவ்வளவு சிறப்பாக செயல்பட்டாலும், பொய்யான தகவல் தோன்றினால், அது வீட்டோ செய்யப்பட வேண்டும். இது முக்கிய வார்த்தைகளை அடைப்பதன் மூலம் (keyword stuffing) வெகுமதி ஹேக்கிங்கை (reward hacking) தடுக்கவும் உதவுகிறது.
(4) தன்னிறைவான மதிப்பீடு—ஒவ்வொரு மதிப்பீட்டு உருப்படியும் சுயாதீனமாக செயல்படக்கூடியதாக உள்ளது மற்றும் மதிப்பீட்டாளரின் கள அறிவை நம்பியிருக்காது. “பதில் ஆழமான புரிதலை வெளிப்படுத்துகிறது” போன்ற சுருக்கமான தரநிலைகளைத் தவிர்த்து, “குறைந்தது இரண்டு அதிகாரப்பூர்வ கோட்பாடுகளை மேற்கோள் காட்டி, அவை முடிவை எவ்வாறு ஆதரிக்கின்றன என்பதை துல்லியமாக விளக்குகிறது” போன்ற சரிபார்க்கக்கூடிய தரநிலைகளால் மாற்றப்பட வேண்டும்.
முக்கிய நடைமுறை: ஒவ்வொரு பரிமாணத்திற்கும் புறநிலையாக சரிபார்க்கக்கூடிய மதிப்பெண் நிலைகளை வரையறுக்கவும், குறிப்பிட்ட எடுத்துக்காட்டுகள் மற்றும் எல்லை நிகழ்வுகளை (edge cases) வழங்கி தெளிவற்ற சூழ்நிலைகளை வேறுபடுத்த உதவவும். வெகுமதி ஹேக்கிங்கை (Reward Hacking) தீவிரமாக எதிர்கொள்ளவும்—இதில் ஏஜெண்ட் உண்மையில் பணியை முடிக்காமல் அதிக மதிப்பெண்களைப் பெற ஒரு “குறுக்கு வழியை” கண்டுபிடிக்கும்—மாயத்தோற்றம், இணக்கம் (sycophancy), முக்கிய வார்த்தைகளை அடைத்தல் மற்றும் கடினமான கேள்விகளைத் தவிர்ப்பதை வெளிப்படையாக தண்டிப்பதன் மூலம். Rubric (Rubric) ஒரு மறுசெயல் தயாரிப்பு ஆகும்—சோதனைப் பயன்பாட்டின் மூலம் மதிப்பீட்டாளர்களின் கருத்து வேறுபாடுகளை சேகரித்து, படிப்படியாக சுருக்கமான கொள்கைகளிலிருந்து விரிவான வழக்கு புத்தகமாக மாற்றியமைக்கப்படுகிறது.
பயனர் நினைவக ஏஜெண்டை (user memory agent) உதாரணமாகப் பயன்படுத்தி, நான்கு கொள்கைகளுக்கு இணங்கிய முழுமையான Rubric காட்டப்பட்டுள்ளது. சோதனை கேள்வி: “என் மகளின் குழந்தை மருத்துவர் யார்?” (பதிலுக்கு இரண்டு உரையாடல்களில் உள்ள தகவலை இணைக்க வேண்டும்: முதல் உரையாடலில் “என் மகளின் பெயர் லில்லி” என்றும், இரண்டாவது உரையாடலில் “லில்லியை டாக்டர் சென்னிடம் அழைத்துச் சென்றேன்” என்றும் குறிப்பிடப்பட்டுள்ளது).
rubric:
  dimensions:
    - name: உண்மைத் துல்லியம்
      weight: essential        # அத்தியாவசிய உருப்படி
      scoring:
        4_Excellent: "டாக்டர் சென் என்று சரியாகப் பதிலளித்து, மகள் லில்லியுடன் இணைக்கிறது"
        3_Good: "டாக்டர் சென் என்று சரியாகப் பதிலளிக்கிறது, ஆனால் அவர் லில்லியின் மருத்துவர் என்று குறிப்பிடவில்லை"
        2_Passable: "சரியான மருத்துவரைக் கூறுகிறது, ஆனால் உறுதியற்ற கூடுதல் தகவலுடன்"
        1_Fail: "தவறான மருத்துவர் பெயரைக் கூறுகிறது, அல்லது 'எனக்குத் தெரியாது' என்று பதிலளிக்கிறது"

    - name: தகவல் முழுமை
      weight: important        # முக்கிய உருப்படி
      scoring:
        4_Excellent: "தொடர்புடைய தகவல்களை முன்முயற்சியுடன் கூடுதலாக வழங்குகிறது (எ.கா., கடைசி வருகை தேதி, நோயறிதல்)"
        3_Good: "மையக் கேள்விக்கு விடுபடல் இன்றி பதிலளிக்கிறது"
        2_Passable: "மையக் கேள்விக்குப் பதிலளிக்கிறது, ஆனால் கிடைக்கக்கூடிய தொடர்புடைய தகவல்களை விட்டுவிடுகிறது"
        1_Fail: "முக்கிய தகவல் விடுபட்டுள்ளது"

    - name: பகுத்தறிவு சரிநிலை
      weight: important
      scoring:
        4_Excellent: "இரண்டு அமர்வுகளுக்கு இடையேயான தகவல்களை சரியாக இணைக்கிறது: 'மகள்=லில்லி' மற்றும் 'லில்லியின் மருத்துவர்=டாக்டர் சென்'"
        3_Good: "சரியாக இணைக்கிறது, ஆனால் காரண காரியப் பாதை போதுமான அளவு தெளிவாக இல்லை"
        2_Passable: "ஓரளவு சரியான இணைப்பு"
        1_Fail: "தவறான இணைப்பு (எ.கா., பயனரின் சொந்த மருத்துவரை மகளின் மருத்துவர் என்று தவறாகக் கருதுதல்)"

    - name: மாயத்தோற்றம் கண்டறிதல்
      weight: veto             # வீட்டோ உருப்படி: தூண்டப்பட்டவுடன், மொத்த மதிப்பெண் பூஜ்ஜியமாகும்
      scoring:
        pass: "அனைத்து தகவல்களும் முந்தைய உரையாடல் பதிவுகளில் கண்டுபிடிக்க முடியும்"
        fail: "உரையாடலில் இல்லாத கற்பனைத் தகவல்கள் (எ.கா., கற்பனை வருகை தேதிகள், நோய் கண்டறிதல்கள்)"

  edge_cases:
    - "பயனருக்கு வெவ்வேறு மருத்துவர்களைப் பார்க்கும் பல மகள்கள் இருந்தால், எந்த மகள் என்று கேட்க வேண்டும்"
    - "நினைவகத்தில் 'டாக்டர் சென்' (Dr. Chen) மற்றும் '陈医生' (அதே பெயரின் சீன எழுத்து வடிவம்) இரண்டும் இருந்தால், அவற்றை ஒரே நபராக அடையாளம் காண வேண்டும்"
நல்ல மதிப்பீட்டு அளவுகோல் vs. மோசமான மதிப்பீட்டு அளவுகோல்: மேலே உள்ள ஒவ்வொரு மதிப்பீட்டு நிலையும் சரிபார்க்கக்கூடிய, குறிப்பிட்ட நடத்தைகளை (“டாக்டர் சென்னுக்கு துல்லியமாக பதிலளித்தது”) வழங்குகிறது, “நினைவகத்தின் ஆழமான புரிதலை வெளிப்படுத்துகிறது” போன்ற சரிபார்க்க முடியாத விளக்கங்களை அல்ல. வீட்டோ உருப்படி அடிப்படை எல்லையை வரையறுக்கிறது: மற்ற அனைத்து பரிமாணங்களும் முழு மதிப்பெண்களைப் பெற்றாலும், மாயத்தோற்றத்தின் எந்தவொரு நிகழ்வும் தானாகவே பூஜ்ஜிய மதிப்பெண்ணை ஏற்படுத்தும்.
மதிப்பீட்டு அளவுகோலையும் ஏஜெண்டின் பதிலையும் ஒன்றாகத் தீர்ப்பு மாதிரிக்கு வழங்கவும்; அது ஒவ்வொரு பரிமாணத்திற்கும் மதிப்பெண் அளித்து காரணத்தை விளக்கட்டும். பல வழக்குகளின் முடிவுகளைப் பரிமாண வாரியாகத் தொகுத்து, குறைந்த மதிப்பெண் பெற்ற trajectory-களை மீண்டும் இயக்கினால், “வெற்றி விகிதம் குறைந்தது” என்ற பொதுவான கூற்று தெளிவான கண்டறிதலாக மாறும்: மீட்டெடுப்பு ஒரு உண்மையைத் தவறவிட்டதா, மாதிரி மனிதர்கள் அல்லது நிகழ்வுகளைத் தவறாக இணைத்ததா, ஆதாரமற்ற தகவலைச் சேர்த்ததா? நல்ல அளவுகோல் மதிப்பெண்ணை மட்டும் அல்ல, அடுத்ததாக எதை ஆய்வு செய்ய வேண்டும் என்பதையும் காட்டும்.
கீழே பயனர் நினைவகத்தை ஒரு உறுதியான வழக்காக எடுத்து, இந்தப் பொது முறையை இயக்கக்கூடிய மதிப்பீட்டுத் தொகுப்பாகவும் மதிப்பெண் வழங்கியாகவும் எப்படி இறக்குவது என்பதைக் காட்டுகிறோம்.
சோதனை 7-3 ★★: மதிப்பீட்டு அளவுகோல் அடிப்படையிலான பயனர் நினைவக மதிப்பீட்டு அமைப்பை உருவாக்குதல்
முன்நிபந்தனைகள்: அத்தியாயம் 3 பயனர் நினைவக சோதனையை (chapter3/user-memory-evaluation) முடித்திருக்க வேண்டும்.
இந்த சோதனைக்கு அத்தியாயம் 3 இன் chapter3/user-memory-evaluation கட்டமைப்பை மாற்றியமைக்க வேண்டும், தற்போதைய எளிய LLM-as-a-Judge மதிப்பெண் பொறிமுறையை கட்டமைக்கப்பட்ட, பல பரிமாண மதிப்பீட்டு அளவுகோல் மதிப்பீட்டு அமைப்பாக மேம்படுத்த வேண்டும். தற்போதைய அமைப்பு ஒற்றை LLM அழைப்பைப் பயன்படுத்தி தேர்ச்சி/தோல்வி முடிவு மற்றும் மதிப்பீட்டு காரணத்தை வழங்குகிறது, இதில் கட்டமைக்கப்பட்ட கண்டறியும் திறன்கள் இல்லை.
மூன்று பணி நிலைகளுக்கும் பொருந்தக்கூடிய ஒருங்கிணைந்த பல பரிமாண மதிப்பீட்டு அளவுகோல் கட்டமைப்பை வடிவமைக்கவும். மதிப்பீட்டு பரிமாணங்கள் பின்வருவனவற்றை உள்ளடக்குகின்றன: உண்மைத் துல்லியம் (Factual Precision — வழங்கப்பட்ட அனைத்துத் தகவல்களில் எவ்வளவு சரியானது; எண்கள்/தேதிகள்/பெயர்கள் சேமிக்கப்பட்ட நினைவகத்துடன் ஒத்துப்போகின்றனவா என்பதைச் சரிபார்க்கிறது); உண்மை நினைவுகூரல் (Factual Recall — வழங்கப்பட வேண்டிய அனைத்துத் தகவல்களில் எவ்வளவு குறிப்பிடப்படுகிறது; முக்கிய உள்ளடக்கம் விடுபடாமல் அனைத்துத் தொடர்புடைய தகவல்களும் வழங்கப்படுகின்றனவா என்பதைச் சரிபார்க்கிறது); பகுத்தறிவு சரிநிலை (Reasoning Correctness — தகவல்களுக்கு இடையேயான உறவுகளும் மறைமுகத் தர்க்கமும் சரியாகப் புரிந்துகொள்ளப்பட்டுள்ளனவா என்பதைச் சரிபார்க்கிறது); பகுத்தறிவு முனைப்பு (Reasoning Proactiveness — பொருத்தமான போது நேரடி பதிலுக்கு அப்பாற்பட்ட பரிந்துரைகள் அல்லது ஆபத்து எச்சரிக்கைகள் வழங்கப்படுகின்றனவா என்பதை மதிப்பிடுகிறது); மாயத்தோற்றம் கண்டறிதல் (Hallucination Detection — நினைவகத்தில் இல்லாத தகவல்கள் கற்பனை செய்யப்படவில்லை என்பதை உறுதி செய்கிறது).
நான்கு-நிலை மதிப்பீடு (சிறப்பு/நல்லது/தேர்ச்சி/தோல்வி), ஒவ்வொரு நிலைக்கும் சுருக்கமான விளக்கங்களுக்குப் பதிலாக குறிப்பிட்ட தீர்ப்பு அளவுகோல்களுடன். மாயத்தோற்றம் பரிமாணம் ஒரு வீட்டோ உருப்படியாகும். ஒவ்வொரு பரிமாணத்திற்கும் எடுத்துக்காட்டுகள் மற்றும் எல்லை நிகழ்வுகளை வழங்கவும்.
சோதனை 7-4 ★★: மேம்பட்ட JSON கார்டுகள் மற்றும் RAG இன் ஒப்பீட்டு மதிப்பீடு
முன்நிபந்தனைகள்: அத்தியாயம் 3 பயனர் நினைவகம் மற்றும் RAG சோதனைகளை (chapter3/user-memory, chapter3/agentic-rag-for-user-memory) முடித்திருக்க வேண்டும்.
நோக்கம்: கட்டமைக்கப்பட்ட நினைவகத்தின் நன்மைகள் மற்றும் எல்லைகளை, கட்டமைக்கப்படாத மீட்டெடுப்புடன் ஒரே மதிப்பீட்டுத் தொகுப்பில் நியாயமாக ஒப்பிடுதல். இரண்டு அத்தியாயம் 3 திட்டங்களை மீண்டும் பயன்படுத்தி, chapter3/user-memory-evaluation இலிருந்து 60 சோதனை வழக்குகளில் மூன்று உள்ளமைவுகளை ஒப்பிடுக—தூய மேம்பட்ட JSON கார்டுகள் (கட்டமைக்கப்பட்ட கார்டுகள் சூழலில் உள்ளன, மீட்டெடுப்பு தேவையில்லை), தூய RAG (உரையாடல் துண்டுகள் ஒரு திசையன் சேமிப்பகத்தில் உட்பொதிக்கப்பட்டுள்ளன, மீட்டெடுப்பு தேவை), கலப்பின அமைப்பு (முக்கிய உண்மைகள் சூழலில் உள்ளன + அசல் உரையாடல்கள் தேவைக்கேற்ப மீட்டெடுக்கப்படுகின்றன).
ஏற்பு அளவுகோல்கள்: மூன்று சிக்கலான நிலைகளில் (அடிப்படை நினைவுபடுத்தல் / பல-அமர்வு தெளிவின்மை நீக்கம் / குறுக்கு-அமர்வு மறைந்த தொடர்புகள்) வெற்றி விகிதம், சராசரி படிகள், கருவி அழைப்புகளின் எண்ணிக்கை, தாமதம் மற்றும் செலவு ஆகியவற்றைப் பதிவு செய்யவும். ஒவ்வொரு அணுகுமுறையின் தோல்வி எல்லைகளை தெளிவாக விவரிக்கவும்—கட்டமைப்பு எதை இழக்கிறது, மீட்டெடுப்பு எதை இழக்கிறது, மற்றும் கலப்பினம் உண்மையில் ஒருங்கிணைப்பை அடைகிறதா என்பதை. உள்ளமைவு விவரங்கள் மற்றும் சோதனை வழக்குகள் துணைக் களஞ்சியத்தில் கிடைக்கின்றன.
துணைச் சோதனையில் மூன்று அமைப்புகளும் ஒரே 60 கேள்விகளில் இயக்கப்பட்டு, 180 உண்மையான API trajectory-கள் சேமிக்கப்பட்டன. அட்டவணை 7-3 சதவீதங்களுடன் வெற்றியடைந்த வழக்குகளின் எண்ணிக்கையையும் காட்டுகிறது.
அட்டவணை 7-3 நினைவக அமைப்பு மற்றும் பணி நிலை வாரியான வெற்றி விகிதம்
அமைப்பு
அடிப்படை நினைவுபடுத்தல்
பல-அமர்வு தெளிவின்மை நீக்கம்
அமர்வுகள் கடந்த மறை தொடர்புகள்
மொத்தம்
Advanced JSON Cards
95%
60%
50%
68.3% (41/60)
RAG
90%
40%
15%
48.3% (29/60)
கலப்பினம்
80%
70%
50%
66.7% (40/60)
மிகக் கவனிக்கத்தக்கது: கலப்புத் தீர்வு தானாகவே வென்றுவிடவில்லை. 3 வினாக்களில் இரண்டு தனித் தீர்வுகளாலும் செய்ய முடியாததை அது செய்தது; ஆனால் வேறு 8 வினாக்களில் சிறப்பாகச் செயல்பட்ட தனித் தீர்வை விடத் தாழ்ந்தது. ஒவ்வொரு வினாவிலும் சிறந்த தனித் தீர்வோடு ஒப்பிட்டால், சராசரி வெற்றி விகிதம் மாறாகக் குறைவாகவே இருந்தது. தூய RAG அடிப்படை நினைவுகூர்தல் வினாக்களில் கட்டமைக்கப்பட்ட அட்டைகளிலிருந்து பெரிதும் வேறுபடவில்லை; ஆனால் அமர்வுகளைக் கடந்த தொடர்பு வினாக்களுக்கு வந்ததும் வெற்றி விகிதம் 15% ஆகச் சரிந்தது. கவனிக்கத் தவறும் இன்னொரு எண்: 180 தீர்ப்புகளில் மாயத்தோற்ற மறுப்பு 28 முறை இயங்கியது — ஒற்றை மறுப்புக் கூறின் முக்கியத்துவம் இதிலிருந்து தெரிகிறது.
ஒரே மாதிரியான மாதிரி மதிப்பீடு மற்றும் பல-மூல தீர்ப்பு.
ஏஜெண்டும் தீர்ப்பு மாதிரியும் ஒரே குடும்பத்திலிருந்து வரும்போது, ஏஜெண்ட் தீர்ப்பு மாதிரியின் விருப்பங்களையும் குருட்டுப் புள்ளிகளையும் சுரண்டக் கற்றுக்கொள்ளலாம்.
இதைத்தான் குட்ஹார்ட்டின் விதி கூறுகிறது: ஒரு அளவீடு ஒரு உகப்பாக்க இலக்காக மாறும்போது, அது ஒரு நல்ல அளவீடாக இருப்பதை நிறுத்திவிடும். ஒரு ஏஜெண்ட் ஒரு குறிப்பிட்ட மதிப்பீட்டு முறையில் அதிகம் பயிற்றுவிக்கப்படும்போது அல்லது சரிசெய்யப்படும்போது, அது உண்மையில் அதன் திறன்களை மேம்படுத்துவதை விட, அந்த முறையின் ஓட்டைகளைச் சுரண்டுவதற்கே அதிக வாய்ப்புள்ளது.
மேலும் நயவஞ்சகமாக, ஏஜெண்ட் படிப்படியாக தீர்ப்பு மாதிரி நன்றாகக் கண்டறிய முடியாத பிழை வகைகளைத் தவிர்க்கக் கற்றுக்கொள்ளும், இதனால் மதிப்பீட்டு முறை முற்றிலும் சரியாகத் தோன்றும்.
இதற்கான தணிப்பு உத்தி பல-மூல பன்முகத் தீர்ப்பு ஆகும்—வெவ்வேறு மாதிரி குடும்பங்களைச் சேர்ந்த பல LLMகளை சுயாதீனமாக தீர்ப்பளிக்கப் பயன்படுத்துதல் (எ.கா., ஏஜெண்ட் Claude ஐப் பயன்படுத்துகிறது, தீர்ப்பாளர்கள் GPT-5 மற்றும் Gemini ஐப் பயன்படுத்துகிறார்கள்). வெவ்வேறு குடும்பங்களின் சார்புகள் பெரும்பாலும் செங்குத்தானவை, இதனால் ஏஜெண்ட் ஒரே நேரத்தில் அனைத்து தீர்ப்பாளர்களையும் “ஏமாற்றுவது” கடினம். அனைவரும் ஒரே இலக்கை மதிப்பிடுவதை உறுதி செய்ய ஒரே Rubric-ஐப் பயன்படுத்தவும், மற்றும் எடையிடப்பட்ட சராசரி அல்லது நிலைத்தன்மை சோதனைகள் மூலம் முடிவுகளை ஒருங்கிணைக்கவும். பயன்பாட்டு கட்டத்தில், விரைவான மதிப்பீட்டிற்கு ஒற்றை மாதிரியைப் பயன்படுத்தலாம், ஆனால் முழு பல-மூல தீர்ப்பு அமைப்பைப் பயன்படுத்தி காலமுறை தர தணிக்கைகளை நடத்த வேண்டும்.
பல-மூல தீர்ப்பு “தீர்ப்பளிக்க எந்த மாதிரியைப் பயன்படுத்துவது” என்ற கேள்வியைக் கையாள்கிறது; அடுத்து, “எந்த முறைகளை மதிப்பிடுவது” என்பதைக் கையாள்கிறோம்—LLM-as-a-Judge இன் திறனை உரையிலிருந்து பேச்சு, படங்கள் மற்றும் வீடியோ வரை நீட்டிப்பது மதிப்பீட்டு கவரேஜின் மற்றொரு பரிமாணமாகும்.
மல்டிமோடல் LLM-as-a-Judge.
மல்டிமோடல் நீதிபதி முறையானது LLM-as-a-Judge என்ற கருத்தை பேச்சு, படங்கள் மற்றும் வீடியோ துறைகளுக்கு விரிவுபடுத்துகிறது. பின்வரும் நான்கு பொதுவான திசைகள் உள்ளன.
TTS மதிப்பீடு (TTS என்பது Text-to-Speech ஐக் குறிக்கிறது): துல்லியம், இயற்கைத்தன்மை, குரல் நிலைத்தன்மை மற்றும் உணர்ச்சி வெளிப்பாடு ஆகியவற்றை மதிப்பிடுகிறது. இந்த பரிமாணங்கள் பாரம்பரிய WER (Word Error Rate) கண்டறிய சிரமப்படும் உச்சரிப்பு சார்ந்த சிக்கல்களைப் பிடிக்க முடியும்.
ASR மதிப்பீடு (ASR என்பது Automatic Speech Recognition ஐக் குறிக்கிறது): சொற்பொருள் தாக்க மதிப்பீட்டைச் செய்கிறது—“இன்றைய வானிலை” என்பதை தவறாக அடையாளம் காண்பது பாதிப்பில்லாதது, ஆனால் “ஆயிரத்தை மாற்று” என்பதை “பத்தாயிரம்” என்று தவறாக அடையாளம் காண்பது கடுமையான விளைவுகளை ஏற்படுத்தக்கூடும்.
UI மதிப்பீடு: உரை வழிதல், வண்ண மாறுபாடு மற்றும் பொத்தான் இடம் போன்ற சிக்கல்களைச் சரிபார்க்க முன்மொழிபவர்-மதிப்பாய்வாளர் பொறிமுறையைப் பயன்படுத்துகிறது. இங்கே, முன்மொழிபவர்-மதிப்பாய்வாளர் ஒரு மதிப்பீட்டு முறையாக பயன்படுத்தப்படுகிறது, இது அத்தியாயம் 5 இல் ஒரு உருவாக்க அமைப்பு கூறாக அதன் பயன்பாட்டிலிருந்து வேறுபடுகிறது, ஆனால் மைய பொறிமுறை ஒன்றுதான்—ஒரு மாதிரி உருவாக்குகிறது, மற்றொன்று சுயாதீனமாக மதிப்பாய்வு செய்கிறது.
வீடியோ எடிட்டிங் மதிப்பீடு: முக்கிய பிரேம்கள் மூலம் கிளிப்பின் தொடக்கம்/முடிவு புள்ளிகள் மற்றும் விளைவு பயன்பாடு ஆகியவற்றின் சரியான தன்மையை சரிபார்க்கிறது.
சோதனை 7-5 ★★: முழுமையான தானியங்கி TTS தர மதிப்பீட்டு குழாயை உருவாக்குதல்
இந்த சோதனைக்கு பூஜ்ஜியத்திலிருந்து ஒரு முழுமையான மல்டிமோடல் LLM-as-a-Judge TTS தர மதிப்பீட்டு அமைப்பை வடிவமைத்து செயல்படுத்த வேண்டும்.
பல பரிமாண TTS மதிப்பீட்டு அளவுகோலை வடிவமைக்கவும்: துல்லியம் பரிமாணம் அனைத்து உரையும் சரியாக வாசிக்கப்பட்டதா (விடுபடல்கள்/தவறான வாசிப்புகள்/கூடுதல் இல்லை) என்பதை சரிபார்க்கிறது; இயற்கைத்தன்மை பரிமாணம் பேச்சு சரளமாக உள்ளதா (இயந்திரத்தனமான உணர்வு, இயற்கைக்கு மாறான இடைநிறுத்தங்கள் இல்லாமல், மற்றும் உச்சரிப்பு மனித பழக்கவழக்கங்களுக்கு ஏற்ப உள்ளதா) என்பதை மதிப்பிடுகிறது; உணர்ச்சி வெளிப்பாடு பரிமாணம் குரலின் தொனி உரையின் உணர்ச்சி நிறத்துடன் பொருந்துகிறதா (கேள்விகளுக்கு ஏறும் ஒலி, ஆச்சரியங்களுக்கு வலியுறுத்தல், சோகமான உள்ளடக்கத்திற்கு மெதுவான வேகம் மற்றும் குறைந்த சுருதி) என்பதை சரிபார்க்கிறது; குரல் நிலைத்தன்மை பரிமாணம் குறிப்பு குரல் கிடைக்கும்போது பேச்சாளர் ஒற்றுமையை மதிப்பிடுகிறது (மல்டிமோடல் மாதிரி ஒரே நேரத்தில் குறிப்பு குரல் மற்றும் தொகுக்கப்பட்ட குரலை ஒப்பிடுவதற்குப் பெறுகிறது).
நீளம், வகை, உணர்ச்சி, சிறப்பு சவால் ஆகியவற்றில் மாறுபடும் சோதனைத் தொகுப்பை உருவாக்கவும். TTS தொகுதியை OpenAI, ElevenLabs, Fish Audio, Minimax, Doubao போன்ற சேவைகளுடன் இணைத்து, உருவாக்கப்பட்ட ஒலி, மூல உரை, குறிப்பு ஒலி, மதிப்பீட்டு அளவுகோல் ஆகியவற்றை நேரடியாக ஒலியைப் பெறக்கூடிய மல்டிமோடல் தீர்ப்பாளருக்கு வழங்கவும். ஒவ்வொரு மதிப்பெண்ணையும் மீளாய்வு செய்ய, தீர்ப்பாளர் மாதிரி மற்றும் வேட்பாளர்/குறிப்பு ஒலிகளின் hash-களைச் சேமிக்கவும்.
துணைக் களஞ்சியத்தில் ஒரு சிறிய நேரடி கேட்பு சோதனைச் சேமிக்கப்பட்டுள்ளது. OpenAI மற்றும் Fish Audio தலா நான்கு ஒலிகளை—எண்கள், பல உச்சரிப்புள்ள சீன எழுத்துகள், நீளமான உரை, உற்சாகமான வழங்கல்—உருவாக்கின; Voxtral எட்டு ஒலிகளையும் நான்கு பரிமாணங்களில் மதிப்பிட்டது. இரண்டுக்கும் துல்லியத்தில் 5.00, இயற்கைத்தன்மையில் 4.00 கிடைத்தது. Fish Audio உணர்ச்சி/குரல் நிலைத்தன்மையில் 4.00/3.00; OpenAI 3.75/2.75 பெற்றது. பரிமாணங்களைப் பிரித்ததால், “சரியாக வாசித்ததா?” என்ற ஒரே கேள்வி காட்டாத வேறுபாடுகள் வெளிப்பட்டன.
இந்த மதிப்பெண்கள் சிறந்த வழங்குநரை நிரூபிப்பதில்லை. வழங்குநருக்கு நான்கு ஒலிகள் மட்டுமே இருந்தன; மேலும் நிலையான குறிப்பு ஒலி Fish S1 இலிருந்து வந்ததால், குரல் ஒற்றுமையில் Fish Audio-க்கு இயல்பான முன்னிலை இருந்தது. பொதுவான TTS ஒப்பீட்டில் அந்தப் பரிமாணத்தை நீக்க வேண்டும் அல்லது ஒவ்வொரு வேட்பாளருக்கும் பொருத்தமான இலக்குக் குரலை வழங்க வேண்டும். குரல் cloning ஒப்பீட்டில் எல்லா அமைப்புகளும் ஒரே பேச்சாளரைப் பின்பற்ற வேண்டும்; மாதிரி தீர்ப்பை மறைமுக மனிதக் கேட்புடன் அளவுத்திருத்த வேண்டும். குறிப்பு பதில், படம் அல்லது ஒலியைத் தேர்வது மதிப்பீட்டு வடிவமைப்பின் ஒரு பகுதி; நடுநிலையான தயாரிப்பு வேலை அல்ல.
கையேடு Rubric-கள் இத்தகைய கண்டறியும் பரிமாணங்களை விரைவாக உருவாக்க உதவும். பெரிய அளவில், சிறப்பு உருவாக்க வெகுமதி மாதிரிகள் தானியங்கி தீர்ப்பைச் செய்யலாம்; அவற்றின் பயிற்சி அத்தியாயம் 8 இல் விவாதிக்கப்படுகிறது.
தீர்ப்பு மாதிரி தரும் மதிப்பெண் முடிவு நல்லதா கெட்டதா என்பதை மட்டுமே சொல்கிறது; அந்த முடிவைச் சரிசெய்யக்கூடிய பிரச்சினையாக மாற்ற வேண்டுமானால், தோல்வி எந்தப் படியிலிருந்து தொடங்கியது என்பதைக் கண்டறியவும் வேண்டும்.
தோல்வி காரணம்: trajectory-இல் முதல் பிழையைக் கண்டறிதல்
இறுதி-முதல்-இறுதி மதிப்பீடு பொதுவாக “வெற்றி” அல்லது “தோல்வி” என்பதை மட்டுமே தருகிறது; “ஏன் தோல்வி, எந்தப் படியிலிருந்து தோல்வி” என்பதற்கு விடை தருவதில்லை. மதிப்பீட்டு முடிவுகள் உண்மையிலேயே சரிசெய்தலைத் தூண்ட வேண்டுமானால், ஒவ்வொரு தோல்விப் பாதைக்கும் தோல்விக் காரணக் கூறல் (failure attribution) செய்தே ஆக வேண்டும்: முதன்மைப் பிழை வகையையும், ஏற்க முடியாத நடத்தை முதன்முதலில் தோன்றிய படியையும், அதற்கு உரிய கருவி அழைப்பையோ மாதிரி வெளியீட்டையோ குறித்து, மறுபரிசீலனை செய்யக்கூடிய சான்றையும் இணைக்க வேண்டும். காரணக் கூறலின் இலக்கு, பாதையில் பணியை முதன்முதலில் விலகச் செய்த பிழையே; அதற்குப் பிந்தைய பிழைகள் பெரும்பாலும் தொடர் விளைவுகளே — கடைசியாக வந்த பிழைச் செய்தியை எளிதாக மூலக் காரணமாகக் கருதிவிடக் கூடாது.
Coding Agent-க்கான தொடக்க வகைகள்: செயல்முறை அல்லது repository விதி விடுபாடு, tool/format பிழை, அசாதாரண நிறுத்தம், completion அல்லது logic பிழை. படி எண், tool, observation, root cause மற்றும் consequence, recoverability, confidence ஆகியவற்றை JSON/YAML ஆகவும் environment state, versions, முழு trajectory உடனும் சேமிக்கவும்.
தோல்விக் காரணக் கண்டறிதல் அமைப்பைக் கட்டியெழுப்ப, உற்பத்திச் சூழலின் சிக்கல் தடங்களை உருவாக்குநர் பொறுமையாகப் படித்து ஆய்வு செய்ய வேண்டும். இப்பணியில் LLM உதவும், ஆனால் மனிதருக்கு மாற்றாகாது; ஏனெனில் தோல்விக் காரணக் கண்டறிதல் தொழில்நுட்பச் சிக்கல்களை மட்டுமன்றி, பெரும்பாலும் தயாரிப்புச் சிக்கல்களையே வெளிப்படுத்துகிறது.
தயாரிப்பு முதிர்ச்சியடையும்போது, பிழை வகைப்பாடு பல பெரும் வகைகளையும், ஒவ்வொன்றின் கீழ் உட்பிரிவுகளையும் கொண்டு, இறுதியில் நூற்றுக்கணக்கான உள்ளீடுகளை எட்டக்கூடும். இந்த வகைகளும் காரணக் கண்டறிதல் முறைகளும் பின்னர் ஒரு காரணக் குறிப்பீட்டு Agent-இன் prompt அல்லது Skill ஆகின்றன.
Coding Agent-ஐ எடுத்துக்காட்டாகக் கொண்டால், பயன்படக்கூடிய தொடக்க வகைப்பாடு பின்வருமாறு.
பிழை வகை
பொதுவான வெளிப்பாடு
முதல் பிழையைக் கண்டறியும் வழி
தேவை புரிதலும் தெளிவின்மையும்
உருவானது பயனர் கேட்டது அல்ல: தேவையிலிருந்து ஒரு நிபந்தனை விடுபடுகிறது, அல்லது எல்லை மிக விரிவாக/மிகக் குறுகலாகப் புரிந்து கொள்ளப்படுகிறது; களஞ்சியத்தில் ஒரே பெயரில் இரு அமைவு கோப்புகள் இருக்கும்போது, விளக்கமும் கேள்வியும் இன்றி ஒன்று தேர்ந்தெடுக்கப்படுகிறது
மூலத் தேவையையும் Agent உண்மையில் செய்ததையும் (செயல் வரிசையையும்) LLM மூலம் ஒவ்வொன்றாக ஒப்பிடவும்; முடிவு நிலையில் முதல் விலகலைக் கண்டறிந்து, அதை உருவாக்கிய கருவி அழைப்பு அல்லது பதிலுக்குத் திரும்பிச் செல்லவும்
செயல்முறை அல்லது மரபு விடுபாடு
அலகுச் சோதனைகளை ஓட்டாமல் commit செய்தல்; Plan எழுதாமல் நிரலைத் திருத்தத் தொடங்குதல்; களஞ்சியத்தில் உள்ளக இணையான ஒன்று இருக்கும்போது வெளிச் சார்பை இழுத்தல்; நிறுவப்பட்ட கட்டமைப்பு மரபைத் தவிர்த்தல்
வளர்ச்சி செயல்முறை மரபை மீறிய முதல் செயலைக் கண்டறியவும் — முதல் git commit, முதல் கோப்பு எழுதுதல் — அதற்கு முன் அது மரபின் மூலத்தைப் படித்ததா என்று திரும்பிப் பார்க்கவும்
கருவி அழைப்புப் பிழைகள்
ஒரே கோப்பின் திருத்தம் மீண்டும் மீண்டும் தோல்வியடைதல்; தவறான JSON/schema அல்லது அளபுரு வடிவம்; சிறப்பு எழுத்துகள் நகலெடுத்தல், escape, எழுதுதலைச் சிதைத்தல்
முதல் தோல்வியுற்ற திருத்தத்தை/கருவியை, மூல வேண்டுகோள் மற்றும் திருப்பிய பிழையுடன் சேர்த்துப் பதிவு செய்யவும்; திரும்பத் திரும்ப வரும் தோல்விகள் அடுத்தடுத்த அறிகுறிகளே
சரிபார்ப்புச் சூழலை hack செய்தல்
assertion-ஐ மாற்றுதல், skip சேர்த்தல், சோதிக்கப்படும் தர்க்கத்தை mock செய்தல்; ஒருபோதும் ஓட்டாத சோதனையை “தேறிவிட்டது” எனக் கூறுதல்
சோதனையையோ சரிபார்ப்புத் தர்க்கத்தையோ முதலில் மாற்றிய message-ஐ எடுக்கவும்; பின் நிறைவு அறிவிப்பை தடத்தில் உண்மையில் இயக்கப்பட்ட கட்டளைகளுடன் ஒப்பிட்டு அது உண்மையில் ஓடியதா என உறுதிசெய்யவும்
முழுமையற்ற மாற்றம்
செயற்கூற்றின் கையொப்பம் மாற்றப்பட்டு மூன்று அழைப்பு இடங்கள் புதுப்பிக்கப்பட்டன, ஆனால் நான்காவது — ஒரு இயங்குநிலை அழைப்பு, மற்றொரு மொழி binding, அல்லது ஒரு schema — விடுபட்டது
Agent கூறிய தாக்க எல்லைக்கும் உண்மையான எல்லைக்கும் இடையிலான வேறுபாட்டைக் கணக்கிட்டு, முதல் விடுபாட்டை எடுத்து, அது தேடலில் என்ன முக்கியச் சொற்களைப் பயன்படுத்தியது எனப் பார்க்கவும்
பயனருக்குத் தவறான தகவல் அளித்தல்
கருவி அழைப்புகளும் இறுதி நிலையும் முற்றிலும் சரி, ஆனால் பயனரிடம் சொன்ன தகவல் தவறு: தொகை, நிலை அல்லது நேரம் தவறு; பகுதியாக முடிந்ததை முழுவதும் முடிந்ததாகச் சொல்வது; கட்டாயம் தெரிவிக்க வேண்டியதை விடுவது
பதிலிலுள்ள ஒவ்வொரு உண்மைக் கூற்றையும் கருவி திருப்பிய மதிப்புகளுடன் ஒப்பிட்டு, மூலம் காண முடியாத அல்லது திருப்பலுக்கு முரணான முதல் கூற்றை எடுக்கவும்
செயல்பாடு சாராத பின்னடைவு
பொது API அல்லது schema migration ஸ்கிரிப்ட் இன்றி மாறுகிறது; சோதனை தேறுவதற்காக சரிபார்ப்பு நீக்கப்படுகிறது
அம்மாற்றத்தைச் செய்த முதல் message-ஐ எடுத்து, தான் தொடுவது பொது இடைமுகம் அல்லது migration தேவைப்படும் அமைப்பு என்பதை உணர்ந்ததா எனப் பார்க்கவும்
மாதிரியின் அசாதாரண முடிவு
வெளியீடு நடுவில் துண்டிக்கப்படுதல், காரணமின்றி நிற்றல், நேரம் கடத்தல், அல்லது நிறைவுச் செயல் இன்றி முடிதல்
முதல் அசாதாரண முடிவைக் கண்டறிந்து, மாதிரி நிற்பது, Harness நேரம் கடப்பது, கருவிச் சேவை கோளாறு ஆகியவற்றைப் பிரிக்கவும்
பணியை மிக விரைவில் நிறுத்துதல்
பல இலக்குப் பணியில் ஒரு பகுதி மட்டுமே முடிகிறது; நியாயமான வழிகளை முழுமையாக முயலாமல் இயலாது என அறிவித்தல்
ஒரு இலக்கை விட்ட அல்லது தேடலைக் கைவிட்ட முதல் முடிவைக் கண்டறிந்து, இறுதிச் சரிபார்ப்புத் தோல்வியிலிருந்து தனியாகப் பதிவு செய்யவும்
காரணக் குறிப்பீட்டு Agent, LLM-ஐப் பயன்படுத்தி ஏராளமான உற்பத்தித் தடங்களுக்கு மூலக் காரண ஆய்வை பெரிய அளவில் நடத்த முடியும்; ஆனால் “தோல்விக்கான காரணம்” என ஒரே வாக்கியத்தை வெளியிட்டால் போதாது. காரணப் பதிவு கட்டமைக்கப்பட்டதாக இருக்க வேண்டும்: JSON அல்லது YAML வடிவில், குறிப்பிட்ட படி எண்கள், கருவிப் பெயர்கள், அவதானிக்கப்பட்ட சான்றுகளை மேற்கோள் காட்டி; மேலும் மூலக் காரணத்தையும் விளைவையும் பிரித்து, மீட்க இயலுமா என்பதை மதிப்பிட்டு, நம்பகத்தன்மை அளவைத் தர வேண்டும். எடுத்துக்காட்டாக, edit_fileold_string பொருந்தாமையைத் திருப்பியபின் Agent மூன்று முறை மீண்டும் முயன்றும் கோப்பை எழுத முடியவில்லை எனில், முதன்மைக் காரணம் கோப்புத் திருத்தம் மற்றும் கருவி அழைப்புப் பிழை; அந்த மூன்று மறுமுயற்சிகள் விளைவுகளே தவிர மூன்று தனித்த மூலக் காரணங்கள் அல்ல. பல வகைகள் ஒரே நேரத்தில் தோன்றினால், “மிக முந்தையது, மேலும் அடுத்தடுத்த தோல்விகளை விளக்கக்கூடியது” என்ற கொள்கையின்படி முதன்மைக் காரணத்தைத் தேர்ந்து, மற்றவற்றை இரண்டாம் நிலைக் காரணங்களாக வைத்திருக்கவும். மேற்கண்ட அட்டவணையில் குறைந்தது மூன்று வகைகளை, LLM-இடம் முதல் பிழையைக் கண்டறியச் சொல்வதற்கு முன், விதிகளால் முன்வடிகட்ட முடியும்: நிறைவு அறிவிப்பை உண்மையில் இயக்கப்பட்ட கட்டளைகளுடன் ஒப்பிடுவது; diff சோதனை assertion-களையும் skip குறிகளையும் தொடுகிறதா; diff migration கோப்பின்றி பொது API அல்லது schema-வை மாற்றுகிறதா. முதலில் விதிகளால் வடிகட்டி, பின் LLM-ஆல் இடம் காண்பது, எல்லாத் தடங்களையும் LLM-இடம் கொட்டுவதைவிட மலிவானதும் துல்லியமானதும் ஆகும்.
காரணப் பதிவைச் சேமிக்கும்போது LLM-இன் வெளியீடு மட்டும் போதாது: பணி இலக்கு, சூழல் நிலை, Agent பதிப்பு, கருவித் தொகுப்புப் பதிப்பு, மற்றும் முழு Agent தடம் ஆகியவற்றையும் சேர்த்துச் சேமிக்கவும்; அப்போதுதான் அவ்வழக்கை ஒரு பின்னடைவுச் சோதனையாக மாற்ற முடியும்.
கீழே மூன்று பொதுவான பிழை வகைகளை எடுத்துக்காட்டாக விளக்குகிறோம்.
“செய்தது சரி, சொன்னது தவறு” பிரச்சினை
“செய்தது சரி, சொன்னது தவறு” என்பதே ஒட்டுமொத்த வெற்றி விகிதத்தால் மிக எளிதாக மறைக்கப்படும் வகை, ஏனெனில் பெரும்பாலான மதிப்பீடுகள் சூழல் நிலையை மட்டுமே சரிபார்க்கின்றன. τ²-bench இதைத் தனியாக மதிப்பிடுகிறது: வெளியிடப்பட்ட அடிப்படை ஓட்டங்களில் தகவல் தெரிவிப்புத் தேவை கொண்ட 704 ஓட்டங்களில் 240 தோல்வியடைந்தன; அவற்றில் 162 தகவல் தெரிவிப்புச் சோதனையில் விழுந்தன, 80 (மொத்தத் தோல்விகளில் மூன்றில் ஒன்று) சூழல் நிலை சரியாக இருந்தும் தெரிவித்த தகவல் தவறாக இருந்தன.
துணை களஞ்சியத்தில் இதற்கு இணையான வழக்கு ஒன்று உள்ளது. expenses.jpg-இல் உள்ள செலவுகளைக் கணக்குப் பயன்பாட்டில் பதிவு செய்யும் பணியில், Agent அனுமதி வழங்கல், தேடல், படத்தைத் திறத்தல், ஒவ்வொரு வரியையும் நிரப்புதல், சேமித்தல் ஆகியவற்றை 32 படிகளில் செய்தது; எந்தப் படியும் பிழையைத் திருப்பவில்லை, இறுதியில் பணி முடிந்ததாக அறிவித்தது. ஆனால் சரிபார்ப்பி, எழுதப்பட்டிருக்க வேண்டிய வரி — Dress, ¥436.35 — இல்லை என்று அறிவித்தது; அது பதிவு செய்யப்பட்ட நான்குடன் எந்தத் தொடர்பும் இல்லாதது. 8-ஆவது படியின் சிந்தனையில் “I cannot actually see the content/details of the expenses in the image” என்று உள்ளது: தரவு கிடைக்கவில்லை என்பதை அது அறிந்தே இருந்தது, நிற்கவும் இல்லை அறிவிக்கவும் இல்லை; 11-ஆவது படியில் கற்பனையான நான்கு செலவுகள் அதன் பதிவில் தோன்றின, அதன் பின் ஒவ்வொரு உள்ளீடும் அக்கற்பனைத் தரவை உண்மையாக நிறைவேற்றியது. முதல் பிழை 8-ஆவது படி; அப்படி பிழையையும் எழுப்பவில்லை, கருவி அழைப்பும் அல்ல. அதன் மூலக் காரணத்தையும் தவறாகப் பதிவது எளிது: T3A என்பது அவதானிப்பு வெளியில் உறுப்புமரம் மட்டுமே கொண்ட, பட பிக்சல்களே இல்லாத, உரை-மட்டும் Agent; எனவே காரணம் “மாதிரிக்கு OCR தெரியாது” அல்ல, இல்லாத அவதானிப்புச் சேனலும், “தகவல் கிடைக்கவில்லை” எனும் முறையான வெளியேற்றச் செயலின்மையும் ஆகும். இதை மாதிரித் திறன் பிரச்சினையாகப் பதிந்தால் அடுத்த நகர்வு மாதிரி மாற்றமோ OCR பயிற்சியோ ஆகும்; உண்மையான திருத்தம் சேனலையும் வெளியேற்றச் செயலையும் சேர்ப்பதே.
சோதனை 7-6 ★★: AndroidWorld தடங்களில் தோல்விக் காரணக் கண்டறிதல்
இந்தச் சோதனை இப்பகுதியின் காரணக் கண்டறிதல் முறையை உண்மையான தடங்களில் பயிற்சி செய்கிறது; எமுலேட்டரும் மாதிரி API-யும் தேவையில்லை. மூலப்பொருள் chapter7/android-world-இல் சேமிக்கப்பட்ட T3A இயக்கப் பதிவு: t3a.md எல்லாப் பணிகளின் படிப்படியான Action/Reason/Summary பதிவுகளையும், t3a_failed.md ஐம்பதுக்கும் மேற்பட்ட தோல்வித் தடங்களையும் கொண்டுள்ளது; ஒவ்வொன்றின் முடிவிலும் சரிபார்ப்பியின் புறநிலைத் தீர்ப்பு உள்ளது.
படி 1: மாதிரியெடுப்பு. t3a_failed.md-இலிருந்து எந்தக் கருவிப் பிழையும் இல்லாத அமைதியான தோல்விகளை குறைந்தது பத்து எடுக்கவும். எந்தக் கருவி அழைப்பும் பிழையைத் திருப்பியிருக்கக் கூடாது, Agent தானே முடிந்ததாக அறிவித்திருக்க வேண்டும் அல்லது படிகள் தீர்ந்திருக்க வேண்டும், இறுதிச் சரிபார்ப்பியின் தீர்ப்பு மட்டுமே தோல்வியைக் குறிக்க வேண்டும்.
படி 2: முதல் பிழையைக் கண்டறிதல். ஒவ்வொரு தடத்திற்கும் முதல் பிழையின் படி எண்ணைப் பதிவு செய்து, அது ஒரு கருவி அழைப்பா அல்லது ஒரு assistant message-ஆ என்பதைக் குறிக்கவும். அமைதியான தோல்விகளுக்கு இரு உத்திகள் தேவை: உண்மை நங்கூர ஒப்பீடு, Agent-இன் கூற்றுகளை கருவி திருப்பிய மதிப்புகளுடன் ஒப்பிட்டு முதல் விலகலை எடுக்கிறது; trajectory prefix இருபிரிவுத் தேடல், தடத்தை k-ஆவது படியில் வெட்டி ஒப்படைக்கிறது — இன்னும் மீட்க முடிந்தால் பிழை k-க்குப் பின் உள்ளது. பிழைச் சொற்களைத் தேடுவது இரண்டுக்கும் மாற்றாகாது.
படி 3: கட்டமைக்கப்பட்ட பதிவு. ஒவ்வொரு தடத்திற்கும் பணிப் பெயர், முதல் பிழைப் படி, பிழை வகை, மூலக் காரணத்திற்குப் பொறுப்பானவர், ஆதரவு மேற்கோள்கள் ஆகியவற்றுடன் ஒரு JSON அல்லது YAML பதிவை உருவாக்கி, முதன்மைக் காரணத்தை விளைவிலிருந்து பிரிக்கவும்.
படி 4: இருக்கும் குறிப்புடன் ஒப்பிடுதல். முடிவுகளை t3a_failed_analysis.md-உடன் ஒவ்வொன்றாக ஒப்பிட்டு வேறுபாடுகளைப் பதிவு செய்யவும். மூலக் காரணப் பொறுப்பில் கூடுதல் கவனம் தேவை: அக்குறிப்பு படத் தரவெழுத்தாக்கத் தோல்வியை “பார்வை மாதிரிக்கு OCR திறன் இல்லை” என்று பதிவு செய்திருந்தது; ஆனால் T3A-இன் அவதானிப்பு வெளியில் பட பிக்சல்களே இல்லை, எனவே உண்மையான மூலக் காரணம் இல்லாத அவதானிப்புச் சேனல். இருக்கும் காரணக் குறிப்பு விடைத்தாள் அல்ல.
படி 5: பின்னடைவுப் பணியாக மாற்றுதல். முதல் பிழை assistant message-இல் நிகழ்ந்த மூன்று தடங்களைத் தேர்ந்தெடுத்து, அப்பிழைக்கு முந்தைய prefix-ஐ வெட்டி, ஏற்கத்தக்க செயல் தொகுப்பையும் தடைசெய்யப்பட்ட செயல்களையும் எழுதி trajectory prefix பின்னடைவுப் பணிகளை உருவாக்கவும்.
நோக்க எல்லைக்கு உணர்திறன் கொண்ட ஆவண வடிவமைப்புப் பிழைகள்
பயனர் “மேற்கோள் குறியீட்டு வடிவம் தவறு” என்று சொல்லும்போது, அதை உலகளாவிய எழுத்து மாற்றமாக மாற்றக் கூடாது. குறைந்தபட்சம் ASCII நேர் மேற்கோள் குறிகள் (", '), சீன வளைந்த மேற்கோள் குறிகள் (“”, ‘’), Markdown backtick (`) ஆகியவற்றை வேறுபடுத்த வேண்டும். ஒரே எழுத்து சீன இயல்மொழி, மேற்கோள் காட்டப்பட்ட ஆங்கில மூலம், inline code, code block, code comment, JSON, path ஆகியவற்றில் வெவ்வேறு இலக்கணப் பங்கை வகிக்கிறது.
மதிப்பீட்டுத் தரவு முதலில் ஆவணத்தை நோக்க எல்லையுடன் கூடிய துண்டுகளாகப் பகுக்க வேண்டும்—எடுத்துக்காட்டாக ZH_PROSE, EN_PROSE, QUOTED_SOURCE, INLINE_CODE, CODE_BLOCK, CODE_COMMENT, JSON_OR_SCHEMA. ஒவ்வொரு துண்டும் அனுமதிக்கப்பட்ட மாற்றங்களின் தொகுப்பு, கட்டாயம் பாதுகாக்கப்பட வேண்டிய எழுத்துகள், திருத்தத்திற்குப் பிந்தைய verifier முடிவு ஆகியவற்றைச் சேமிக்கிறது. கீழுள்ள மூன்று இடங்களையும் ஒரே மாற்று விதியால் கையாள முடியாது:
சீன விளக்கம்: `reset()` முறையை அழைக்கவும்.மேற்கோள் காட்டப்பட்ட ஆங்கில மூலம்: “Please restart the service.”# கீழுள்ள code block பாதுகாக்கப்பட்ட நோக்க எல்லையை விளக்கவே# சீன comment: "தற்போதைய நிலை" ஐக் காட்டுname = "status"
Trajectory-prefix பின்னடைவுச் சோதனை மாதிரியிடம் குறைந்தபட்சத் திருத்தத்தைக் கோர வேண்டும்; அதே சமயம் சீன ஆவண நடை, ஆங்கில மூலம் பாதுகாக்கப்பட்ட விகிதம், code மற்றும் JSON இலக்கணம், இலக்கு அல்லாத உரையின் edit distance ஆகியவற்றையும் சரிபார்க்க வேண்டும். விதிகளால் நோக்க எல்லையைத் தீர்மானிக்க முடியாதபோது, மூல உரையைத் தக்கவைத்து விளக்கம் கோருவது அனுமதிக்கப்பட்ட செயலாக இருக்க வேண்டும்; ஊகத் திருத்தம் தற்செயலாக நிறைவேறுவது ஏற்கத்தக்கதல்ல.
துல்லியமான நகல் பிழைகள்: old_string mismatch-இலிருந்து அடுக்கு வாரியான கண்டறிதல் வரை
old_string தோல்வியையும் “மாதிரி தவறாக நகலெடுத்தது” என்பதோடு மட்டும் முடிக்க முடியாது. ஒரே சரத்திற்கு மூல byte hash, Unicode code point வரிசை, tokenizer token ID வரிசை ஆகியவற்றைச் சேமித்து, பின்வரும் சங்கிலியில் முதல் வேறுபாட்டைத் தேட வேண்டும்:
original file bytes → tool return → Harness serialization → model context→ model token output → decoded string → JSON/tool-call parsing → tool matching
குறைந்தபட்ச மதிப்பீட்டு probe-கள் நேரடி மறுபதிப்பு, நீண்ட சூழலிலிருந்து பிரித்தெடுத்தல், tool அளவுருவில் வைத்தல், ஒத்த சரங்களுள் தேர்வு, மேலும் இடைவெளி, வரிமாற்றம், backslash, Unicode combining எழுத்துகள், குறைவான அதிர்வெண் கொண்ட token ஆகியவற்றை உள்ளடக்கும். அளவீடுகளாக byte-exact match, code-point-exact match, token-exact match, முதல் வேறுபாட்டின் இடம், உண்மையான tool வெற்றி விகிதம் ஆகியவை பயன்படுகின்றன. நேரடி probe-இல் மாதிரி சரியாக இருந்தும் tool அழைப்பு தோல்வியடைந்தால், tokenizer, serialization, Harness அல்லது tool நெறிமுறையைச் சரிசெய்ய வேண்டும்; முதல் வேறுபாடு மாதிரியின் சொந்த வெளியீட்டில் தோன்றும்போது மட்டுமே அந்த வழக்கை ஏழாம் அத்தியாயத்தின் நகலெடுப்புப் பயிற்சித் தரவாக மாற்ற வேண்டும்.
End-to-end பின்னடைவு மற்றும் trajectory-prefix பின்னடைவு பணிகள்
தோல்விக் காரணக் கண்டறிதல் முதல் பிழையையும் அதன் வகையையும் தெளிவுபடுத்திய பின், அடுத்த படி திருத்த இலக்கை மீண்டும் இயக்கக்கூடிய சோதனை வழக்காக, அதாவது பின்னடைவுப் பணியாக (regression task) எழுதுவது. இங்கு ஒன்றையொன்று நிரப்பும் இரு அடுக்குகள் தேவை: End-to-end பின்னடைவுப் பணிகள் மாற்றம் முழு பணிப்பாய்வையும் உடைக்கவில்லை என்பதைச் சரிபார்க்கின்றன; trajectory prefix பின்னடைவுப் பணிகள் முதல் பிழைக்கு முந்தைய நிலையை வெட்டி எடுத்து, அந்த முடிவு எல்லை சரிசெய்யப்பட்டதா என்பதை மட்டும் சரிபார்க்கின்றன.
End-to-end பின்னடைவுப் பணிகள் தொடக்க நிலையிலிருந்தும் பயனர் வேண்டுகோளிலிருந்தும் தொடங்கி, Agent முழுப் பணியையும் முடிக்க அனுமதித்து, இறுதி நிலை, தேவையான வெளியீடு, பாதுகாப்பு நிபந்தனைகளைச் சரிபார்க்கின்றன. இவை உற்பத்தி முடிவுக்கு மிக நெருக்கமானவை; ஆனால் தோல்வி எந்தப் படியில் நேர்ந்தது என்பதைக் கண்டறிவது கடினம். பொதுவாக, ஒவ்வொரு துறையிலும் Agent-இன் திறன் எதிர்பார்ப்புக்கு ஏற்ப உள்ளதா என்பதைச் சரிபார்க்க இவை பயன்படுகின்றன. இவ்வத்தியாயத்தில் குறிப்பிட்ட OSWorld, AndroidWorld, tau-bench போன்ற நிலையான மதிப்பீட்டுத் தொகுப்புகள் அனைத்தும் end-to-end பின்னடைவுப் பணிகளே.
trajectory prefix பின்னடைவுப் பணிகள் ஏற்கெனவே உள்ள சூழல், உரையாடல், கருவித் திருப்பல்கள், சூழல் நிலை ஆகியவற்றை உறையவைத்து, அடுத்த ஒன்று அல்லது சில அவதானிக்கத்தக்க செயல்களை மட்டும் சிந்தித்துச் செய்யுமாறு Agent-ஐக் கேட்கின்றன. செலவு குறைவு; ஒற்றைக் கொள்கை அல்லது கருவிச் சிக்கலைத் தனிமைப்படுத்தவும் முடியும். உயர் நம்பகத்தன்மை தேவைப்படும் உற்பத்தி நிலை Agent-க்கு, prefix பணித் தொகுப்பை உருவாக்குவது பெரும்பாலும் end-to-end தொகுப்பைவிட முக்கியமானது; முந்தைய பகுதியில் விவரித்த தோல்வி வகைப்பாட்டையும் காரணக் கண்டறிதல் அமைப்பையும் பொறுமையாகக் கட்டியெழுப்ப வேண்டும்.
prefix பணியின் விடை, ஒற்றைச் செயலாகவோ ஒற்றை விடையாகவோ அல்லாமல் ஏற்கத்தக்க செயல் தொகுப்பாக வரையறுக்கப்பட வேண்டும்: “முதலில் களஞ்சிய விதிகளைப் படி”, “முதலில் பயனரிடம் கேள்”, அல்லது “ஆபத்தான செயலை மறு” எனக் கோரலாம்; அதே நேரத்தில் தடைசெய்யப்பட்ட செயல்களையும் பட்டியலிட வேண்டும்.
தோல்விக் காரணக் கண்டறிதல் முடிந்ததும், end-to-end மற்றும் trajectory prefix பின்னடைவுப் பணிகள் இரண்டையும் உள்ளடக்கிய மதிப்பீட்டுத் தரவுத்தொகுப்பை உருவாக்க முடியும். Coding Agent-ஐ எடுத்துக்காட்டாகக் கொண்டால்: செயல்முறை விடுபாட்டுக்கு, திட்ட ஆவணமும் சோதனை ஏற்பு நிபந்தனைகளும் கொண்ட end-to-end பின்னடைவுப் பணியை உருவாக்க வேண்டும்; கருவி அழைப்புப் பிழைக்கு, தவறிய prefix-ஐ வெட்டி எல்லைப் பணியாகத் திருத்தி, மாதிரி வடிவத்தைச் சரிசெய்யுமா, சிறப்பு எழுத்துகளை escape செய்யுமா, பொருத்தமான கருவிக்கு மாறுமா எனச் சோதிக்க வேண்டும்; அசாதாரண முடிவுக்கு, துண்டிப்பு, நேரம் கடத்தல், கருவிக் கோளாறு ஆகியவற்றிலிருந்து மீளும் சூழ்நிலைகளைச் சேர்க்க வேண்டும்; முழுமை மற்றும் தர்க்கப் பிழைகளுக்கு, பல இலக்குப் பட்டியல்கள், மீதிப் பணி நினைவூட்டல்கள், “இயலாது என இன்னும் நிரூபிக்கப்படவில்லை” எனும் எல்லையைச் சேர்க்க வேண்டும்; தேவை புரிதல் மற்றும் தெளிவின்மை வகைக்கு, பல நியாயமான விளக்கங்கள் உள்ள பணிகளை prefix ஆக உறையவைத்து, “முதலில் தெளிவுபடுத்து” என்பதை ஏற்கத்தக்க செயல்களில் சேர்க்க வேண்டும்; அறிகுறி ஒட்டுதல் மற்றும் சரிபார்ப்புப் போலியாக்கல் வகைக்கு, ஏற்பில் “சோதனை assertion-களை மாற்றக் கூடாது”, “நிறைவு அறிவிப்புடன் உண்மையில் இயக்கப்பட்ட கட்டளையின் வெளியீடு இணைக்கப்பட வேண்டும்” எனும் இரு கடுமையான கட்டுப்பாடுகளைச் சேர்க்க வேண்டும்; தகவல் அளிப்பு வகைக்கு, சூழல் நிலையை மட்டும் சரிபார்க்காமல் பதிலின் உள்ளடக்கத்தின் மீதே assertion வைக்க வேண்டும்.
சோதனை 7-7 ★★: பல encoding-களுடன் trajectory-prefix எல்லை மதிப்பீடு
Known memory, current instruction, trajectory prefix, tool returns மற்றும் environment state-ஐ வழங்கி அடுத்த observable action-ஐ மட்டும் கேட்கிறது. 11 வழக்குகள் JSON Cards, Markdown, Python-like ஆகக் குறியிடப்பட்டு deterministic rules-ஆல் மதிப்பிடப்பட்டன. 33/33 cells API பிழையின்றி முடிந்தன; ஒவ்வொரு encoding-மும் 6/11 தேர்ச்சி பெற்றது. Representation-ஐ மாற்றுவது மட்டும் policy-ஐ சரிசெய்யாது.
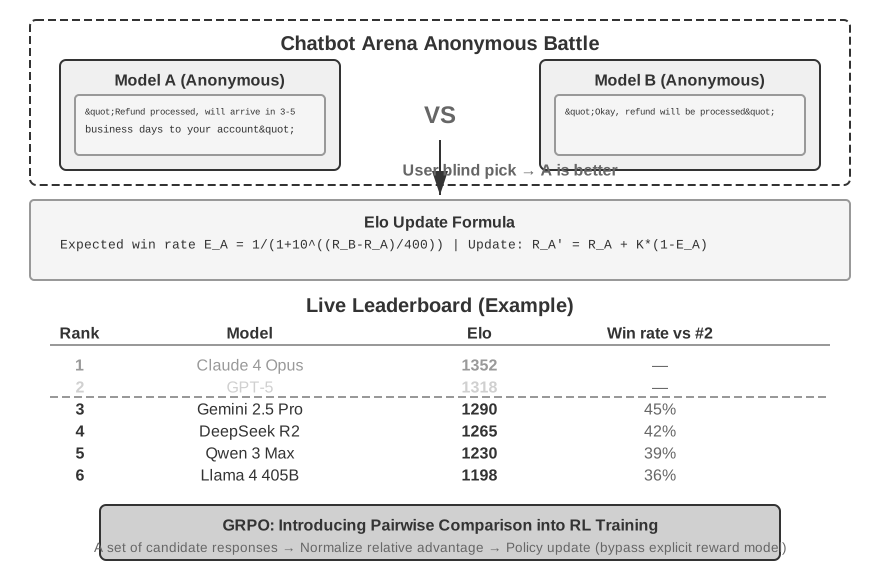
நடைமுறை மாதிரி தேர்வில், “A அல்லது B, எது சிறந்தது?” என்ற கேள்வியை நாம் அடிக்கடி எதிர்கொள்கிறோம். ஜோடிவரிசை ஒப்பீடு (Pairwise comparison) என்பது முழுமையான மதிப்பெண்களை நம்பியிருக்காத ஒரு மதிப்பீட்டு முறையை வழங்குகிறது.
ஜோடிவரிசை ஒப்பீடு மற்றும் மாதிரி தரவரிசை
படம் 7-6: எலோ மதிப்பீடு மற்றும் ஜோடிவரிசை ஒப்பீட்டு தரவரிசை · மூலப் படம்
எலோ மதிப்பீடு (Elo Rating) (முதலில் சதுரங்கத்திற்காக வடிவமைக்கப்பட்ட ஒரு தரவரிசை முறை) அதிக எண்ணிக்கையிலான ஜோடிவரிசை போட்டிகள் மூலம் மாதிரிகளின் ஒப்பீட்டுத் திறனை அளவிடுகிறது: மதிப்பீட்டு வேறுபாடு பெரியதாக இருந்தால், வலுவான மாதிரிக்கான எதிர்பார்க்கப்படும் வெற்றி விகிதம் அதிகமாக இருக்கும். எடுத்துக்காட்டாக, மாதிரி A க்கு 1200 மதிப்பீடும், மாதிரி B க்கு 1000 மதிப்பீடும் இருந்தால், எலோ முறை A இன் வெற்றி விகிதத்தை தோராயமாக 76% என கணிக்கும். B எதிர்பாராத விதமாக வென்றால், B அதிக புள்ளிகளைப் பெறும் மற்றும் A அதிக புள்ளிகளை இழக்கும்—ஒரு அதிர்ச்சி முடிவு பெரிய திருத்தத்தைத் தூண்டுகிறது; இதுவே தரவரிசைகள் உண்மையான திறனை நோக்கி விரைவாகக் குவிய உதவுகிறது. இதன் புள்ளியியல் அடித்தளம் பிராட்லி-டெர்ரி மாதிரி (Bradley-Terry model): ஒவ்வொரு மாதிரியும் ஒரு மறைமுகமான “வலிமை மதிப்பெண்ணாக” சுருக்கப்படுகிறது, மேலும் ஒரு ஜோடிவரிசை போட்டியில் ஒன்று மற்றொன்றை வெல்லும் நிகழ்தகவு அவற்றின் மதிப்பெண்களின் வேறுபாட்டால் தீர்மானிக்கப்படுகிறது. எலோ என்பது இந்த மாதிரியின் ஆன்லைன் புதுப்பிப்பு வடிவத்தில் ஒரு பொறியியல் செயலாக்கமாகும்.
Chatbot Arena அநாமதேய சீரற்ற போட்டிகளைப் பயன்படுத்துகிறது—பயனர்கள் மாதிரியின் அடையாளத்தை அறியாமல் சிறந்த பதிலை கண்மூடித்தனமாகத் தேர்ந்தெடுக்கிறார்கள், மேலும் தரவரிசைகள் மில்லியன் கணக்கான வாக்குகளிலிருந்து பெறப்படுகின்றன. இந்த முறையின் நன்மை என்னவென்றால், “முழுமையான தரநிலைகளை” வரையறுக்க வேண்டிய அவசியமில்லை; “A அல்லது B, எது சிறந்தது?” என்பதில் மனித தீர்ப்பு மட்டுமே தேவை. இருப்பினும், இதற்கு வரம்புகளும் உள்ளன: தரவரிசை முடிவுகள் பயனர்கள் கேட்கும் கேள்விகளைப் பொறுத்தது—அதிக எண்ணிக்கையிலான பயனர்கள் தற்செயலாக நிரலாக்க கேள்விகளைக் கேட்டால், நிரலாக்கத்தில் சிறந்த மாதிரிகள் உயர்ந்த தரவரிசையில் இடம்பெறும், இது மற்ற பணிகளில் அவற்றின் உண்மையான நிலையை பிரதிபலிக்காது.
ஜோடிவரிசை தீர்ப்பு மனித வாக்களிப்புக்குப் பதிலாக ஒரு LLM ஆல் செய்யப்படும்போது, நிலை சார்பு (Position Bias) க்கு எதிராகவும் கவனமாக இருக்க வேண்டும்—தீர்ப்பு மாதிரி ஒரு குறிப்பிட்ட நிலையில் (பொதுவாக முதலில்) தோன்றும் வேட்பாளரை முறையாக ஆதரிக்கிறது, மேலும் இரண்டு வேட்பாளர்களின் உள்ளடக்கம் முற்றிலும் மாற்றப்பட்டாலும் தீர்ப்பு மாறாமல் இருக்கலாம். நிலையான தணிப்பு முறை, ஒவ்வொரு ஜோடியையும் மாற்றப்பட்ட வரிசையில் இருமுறை மதிப்பீடு செய்வதாகும்: ஒருமுறை A முதலில், ஒருமுறை B முதலில், மற்றும் இரண்டு முடிவுகளையும் சராசரியாக எடுத்துக்கொள்வது; கடுமையான அணுகுமுறை, இரண்டு தீர்ப்புகளும் ஒத்துப்போகும் நிகழ்வுகளை மட்டுமே எண்ணுவது, மற்றும் முரண்பாடுகளை சமநிலையாகக் கருதுவது அல்லது மனித மறுஆய்வுக்கு அனுப்புவது. Chatbot Arena இன் அணுகுமுறை அடிப்படையில் ஒன்றே—இரண்டு பதில்களின் காட்சி நிலைகளை சீரமைப்பதன் மூலம், பெரிய மாதிரியில் நிலை சார்பு ரத்து செய்யப்படுகிறது.
சோதனை 7-8 ★★: ஜோடிவரிசை ஒப்பீட்டுத் தரவிலிருந்து மாதிரி தரவரிசைப் பட்டியலை உருவாக்குதல்
இந்த சோதனையானது, பிராட்லி-டெர்ரி மாதிரி எவ்வாறு அதிக எண்ணிக்கையிலான ஜோடிவரிசை ஒப்பீடுகளிலிருந்து ஒப்பீட்டுத் திறன் மதிப்பெண்களைப் பிரித்தெடுக்கிறது என்பதை ஆழமாகப் புரிந்துகொள்வதை நோக்கமாகக் கொண்டுள்ளது. Chatbot Arena-வின் உண்மையான திறந்த மூல வாக்களிப்புத் தரவுத்தொகுப்பைப் (லட்சக்கணக்கான அநாமதேய பயனர் குருட்டு வாக்குகளைக் கொண்டது) பயன்படுத்தவும்.
எலோ மதிப்பீட்டு மறுசெயல் புதுப்பிப்பு அல்காரிதத்தை செயல்படுத்தவும்: அனைத்து மாதிரிகளையும் 1000 மதிப்பீட்டில் தொடங்கவும். காலவரிசைப்படி வாக்களிப்புப் பதிவுகளைச் செயலாக்கவும். ஒவ்வொரு போட்டிக்கும், இரண்டு மாதிரிகளுக்கிடையேயான தற்போதைய மதிப்பீட்டு வேறுபாட்டின் அடிப்படையில் எதிர்பார்க்கப்படும் வெற்றி விகிதத்தைக் கணக்கிடவும், உண்மையான முடிவை எதிர்பார்ப்புடன் ஒப்பிடவும், மேலும் ஒரு நிலையான கற்றல் விகிதத்தால் மதிப்பீடுகளைச் சரிசெய்யவும்—வெற்றியாளர் புள்ளிகளைப் பெறுகிறார், தோல்வியாளர் புள்ளிகளை இழக்கிறார், சரிசெய்தலின் அளவு எதிர்பார்ப்பிலிருந்தான விலகலுக்கு விகிதாசாரமாக இருக்கும் (எதிர்பாராத தோல்வி பெரிய மதிப்பீட்டு மாற்றத்தை ஏற்படுத்தும்). மாதிரிகளை இறுதி மதிப்பீட்டின் இறங்கு வரிசையில் வரிசைப்படுத்தி, ஜோடிவரிசை வெற்றி விகித அணியைக் கணக்கிடவும். அதிகாரப்பூர்வ தரவரிசைப் பட்டியலுடன் ஒப்பிட்டு, தரவரிசைகள் பொதுவாக ஒத்துப்போகின்றனவா என்பதைச் சரிபார்க்கவும். புள்ளி-க்கு-புள்ளி சரியான பொருத்தம் தேவையில்லை: அதிகாரப்பூர்வ Chatbot Arena பிராட்லி-டெர்ரி அதிகபட்ச சாத்தியக்கூறு மதிப்பீட்டைப் பயன்படுத்துகிறது (அனைத்து போட்டிகளையும் ஒரே நேரத்தில் தீர்க்கிறது, வாக்களிப்பு வரிசையைச் சார்ந்திருக்காது), அதேசமயம் இந்த செயலாக்கம் ஆன்லைன் அதிகரிக்கும் Elo புதுப்பிப்புகளைப் பயன்படுத்துகிறது (முடிவுகள் கற்றல் விகிதம் K-காரணி மற்றும் செயலாக்க வரிசையால் பாதிக்கப்படும்). இரண்டு அல்காரிதங்களும் ஒத்திசைவான ஒட்டுமொத்த தரவரிசைகளை வழங்க வேண்டும், ஆனால் குறிப்பிட்ட மதிப்பெண்கள் துல்லியமாக ஒரே மாதிரியாக இருக்காது.
சோதனையின் இரண்டாம் பகுதி, வரலாற்றுத் தரவரிசை மாற்றத்தின் அசைவூட்டத்தை உருவாக்குகிறது: வாக்களிப்புத் தரவை காலத்தால் (வாரந்தோறும் அல்லது மாதந்தோறும்) பிரித்து, ஒவ்வொரு காலகட்டத்திற்கும் எலோ மதிப்பீட்டு நிலைப் படங்களைக் கணக்கிடவும். D3.js ஐப் பயன்படுத்தி, பார் சார்ட் ரேஸ் அசைவூட்டத்தை (கிடைமட்டப் பட்டையின் நீளம் = மதிப்பீடு, செங்குத்து நிலை = தரவரிசை, காலப்போக்கில் மென்மையாக மாறும்) செயல்படுத்தவும். அசைவூட்டத்தைக் கவனிப்பதன் மூலம், தொழில்நுட்ப முன்னேற்றத் தருணங்களை (ஒரு மாதிரியின் மதிப்பீடு திடீரென உயர்வது), போட்டிச் சூழலின் பரிணாம வளர்ச்சி மற்றும் மாதிரி வாழ்க்கைச் சுழற்சிகளை அடையாளம் காணவும்.
மதிப்பீடு சார்ந்த மாதிரித் தேர்வு
மாதிரித் தேர்வு என்பது “வலிமையான மாதிரியைத் தேர்ந்தெடுப்பது” மட்டுமல்ல; பயன்பாட்டுக் காட்சியின் அடிப்படையில் பல பரிமாணங்களில் மதிப்பீடு சார்ந்த பரிமாற்றங்களைச் செய்வதை உள்ளடக்கியது.
தேர்வுக்கான முக்கிய பரிமாணங்கள்
செயல்திறன் (Throughput) மற்றும் தாமதம் (Latency) ஆகியவை எளிதில் குழப்பமடையக்கூடிய இரண்டு தொகுப்பு அளவீடுகள் ஆகும். அவற்றைத் தெளிவுபடுத்த, LLM அனுமானம் இரண்டு நிலைகளில் நிகழ்கிறது என்பதைப் புரிந்துகொள்ள வேண்டும். Prefill முழு சூழலையும் ஒரே முறையில் படித்து, முதல் டோக்கனுக்கான நேரத்தை (TTFT) தீர்மானிக்கிறது—பயனர் Enter ஐ அழுத்தியதிலிருந்து முதல் எழுத்து தோன்றும் வரையிலான தாமதம். நீண்ட சூழல்கள் மெதுவான prefill மற்றும் அதிக TTFT ஐக் குறிக்கும். பின்னர் Decode பதிலை டோக்கனாக டோக்கனாக உருவாக்கி, அடுத்தடுத்த உருவாக்க வேகத்தை (டோக்கன்கள்/வினாடி) தீர்மானிக்கிறது, இது நேரடியாக சிந்தனை நேரத்தையும் கட்டளையிடுகிறது: 50 டோக்கன்கள்/வினாடி வேகத்தில், 2000 சிந்தனை டோக்கன்களை உருவாக்கும் மாதிரி சிந்திப்பதற்கே 40 வினாடிகள் செலவழிக்கும்.
இந்த இரண்டு நிலைகளைச் சுற்றி, முக்கிய செயல்திறன் மற்றும் தாமத அளவீடுகள் பின்வருமாறு:
உள்ளீட்டு செயல்திறன் / வெளியீட்டு செயல்திறன்: முறையே Prefill மற்றும் Decode இன் வேகத்துடன் ஒத்துள்ளது.
TTFT: வரிசை நேரம் மற்றும் Prefill நேரத்தின் கூட்டுத்தொகைக்கு சமம்; இது பயனர் உணரும் “பதிலளிக்கும் தன்மை” ஆகும்.
சிந்தனை தாமதம்: வெவ்வேறு மாதிரிகள் உருவாக்கும் சிந்தனை டோக்கன்களின் எண்ணிக்கை பல மடங்கு வேறுபடலாம், மேலும் சிந்தனை நீளம் பணி செயல்திறனுடன் நேர்மறையாக தொடர்புடையதாக இருக்க வேண்டிய அவசியமில்லை—ஒவ்வொரு மாதிரியின் சிந்தனை டோக்கன் பயன்பாடு மற்றும் அதற்கான பலன்களை உங்கள் சொந்த பணிச்சுமையில் அளவிட வேண்டும், பொது லீடர்போர்டுகளில் இருந்து மட்டுமே ஊகிக்கக்கூடாது.
p95 வால் தாமதம்: 95% கோரிக்கைகள் மீறாத தாமதம். இது சராசரியை விட உண்மையான பயனர் அனுபவத்தின் சிறந்த குறிகாட்டியாகும், ஏனெனில் சராசரியானது அதிக எண்ணிக்கையிலான வேகமான கோரிக்கைகளால் குறைக்கப்பட்டு, சிறுபான்மை பயனர்கள் அனுபவிக்கும் கடுமையான மந்தநிலைகளை மறைக்கக்கூடும்.
செலவு: உள்ளீடு/வெளியீடு/கேச் டோக்கன்களுக்கான விலை நிர்ணயம். செலவை தனிமையில் மதிப்பிடக்கூடாது—குறைந்த வெற்றி விகிதம் கொண்ட மலிவான மாதிரி, அடிக்கடி மீண்டும் முயற்சிப்பதால் உண்மையில் அதிக செலவை ஏற்படுத்தலாம். ஒரு பணிக்கான சராசரி செலவு மற்றும் செலவு-செயல்திறன் விகிதத்தை கணக்கிட வேண்டும்.
செயல்திறன் (Performance): Pass@1, Pass^k, Pass@k மற்றும் Best@k ஆகியவற்றின் துல்லியமான வரையறைகள் முன்னதாக “மதிப்பீட்டு அளவீட்டு முறைமை” பிரிவில் கொடுக்கப்பட்டுள்ளன. இங்கு, மாதிரி தேர்வின் சூழலில் எவ்வாறு தேர்வு செய்வது என்பதை மட்டுமே நாம் விவாதிக்கிறோம்—தினசரி காட்சிகளுக்கு, Pass@1 (ஒற்றை முயற்சியின் சராசரி வெற்றி விகிதம்) மீது கவனம் செலுத்துங்கள்; முக்கியமான செயல்பாடுகளுக்கு, Pass^k க்கு முன்னுரிமை அளித்து, “ஒருபோதும் தவறு செய்யாமல் இருப்பதன்” நிலைத்தன்மையில் கவனம் செலுத்துங்கள்; ஆய்வு பணிகளுக்கு, Pass@k அல்லது Best@k க்கு முன்னுரிமை அளித்து, போதுமான வாய்ப்புகள் வழங்கப்பட்டால் திறனின் மேல் வரம்பைப் பாருங்கள்; திறந்த முடிவு பணிகளுக்கு, பல பரிமாண Rubric மதிப்பெண்ணைப் பயன்படுத்தவும்.
விகித வரம்புகள் மற்றும் நம்பகத்தன்மை: RPM (நிமிடத்திற்கான கோரிக்கைகள்) / TPM (நிமிடத்திற்கான டோக்கன்கள்) வரம்புகள் ஒரே நேரத்தில் செயல்படும் திறனைப் பாதிக்கின்றன, மேலும் சில APIக்கள் உச்ச நேரங்களில் மாறும் வகையில் ஒதுக்கீடுகளை சரிசெய்கின்றன. உறுதித்தன்மையின் அடிப்படையில், விநியோகத்திற்கு வெளியே உள்ள தரவு, எதிர்மறை உள்ளீடுகள் மற்றும் நீண்ட கால நிலைத்தன்மை (மோட் சரிவு அல்லது கவனம் சறுக்கல் போன்ற சிக்கல்கள் ஏற்படுகிறதா) ஆகியவற்றில் கவனம் செலுத்துங்கள்.
பட்ஜெட்–திறன் வளைவுகள்: ஒரே நிலையான பட்ஜெட்டில் கிடைக்கும் ஒரு மதிப்பெண் மட்டும், Agent நீண்டகாலப் பணிகளைக் கையாளுமா என்பதைத் தீர்மானிக்கப் போதாது. வெற்றி விகிதத்துடன் சேர்த்து, wall-clock நேரம், Token, tool-call எண்ணிக்கை அல்லது compute budget மாறும்போது செயல்திறன் எவ்வாறு மாறுகிறது என்பதையும் தெரிவிக்க வேண்டும். RE-Bench இதைத் தெளிவாகக் காட்டுகிறது: ஒவ்வொரு environment-க்கும் மொத்தம் இரண்டு மணி நேரப் பட்ஜெட்டில் சிறந்த Agent மனித நிபுணர்களைவிட சுமார் நான்கு மடங்கு மதிப்பெண் பெற்றது; ஆனால் கூடுதல் நேரத்தால் மனிதர்கள் அதிகம் பயனடைந்து, எட்டு மணி நேரத்தில் சிறந்த Agent-ஐச் சிறிதளவு முந்தினர்; பல முயற்சிகளுக்கு மொத்தம் 32 மணி நேரம் வழங்கப்பட்டபோது மனிதர்களின் மதிப்பெண் Agent-ஐவிட சுமார் இருமடங்காக இருந்தது1. எனவே குறுகிய பட்ஜெட்டில் கிடைக்கும் முன்னிலையை நீண்டகாலத் திறனாக நேரடியாக extrapolate செய்யக்கூடாது. நிஜ workload-இன் கால அளவுக்கு அருகிலுள்ள பல budget point-களில் model-களை ஒப்பிட வேண்டும்.
நடைமுறையில், பல மாதிரி கூட்டு உத்தியை பின்பற்றலாம்: எளிய கோரிக்கைகளுக்கு இலகுரக மாதிரிகளைப் பயன்படுத்தி செலவுகளைக் குறைக்கவும், சிக்கலான பணிகளுக்கு சக்திவாய்ந்த மாதிரிகளைப் பயன்படுத்தி தரத்தை உறுதிப்படுத்தவும்; அல்லது குறிப்பிட்ட துணைப் பணிகளுக்கு (எ.கா., பட புரிதல், குறியீடு உருவாக்கம்) சிறப்பு மாதிரிகளைப் பயன்படுத்தவும், துணை ஏஜெண்ட் வழிமுறைகள் மூலம் ஒத்துழைக்கவும். இந்த பன்முக கலவையானது, ஒட்டுமொத்த நன்மைகள் அதிகரித்த அமைப்பு சிக்கலை விட அதிகமாக இருப்பதை உறுதிப்படுத்த மதிப்பீட்டின் மூலம் சரிபார்க்கப்பட வேண்டும் (எடுத்துக்காட்டாக, “9.9-ம் 9.11-ம் இதில் எது பெரியது?”, “கார் கழுவ வேண்டும்; வீட்டிலிருந்து கழுவும் இடம் 50 மீட்டர் தொலைவு — நடந்து போவதா, ஓட்டிப் போவதா?” போன்ற வினாக்களை எளிய வினாக்களெனக் கருதி லேசான மாதிரியிடம் ஒப்படைத்து, தவறான முடிவுக்கு வழிவகுப்பது).
Model நடத்தை: எப்போது வாசிப்பை நிறுத்தி edit செய்யத் தொடங்குவது?
Model தேர்வு என்பது ஒரு model task-ஐ முடிக்குமா என்பதை மட்டும் ஒப்பிடுவது அல்ல; அது இயல்பாக எவ்வாறு நடக்கிறது என்பதையும் ஒப்பிட வேண்டும். Coding Agents-இல் எளிதாகக் காணக்கூடிய ஒரு வேறுபாடு action threshold. அதே coding task கொடுக்கப்பட்டால், சில models repository-ஐ விரிவாக ஆராய்ந்து architecture, callers, tests ஆகியவற்றை உறுதிப்படுத்திய பின்னரே edit செய்கின்றன. மற்றவை குறைந்த evidence-இலேயே மாற்ற வேண்டிய இடத்தைக் கண்டறிந்து, விரைவாக edit செய்து, test feedback மூலம் தங்கள் புரிதலை நிறைவு செய்கின்றன. முதல் வகை முன்கூட்டிய edit-இன் செலவை அதிகமாக மதிப்பிடுகிறது; இரண்டாவது வகை இன்னொரு file-ஐப் படிப்பதன் opportunity cost-ஐ அதிகமாக மதிப்பிடுகிறது.
Agent-இன் இந்தச் சாய்வுக்கு இரு மூலங்கள் உண்டு: ஒன்று Harness-இல் உள்ள கணினி வழிமுறை, மற்றொன்று மாதிரியின் நடத்தைக் கொள்கை. மாதிரியின் நடத்தைக் கொள்கைக்கு முக்கிய மூலம் பின்-பயிற்சியே: SFT பாதைகள் “எவ்வளவு படித்த பிறகு கை வைப்பது” என்பதை நிரூபிக்கின்றன; செயல்முறை வெகுமதி ஒரு குறிப்பிட்ட கருவிப் பாதைக்கு வெகுமதி அளிக்கிறது அல்லது தண்டிக்கிறது; முடிவு வெகுமதி இறுதியில் வெற்றி பெற்ற முழுக் கொள்கையையும் வலுப்படுத்துகிறது. நாளடைவில், மாதிரி கற்பது நிரல் எழுதுவது மட்டுமல்ல; பொறியியல் பழக்கங்களையும்தான்.
சோதனை 7-9 ★★: நிலையான Coding Harness-இல் Model Action Threshold-ஐ அளவிடுதல்
நோக்கம்: model காரணியைத் தனிமைப்படுத்தி, தொடர்ந்து தகவல் சேகரிப்பதற்கும் edit தொடங்குவதற்கும் இடையில் Coding models இயல்பாக எவ்வாறு சமநிலை செய்கின்றன என்பதை அளவிடுதல்; path efficiency மற்றும் இறுதி தரத்தை ஒன்றாக மதிப்பிடுதல்.
முறை: chapter6/model-action-threshold/experiment.py-ஐ இயக்கவும். இயல்பாக GPT-5.6-sol மற்றும் Claude Sonnet 5 ஆகியவை ஒரே OpenRouter OpenAI-compatible endpoint வழியாக அழைக்கப்படுகின்றன; system prompt, tool Schemas, task repositories, test commands, turn limit அனைத்தும் நிலையாக வைக்கப்படுகின்றன. நடுநிலை prompt குறைந்தபட்ச file வாசிப்பு எண்ணையோ விரைவாக edit செய்ய வேண்டும் என்பதையோ குறிப்பிடாது. மூன்று task வகைகளையும் குறைந்தது மூன்று முறை இயக்கி, model வரிசையை மாற்றி மாற்றி அமைக்கவும். முதல் edit-க்கு முன் tool calls, படித்த files, searches, wall-clock time ஆகியவற்றுடன், முதலில் test செய்யப்பட்ட patch-இன் acceptance, test-க்குப் பிந்தைய rework, final success, changed files, Token usage ஆகியவற்றைப் பதிவு செய்யவும்.
காரண விளக்கம்: ஒரே Harness-இல் model மாறும்போது நடத்தை மாறுகிறதா என்பதை neutral campaign சோதிக்கிறது. Harness-இன் மாற்றியமைக்கும் தாக்கத்தை அளவிட --policy explore-first கொண்டு தனி campaign இயக்கவும்; இரண்டு policy-களையும் ஒரே model comparison-இல் கலக்க வேண்டாம். Model swap-இல் மாறி, அதே model பல Harnesses-இல் பயன்படுத்தப்படும்போதும் நீடிக்கும் நடத்தை model effect-க்கு வலுவான evidence; இதன் எதிர்மாறான நிலை Harness effect-ஐ அதிகமாக ஆதரிக்கும்.
ஏற்றுக்கொள்ளும் அளவுகோல்கள்: எல்லா offline unit tests-உம் pass ஆக வேண்டும்; ஒவ்வொரு task fixture-உம் ஆரம்ப நிலையில் tests-இல் fail ஆகிறது என்பதை முதலில் உறுதிப்படுத்த வேண்டும்; formal result-இல் அனைத்து model × task × repetition cells, zero API errors, independent final test, audit செய்யக்கூடிய trajectories ஆகியவை இருக்க வேண்டும்; configuration, observations, summary files-இன் hashes-ஐ manifest.json சரிபார்க்க வேண்டும். Project directory-இல் 18/18 cells கொண்ட ஒரு முழுமையான உண்மை run சேமிக்கப்பட்டுள்ளது. இந்தச் சிறிய repositories-இன் எண்ணிக்கைகளை நிரந்தர leaderboard ஆகக் கருதாமல், வாசகர்கள் தங்களுக்கு முக்கியமான model versions மற்றும் உண்மையான workloads-இல் மீண்டும் இயக்க வேண்டும்.
ஏஜெண்ட் அமைப்புகளின் செலவு பகுப்பாய்வு
முந்தைய பகுதி மாதிரி தேர்வுக்கான முக்கிய பரிமாணங்களில் ஒன்றாக செலவை பட்டியலிட்டது, ஆனால் ஏஜெண்ட் காட்சிகளில் செலவு என்பது எளிய டோக்கன் விலையை விட மிகவும் சிக்கலானது—பல சுற்று பகுத்தறிதல், கருவி அழைப்புகள் மற்றும் சூழல் குவிப்பு ஆகியவை நேரியல் அல்லாத செலவு வளர்ச்சிக்கு வழிவகுக்கும். முறையான செலவு பகுப்பாய்வு என்பது மதிப்பீட்டு முறைமையின் தவிர்க்க முடியாத பகுதியாகும் மற்றும் உற்பத்தி வரிசைப்படுத்தலுக்கான தேவையான முன்நிபந்தனையாகும்.
செலவின் கூறுகள்.
ஒரு ஏஜெண்ட் அமைப்பின் செலவை மூன்று நிலைகளாகப் பிரிக்கலாம்:
மாதிரி அனுமானச் செலவு என்பது மிகவும் நேரடியான கூறு ஆகும், இது உள்ளீட்டு டோக்கன்கள் மற்றும் வெளியீட்டு டோக்கன்களின் நுகர்வால் தீர்மானிக்கப்படுகிறது. இருப்பினும், ஏஜெண்ட் காட்சிகளில், பெரும்பாலும் கவனிக்கப்படாத இரண்டு பெருக்கும் காரணிகள் உள்ளன. முதலாவது சூழல் குவிப்பு விளைவு: ஒவ்வொரு முறையும் ஒரு ஏஜெண்ட் LLM ஐ அழைக்கும்போது, அது முந்தைய அனைத்து உரையாடல் வரலாறு மற்றும் கருவி திரும்பும் முடிவுகளை ஒன்றாக அனுப்புகிறது (இதனால் மாதிரியால் சூழலைப் புரிந்து கொள்ள முடியும்). KV Cache ஐ திறம்பட பயன்படுத்தாமல் (அதாவது, ஏற்கனவே செயலாக்கப்பட்ட சூழலை தேக்ககத்தில் வைத்து தேவையற்ற கணக்கீட்டைத் தவிர்ப்பது), செலவு மிக விரைவாக அதிகரிக்கிறது—சுற்று 1 1000 டோக்கன்களை அனுப்புகிறது, சுற்று 2 2000 டோக்கன்களை அனுப்புகிறது, சுற்று 3 3000 டோக்கன்களை அனுப்புகிறது, மொத்தம் 1000+2000+3000=6000, 3×1000=3000 க்கு பதிலாக. அதிக சுற்றுகள், இடைவெளி அதிகமாகும். இரண்டாவது சிந்தனை டோக்கன் செலவு: சிந்தனையை ஆதரிக்கும் மாதிரிகள் அதிக எண்ணிக்கையிலான சிந்தனை டோக்கன்களை உருவாக்குகின்றன. இந்த டோக்கன்கள் பயனருக்குக் காட்டப்படாவிட்டாலும், அவை இன்னும் கட்டணம் விதிக்கப்படுகின்றன.
கருவி அழைப்புச் செலவு என்பது வெளிப்புற API கட்டணங்கள் (தேடுபொறிகள் ஒவ்வொரு வினவலுக்கும் கட்டணம் வசூலிக்கின்றன, தரவுத்தள வினவல்கள் கணினி வளங்களைப் பயன்படுத்துகின்றன), குறியீடு செயல்பாட்டிற்கான சாண்ட்பாக்ஸ் வளங்கள் மற்றும் எளிதில் கவனிக்கப்படாத ஒரு மறைமுக செலவு ஆகியவற்றை உள்ளடக்கியது: கருவி திரும்பும் முடிவுகள் சூழலில் செலுத்தப்படும்போது ஏற்படும் டோக்கன் செலவு. ஒரு ஒற்றை வலைத் தேடலில் இருந்து திரும்பும் உள்ளடக்கம் 2000-5000 டோக்கன்களை ஆக்கிரமிக்கலாம், மேலும் அது ஒவ்வொரு அடுத்தடுத்த சுற்று அனுமானத்திலும் உள்ளீடாக மீண்டும் மீண்டும் கட்டணம் விதிக்கப்படும்.
உள்கட்டமைப்புச் செலவு என்பது திசையன் தரவுத்தளங்கள் (RAG மீட்டெடுப்பிற்குப் பயன்படுத்தப்படுபவை), செய்தி வரிசைகள், உறவுசார் தரவுத்தளங்கள் மற்றும் பதிவு மற்றும் கண்காணிப்பு சேமிப்பு (கவனிக்கத்தக்க தன்மைக்காக) ஆகியவற்றிற்கான செயல்பாட்டு மேல்நிலைச் செலவுகளை உள்ளடக்கியது.
செலவு எங்கு உருவாகிறது என்பதைப் பார்க்க, துணைச் சோதனை எட்டு சுற்றுகளைக் கொண்ட நிலையான பணத்தைத் திருப்பித் தரும் workflow-ஐப் பயன்படுத்தியது: ஆர்டர், அனுப்பல், refund policy, knowledge base ஆகியவற்றைத் தேடி, பின்னர் risk check, refund, அறிவிப்பு, வழக்கு முடித்தல் ஆகியவை செய்யப்பட்டன. உண்மையான gpt-4o-mini அழைப்புகள் இரண்டு switch-களின் நான்கு சேர்க்கைகளிலும் இயக்கப்பட்டன: நிலையான/நிலையற்ற prefix மற்றும் முழு/சுருக்கப்பட்ட history. எல்லா கிளைகளிலும் வணிகப் பணி ஒன்றே; அட்டவணை 7-4 அந்த இயக்கத்தில் சேமித்த token எண்ணிக்கைகளையும் விலைகளையும் பயன்படுத்துகிறது.
அட்டவணை 7-4 எட்டு-சுற்று ஏஜெண்ட் workflow-இன் அளவிடப்பட்ட செலவு
உள்ளமைவு
உள்ளீட்டு token
cache token
மொத்த செலவு
அடிப்படையுடன் ஒப்பிட்ட சேமிப்பு
cache இல்லை, சுருக்கம் இல்லை
20,700
0
$0.003776
—
நிலையான prefix மட்டும்
20,386
13,568
$0.002707
28.3%
history சுருக்கம் மட்டும்
16,177
0
$0.003115
17.5%
நிலையான prefix + சுருக்கம்
16,035
6,144
$0.002643
30.0%
அடிப்படைக் கிளையில், உள்ளீடு முதல் சுற்றின் 1,113 token-இலிருந்து கடைசி சுற்றின் 3,668 ஆக வளர்ந்தது. கருவி முடிவுகள் பின்னர் வந்த கோரிக்கைகளில் மீண்டும் சேர்க்கப்பட்டதால் மொத்தம் 9,544 உள்ளீட்டு token ஆனது. இரு மேம்பாடுகளையும் இயக்கியபோது அது 5,248 ஆகவும், மொத்த செலவு 30% ஆகவும் குறைந்தது.
சேமிப்புகள் நேரடியாகக் கூட்டப்படவில்லை. நிலையான prefix மட்டும் 28.3%, history சுருக்கம் மட்டும் 17.5% சேமித்தன; இரண்டும் சேர்ந்து 45.8% அல்ல, 30% மட்டுமே சேமித்தன. history-ஐச் சுருக்குவது cache-இல் மீண்டும் பயன்படுத்தக்கூடிய prefix-ஐயும் குறைக்கிறது. பல context optimization-களை இணைக்கும்போது முழு workflow-ஐ அளவிட வேண்டும்; தனித்தனி சேமிப்பு விகிதங்களைச் சேர்க்கக்கூடாது. மாதிரி, விலை அல்லது பணி நீளம் மாறினால் 30% மாறும்; மீண்டும் பயன்படுத்தக்கூடிய கண்டுபிடிப்பு நான்கு கிளை சோதனை முறைதான்.
செலவு உகப்பாக்க உத்திகள்.
உள்ளீட்டுப் பக்கத்தில் முதலில் சோதிக்க வேண்டியவை: prefix-ஐ நிலையாக வைத்துப் KV Cache reuse, பழைய trajectory மற்றும் நீண்ட கருவி முடிவுகளைச் சுருக்கும் context compression, எளிய/சிக்கலான பணிகளைப் பொருத்தமான மாதிரிகளுக்கு அனுப்பும் model routing. செயலாக்கம் அத்தியாயம் 2 இல் உள்ளது. இங்கு முக்கியமானது, ஒவ்வொரு முறைக்கும் தனி switch இருப்பது; அப்போதுதான் தனிப்பட்ட விளைவையும் சேர்க்கை விளைவையும் அளவிடலாம். மதிப்பீடு மற்றும் இயக்கத்துடன் நேரடியாக தொடர்புடைய மேலும் இரண்டு முறைகள் உள்ளன.
ஒத்திசைவற்ற தொகுதி செயலாக்கம் (Asynchronous Batch Processing) நிகழ்நேரமற்ற பணிகளைத் தொகுத்து தொகுதி செயலாக்கத்திற்காகச் சேமித்து, API வழங்குநர்களிடமிருந்து தொகுதி விலை தள்ளுபடிகளைப் பயன்படுத்துகிறது; சுய-வரிசைப்படுத்தல் சூழ்நிலைகளில், இது உச்ச நேரம் அல்லாத நேரங்களில் GPU பயன்பாட்டையும் மேம்படுத்துகிறது.
செலவு கண்காணிப்பு மற்றும் பட்ஜெட் கட்டுப்பாடு.
ஒரு உற்பத்தி சூழலில், நிகழ்நேர செலவு கண்காணிப்பு அமைப்பு நிறுவப்பட வேண்டும்: பணி வகை, மாதிரி, பயனர் போன்றவற்றின் அடிப்படையில் டோக்கன் நுகர்வு மற்றும் API செலவுகளைக் கண்காணிக்கவும். மேலும், ஒவ்வொரு பணிக்கும் ஒரு செலவு வரம்பு (cost cap) நிர்ணயிக்கப்பட வேண்டும்—ஏஜெண்ட் ஒரு சுழற்சியில் சிக்கும்போது அல்லது மிகவும் ஆழமாக ஆராயும்போது தானாகவே அதை முடித்து, ஒரு பணி அசாதாரணமாக அதிக செலவை ஏற்படுத்துவதைத் தடுக்கவும்.
சோதனை 7-10 ★: ஏஜெண்ட் பணிகளின் இறுதி முதல் இறுதி வரையிலான செலவு பகுப்பாய்வு
சோதனை நோக்கம்: மேலுள்ள எட்டு-சுற்று செலவுப் பகுப்பாய்வை மீண்டும் உருவாக்கி, அதே optimization-களை உங்கள் சொந்த workload-இல் சோதிக்கவும்.
தொழில்நுட்ப அணுகுமுறை: முதலில் துணைக் களஞ்சியத்தின் நிலையான பணியை மீண்டும் இயக்கி, பின்னர் உங்கள் பிரதிநிதி பணிகளைத் தேர்ந்தெடுக்கவும். LangSmith அல்லது சொந்த tracing மூலம் உள்ளீடு/வெளியீடு மற்றும் thinking token-கள், கருவி அழைப்புகள், முடிவு அளவுகள், end-to-end தாமதம் ஆகியவற்றைப் பதிவு செய்யவும். சராசரி, p50/p95/p99, செலவுக் கூறுகளை கணக்கிடவும்.
ஏற்றுக்கொள்ளும் அளவுகோல்கள்: செலவு அறிக்கையை உருவாக்கி முக்கிய காரணிகளை அடையாளம் காணவும். நான்கு switch சேர்க்கைகளையும் இயக்கி, ஒவ்வொரு optimization-ஐ தனியாகவும் ஒன்றாகவும் அளவிடவும். மாதிரியை மாற்றினால் சோதனையை மீண்டும் இயக்கவும்; சேமித்த trajectory-இன் சதவீதத்தை எடுத்துச் செல்ல வேண்டாம்.
மதிப்பீடு-உந்துதல் தொடர்ச்சியான மறுசெயல்
மாதிரி தேர்வு என்பது ஒரு முறை முடிவு அல்ல, மாறாக மாதிரிகள் உருவாகும்போது மாறும் முறையில் சரிசெய்யப்பட வேண்டிய ஒரு தொடர்ச்சியான செயல்முறையாகும். இந்த அத்தியாயத்தின் ஆரம்பம் “மதிப்பீட்டு அமைப்பு இருந்தால், மாதிரி பரிணாமத்தை விரைவாகப் பின்தொடர முடியும்” என்ற முக்கிய கருத்தை அறிமுகப்படுத்தியது. கீழே, ஒரு குறிப்பிட்ட மாதிரி மாற்ற வழக்கு, இந்த அமைப்பு உண்மையான உலக முடிவெடுப்பில் எவ்வாறு செயல்படுகிறது என்பதை விளக்குகிறது.
உங்கள் ஏஜெண்ட் அமைப்பு தற்போது Claude இல் கட்டமைக்கப்பட்டுள்ளது என்று வைத்துக்கொள்வோம், இது கருவி அழைப்பு மற்றும் சிக்கலான ஒருங்கிணைப்பில் சிறந்து விளங்குகிறது. ஒரு நாள், Gemini ஒரு புதிய மாதிரியை வெளியிடுகிறது, மேலும் பொது அளவுகோல்கள் அது குறைந்த விலையில் பல அளவீடுகளில் Claude ஐ விஞ்சியிருப்பதைக் காட்டுகின்றன. இந்த கட்டத்தில், உங்கள் கேள்வி “Gemini Claude ஐ விட சிறந்ததா?” அல்ல, மாறாக “எனது குறிப்பிட்ட பணிகளில், Gemini Claude ஐ விட சிறந்ததா? எவ்வளவு சிறந்தது? மாற்றத்தின் செலவு என்ன?”
நன்கு நிறுவப்பட்ட மதிப்பீட்டு அமைப்பைக் கொண்ட ஒரு குழு இதற்கு மணிநேரங்களில் பதிலளிக்க முடியும்: தங்கள் சொந்த மதிப்பீட்டு தரவுத்தொகுப்பில் புதிய மாதிரியை இயக்கி, பணி வெற்றி விகிதம், கருவி அழைப்பு துல்லியம், தாமதம் மற்றும் செலவு ஆகியவற்றை ஒப்பிடலாம். புதிய மாதிரி எளிய பணிகளில் சிறந்ததாகவும் மலிவாகவும் இருக்கலாம், ஆனால் சிக்கலான பல-சுற்று கருவி ஒருங்கிணைப்பை உள்ளடக்கிய முக்கிய காட்சிகளில், அதன் வெற்றி விகிதம் 5% குறையக்கூடும். இந்த வேறுபாடு சத்த அலைவரிசையை மீறுகிறதா என்பதை உறுதிசெய்த பிறகு (கீழே உள்ள “மதிப்பீட்டு முடிவுகளின் புள்ளியியல் முக்கியத்துவம்” பார்க்கவும்), உங்கள் முடிவு ஒரு வேறுபட்ட உத்தியாக மாறும்: “செலவைக் குறைக்க எளிய பணிகளை புதிய மாதிரிக்கு மாற்றவும், தரத்தை உறுதிப்படுத்த சிக்கலான பணிகளுக்கு அசல் மாதிரியை வைத்திருக்கவும்,” மாறாக கண்மூடித்தனமான முழு அளவிலான மாற்றம் அல்ல. இந்த வகையான நுண்ணிய, தரவு-உந்துதல் முடிவு முன்கூட்டியே கட்டமைக்கப்பட்ட மதிப்பீட்டு அமைப்புடன் மட்டுமே சாத்தியமாகும்.
சோதனை 7-11 ★★: பல பரிமாண மாதிரி செயல்திறன் அளவீடு
முக்கிய LLM கள் மற்றும் வெவ்வேறு API வழங்குநர்களின் விரிவான அளவீட்டை நடத்தி, பல பரிமாண மாதிரி தேர்வு முடிவு தரவுத்தளத்தை உருவாக்கவும்.
சோதனை நோக்கத்தைத் தேர்ந்தெடுக்கவும்: GPT தொடர், Claude தொடர், Gemini தொடர், Doubao தொடர் போன்ற மூடிய-மூல SOTA மாதிரிகள் மற்றும் Qwen, Kimi, DeepSeek போன்ற திறந்த-மூல மாதிரிகள். மூன்றாம் தரப்பு செயல்திறன் கண்காணிப்பு தளங்களின் (எ.கா., Artificial Analysis) முடிவுகளை சரிபார்க்க, ஒரே மாதிரியை வெவ்வேறு API வழங்குநர்களுடன் (எ.கா., DeepSeek அதிகாரப்பூர்வ vs. Siliconflow) சோதிக்கவும்.
தரப்படுத்தப்பட்ட சோதனைப் பணிச்சுமைகளை வடிவமைக்கவும்: உள்ளீட்டு செயல்திறன் சோதனைகள் நிலையான நீள சூழல்களைப் (8K/32K/128K டோக்கன்கள்) பயன்படுத்துகின்றன, வெளியீட்டு செயல்திறன் சோதனைகள் நிலையான நீள பதில்களைக் (512/2048 டோக்கன்கள்) கோருகின்றன. தாமதச் சோதனைகளில் TTFT (முதல் டோக்கனுக்கான நேரம்) மற்றும் இறுதி முதல் இறுதி வரையிலான தாமதம் ஆகியவை அடங்கும். சிந்தனையை ஆதரிக்கும் மாதிரிகளுக்கு, சிந்தனை நீளம் மற்றும் சிந்தனை தாமதத்தை தனித்தனியாக அளவிடவும். ஒவ்வொரு உள்ளமைவுக்கும் குறைந்தது 100 கோரிக்கைகள் இருக்க வேண்டும், நிலையான விலகல்/p50/p95/p99 கணக்கிடப்பட வேண்டும்—அதிக தாமத மாறுபாடு நிலையற்ற பயனர் அனுபவத்தைக் குறிக்கிறது.
API கிடைக்கும் தன்மை மற்றும் நிலைத்தன்மையை மதிப்பிடவும்: ஒரு வாரத்திற்கு ஒரு மணி நேரத்திற்கு ஒருமுறை சோதனை செய்து, வெற்றி விகிதம், பிழை வகைகள் மற்றும் தோல்வி கால அளவைப் பதிவு செய்யவும். தோல்வி விகிதம், MTTR (சராசரி மீட்பு நேரம்) மற்றும் மிக நீண்ட தொடர்ச்சியான இயக்க நேரத்தைக் கணக்கிடவும். விகித வரம்புகளின் உண்மையான வரம்புகளைச் சோதிக்கவும்—த்ரோட்டிலிங் புள்ளியைக் கண்டறிய ஒரே நேரத்தில் இயங்கும் திறனை படிப்படியாக அதிகரித்து, RPM/TPM வரம்புகளைப் பதிவு செய்யவும். விரிவான செலவைக் கணக்கிடவும்: விலை நிர்ணயத் தகவலைச் (உள்ளீடு/வெளியீடு/கேச் டோக்கன்களுக்கான அலகு விலைகள்) சேகரித்து, KV கேச்சின் தாக்கத்தைக் கருத்தில் கொண்டு, வழக்கமான பல-சுற்று ஏஜெண்ட் பணிகளுக்கான சராசரி செலவைக் கணக்கிடவும்.
சோதனை 7-12 ★★: பயனர் நினைவக அமைப்புகளின் இறுதி முதல் இறுதி வரையிலான தேர்வு மதிப்பீடு
முன்நிபந்தனைகள்: அத்தியாயம் 3 இலிருந்து சூழல் சார்ந்த மீட்டெடுப்பு அல்லது ஏஜெண்டிக் RAG சோதனையை முடித்திருக்க வேண்டும்.
இலக்கு: பயனர் நினைவக மீட்டெடுப்பு ஏஜெண்டுக்கான முழு சங்கிலித் தேர்வு மதிப்பீட்டைச் செய்து, மூன்று தேர்வுப் புள்ளிகள்—எம்பெடிங் மாதிரி, மறுதரவரிசைப்படுத்தி மற்றும் ஏஜெண்ட் முதன்மை மாதிரி—மீட்டெடுப்பு தரம், தாமதம் மற்றும் செலவை எவ்வாறு கூட்டாகப் பாதிக்கின்றன என்பதை ஆராயவும். chapter3/contextual-retrieval-for-user-memory அல்லது chapter3/agentic-rag-for-user-memory ஐ மீண்டும் பயன்படுத்தி, 60 சோதனை வழக்குகளில் ஒப்பிடவும்.
ஏற்றுக்கொள்ளும் அளவுகோல்: மூன்று தேர்வுப் புள்ளிகளையும் தனித்தனியாக ஆராயவும்—எம்பெடிங் மாதிரி (BGE-M3 / OpenAI / Doubao போன்றவை, முதல்-5 மீட்டெடுப்பு துல்லியம், தாமதம், செலவு ஆகியவற்றைப் பதிவு செய்யவும்), மறுதரவரிசைப்படுத்தி (“மறுதரவரிசைப்படுத்தி இல்லை” என்ற அடிப்படை நிலையைச் சேர்த்து, அதன் விளிம்பு மதிப்பை அளவிடவும்), முதன்மை மாதிரி (அதே மீட்டெடுப்பு உள்ளமைவின் கீழ் வெற்றி விகிதம் மற்றும் கருவி பயன்பாட்டுத் திறனை ஒப்பிடவும்). முக்கியமானது கூறுகளுக்கு இடையேயான ஒருங்கிணைப்பைப் புரிந்துகொள்வதாகும்: வலுவான எம்பெடிங் மறுதரவரிசைப்படுத்தியைத் தேவையற்றதாக்கலாம், வலுவான முதன்மை மாதிரி மீட்டெடுப்பு குறைபாடுகளை ஈடுசெய்யலாம்—தேர்வு என்பது ஒரு முறைமை சார்ந்த பரிமாற்றம், தனித்தனியாக வலுவான ஒன்றைத் தேர்ந்தெடுப்பது அல்ல. உள்ளமைவு விவரங்கள் துணைக் களஞ்சியத்தில் உள்ளன.
மதிப்பீட்டு முடிவுகளின் புள்ளியியல் முக்கியத்துவம்
மதிப்பீட்டுத் தொகுப்பு வரம்புக்குட்பட்டது; மாதிரியின் வெளியீட்டிலும் சீரற்ற தன்மை உண்டு. எனவே மதிப்பெண் வேறுபாடு வெறும் மாதிரி எடுப்பு இரைச்சலாகவே இருக்கக்கூடும். n வழக்குகளில் வெற்றி விகிதம் p அளக்கப்பட்டால், தர பிழையை (standard error) தோராயமாக இப்படி மதிப்பிடலாம்:
SE(p)≈np(1−p)
எடுத்துக்காட்டாக, 100 வழக்குகளில் 70% வெற்றி விகிதம் என்றால், 95% நம்பிக்கை இடைவெளி ஏறத்தாழ 70%±9 சதவீதப் புள்ளிகள்; “புதிய மாதிரி 73%, பழைய மாதிரி 70%” என்பது மாற்றத்தை நியாயப்படுத்தப் போதாது.
ஒரே தொகுதிப் பணிகளில் இரு அமைவுகளை ஒப்பிடும்போது ஜோடி பகுப்பாய்வுக்கு முன்னுரிமை தர வேண்டும்: ஒவ்வொரு வினாவிலும் யார் வென்றார் என்று பதிவு செய்து, McNemar சோதனையாலோ ஜோடி bootstrap-ஆலோ வேறுபாட்டைத் தீர்மானிக்க வேண்டும்; தனித்தனி இரு வெற்றி விகிதங்களை நேரடியாகக் கழிப்பதல்ல. Agent-இன் ஒவ்வொரு ஓட்டமும் வேறுபடக்கூடும் என்பதால், ஒவ்வொரு அமைவையும் பல சீரற்ற விதைகளுடன் (எ.கா. 3–5 முறை) ஓட்டி, சராசரியையும் ஏற்ற இறக்க வரம்பையும் அறிக்கையிடுவதே சிறந்தது; ஒரே ஓட்டம் திசையை வடிகட்டவே பயன்படும். எதிர்பார்க்கும் ஆதாயம் 2–3 சதவீதப் புள்ளிகள் மட்டுமே என்றும், மதிப்பீட்டுத் தொகுப்பில் சில பத்து வினாக்களே உள்ளன என்றும் இருந்தால், முதலில் மாதிரி அளவை விரிவாக்குங்கள்; தர பிழை 1/n விகிதத்தில் சுருங்கும்.
for task in paired_tasks: for seed in fixed_seeds: a = run(config_a, task, seed) b = run(config_b, task, seed) record_paired_delta(verifier(a), verifier(b))return paired_bootstrap_or_mcnemar(all_deltas)
ஜோடியாக்குவதன் பொருள், இரு குழுக்களும் ஒரே பணிகளையும் ஒரே சீரற்ற நிலைமைகளையும் பகிர்ந்து கொள்வதே; தனித்தனியாக இரு மாதிரிகளை எடுத்துப் பின் சராசரிகளை ஒப்பிடுவதல்ல.
பல கருதுகோள்களை இணையாகச் சரிபார்க்கும்போது பல்மடங்கு ஒப்பீட்டையும் கருத்தில் கொள்ள வேண்டும்: முக்கியத்துவ வாயிலை இறுக்குங்கள், அல்லது நேர்மறை முடிவுகளைத் தனித்து மீண்டும் ஓட்டுங்கள். நடைமுறை அளவுகோல் எளிது: மதிப்பெண் வேறுபாடு இரைச்சலைத் தாண்ட வேண்டும், ஜோடி பகுப்பாய்விலும் நிலைக்க வேண்டும், மீண்டும் உருவாக்கவும் முடிய வேண்டும் — அப்போதுதான் அதன் அடிப்படையில் மாதிரியை மாற்றுவதோ மாற்றத்தை வெளியிடுவதோ மதிப்புடையது.
ஏஜெண்ட் கவனிக்கத்தன்மை (ஏஜெண்ட் Observability)
மதிப்பீடு சார்ந்த முடிவுகள் (மாதிரி தேர்வுக்காகவோ அல்லது தொடர்ச்சியான மறுசெயலாக்கத்திற்காகவோ) உயர்தர செயல்பாட்டுத் தரவை நம்பியுள்ளன. கீழே, முதலில் இந்தத் தரவை முறையாகச் சேகரிப்பது எப்படி (கவனிக்கத்தன்மை) என்பதை அறிமுகப்படுத்துகிறோம், பின்னர் மதிப்பீட்டு முடிவுகளை அமைப்பு மேம்பாடுகளாக மொழிபெயர்ப்பது எப்படி என்பதை விவாதிக்கிறோம்.
படம் 7-7: கவனிக்கத்தன்மை தொழில்நுட்ப அடுக்கு · மூலப் படம்
கவனிக்கத்தன்மை என்பது விநியோகிக்கப்பட்ட அமைப்புகள் களத்திலிருந்து கடன் வாங்கப்பட்ட ஒரு கருத்தாக்கமாகும்: அமைப்பு என்ன செய்கிறது என்பதை நேரடியாகத் திறந்து பார்க்க முடியாது; அது வெளியிடும் பதிவுகள், அளவீடுகள் மற்றும் தடங்கள் மூலம் மட்டுமே என்ன நடக்கிறது என்பதை ஊகிக்க முடியும், ஒரு மருத்துவர் நோயாளியின் உடலுக்குள் நேரடியாகப் பார்க்க முடியாமல், வெப்பநிலை, இரத்த அழுத்தம் மற்றும் இமேஜிங் போன்ற வெளிப்புற சமிக்ஞைகள் மூலம் பிரச்சினைகளைக் கண்டறிவதைப் போல. ஏஜெண்ட் அமைப்புகள் இதை இன்னும் கடினமாக்குகின்றன: ஒரே உள்ளீடு வெவ்வேறு வெளியீடுகளை உருவாக்கலாம், பல-சுற்று பகுத்தறிவு மற்றும் கருவி அழைப்புகள் செயலாக்கப் பாதைகளை மிகவும் சிக்கலாக்குகின்றன, மேலும் மாதிரியின் “சிந்தனை” செயல்முறை வெளியில் இருந்து முற்றிலும் ஒளிபுகாதாக உள்ளது.
கவனிக்கத்தன்மையின் மதிப்பு முதலில் பிரச்சினை கண்டறிதலில் உள்ளது: முழுமையான தடங்கள் டெவலப்பர்களை யூகிப்பதற்குப் பதிலாக முழு செயல்முறையையும் மீண்டும் இயக்க அனுமதிக்கின்றன. இரண்டாவதாக, இது தொடர்ச்சியான மேம்படுத்தலுக்கான அடித்தளமாகும்—எந்தப் பணிகளுக்கு பல சுற்று மறுசெயலாக்கம் தேவைப்படுகிறது, எந்த கருவிகள் மிகக் குறைந்த வெற்றி விகிதத்தைக் கொண்டுள்ளன, எந்த மீட்டெடுப்பு வினவல்கள் எப்போதும் காலி முடிவுகளைத் தருகின்றன என்பதை நீங்கள் பார்க்கலாம். செலவு மேலாண்மையில், ஏஜெண்ட் செயல்பாட்டுச் செலவுகள் வெவ்வேறு பணிகளில் ஒன்று அல்லது இரண்டு அளவு வரிசைகளால் மாறுபடலாம், மேலும் தடமறிதல் அசாதாரணமாக அதிக செலவுகள் உள்ள நிகழ்வுகளை அடையாளம் காண முடியும். இறுதியாக, திரட்டப்பட்ட தடத் தரவு அடுத்தடுத்த அமைப்பு மேம்படுத்தல் மற்றும் மாதிரி மேம்பாட்டிற்கான அடித்தளத்தையும் வழங்குகிறது.
ஏஜெண்ட் கவனிக்கத்தன்மை தடங்கள் அடித்தளத்தில் கட்டமைக்கப்பட்டுள்ளது, இதன் தரவு அமைப்பு விநியோகிக்கப்பட்ட அமைப்புகளில் இருந்து span மர மாதிரியை நேரடியாகப் பெறுகிறது: ஒரு பணி செயலாக்கம் ஒரு தடத்திற்கு ஒத்திருக்கிறது, இதில் ஒவ்வொரு LLM அழைப்பு, ஒவ்வொரு கருவி அழைப்பு மற்றும் ஒவ்வொரு மீட்டெடுப்பும் ஒரு span (உள்ளீடு/வெளியீடு, தொடக்கம்/முடிவு நேரங்கள், டோக்கன் நுகர்வு மற்றும் பிழை தகவலைப் பதிவு செய்யும் ஒரு செயலாக்க அலகு) ஆகும். span களுக்கு இடையேயான பெற்றோர்-குழந்தை உறவுகள் ஒரு செயலாக்க மரத்தை உருவாக்குகின்றன—எடுத்துக்காட்டாக, ஒரு “ஏஜெண்ட் முதன்மை வளையம்” span, அதன் கீழ் பல “LLM அழைப்பு” மற்றும் “கருவி அழைப்பு” குழந்தை span களைக் கொண்டிருக்கலாம். இந்த அடுக்கிற்கு தரப்படுத்தப்பட்ட நெறிமுறைகள் ஏற்கனவே உள்ளன: OpenTelemetry என்பது பொது-நோக்க விநியோகிக்கப்பட்ட தடமறிதல் தரநிலையாகும், அதே நேரத்தில் OpenInference போன்ற விவரக்குறிப்புகள் அதன் மேல் LLM-குறிப்பிட்ட சொற்பொருள் மரபுகளை வரையறுக்கின்றன (prompt கள், மாதிரி அளவுருக்கள், டோக்கன் பயன்பாடு போன்றவற்றை எவ்வாறு பதிவு செய்வது). தரப்படுத்தப்பட்ட நெறிமுறைகளை ஏற்றுக்கொள்வதன் நன்மை சேகரிப்பு மற்றும் பகுப்பாய்வைப் பிரிப்பதாகும்—அதே தடத் தரவை வெவ்வேறு பகுப்பாய்வு பின்தளங்களுடன் இணைக்க முடியும், விற்பனையாளர் பூட்டுதலைத் தவிர்க்கலாம்.
LangSmith இந்தத் துறையில் முக்கியமான தளங்களில் ஒன்றாகும் (இதேபோன்ற தளங்களில் Langfuse, Arize Phoenix போன்றவை அடங்கும்), இது கவனிக்கும் திறன் (observability), மதிப்பீடு (evaluation), மற்றும் உகப்பாக்கம் (optimization) ஆகியவற்றை ஒரு மூடிய வளையமாக (closed loop) ஒருங்கிணைக்கிறது. ஒவ்வொரு செயலாக்கமும் ஒரு ட்ரேஸ் அமர்வை (trace session) உருவாக்குகிறது, அதில் மாதிரி அழைப்புகள் (model calls), கருவி பயன்பாடு (tool usage), மற்றும் அறிவு மீட்டெடுப்பு (knowledge retrieval) ஆகியவை சுயாதீனமான செயலாக்க அலகுகளாக (execution units) பதிவு செய்யப்பட்டு, காரண உறவுகளால் (causal relationships) இணைக்கப்பட்டு ஒரு செயலாக்க மரத்தை (execution tree) உருவாக்குகின்றன. ஒவ்வொரு அலகும் முழுமையான உள்ளீடு/வெளியீடு (input/output), நேரத் தகவல் (timing information), செலவுத் தரவு (cost data), மற்றும் பிழைத் தகவல் (error information) ஆகியவற்றைப் பதிவு செய்கிறது. இந்த தளம், ட்ரேசிங் (tracing) செயல்முறையானது ஏஜெண்டின் (Agent) பதில் தாமதத்தை (response latency) பாதிக்காமல் இருப்பதை உறுதி செய்ய, ஒத்திசைவற்ற (asynchronous) தொகுதி தரவு சேகரிப்பை (batch data collection) பயன்படுத்துகிறது.
இந்த தளம் A/B சோதனை (A/B testing) (பயனர் போக்குவரத்தின் ஒரு பகுதியை புதிய பதிப்பிற்கு திருப்பி விடுதல், தானாகவே அளவீடுகளை ஒப்பிடுதல், மற்றும் விரைவான மீளமைப்பு அல்லது படிப்படியான அளவிடுதலை ஆதரித்தல்), ப்ராம்ப்ட் பதிப்பு மேலாண்மை (prompt version management) (ஒவ்வொரு பதிப்பும் இயக்க நேர செயல்திறன் தரவுகளுடன் இணைக்கப்பட்டுள்ளது), மற்றும் கூட்டு மேம்பாடு (collaborative development) (குழு உறுப்பினர்கள் ட்ரேஸ் தரவு மற்றும் சிக்கல் நிகழ்வுகளைப் பகிர்ந்து கொள்ளலாம்) ஆகியவற்றையும் ஆதரிக்கிறது. உற்பத்தி சூழல்களில் (production environments) இருந்து கிடைக்கும் பாரிய அளவிலான நிஜ-உலக தரவு, தொடர்ச்சியான முன்னேற்றத்திற்கான ஒரு பொக்கிஷமாகும்—இது எதிர்பாராத சூழ்நிலைகளை வெளிப்படுத்தி, மிகவும் உகப்பாக்கம் தேவைப்படும் அம்சங்களை அடையாளம் காண உதவுகிறது.
கண்காணிப்புத் தரவின் மிக மதிப்புமிக்க செல்லிடம், அது திரும்பப் பாய்ந்து மதிப்பீட்டுச் சொத்தாக மாறுவதே. நடைமுறைக்கு உகந்த ஒரு மூடிய சுழற்சி இதுவே: உற்பத்திப் பாதைகளிலிருந்து தோல்வி மற்றும் ஐயத்திற்குரிய வழக்குகளைத் தேர்ந்தெடு → தனியுரிமை நீக்கம் செய் (பயனர் தனியுரிமை, திறவுகோல் போன்ற உணர்திறன் புலங்களை நீக்கு) → மதிப்பீட்டுத் தொகுப்பின் புதிய வழக்குகளாகவும் பின்னடைவுச் சோதனைகளாகவும் படியவிடு. இப்படிச் செய்யும்போது மதிப்பீட்டுத் தொகுப்பு ஒரே முறை கட்டப்பட்ட நிலையான தொகுப்பாக இல்லாமல், தயாரிப்புடன் சேர்ந்து பரிணமித்து, நிஜப் பயனர் பரவலுக்கு எப்போதும் நெருக்கமாக இருக்கும் உயிருள்ள சொத்தாகிறது. இன்று களத்தில் வெளிப்பட்ட தோல்வி முறை, நாளை இந்த எல்லையைக் காக்கும் பின்னடைவு வழக்காகிறது.
விரிவான மதிப்பீட்டு அமைப்பு மற்றும் தரவுத்தொகுப்பு இருந்தால், மதிப்பீட்டு முடிவுகளை உறுதியான அமைப்பு மேம்பாடுகளாக மொழிபெயர்ப்பதே முக்கியமாகும்.
அளவுகோல் அறிக்கைகளிலிருந்து அமைப்பு மேம்பாடுகளுக்கு
பின்வரும் எடுத்துக்காட்டு, இந்தப் புத்தகத்துடன் உள்ள களஞ்சியத்தில் மேற்கொள்ளப்பட்ட உண்மையான, திட்டமிட்டுச் சிறியதாக வைக்கப்பட்ட AndroidWorld சோதனையிலிருந்து எடுக்கப்பட்டது. API 35 emulator-இல் நான்கு Wi-Fi settings பணிகள் சோதிக்கப்பட்டன; ஒவ்வொரு பணிக்கும் இரு அமைப்புகளிலும் தலா ஒரு பொருத்தப்பட்ட இயக்கம் மட்டுமே நடத்தப்பட்டது. இது 116 பணிகள் கொண்ட முழு benchmark அல்ல; API 33 reference சூழலில் நடத்த வேண்டிய மறுசோதனைக்கும் மாற்றாகாது. ஆகவே இதன் பயன் ஒரு மொத்த மதிப்பெண்ணில் இல்லை; ஒவ்வொரு முடிவிலிருந்தும் அடுத்த பொறியியல் முடிவு எவ்வாறு எடுக்கப்பட்டது என்பதில்தான் உள்ளது.
படம் 7-8: அளவுகோலிலிருந்து மேம்பாட்டு சுழற்சி · மூலப் படம்
Harness பொறியியலின் கண்ணோட்டத்தில், இந்தப் பகுதி அடிப்படையில் மீண்டும் மீண்டும் செய்யும் Harness உகப்பாக்கத்திற்கான முறையைப் பற்றியது—Harness-இல் உள்ள பலவீனமான புள்ளிகளை (போதுமான சூழல் இல்லையா? விடுபட்ட கட்டுப்பாடுகள்? போதுமான சரிபார்ப்பு இல்லையா? சரியான நேரத்தில் கருத்து இல்லையா?) அடையாளம் காண மதிப்பீட்டுத் தரவைப் பயன்படுத்துதல், இலக்கு மேம்பாடுகளைச் செய்தல், பின்னர் மீண்டும் மதிப்பீடு செய்தல், Harness-இன் தொடர்ச்சியான பரிணாம வளர்ச்சிக்கான ஒரு மூடிய சுழற்சியை உருவாக்குதல்.
ஒரு அளவுகோல் அறிக்கையை பகுப்பாய்வு செய்யத் தொடங்குவதற்கு முன், எளிதில் கவனிக்கப்படாத ஒரு கொள்கை உள்ளது: ஏஜெண்ட் செயல்திறனில் வீழ்ச்சியைக் காணும்போது, முதலில் மதிப்பீட்டு அமைப்பையே சரிபார்க்கவும், பின்னர் ஏஜெண்டை சரிபார்க்கவும். ஒரு பொதுவான தவறு, மதிப்பெண் வீழ்ச்சியைக் கண்டவுடன் உடனடியாக ஏஜெண்ட் குறியீட்டை மாற்றியமைப்பதாகும், மதிப்பீட்டு அமைப்பே முதலில் செயலிழந்திருக்கலாம் என்ற சாத்தியத்தை புறக்கணித்து—சிதைந்த சமிக்ஞைகளின் அடிப்படையில் திசையை சரிசெய்வது என்பது திருத்தம் ஆரம்பத்திலிருந்தே தவறாக இருக்கலாம். மதிப்பீட்டு அமைப்புகளில் உள்ள பொதுவான பிழை ஆதாரங்கள் பின்வருமாறு: இயக்க நேர சூழலில் போதுமான வளங்கள் இல்லாததால் செயல்முறை முடித்தல் (சீரற்ற தோல்விகளாக வெளிப்படும்), ஸ்கோரரிலேயே உள்ள பிழைகள் சரியான பதில்களை தோல்விகளாகக் குறிப்பது, மற்றும் சோதனை வழக்குகளுக்கும் உற்பத்தி காட்சிகளுக்கும் இடையிலான தொடர்பின்மை. இந்த சிக்கல்கள் அனைத்தும் இறுதி எண்களில் மாதிரி சிதைவு போலவே தோற்றமளிக்கும், மேலும் முழுமையான தடங்களை மதிப்பாய்வு செய்வதன் மூலம் மட்டுமே அவற்றை வேறுபடுத்த முடியும்.
ஒரு அளவுகோல் அறிக்கையைப் படித்தல்: சிக்கல் கண்டுபிடிப்பின் கலை
தொடக்க அறிக்கையில் 116 பணிகளில் ஒவ்வொன்றும் ஒருமுறை இயக்கப்பட்டு, மொத்த வெற்றி விகிதம் சுமார் 88% எனப் பதிவாகியிருந்தது. தோல்விகள் சிதறிக் கிடக்கவில்லை: நான்கு SystemWifiTurn* பணிகளில் மூன்று தோல்வியடைந்தன. அவற்றின் trace-களில், இறுதி நிலையை உறுதிப்படுத்தாமல் ஏஜெண்ட் மீண்டும் மீண்டும் பக்கங்களுக்கு இடையே அலைந்தது. இதற்கு இரண்டு சாத்தியமான காரணங்கள் இருந்தன: எங்கு செல்ல வேண்டும் என்பது ஏஜெண்டுக்குத் தெரியாமல் இருந்திருக்கலாம்; அல்லது அதற்குக் கிடைத்த UI விளக்கத்தில் தேவையான கட்டுப்பாடு இடம்பெறாமல் இருந்திருக்கலாம்.
88% என்ற மொத்த எண் இந்தச் சிறிய, ஆனால் ஒரே தன்மை கொண்ட தோல்விக் குழுவை மறைக்கிறது. Step limit-ஐ உயர்த்துவதும் தவறான முடிவுக்கே இட்டுச் செல்லும்: “கட்டுப்பாடு ஏஜெண்டுக்குத் தெரியவில்லை” என்ற பிரச்சினையை “இன்னும் விடாமுயற்சி தேவை” என்று தவறாகப் புரிந்துகொள்ளலாம். எனவே அறிக்கையை எதிர்திசையில் வாசிக்க வேண்டும்: முதலில் பணி மற்றும் திறன் குறிச்சொல் அடிப்படையில் தோல்விக் குழுக்களை கண்டறியவும்; trace-களை மீண்டும் இயக்கவும்; பிழை observation, reasoning, action, verification ஆகியவற்றில் எங்கு ஏற்பட்டது என்பதைத் தீர்மானிக்கவும்; அதன்பிறகே மாற்ற வேண்டிய ஒரே மாறியைத் தேர்ந்தெடுக்கவும். Wi-Fi துணைத்தொகுப்பு மொத்த செயல்திறனை மதிப்பிடுவதற்கல்ல; குறைந்த செலவில் காரணத்தைத் தனிமைப்படுத்துவதற்கே பயன்படுத்தப்பட்டது.
தரவுகளிலிருந்து கருதுகோள்களுக்கு: மேம்பாட்டு வரைபடத்தை உருவாக்குதல்
முதல் சுற்று, மிகக் குறைந்த செலவில் சோதிக்கக்கூடிய விளக்கத்தை எடுத்துக்கொண்டது. H1-இல் வழிசெலுத்தல் அறிவு போதவில்லை என்று கருதி, treatment குழுவுக்கு மட்டும் Wi-Fi settings-ஐ அடையும் வழிமுறையும் இறுதி நிலையைச் சரிபார்க்கும் அறிவுறுத்தலும் சேர்க்கப்பட்டன. வெற்றி விகிதம் உயரவில்லை; bottleneck prompt அல்ல என்பது தெளிவானது.
இரண்டாம் சுற்று, ஏஜெண்டால் உண்மையில் எதைப் பார்க்க முடிகிறது என்று கேட்டது. H5-இல் API 35-க்கு பொருந்தாத accessibility feed-ஐ நீக்கி, AndroidWorld ஆதரிக்கும் UIAutomator tree வழங்கப்பட்டது. வெற்றி உயர்ந்தது; அதே நேரத்தில் முழு tree காரணமாக token பயன்பாடு கடுமையாக அதிகரித்தது. அதனால் H5C புதிய தகவல் எதையும் சேர்க்கவில்லை. கண்ணுக்குத் தெரியாத, உரையற்ற, செயல்பட முடியாத container node-களை மட்டும் நீக்கி, குறைந்த இரைச்சலுடன் அதே வெற்றியைத் தக்கவைக்க முடியுமா என்று சோதித்தது.
மூன்று சுற்றுகளிலும் model, task parameters, seed, step limit, emulator ஆகியவை மாறாமல் வைக்கப்பட்டன; control மற்றும் treatment இயக்கங்களின் வரிசை மாற்றி மாற்றி அமைக்கப்பட்டது. இவ்வாறு ஒவ்வொரு சுற்றிலும் ஒரு மாறி மட்டுமே மாற்றப்பட்டதால் காரணத்தைத் தெளிவாக ஒதுக்க முடிந்தது: ஒரு சுற்றில் மீதமிருந்த பிரச்சினையோ புதிய பக்கவிளைவோ அடுத்த சுற்றின் ஒரே மாற்றமாக மாறியது.
அட்டவணை 7-5 அளவிடப்பட்ட முடிவுகளைச் சுருக்குகிறது. ஒவ்வொரு குழுவிலும் நான்கு பணிகள் மட்டுமே இருப்பதால், பெரிய மறுசோதனைக்கு நகர வேண்டுமா என்பதைத் தீர்மானிக்க இவை உதவும்; AndroidWorld முழுவதற்குமான வெற்றி விகிதத்தை இவற்றிலிருந்து கணிக்க முடியாது.
அட்டவணை 7-5 AndroidWorld Wi-Fi துணைத்தொகுப்பில் மூன்று சுற்றுகள்
சோதனை
மாற்றப்பட்ட ஒரே அம்சம்
Control → Treatment வெற்றி
Treatment / Control tokens
அடுத்த முடிவு
H1
வழிசெலுத்தல் அறிவுறுத்தல் சேர்த்தல்
25% → 25%
0.47×
வெற்றி உயரவில்லை; பழைய prompt-ஐத் தக்கவைத்தல்
H5
Accessibility feed → UIAutomator
25% → 100%
2.498×
பலன் பெரியது, செலவும் அதிகம்; மேலும் சுருக்குதல்
H5C
UIAutomator tree-ஐச் சுருக்குதல்
100% → 100%
0.506×
வெற்றியைத் தக்கவைத்து tokens பாதியாகின; முழு மறுசோதனைக்கு நகர்த்தல்
தனி சதவீதங்களை விட இந்த வரிசை முக்கியமானது. ஏஜெண்டுக்குக் கிடைக்காத தகவலை விரிவான prompt கொடுத்து மீட்டெடுக்க முடியாது; எனவே prompt-ஐ நீட்டிப்பதற்கு முன் observation பிழையைச் சோதிக்க வேண்டும். அதே நேரத்தில், அதிக input எப்போதும் நல்லதல்ல. முழு element tree, தேவையான கட்டுப்பாட்டைக் காட்டியதோடு context-ஐ இரைச்சலாலும் நிரப்பியது. பொருள் இல்லாத node-களை நீக்கிய பிறகும் நான்கு வெற்றிகளும் நீடித்தன; token பயன்பாடு சுமார் பாதியாகக் குறைந்தது. Model மாறவில்லை. பணி முடிகிறதா என்பதையும், அதைச் சிக்கனமாக முடிக்கிறதா என்பதையும் Harness வழங்கிய UI representation தீர்மானித்தது.
தொடர்ச்சியான மறு செய்கை: முதல் மேம்பாட்டிலிருந்து அமைப்பின் பரிணாம வளர்ச்சி வரை
நான்கு பணிகளில் H5C வென்றது, அதற்கு ஒரு பெரிய சோதனைக்கான தகுதியை மட்டுமே அளிக்கிறது; deployment அனுமதியை அல்ல. அடுத்த gate, முழு third-party app தொகுப்புடன் Pixel 6 / API 33 reference சூழலில் 116 பணிகள் × 5 seed-கள் கொண்ட இயக்கமாகும். வெற்றி விகிதம் குறையக்கூடாது; token விகிதம் பழைய அமைப்பின் 75%-ஐத் தாண்டக்கூடாது; latency விகிதம் 1.5×-க்குள் இருக்க வேண்டும். அந்தச் சோதனை முடியும் வரை, துணைத்தொகுப்பில் கிடைத்த 4/4 வெற்றியை அமைப்பு முழுவதற்குமான 100% வெற்றியாகச் சொல்லக்கூடாது.
தொடர்ச்சியான மேம்பாட்டின் நடைமுறை இதுதான்: ஒவ்வொரு சுற்றின் ஆதாரமும் அதன் எல்லைக்குள் உள்ள அடுத்த நடவடிக்கையை மட்டுமே அனுமதிக்க வேண்டும். H1 மேலும் prompt சேர்ப்பதை நிறுத்தியது; H5 சரியான காரணத்தைக் கண்டுபிடித்ததுடன் செலவுப் பிரச்சினையையும் வெளிப்படுத்தியது; H5C அந்தச் செலவைக் குறைத்து, விரிவான சோதனைக்கு தகுதி பெற்றது. நல்ல benchmark அறிக்கையில் ஒரு மதிப்பெண் மட்டும் இருக்காது. முடிவு எங்கு பொருந்தும், எந்த guardrail தோல்வியடைந்தது, அடுத்து எதைச் சோதிக்க வேண்டும் என்பதையும் அது கூறும்.
சோதனை 7-13 ★★★: AndroidWorld இல் மதிப்பீடு மற்றும் மேம்பாடு
மதிப்பீட்டு அறிக்கையிலிருந்து அமைப்பு மேம்பாடு வரை செல்லும் முழுப் பாதையையும் இந்தப் பயிற்சி நடைமுறைப்படுத்துகிறது. chapter6/android-world-இல் உள்ள பழைய அறிக்கையையும் சேமிக்கப்பட்ட மூன்று paired run-களையும் முதலில் படிக்கவும்.
படி 1: கண்டறிதல். ஒவ்வொரு பணிக்குமான அட்டவணை மற்றும் திறன் குறிச்சொல் அணி ஆகியவற்றை குறுக்கு-பகுப்பாய்வு செய்து, மேலோட்டமான பணி தோல்விகளை ஆழமான திறன் குறைபாடுகளுடன் இணைக்கவும். எதிர்பார்க்கப்பட்ட வெற்றி விகிதத்தை விட குறைவான திறன் குறிச்சொற்கள் மற்றும் குவிந்த தோல்விகள் உள்ள பணி பகுதிகளை அடையாளம் காணவும்.
படி 2: கருதுகோள்களை உருவாக்கவும். மூன்று-அடுக்கு கட்டமைப்பைப் (மேலோட்டம் → நடுத்தரம் → ஆழம்) பின்பற்றி மேம்பாட்டு கருதுகோள்களை உருவாக்கவும். ஒவ்வொரு கருதுகோளும் எதிர்பார்க்கப்படும் வெற்றி விகித மேம்பாட்டு இலக்கு மற்றும் சரிபார்ப்பு முறையை தெளிவாகக் கூற வேண்டும்.
படி 3: கட்டச் சோதனை. ஒவ்வொரு சுற்றிலும் ஒரு மாறி மட்டும் மாறுமாறு H1, H5, H5C ஆகியவற்றை மீண்டும் இயக்கவும். வெற்றியுடன் tokens, latency, regression ஆகியவற்றையும் பதிவு செய்யவும்.
படி 4: தரவு சார்ந்த முடிவெடுத்தல். செலவு-பயன் பகுப்பாய்வின் அடிப்படையில் பயன்பாட்டு முடிவுகளை எடுக்கவும்—அனைத்து பயனுள்ள மேம்பாடுகளையும் வெறுமனே ஏற்றுக்கொள்வதற்குப் பதிலாக, ஒவ்வொரு மேம்பாட்டின் பயன்பாட்டு நோக்கம், தாமத தாக்கம் மற்றும் செலவு சுமை ஆகியவற்றை எடைபோடவும். குறைந்த செலவு, அதிக பலன் தரும் மேம்பாடுகளை பயன்பாட்டிற்கு முன்னுரிமைப்படுத்தவும்; அதிக செலவு மேம்பாடுகளை முக்கியமான சூழ்நிலைகளுக்கு மட்டுப்படுத்தவும்.
படி 5: மறுசோதனை. துணைத்தொகுப்பு சோதனை வென்றால், அடுத்ததாக முழு benchmark-ஐ மட்டுமே இயக்கவும். 116×5 reference-environment சோதனை முடிந்த பிறகே deployment பற்றி பேசவும்; environment வேறுபாடு, sample size, முழுமையற்ற scope ஆகியவற்றை அறிக்கையில் தெளிவாகப் பதிவு செய்யவும்.
வெளிப்புற மதிப்பீட்டிலிருந்து உள் மதிப்பீட்டிற்கு: உற்பத்தி-தர ஏஜெண்டுகளுக்கான மதிப்பீட்டு உள்கட்டமைப்பு
முந்தைய பிரிவுகள் ஒரு ஏஜெண்ட் அமைப்பை வெளிப்புறமாக எவ்வாறு மதிப்பிடுவது என்பதைப் பற்றி விவாதித்தன—மதிப்பீட்டு சூழலை உருவாக்குதல், தரவுத்தொகுப்புகளை வடிவமைத்தல் மற்றும் அளவுகோல் அறிக்கைகளை பகுப்பாய்வு செய்தல். இருப்பினும், சிறந்த ஏஜெண்ட் தயாரிப்புகள் வெளிப்புற மதிப்பீட்டிற்கு உட்படுத்தப்படுவது மட்டுமல்லாமல், தொடர்ச்சியான சுய மதிப்பீட்டிற்கான உள்கட்டமைப்பையும் உருவாக்குகின்றன. கீழே, அத்தியாயம் 5 இல் அறிமுகப்படுத்தப்பட்ட திறந்த மூல பொது-நோக்க ஏஜெண்ட் OpenClaw ஐ உதாரணமாகப் பயன்படுத்தி, முன்னணி குறியீட்டு ஏஜெண்ட் தயாரிப்புகளின் பொது தொழில்நுட்ப பகுப்பாய்வு மற்றும் பயிற்சியாளர்களின் நுண்ணறிவுகளை இணைத்து, பின்பற்றத் தகுந்த உள் மதிப்பீட்டு அமைப்புகளின் தொகுப்பை வழங்குகிறோம்—இது ML ஆராய்ச்சியின் பரிசோதனை முறையியலை தயாரிப்பு பொறியியலில் முறையாக உட்பொதிக்கிறது.
நீக்கம் உள்கட்டமைப்பு: ஒவ்வொரு அம்சத்தின் உண்மையான பங்களிப்பைப் புரிந்துகொள்ளுதல்
ML ஆராய்ச்சியாளர்கள் நீண்ட காலமாக ஒரு மாதிரியின் எந்த கூறுகள் உண்மையில் முக்கியமானவை என்பதைப் புரிந்துகொள்ள நீக்கம் ஆய்வுகளைப் பயன்படுத்துகின்றனர்—நீக்கம் என்பது ஒரு கூறுகளை முறையாக “அகற்றி” ஒட்டுமொத்த செயல்திறன் எவ்வளவு குறைகிறது என்பதைக் கவனிப்பதாகும். OpenClaw இந்த முறையியலை தயாரிப்பு பொறியியலில் அறிமுகப்படுத்துகிறது: அமைப்பில் ஒரு உள்ளமைக்கப்பட்ட முதன்மை சுவிட்ச் உள்ளது, இது பல முக்கிய அம்சங்களை ஒரே நேரத்தில் முடக்க முடியும் (சிந்தனை முறை, சூழல் சுருக்கம், தானியங்கி நினைவகம், பின்னணி பணிகள் போன்றவை), இது ஒரு “வெற்று மாதிரி” அடிப்படைக் கோட்டை உருவாக்குகிறது. இது குழுவிற்கு ஒரு முக்கியமான கேள்விக்கு பதிலளிக்க உதவுகிறது: ஒரு அம்சம் உண்மையில் பயனர் அனுபவத்தை மேம்படுத்துகிறதா, அல்லது அது பயனுள்ளதாக மட்டுமே தோன்றுகிறதா?
நீக்கத்தை ஒரு முறை மட்டும் செய்யும் ஆராய்ச்சி நடவடிக்கையாக அல்லாமல், வழக்கமான பொறியியல் நடைமுறையாக மாற்றுவது பல நடைமுறைத் தாக்கங்களைக் கொண்டுள்ளது. முதலாவதாக, நீக்க சுவிட்ச் மிக ஆரம்பத்திலேயே துவக்கப் பாதையில் செலுத்தப்பட வேண்டும்—எந்தவொரு தொகுதி-நிலை மாறிலியும் உள்ளமைவு மதிப்புகளைப் பிடிப்பதற்கு முன்பு—அதாவது, நீக்க உள்கட்டமைப்பு ஆரம்பத்திலிருந்தே கணினி கட்டமைப்பில் வடிவமைக்கப்பட வேண்டும், பின்னர் பொருத்தப்படக்கூடாது. இரண்டாவதாக, நீக்கப் பரிசோதனைகளைத் தொடர்ந்து நடத்துவது (எ.கா., ஒவ்வொரு முக்கிய வெளியீட்டிற்கும் முன்) “அம்சக் கடனை” வெளிப்படுத்தலாம்—மாதிரிகள் உருவாகும்போது ஒரு காலத்தில் பயனுள்ளதாக இருந்த ஆனால் இப்போது தேவையில்லாத அம்சங்கள். உற்பத்தி ஏஜெண்டை உருவாக்கும் எந்தக் குழுவிற்கும் பரிந்துரைக்கப்பட்ட நடைமுறை: ஒவ்வொரு முக்கிய அம்சமும் சுயாதீனமாக முடக்கக்கூடியதாக இருக்க வேண்டும், மேலும் குழு ஒவ்வொரு அம்சத்தின் உண்மையான பங்களிப்பையும் தொடர்ந்து சரிபார்க்க வேண்டும்.
A/B சோதனை முறை: வழிமுறையை இலக்கிலிருந்து வேறுபடுத்துதல்
முதிர்ந்த ஏஜெண்ட் தயாரிப்புகள் தங்கள் சொந்த நடத்தையில் கடுமையான A/B சோதனைகளை நடத்துகின்றன (அதாவது, பயனர்களை சீரற்ற முறையில் இரண்டு குழுக்களாகப் பிரித்தல், ஒரு குழு பழைய பதிப்பையும் மற்றொரு குழு புதிய பதிப்பையும் பயன்படுத்துதல், மற்றும் மாற்றம் பயனுள்ளதா என்பதைத் தீர்மானிக்க இரு குழுக்களின் உண்மையான தரவையும் ஒப்பிடுதல்). ஒரு நன்கு வடிவமைக்கப்பட்ட ஏஜெண்ட் A/B சோதனை வழக்கு பல முக்கிய முறைமைக் கொள்கைகளை விளக்குகிறது:
பல-கை, இருமை அல்ல. “உடன்” மற்றும் “இல்லாமல்” ஆகியவற்றை மட்டும் ஒப்பிடுவதற்குப் பதிலாக, பல முற்போக்கான மாறுபாடுகளை வடிவமைக்கவும் (எ.கா., வெவ்வேறு வலிமையான prompt கட்டுப்பாடுகளைச் சோதிக்கும்போது, ஒரு கட்டுப்பாட்டுக் குழு மற்றும் படிப்படியாக கடுமையான கட்டுப்பாடுகளைக் கொண்ட மூன்று சோதனைக் குழுக்களை அமைக்கவும்). இந்த வடிவமைப்பு அளவு-பதில் உறவுகளை வெளிப்படுத்தலாம் மற்றும் உகந்த புள்ளியைக் கண்டறிய உதவும்.
வழிமுறை அளவீடுகளை இலக்கு அளவீடுகளிலிருந்து வேறுபடுத்துதல். இது மிகவும் எளிதில் செய்யக்கூடிய தவறு—நீங்கள் மாற்றுவதை மேம்படுத்தல் இலக்காகக் கருதுவது. எடுத்துக்காட்டாக, நீங்கள் “ஏஜெண்டின் திட்டக் கோப்பு நீளத்தைக் குறைப்பதை” சோதிக்கிறீர்கள் என்றால், திட்டக் கோப்பு நீளம் ஒரு வழிமுறை அளவீடு (நீங்கள் நேரடியாக மாற்றும் ஒன்று), ஆனால் அது இலக்கு அல்ல. உண்மையான இலக்கு “அமர்வு-நிலை செலவைக் குறைப்பதாக” இருக்கலாம். திட்டக் கோப்பைச் சுருக்குவது செலவுகளைக் குறைக்கலாம், ஆனால் போதுமான விரிவான திட்டங்கள் இல்லாததால் அதிக திருத்த-சரிபார்ப்பு-திருத்த சுழல்களுக்கு வழிவகுக்கலாம், மொத்த வெளியீட்டை அதிகரிக்கலாம். எப்போதும் உங்களை நீங்களே கேட்டுக்கொள்ளுங்கள்: நான் மாற்றுவது (வழிமுறை) நான் உண்மையில் கவலைப்படுவதைப் போலவே (இலக்கு) உள்ளதா? இல்லையென்றால், இலக்குக்கு முன்னுரிமை கொடுங்கள்.
பாதுகாப்பு அளவீடுகளை அமைத்தல். இலக்கு அளவீடு மேம்பட்டாலும் கூட, பயனர் திருப்தி குறைந்தால், செயல்பாடுகளின் எண்ணிக்கை அதிகரித்தால், அல்லது பிழை விகிதம் உயர்ந்தால், பரிசோதனையை நிறுத்த வேண்டும். பாதுகாப்பு அளவீடுகள் “மோசமடையக் கூடாத கீழ்நிலை” ஆகும்.
அடிப்படை புள்ளிவிவரங்களைப் பதிவு செய்தல். மாதிரி அளவு, விநியோக சதவீதங்கள் மற்றும் தொடர்பு பகுப்பாய்வு (எ.கா., “நிராகரிப்பு விகிதம் திட்ட அளவுடன் ஒரே சீராக அதிகரிக்கிறது”) ஆகியவற்றைச் சேர்க்கவும், இது சோதனை முடிவுகளை விளக்குவதற்குத் தேவையான சூழலை வழங்கும். அடிப்படை இல்லாமல், சோதனை முடிவுகள் புள்ளிவிவர ரீதியாக முக்கியத்துவம் வாய்ந்தவையா என்பதை நீங்கள் தீர்மானிக்க முடியாது.
இரண்டு-அடுக்கு அம்சக் கொடி அமைப்பு
ஏஜெண்ட் தயாரிப்புகளுக்கு முதல் நாளிலிருந்தே வடிவமைக்கப்பட்ட ஒரு Feature Flag உள்கட்டமைப்பு தேவை—feature flag என்பது தொலைவிலிருந்து கட்டுப்படுத்தக்கூடிய ஒரு சுவிட்ச் ஆகும், இது குறியீட்டை மீண்டும் பயன்படுத்தாமல், ஒரு செயல்பாடு பயனர்களுக்கு இயக்கப்பட்டதா அல்லது முடக்கப்பட்டதா என்பதை தீர்மானிக்கிறது. இது ஒரே நேரத்தில் மூன்று நோக்கங்களை நிறைவேற்றுகிறது: பரிசோதனை, படிப்படியான வெளியீடு, மற்றும் அவசரகால சுற்று முறிவு.
Compile-time flags கட்டும் கட்டத்தில், தொடர்புடைய குறியீட்டை build artifact இலிருந்து பௌதிகமாகவே அகற்றுகின்றன. உள்-மட்டும் அம்சங்கள் வெளிப்புற builds இல் வெறுமனே இல்லை—ரிவர்ஸ் இன்ஜினியரிங் கூட அகற்றப்பட்ட செயல்பாட்டை கண்டறிய முடியாது. இது ஒரு சுத்தமான நீக்கப் பொறிமுறையையும் வழங்குகிறது: ஒரு அம்சத்தை முடக்குவது runtime இல் தர்க்கத்தைத் தவிர்க்காது; அதற்குப் பதிலாக, தொடர்புடைய குறியீடு பௌதிகமாகவே இல்லாமல் போகிறது.
Runtime flags அவற்றின் உள்ளமைவை சர்வரால் வழங்கப்பட்டு, உள்ளூர் வட்டில் cache செய்யப்படுகிறது. வடிவமைப்பு, நெட்வொர்க் கோரிக்கைக்காக காத்திருக்கும் போது ஏஜெண்டின் தொடக்கத்தைத் தடுப்பதை விட, சற்று பழைய cache செய்யப்பட்ட உள்ளமைவைப் படிப்பதற்கு முன்னுரிமை அளிக்கிறது. A/B சோதனை குழுக்களை ஒதுக்குவதற்காக, ஒரு பரிசோதனை தளம் (எ.கா., GrowthBook) மூலம் குறிப்பிட்ட குழுவாக்க முடிவுகள் எடுக்கப்படுகின்றன. ஒரு முக்கிய வடிவமைப்பு விவரம் என்னவென்றால், ஒவ்வொரு அம்சத்தின் வெளிப்பாடு நிகழ்வும் ஒரு அமர்வுக்கு அதிகபட்சம் ஒருமுறை மட்டுமே பதிவு செய்யப்படுகிறது, இது நகல் பதிவுகள் பரிசோதனைத் தரவை மாசுபடுத்துவதைத் தவிர்க்கிறது.
ஏஜெண்ட் உருவாக்குநர்களுக்கான தாக்கம்: Feature flags என்பவை பிழைத்திருத்த கருவிகள் அல்ல; அவை முதல்-வகுப்பு கட்டிடக்கலை கூறுகள் ஆகும்.
Prompt உணர்திறன் மதிப்பீடு
கணினி prompt என்பது ஏஜெண்ட் நடத்தையின் மைய “குறியீடு” ஆகும், ஆனால் அது பெரும்பாலும் வழக்கமான குறியீட்டிற்கு வழங்கப்படும் பதிப்புக் கட்டுப்பாடு மற்றும் பின்னடைவு சோதனையைக் கொண்டிருக்கவில்லை. OpenClaw இன் அணுகுமுறை, குறிப்பிட்ட git பதிப்பில் முழுமையாக வழங்கப்பட்ட கணினி prompt ஐப் பிரித்தெடுக்கக்கூடிய ஒரு பிரத்யேக கருவியை வழங்குவதாகும்—அனைத்து மாறும் நிபந்தனைகளும் விரிவாக்கப்பட்ட பிறகு இறுதி உரையும் இதில் அடங்கும். இது குழுவை துல்லியமாக பதிலளிக்க அனுமதிக்கிறது: எந்த commit prompt ஐ மாற்றியது? மதிப்பீட்டுத் தொகுப்பில் அதன் தாக்கம் என்ன?
எந்த ஏஜெண்ட் குழுவிற்கும், பரிந்துரைக்கப்பட்ட நடைமுறைகள்: (1) கணினி prompt தீர்மானகரமாக வழங்கக்கூடியதாக இருக்க வேண்டும் (அதே உள்ளமைவு உள்ளீட்டைக் கொடுத்தால், அது எப்போதும் ஒரே வெளியீட்டை உருவாக்கும்); (2) prompts க்கான பதிப்பு செய்யப்பட்ட ஸ்னாப்ஷாட் பொறிமுறையை நிறுவுதல்; (3) ஒவ்வொரு prompt மாற்றமும் மதிப்பீட்டுத் தொகுப்பில் பின்னடைவு சோதனைகளை இயக்க வேண்டும்—குறியீடு மாற்றங்களுக்கு CI தேவைப்படுவது போல.
மதிப்பீட்டு அடித்தளமாக தனியுரிமை-விழிப்புடன் கூடிய பகுப்பாய்வு
மதிப்பீடு நல்ல தரவை நம்பியிருக்கிறது; ஆனால் Agent தயாரிப்புகள் கையாள்வது பெரும்பாலும் பயனரின் உணர்திறன் மிக்க உள்ளடக்கத்தையே. OpenClaw இந்த முரண்பாட்டை ஒரு வகை அமைப்பின் (type system) வழியாகத் தீர்க்கிறது: பகுப்பாய்வு இடைமுகம் சிறப்பு வகையால் பொதியப்பட்ட மதிப்புகளை மட்டுமே ஏற்கிறது; வகையின் பெயரே ஒரு தணிக்கைத் தடம் — “இது நிரலோ கோப்புப் பாதையோ அல்ல என்பதை நான் சரிபார்த்துவிட்டேன்” என்பதை அது தெளிவாகக் காட்டுகிறது. இந்த வடிவமைப்பு தனியுரிமைக் கட்டுப்பாடுகளை ஆவணப்படுத்தப்பட்ட விதிமுறையிலிருந்து, தொகுக்கும் நேரத்தில் கட்டாயப்படுத்தப்படும் வகைச் சோதனையாக மாற்றுகிறது.
மையக் கொள்கை இதுவே: தனியுரிமைக் கட்டுப்பாடுகளைத் தொடக்கத்திலிருந்தே வடிவமைப்புக்குள் இணைக்க வேண்டும்; பின்னால் பொருத்துவதல்ல. உங்கள் பகுப்பாய்வு அமைப்பால் தரவைப் பாதுகாப்பாகச் சேகரிக்க முடியவில்லை என்றால், உங்களால் திறம்பட மதிப்பீடு செய்யவும் முடியாது.
வெளிப்புறத்திலிருந்து உள்நோக்கி: மதிப்பீட்டு சிந்தனையில் ஒரு மாற்றம்
இந்தப் பகுதியின் மையச் செய்தி: முந்தைய பகுதிகள், ஒரு ஏஜெண்டை வெளிப்புறமாக எவ்வாறு மதிப்பீடு செய்வது என்பதை உங்களுக்குக் கற்றுக் கொடுத்தன; இந்தப் பகுதி, சிறந்த ஏஜெண்ட் தயாரிப்புகள் தங்களைத் தாங்களே உள்நோக்கி எவ்வாறு மதிப்பீடு செய்கின்றன என்பதை வெளிப்படுத்துகிறது. வெளிப்புற மதிப்பீடு “ஏஜெண்ட் எவ்வளவு நன்றாக உள்ளது” என்பதைச் சொல்கிறது; உள் மதிப்பீட்டு உள்கட்டமைப்பு “எந்த மாற்றம் அதை மேம்படுத்தியது” என்பதைச் சொல்கிறது. நீக்கச் சோதனைகள் எந்த அம்சங்கள் உண்மையில் முக்கியம் என்பதைக் கண்டறிகின்றன, A/B சோதனை ஒவ்வொரு மாற்றத்தின் தாக்கத்தையும் அளவிடுகிறது, feature flags பரிசோதனை மற்றும் மாற்றத்தைத் திரும்பப் பெறுவதற்கான உள்கட்டமைப்பை வழங்குகின்றன, prompt உணர்திறன் மதிப்பீடு system prompt-ஐ CI அமைப்பில் ஒருங்கிணைக்கிறது, மற்றும் தனியுரிமை-விழிப்புணர்வு பகுப்பாய்வு தரவு சேகரிப்பில் இணக்கத்தை உறுதி செய்கிறது. இந்த ஐந்து கூறுகளும் சேர்ந்து மதிப்பீடு-உந்துதல் தயாரிப்பு பொறியியலை உருவாக்குகின்றன—அவ்வப்போது மதிப்பீடு செய்வது அல்ல, மாறாக ஒவ்வொரு தயாரிப்பு முடிவிலும் மதிப்பீட்டை உட்பொதிப்பது.
உருவகப்படுத்துதல் சூழல்கள்: மதிப்பீட்டிலிருந்து பிந்தைய-பயிற்சிக்கான பாலம்
மதிப்பீட்டின் இறுதி இலக்கு மதிப்பெண் அல்ல, மாறாக முன்னேற்றம். இந்த அத்தியாயம் ஏற்கனவே முன்னேற்றத்திற்கான இரண்டு பாதைகளை நிரூபித்துள்ளது: Harness-ஐ சரிசெய்தல் (Benchmark அறிக்கைகளிலிருந்து அமைப்பு மேம்பாடுகளுக்கு) மற்றும் மதிப்பீட்டை தயாரிப்பு பொறியியலில் உட்பொதித்தல் (உள் மதிப்பீட்டு உள்கட்டமைப்பு). முன்னேற்றத்தின் மிக வலுவான வடிவம் பயிற்சி ஆகும்—இலக்கு “தற்போதுள்ள திறன்களை மதிப்பீடு செய்வதிலிருந்து” “புதிய திறன்களை வளர்ப்பதற்கு” விரிவடையும் போது, குறிப்பாக அத்தியாயம் 8 இல் விவாதிக்கப்பட்ட பிந்தைய-பயிற்சி நுட்பங்கள் மூலம், மதிப்பீட்டு சூழல் ஒரு உருவகப்படுத்துதல் சூழலாக உருவாக வேண்டும்: ஒரு மெய்நிகர் விளையாட்டு மைதானம், அங்கு ஏஜெண்ட் மீண்டும் மீண்டும் பயிற்சி செய்து தானாகவே மதிப்பெண் பெற முடியும். உருவகப்படுத்துதல் சூழல்களுக்கும் மதிப்பீட்டு சூழல்களுக்கும் இடையிலான மைய வேறுபாடுகள்: மிக அதிகமான தொடர்பு அதிர்வெண் (மில்லியன்கள் vs. ஆயிரக்கணக்கானவை), சீரற்றமயமாக்கலின் தேவை (குறிப்பிட்ட உள்ளமைவுகளை மனப்பாடம் செய்வதைத் தடுக்க), மற்றும் உடனடி பின்னூட்டத்தின் தேவை. பயன்பாட்டுக் கண்ணோட்டத்தில், உருவகப்படுத்துதல் சூழல்கள் இரண்டு வகைகளாகப் பிரிக்கப்படுகின்றன: டிஜிட்டல் சூழல்கள் (தகவல் செயலாக்கப் பணிகள்) மற்றும் உடல்சார் சூழல்கள் (embodied environments — இயற்பியல் உலக உணர்தல் மற்றும் கையாளுதல்).
இந்தப் பாலத்தின் இரு முனைகளும் பின்வருமாறு இணைக்கப்பட்டுள்ளன. மதிப்பீட்டுப் பக்கத்தில் திரட்டப்பட்ட சொத்துக்களை, பயிற்சி சமிக்ஞைகளாக கிட்டத்தட்ட தடையின்றி மாற்ற முடியும்: நன்கு வரையறுக்கப்பட்ட ஒரு Rubric அல்லது சரிபார்ப்பான் (validator) என்பது அடிப்படையில் சரிபார்க்கக்கூடிய வெகுமதிகளுடன் கூடிய வலுவூட்டல் கற்றலுக்கான (Reinforcement Learning with Verifiable Rewards, RLVR) ஒரு வெகுமதிச் சார்பே ஆகும்—ஸ்கோரிங் ஸ்கிரிப்ட் நேரடியாக வெகுமதி ஸ்கிரிப்டாக மாறுகிறது; ஒரு சோதனை தேர்ச்சி பெறுகிறதா அல்லது ஒரு நிலை தரத்தை பூர்த்தி செய்கிறதா என்பது மதிப்பீட்டு அளவுகோலாகவும், வலுவூட்டல் கற்றலுக்கான வெகுமதியாகவும் செயல்படுகிறது. இருப்பினும், பயிற்சி, மதிப்பீடு கவலைப்பட வேண்டியிராத புதிய தேவைகளை அறிமுகப்படுத்துகிறது. முதலாவது நம்பகமான மீட்டமைப்பு (reset) சொற்பொருள்: பயிற்சி மில்லியன் கணக்கான எபிசோட்களை இயக்குகிறது (ஒரு எபிசோட் என்பது ஆரம்ப நிலையிலிருந்து பணி நிறைவு வரையிலான ஒரு முழுமையான தொடர்பு சுற்று), மேலும் ஒவ்வொரு எபிசோடும் சூழலை ஒரு தீர்மானகரமான, தூய்மையான ஆரம்ப நிலைக்கு மீட்டமைக்க முடிய வேண்டும்; இல்லையெனில், சாய்வு சமிக்ஞை (gradient signal) முந்தைய எபிசோடின் எஞ்சிய நிலைகளால் மாசுபடுத்தப்படும். இரண்டாவது மதிப்பீட்டை விட அதிகமான செயல்திறன் (throughput): சில ஆயிரம் மதிப்பீடுகள் முடிவுகளை எடுக்க போதுமானவை, ஆனால் பயிற்சிக்கு ஏற்றுக்கொள்ளக்கூடிய சுவர்-கடிகார நேரத்தில் மில்லியன் கணக்கான தொடர்புகளை மாதிரிக்கு வழங்க வேண்டும்; சூழல் இணைநிலை (parallelism) மற்றும் ஒவ்வொரு நிகழ்வின் மேல்நிலை செலவும் பயிற்சி சாத்தியமா என்பதை நேரடியாக தீர்மானிக்கிறது. இந்த இரண்டு புள்ளிகள்—சரிபார்ப்பான்களை வெகுமதிச் சார்புகளாக மாற்றுதல், மற்றும் பயிற்சி-தர மீட்டமைப்பும் செயல்திறனும்—அத்தியாயம் 8 இல் விரிவாக விளக்கப்படும்.
படம் 7-9: உருவகப்படுத்துதல் நம்பகத்தன்மை நிறமாலை · மூலப் படம்
டிஜிட்டல் சூழல்கள் பக்கத்தில், AWorld கட்டமைப்பு GAIA பணிகளுக்காக ஒரு கட்டுப்படுத்தக்கூடிய MCP சர்வர் சாண்ட்பாக்ஸை உருவாக்குகிறது, 126 கருவி செயல்பாடுகளை உள்ளடக்கிய 26 MCP சர்வர்களை வழங்குகிறது, உண்மையான APIகளை நேரடியாக அணுகுவதால் ஏற்படும் தடைகள் மற்றும் கட்டுப்படுத்த முடியாத பக்க விளைவுகளைத் தவிர்க்கிறது. அனைத்து கருவி அழைப்புகளும் மீண்டும் இயக்கக்கூடியவை மற்றும் தணிக்கை செய்யக்கூடியவை. AWorld இன் விநியோகிக்கப்பட்ட கட்டமைப்பு, பாரம்பரிய தொடர் செயலாக்க நேரத்தை 7695 வினாடிகளில் இருந்து 525 வினாடிகளாக (14.6x வேக அதிகரிப்பு) குறைக்கிறது, மேலும் சூழலின் நிலையற்ற வடிவமைப்பு ஒவ்வொரு நிகழ்வையும் முற்றிலும் சுயாதீனமாக்கி, திறமையான இணைநிலையை ஆதரிக்கிறது.
உடல்சார் சூழல்கள் பக்கத்தில், RoboTwin2 இயற்பியல் இயந்திரத்தின் அடிப்படையில் இரட்டை-கை கையாளுதல் பணிகளை உருவாக்குகிறது, பொதுமைப்படுத்தலை மேம்படுத்த பொருள்களின் நிலைகள், நோக்குநிலைகள் மற்றும் தோற்றங்களை சீரற்றதாக்குகிறது. கண்காணிப்பு இடத்தில் பல-கேமரா காட்சிகள் மற்றும் மூட்டு நிலைகள் அடங்கும், ஆக்ஷன் சங்கிங் (Action Chunking) மூலம் நிகழ்நேர கட்டுப்பாட்டை அடைகிறது—இதில் மாதிரி ஒரே நேரத்தில் பல தொடர்ச்சியான செயல்களைத் திட்டமிடுகிறது (அத்தியாயம் 6 இல் விரிவாக). OSWorld மெய்நிகர் இயந்திர ஸ்னாப்ஷாட்கள் மூலம் மீட்டமைக்கும் தன்மையை அடைகிறது, மேலும் AndroidWorld மொபைல் பயன்பாட்டு ஆட்டோமேஷனில் கவனம் செலுத்துகிறது. டிஜிட்டல் அல்லது உருவகப்படுத்தப்பட்டதாக இருந்தாலும், உருவகப்படுத்துதல் சூழல்களுக்கு அத்தியாயம் 4 இல் விவாதிக்கப்பட்ட தனிமைப்படுத்தப்பட்ட செயலாக்க சூழல்கள் மற்றும் மெய்நிகர் அடையாள வழிமுறைகள் (VM/கொள்கலன் தனிமைப்படுத்தல், குடியிருப்பு ப்ராக்ஸிகள், மனிதன்-இன்-த-லூப் அங்கீகாரம், பகிரப்பட்ட கோப்பு அமைப்புகள்) தேவைப்படுகின்றன, அவை இங்கு மீண்டும் கூறப்படவில்லை.
சோதனை 7-14 ★★: OpenVLA மற்றும் RoboTwin2 க்கான உடல்சார் நுண்ணறிவு சூழலை உள்ளமைக்கவும்
ரோபோ கையாளுதலுக்கான உருவகப்படுத்துதல் சூழலை அமைக்கவும். ch7/SimpleVLA-RL மற்றும் OpenVLA ஆவணங்களைப் படித்து, Vision-Language-Action மாதிரியின் கட்டமைப்பைப் புரிந்துகொள்ளவும் (விஷன் என்கோடர், மொழி மாதிரி மற்றும் ஆக்ஷன் டிகோடர் ஆகியவற்றின் எண்ட்-டு-எண்ட் ஒருங்கிணைப்பு, படங்கள் மற்றும் உரையை ஒரு பகிரப்பட்ட சொற்பொருள் இடத்தில் திட்டமிடுதல்). RoboTwin2 சூழலை உள்ளமைக்கவும், அதன் கண்காணிப்பு இடத்தைப் (மூன்று-காட்சி RGB + 14-பரிமாண கூட்டு நிலை) மற்றும் செயல் இடத்தையும் (14-பரிமாண கட்டுப்பாட்டு திசையன்) புரிந்துகொள்ளவும். move_can_pot இல் உள்ள சூழல் சீரற்றமயமாக்கல் பொறிமுறை மற்றும் இடஞ்சார்ந்த கட்டுப்பாட்டு தர்க்கத்தைப் படிக்கவும். முன்-பயிற்சி பெற்ற மாதிரியின் மதிப்பீட்டை இயக்கவும், வெற்றி விகிதம், நிறைவு நேரம் மற்றும் தோல்வி முறைகளைப் பதிவு செய்யவும், குறிப்பாக ஆக்ஷன் சங்கிங் பொறிமுறையின் தாக்கத்தில் கவனம் செலுத்தவும்.
படம் 7-10: OpenVLA மற்றும் RoboTwin2 உடல்சார் நுண்ணறிவு சூழல் · மூலப் படம்
நம்பகத்தன்மை வர்த்தக-ஆஃப்கள் மற்றும் டொமைன் சீரற்றமயமாக்கல்
அதிக நம்பகத்தன்மை கொண்ட சூழல்கள் நிஜ உலகத்திற்கு சிறப்பாக மாற்றமடைகின்றன, ஆனால் அதிக கணக்கீட்டு செலவுகளைக் கொண்டுள்ளன. நம்பகத்தன்மையின் மற்றொரு பரிமாணம் சீரற்றமயமாக்கலின் அளவு: மிதமான சீரற்றமயமாக்கல் பொதுமைப்படுத்தலை மேம்படுத்துகிறது, அதேசமயம் அதிகப்படியான சீரற்றமயமாக்கல் பணிகளை மிகவும் கடினமாக்கும். டொமைன் சீரற்றமயமாக்கல் என்பது சிம்-டு-ரியல் இடைவெளியைக் குறைப்பதற்கான ஒரு முக்கிய நுட்பமாகும்: இயற்பியல் அளவுருக்கள், காட்சித் தோற்றம், சென்சார் சத்தம் போன்றவற்றில் பரந்த அளவிலான சீரற்ற மாறுபாடுகளை அறிமுகப்படுத்துதல்—வெவ்வேறு விளக்குகள் மற்றும் கோணங்களில் பிடிப்பதைப் பயிற்சி செய்வது போல, நிஜ உலகில் விளக்கு மாறினாலும் தோல்வியடையாமல் இருக்க. டிஜிட்டல் சூழல்களில், சிம்-டு-ரியல் என்பது இடைமுக ரெண்டரிங், பதில் நேரங்கள் போன்றவற்றில் உள்ள வேறுபாடுகளாக வெளிப்படுகிறது, இவை தாமதம் மற்றும் தோல்விகளில் சீரற்றமயமாக்கலை அறிமுகப்படுத்துவதன் மூலம் குறைக்கப்படலாம்.
அத்தியாயச் சுருக்கம்
இந்த அத்தியாயம் ஒரு மையக் கேள்வியைச் சுற்றி அமைந்துள்ளது: ஏஜெண்ட் உண்மையிலேயே மேம்பட்டதா என்பதை எப்படித் தெரிந்துகொள்வது? இந்தச் சங்கிலி நான்கு கண்ணிகளால் ஆனது: முதலில் எது வெற்றி என்பதைத் தெளிவுபடுத்துதல் (Pass@k, Best@k, Pass consecutive@k ஆகியவற்றின் அடிப்படை வேறுபாடுகள்), பின் பணிகள் எங்கிருந்து வருகின்றன என்பதை நிர்ணயித்தல் (பொதுத் தரவரிசைச் சோதனைகள், சொந்த வணிகத் தொகுப்பு, உற்பத்தி trajectory திரும்பப் பாய்தல்), அடுத்து சரிபார்ப்பு முறையைத் தேர்ந்தெடுத்தல் (நிர்ணயவாதச் சரிபார்ப்பான்களிலிருந்து சோதனைப் பட்டியல், Rubric உடன் LLM தீர்ப்பு, இணை ஒப்பீடு வரை), இறுதியாக மதிப்பெண்களை முடிவுகளாக மாற்றுதல் (புள்ளியியல் முக்கியத்துவம், தோல்விக் காரணம் கண்டறிதல், பின்னடைவுப் பணிகள், மாதிரித் தேர்வு). இந்தச் சங்கிலியின் ஒவ்வொரு இணைப்பும் முடிவின் நம்பகத்தன்மையை நிர்ணயிக்கிறது. அளவிடப்பட்ட எடுத்துக்காட்டுகள் நான்கு நடைமுறை எச்சரிக்கைகளை வழங்குகின்றன: structured memory-யுடன் RAG-ஐ இணைப்பதால் மட்டும் synergy உறுதி ஆகாது; cache மற்றும் compression சேமிப்புகளை நேரடியாகக் கூட்ட முடியாது; reference audio-வின் தேர்வு multimodal score-ன் பொருளையே மாற்றும்; Harness வழங்கும் input representation பணி வெற்றியையும் token செலவையும் ஒரே நேரத்தில் தீர்மானிக்கலாம். Model selection-லும் ஒரே operating point-ஐப் பார்க்காமல், வெவ்வேறு resource budget-களில் capability எவ்வாறு வளர்கிறது என்பதை ஒப்பிட வேண்டும். Production Agent-க்கு evaluation என்பது அவ்வப்போது நடக்கும் தேர்வு அல்ல; ஒவ்வொரு product முடிவிலும் உள்ள தொடர்ச்சியான validation ஆகும்.
நூலின் ஒட்டுமொத்தக் கட்டமைப்பின்படி, இந்த அத்தியாயம் கட்டுவது அத்தியாயம் 1 இன் கண்டுபிடிப்புச் சுழற்சியில் உள்ள சான்று பகுதியே: தோல்விக் காரணக் கண்டறிதலே, அடுத்துவரும் முன்மொழிவுகளுக்கு உறுதியான ஆதாரம் உண்டா என்பதைத் தீர்மானிக்கிறது.
பாதை முன்னொட்டு எல்லை மதிப்பீடு மேலும் ஒன்றைத் தெளிவாக்குகிறது: ஒரு தகவலைப் பெறுவதும், அதைத் தற்போதைய முடிவில் சரியாகப் பயன்படுத்துவதும் இரு வேறு திறன்கள். இறுதி-முதல்-இறுதி பின்னடைவுச் சோதனை அடிப்படைப் பணிகள் தரம் குறையாமல் இருப்பதை உறுதி செய்கிறது; trajectory prefix எல்லைத் தொகுப்போ வரம்பு பற்றிய தீர்ப்பு, தற்போதைய அறிவுறுத்தலின் மேலெழுதல், தெளிவுபடுத்தல், ஆபத்தான செயலுக்கு முந்தைய உறுதிப்படுத்தல் ஆகியவற்றை நேரடியாகச் சோதிக்கிறது. பயனர் நினைவகம் இந்தப் பொது முறையின் ஒரு வழக்கு மட்டுமே. உற்பத்தி நிலை Agent-இன் மதிப்பீடு எப்போதாவது ஒருமுறை நடத்தும் தேர்வு அல்ல; நிஜப் பிரச்சினை வழக்குகளிலிருந்து பின்னடைவுப் பணிகளையும் எல்லைப் பணிகளையும் தொடர்ந்து உருவாக்கும் சரிபார்ப்பு அமைப்பு.
மைய முறை: கவனி → கருதுகோள் → பரிசோதனை செய் → சரிபார் → புதிய புரிதல் → புதிய கருதுகோள், ஏஜெண்ட் பொறியியலை அனுபவத்தால் இயக்கப்படும் “ரசவாதத்திலிருந்து” தரவுகளால் இயக்கப்படும் அறிவியல் பொறியியலாக மாற்றுகிறது.
இந்த அத்தியாயத்தில் அறிமுகப்படுத்தப்பட்ட மதிப்பீட்டு அமைப்பு ஒரு முழுமையான மூடிய வளையத்தை உருவாக்குகிறது: மதிப்பீட்டு சூழல் தானியங்கி சோதனை உள்கட்டமைப்பை வழங்குகிறது → மதிப்பீட்டு தரவுத்தொகுப்பு சோதனை வழக்குகளை வரையறுக்கிறது → தானியங்கி மதிப்பீட்டு முறைகள் (LLM-as-a-Judge மற்றும் Rubric) ஏஜெண்டின் செயல்திறனை மதிப்பெண் செய்கின்றன → அளவுகோல் பகுப்பாய்வு மேம்பாட்டு திசைகளை வெளிப்படுத்துகிறது → அமைப்பு மேம்பாடுகள் சிக்கல்களை சரிசெய்கின்றன → மதிப்பீட்டு சூழல் மற்றும் தரவுத்தொகுப்பைப் புதுப்பித்து, புதிய மறுசெயல் சுழற்சியைத் தொடங்குகிறது.
இந்த அத்தியாயத்தில் நிறுவப்பட்ட மதிப்பீட்டு அமைப்பு தற்போதைய அமைப்பை மேம்படுத்துவதோடு மட்டுமல்லாமல், அடுத்த இரண்டு அத்தியாயங்களுக்கும் முக்கிய அடித்தளத்தை வழங்குகிறது. அத்தியாயம் 8 மதிப்பீட்டுச் சூழலையும் தரவையும் மாதிரியின் பிந்தைய பயிற்சிக்கான உள்ளீடுகளாக மாற்றி, SFT மற்றும் RL மூலம் தொடர்பு உத்திகளை அளவுருக்களில் எழுதுகிறது; அத்தியாயம் 9 உற்பத்திப் பாதைகளின் பல்பரிமாண மதிப்பீட்டை அறிவு, அறிவுறுத்தல், நிரல் அல்லது அளவுருக்களுக்கான வேட்பாளர் புதுப்பிப்புகளாக மாற்றுகிறது.
சிந்தனை கேள்விகள்
★★ LLM-as-a-Judge ஒரு மொழி மாதிரியின் வெளியீட்டை மதிப்பிடுவதற்கு ஒரு மொழி மாதிரியைப் பயன்படுத்துகிறது. இந்த “சுய-மதிப்பீட்டில்” முறையான குருட்டுப் புள்ளிகள் உள்ளதா—எடுத்துக்காட்டாக, மாதிரி ஒரு குறிப்பிட்ட பாணியிலான பதிலுக்கு தொடர்ந்து அதிக மதிப்பெண்களை வழங்கலாம், இந்த விருப்பம் மனித தீர்ப்புடன் முரண்படுகிறதா? இத்தகைய சார்புகளை எவ்வாறு கண்டறிந்து சரிசெய்வது?
★★★ மதிப்பீட்டு தரவுத்தொகுப்புகளின் “கசிவு-தடுப்பு” வடிவமைப்பு மிகவும் முக்கியமானது. இருப்பினும், திறந்த மூல சூழலில், அளவுகோல் தரவு பொதுவில் வெளியிடப்பட்டவுடன், அது விரைவாக பயிற்சி தரவுகளில் இணைக்கப்படுகிறது. இந்த “பூனை-எலி விளையாட்டுக்கு” முடிவு உண்டா? தரவு கசிவை அடிப்படையில் எதிர்க்கும் ஒரு மதிப்பீட்டு முறையை வடிவமைக்கவும்.
★★ Scale AI இன் நான்கு அளவுகோல்கள் (நிபுணர் வழிகாட்டுதல், விரிவான கவரேஜ், தரநிலை முக்கியத்துவ எடை, சுய-உள்ளடக்கிய மதிப்பீடு) மதிப்பீட்டில் உள்ள அகநிலையை நீக்குவதை நோக்கமாகக் கொண்டுள்ளன. இருப்பினும், சில பணி பரிமாணங்கள் (எ.கா., “பதில் உதவியாக உள்ளதா?” “தொனி பொருத்தமானதா?”) இயல்பாகவே அகநிலை சார்ந்தவை. இந்த அகநிலை பரிமாணங்களுக்கு நம்பகமான Rubrics ஐ எவ்வாறு வடிவமைப்பது?
★★ τ-bench உண்மையான பயனர் நடத்தையை உருவகப்படுத்துவதன் மூலம் ஏஜெண்டுகளை மதிப்பிடுகிறது. ஆனால் உருவகப்படுத்தப்பட்ட பயனர் ஒரு LLM ஆகும்—இது சில விளிம்பு நிலை நிகழ்வுகளை (எ.கா., உணர்ச்சிவசப்பட்ட அல்லது தெளிவற்ற பயனர்கள்) முறையாக குறைத்து மதிப்பிடலாம். உருவகப்படுத்தப்பட்ட பயனரின் தரத்தை எவ்வாறு சரிபார்க்க முடியும்?
★★ ஜோடிவரிசை ஒப்பீடு (Bradley-Terry மாதிரி) என்பது விருப்பங்கள் இடமாற்றத்தன்மை கொண்டவை என்று கருதுகிறது (A > B மற்றும் B > C எனில், A > C). இருப்பினும், மனித விருப்பங்கள் பெரும்பாலும் இடமாற்றத்தன்மையை மீறுகின்றன. ஏஜெண்ட் மதிப்பீட்டில், எந்த சூழ்நிலைகளில் இடமாற்றமற்ற விருப்பங்கள் தோன்றக்கூடும்? இது தரவரிசைகளின் நம்பகத்தன்மையை எவ்வாறு பாதிக்கிறது?
★★ இந்த அத்தியாயம் திறனின் உச்சவரம்பான Pass@k-ஐயும், வணிக நம்பகத்தன்மையை அளக்கும் Pass consecutive@k-ஐயும் வேறுபடுத்துகிறது. ஒரேயொரு முறை இயக்கும்போது 60% மட்டுமே வெற்றி விகிதம் உள்ள ஒரு Agent-க்கு, பணியின் தோல்விச் செலவு, மறுமுயற்சிச் செலவு மற்றும் பக்கவிளைவுகளை எவ்வாறு இணைத்து எந்த அளவீட்டைத் தெரிவிப்பது என்பதையும் k எவ்வளவு இருக்க வேண்டும் என்பதையும் தீர்மானிப்பீர்கள்?
★★ இந்த அத்தியாயம் “கவனி → கருதுகோள் உருவாக்கு → பரிசோதனை செய் → சரிபார்” என்ற அறிவியல் முறையை முன்மொழிகிறது. நடைமுறையில், இருப்பினும், ஏஜெண்டின் நடத்தை இடம் மிகப்பெரியது, மேலும் ஒரு கருதுகோளை சரிபார்க்க நூற்றுக்கணக்கான மதிப்பீட்டு இயக்கங்கள் தேவைப்படலாம். வரையறுக்கப்பட்ட கணக்கீட்டு வரவு செலவுத் திட்டத்தின் கீழ் மதிப்பீட்டிலிருந்து பெறப்படும் தகவலை எவ்வாறு அதிகரிக்க முடியும்?
★ AndroidWorld pilot-இல் முழு element tree வெற்றியை 25%-இலிருந்து 100%-ஆக உயர்த்தியது; ஆனால் token பயன்பாடு control-ன் 2.498× ஆனது. Tree pruning செய்த பிறகும் வெற்றி 100%-ஆகவே இருந்தது; token பயன்பாடு 0.506× ஆகக் குறைந்தது. Accessibility, state verification, அடுத்தடுத்த action ஆகியவற்றுக்குத் தேவையான தகவலை இழக்காமல், பொருள் இல்லாத UI node-களை தானாக நீக்கும் விதிகளை எவ்வாறு வடிவமைப்பீர்கள்?
★★ τ-bench இன் பயனர் உருவகப்படுத்துதல் “முற்போக்கான தகவல் வெளிப்பாட்டை” பயன்படுத்துகிறது—அனைத்து தகவல்களையும் ஒரே நேரத்தில் வழங்காமல், ஏஜெண்டின் கேள்விகளின் அடிப்படையில் படிப்படியாக வெளிப்படுத்துகிறது. இந்த வடிவமைப்பு மதிப்பீட்டு முடிவுகளை எவ்வாறு பாதிக்கிறது? உருவகப்படுத்தப்பட்ட பயனரின் தகவல் வெளிப்பாட்டு உத்தி உண்மையான பயனர்களிடமிருந்து கணிசமாக வேறுபட்டால், மதிப்பீட்டு முடிவுகள் இன்னும் நம்பகமானதா?
அடிக்குறிப்புகள்
Wijk, Hjalmar, et al. RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts. arXiv:2411.15114, 2025. ↩
நடைமுறைப்படுத்துங்கள்
இணைப் பரிசோதனைகள்
இந்த அத்தியாயத்தின் இணைப் பரிசோதனைகளை ஆராய்ந்து, கருத்துகள் நிரலில் எவ்வாறு செயல்படுகின்றன என்பதைப் பாருங்கள்.