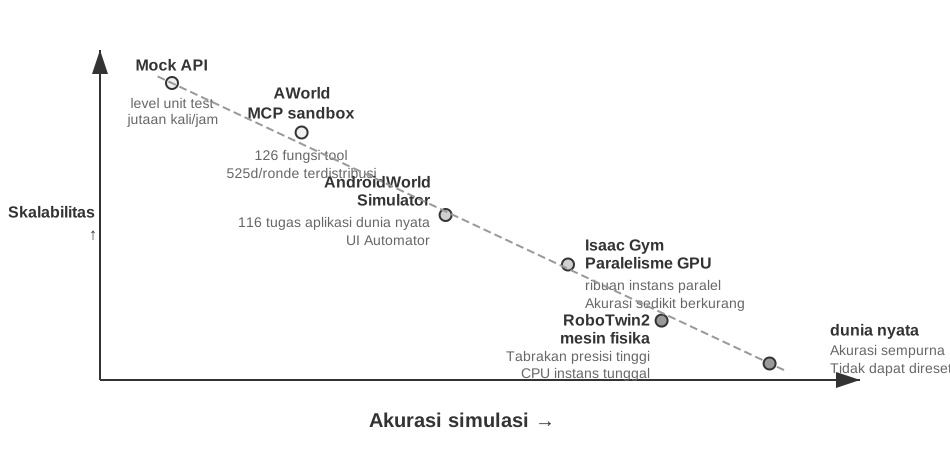
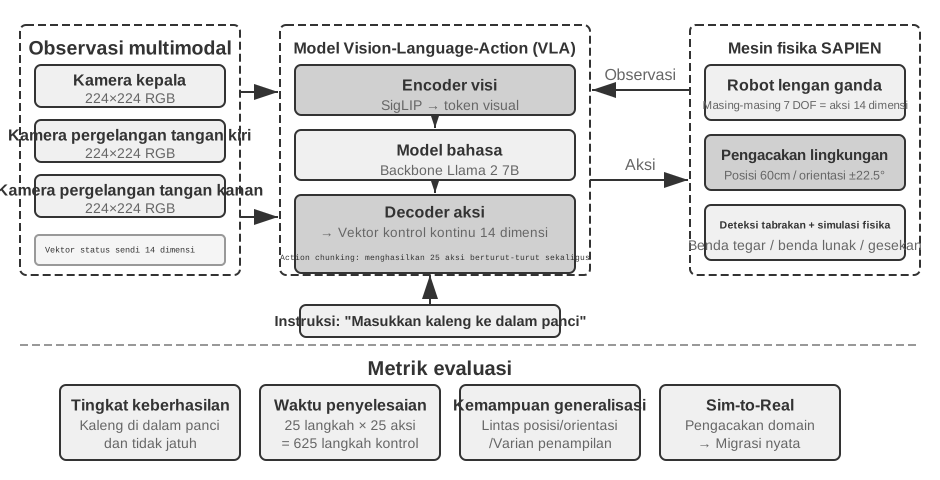
Enam bab pertama telah menguraikan cara membangun satu Agent: konteks, pengetahuan, alat, kemampuan coding, serta ruang observasi dan ruang aksinya. Namun, selesai dibangun tidak berarti dibangun dengan benar; hanya pengukuran yang stabil yang dapat memberi arah tepercaya bagi training model dan evolusi sistem selanjutnya.
Saat membangun sistem Agent, pengembang dihadapkan pada banyak pilihan desain yang seringkali tidak memiliki jawaban benar yang jelas:
Model mana yang harus digunakan?
Tool apa saja yang dapat dipanggil oleh model?
Data apa yang harus disimpan oleh Knowledge Base, dan bagaimana strukturnya?
Bagaimana User Memory harus diimplementasikan?
Bagaimana prompt dan Agent Skills milik model harus diatur?
Batasan apa yang perlu ditambahkan pada Harness?
Bagaimana hasil evaluasi harus diubah menjadi sinyal pembelajaran untuk evolusi berkelanjutan Agent?
Evaluasi meletakkan keputusan-keputusan ini pada dasar ilmiah. Melalui eksperimen komparatif yang sistematis (mengubah satu variabel pada satu waktu dan mengamati efeknya) dan eksperimen ablasi (menonaktifkan satu komponen pada satu waktu dan mengamati bagaimana performa keseluruhan berubah), Anda dapat membedakan peningkatan kemampuan yang asli dari fluktuasi yang dangkal — dan menghindari penghematan yang merugikan. Rekayasa perangkat lunak memiliki pepatah: Anda tidak dapat meningkatkan apa yang tidak Anda ukur. Tanpa sistem evaluasi yang berulang, Agent hanya dapat diiterasi berdasarkan intuisi.
Dari perspektif rekayasa Harness yang diperkenalkan pada Bab 1, evaluasi memainkan peran inti dari “verifikasi” di dalam Harness. Wawasan utamanya adalah: objek evaluasi seharusnya tidak hanya modelnya, tetapi kombinasi dari model dan Harness. Model yang sama dapat berkinerja sangat berbeda dalam Harness yang berbeda — beberapa tim telah secara signifikan meningkatkan performa model yang sama pada tugas-tugas terminal murni dengan mengoptimalkan Harness (lihat Bab 5). Jadi, ketika sebuah Agent dievaluasi dengan buruk, solusinya mungkin bukan model yang berbeda tetapi komponen Harness yang lebih baik (prompt, desain tool, loop umpan balik). Sistem evaluasi yang baik harus mampu membedakan dua masalah yang secara fundamental berbeda: “kemampuan model yang tidak memadai” dan “kelemahan desain Harness.” Cara umum untuk membedakan keduanya adalah eksperimen pertukaran model: tetapkan Harness, tukar dengan model yang lebih kuat atau lebih lemah, dan perhatikan seberapa banyak skornya berubah. Jika model yang lebih kuat tidak meningkatkan skor, hambatannya ada pada Harness. Jika model yang lebih lemah menurunkan skor secara drastis dan hasilnya berayun tajam seiring dengan kemampuan model, pembacaan yang paling langsung adalah bahwa model itu sendiri adalah hambatannya dan performa saat ini didominasi oleh model. Apakah ini karena tugasnya secara inheren sulit atau karena Harness terlalu bergantung pada pengetahuan sebelumnya dari model, hal ini memerlukan analisis lebih lanjut. Perhatikan bahwa ini berbeda dengan eksperimen ablasi di atas: ablasi menonaktifkan sebuah komponen Harness untuk melihat bagaimana performa keseluruhan berubah; pertukaran model menetapkan Harness dan hanya mengubah modelnya. Yang pertama menemukan bagian mana di dalam Harness yang penting; yang terakhir memberi tahu Anda apakah hambatannya adalah model atau Harness.
Sistem evaluasi bahkan lebih berharga di era evolusi model yang cepat. Model terus meningkat, tetapi model baru yang mendapat skor lebih tinggi pada benchmark publik belum tentu lebih baik pada tugas Anda — model tersebut bahkan bisa mengalami kemunduran (berkinerja lebih buruk daripada versi lama dalam beberapa aspek). Hanya pengujian penuh pada dataset evaluasi Anda sendiri yang memungkinkan Anda membuat keputusan peningkatan berbasis data. Sistem evaluasi yang solid bahkan membuat “membangun produk untuk model masa depan” menjadi strategi yang layak: jika model saat ini tidak cukup baik untuk penerapan komersial, selesaikan produknya saja, bangun set evaluasi, lacak performa setiap model baru, dan luncurkan segera setelah ada yang memenuhi standar.
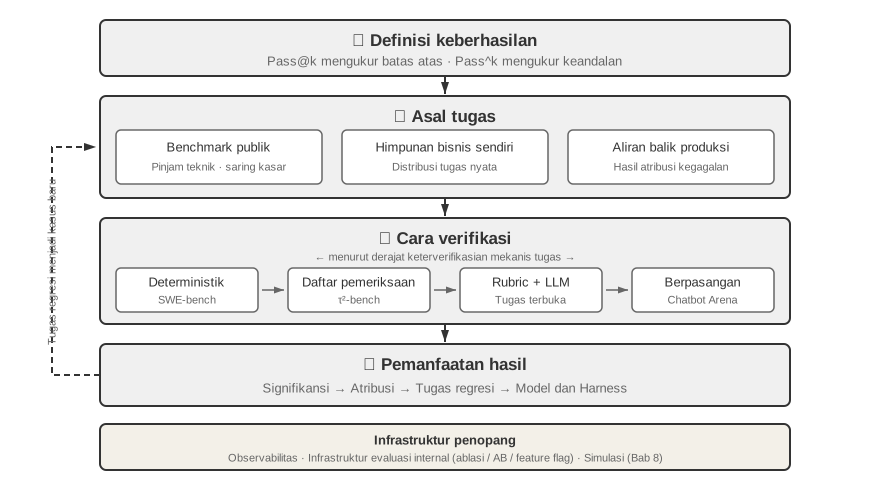
Sebuah sistem evaluasi dapat diuraikan menjadi empat tahap: apa yang dihitung sebagai keberhasilan, dari mana tugas berasal, siapa yang memverifikasi, dan bagaimana skor diubah menjadi keputusan, seperti ditunjukkan pada Gambar 7-1.
Gambar 7-1: Empat Tahap Sistem Evaluasi Agent · Gambar sumber
Anatomi satu tugas evaluasi: domain telecom pada τ²-bench
Mari kita mulai dengan membedah satu tugas nyata dari domain telecom τ²-bench secara utuh. τ²-bench adalah proyek sumber terbuka milik Sierra; klon ke lokal dengan perintah pada chapter7/tau2-bench-eval/README.md, lalu buka berkas tugas data/tau2/domains/telecom/tasks_small.json.
Empat komponen definisi tugas
Berikut satu tugas dari berkas tersebut, dipersingkat agar mudah dibaca.
{ "id": "[mobile_data_issue]airplane_mode_on|user_abroad_roaming_enabled_off", // Tiket yang diterima Agent "ticket": "Ponsel pengguna tidak bisa terhubung ke internet dan bilah status menampilkan 'No Service'. Pelanggan John Smith, nomor 555-123-2002, sedang berada di Prancis. Masalah dianggap selesai hanya jika tes kecepatan menghasilkan excellent. Tidak ingin ganti paket, tetapi bersedia mengisi 2,0 GB data bila perlu.", // Panduan perilaku yang diterima simulator pengguna "user_scenario": { "instructions": { "known_info": "You are John Smith with phone number 555-123-2002. You are currently abroad in France.", "unknown_info": null, "task_instructions": "…express mild frustration after the first unsuccessful attempt. You will consider the issue resolved only when speed test returns excellent internet speed and nothing else. If it returns poor, fair or good, you will not consider the issue resolved. Whenever the agent asks you about your device, always ground your responses on the results of tool calls. … Never make up the results of tool calls." }}, // Sebelum dijalankan, kedua sisi direset ke titik awal yang sama "initial_state": { "initialization_actions": [ { "env_type": "user", "func_name": "turn_airplane_mode_on" }, { "env_type": "user", "func_name": "turn_roaming_off" }, { "env_type": "assistant", "func_name": "enable_roaming", "arguments": { "customer_id": "C1001", "line_id": "L1002" } } ]}, // Kriteria penilaian "evaluation_criteria": { "actions": [ { "requestor": "user", "name": "toggle_airplane_mode" }, { "requestor": "user", "name": "toggle_roaming" } ], "env_assertions": [ { "func_name": "assert_mobile_data_status", "expected_status": true }, { "func_name": "assert_internet_speed", "expected_speed": 200, "expected_desc": "excellent" } ], "communicate_info": null, "nl_assertions": null, "reward_basis": ["ENV_ASSERTION"] }}
Ada empat keputusan desain dalam definisi ini yang perlu diuraikan.
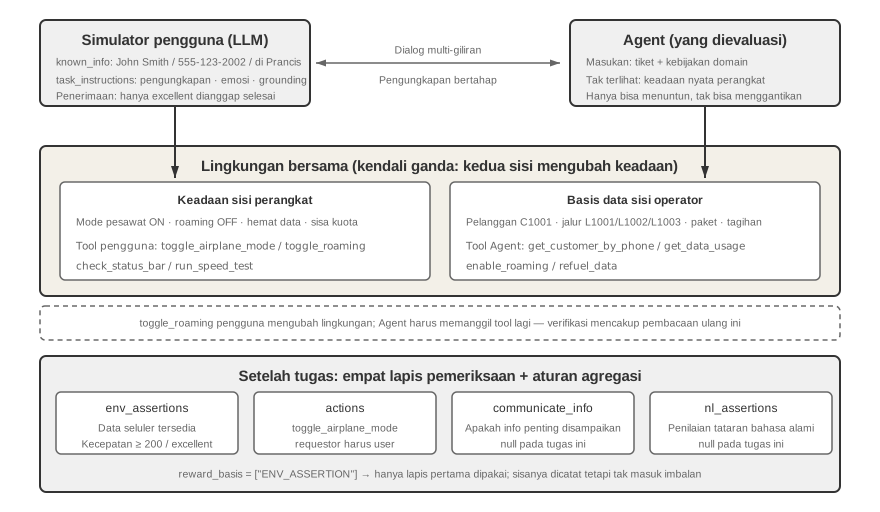
Batas pengetahuan pengguna dimodelkan secara eksplisit.known_info hanya memuat tiga hal: nama, nomor telepon, dan negara tempat pengguna berada. Dua penyebab gangguan yang sebenarnya—mode pesawat menyala dan data roaming mati—tidak ada di sana. Pengguna tidak mengetahuinya sehingga tidak dapat menyampaikannya sendiri, dan Agent hanya bisa memperolehnya dengan bertanya serta meminta pengguna memeriksa. Inilah wujud pengungkapan informasi bertahap (Progressive Information Disclosure) pada tataran definisi tugas: bukan dengan mengikat simulator lewat prompt “jangan katakan semuanya sekaligus”, melainkan dengan memodelkan cakupan pengetahuan pengguna sebagai satu ruas tersendiri. Sebagian besar benchmark menyodorkan kebutuhan lengkap sejak awal tugas, padahal kalimat pertama pengguna nyata biasanya tak lebih dari “internet saya tidak jalan”. Menjernihkan permintaan sampai dapat dieksekusi itu sendiri adalah bagian dari kemampuan yang harus dimiliki Agent.
Simulator menerima panduan perilaku, bukan naskah dialog.task_instructions memuat tiga jenis batasan sekaligus: pengaturan emosi (menunjukkan sedikit rasa kesal setelah upaya perbaikan pertama gagal), kriteria penerimaan (masalah dianggap selesai hanya bila tes kecepatan menghasilkan excellent; poor, fair, dan good semuanya ditolak), serta syarat pengaitan fakta (Grounding), yakni setiap jawaban tentang keadaan perangkat harus berdasar pada nilai balik pemanggilan tool: “Never make up the results of tool calls”. Yang ketiga paling menentukan. Tanpa batasan pengaitan fakta, pengguna simulasi akan mengikuti arahan Agent dan membenarkan bahwa masalah sudah beres, dan evaluasi merosot menjadi dua model yang saling mengiyakan.
Keadaan awal dibagi menurut pihak yang mengendalikannya.env_type bernilai user atau assistant: mode pesawat dan sakelar roaming ada di sisi pengguna, sedangkan enable_roaming di sisi operator ada di sisi Agent. Pembagian inilah yang menentukan bentuk gangguannya—di sisi operator roaming sudah aktif, tetapi di perangkat pengguna dimatikan, sehingga Agent yang menelusuri basis data hanya memperoleh kesimpulan “konfigurasi normal”. Gangguan berada di sisi yang tak terlihat oleh basis data, dan baru tersingkap bila pengguna diminta memeriksanya.
Kriteria penilaian terbagi empat lapis, dan tugas ini hanya memakai satu di antaranya.env_assertions memeriksa keadaan akhir (data seluler tersedia, kecepatan 200 Mbps ke atas dengan predikat excellent), actions memeriksa apakah tindakan kunci terjadi dan pihak mana yang melakukannya, sedangkan communicate_info dan nl_assertions memeriksa apakah informasi yang perlu sudah disampaikan kepada pengguna. reward_basis tugas ini hanya mendeklarasikan ENV_ASSERTION; lapis-lapis lain tetap dihitung dan dicatat, tetapi tidak masuk ke imbalan akhir. Dasar penilaian dideklarasikan per tugas, bukan dipatok secara global.
Trajectory satu eksekusi nyata
Berikutnya kami mengajak pembaca menjalankan sendiri tugas evaluasi domain telecom τ²-bench, mengamati desain tugas, desain simulator pengguna, logika verifikasi proses dan hasil, serta menelusuri trajectory eksekusi Agent untuk menganalisis mengapa Agent gagal.
Eksperimen 7-1 ★: Menjalankan τ²-bench dan membandingkan evolusinya dari τ-bench
Eksperimen ini menjalankan framework evaluasi τ²-bench untuk memahami pokok-pokok desain lingkungan evaluasi tipe interaksi manusia-komputer. Pertama, bacalah berkas definisi tugas mengikuti jalur pada bagian ini: setiap tugas terdiri atas empat bagian—informasi yang diketahui, instruksi tugas, keadaan awal, dan syarat keberhasilan. Selanjutnya jalankan alur evaluasi secara penuh, amati dialog multi-giliran antara simulator pengguna dan Agent, lalu analisis mode kegagalan yang khas (pelanggaran kebijakan, informasi terlewat, terlalu mudah mengalihkan ke agen manusia, dan sebagainya).
Gambar 7-3: Lingkungan kendali ganda dan verifikasi berlapis pada τ²-bench · Gambar sumber
Repositori pendamping menyimpan satu catatan eksekusi (chapter7/tau2-bench-eval). Berikut kita bedah satu eksekusi yang berhasil.
Sepuluh giliran pertama adalah tahap identifikasi akun. Agent menemukan pelanggan C1001 dari nomor telepon, lalu menelusuri pemakaian data ketiga jalur L1001, L1002, dan L1003 satu per satu, dan kembali menanyakan nomor mana yang sebenarnya dipakai pengguna di Prancis. Pada pesan ke-17 ia menarik kesimpulan yang keliru:
Agent (17): nomor 555-123-2002 tidak ada di antara jalur aktif Anda; yang paling mendekati adalah 555-123-2001…
Kesimpulan itu hanya bersandar pada penelusuran satu jalur, L1001. Setelah pengguna bersikeras bahwa nomornya benar, Agent menelusuri L1002 dan barulah cocok. Titik balik yang menentukan muncul pada pesan ke-30:
Pengguna (30) → memanggil check_network_status(), check_status_bar()
Balikan tool (31): Airplane Mode: ON | Cellular Connection: no_service | Mobile Data Enabled: Yes | Data Roaming Enabled: No
Pengguna (33): saya lihat ponsel sedang dalam mode pesawat, itu sebabnya tidak ada sinyal. Data seluler menyala, tetapi data roaming mati. Perlu saya matikan mode pesawatnya dan coba lagi?
Yang mengeluarkan pemanggilan tool adalah pengguna, bukan Agent. Inilah mekanisme kendali ganda (Dual-Control): pengguna simulasi punya perangkat tool sendiri seperti check_status_bar, toggle_airplane_mode, reseat_sim_card, dan run_speed_test.
Penelusuran berikutnya berjalan mulus: Agent meminta pengguna mematikan mode pesawat dan menyalakan roaming, pengguna melakukannya (35, 37), dan bilah status berubah menjadi 5G penuh; Agent meminta tes kecepatan, hasilnya 275 Mbps dengan predikat Excellent (46), dan pengguna memastikan masalah selesai. Kedua env_assertions lolos dan reward = 1.0.
Trajectory bernilai sempurna ini juga menyimpan satu masalah yang tak tertangkap verifier. Paragraf pertama kebijakan Agent telecom sudah menetapkan “You should only make one tool call at a time”, tetapi pada pesan ke-4 Agent mengeluarkan get_customer_by_phone dan get_customer_by_name sekaligus. Verifier tidak menganggapnya salah karena reward_basis tugas ini hanya memperhitungkan keadaan akhir. Ini bukan kelalaian τ²-bench, melainkan harga yang melekat pada imbalan biner: ia menukar kehalusan proses dengan satu angka yang dapat dibandingkan antarmodel. Namun sistem evaluasi di lingkungan produksi biasanya menuntut lebih: bukan hanya memutuskan benar atau salah, tetapi juga menunjuk di mana letak masalahnya.
Tugas yang gagal juga layak dianalisis. Nomor pengguna adalah 555-123-2002, tetapi Agent memilih jalur L1001 dan terus bernalar berdasarkan pemakaian 3,2/5 GB pada jalur itu. Di tengah jalan get_details_by_id(L1001) dengan jelas mengembalikan bahwa nomor jalur tersebut adalah 555-123-2001; Agent membaca hasil itu tetapi tidak mengoreksi penilaiannya, lalu menghabiskan puluhan pesan untuk penelusuran yang tidak relevan dan akhirnya mengalihkan ke agen manusia. Sebenarnya separuh tugas sudah ia selesaikan—ia menuntun pengguna mematikan mode hemat data, dan tindakan di sisi pengguna itu benar-benar terjadi serta diverifikasi lingkungan. Namun salah memilih jalur membuat pengisian 2 GB yang diperlukan tidak pernah dijalankan, dan ketiga asersi keadaan akhir gagal semua. Bentuk kegagalan ini sangat mirip dengan kasus AndroidWorld yang dibahas nanti pada bagian “Atribusi kegagalan”: bukti yang diperlukan untuk mengoreksi penilaian sudah masuk ke konteks, tetapi Agent tidak menelusuri balik berdasarkan bukti itu.
Satu tugas ini saja sudah memunculkan seluruh pertanyaan yang harus dijawab sebuah himpunan evaluasi: apa yang dihitung sebagai keberhasilan, dari mana tugas berasal, siapa yang memverifikasi, dan bagaimana skor diubah menjadi keputusan. Bagian-bagian berikut membahasnya berurutan.
Metrik evaluasi: definisi keberhasilan
Hasil evaluasi pada bagian sebelumnya adalah empat dari lima tugas lolos. Dari angka 0,8 saja kita tidak bisa menilai apakah sistem itu layak pakai. Bila itu adalah Agent layanan pelanggan untuk pengembalian dana, artinya satu dari lima pengguna tidak memperoleh pengembalian yang menjadi haknya; bila itu adalah Agent keamanan untuk berburu kerentanan, empat kena dari lima sudah cukup mengesankan. Bedanya terletak pada seberapa tinggi tingkat keberhasilan yang dituntut skenario bisnisnya.
Keajaiban teknis: batas kemampuan dengan Pass@k
Banyak model dan Agent saat ini masih berada pada tahap yang bisa disebut “keajaiban teknis”. Keajaiban di sini berarti batas atas kemampuan yang diperlihatkan setelah banyak percobaan, anggaran waktu yang longgar, dan penyaringan oleh manusia: cukup satu kali berhasil untuk membuktikan bahwa hal itu pada prinsipnya bisa dilakukan. Itulah persis logika Pass@k — tugas yang sama dijalankan k kali, dan dianggap lulus asalkan setidaknya satu kali lolos; bila keluarannya berupa skor kontinu, diambil yang terbaik dan disebut Best@k.
Pembahasan Anthropic tentang Agent yang berjalan lama menggambarkan batas atas semacam ini: membiarkan Agent bekerja mandiri selama seminggu untuk menulis kompiler C dari nol; menyuruhnya terus menjelajah sampai menemukan contoh tandingan bagi sebuah konjektur matematis penting; atau memeriksa perangkat lunak sumber terbuka berulang-ulang sampai tersingkap celah keamanan serius yang sudah bertahun-tahun ada di sana.
Dalam penjelajahan teknis dan ilmiah semacam ini, yang dipertontonkan biasanya bukan “selalu benar setiap kali”, melainkan satu lintasan terobosan yang akhirnya muncul setelah anggaran penjelajahan direntangkan cukup jauh. Untuk penemuan ilmiah, perburuan celah, dan penciptaan terbuka, batas atas itu sendiri sudah berharga: manusia dapat memilih satu lintasan terbaik dari k kandidat.
Selain lab model dasar, banyak perusahaan aplikasi juga memakai strategi “keajaiban teknis”. Manus menarik perhatian luas karena menyodorkan sebuah komputer virtual: orang-orang yang sebelumnya tak punya gambaran konkret tentang Agent menyaksikan bahwa AI bisa mengoperasikan komputer layaknya manusia, bekerja setengah jam bahkan sejam penuh, dan menuntaskan tugas rumit selangkah demi selangkah.
OpenClaw membuat banyak orang untuk pertama kalinya merasakan “kesan hidup” dari sebuah Agent. Pengguna menugaskan pekerjaan lewat aplikasi pesan instan persis seperti kepada orang sungguhan; ia dapat mengakses seluruh berkas di komputer serta layanan daring, pada tahap tertentu berinisiatif melapor atau meminta informasi tambahan, bahkan bisa membangunkan dirinya sendiri untuk memeriksa dan menangani surel.
Manus dan OpenClaw awal tidak punya tingkat keberhasilan tinggi pada tugas rumit, dan biaya token-nya pun sangat besar. Namun karena kerangka Agent ini bersifat serbaguna, ketika dipasangkan dengan model terkuat, tugas rumit kerap memperoleh Pass@k yang tinggi sehingga memperlihatkan batas atas teknis yang tinggi. Tersebarnya “keajaiban teknis” itu secara masif di media sosial menjadi kunci keberhasilan produk-produk ini.
Keandalan bisnis: Pass^k
Bisnis nyata biasanya lebih peduli pada hal sebaliknya: tidak boleh salah satu kali pun dalam sekian percobaan. Sasaran ini kami sebut Pass^k (dibaca Pass consecutive k): tugas yang sama dijalankan k kali berturut-turut, setiap kali harus lolos, dan tidak boleh memicu butir veto apa pun soal keamanan, kepatuhan, atau halusinasi. Ia menjawab “apakah Agent sanggup mengantar hasil secara stabil dan andal”, bukan “apakah ia sesekali bisa membuat keajaiban”.
Bila tiap kali jalan saling bebas dan tingkat keberhasilan sekali jalan adalah p, hubungan kedua metrik itu gamblang:
Pass@k=1−(1−p)k,Passk=pk.
Misalnya pada p=0.6 dan k=5: Pass@5 =1−0.45≈99.0%, seolah-olah “berhasil setidaknya sekali” hampir selalu tercapai; tetapi Pass consecutive@5 =0.65≈7.8%, yang menunjukkan lima kali beruntun tanpa cela masih sulit. Angka pertama cocok untuk mengukur langit-langit kemampuan saat penjelajahan; hanya angka kedua yang mendekati tuntutan keandalan pada pembayaran, pengembalian dana, perubahan hak akses, dan penggelaran produksi.
Laporan evaluasi wajib menuliskan dengan jelas apa arti k percobaan itu: k pengambilan sampel independen atas tugas yang sama, atau k tugas berurutan pada jalur produksi. Untuk operasi yang menimbulkan efek samping, tidak boleh sekadar “ulangi sampai berhasil”; ambil sampel di sandbox atau lingkungan yang bisa di-rollback, dan catat setiap kegagalan ke dalam metrik keandalan.
Lingkungan evaluasi
Setelah dasar metriknya jelas, pertanyaan berikutnya adalah di mana mengukurnya. Lingkungan evaluasi adalah perangkat yang dapat dijalankan berulang: dengan keadaan awal yang sama, Agent yang sama semestinya menghasilkan hasil yang sebanding.
Lima komponen penyusun
Mari kembali ke tugas telecom yang tadi dibedah. Dengan menjadikannya rujukan, semua yang dibutuhkan sebuah lingkungan evaluasi yang dapat dijalankan berulang sudah lengkap.
Himpunan data (Dataset) adalah berkas tugas itu sendiri: keadaan awal, tiket untuk Agent, panduan perilaku untuk simulator, dan kriteria penerimaan dikemas menjadi satu rekaman, dan satu rekaman adalah satu kasus uji.
Keadaan lingkungan (Environment State) adalah informasi yang berubah selama tugas berjalan: pelanggan, jalur, paket, dan tagihan di basis data, ditambah mode pesawat, roaming, sakelar hemat data, dan sisa kuota di sisi perangkat. Ia harus dapat direset, dan initialization_actions adalah skrip resetnya. Kenyataan menuntut perubahan keadaan mengikuti logika bisnis; keterkendalian menuntut kita bisa kembali ke titik awal yang sama sebelum tiap eksekusi.
Antarmuka tool (Tools) terbagi ke dua sisi. Agent dapat memanggil operasi di sisi operator seperti menelusuri pelanggan, menelusuri pemakaian, mengisi kuota, dan mengalihkan ke agen manusia; pengguna dapat mengoperasikan berbagai sakelar di perangkatnya. Kedua perangkat tool bersifat atomik dan tidak ada abstraksi tingkat tinggi semacam “selesaikan masalah internet pengguna”—tingkat abstraksi yang terlalu tinggi menurunkan evaluasi menjadi pemeriksaan satu pemanggilan fungsi, sementara perencanaan dan penalaran terserap ke dalam tool itu sendiri.
Kriteria penilaian (Rubric) adalah empat lapis pemeriksaan pada evaluation_criteria ditambah aturan agregasi reward_basis.
Protokol eksekusi (Interaction Protocol) menetapkan urutan interaksi dan syarat berhenti. Di sini sinyal berhenti normal adalah pengguna simulasi mengeluarkan ###STOP###; selain itu ada batas jumlah giliran, dan pengguna simulasi bisa menyudahi percakapan sendiri karena kehabisan kesabaran—efisiensi komunikasi yang terlalu rendah dengan sendirinya dihitung sebagai kegagalan.
Kurang satu saja dari kelima komponen ini, evaluasi tidak lagi membentuk lingkaran yang dapat diulang. Ketika membahas benchmark lain di bawah, kelima butir ini tetap menjadi kerangka pembanding.
Lingkungan evaluasi tipe interaksi manusia-komputer dan tipe pemanggilan tool
Tugas seperti telecom wajib punya lawan bicara, sehingga bagian simulasi pengguna dari kelima komponen itu tak tergantikan. Ada pula satu kelas besar tugas lain yang sama sekali tidak punya lawan bicara: pada pembuatan kode, analisis data, dan penyelesaian soal matematika, Agent dari awal sampai akhir hanya berinteraksi dengan tool, kebenarannya ditentukan oleh lolos tidaknya verifikasi eksekusi, dan tidak diperlukan anotasi manusia maupun penilaian model. Lingkungan semacam ini meniadakan simulator pengguna; empat komponen sisanya tetap ada, hanya bentuknya lebih sederhana: keadaan lingkungan berupa sistem berkas atau basis data, kriteria penilaian berupa sepotong kode uji, dan protokol eksekusi menyusut menjadi “terus memanggil tool sampai memberi jawaban atau kehabisan giliran”.
Framework Verifiers melapisi lingkungan semacam ini berdasarkan dua dimensi: apakah tugas perlu mempertahankan keadaan antargiliran, dan apakah perlu isolasi. SingleTurnEnv cocok untuk memberi satu soal matematika lalu langsung memverifikasi jawabannya; ToolEnv cocok untuk mencari beberapa halaman web lalu menjawab secara ringkas dan memverifikasi hasil akhirnya; StatefulToolEnv cocok untuk mengubah rekaman basis data lalu memverifikasi perubahan keadaan; SandboxEnv cocok untuk menjalankan kode di sandbox lalu memeriksa berkas keluaran. Tabel 7-1 merangkum keempat tipe ini agar mudah dipilih menurut kebutuhan keadaan tugas, pemanggilan tool, dan isolasi.
Tabel 7-1 Perbandingan tipe lingkungan Verifiers
Tipe lingkungan
Mempertahankan keadaan
Pemanggilan tool
Kasus penggunaan khas
SingleTurnEnv
Tidak
Tidak
Tanya jawab satu giliran, soal matematika
ToolEnv
Tidak
Multi-giliran
Pencarian + sintesis informasi
StatefulToolEnv
Ya
Multi-giliran
Mengubah rekaman basis data
SandboxEnv
Ya + terisolasi
Multi-giliran
Eksekusi kode dan pengujian
Framework ini mendukung sampling paralel dan cache trajectory; trajectory lengkap tiap evaluasi (observasi, tindakan, imbalan) disimpan sehingga mudah dianalisis dan diputar ulang. Selain itu, efek eksekusi sebuah tool bergantung pada keadaan saat itu, sehingga ketika gagal sebaiknya dikembalikan pesan kesalahan yang jelas, bukan sekadar penanda gagal, agar Agent dapat menyesuaikan strateginya.
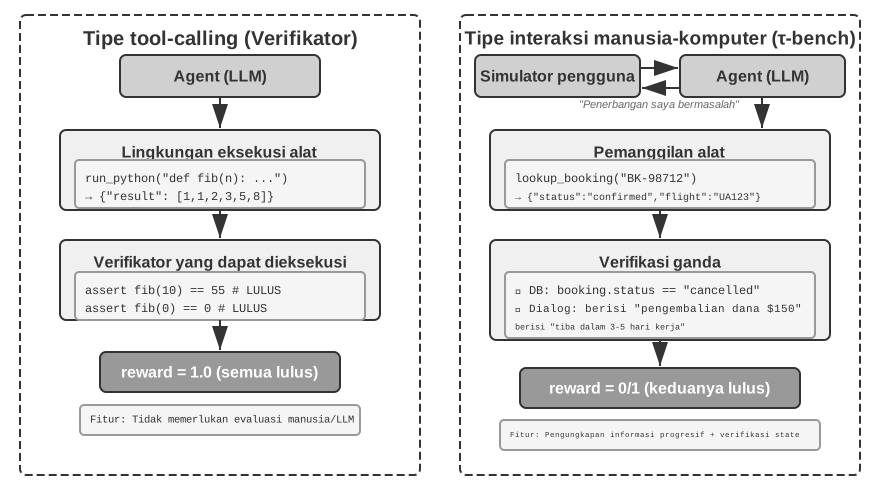
Evaluasi tipe pemanggilan tool menguji kebenaran perubahan keadaan yang dapat diamati, sedangkan evaluasi tipe interaksi manusia-komputer menguji kelayakan strategi komunikasi—yang pertama memverifikasi tindakan, yang kedua memverifikasi penuntunan. Perbandingan struktur kedua tipe lingkungan dapat dilihat pada Gambar 7-2.
Gambar 7-2: Lingkungan Evaluasi Pemanggilan Tool dan Interaksi Manusia-Komputer · Gambar sumber
Desain himpunan data evaluasi
Jika lingkungan evaluasi adalah panggung, himpunan data adalah naskahnya. Dengan lima komponen yang sama, mengganti kelas tugas bisa membuat cara pengisiannya berbeda sama sekali: dari mana tugas berasal, sedalam apa verifier dapat memeriksa, dan bagaimana mencegahnya dihafal. Bagian ini berangkat dari praktik desain beberapa benchmark publik dan berakhir pada pertanyaan yang lebih praktis—dari mana seharusnya tugas dalam himpunan evaluasi buatan sendiri berasal.
Perbandingan menyilang keputusan desain antarbenchmark
Ada atau tidaknya lawan bicara, yang dibedakan pada bagian sebelumnya, hanyalah lapis perbedaan pertama pada tataran lingkungan; perbedaan pada tataran himpunan data lebih menunjukkan pertukaran desainnya. Tabel 7-2 menyandingkan beberapa benchmark yang sering dikutip.
Tabel 7-2 Keputusan desain kunci beberapa benchmark Agent
Benchmark
Kemampuan yang diuji
Asal tugas
Pemeran lingkungan
Verifier
τ²-bench
Interaksi manusia-komputer dan pemanggilan tool pada layanan pelanggan
Ditulis manual + pembangkitan kombinatorial
Simulator pengguna + basis data bisnis
Empat lapis pemeriksaan diagregasi menjadi biner oleh reward_basis
SWE-bench Verified
Pengembangan perangkat lunak, coding
Issue nyata GitHub, disaring manual
Repositori kode + suite uji
Verifikasi ganda FAIL_TO_PASS / PASS_TO_PASS
AndroidWorld
Mengoperasikan GUI ponsel Android
Instansiasi templat berparameter
Emulator Android sungguhan
Asersi keadaan akhir UI
OSWorld
Mengoperasikan GUI desktop Linux
Mulai dari keadaan tengah yang disiapkan
Mesin virtual sungguhan
134 fungsi evaluasi mandiri
Terminal-Bench
Mengoperasikan terminal Linux, coding
Ditulis manual
Kontainer Docker
Pemeriksaan sistem berkas + eksekusi nyata
GAIA
Asisten AI umum yang mengumpulkan informasi
Ditulis manual + lampiran khusus
Internet terbuka
Pencocokan string persis
Verifier
Agent dengan mudah menulis laporan panjang lebar yang menyatakan tugas sudah selesai seluruhnya, padahal kenyataannya sama sekali belum. Kerangka evaluasi harus memverifikasi fakta yang bisa diperiksa mesin secara mandiri, bukan pernyataan Agent tentang dirinya sendiri.
SWE-bench Verified menguraikan “perbaikan selesai” menjadi dua proposisi mandiri. Yang satu adalah FAIL_TO_PASS: gagal sebelum diperbaiki dan lolos sesudahnya, yang membuktikan masalahnya memang terselesaikan. Yang lain adalah PASS_TO_PASS: lolos baik sebelum maupun sesudah, yang membuktikan tidak ada cacat baru yang masuk. Bila hanya yang pertama diperiksa, Agent bisa lolos dengan menghapus atau mengubah asersi yang menghalangi; bila hanya yang kedua, sama saja dengan tidak memeriksa. Hanya dengan memeriksa keduanya, “sudah diperbaiki” dan “tidak merusak apa pun” menjadi dua kesimpulan yang masing-masing dapat dibuktikan. Ia juga memastikan kestabilan uji itu sendiri, menyingkirkan uji tidak stabil (flaky test) yang kadang lolos kadang gagal.
Verifier OSWorld mampu menemukan keadaan yang tampak selesai tetapi sebenarnya keliru. Ia dilengkapi 134 fungsi evaluasi mandiri dan hak akses penuh ke sistem operasi, sehingga dapat memeriksa struktur sistem berkas, keadaan proses, koneksi jaringan, dan keadaan internal aplikasi. Pada tugas basis data, skrip evaluasi tidak hanya memastikan berkas laporan ada, tetapi juga menyambung ke basis data untuk memastikan SQL benar-benar dijalankan; pada tugas peramban ia mengurai pohon DOM, memeriksa cookie dan localStorage, serta mengirim permintaan verifikasi ke backend untuk memastikan formulirnya benar-benar berlaku.
Tugas build-linux-kernel-qemu pada Terminal-Bench menuntut kernel Linux 6.9 dibangun dari sumber, menambahkan printk kustom di start_kernel, membuat initramfs, dan menjalankannya di QEMU; kriteria keberhasilannya adalah munculnya pesan kustom itu di log boot. Agent tidak bisa memalsukan keluaran—ia harus benar-benar menuntaskan seluruh prosesnya.
Pembagian tingkat kesulitan tugas
Himpunan tugas evaluasi perlu memuat tugas dengan tingkat kesulitan berbeda. Dengan begitu, ketika kemampuan model meningkat, himpunan tugas evaluasi tidak cepat usang.
Seluruh 466 soal GAIA dibagi menjadi tiga tingkat kesulitan: Level 1 cukup dengan satu atau dua tool (manusia 93,9%, GPT-4 30,3%), Level 2 menuntut penalaran bertahap (91,8% berbanding 9,7%), dan Level 3 menuntut komposisi rumit (87,3% berbanding 0%). Pelapisan ini bukan sekadar menandai kesulitan, tetapi juga bernilai diagnostik: kegagalan di Level 1 menunjuk pada penggunaan tool dasar, Level 2 pada perencanaan bertahap dan pemaduan informasi, dan Level 3 pada penalaran runtun panjang dan pengelolaan kerumitan, dan ketiganya mengarah ke arah perbaikan yang berlainan.
Terminal-Bench mencakup mulai dari pendaftaran model mlflow yang sederhana, pembobolan kata sandi 7z berkesulitan menengah, integrasi banyak komponen server git dan webserver yang sulit, sampai analisis sandi diferensial FEAL yang paling berat.
τ²-bench bahkan merancang khusus tugas jebakan: pengguna mengaku “layanan pelanggan sudah menyetujui pembatalan” padahal sebenarnya tidak sesuai kebijakan, untuk menguji apakah Agent tetap menjaga penilaian yang benar di bawah tekanan dan penyesatan.
Pencegahan kebocoran data
GAIA membuat jawabannya tidak dapat dicari langsung di internet. Tugasnya sederhana secara konsep tetapi jalannya terbuka: misalnya, berangkat dari Astronomy Picture of the Day NASA pada tanggal tertentu, mengenali astronaut dalam foto, mencari kelompok astronaut tempatnya bernaung, menghitung siapa dari kelompok itu yang paling singkat berada di antariksa, dan mengeluarkannya persis dalam format “nama belakang, dipisahkan titik koma, dengan pemisah ribuan”. Jawabannya sangat spesifik dan benar tidaknya ditentukan oleh pencocokan string persis. Pencegahan kebocoran bersandar pada dua hal: pertama, pertanyaannya hanya terjawab bila beberapa sumber informasi dipadukan sehingga tak ada satu halaman web pun yang langsung memberi jawaban; kedua, sebagian tugas disertai lampiran yang dibuat khusus (PDF, audio, dan gambar yang tidak ada di internet).
AndroidWorld menurunkan banyak instansi dari satu templat. Tugasnya bukan teks statis melainkan templat yang dapat diinstansiasi secara dinamis, misalnya “ubah nomor telepon kontak [CONTACT_NAME] menjadi [NEW_PHONE]”, dengan nilai parameter dibangkitkan acak pada tiap evaluasi. Ini memberi tiga keuntungan: parameter selalu berbeda sehingga memutar ulang urutan operasi yang tetap menjadi sia-sia; satu templat dapat melahirkan instansi yang nyaris tak terbatas; dan dengan mengunci sebagian parameter serta mengubah sisanya, pengaruh satu faktor tertentu dapat diukur dengan tepat.
Terminal-Bench menyisipkan penanda kenari pada teks soal. Tiap soal membawa canary GUID; bila sebuah model mampu mengeluarkan isi yang memuat GUID itu, berarti data benchmark sudah masuk ke himpunan latih. Ini tidak mencegah kebocoran, tetapi membuatnya dapat dideteksi.
Kendali mutu dan pemeliharaan jangka panjang
Membuat himpunan evaluasi bermutu tinggi sangatlah sulit. Bentuk sekarang dari sebagian besar benchmark di atas adalah hasil perbaikan berulang setelah versi pertamanya dipakai dan masalahnya tersingkap. Dari τ-bench ke τ²-bench, misalnya, ada lima tempat yang dirancang ulang.
Pertama, instruksi tugas terlalu umum sehingga jawabannya bisa ditebak. Instruksi versi pertama ditulis luas, sehingga model tak perlu benar-benar menjernihkan permintaan—menebak satu prosedur dari akal sehat saja sudah cukup untuk lolos. τ²-bench membelah naskah menjadi dua ruas, known_info dan task_instructions: yang pertama membatasi apa yang diketahui pengguna, yang kedua mengatur cara pengungkapannya. Apa yang tidak diketahui pengguna tak bisa ditebak Agent dan hanya bisa diperoleh dengan menelusuri.
Kedua, syarat keberhasilan kurang cermat sehingga verifikasi salah menilai. Syarat semacam “jaringan sudah pulih” tidak punya batas yang dapat diperiksa. τ²-bench mengubahnya menjadi “dianggap selesai hanya bila hasil tes kecepatan excellent; poor, fair, dan good semuanya tidak diterima”. Perubahan ini menyasar perbaikan asal jadi, yaitu menekan gejala tanpa menuntaskan akar masalah.
Ketiga, perilaku simulator pengguna terlalu mekanis. Pengguna simulasi versi pertama hanya menjawab secara pasif. τ²-bench menambahkan emosi (menunjukkan ketidakpuasan setelah perbaikan pertama gagal), batas kesabaran (memutus percakapan bila komunikasi terlalu tidak efisien), dan syarat pengaitan fakta. Ketiganya bekerja bersama sehingga simulator mendekati pengguna nyata sambil tetap dapat direproduksi.
Keempat, pengguna tidak hanya terlibat dalam percakapan, tetapi juga dalam pengoperasian. Domain telecom memperkenalkan lingkungan kendali ganda. Pada evaluasi sebelumnya hanya Agent yang dapat mengubah lingkungan, padahal pada skenario dukungan teknis sebagian besar tindakan semestinya dilakukan pengguna sendiri di perangkatnya. Kendali ganda juga menambah satu dimensi pada verifikasi: setelah pengguna mengubah keadaan, Agent harus memanggil tool lagi untuk mengetahui hasilnya, sehingga verifikasi kini mencakup “apakah Agent benar-benar membaca hasil tindakan di sisi pengguna”.
Kelima, instansi tugas dibangkitkan secara dinamis. Instansi konkret τ²-bench (nama pengguna, nomor, kombinasi gangguan) dapat diparameterkan dan dibangkitkan secara massal, yang sekaligus memperbaiki cakupan dan ketahanan terhadap kebocoran.
SWE-bench Verified: sebelum dirilis, 71% tugas aslinya disingkirkan. OpenAI mengambil acak 1.699 dari 2.294 tugas asli untuk dievaluasi manusia, dan merekrut 93 pengembang yang mahir Python untuk memeriksanya satu per satu: apakah deskripsi masalahnya jelas, apakah kasus ujinya mencakup kondisi batas, apakah ujinya stabil, apakah patch rujukan memasukkan kesalahan baru, dan apakah kesulitannya wajar. Pada akhirnya hanya 500 yang lolos. Tingkat penyingkiran yang tinggi menghasilkan rasio sinyal terhadap derau yang lebih baik, dan biaya evaluasi pun turun sekitar 80%. Tugas Agent yang rumit lazimnya butuh beberapa menit sampai beberapa jam, dan menjalankan satu himpunan evaluasi secara penuh dengan model terdepan kerap menelan ribuan dolar biaya token, sehingga menekan biaya evaluasi sangatlah penting.
OSWorld: dalam 15 bulan setelah dirilis muncul lebih dari 300 masalah. Dirilis pada April 2024, ia cepat menjadi benchmark penting bagi evaluasi Agent multimodal, tetapi pemakaian luas berikutnya menyingkap empat jenis masalah: masalah lingkungan (situs yang menangkal scraping, CAPTCHA, perubahan konten dinamis), masalah deskripsi tugas (rumusan yang bermakna ganda), masalah logika verifikasi (terlalu ketat atau terlalu longgar), dan masalah keadaan awal (konfigurasi tidak lengkap). Tim dari Universitas Hong Kong membentuk kelompok sekitar 10 orang dan selama dua bulan bekerja erat dengan MoonShot AI, OpenAI, ByteDance Seed TARS, Anthropic, Simular, dan lainnya untuk memperbaikinya secara sistematis: masalah lingkungan diatasi dengan mengunci versi dan cadangan offline, masalah deskripsi dengan menulis ulang rumusan yang bermakna ganda, masalah verifikasi dengan membangun garis dasar yang benar secara manual lalu menyetel syaratnya, dan masalah keadaan awal dengan menambah pemeriksaan kelengkapan.
Eksperimen 7-2 ★: Mengerjakan tugas benchmark secara manual
Pilih tugas dari GAIA, AndroidWorld, SWE-Bench Verified, Terminal-Bench, dan OSWorld-Verified lalu kerjakan sendiri; disarankan satu mudah, satu sedang, dan satu sulit untuk tiap himpunan data. Tingkat “sulit” pun menantang bagi manusia.
Setelah selesai, jawab dua pertanyaan. Apakah deskripsi tugas itu memuat lebih dari satu tafsir yang masuk akal, dan bila ya, tafsir mana yang diakui verifier? Jika Anda mencoba lolos tanpa benar-benar mengerjakannya, apa jalur termurahnya, dan mampukah verifier menghadangnya?
Tiga asal himpunan evaluasi
Ada pandangan umum bahwa benchmark publik hanya melayani pemeringkatan model dan sedikit kaitannya dengan bisnis nyata. Memang benar skor benchmark publik sulit langsung memandu keputusan produk, tetapi teknik desainnya sangat mudah dipindahkan. Kedalaman verifikasi, pembangkitan berparameter, pencegahan kebocoran, dan pemeliharaan mutu—yang dibahas di atas—justru merupakan bagian yang paling mudah terlewat dalam himpunan evaluasi buatan sendiri.
Himpunan evaluasi di lingkungan produksi biasanya punya tiga asal.
Benchmark publik dipakai untuk penyaringan kasar model dan untuk meminjam teknik desain, dan umumnya bukan untuk keputusan produk. Distribusi tugasnya tidak sama dengan distribusi tugas bisnis nyata; naik dua poin persentase di GAIA tidak berhubungan secara niscaya dengan tingkat keberhasilan pengembalian dana.
Himpunan bisnis buatan sendiri mencakup distribusi tugas yang sebenarnya dan dapat menjadi dasar pemilihan model serta keputusan desain Harness. Misalnya, τ²-bench dapat langsung dipakai sebagai kerangka bagi sistem evaluasi mana pun yang memerlukan pengguna simulasi; cukup ganti data domain dan perangkat toolnya.
Aliran balik trajectory produksi berasal dari kegagalan nyata di lapangan: koreksi eksplisit dari pengguna, penilaian buruk dari pengguna, serta kasus yang ditemukan belakangan lewat pemeriksaan keadaan, verifier berbasis aturan, atau tinjauan LLM. Setelah melalui atribusi kegagalan, semuanya mengendap menjadi kasus regresi. Caranya diuraikan nanti pada bagian “Atribusi kegagalan” dan “Tugas regresi ujung ke ujung dan tugas regresi trajectory prefix”. Asal ini paling mahal sekaligus paling akurat, karena datang langsung dari masalah yang benar-benar dialami pengguna.
Pada tahap awal biasanya hanya ada benchmark publik dan sedikit himpunan bisnis yang ditulis tangan; setelah sistem berjalan beberapa lama di produksi, kasus yang mengalir balik dari trajectory produksi menjadi bagian terbesar.
Metode evaluasi otomatis
Benchmark yang dibahas pada bagian-bagian sebelumnya punya satu kesamaan: verifier-nya hampir semuanya deterministik. SWE-bench menjalankan suite uji, AndroidWorld mengasersi keadaan akhir UI, GAIA melakukan pencocokan string persis, dan empat lapis pemeriksaan τ²-bench pun seluruhnya dijalankan oleh kode. Pilihan ini punya alasan kuat: verifikasi deterministik tidak menambah ongkos model, hasilnya sepenuhnya dapat direproduksi, dapat dimasukkan ke integrasi berkelanjutan seperti uji unit, dan memudahkan pemeringkatan antarmodel.
Harganya, ia hanya dapat menilai benar tidaknya hasil akhir, tetapi tidak dapat memberi sebab kesalahannya. Tugas τ²-bench yang gagal berakhir dengan nilai 0, dan angka 0 itu tidak menjelaskan apakah Agent salah pada tahap pemilihan jalur atau melewatkan langkah pengisian kuota, apalagi menunjukkan apa yang harus diubah berikutnya. Bagi benchmark publik yang dipakai untuk pemeringkatan, ini bukan cacat; bagi sistem produksi yang perlu perbaikan berkelanjutan, justru itulah informasi yang paling dibutuhkan.
Skenario produksi punya kesulitan kedua: banyak penilaian sama sekali tidak dapat ditulis sebagai asersi yang bisa diperiksa kode. Apakah balasan atas keluhan sudah pantas, apakah sebuah laporan riset melewatkan informasi kunci, apakah penelusuran memori salah mengaitkan hubungan antarorang—semua ini tidak punya satu keadaan akhir yang bisa ditelusuri, dan juga tak bisa diputuskan dengan pencocokan kata kunci.
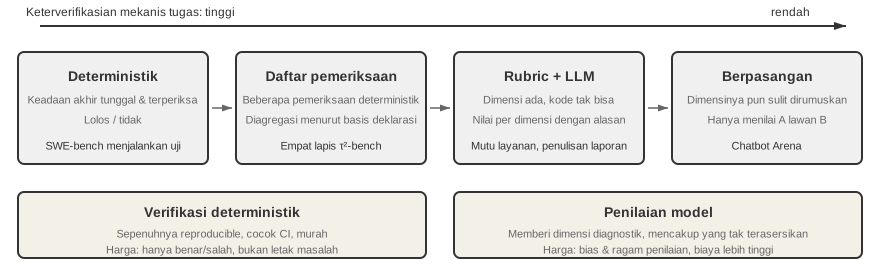
Karena itu, dalam beranjak dari benchmark publik ke evaluasi di lingkungan produksi, cara verifikasi perlu bergeser ke kanan sepanjang satu spektrum yang sumbu mendatarnya adalah derajat keterverifikasian mekanis sebuah tugas, seperti pada Gambar 7-4.
Gambar 7-4: Spektrum cara verifikasi—dari verifikasi deterministik ke penilaian model · Gambar sumber
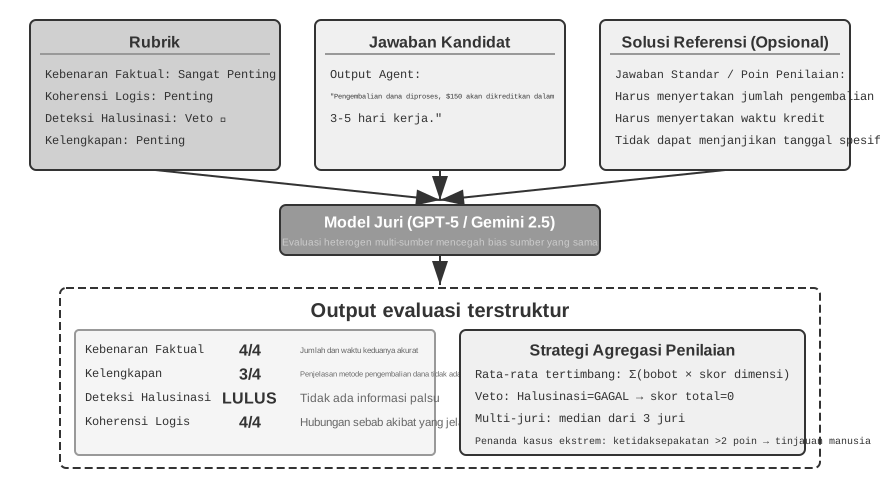
Dua perkakas di sisi kanan spektrum itulah yang kemudian menjadi tumpuan evaluasi produksi: Rubric memecah “bagus atau tidak” yang kabur menjadi beberapa dimensi yang dapat dinilai terpisah, dan LLM-as-a-Judge memberi nilai ketika tidak ada patokan deterministik. Hanya bila keduanya digabung, tingkat kegagalan yang kabur dapat dikembalikan menjadi masalah konkret yang bisa ditangani; dipadukan dengan atribusi kegagalan pada paruh kedua bagian ini, terbentuklah lingkar tertutup evaluasi Agent produksi yang lengkap.
Perlu ditegaskan, bergeser ke kanan tidak berarti meninggalkan sisi kiri. Setiap pemeriksaan yang dapat ditulis sebagai asersi program sebaiknya tetap berupa asersi, dan penilaian LLM hanya dipakai untuk dimensi yang memang tak dapat diputuskan secara mekanis. Pemeriksaan deterministik lebih murah dan lebih stabil, serta lebih cocok dijalankan jangka panjang sebagai uji regresi.
Mengapa LLM-as-a-Judge dibutuhkan? Untuk tugas terbuka (misalnya, membuat laporan, menangani keluhan pelanggan, konten kreatif), tidak ada jawaban standar untuk perbandingan otomatis, dan evaluasi manusia memakan biaya besar serta sulit untuk diskalakan. LLM-as-a-Judge menyeimbangkan skalabilitas otomatisasi dengan penilaian pakar manusia dengan menyuruh model bahasa mengevaluasi output terhadap kriteria penilaian yang ditentukan pakar (sebuah Rubric). Meski begitu, metode ini memiliki keterbatasan yang diketahui: model juri membawa biasnya sendiri (paling umum bias panjang (length bias)—kecenderungan untuk memberi skor lebih tinggi pada tanggapan yang lebih panjang dan lebih detail bahkan ketika mereka tidak lebih benar), dan penilaian berulang dari input yang sama dapat bervariasi. Bias panjang secara khusus memerlukan tindakan pencegahan khusus. Tiga pertahanan umum adalah: hukum (penalize) kata-kata yang berlebihan (verbosity) secara eksplisit dalam Rubric dan batasi panjang tanggapan per jenis tugas; dalam perbandingan berpasangan (pairwise), bawa kedua kandidat ke panjang yang sama sebelum menilai; dan secara teratur mengaudit korelasi antara skor dan panjang tanggapan—jika skor tinggi hampir selalu diberikan pada tanggapan yang panjang, juri telah terpengaruh oleh panjang dan Rubric tersebut memerlukan revisi. Untuk mengatasi tantangan ini secara sistematis, desain Rubric harus mengikuti prinsip-prinsip di bawah ini:
Rubric (Kriteria Penilaian): Dasar untuk Penilaian LLM.
Empat Prinsip Rubric (Scale AI, “Rubrics as Rewards”):
(1) Berdasarkan Panduan Pakar (Based on Expert Guidance)—Sebuah Rubric harus mencerminkan pengetahuan domain, menangkap fakta inti dan langkah-langkah penalaran. Sebuah Rubric untuk tanya jawab (Q&A) medis, misalnya, memerlukan kriteria diagnostik dan kesalahan medis yang harus dihindari; Rubric tanpa dasar kepakaran hanya dapat menangkap fitur permukaan seperti keluwes / mengalir lancaran.
(2) Cakupan Komprehensif (Comprehensive Coverage)—Sebuah Rubric harus mencakup keakuratan faktual, koherensi logis, kelengkapan, dan keselamatan. Ini seharusnya tidak hanya mendefinisikan standar positif tetapi juga secara eksplisit mengidentifikasi Jebakan (Pitfalls)—yakni, kesalahan umum berisiko tinggi, seperti merekomendasikan terapi yang belum diverifikasi dalam saran medis.
(3) Pembobotan Kepentingan Terstandarisasi (Standardized Importance Weighting)—Klasifikasikan kriteria sebagai item Esensial (Essential), Penting (Important), Opsional (Optional), atau Jebakan (Pitfall). Skema ini mendukung mekanisme Veto (Veto mechanism): misalnya, dalam skenario layanan pelanggan, halusinasi (membuat informasi palsu) adalah dimensi veto yang khas—tidak peduli seberapa baik kinerja dimensi lain, jika informasi palsu muncul, itu harus diveto. Ini juga membantu mencegah peretasan reward (reward hacking) melalui penumpukan kata kunci (keyword stuffing).
(4) Evaluasi Mandiri (Self-Contained Evaluation)—Setiap item evaluasi dapat ditindaklanjuti secara independen dan tidak bergantung pada pengetahuan domain evaluator. Standar abstrak seperti “respons menunjukkan pemahaman yang mendalam” harus dihindari, diganti dengan standar yang dapat diverifikasi seperti “mengutip setidaknya dua teori otoritatif dan secara akurat menjelaskan bagaimana keduanya mendukung kesimpulan tersebut.”
Praktik utamanya: tentukan tingkat penilaian yang dapat diverifikasi secara objektif untuk setiap dimensi, dengan contoh nyata dan kasus ekstrem (edge cases) untuk menyelesaikan situasi ambigu. Secara aktif berjaga-jaga dari Peretasan Reward (Reward Hacking)—Agent menemukan “jalan pintas” ke skor tinggi tanpa benar-benar menyelesaikan tugas—dengan secara eksplisit menghukum halusinasi, sikap selalu setuju (sycophancy) (sycophancy), penumpukan kata kunci, dan menghindari pertanyaan sulit. Sebuah Rubric adalah produk iteratif: penggunaan uji coba mengungkap ketidaksepakatan di antara para evaluator, dan Rubric tersebut secara bertahap berevolusi melalui umpan balik ini dari prinsip-prinsip abstrak menjadi buku kasus (casebook) yang mendetail.
Berikut adalah Rubric lengkap yang mengikuti keempat prinsip tersebut, menggunakan Agent User Memory sebagai contoh. Pertanyaan tes: “Siapa dokter anak putri saya?” (Jawabannya membutuhkan pengaitan informasi di dua percakapan: percakapan pertama menyebutkan “nama putri saya adalah Lily,” yang kedua menyebutkan “membawa Lily ke Dr. Chen”).
rubric:
  dimensions:
    - name: Factual Correctness
      weight: essential        # Item esensial
      scoring:
        4_Excellent: "Menjawab Dr. Chen dengan benar, dan mengaitkannya dengan putri Lily"
         3_Good: "Menjawab Dr. Chen dengan benar tetapi tidak menyebutkan bahwa Dr. Chen adalah dokter Lily"
        2_Passable: "Memberikan nama dokter yang benar tetapi dengan informasi tambahan yang tidak pasti"
        1_Fail: "Memberikan nama dokter yang salah, atau menjawab 'Saya tidak tahu'"

    - name: Information Completeness
      weight: important        # Item penting
      scoring:
        4_Excellent: "Secara proaktif menambahkan informasi yang relevan (misalnya, tanggal kunjungan terakhir, diagnosis)"
        3_Good: "Menjawab pertanyaan inti tanpa ada yang terlewat"
        2_Passable: "Menjawab pertanyaan inti tetapi melewatkan informasi terkait yang tersedia"
        1_Fail: "Informasi kunci hilang"

    - name: Reasoning Correctness
      weight: important
      scoring:
        4_Excellent: "Mengaitkan dua potong informasi lintas sesi dengan benar: 'putri=Lily' dan 'dokter Lily=Dr. Chen'"
        3_Good: "Mengaitkan dengan benar tetapi jalur penalarannya kurang jelas"
        2_Passable: "Pengaitan sebagian benar"
        1_Fail: "Pengaitan salah (misalnya, mengira dokter pengguna sendiri sebagai dokter putrinya)"

    - name: Hallucination Detection
      weight: veto             # Item veto: sekali terpicu, skor total menjadi nol
      scoring:
        pass: "Semua informasi dapat dilacak kembali ke riwayat rekaman percakapan"
        fail: "Informasi yang dibuat-buat tidak ada dalam percakapan (misalnya, tanggal kunjungan fiktif, diagnosis)"

  edge_cases:
    - "Jika pengguna memiliki beberapa putri yang mengunjungi dokter berbeda, harus menanyakan putri yang mana"
    - "Jika memori mengandung 'Dr. Chen' dan '陈医生' (nama yang sama ditulis dalam bahasa Mandarin), harus mengenali mereka sebagai orang yang sama"
Rubric yang Baik vs. Rubric yang Buruk: Setiap tingkat penilaian di atas menetapkan perilaku yang dapat diverifikasi dan konkret (“Menjawab Dr. Chen dengan benar”) alih-alih deskripsi yang tidak dapat dinilai secara objektif, seperti “menunjukkan pemahaman memori yang mendalam.” Item veto menetapkan batas bawah: bahkan jika setiap dimensi lain mendapat nilai penuh, satu contoh halusinasi akan secara otomatis menghasilkan nilai nol.
Kirim Rubric bersama respons aktual Agent ke model penilai untuk memperoleh skor dan alasan per dimensi. Setelah puluhan hasil dikumpulkan, putar ulang jejak yang nilainya rendah. Penurunan tingkat keberhasilan yang semula samar lalu dapat dipecah menjadi diagnosis konkret: informasi tidak ditemukan, hubungan antartokoh keliru, atau jawaban menambahkan hal yang tidak didukung data. Dengan demikian Rubric bukan hanya memberi nilai, tetapi juga menunjukkan bagian yang perlu diperbaiki.
Berikut ini memakai memori pengguna sebagai kasus konkret, untuk menunjukkan bagaimana metode umum ini diturunkan menjadi set evaluasi dan verifier yang dapat dijalankan.
Eksperimen 7-3 ★★: Membangun Sistem Evaluasi User Memory Berbasis Rubric
Prasyarat: Harus menyelesaikan Eksperimen User Memory Bab 3 (chapter3/user-memory-evaluation).
Eksperimen ini mengharuskan modifikasi kerangka kerja chapter3/user-memory-evaluation dari Bab 3, meningkatkan mekanisme penilaian LLM-as-a-Judge sederhana saat ini ke sistem evaluasi Rubric multi-dimensi yang terstruktur. Sistem yang ada menggunakan panggilan LLM tunggal untuk mengembalikan hasil lulus/gagal beserta penalaran evaluasi, sehingga kurang memiliki kemampuan diagnostik terstruktur.
Rancang kerangka kerja Rubric multi-dimensi terpadu yang dapat diterapkan pada ketiga tingkat tugas. Dimensi evaluasi meliputi: Factual Correctness (presisi: dari semua informasi yang diberikan, berapa banyak yang benar—memverifikasi bahwa angka/tanggal/nama konsisten dengan memori yang disimpan); Information Completeness (recall: dari semua informasi yang seharusnya diberikan, berapa banyak yang disebutkan—memverifikasi bahwa semua informasi relevan disediakan tanpa ada konten kunci yang terlewat); Reasoning Correctness (memeriksa apakah hubungan antara potongan informasi dan logika implisit dipahami dengan benar); Reasoning Proactiveness (mengevaluasi apakah saran atau peringatan risiko di luar jawaban langsung diberikan ketika dirasa tepat); Hallucination Detection (memastikan tidak ada informasi yang tidak ada di memori yang dibuat-buat).
Penilaian empat tingkat (Excellent/Good/Passable/Fail), dengan kriteria penilaian spesifik untuk setiap tingkat alih-alih deskripsi abstrak. Dimensi halusinasi adalah item veto. Berikan contoh dan kasus batas untuk setiap dimensi.
Eksperimen 7-4 ★★: Evaluasi Komparatif antara Advanced JSON Cards vs. RAG
Prasyarat: Harus menyelesaikan eksperimen User Memory dan RAG Bab 3 (chapter3/user-memory, chapter3/agentic-rag-for-user-memory).
Tujuan: Membandingkan secara adil kapan memori terstruktur dan penarikan tidak terstruktur bekerja lebih baik pada set evaluasi yang sama. Gunakan kembali dua proyek Bab 3 dan bandingkan tiga konfigurasi pada 60 kasus uji dari chapter3/user-memory-evaluation: Advanced JSON Cards saja, RAG saja, serta sistem hybrid dengan fakta inti tetap berada di konteks dan percakapan asli ditarik saat diperlukan.
Kriteria Penerimaan: Catat tingkat keberhasilan, rata-rata langkah, jumlah pemanggilan tool (tool calls), latensi, dan biaya di tiga tingkat kompleksitas (penarikan dasar / disambiguasi multi-sesi / asosiasi tersembunyi lintas sesi). Jelaskan dengan jelas batasan kegagalan untuk setiap pendekatan—apa yang dilewatkan oleh memori terstruktur, apa yang dilewatkan oleh penarikan, dan apakah sistem hybrid benar-benar mencapai sinergi. Detail konfigurasi dan kasus uji tersedia di repositori pendamping.
Eksperimen pendamping menguji ketiga sistem dengan 60 pertanyaan yang sama dan menyimpan 180 jejak pemanggilan API nyata. Tabel 7-3 mencantumkan jumlah soal yang berhasil di samping persentase keseluruhan agar ukuran sampelnya tetap terlihat.
Tabel 7-3 Tingkat keberhasilan tiga sistem memori menurut tingkat kesulitan
Sistem
Ingatan dasar
Disambiguasi multi-sesi
Hubungan tersembunyi lintas sesi
Keseluruhan
Advanced JSON Cards
95%
60%
50%
68.3% (41/60)
RAG
90%
40%
15%
48.3% (29/60)
Hybrid
80%
70%
50%
66.7% (40/60)
Yang paling patut dicatat, solusi hibrida tidak menang dengan sendirinya. Pada 3 soal ia melakukan apa yang tak sanggup dilakukan kedua solusi tunggal, tetapi pada 8 soal lain ia kalah dari solusi tunggal yang lebih baik; dibanding solusi tunggal terbaik pada tiap soal, rata-rata tingkat keberhasilannya justru lebih rendah. RAG murni tak jauh berbeda dari kartu terstruktur pada soal recall dasar, tetapi begitu masuk soal keterkaitan lintas sesi, tingkat keberhasilannya jatuh ke 15%. Satu angka lain yang mudah terlewat: dari 180 penilaian, veto halusinasi terpicu 28 kali—terlihat betapa pentingnya sebuah butir veto mutlak.
Masalah Model Satu Keluarga dan Penilaian Multi-Sumber (Multi-Source Judging).
Ketika Agent dan model penilai berasal dari keluarga yang sama, Agent mungkin belajar untuk mengeksploitasi preferensi dan titik buta (blind spots) model penilai tersebut.
Ini persis seperti yang dinyatakan oleh Hukum Goodhart: ketika sebuah metrik menjadi target optimalisasi, ia berhenti menjadi metrik yang baik. Semakin banyak Agent dilatih atau disesuaikan dengan sistem penilaian tertentu, semakin ia cenderung mengeksploitasi celah dalam sistem tersebut alih-alih benar-benar meningkatkan kemampuannya.
Lebih berbahayanya lagi, Agent secara bertahap akan belajar untuk menghindari jenis kesalahan yang tidak pandai dideteksi oleh model penilai, sehingga membuat sistem penilaian tampak baik-baik saja.
Mitigasinya adalah multi-source heterogeneous judging (penilaian heterogen multi-sumber)—penilai independen yang diambil dari keluarga model yang berbeda (jika Agent berjalan di Claude, nilai dengan GPT-5 dan Gemini). Bias dari keluarga yang berbeda seringkali ortogonal, sehingga Agent jarang bisa mengelabui semua penilai secara bersamaan. Gunakan Rubric yang sama agar semuanya menilai target yang sama, dan kumpulkan dengan rata-rata tertimbang atau pemeriksaan konsistensi. Dalam penerapan (deployment), satu model dapat menangani evaluasi yang cepat, dengan audit kualitas berkala yang dijalankan terhadap penyiapan multi-sumber secara penuh.
Penilaian multi-sumber mengatasi pertanyaan tentang model mana yang harus berfungsi sebagai penilai; pertanyaan selanjutnya adalah modalitas mana yang harus dievaluasi—memperluas LLM-as-a-Judge dari teks ke suara, gambar, dan video adalah poros lain dari cakupan evaluasi.
Multimodal LLM-as-a-Judge.
Penilaian multimodal memperluas LLM-as-a-Judge ke ranah suara, gambar, dan video. Empat arah umumnya adalah sebagai berikut.
Evaluasi TTS (TTS kependekan dari Text-to-Speech): Menilai akurasi, kealamian, konsistensi suara, dan ekspresi emosional. Dimensi-dimensi ini dapat menangkap masalah prosodi yang sulit dideteksi oleh WER (Word Error Rate) tradisional.
Evaluasi ASR (ASR kependekan dari Automatic Speech Recognition): Melakukan penilaian dampak semantik—salah mengenali “cuaca hari ini” tidak berbahaya, tetapi salah mengenali “transfer seribu” menjadi “sepuluh ribu” dapat memiliki konsekuensi serius.
Evaluasi UI: Menggunakan mekanisme Proposer-Reviewer untuk memeriksa masalah seperti teks meluber (text overflow), kontras warna, dan penempatan tombol. Di sini, proposer-reviewer digunakan sebagai metode evaluasi, berbeda dari penggunaannya sebagai komponen sistem generasi pada Bab 5, tetapi mekanisme intinya sama—satu model menghasilkan, model yang lain meninjau secara independen.
Evaluasi Pengeditan Video: Memverifikasi ketepatan titik awal/akhir klip dan penerapan efek melalui keyframe.
Eksperimen 7-5 ★★: Membangun Pipeline Evaluasi Kualitas TTS yang Sepenuhnya Otomatis
Eksperimen ini mengharuskan perancangan dan implementasi sistem evaluasi kualitas TTS LLM-as-a-Judge multimodal yang lengkap dari awal.
Rancang Rubric TTS multi-dimensi: Dimensi Accuracy memverifikasi apakah semua teks dibaca dengan benar (tanpa penghilangan/salah baca/penambahan); dimensi Naturalness menilai apakah suara terdengar alami dan bukan seperti robot, tidak ada jeda yang tidak wajar, dan menggunakan prosodi alami; dimensi Emotional Expression memeriksa apakah nada cocok dengan nada emosional teks (intonasi naik untuk pertanyaan, penekanan untuk seruan, langkah lebih lambat dan nada lebih rendah untuk konten sedih); dimensi Voice Consistency mengevaluasi kemiripan pembicara ketika suara referensi tersedia (model multimodal secara bersamaan menerima suara referensi dan suara yang disintesis untuk perbandingan).
Bangun korpus yang bervariasi dalam panjang, genre, emosi, angka, nama diri, kata berpelafalan ambigu, dan dialek. Modul TTS dapat terhubung ke OpenAI, ElevenLabs, Fish Audio, Minimax, atau Doubao. Model penilai multimodal yang menerima audio menilai suara sintetis, teks asli, suara referensi, dan Rubric secara bersamaan. Selain menganalisis distribusi per dimensi, simpan nama model penilai serta hash audio referensi dan setiap kandidat agar hasil dapat diaudit.
Repositori menyimpan pilot kecil dengan penilaian audio langsung. OpenAI dan Fish Audio masing-masing menghasilkan empat sampel—angka, pelafalan ambigu, kalimat panjang, dan nada bersemangat—lalu Voxtral menilai kedelapan audio pada empat dimensi di atas. Keduanya memperoleh 5.00 untuk akurasi dan 4.00 untuk kealamian. Untuk ekspresi emosi dan konsistensi suara, Fish Audio mendapat 4.00 dan 3.00, sedangkan OpenAI 3.75 dan 2.75. Memisahkan dimensi memperlihatkan perbedaan nada dan suara meskipun keduanya sama-sama membaca teks dengan benar.
Delapan sampel belum cukup untuk menentukan layanan yang lebih baik. Selain hanya empat sampel per layanan, audio referensi tetap dibuat dengan Fish S1 sehingga perbandingan kemiripan suara sejak awal menguntungkan Fish Audio. Untuk membandingkan TTS umum, kemiripan dengan suara Fish tidak boleh masuk skor total. Untuk membandingkan kloning suara, semua sistem harus meniru pembicara target yang sama dan skor model perlu dikalibrasi dengan uji dengar manusia secara buta. Pemilihan jawaban, gambar, atau audio referensi adalah bagian dari desain evaluasi, bukan persiapan netral sebelum evaluasi.
Rubric buatan manusia cocok untuk membangun dimensi diagnostik ini dengan cepat. Pada skala lebih besar, model hadiah generatif dapat dilatih untuk mengotomatisasi penilaian; Bab 8 membahas metode pelatihannya.
Skor yang diberikan model penilai hanya menyatakan hasilnya baik atau buruk; untuk mengubah hasil itu menjadi masalah yang dapat diperbaiki, kita masih perlu menemukan dari langkah mana kegagalannya sebenarnya bermula.
Atribusi kegagalan: Melacak kesalahan pertama dalam trajectory
Evaluasi end-to-end sering hanya memberi “lulus” atau “gagal”. Agar hasilnya memandu perbaikan, catat kategori, langkah pertama yang tidak dapat diterima, tool call atau output model terkait, dan bukti yang dapat diaudit untuk setiap trajectory gagal. Bad case biasanya datang dari koreksi eksplisit pengguna, feedback negatif, atau pemeriksaan status/aturan setelah kejadian. LLM dapat membantu, tetapi pembacaan manusia tetap penting karena akar masalah sering berada pada produk, bukan sekadar bug teknis.
Untuk Coding Agent, taksonomi awal mencakup proses atau aturan yang terlewat, kesalahan tool/format, terminasi model yang abnormal, serta masalah logika atau kelengkapan. Simpan catatan JSON/YAML terstruktur berisi nomor langkah, tool, observasi, akar penyebab versus konsekuensi, kemampuan pemulihan, dan confidence bersama state, versi, dan trajectory lengkap.
Membangun sistem atribusi kegagalan menuntut pengembang membaca dan menganalisis trace bermasalah dari produksi dengan sabar. LLM bisa membantu, tetapi tak bisa menggantikan manusia, sebab atribusi kegagalan kerap menyingkap masalah produk, bukan sekadar masalah teknis.
Seiring produk makin matang, taksonomi galat bisa memuat beberapa kelas besar, masing-masing dengan subkelas, hingga akhirnya mencapai ratusan jenis. Kelas-kelas itu berikut cara atribusinya kemudian menjadi prompt atau Skill bagi Agent penganotasi atribusi.
Dengan Coding Agent sebagai contoh, taksonomi awal yang layak pakai tampak seperti ini.
Kelas galat
Gejala khas
Cara menemukan galat pertama
Pemahaman kebutuhan dan ambiguitas
Yang dibuat bukan yang diminta pengguna: satu syarat dalam kebutuhan terlewat, atau cakupan dibaca terlalu luas/terlalu sempit; ketika repositori punya dua berkas konfigurasi bernama sama, salah satu dipilih begitu saja tanpa penjelasan maupun pertanyaan
Pakai LLM untuk menyandingkan kebutuhan asli dengan apa yang benar-benar dikerjakan Agent (urutan aksi), butir demi butir; temukan simpangan pertama di tataran hasil, lalu telusuri balik ke pemanggilan tool atau kalimat jawaban yang menyebabkannya
Proses atau konvensi terlewat
Commit tanpa menjalankan unit test; menyunting kode sebelum menulis Plan; menarik dependensi luar padahal repositori sudah punya padanan internal; menerobos konvensi arsitektur yang sudah ditetapkan
Cari aksi pertama yang melanggar konvensi proses pengembangan — git commit pertama, penulisan berkas pertama — lalu periksa apakah sebelumnya ia sempat membaca sumber konvensi itu
Galat pemanggilan tool
Penyuntingan berkas yang sama gagal berulang kali; format JSON/schema atau argumen keliru; karakter khusus merusak penyalinan, escaping, atau penulisan
Catat penyuntingan/tool pertama yang gagal beserta permintaan asli dan galat yang dikembalikan; kegagalan berulang adalah gejala lanjutan
Meretas lingkungan verifikasi
Menyunting assertion, menambah skip, menge-mock logika yang sedang diuji; menyatakan “tes lulus” padahal tak pernah dijalankan
Ambil message pertama yang mengubah tes atau logika verifikasi; lalu sandingkan pernyataan selesai dengan perintah yang benar-benar dijalankan di trace untuk memastikan ia sungguh menjalankannya
Perubahan tidak tuntas
Tanda tangan fungsi diubah dan tiga titik pemanggilan diperbarui, tetapi yang keempat — panggilan dinamis, binding di bahasa lain, atau schema — terlewat
Hitung selisih himpunan antara cakupan dampak yang diklaim Agent dan yang sebenarnya, ambil kelalaian pertama, lalu tengok kata kunci apa yang ia pakai saat mencari
Informasi salah dilaporkan ke pengguna
Pemanggilan tool dan keadaan akhir semuanya benar, tetapi yang disampaikan ke pengguna tidak: nominal, status, atau waktu keliru; yang baru sebagian dikatakan tuntas; hal yang wajib diberitahukan terlewat
Sandingkan setiap klaim faktual dalam jawaban dengan nilai balik tool, lalu ambil klaim pertama yang tak bisa ditelusuri atau yang bertentangan dengan nilai balik
Regresi non-fungsional
API publik atau schema berubah tanpa skrip migrasi; validasi dihapus supaya pemeriksaan lolos
Ambil message pertama yang melakukan perubahan itu, lalu lihat apakah ia sadar sedang menyentuh antarmuka publik atau struktur yang butuh migrasi
Terminasi model tak normal
Keluaran terpotong di tengah, berhenti tanpa sebab, kehabisan waktu, atau berakhir tanpa aksi penutup
Temukan terminasi tak normal yang pertama, lalu pisahkan antara model berhenti, Harness timeout, dan gangguan layanan tool
Menghentikan tugas terlalu dini
Tugas bertujuan jamak baru selesai sebagian; menyatakan sesuatu mustahil tanpa menghabiskan opsi yang masuk akal
Temukan keputusan pertama yang melepas sebuah tujuan atau menyerah menjelajah, dan catat terpisah dari kegagalan verifikasi akhir
Agent penganotasi atribusi dapat memakai LLM untuk menjalankan analisis akar masalah secara besar-besaran atas banyak trace produksi, tetapi tidak boleh hanya mengeluarkan satu kalimat “penyebab kegagalan”. Catatan atribusi harus terstruktur: dalam JSON atau YAML, mengutip nomor langkah spesifik, nama tool, dan bukti yang teramati; ia juga harus memisahkan akar masalah dari akibat, menilai apakah masih bisa dipulihkan, dan memberi tingkat keyakinan. Misalnya edit_file mengembalikan ketidakcocokan old_string lalu Agent mencoba ulang tiga kali dan tetap gagal menulis berkas: penyebab utamanya adalah galat penyuntingan berkas dan pemanggilan tool, sedangkan tiga percobaan ulang itu akibat, bukan tiga akar masalah yang berdiri sendiri. Bila beberapa kelas muncul bersamaan, pilih penyebab utama dengan kaidah “paling awal dan mampu menjelaskan kegagalan sesudahnya”, sisanya disimpan sebagai penyebab sekunder. Sedikitnya tiga kelas pada tabel di atas bisa disaring lebih dulu dengan aturan sebelum LLM diminta menemukan galat pertama: menyandingkan pernyataan selesai dengan perintah yang benar-benar dijalankan; apakah diff menyentuh assertion tes dan penanda skip; apakah diff mengubah API publik atau schema tanpa berkas migrasi. Menyaring dengan aturan dulu, baru melokalisasi dengan LLM, lebih murah sekaligus lebih akurat daripada menjejalkan seluruh trace ke LLM.
Saat menyimpan catatan atribusi, jangan hanya keluaran LLM: simpan pula tujuan tugas, keadaan lingkungan, versi Agent, versi kumpulan tool, dan trace Agent yang utuh, agar kasusnya dapat diubah menjadi uji regresi.
Berikut diuraikan tiga kelas galat yang khas.
Masalah “tindakannya benar, laporannya salah”
“Tindakannya benar, laporannya salah” adalah kategori yang paling mudah tertutup oleh tingkat keberhasilan agregat, karena kebanyakan evaluasi hanya memeriksa keadaan lingkungan. τ²-bench menilainya terpisah: dari 704 run baseline terpublikasi yang tugasnya memuat syarat penyampaian informasi, 240 gagal, 162 di antaranya jatuh pada pemeriksaan penyampaian, dan 80 — sepertiga dari seluruh kegagalan — memiliki keadaan lingkungan yang benar tetapi laporan yang salah.
Repositori pendamping menyimpan kasus yang sepadan. Ditugasi memasukkan pengeluaran dari expenses.jpg ke aplikasi pembukuan, Agent menghabiskan 32 langkah untuk memberi izin, mencari, membuka gambar, mengisi tiap baris, dan menyimpan, tanpa satu langkah pun mengembalikan galat, lalu menyatakan tugas selesai; validator melaporkan bahwa baris yang seharusnya ditulis — Dress, ¥436,35 — tidak ada, dan tak berkaitan dengan empat baris yang ia masukkan. Pada langkah 8 penalarannya sendiri berbunyi “I cannot actually see the content/details of the expenses in the image”: ia sudah tahu datanya tidak diperoleh, tidak berhenti dan tidak melapor, dan pada langkah 11 empat pengeluaran rekaan muncul dalam catatannya, yang kemudian dieksekusi dengan setia oleh setiap masukan berikutnya. Kesalahan pertama ada di langkah 8, dan langkah itu tidak memunculkan galat maupun berupa pemanggilan tool. Akar masalahnya juga mudah salah arsip: T3A adalah Agent teks-saja yang ruang observasinya hanya berisi pohon elemen dan tanpa piksel gambar, sehingga penyebabnya bukan “model tidak bisa OCR” melainkan kanal observasi yang hilang ditambah tiadanya aksi keluar yang sah berupa “informasi tidak tersedia”. Mengarsipkannya sebagai masalah kapabilitas model membawa langkah berikutnya ke penggantian model atau pelatihan OCR; perbaikan sebenarnya adalah menambah kanal dan aksi keluar itu.
Eksperimen 7-6 ★★: Atribusi kegagalan pada trace AndroidWorld
Eksperimen ini melatih metode atribusi pada bagian ini dengan trace nyata, tanpa emulator dan tanpa API model. Materinya adalah rekaman jalannya T3A yang tersimpan di chapter7/android-world: t3a.md memuat Action/Reason/Summary langkah demi langkah untuk semua tugas, sedangkan t3a_failed.md mengumpulkan lebih dari lima puluh trace gagal yang masing-masing diakhiri putusan objektif dari validator.
Langkah 1: Pengambilan sampel. Ambil sedikitnya sepuluh kegagalan senyap dari t3a_failed.md, yaitu trace tanpa satu pun galat tool. Tidak boleh ada pemanggilan tool yang gagal, Agent menyatakan selesai sendiri atau kehabisan langkah, dan hanya putusan validator di akhir yang menandai kegagalan.
Langkah 2: Temukan kesalahan pertama. Untuk tiap trace, catat nomor langkah kesalahan pertama dan tegaskan apakah langkah itu berupa pemanggilan tool atau sebuah assistant message. Kegagalan senyap butuh dua teknik: pembandingan jangkar fakta, yang menyandingkan pernyataan Agent dengan nilai balik tool lalu mengambil titik simpang pertama; dan biseksi trajectory prefix, yang memotong trajectory di langkah k lalu menyerahkannya — bila masih tertolong, galat ada setelah k. Mencari kata kunci galat tidak menggantikan keduanya.
Langkah 3: Tulis catatan terstruktur. Hasilkan satu catatan JSON atau YAML per trace berisi nama tugas, langkah kesalahan pertama, kategori kesalahan, pihak penanggung jawab akar masalah, kutipan bukti, serta pemisahan sebab utama dari akibat.
Langkah 4: Bandingkan dengan catatan yang ada. Bandingkan hasil Anda dengan t3a_failed_analysis.md butir demi butir dan catat setiap perbedaan. Perhatikan khusus atribusi akar masalah: catatan itu semula menulis kegagalan transkripsi gambar sebagai “model visi tidak punya OCR”, padahal ruang observasi T3A sama sekali tidak memuat piksel gambar, sehingga akar masalah sebenarnya adalah kanal observasi yang hilang. Catatan atribusi yang sudah ada bukan kunci jawaban.
Langkah 5: Ubah menjadi tugas regresi. Pilih tiga trace yang kesalahan pertamanya berupa assistant message, potong prefix tepat sebelum kesalahan itu, lalu tulis himpunan aksi yang dapat diterima dan aksi terlarang untuk membentuk tugas regresi trajectory prefix.
Kesalahan format dokumen yang peka terhadap cakupan
Ketika pengguna berkata “format tanda kutipnya salah”, itu tidak boleh diubah menjadi penggantian karakter global. Setidaknya Anda harus membedakan tanda kutip lurus ASCII (", '), tanda kutip lengkung Tionghoa (“”, ‘’), dan backtick Markdown (`). Karakter yang sama memikul peran sintaktis yang berbeda dalam prosa Tionghoa, sumber bahasa Inggris yang dikutip, kode sebaris, blok kode, komentar kode, JSON, dan path.
Data evaluasi sebaiknya lebih dulu mengurai dokumen menjadi potongan-potongan bercakupan—misalnya ZH_PROSE, EN_PROSE, QUOTED_SOURCE, INLINE_CODE, CODE_BLOCK, CODE_COMMENT, dan JSON_OR_SCHEMA. Setiap potongan menyimpan himpunan transformasi yang diizinkan, karakter yang wajib dilindungi, serta hasil verifier setelah penyuntingan. Tiga kasus di bawah ini tidak dapat ditangani oleh satu aturan penggantian:
Prosa Tionghoa: panggil metode `reset()`.Sumber Inggris yang dikutip: “Please restart the service.”# blok kode berikut hanya untuk menggambarkan cakupan yang dilindungi# Komentar Tionghoa: tampilkan "status saat ini"name = "status"
Regresi trajectory-prefix harus menuntut model melakukan suntingan minimal, sekaligus memeriksa gaya dokumen Tionghoa, tingkat pelestarian sumber Inggris, sintaksis kode dan JSON, serta jarak edit pada teks non-target. Ketika aturan tidak dapat menentukan cakupan, mempertahankan teks asli dan meminta klarifikasi harus dihitung sebagai tindakan yang diizinkan, bukan suntingan tebakan yang kebetulan lolos.
Kesalahan penyalinan persis: dari old_string mismatch ke pelacakan lapis demi lapis
Kegagalan old_string juga tidak bisa hanya diatribusikan pada “modelnya salah menyalin”. Untuk string yang sama, simpanlah hash byte asli, urutan code point Unicode, dan urutan token ID tokenizer, lalu cari perbedaan pertama sepanjang rantai berikut:
byte file asli → balasan tool → serialisasi Harness → konteks model→ keluaran token model → string hasil decode → parsing JSON/tool-call → pencocokan tool
Serangkaian probe evaluasi minimal mencakup pengulangan langsung, ekstraksi dari konteks panjang, penempatan ke argumen tool, pemilihan di antara string serupa, serta spasi, baris baru, backslash, karakter penggabung Unicode, dan token berfrekuensi rendah. Metriknya adalah byte-exact match, code-point-exact match, token-exact match, posisi perbedaan pertama, dan tingkat keberhasilan tool yang sebenarnya. Jika model benar pada probe langsung tetapi panggilan tool tetap gagal, perbaikilah tokenizer, serialisasi, Harness, atau protokol tool; hanya ketika perbedaan pertama muncul pada keluaran model itu sendiri, kasus tersebut diubah menjadi data latih penyalinan pada Bab 8.
Tugas regresi end-to-end dan regresi trajectory prefix
Atribusi kegagalan sudah memastikan galat pertama beserta kelasnya; langkah berikutnya adalah menuliskan sasaran perbaikan sebagai kasus uji yang bisa dijalankan berulang, yaitu tugas regresi (regression task). Di sini diperlukan dua lapis yang saling melengkapi: tugas regresi end-to-end memastikan perubahan tidak merusak alur kerja utuh; tugas regresi trajectory prefix memotong keadaan tepat sebelum galat pertama dan hanya memeriksa apakah batas keputusan itu sudah diperbaiki.
Tugas regresi end-to-end berangkat dari keadaan awal dan permintaan pengguna, membiarkan Agent menuntaskan seluruh tugas, lalu memeriksa keadaan akhir, keluaran yang diwajibkan, dan syarat keamanan. Ia paling mendekati hasil produksi, tetapi sulit dipakai menentukan di langkah mana kegagalan terjadi. Umumnya tugas regresi end-to-end dipakai untuk memastikan kemampuan Agent di tiap ranah masih sesuai harapan. Kumpulan evaluasi standar yang dibahas di bab ini — OSWorld, AndroidWorld, tau-bench — semuanya tugas regresi end-to-end.
Tugas regresi trajectory prefix membekukan konteks, dialog, nilai balik tool, dan keadaan lingkungan yang sudah ada, lalu hanya meminta Agent memikirkan dan menjalankan satu atau beberapa aksi teramati berikutnya. Biayanya lebih rendah dan ia mampu mengisolasi persoalan satu kebijakan atau satu tool. Untuk Agent tingkat produksi yang menuntut keandalan tinggi, menyusun himpunan tugas prefix sering lebih penting ketimbang yang end-to-end, dan itu menuntut pengembang membangun dengan sabar taksonomi kegagalan serta sistem atribusi yang dibahas pada bagian sebelumnya.
Jawaban tugas prefix sebaiknya didefinisikan sebagai himpunan aksi yang dapat diterima, bukan satu aksi atau satu jawaban tunggal: boleh menuntut “baca dulu aturan repositori”, “tanya dulu ke pengguna”, atau “tolak operasi berbahaya”, sekaligus mendaftar aksi yang dilarang.
Setelah atribusi kegagalan rampung, kumpulan data evaluasi yang mencakup tugas regresi end-to-end maupun trajectory prefix dapat disusun. Dengan Coding Agent sebagai contoh: proses yang terlewat mesti menghasilkan tugas regresi end-to-end berikut dokumen rencana dan syarat penerimaan uji; galat pemanggilan tool mesti dipotong pada prefix yang gagal lalu disunting menjadi tugas batas, menguji apakah model sanggup membetulkan format, meng-escape karakter khusus, atau beralih ke tool yang tepat; terminasi tak normal mesti menambah skenario pemulihan dari pemotongan, timeout, dan gangguan tool; galat ketuntasan dan logika mesti menambah daftar tujuan jamak, pengingat pekerjaan tersisa, serta batas “belum terbukti mustahil”; kelas pemahaman kebutuhan dan ambiguitas mesti membekukan tugas bertafsir ganda menjadi prefix dan memasukkan “klarifikasi dulu” ke himpunan aksi yang diterima; kelas tambal gejala dan pemalsuan verifikasi mesti menambah dua kendala keras pada penerimaan — “assertion tes tidak boleh diubah” dan “pernyataan selesai wajib disertai keluaran perintah yang benar-benar dijalankan”; kelas pelaporan informasi mesti memasang assertion pada isi jawaban itu sendiri, bukan hanya memeriksa keadaan lingkungan.
Kumpulan data evaluasi adalah fondasi bagi pasca-pelatihan di Bab 8 dan evolusi mandiri Agent di Bab 9.
Eksperimen 7-7 ★★: Evaluasi batas trajectory prefix dengan beberapa encoding
Model menerima memori yang sudah diketahui, instruksi saat ini, trajectory prefix, hasil tool, dan state lingkungan, lalu hanya menghasilkan tindakan berikutnya yang dapat diamati. Sebelas kasus dikodekan sebagai JSON Cards, Markdown, dan Python-like serta dinilai dengan aturan deterministik. Seluruh 33 sel selesai tanpa error API dan setiap encoding lulus 6/11; mengubah representasi saja tidak memperbaiki kebijakan penggunaan konteks.
Dalam pemilihan model secara praktis, kita sering menghadapi pertanyaan: “Mana yang lebih baik, A atau B?” Perbandingan berpasangan (pairwise comparison) memberikan metode evaluasi yang tidak bergantung pada skor absolut.
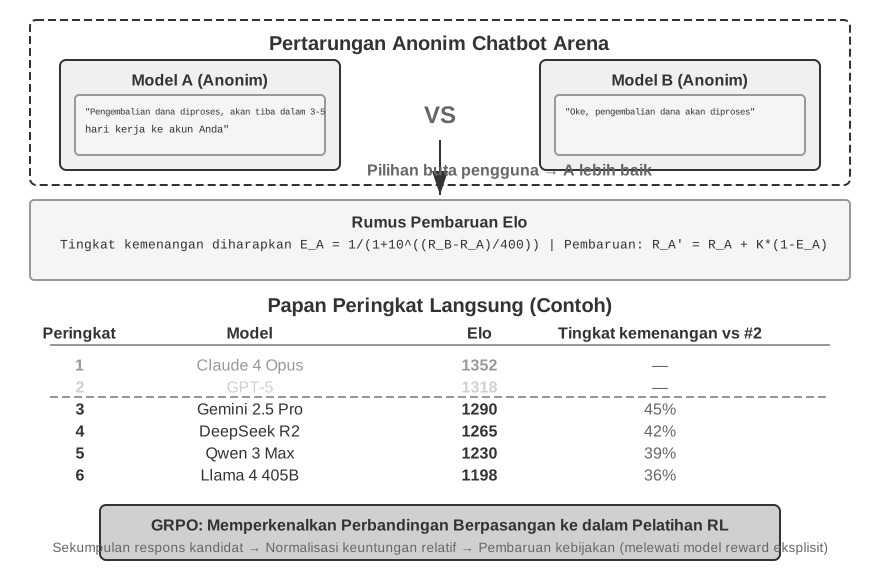
Pairwise Comparison dan Peringkat Model
Gambar 7-6: Peringkat Elo dan Peringkat Pairwise Comparison · Gambar sumber
Elo Rating (sebuah sistem peringkat yang awalnya dirancang untuk catur) mengukur kemampuan relatif model melalui sejumlah besar pertandingan berpasangan (pairwise matchups): semakin besar perbedaan peringkat, semakin tinggi tingkat kemenangan yang diharapkan untuk model yang lebih kuat. Misalnya, jika Model A memiliki peringkat 1200 dan Model B memiliki peringkat 1000, sistem Elo akan memprediksi tingkat kemenangan A sekitar 76%. Jika B secara tak terduga menang, B mendapatkan lebih banyak poin dan A kehilangan lebih banyak—sebuah kejutan (upset) memicu koreksi yang lebih besar, yang memungkinkan peringkat konvergen dengan cepat pada kemampuan sebenarnya. Fondasi statistik ini adalah Bradley-Terry model: setiap model diabstraksikan sebagai “skor kekuatan” laten, dan probabilitas satu model mengalahkan model lain dalam sebuah pertandingan ditentukan oleh perbedaan antara skor mereka. Elo adalah implementasi rekayasa dari model ini dalam bentuk pembaruan online.
Chatbot Arena menggunakan pertandingan acak anonim—pengguna secara buta memilih respons yang lebih baik tanpa mengetahui identitas model, dan peringkat diturunkan dari jutaan suara. Keuntungannya adalah tidak ada “standar absolut” yang perlu ditentukan; yang diperlukan hanyalah penilaian manusia tentang “mana yang lebih baik, A atau B.” Keterbatasannya: peringkat bergantung pada apa yang kebetulan ditanyakan pengguna. Jika banyak pengguna mengajukan pertanyaan pemrograman, model yang kuat dalam pemrograman mendapat peringkat lebih tinggi—yang mungkin tidak banyak berarti tentang tingkat kemampuan mereka pada tugas-tugas lain.
Ketika penilaian berpasangan (pairwise judging) dilakukan oleh LLM daripada pemungutan suara manusia, seseorang juga harus waspada terhadap Position Bias—model penilai secara sistematis lebih menyukai kandidat yang muncul pada posisi tertentu (biasanya yang pertama), dan penilaian mungkin tetap tidak berubah bahkan jika konten kedua kandidat sepenuhnya ditukar. Metode mitigasi standar adalah mengevaluasi setiap pasangan dua kali dengan urutan yang ditukar: sekali dengan A pertama, sekali dengan B pertama, dan merata-ratakan kedua hasilnya; pendekatan yang lebih ketat adalah hanya menghitung kasus di mana kedua penilaian konsisten, dan memperlakukan ketidakkonsistenan sebagai seri atau mengirimkannya untuk tinjauan manusia. Pendekatan Chatbot Arena pada dasarnya sama—mengacak posisi tampilan kedua respons sehingga Position Bias saling meniadakan dalam sampel yang besar.
Eksperimen 7-8 ★★: Membangun Papan Peringkat Model dari Data Perbandingan Berpasangan
Eksperimen ini bertujuan untuk memahami secara mendalam bagaimana Bradley-Terry model mengekstrak skor kemampuan relatif dari sejumlah besar perbandingan berpasangan dengan mengimplementasikan sistem perhitungan Elo Rating dari awal. Gunakan kumpulan data pemungutan suara sumber terbuka (open-source) nyata dari Chatbot Arena (berisi jutaan suara buta pengguna anonim).
Implementasikan algoritma pembaruan iteratif Elo Rating: Inisialisasi semua model dengan peringkat 1000. Proses catatan pemungutan suara dalam urutan kronologis. Untuk setiap pertandingan, hitung ekspektasi tingkat kemenangan berdasarkan perbedaan peringkat saat ini antara kedua model, bandingkan hasil aktual dengan ekspektasi, dan sesuaikan peringkat dengan tingkat pembelajaran tetap—pemenang mendapat poin, yang kalah kehilangan poin, dengan besaran penyesuaian sebanding dengan penyimpangan dari ekspektasi (kekalahan tak terduga menghasilkan perubahan peringkat yang lebih besar). Urutkan model dalam urutan menurun berdasarkan peringkat akhir dan hitung matriks tingkat kemenangan berpasangan. Bandingkan dengan papan peringkat resmi untuk memverifikasi bahwa peringkatnya secara umum konsisten. Penyelarasan titik demi titik yang tepat tidak diperlukan: Chatbot Arena resmi menggunakan estimasi kemungkinan maksimum Bradley-Terry (menyelesaikan semua pertandingan secara bersamaan, terlepas dari urutan pemungutan suara), sementara implementasi ini menggunakan pembaruan Elo inkremental online (hasil dipengaruhi oleh faktor-K tingkat pembelajaran dan urutan pemrosesan). Kedua algoritma tersebut harus menghasilkan peringkat keseluruhan yang konsisten, tetapi skor spesifiknya tidak akan persis identik.
Bagian kedua dari eksperimen membuat animasi evolusi peringkat historis: Potong data pemungutan suara berdasarkan waktu (mingguan atau bulanan) dan hitung snapshot Elo Rating untuk setiap titik waktu. Gunakan D3.js untuk mengimplementasikan animasi balapan diagram batang (panjang batang horizontal = peringkat, posisi vertikal = peringkat, berubah secara mulus seiring waktu). Dengan mengamati animasi, identifikasi momen terobosan teknologi (peringkat model tiba-tiba melonjak), evolusi lanskap kompetitif, dan siklus hidup model.
Pemilihan Model Berbasis Evaluasi
Pemilihan model bukan sekadar “memilih model terkuat”; ini melibatkan trade-off berbasis evaluasi di berbagai dimensi berdasarkan skenario aplikasi.
Dimensi Kunci untuk Pemilihan
Throughput dan Latency adalah dua kelompok metrik yang mudah dikacaukan; menguraikannya hanya membutuhkan satu fakta—inferensi LLM berjalan dalam dua tahap. Prefill membaca seluruh konteks sekaligus dan menentukan Time To First Token (TTFT): penundaan antara pengguna menekan Enter dan karakter pertama muncul. Semakin panjang konteks, semakin lambat Prefill dan semakin tinggi TTFT. Decode kemudian menghasilkan respons token demi token, menetapkan kecepatan pembuatan (tokens/second)—yang juga menentukan waktu berpikir: pada 50 tokens/s, model yang menghasilkan 2000 token pemikiran menghabiskan waktu 40 detik hanya untuk berpikir.
Di sekitar dua tahap ini, metrik Throughput dan Latency utama adalah sebagai berikut:
Input Throughput / Output Throughput: Masing-masing sesuai dengan kecepatan Prefill dan Decode.
TTFT: Sama dengan waktu antrean ditambah waktu Prefill; ini adalah “responsivitas” yang dirasakan pengguna.
Thinking Latency: Jumlah token pemikiran yang dihasilkan dapat bervariasi beberapa kali lipat di seluruh model, dan panjang pemikiran belum tentu berkorelasi positif dengan efektivitas tugas—ukur penggunaan token pemikiran setiap model dan manfaat yang sesuai pada beban kerja Anda sendiri, daripada hanya menyimpulkan dari papan peringkat publik.
p95 Tail Latency: Latency yang tidak akan dilampaui oleh 95% permintaan. Ini adalah indikator pengalaman pengguna nyata yang lebih baik daripada rata-rata, yang dapat ditarik ke bawah oleh sejumlah besar permintaan cepat, menutupi perlambatan parah yang dialami oleh minoritas pengguna.
Cost: Harga untuk token input/output/cache. Cost tidak boleh dievaluasi secara terpisah—model murah dengan tingkat keberhasilan rendah mungkin sebenarnya menimbulkan biaya lebih tinggi karena seringnya mencoba ulang. Biaya rata-rata per tugas dan rasio biaya-kinerja perlu dihitung.
Performance: Definisi pasti dari Pass@1, Pass^k, Pass@k, dan Best@k diberikan sebelumnya di “Sistem Metrik Evaluasi.” Di sini, kami hanya membahas bagaimana memilih dalam konteks pemilihan model—untuk skenario harian, fokus pada Pass@1 (tingkat keberhasilan rata-rata percobaan tunggal); untuk operasi kritis, prioritaskan Pass^k, dengan fokus pada stabilitas “tidak pernah membuat kesalahan”; untuk tugas eksplorasi, prioritaskan Pass@k atau Best@k, melihat batas atas kemampuan dengan memberikan cukup peluang; untuk tugas terbuka, gunakan penilaian Rubric multi-dimensi.
Rate Limits dan Reliability: Batasan RPM (Requests Per Minute) / TPM (Tokens Per Minute) memengaruhi kemampuan konkurensi, dan beberapa API secara dinamis menyesuaikan kuota selama jam sibuk. Dalam hal ketahanan, perhatikan data out-of-distribution, input adversarial, dan stabilitas jangka panjang (apakah masalah seperti mode collapse atau attention drift terjadi).
Kurva Anggaran-Kemampuan (Budget-capability curves): Skor tunggal pada anggaran tetap tidak cukup untuk menentukan apakah Agent dapat menangani pekerjaan jangka panjang (long-horizon). Selain tingkat keberhasilan, laporkan bagaimana kinerja berubah seiring dengan waktu jam dinding (wall-clock time), token, pemanggilan tool, atau anggaran komputasi. RE-Bench membuat masalah ini menjadi konkret: dengan total anggaran dua jam per lingkungan, Agent terbaik mendapat skor sekitar empat kali lebih tinggi dari pakar manusia; Namun, manusia mendapat lebih banyak manfaat dari waktu tambahan, sedikit melampaui Agent terbaik pada delapan jam, dan mencetak skor sekitar dua kali lebih tinggi ketika beberapa percobaan diberikan waktu total 32 jam1. Oleh karena itu, kepemimpinan anggaran singkat tidak dapat diekstrapolasi langsung ke kemampuan berjalan lama. Pemilihan model harus membandingkan beberapa titik anggaran yang mendekati durasi beban kerja sebenarnya.
Dalam praktiknya Anda dapat mencampur model: model ringan pada permintaan sederhana untuk memangkas biaya, model kuat pada tugas kompleks untuk melindungi kualitas; atau model spesialis pada sub-tugas tertentu (pemahaman gambar, pembuatan kode), berkolaborasi melalui mekanisme sub-agent. Setiap kombinasi heterogen seperti itu harus divalidasi oleh evaluasi, untuk memastikan keseluruhan manfaat melebihi kompleksitas sistem yang ditambahkan (misalnya, menganggap pertanyaan seperti “mana yang lebih besar, 9,9 atau 9,11?” atau “saya mau cuci mobil, tempat cucinya 50 meter dari rumah—jalan kaki atau menyetir?” sebagai pertanyaan sederhana lalu menyerahkannya ke model ringan, sehingga keputusannya salah).
Perilaku Model: Kapan Berhenti Membaca dan Mulai Menyunting
Pemilihan model tidak hanya membandingkan apakah suatu model dapat menuntaskan tugas, tetapi juga bagaimana perilaku bawaannya. Salah satu perbedaan yang mudah diamati pada Coding Agent adalah ambang tindakan. Saat menghadapi tugas coding yang sama, sebagian model menjelajahi repositori secara luas dan memastikan arsitektur, pemanggil, serta pengujian sebelum menyunting. Model lain melokalisasi perubahan dari bukti yang lebih sedikit, menyunting lebih awal, lalu memakai umpan balik pengujian untuk melengkapi pemahamannya. Kelompok pertama menilai biaya penyuntingan prematur lebih tinggi; kelompok kedua menilai biaya peluang membaca satu berkas lagi lebih tinggi.
Kecenderungan Agent semacam ini punya dua sumber: system prompt di dalam Harness, dan kebijakan perilaku model. Pasca-pelatihan adalah sumber kunci kebijakan perilaku itu: trajektori SFT mendemonstrasikan “seberapa jauh membaca sebelum mulai bertindak”, imbalan proses memberi ganjaran atau hukuman pada jalur tool tertentu, dan imbalan hasil memperkuat seluruh strategi yang akhirnya berhasil. Lama-kelamaan, yang dipelajari model bukan hanya cara menulis kode, melainkan juga kebiasaan rekayasa.
Eksperimen 7-9 ★★: Mengukur Ambang Tindakan Model dalam Coding Harness Tetap
Tujuan: mengisolasi faktor model, mengukur bagaimana model Coding menyeimbangkan pengumpulan informasi lanjutan dengan mulai menyunting, serta menilai efisiensi lintasan bersama kualitas hasil.
Metode: jalankan chapter6/model-action-threshold/experiment.py. Secara default, program memanggil GPT-5.6-sol dan Claude Sonnet 5 melalui endpoint OpenRouter OpenAI-compatible yang sama sambil menetapkan system prompt, schema alat, repositori tugas, perintah pengujian, dan batas putaran yang sama. Prompt netral tidak menentukan jumlah minimum berkas yang harus dibaca maupun kewajiban untuk cepat menyunting. Ulangi masing-masing dari tiga kategori tugas setidaknya tiga kali dan selang-selingkan urutan model. Catat panggilan alat, berkas yang dibaca, pencarian, dan waktu dinding sebelum penyuntingan pertama, beserta penerimaan patch pertama yang diuji, pengerjaan ulang setelah pengujian, keberhasilan akhir, berkas yang berubah, dan penggunaan Token.
Interpretasi kausal: kampanye netral menanyakan apakah perilaku berubah bersama model di dalam satu Harness. Untuk mengukur Harness sebagai pengubah, jalankan kampanye terpisah dengan --policy explore-first; jangan mencampur kedua policy dalam satu perbandingan model. Perilaku yang berubah saat model ditukar dan bertahan untuk model yang sama di berbagai Harness menjadi bukti lebih kuat bagi efek model; pola sebaliknya lebih mendukung efek Harness.
Kriteria penerimaan: seluruh unit test offline lulus; setiap fixture tugas terlebih dahulu dipastikan berada dalam kondisi pengujian gagal; hasil formal mencakup seluruh sel model × tugas × pengulangan, nol error API, pengujian akhir independen, dan lintasan yang dapat diaudit; serta manifest.json memverifikasi hash konfigurasi, observasi, dan ringkasan. Direktori proyek menyimpan satu run lengkap 18/18 sel. Pembaca harus menjalankannya kembali pada versi model dan beban kerja nyata yang relevan, bukan memperlakukan angka dari repositori mini ini sebagai leaderboard permanen.
Analisis Biaya Sistem Agent
Bagian sebelumnya mencantumkan biaya di antara dimensi pemilihan utama, tetapi biaya Agent jauh lebih kompleks daripada sekadar harga token—penalaran multi-putaran, pemanggilan tool, dan akumulasi konteks membuat biaya tumbuh secara non-linear. Analisis biaya sistematis adalah bagian tak terpisahkan dari sistem evaluasi dan prasyarat untuk penerapan produksi.
Komponen Biaya.
Biaya sistem Agent dapat diuraikan menjadi tiga level:
Model inference cost adalah komponen yang paling langsung, ditentukan oleh konsumsi token input dan token output. Namun, dalam skenario Agent, ada dua faktor penguat yang sering diabaikan. Yang pertama adalah efek akumulasi konteks (context accumulation effect): setiap kali Agent memanggil LLM, ia mengirimkan semua riwayat percakapan sebelumnya dan output alat bersama-sama (sehingga model dapat memahami konteks). Tanpa secara efektif memanfaatkan KV Cache (yaitu, melakukan cache pada konteks yang sudah diproses untuk menghindari komputasi yang berlebihan), biaya tumbuh sangat cepat—Putaran 1 mengirim 1000 token, Putaran 2 mengirim 2000 token, Putaran 3 mengirim 3000 token, total 1000+2000+3000=6000 bukannya 3×1000=3000. Semakin banyak putaran, semakin besar celahnya. Yang kedua adalah thinking token cost: model yang mendukung pemikiran menghasilkan sejumlah besar token pemikiran. Meskipun token ini tidak ditampilkan kepada pengguna, token tersebut tetap ditagih.
Tool call cost mencakup biaya API eksternal (mesin pencari mengenakan biaya per kueri, kueri basis data mengonsumsi sumber daya komputasi), sumber daya sandbox untuk eksekusi kode, dan biaya tidak langsung yang mudah diabaikan: biaya token yang timbul saat output alat disuntikkan ke dalam konteks. Konten yang dikembalikan dari satu pencarian web mungkin menempati 2000-5000 token, dan itu akan berulang kali ditagih sebagai input di setiap putaran inferensi berikutnya.
Infrastructure cost mencakup overhead operasional untuk vector databases (digunakan untuk RAG retrieval), message queues, relational databases, dan penyimpanan logging dan tracing (untuk observabilitas).
Untuk melihat sumber biaya secara nyata, eksperimen pendamping menetapkan alur pengembalian dana delapan putaran: memeriksa pesanan, pengiriman, kebijakan, dan basis pengetahuan, lalu menjalankan pemeriksaan risiko, pengembalian dana, pemberitahuan, dan penutupan. Panggilan gpt-4o-mini yang sebenarnya mengaktifkan atau menonaktifkan dua opsi—awalan stabil dan kompresi riwayat—dalam desain 2×2. Keempat konfigurasi menyelesaikan pekerjaan yang sama. Biaya pada Tabel 7-4 dihitung dari pemakaian token yang tersimpan dan harga saat itu.
Tabel 7-4 Biaya nyata tugas Agent delapan putaran
Konfigurasi
Token input
Token cache
Total biaya
Hemat dari baseline
Tanpa cache, tanpa kompresi
20,700
0
$0.003776
—
Hanya awalan stabil
20,386
13,568
$0.002707
28.3%
Hanya kompresi riwayat
16,177
0
$0.003115
17.5%
Awalan stabil + kompresi
16,035
6,144
$0.002643
30.0%
Pada baseline, input per putaran naik dari 1,113 menjadi 3,668 token. Hasil tool berulang kali masuk ke permintaan berikutnya dan menyumbang 9,544 token input dalam delapan putaran. Dengan kedua optimasi, angka itu turun menjadi 5,248 dan biaya total turun 30%.
Efeknya tidak dapat dijumlahkan. Awalan stabil saja menghemat 28.3% dan kompresi saja 17.5%, tetapi gabungan keduanya hanya 30.0%. Kompresi riwayat juga memperpendek awalan yang dapat mengenai cache. Saat beberapa optimasi konteks digabungkan, ukur semua kombinasi pada tugas lengkap; jangan menjumlahkan persentase penghematan terpisah. Angka 30% akan berubah bersama model, harga, dan panjang tugas. Yang dapat digunakan kembali adalah desain empat kelompoknya.
Strategi Optimalisasi Biaya.
Di sisi input, tiga hal patut diuji lebih dahulu: mempertahankan awalan agar KV Cache dapat digunakan kembali, memangkas jejak lama dan keluaran tool yang panjang melalui kompresi konteks, serta memilih model ringan atau kuat sesuai kerumitan tugas. Bab 2 membahas penerapannya. Di sini yang penting adalah setiap fitur dapat diaktifkan secara terpisah, sehingga kontribusi individual dan kemungkinan saling meniadakan saat digabungkan dapat diukur. Dua metode berikutnya khusus berkaitan dengan evaluasi dan operasi.
Asynchronous Batch Processing mengakumulasi tugas non-real-time untuk pemrosesan batch, memanfaatkan diskon harga batch dari penyedia API; dalam skenario self-deployment, ini juga meningkatkan utilitas GPU selama jam di luar jam sibuk (off-peak hours).
Pemantauan Biaya dan Kontrol Anggaran.
Dalam lingkungan produksi, sistem pemantauan biaya waktu nyata (real-time cost monitoring) harus dibangun: melacak konsumsi token dan biaya API berdasarkan jenis tugas, model, pengguna, dll. Selain itu, tetapkan batas biaya (cost cap) untuk setiap tugas—secara otomatis menghentikan Agent ketika jatuh ke dalam loop atau mengeksplorasi terlalu dalam, mencegah tugas tunggal menimbulkan biaya tinggi yang tidak normal.
Eksperimen 7-10 ★: Analisis Biaya End-to-End Tugas Agent
Tujuan Eksperimen: Mereproduksi rincian biaya tugas delapan putaran di atas dan memvalidasi optimasi pada beban kerja nyata milik Anda.
Pendekatan Teknis: Reproduksi tugas tetap di repositori, kemudian ganti dengan beberapa tugas representatif Anda. Gunakan LangSmith atau sistem tracing sendiri untuk merekam token input/output/thinking, jumlah dan ukuran hasil tool, serta latensi end-to-end. Hitung biaya rata-rata, p50/p95/p99, dan komposisi biaya per jenis tugas.
Kriteria Penerimaan: Buat laporan yang mengidentifikasi pendorong biaya utama. Jalankan keempat kombinasi cache dan kompresi untuk mengukur efek tunggal serta interaksinya. Jika model berubah, ukur ulang dan jangan memakai persentase penghematan dari jejak pendamping.
Iterasi Berkelanjutan Berbasis Evaluasi
Pemilihan model bukanlah keputusan satu kali tetapi proses yang berkelanjutan, disesuaikan seiring dengan evolusi model. Bab ini dibuka dengan klaim bahwa sistem evaluasi memungkinkan Anda mengimbangi evolusi model; kasus peralihan model konkret menunjukkan bagaimana hal itu terjadi dalam keputusan nyata.
Misalkan sistem Agent Anda saat ini dibangun di atas Claude, unggul dalam pemanggilan tool dan orkestrasi kompleks. Suatu hari, Gemini merilis model baru, dan benchmark publik menunjukkan itu melampaui Claude pada beberapa metrik dengan harga yang lebih rendah. Pada titik ini, pertanyaan Anda bukanlah “Apakah Gemini lebih baik dari Claude?” tetapi “Pada tugas spesifik saya, apakah Gemini lebih baik dari Claude? Seberapa lebih baik? Berapa biaya peralihannya?”
Tim dengan sistem evaluasi yang solid dapat menjawab ini dalam hitungan jam: jalankan model baru pada dataset evaluasinya sendiri dan bandingkan tingkat keberhasilan tugas, akurasi pemanggilan alat (tool call), latensi, dan biaya. Anda mungkin menemukan bahwa model baru benar-benar lebih baik dan lebih murah untuk tugas-tugas sederhana—tetapi dalam skenario inti yang melibatkan orkestrasi tool multi-ronde yang kompleks, tingkat keberhasilannya turun 5%. Setelah Anda mengonfirmasi bahwa perbedaannya melampaui estimasi noise sampel (lihat “Signifikansi Statistik dari Hasil Evaluasi” di bawah), keputusan Anda menjadi strategi yang dibedakan—migrasikan tugas-tugas sederhana ke model baru untuk memangkas biaya, pertahankan model asli pada tugas-tugas kompleks untuk melindungi kualitas—daripada penggantian total secara membabi buta. Keputusan yang sangat terperinci dan didorong oleh data (data-driven) seperti ini hanya dimungkinkan dengan sistem evaluasi yang dibangun sebelumnya.
Eksperimen 7-11 ★★: Benchmarking Kinerja Model Multi-Dimensi
Lakukan benchmark komprehensif terhadap LLM arus utama dan berbagai penyedia API untuk membangun basis data keputusan pemilihan model multi-dimensi.
Pilih ruang lingkup pengujian: Model SOTA sumber tertutup seperti seri GPT, seri Claude, seri Gemini, seri Doubao, dan model sumber terbuka seperti Qwen, Kimi, DeepSeek. Uji model yang sama dengan berbagai penyedia API (misalnya, DeepSeek resmi vs. Siliconflow) untuk memverifikasi hasil dari platform pemantauan kinerja pihak ketiga (misalnya, Artificial Analysis).
Rancang beban kerja pengujian terstandarisasi: Uji throughput input menggunakan konteks dengan panjang tetap (8K/32K/128K token), uji throughput output meminta respons dengan panjang tetap (512/2048 token). Uji latensi mencakup TTFT (Time to First Token) dan latensi ujung-ke-ujung (end-to-end latency). Untuk model yang mendukung thinking, ukur panjang thinking dan latensi thinking secara terpisah. Untuk setiap konfigurasi, buat setidaknya 100 permintaan dan hitung standar deviasi, p50, p95, dan p99; varians latensi yang tinggi menunjukkan pengalaman pengguna yang tidak stabil.
Evaluasi ketersediaan dan stabilitas API: Lakukan pemeriksaan (probe) sekali per jam selama seminggu, catat tingkat keberhasilan, jenis kesalahan, dan durasi kegagalan. Hitung tingkat kegagalan (failure rate), MTTR (Mean Time to Recovery), dan waktu aktif berkelanjutan (continuous uptime) terlama. Uji ambang batas aktual dari rate limits—tingkatkan konkurensi secara bertahap untuk menemukan titik throttling, catat batasan RPM/TPM. Hitung biaya komprehensif: Kumpulkan informasi harga (harga satuan untuk token input/output/cache), pertimbangkan dampak KV Cache, dan hitung biaya rata-rata untuk tugas Agent multi-ronde yang khas.
Eksperimen 7-12 ★★: Evaluasi Pemilihan Ujung-ke-Ujung (End-to-End) untuk Sistem User Memory
Prasyarat: Harus menyelesaikan eksperimen contextual retrieval atau agentic RAG dari Bab 3.
Tujuan: Lakukan evaluasi pemilihan model ujung-ke-ujung (end-to-end) pada Agent yang mengambil User Memory, memeriksa bagaimana embedding model, reranker, dan model utama Agent secara bersama-sama memengaruhi kualitas, latensi, dan biaya pengambilan. Gunakan kembali chapter3/contextual-retrieval-for-user-memory atau chapter3/agentic-rag-for-user-memory, dan bandingkan konfigurasi pada 60 kasus uji.
Penerimaan: Evaluasi masing-masing dari ketiga poin pemilihan secara bergiliran—embedding model (BGE-M3 / OpenAI / Doubao, dll., catat akurasi pengambilan top-5, latensi, biaya), reranker (sertakan baseline “tanpa reranker”, kuantifikasi nilai marjinalnya), dan model utama (bandingkan tingkat keberhasilan dan efisiensi penggunaan tool di bawah konfigurasi pengambilan yang sama). Kuncinya adalah mengidentifikasi sinergi di antara komponen-komponen tersebut: embedding yang lebih kuat mungkin membuat reranker menjadi berlebihan, dan model utama yang lebih kuat mungkin mengompensasi kekurangan pengambilan. Pemilihan adalah trade-off sistemik, bukan sekadar memilih komponen terkuat secara terisolasi. Detail konfigurasi ada di repositori pendamping.
Signifikansi Statistik dari Hasil Evaluasi
Set evaluasi terbatas dan keluaran model pun acak, sehingga selisih skor bisa saja hanya derau pencuplikan. Jika Anda mengukur laju keberhasilan p pada n kasus, galat bakunya dapat ditaksir secara kasar sebagai:
SE(p)≈np(1−p)
Misalnya, pada 100 kasus dengan laju keberhasilan 70%, selang kepercayaan 95% kira-kira 70%±9 poin persentase; “model baru 73% lawan model lama 70%” belum cukup untuk mendukung peralihan.
Ketika membandingkan dua konfigurasi pada kumpulan tugas yang sama, dahulukan analisis berpasangan: catat per soal siapa yang menang, lalu nilai selisihnya dengan uji McNemar atau bootstrap berpasangan, bukan dengan mengurangkan dua laju keberhasilan yang independen. Karena setiap jalannya Agent pun bisa berbeda, sebaiknya tiap konfigurasi dijalankan dengan beberapa benih acak (misalnya 3–5 kali) dan dilaporkan rerata beserta rentang fluktuasinya; sekali jalan hanya berguna untuk menyaring arah. Bila keuntungan yang diharapkan hanya 2–3 poin persentase sementara set evaluasi cuma berisi beberapa puluh soal, perbesar dulu sampelnya—galat baku menyusut sebesar 1/n.
for task in paired_tasks: for seed in fixed_seeds: a = run(config_a, task, seed) b = run(config_b, task, seed) record_paired_delta(verifier(a), verifier(b))return paired_bootstrap_or_mcnemar(all_deltas)
Makna berpasangan adalah kedua kelompok berbagi tugas dan kondisi acak yang sama, bukan mencuplik dua kumpulan sampel terpisah lalu membandingkan rerata masing-masing.
Ketika memverifikasi beberapa hipotesis secara paralel, pertimbangkan pula perbandingan berganda: perketat ambang signifikansi, atau jalankan ulang hasil positif secara independen. Kriteria praktisnya sederhana: selisih skor baru layak dijadikan dasar untuk berganti model atau merilis perubahan bila ia melampaui derau, bertahan dalam analisis berpasangan, dan dapat direproduksi.
Observabilitas Agent (Agent Observability)
Keputusan yang didorong oleh evaluasi (baik untuk pemilihan model atau iterasi berkelanjutan) bergantung pada data operasional berkualitas tinggi. Di bawah ini, pertama-tama kita akan memperkenalkan cara mengumpulkan data ini secara sistematis (observabilitas), dan kemudian mendiskusikan cara menerjemahkan hasil evaluasi menjadi perbaikan sistem.
Gambar 7-7: Tumpukan Teknologi Observabilitas · Gambar sumber
Observabilitas adalah konsep yang dipinjam dari sistem terdistribusi: Anda tidak dapat membuka sistem dan melihatnya bekerja; Anda menyimpulkan apa yang terjadi dari log, metrik, dan jejak (traces) yang dipancarkannya—cara seorang dokter, tidak dapat melihat ke dalam diri seorang pasien, mendiagnosis dari suhu tubuh, tekanan darah, dan pencitraan medis. Sistem Agent membuat hal ini menjadi lebih sulit: input yang sama dapat menghasilkan output yang berbeda, penalaran multi-ronde dan pemanggilan tool membuat alur eksekusi menjadi sangat kompleks, dan “thinking” (pemikiran) model sepenuhnya buram dari luar.
Nilai dari observabilitas terletak pertama-tama pada diagnosis masalah: jejak (traces) yang lengkap memungkinkan pengembang untuk memutar ulang seluruh proses alih-alih menebak. Kedua, itu adalah fondasi untuk optimisasi berkelanjutan—Anda dapat melihat tugas mana yang memerlukan beberapa ronde iterasi, tool mana yang memiliki tingkat keberhasilan terendah, dan kueri pencarian mana yang selalu mengembalikan hasil kosong. Dalam manajemen biaya, biaya operasi Agent dapat berbeda satu atau dua tingkat besaran di antara tugas-tugas, dan jejak (tracing) memunculkan kasus-kasus mahal yang tidak wajar. Terakhir, akumulasi data jejak (trace data) mendasari optimisasi sistem dan perbaikan model di kemudian hari.
Observabilitas Agent dibangun di atas fondasi traces (jejak), yang struktur datanya langsung mewarisi model pohon bentangan (span tree) dari sistem terdistribusi: satu eksekusi tugas sesuai dengan satu jejak (trace), di mana setiap pemanggilan LLM, setiap pemanggilan tool, dan setiap pencarian (retrieval) adalah sebuah span (unit eksekusi yang merekam input/output, waktu mulai/selesai, konsumsi token, dan informasi kesalahan). Hubungan induk-anak di antara span-span tersebut membentuk pohon eksekusi—misalnya, span “Agent Main Loop” (Loop Utama Agent) mungkin memiliki beberapa span turunan “LLM Call” (Panggilan LLM) dan “Tool Call” (Pemanggilan Tool) yang menggantung di bawahnya. Protokol standar sudah tersedia untuk lapisan ini: OpenTelemetry adalah standar tracing terdistribusi tujuan umum (general-purpose), sementara spesifikasi seperti OpenInference mendefinisikan konvensi semantik khusus LLM di atasnya (cara merekam prompt, parameter model, penggunaan token, dll.). Keuntungan mengadopsi protokol standar adalah pemisahan (decoupling) pengumpulan dan analisis—data jejak (trace data) yang sama dapat dihubungkan ke backend analisis yang berbeda, menghindari vendor lock-in.
LangSmith adalah salah satu platform representatif dalam domain ini (platform serupa mencakup Langfuse, Arize Phoenix, dll.), yang mengintegrasikan observabilitas, evaluasi, dan optimisasi ke dalam putaran tertutup (closed loop). Setiap eksekusi menciptakan sesi jejak (trace session), di mana pemanggilan model, penggunaan tool, dan pencarian pengetahuan (knowledge retrieval) dicatat sebagai unit eksekusi independen, dihubungkan oleh hubungan kausal untuk membentuk pohon eksekusi. Setiap unit mencatat informasi lengkap tentang input/output, informasi pengaturan waktu, data biaya, dan informasi kesalahan. Platform ini menggunakan pengumpulan data batch asinkron untuk memastikan bahwa tracing (pelacakan) itu sendiri tidak memengaruhi latensi respons Agent.
Platform ini juga mendukung pengujian A/B (mengalihkan sebagian lalu lintas pengguna ke versi baru, secara otomatis membandingkan metrik, dan mendukung pembatalan (rollback) cepat atau penskalaan bertahap), manajemen versi prompt (setiap versi dikaitkan dengan data kinerja saat waktu proses (runtime)), dan pengembangan kolaboratif (anggota tim dapat berbagi data jejak (trace data) dan kasus-kasus bermasalah). Data dunia nyata dalam jumlah besar dari lingkungan produksi adalah tambang emas untuk peningkatan berkelanjutan—itu dapat mengungkap skenario yang tak terduga dan mengidentifikasi fitur-fitur yang paling butuh optimisasi.
Penggunaan data observabilitas yang paling berharga adalah mengubahnya menjadi aset evaluasi. Loop praktis: ekstrak kasus yang gagal dan mencurigakan dari jejak (traces) produksi → anonimkan (hapus bidang sensitif seperti data pengguna dan keys) → saring (distill) menjadi kasus uji baru dan uji regresi (regression tests) untuk set evaluasi. Set evaluasi kemudian berhenti menjadi koleksi statis sekali pakai dan menjadi aset hidup yang berevolusi dengan produk dan terus mencerminkan distribusi pengguna nyata—pola kegagalan yang terekspos di produksi hari ini menjadi uji regresi (regression tests) yang menjaga garis dasar (baseline) besok. Inilah tepatnya antarmuka antara observabilitas dan tema utama bab ini: observabilitas bertanggung jawab untuk “melihat” apa yang terjadi di dunia nyata, dan evaluasi bertanggung jawab untuk memadatkan pengamatan tersebut menjadi standar yang dapat diulang.
Dengan sistem evaluasi dan dataset yang komprehensif, kuncinya adalah menerjemahkan hasil evaluasi menjadi perbaikan sistem yang nyata.
Dari Laporan Benchmark ke Perbaikan Sistem
Berikut adalah proses tuning AndroidWorld nyata yang tersimpan di repositori pendamping. Pilot ini hanya mencakup empat tugas pengaturan Wi-Fi pada emulator API 35, dengan satu eksekusi berpasangan per tugas. Ini bukan benchmark lengkap 116 tugas dan bukan pengganti pengujian ulang pada lingkungan standar API 33. Nilainya adalah menunjukkan bagaimana hasil satu putaran menentukan satu perubahan pada putaran berikutnya, bukan membuktikan peningkatan sistem secara keseluruhan.
Gambar 7-8: Lingkaran Benchmark ke Perbaikan · Gambar sumber
Dari sudut pandang rekayasa Harness, bagian ini pada dasarnya adalah tentang metodologi untuk optimisasi Harness berulang (iterative Harness optimization)—menggunakan data evaluasi untuk mengidentifikasi titik lemah di Harness (konteks tidak cukup? kurang batasan? validasi tidak memadai? umpan balik (feedback) tidak tepat waktu?), membuat perbaikan yang ditargetkan, dan kemudian mengevaluasi kembali, membentuk putaran tertutup (closed loop) untuk evolusi Harness yang berkelanjutan.
Sebelum menganalisis laporan benchmark apa pun, perhatikan prinsip yang mudah terlewatkan: ketika kinerja Agent menurun, periksa sistem evaluasinya terlebih dahulu, baru kemudian Agent-nya. Kesalahan umum adalah mulai mengedit kode Agent pada saat skor turun, mengabaikan kemungkinan bahwa sistem evaluasi yang rusak terlebih dahulu—mengarahkan dengan sinyal yang terdistorsi dan koreksinya salah sejak langkah pertama. Kegagalan umum di sisi evaluasi mencakup: lingkungan waktu proses (runtime environment) kehabisan sumber daya dan mematikan proses (yang muncul sebagai kegagalan acak), bug di penilai (scorer) yang menandai jawaban benar sebagai kegagalan, dan kasus uji yang melenceng dan tidak sinkron dengan skenario produksi. Dalam angka-angka utamanya, semua ini tampak identik dengan degradasi model; hanya tinjauan atas jejak (traces) penuh yang dapat membedakannya.
Membaca Laporan Benchmark: Seni Menemukan Masalah
Laporan awal menjalankan 116 tugas sekali dan mencatat tingkat keberhasilan keseluruhan sekitar 88%. Namun kegagalan tidak tersebar acak: tiga dari empat tugas SystemWifiTurn* gagal, dengan jejak yang berulang kali berpindah halaman dan tidak dapat memastikan keadaan akhir. Setidaknya ada dua penjelasan: Agent tidak tahu jalur menuju pengaturan, atau representasi layar yang diterimanya tidak lengkap.
Kelompok kecil ini mudah tenggelam dalam angka 88%. Menambah batas langkah juga dapat salah mendiagnosis “tidak melihat UI” sebagai “kurang waktu”. Pertama cari tugas dan kapabilitas tempat kegagalan menumpuk, lalu putar ulang jejak untuk memisahkan masalah melihat, berpikir, bertindak, dan memverifikasi. Membatasi diagnosis pada empat tugas Wi-Fi menekan biaya; hal itu tidak mengestimasi kinerja sistem secara umum.
Dari Data ke Hipotesis: Membangun Peta Jalan Perbaikan
Putaran pertama menguji perubahan termurah. H1 menganggap Agent hanya tidak tahu jalan, sehingga kelompok treatment mendapat petunjuk navigasi Wi-Fi dan instruksi untuk memeriksa keadaan akhir. Tingkat keberhasilan tidak berubah; masalahnya bukan Prompt.
Putaran kedua memeriksa apa yang sebenarnya “dilihat” Agent. H5 mengganti accessibility feed yang tidak kompatibel dengan API 35 menjadi pohon UIAutomator yang didukung AndroidWorld. Keberhasilan meningkat, tetapi pohon lengkap terlalu panjang dan pemakaian token melonjak. H5C tidak menambah informasi baru; ia membuang container yang tidak terlihat, tanpa teks, dan tidak dapat dioperasikan untuk menguji apakah noise dapat dikurangi tanpa menurunkan keberhasilan.
Ketiga putaran mempertahankan model, parameter tugas, seed, batas langkah, dan emulator yang sama, serta mengganti urutan control dan treatment. Dengan satu variabel per putaran, masalah yang ditemukan sebelumnya menjadi satu-satunya perubahan yang diuji berikutnya.
Dari Hasil ke Keputusan: Pertukaran (Trade-offs) yang Didorong Data
Tabel 7-5 merangkum hasil pengukuran tiga putaran. Karena setiap kelompok hanya berisi empat tugas, angka ini hanya menentukan apakah eksperimen layak diperluas, bukan tingkat keberhasilan AndroidWorld secara keseluruhan.
Tabel 7-5 Tiga putaran pada subset Wi-Fi AndroidWorld
Eksperimen
Satu-satunya perubahan
Keberhasilan control→treatment
Token treatment/control
Keputusan berikutnya
H1
Menambah petunjuk navigasi
25%→25%
0.47×
Tidak ada peningkatan; pertahankan Prompt lama
H5
Ganti accessibility feed dengan UIAutomator
25%→100%
2.498×
Efektif, tetapi gagal guardrail biaya
H5C
Ringkas pohon UIAutomator
100%→100%
0.506×
Keberhasilan tetap, token separuh; lanjut ke uji penuh
Rangkaian hasil lebih berguna daripada satu persentase. Prompt yang lebih rinci tidak dapat mengganti informasi yang tidak pernah diterima Agent; untuk kegagalan seperti ini, periksa input terlebih dahulu. Namun lebih banyak input juga tidak selalu lebih baik. Pohon lengkap mengatasi masalah “tidak terlihat” tetapi membawa banyak noise. Setelah node tanpa makna dibuang, keempat tugas tetap berhasil dan token berkurang sekitar separuh. Tanpa mengganti model, cara Harness merepresentasikan UI menyelesaikan masalah kemampuan terlebih dahulu, lalu biaya.
Iterasi Berkelanjutan: Dari Peningkatan Pertama ke Evolusi Sistem
H5C yang lolos pada empat tugas hanya berarti layak memasuki uji berikutnya, bukan siap di-deploy. Gate berikutnya adalah menjalankan 116 tugas, termasuk aplikasi pihak ketiga, masing-masing dengan lima seed pada Pixel 6 / API 33. Tingkat keberhasilan harus non-inferior, rasio token tidak lebih dari 0.75, dan rasio latensi tidak lebih dari 1.5. Sebelum uji penuh itu, hasil 4/4 pada subset tidak boleh ditulis sebagai 100% untuk seluruh sistem.
Inilah disiplin iterasi: bukti hanya membenarkan langkah berikut yang sepadan dengan skalanya. Kegagalan H1 menghentikan penumpukan Prompt; H5 menemukan arah yang benar sekaligus masalah biaya; H5C mengatasi biaya dan baru kemudian layak diuji lebih luas. Laporan Benchmark yang baik menyatakan skor, batas berlaku kesimpulan, guardrail yang belum lolos, dan hal yang akan diuji berikutnya.
Eksperimen 7-13 ★★★: Evaluasi dan Perbaikan di AndroidWorld
Eksperimen ini melatih alur dari laporan evaluasi menuju perbaikan sistem. Mulailah dari laporan historis dan tiga hasil berpasangan yang tersimpan di chapter6/android-world.
Langkah 1: Diagnosis. Analisis silang (Cross-analyze) tabel per tugas dan matriks capability tag untuk memetakan kegagalan tugas tingkat permukaan pada kelemahan kemampuan yang mendasar. Identifikasi capability tags dengan tingkat keberhasilan yang lebih rendah dari ekspektasi dan area tugas dengan kegagalan yang terkonsentrasi.
Langkah 2: Membangun Hipotesis. Rumuskan hipotesis perbaikan mengikuti kerangka kerja tiga lapisan (permukaan → menengah → dalam). Setiap hipotesis harus menyatakan target peningkatan pada tingkat keberhasilan dan metode verifikasinya.
Langkah 3: Eksperimentasi bertahap. Reproduksi H1, H5, dan H5C dengan hanya satu variabel berubah pada setiap putaran. Catat keberhasilan, token, latensi, dan regresi.
Langkah 4: Pengambilan Keputusan Berbasis Data. Buat keputusan peluncuran (deployment) berdasarkan analisis biaya-manfaat—tidak sekadar mengadopsi semua perbaikan yang efektif, melainkan menimbang ruang lingkup aplikasi, dampak latensi, dan beban biaya dari setiap perbaikan. Prioritaskan perbaikan berbiaya rendah dan bermanfaat tinggi untuk di-deploy; batasi perbaikan berbiaya tinggi untuk skenario kritis.
Langkah 5: Iterasi. Pilot yang lolos hanya dapat maju ke uji penuh. Jangan membahas deployment sebelum menyelesaikan 116×5 eksekusi pada lingkungan standar. Laporan harus menyimpan perbedaan lingkungan, ukuran sampel, dan bagian yang belum dijalankan.
Dari Evaluasi Eksternal ke Evaluasi Internal: Infrastruktur Evaluasi untuk Agent Kelas Produksi
Sejauh ini bab ini telah mengevaluasi sistem Agent dari luar—membangun lingkungan evaluasi, merancang dataset, dan menganalisis laporan Benchmark. Tetapi produk Agent terbaik melakukan lebih dari sekadar menjalani evaluasi eksternal; mereka membangun infrastruktur evaluasi mandiri yang berkelanjutan ke dalam produk. Di bawah ini, dengan menggunakan Agent serbaguna open-source OpenClaw yang diperkenalkan pada Bab 5 sebagai contoh dan mengacu pada analisis teknis publik dari produk Coding Agent terkemuka serta wawasan para praktisi, kami menyajikan sistem evaluasi internal yang patut ditiru: sistem yang secara sistematis menanamkan metodologi eksperimental penelitian ML ke dalam rekayasa produk.
Infrastruktur Ablation: Memahami Kontribusi Nyata dari Setiap Fitur
Para peneliti ML telah lama menggunakan studi ablation untuk mempelajari komponen model mana yang benar-benar penting—ablation berarti “menghapus” satu komponen pada satu waktu dan mengamati seberapa jauh kinerja secara keseluruhan menurun. OpenClaw membawa metodologi ini ke dalam rekayasa produk: sakelar utama (master switch) bawaan dapat menonaktifkan beberapa fitur utama sekaligus (mode thinking, context compression, automatic memory, background tasks, dan banyak lagi), menciptakan baseline “bare model”. Hal itu memungkinkan tim untuk menjawab pertanyaan kunci: apakah sebuah fitur benar-benar meningkatkan pengalaman pengguna, atau hanya sekadar terasa berguna?
Menjadikan ablation sebagai praktik rekayasa rutin, alih-alih sebagai aktivitas penelitian satu kali, memiliki beberapa implikasi praktis. Pertama, sakelar ablation harus disuntikkan sangat awal di jalur startup—sebelum ada konstanta tingkat modul yang menangkap nilai konfigurasi—yang berarti infrastruktur ablation harus dirancang ke dalam arsitektur sistem sejak awal, tidak ditambahkan di kemudian hari. Kedua, menjalankan eksperimen ablation secara teratur (misalnya, sebelum setiap rilis utama) dapat mengungkap “feature debt”—fitur yang dulunya efektif tetapi tidak lagi diperlukan seiring berkembangnya model. Bagi tim mana pun yang membangun Agent produksi, praktik yang direkomendasikan adalah: Setiap fitur utama harus dapat dinonaktifkan secara independen, dan tim harus secara rutin memverifikasi kontribusi aktual dari setiap fitur tersebut.
Metodologi A/B Testing: Membedakan Mekanisme dari Tujuan
Produk Agent yang matang melakukan A/B testing yang ketat pada perilakunya sendiri (yakni, secara acak membagi pengguna ke dalam dua grup, satu menggunakan versi lama dan satu menggunakan versi baru, lalu membandingkan data aktual dari kedua grup untuk menentukan apakah suatu perubahan itu efektif). Kasus A/B test Agent yang dirancang dengan baik mengilustrasikan beberapa prinsip metodologi utama:
Beberapa varian (Multiple variants), tidak hanya perbandingan biner. Alih-alih hanya membandingkan “dengan” dan “tanpa”, rancang beberapa varian progresif (misalnya, ketika menguji kekuatan prompt constraints yang berbeda, siapkan kelompok kontrol dan tiga kelompok eksperimen dengan batasan yang secara progresif lebih ketat). Desain ini dapat mengungkap hubungan dosis-respons dan membantu menemukan titik optimal.
Membedakan metrik mekanisme dari metrik target. Ini adalah kesalahan yang paling mudah terjadi—memperlakukan apa yang Anda ubah sebagai target optimasi. Misalnya, jika Anda sedang menguji “mempersingkat panjang file rencana Agent”, panjang rencana adalah metrik mekanisme (sesuatu yang Anda ubah secara langsung), tetapi ini bukanlah targetnya. Target sebenarnya mungkin adalah “mengurangi biaya pada tingkat sesi”. Mempersingkat file rencana mungkin akan menurunkan biaya, tetapi hal itu juga dapat menyebabkan lebih banyak perulangan edit-check-edit akibat rencana yang kurang detail, sehingga meningkatkan total output. Selalu tanyakan pada diri sendiri: Apakah yang saya ubah (mekanisme) sama dengan apa yang benar-benar saya pedulikan (target)? Jika tidak, prioritaskan target.
Menetapkan metrik pagar pembatas (guardrail metrics). Bahkan jika metrik target membaik, eksperimen harus dihentikan jika kepuasan pengguna menurun, jumlah operasi meningkat, atau tingkat kesalahan naik. Metrik guardrail adalah ambang batas yang tidak dapat dinegosiasikan dan tidak boleh mengalami regresi.
Mencatat statistik baseline. Sertakan ukuran sampel, persentil distribusi, dan analisis korelasi (misalnya, “tingkat penolakan meningkat secara monoton seiring ukuran rencana”) untuk memberikan konteks yang diperlukan dalam menafsirkan hasil eksperimen. Tanpa sebuah baseline, Anda tidak dapat menentukan apakah hasil eksperimen tersebut signifikan secara statistik.
Sistem Feature Flag Dua Lapis
Produk Agent membutuhkan infrastruktur Feature Flag yang dirancang sejak hari pertama—Feature Flag adalah sakelar yang dapat dikendalikan dari jarak jauh yang menentukan apakah suatu fungsi diaktifkan atau dinonaktifkan bagi pengguna, tanpa memerlukan redeployment kode. Ia melayani tiga tujuan sekaligus: eksperimentasi, peluncuran bertahap (gradual rollout), dan pemutus sirkuit darurat (emergency circuit breaking).
Compile-time flags secara fisik menghapus kode yang relevan dari artefak build selama fase build. Fitur-fitur khusus internal sama sekali tidak akan ada di build eksternal—bahkan reverse engineering pun tidak dapat menemukan fungsionalitas yang dihapus tersebut. Ini juga memberikan mekanisme ablation yang bersih: menonaktifkan suatu fitur tidak sekadar melewati logika pada runtime; kode yang terkait secara fisik tidak ada.
Runtime flags memiliki konfigurasinya yang dikirimkan oleh server dan disimpan dalam cache lokal di dalam disk. Desain ini memprioritaskan membaca konfigurasi cache yang sedikit basi (stale) alih-alih memblokir startup Agent selagi menunggu network request. Keputusan pengelompokan tertentu dibuat melalui platform eksperimen (misalnya, GrowthBook) untuk menetapkan grup A/B test. Detail desain utama di sini adalah exposure event dari setiap fitur dicatat maksimal satu kali per sesi untuk menghindari data eksperimen yang tercemar oleh duplikasi catatan.
Pelajaran bagi para pengembang Agent: Feature Flag bukanlah alat debugging; mereka adalah komponen arsitektural kelas satu (first-class architectural components).
Penilaian Sensitivitas Prompt
System Prompt adalah “kode” inti dari perilaku Agent, namun ia sering kali tidak memiliki version control dan pengujian regresi (regression testing) yang biasanya ada pada kode reguler. Pendekatan OpenClaw adalah menyediakan tool khusus yang dapat mengekstrak System Prompt yang telah dirender sepenuhnya pada Git revision atau commit tertentu—termasuk teks akhir setelah semua kondisi dinamis diperluas. Ini memungkinkan tim untuk menjawab dengan tepat: Commit mana yang mengubah Prompt? Apa dampaknya pada set evaluasi?
Untuk tim Agent mana pun, praktik yang disarankan adalah: (1) System Prompt harus dapat dirender secara deterministik (diberikan input konfigurasi yang sama, ia selalu menghasilkan output yang sama); (2) Tetapkan mekanisme snapshot berversi untuk Prompt; (3) Setiap perubahan Prompt harus menjalankan pengujian regresi pada set evaluasi—sama halnya perubahan kode yang memerlukan CI.
Analitik Sadar Privasi (Privacy-Aware Analytics) sebagai Dasar Evaluasi
Evaluasi bergantung pada data yang baik, tetapi produk Agent sering kali menangani konten pengguna yang sensitif. OpenClaw memecahkan kontradiksi ini melalui type system: antarmuka analitik hanya menerima nilai yang dibungkus dalam tipe khusus, di mana nama tipe itu sendiri berfungsi sebagai jejak audit (audit trail)—ia secara eksplisit menyatakan “Saya telah memverifikasi bahwa ini bukan kode atau path file.” Desain ini mengubah kendala privasi dari spesifikasi yang didokumentasikan menjadi pemeriksaan tipe (type checks) yang dipaksakan pada saat kompilasi.
Prinsip intinya adalah: Rancang kendala privasi ke dalam sistem sejak awal; jangan menambahkannya di akhir. Jika sistem analitik Anda tidak dapat mengumpulkan data dengan aman, Anda tidak dapat mengevaluasi secara efektif. Privasi dan evaluasi bukanlah kekuatan yang saling berlawanan—desain privacy-aware memaksa Anda untuk berpikir dengan cermat tentang apa yang benar-benar perlu diukur, yang pada gilirannya mendorong metrik evaluasi yang lebih tepat.
Dari Eksternal ke Internal: Pergeseran dalam Pemikiran Evaluasi
Pesan inti dari bagian ini adalah: Bagian-bagian sebelumnya telah mengajarkan Anda cara mengevaluasi sebuah Agent secara eksternal; bagian ini mengungkapkan bagaimana produk Agent terbaik mengevaluasi dirinya sendiri secara internal. Evaluasi eksternal memberi tahu Anda “seberapa baik Agent tersebut”; infrastruktur evaluasi internal memberi tahu Anda “perubahan mana yang membuatnya menjadi lebih baik”. Eksperimen ablation menemukan fitur mana yang benar-benar penting, A/B testing mengkuantifikasi dampak dari setiap perubahan, Feature Flag menyediakan infrastruktur untuk eksperimentasi dan rollback, penilaian sensitivitas Prompt mengintegrasikan System Prompt ke dalam sistem CI, dan analitik sadar privasi memastikan kepatuhan dalam pengumpulan data. Kelima komponen ini secara bersama-sama membentuk rekayasa produk yang digerakkan oleh evaluasi (evaluation-driven product engineering)—bukan mengevaluasi sesekali, melainkan menanamkan evaluasi ke dalam setiap keputusan produk.
Lingkungan Simulasi (Simulation Environments): Jembatan dari Evaluasi ke Post-Training
Titik akhir dari evaluasi bukanlah penskoran, melainkan perbaikan. Bab ini telah mendemonstrasikan dua jalur untuk perbaikan: menyesuaikan Harness (dari laporan Benchmark menjadi perbaikan sistem) dan menanamkan evaluasi ke dalam rekayasa produk (infrastruktur evaluasi internal). Bentuk perbaikan terkuat adalah pelatihan (training)—ketika tujuannya meluas dari “mengevaluasi kemampuan yang ada” menjadi “menumbuhkan kemampuan baru”, terutama melalui teknik post-training yang dibahas pada Bab 8, lingkungan evaluasi perlu berevolusi menjadi lingkungan simulasi (simulation environment): taman bermain virtual di mana Agent dapat berlatih berulang kali dan diberi skor secara otomatis. Perbedaan inti antara lingkungan simulasi dan lingkungan evaluasi adalah: frekuensi interaksi yang jauh lebih tinggi (jutaan vs ribuan), kebutuhan akan pengacakan (randomization - untuk mencegah menghafal konfigurasi tertentu), dan persyaratan untuk umpan balik langsung. Dari perspektif aplikasi, lingkungan simulasi dibagi menjadi dua kategori: lingkungan digital (tugas pemrosesan informasi) dan lingkungan berwujud fisik (embodied environments - persepsi dan manipulasi dunia fisik).
Beginilah cara dua ujung jembatan ini bertemu. Aset-aset yang terakumulasi di sisi evaluasi dikonversi hampir tanpa hambatan menjadi sinyal pelatihan: Rubric atau validator yang terdefinisi dengan baik pada dasarnya adalah fungsi reward untuk Reinforcement Learning with Verifiable Rewards (RLVR)—skrip penskoran menjadi skrip reward; apakah sebuah pengujian lulus atau suatu state memenuhi standar, berfungsi baik sebagai kriteria evaluasi maupun sebagai reward untuk reinforcement learning. Namun pelatihan membawa tuntutan yang tidak pernah perlu dikhawatirkan oleh evaluasi. Yang pertama adalah semantik reset yang andal (reliable reset semantics): pelatihan menjalankan jutaan episode (sebuah episode adalah satu ronde interaksi yang lengkap dari status awal hingga penyelesaian tugas), dan setiap episode harus mampu me-reset lingkungan ke kondisi awal yang bersih dan deterministik; jika tidak, sinyal gradien akan terkontaminasi oleh status sisa dari episode sebelumnya. Yang kedua adalah throughput yang jauh melebihi evaluasi: beberapa ribu evaluasi sudah cukup untuk menarik kesimpulan, tetapi pelatihan memerlukan model untuk diumpankan jutaan interaksi dalam wall-clock time yang dapat diterima; tingkat paralelisme lingkungan dan overhead per instance secara langsung menentukan apakah pelatihan tersebut layak. Kedua hal ini—validator yang diubah menjadi reward function, serta reset dan throughput tingkat pelatihan (training-grade)—akan diuraikan di Bab 8.
Gambar 7-9: Spektrum Fidelitas Simulasi · Gambar sumber
Di sisi lingkungan digital, framework AWorld membangun sandbox MCP server yang dapat dikontrol untuk tugas-tugas GAIA, menyediakan 26 MCP server yang mencakup 126 fungsi tool, menghindari larangan akses (bans) dan efek samping yang tidak dapat dikontrol dari mengakses API nyata secara langsung. Semua pemanggilan tool bersifat replayable dan dapat diaudit. Arsitektur terdistribusi AWorld mengurangi waktu eksekusi serial tradisional dari 7695 detik menjadi 525 detik (percepatan 14.6x), dan desain stateless pada lingkungan tersebut membuat setiap instance sepenuhnya independen, mendukung paralelisme yang efisien.
Di sisi lingkungan berwujud fisik (embodied environment), RoboTwin2 membangun tugas-tugas manipulasi lengan ganda berdasarkan pada mesin fisika (physics engine), mengacak posisi objek, orientasi, dan tampilan untuk meningkatkan generalisasi. Ruang observasinya (observation space) mencakup visual multi-kamera dan joint states, mencapai kontrol real-time melalui Action Chunking—di mana model merencanakan beberapa tindakan berurutan sekaligus (dirinci pada Bab 6). OSWorld menyediakan kemampuan reset melalui virtual machine snapshots, dan AndroidWorld berfokus pada otomatisasi aplikasi seluler. Baik digital maupun berwujud fisik, lingkungan simulasi juga memerlukan lingkungan eksekusi terisolasi dan mekanisme identitas virtual yang dibahas di Bab 4 (isolasi VM/container, proksi residensial, autentikasi Human-in-the-Loop, shared file systems), yang tidak akan diulangi di sini.
Eksperimen 7-14 ★★: Mengonfigurasi Lingkungan Kecerdasan Terwujud (Embodied Intelligence Environment) untuk OpenVLA dan RoboTwin2
Siapkan lingkungan simulasi untuk manipulasi robot. Baca ch7/SimpleVLA-RL dan dokumentasi OpenVLA untuk memahami arsitektur dari model Vision-Language-Action (integrasi end-to-end dari vision encoder, language model, dan action decoder, yang memproyeksikan gambar dan teks ke dalam ruang semantik bersama). Konfigurasikan lingkungan RoboTwin2, pahami observation space (tiga pandangan RGB + 14-dimensi joint state) dan action space (14-dimensi vektor kontrol). Pelajari mekanisme pengacakan lingkungan dan logika batasan spasial dalam move_can_pot. Evaluasi model prapelatihan (pretrained model), catat tingkat keberhasilannya, waktu penyelesaian, dan mode kegagalan, dengan fokus pada dampak dari mekanisme action chunking.
Gambar 7-10: Lingkungan Kecerdasan Terwujud OpenVLA dan RoboTwin2 · Gambar sumber
Pertukaran Fidelity dan Domain Randomization
Lingkungan high-fidelity mendukung transfer yang lebih baik ke dunia nyata tetapi memiliki biaya komputasi yang tinggi. Dimensi fidelity lainnya adalah tingkat pengacakan: pengacakan moderat meningkatkan generalisasi, sementara pengacakan yang berlebihan dapat membuat tugas menjadi terlalu sulit. Domain Randomization adalah teknik kunci untuk mempersempit kesenjangan sim-to-real: memperkenalkan berbagai variasi acak dalam parameter fisik, tampilan visual, sensor noise, dll.—seperti berlatih menggenggam di bawah berbagai pencahayaan dan sudut, sehingga Anda tidak akan gagal di dunia nyata hanya karena cahaya berubah. Di lingkungan digital, sim-to-real berwujud fisik sebagai perbedaan dalam rendering interface, waktu respons, dll., yang dapat dimitigasi dengan memperkenalkan pengacakan dalam latency dan kegagalan.
Ringkasan Bab
Bab ini berpusat pada satu pertanyaan: bagaimana kita tahu bahwa Agent benar-benar membaik? Rantainya terdiri atas empat tahap: pertama menjernihkan apa yang dihitung sebagai keberhasilan (perbedaan basis Pass@k, Best@k, dan Pass consecutive@k), lalu menetapkan dari mana tugas berasal (benchmark publik, himpunan bisnis buatan sendiri, dan aliran balik trajectory produksi), kemudian memilih cara verifikasi (dari verifier deterministik ke daftar pemeriksaan, Rubric dengan penilaian LLM, hingga perbandingan berpasangan), dan akhirnya mengubah skor menjadi keputusan (signifikansi statistik, atribusi kegagalan, tugas regresi, dan pemilihan model). Setiap tahap menentukan keandalan kesimpulan. Eksperimen nyata memberi empat peringatan tambahan: menggabungkan memori terstruktur dan RAG tidak menjamin sinergi; penghematan cache dan kompresi tidak dapat dijumlahkan; pilihan audio referensi mengubah makna skor multimodal; dan kemampuan Agent membaca UI beserta biaya token-nya bergantung pada cara Harness menyajikan input. Model selection harus membandingkan kurva kemampuan pada berbagai anggaran, bukan satu titik. Evaluasi produksi adalah validasi berkelanjutan yang tertanam dalam keputusan produk.
Dilihat dari struktur buku secara keseluruhan, bab ini membangun ruas bukti dalam lingkar penemuan Bab 1: atribusi kegagalan menentukan apakah usulan berikutnya punya pijakan yang kukuh.
Evaluasi batas pada prefiks trajektori lebih jauh menunjukkan bahwa memperoleh sepotong informasi dan menggunakannya dengan benar pada keputusan saat ini adalah dua kemampuan yang berbeda: regresi ujung-ke-ujung menjamin tugas dasar tidak merosot, sedangkan himpunan batas prefiks trajektori langsung memeriksa penilaian cakupan, penimpaan oleh instruksi terkini, permintaan klarifikasi, dan konfirmasi sebelum tindakan berbahaya. Memori pengguna hanyalah satu kasus dari metode umum ini. Evaluasi Agent tingkat produksi bukan ujian yang sesekali digelar, melainkan sistem verifikasi yang terus-menerus menghasilkan tugas regresi dan tugas batas dari kasus masalah nyata.
Metodologi inti: Observe → Hypothesize → Experiment → Validate → New Understanding → New Hypothesis, mengubah Agent engineering dari “alkimia” yang didorong pengalaman menjadi rekayasa ilmiah yang didorong oleh data.
Sistem evaluasi yang diperkenalkan dalam bab ini membentuk closed loop yang lengkap: Evaluation Environment menyediakan infrastruktur pengujian otomatis → Evaluation Dataset mendefinisikan test cases → Automated Evaluation Methods (LLM-as-a-Judge dan Rubric) menilai kinerja Agent → Benchmark Analysis mengungkapkan arah peningkatan → System Improvements memperbaiki masalah → Memperbarui lingkungan evaluasi dan dataset, memulai siklus iterasi baru.
Sistem evaluasi yang ditetapkan di sini tidak hanya mendukung optimasi sistem saat ini tetapi juga memberikan landasan penting untuk dua bab berikutnya. Bab 8 mengubah lingkungan dan data evaluasi menjadi input untuk post-training model, menggunakan SFT dan RL untuk menulis interaction policies ke dalam parameter. Bab 9 mengubah evaluasi multidimensi dari lintasan produksi menjadi kandidat pembaruan untuk pengetahuan, instruksi, program, atau parameter.
Pertanyaan Pemikiran
★★ LLM-as-a-Judge menggunakan language model untuk mengevaluasi output dari language model. Apakah “evaluasi diri” ini memiliki blind spots sistematis—misalnya, model mungkin secara konsisten memberikan skor tinggi pada gaya respons tertentu, sebuah preferensi yang tidak konsisten dengan penilaian manusia? Bagaimana bias semacam itu dapat dideteksi dan dikoreksi?
★★★ Desain “leakage-proof” dari evaluation datasets sangat penting. Namun, dalam ekosistem open-source, begitu data benchmark dipublikasikan, data tersebut dengan cepat dimasukkan ke dalam training data. Apakah “permainan kucing dan tikus” ini memiliki akhir? Rancang metode evaluasi yang secara fundamental menolak data leakage.
★★ Empat kriteria Scale AI (panduan ahli, cakupan komprehensif, pembobotan tingkat kepentingan standar, evaluasi mandiri) bertujuan untuk menghilangkan subjektivitas dalam evaluasi. Namun, dimensi tugas tertentu (misalnya, “Apakah jawabannya membantu?” “Apakah nadanya sesuai?”) pada dasarnya bersifat subjektif. Bagaimana Rubric yang andal dapat dirancang untuk dimensi subjektif ini?
★★ τ-bench mengevaluasi Agent dengan mensimulasikan perilaku pengguna nyata. Tetapi simulated user itu sendiri adalah LLM—ia mungkin secara sistematis meremehkan edge cases tertentu (misalnya, pengguna yang gelisah secara emosional atau tidak jelas). Bagaimana kualitas dari simulated user itu sendiri dapat divalidasi?
★★ Perbandingan berpasangan (model Bradley-Terry) mengasumsikan preferensi bersifat transitif (jika A > B dan B > C, maka A > C). Namun, preferensi manusia sering melanggar transitivitas. Dalam evaluasi Agent, di skenario manakah preferensi non-transitif mungkin muncul? Bagaimana hal ini memengaruhi keandalan rankings?
★★ Bab ini membedakan Pass@k sebagai batas atas kemampuan dari Pass consecutive@k sebagai ukuran keandalan bisnis. Untuk sebuah Agent yang tingkat keberhasilan sekali jalannya hanya 60%, bagaimana Anda menggabungkan biaya kegagalan, biaya percobaan ulang, dan efek samping tugas untuk memutuskan metrik mana yang dilaporkan dan seberapa besar k?
★★ Bab ini mengusulkan metode ilmiah “Observe → Hypothesize → Experiment → Validate.” Namun dalam praktiknya, ruang perilaku Agent sangat luas, dan memvalidasi satu hipotesis mungkin memerlukan ratusan proses evaluasi. Bagaimana informasi yang diperoleh dari evaluasi dapat dimaksimalkan di bawah anggaran komputasi yang terbatas?
★ Dalam pilot AndroidWorld, pohon elemen lengkap menaikkan keberhasilan dari 25% ke 100%, tetapi penggunaan token menjadi 2.498× control; setelah diringkas, keberhasilan tetap 100% dan token turun menjadi 0.506×. Bagaimana merancang aturan pemangkasan otomatis yang membuang node UI tanpa makna tanpa menghilangkan informasi untuk aksesibilitas, verifikasi keadaan, atau tindakan berikutnya?
★★ Simulasi pengguna τ-bench menggunakan pengungkapan informasi progresif (progressive information disclosure)—tidak memberikan semua informasi sekaligus, tetapi secara bertahap mengungkapkannya berdasarkan pertanyaan Agent. Bagaimana desain ini memengaruhi hasil evaluasi? Jika strategi pengungkapan informasi dari simulated user berbeda secara signifikan dari pengguna nyata, apakah kesimpulan evaluasinya masih andal?
Catatan kaki
Wijk, Hjalmar, et al. RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts. arXiv:2411.15114, 2025. ↩
Terapkan dalam praktik
Eksperimen pendamping
Jelajahi eksperimen pendamping bab ini dan lihat penerapan ide-ide ini dalam kode.