第 5 章 運算子與執行時
同一份輸入,剛用於一個輸出,接著又要用於旁邊的輸出:若仍留在計算單元附近,下一次就可以直接使用;若已經換走,就要重新搬來。矩陣乘法的程式需要安排這些使用次序,並給輸入和部分和留下合適的空間。僅僅改變一次處理多少輸出、先算哪一塊,就會改變重複搬移的次數,以及能夠同時執行的任務數。
本章的矩陣乘算例需要約 103 GFLOPs 的運算,輸入、權重和輸出總共佔 128 MiB,一種分塊實作的讀寫量卻達到約 3 GiB。擴大輸出塊可以讓輸入多用幾次,把讀寫量減半,但每個塊的區域性儲存需求也從 24 KiB 增至 80 KiB。有了這些數字,就能判斷減少搬移節省的時間,能否抵消同時執行的塊數變少帶來的損失。
第 4 章介紹了加速器的計算能力、儲存容量和資料傳輸頻寬。本章討論程式如何利用這些資源。以一段 FFN 為例,先說明主機如何發起計算、加速器如何完成任務,再分析矩陣乘的迴圈與分塊,以及相鄰運算子如何共享中間結果。隨後討論編譯器和執行時如何實作這些最佳化,最後計算這些最佳化能讓完整請求節省多少時間。
本章主要使用 Qwen3-8B 的 FFN 作為算例:隱藏寬度 \(H=4096\),FFN 中間寬度 \(F=12288\)。先同時處理 \(M=1024\) 個 token,將各 token 的 4096 維特徵向量排成輸入矩陣 X,計算一支投影 \(C=XW\);X、W 和 C 使用 BF16,每個元素佔 2 bytes,矩陣乘使用 FP32 累加。M 表示一次呼叫處理的 token 數,每個 token 對應輸入矩陣的一行。這些 token 可以來自 prefill 的一段輸入,也可以來自同一批中的多個請求;單請求逐 token decode 時,M 為 1。1
| 物件 | 形狀 | 大小 | 在計算中的作用 |
|---|---|---|---|
| 輸入 X | \([1024,4096]\) | 8 MiB | 每個 token 的特徵向量佔一行,投影后得到該 token 的新特徵向量 |
| 權重 W | \([4096,12288]\) | 96 MiB | 由 1024 個 token 的投影計算共享 |
| 投影 C | \([1024,12288]\) | 24 MiB | 隨後做活化函數等處理 |
本章圍繞三個問題展開:哪些工作在重複執行,哪些資料能夠複用,哪些計算或等待決定了總時間。回答這些問題時,程式在加速器上的執行單位是 kernel。分析讀寫量、緩衝容量和 kernel 數,可以瞭解程式做了多少工作;再結合這些工作的執行順序,才能計算程式需要多長時間。
5.1 加速器執行過程中的提交、搬移與同步
先考慮輸入和輸出都在 CPU 記憶體中的矩陣乘。CPU 準備輸入,將輸入送入 GPU,發起計算,再取回結果。這一過程需要兩個處理器協作。理解兩者何時獨立執行、何時等待對方,是後續融合、流水和圖重放的基礎。
5.1.1 從框架呼叫到 kernel launch
PyTorch 是表達張量運算並組織模型執行的軟體框架。呼叫其矩陣乘法時,CPU 首先執行框架程式碼:讀取張量形狀和資料型別,選擇實作,準備地址和參數,再透過執行時與驅動向 GPU 提交任務。向加速器發起一次 kernel 執行稱為 kernel launch。執行時負責提交任務、管理記憶體和同步執行;編譯器則事先或在首次呼叫時生成加速器程式碼。
這裡有三個層次:運算子描述數學工作,例如矩陣乘和活化函數運算;kernel 在加速器上完成這項工作;launch 是 CPU 發起這次執行的動作。一個矩陣乘可以由多個 kernel 完成,幾個逐元素運算子也可以由同一個 kernel 完成。因此,既可以最佳化加速器上的計算,也可以減少主機準備和提交任務的開銷。
CUDA 執行一個 kernel 時會啟動多個執行緒。若干執行緒組成一個執行緒塊(thread block),所有執行緒塊組成一個執行緒網格(grid)。矩陣乘通常把輸出矩陣分成多個 tile,交給不同執行緒塊計算,塊內執行緒協作讀取輸入並累加結果。加速器將執行緒塊安排到有可用資源的 SM 上。較早完成的塊釋放資源,後續塊便可開始;因此,grid 中的執行緒塊可以分批執行。
kernel launch 採用非同步提交。呼叫回傳時,CPU 已完成這次提交,GPU 則按照任務佇列和依賴關係執行。CPU 可以立即準備下一項任務。只有當 CPU 要用加速器的結果,或者要覆蓋加速器還在使用的資料時,CPU 才需要等相應的加速器操作完成。30
這種分工形成一條簡單流水:CPU 準備並提交任務,GPU 執行任務。大矩陣計算持續較久,CPU 有時間準備下一次呼叫;小運算子迅速結束,GPU 更容易執行完佇列中的任務,停下來等待 CPU 提交下一項。因此,可以從兩方面加速:減少加速器等待主機的時間,以及縮短 kernel 本身的執行時間。
5.1.2 主機與加速器之間的資料複製
CPU 能夠提前提交下一項任務,加速器卻只有在輸入到達後才能計算。先分析資料的傳輸過程,就能看清提交任務後、開始計算前還需要完成哪些工作。除了第 4 章介紹的 H2D 與 D2H,有獨立視訊記憶體的 GPU 還常在視訊記憶體內部複製,常見的複製方向有三種:
| 名稱 | 複製方向 | 典型物件 |
|---|---|---|
| H2D | 主機記憶體 → 視訊記憶體 | 當前 batch 的輸入張量 |
| D2H | 視訊記憶體 → 主機記憶體 | CPU 要使用的計算結果 |
| D2D | 視訊記憶體 → 視訊記憶體 | 固定輸入緩衝或重排結果 |
上述矩陣乘的執行過程是:
CPU 準備輸入 → H2D → GPU 計算 → D2H → CPU 使用結果。
圖 5-1 畫出這些資料在兩側記憶體中的位置和複製方向。
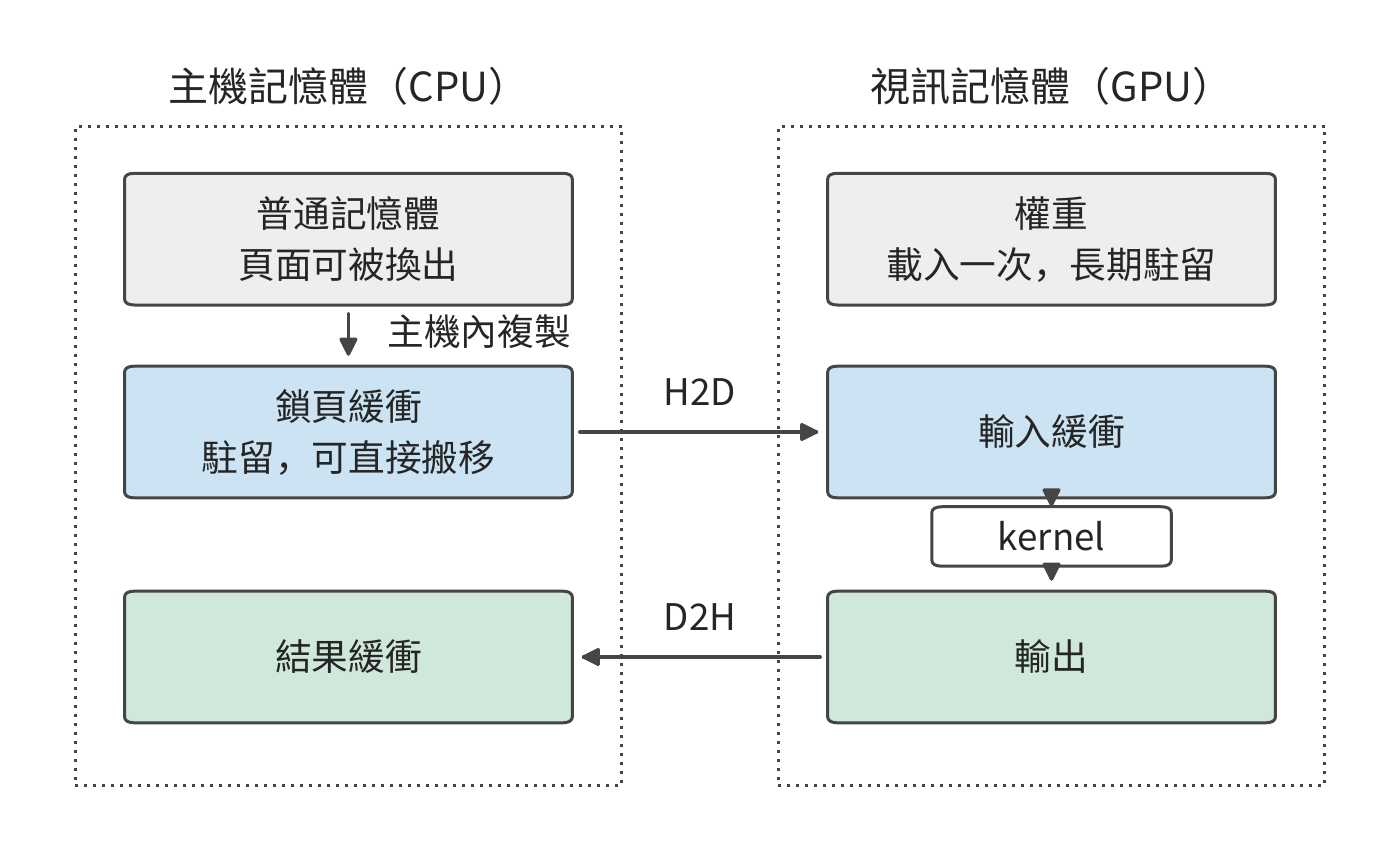
圖 5-1:H2D 把輸入從主機的鎖頁緩衝搬進視訊記憶體,D2H 把結果搬回主機;權重載入一次後留在視訊記憶體,kernel 直接讀取視訊記憶體中的輸入並寫出輸出。普通記憶體中的資料要先複製到鎖頁緩衝,才能由複製引擎直接搬移。
執行完整模型時,並非每次呼叫都要重新傳入所有資料。權重載入後可以一直保留在視訊記憶體中,層間活化值可以由下一個 kernel 直接讀取,KV 也可以在後續 decode 步中繼續使用。如果取樣在 GPU 上完成,CPU 只需接收少量 token ID。因此,主機與加速器之間的複製次數,與加速器內部的讀取次數並不相同:一份權重可以只傳入一次,卻在加速器上讀取多次。
例 5-1:主機到 GPU 的輸入傳輸需要多久? \([8192,4096]\) 的 BF16 張量佔 \(8192\times4096\times2=64\) MiB。RTX PRO 6000 經 PCIe Gen5 x16 接到主機,每個方向的標稱頻寬為 64 GB/s,32傳輸時間為:
將輸入分成兩份 32 MiB 張量,每份約需 0.52 ms,總傳輸量保持不變。這樣做的好處是第一份資料可以更早到達:GPU 開始計算前半批時,複製引擎繼續傳送後半批。第 5.3 節將進一步計算傳輸與計算重疊後的總時間。8
主機記憶體的型別也影響複製過程。普通記憶體的頁面由作業系統管理;鎖頁記憶體(pinned memory)在使用期間保持駐留,便於加速器直接搬移。從普通記憶體傳輸資料時,執行時常先將資料複製到內部的鎖頁緩衝:CPU 先複製一遍,再由加速器讀取。這就是圖 5-1 左側的主機內複製。若每批都把 64 MiB 資料複製進新建的鎖頁緩衝,就在 H2D 之前多做了一次主機複製。讓 CPU 直接在可複用的鎖頁緩衝中準備輸入,可以省去這次中轉和反覆分配。30
5.1.3 stream、event 與完成順序
資料傳到哪裡,決定哪個處理器能夠使用它;資料何時傳完,則決定後續計算何時能夠開始。非同步呼叫回傳後,複製可能仍在進行,需要用執行順序保證計算不會讀到尚未傳完的輸入。CUDA 的 stream(流)是一串按順序執行的加速器任務。把 H2D 和讀取該輸入的 kernel 放在同一 stream 中,計算就排在複製之後;CPU 可以連續提交兩項工作。
若複製和計算放在不同 stream 中,就用 event(事件)指定跨流的執行順序。複製流在 H2D 後記錄事件,計算流等待事件,再使用這份輸入。等待發生在計算流的加速器任務序列中,CPU 仍可繼續提交其他工作。
圖 5-2 把兩條流和兩個事件畫在同一條時間線上。
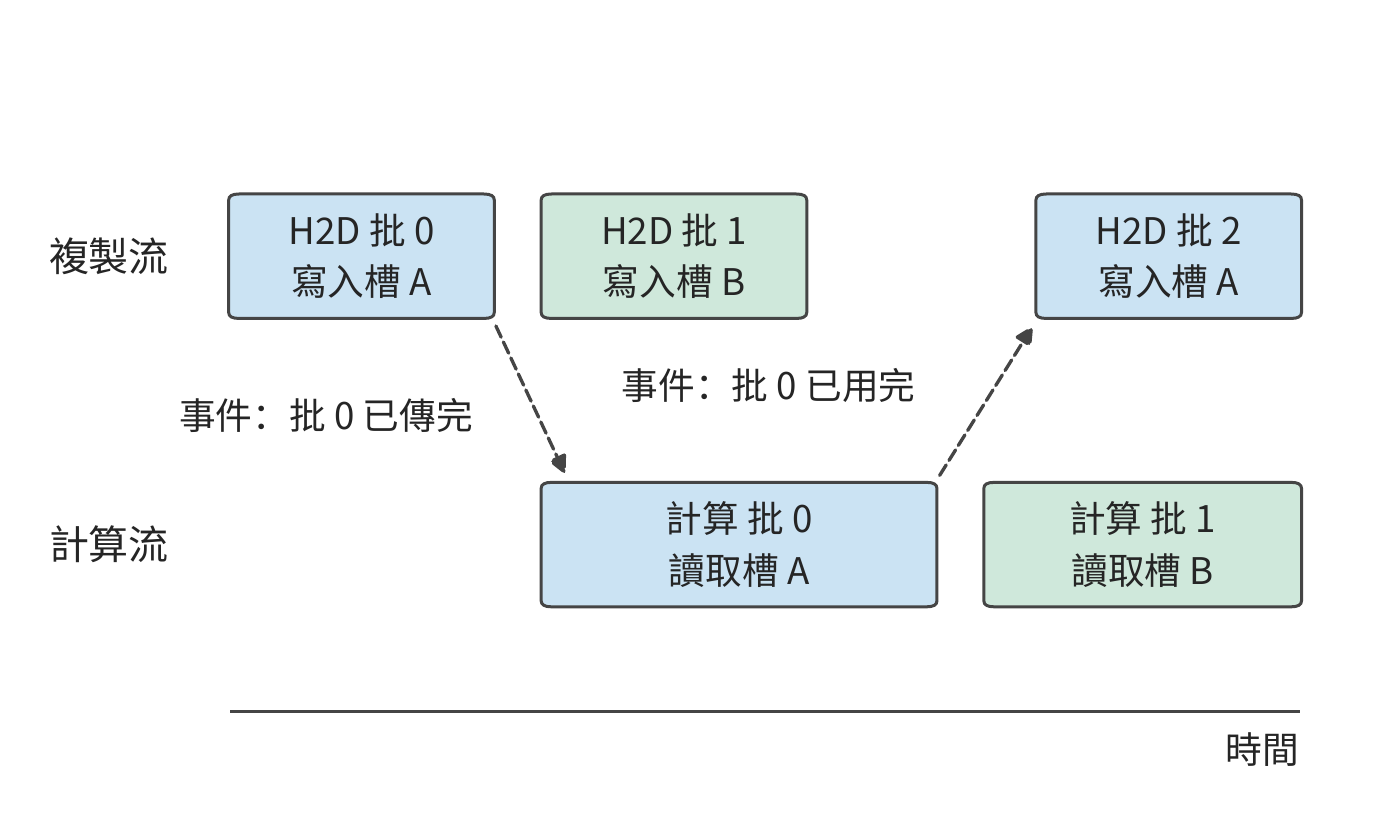
圖 5-2:複製流依次傳入各批輸入,計算流讀取它們。計算批 0 要等「批 0 已傳完」事件;批 2 要重新寫入槽 A,必須等「批 0 已用完」事件。虛線箭頭表示等待事件,不搬移資料。兩個槽的交替使用在第 5.3.2 節展開。
事件也可以用來確定緩衝何時能夠再次使用。設當前輸入從主機緩衝複製到 GPU 的緩衝槽 A。複製完成後,CPU 就可以往主機緩衝寫入下一批輸入;槽 A 則要等 GPU 用完當前輸入後才能覆蓋。兩塊緩衝雖然儲存同一批資料,卻要在不同的時刻才能重新使用。
| 緩衝 | 最後使用者 | 隨後的動作 |
|---|---|---|
| H2D 的主機源緩衝 | 複製引擎讀取 | CPU 寫入下一批輸入 |
| GPU 輸入緩衝 | 讀取該輸入的 kernel | 複製引擎寫入下一批輸入 |
| D2H 的加速器源緩衝 | 複製引擎讀取 | GPU 寫入新結果 |
| D2H 的主機目標緩衝 | 複製引擎寫入 | CPU 讀取當前結果 |
因此,應在最後一次讀寫之後記錄事件,讓隨後使用這塊緩衝的操作等待該事件。CPU 需要 D2H 結果時,可以等待對應事件;其他無關的加速器任務繼續執行。第 5.3 節的雙緩衝正是把兩套這樣的使用順序交錯起來。
這套順序也解釋了程式為什麼會停住不動。每一次等待都指向一個具體的事件,只要該事件始終未被記錄,等待就不會結束;表現出來是程式停住,而不是變慢。上表中四塊緩衝各自的最後使用者,就是四個容易漏記的事件:漏掉 GPU 輸入緩衝的「已用完」事件,複製引擎就一直不能寫入下一批。跨流的迴圈等待也一樣:A 流等 B 流記錄的事件,B 流的這項任務又排在 A 流尚未完成的工作之後,兩條流都不會前進。多卡執行還多一種來源:集合通訊要求參與的每張卡都發起同一次呼叫,只要有一張卡少發起一次,其餘的卡就會一直等待這個不會到來的對端(第 6.4 節)。
排查時先看被等的那一側是否還在前進:仍有結果產出,就只是慢,應回到第 5.1.4 節的時間線逐段計時;完全不動,才是在等一個不會到來的事件,第 10.4.5 節的慢節點屬於前一種。為等待設定超時,超時後列印各流尚未完成的任務,就能確定缺的是哪個事件。
5.1.4 從提交時間到結果可用時間
把複製、計算和緩衝使用的順序連起來,才能確定結果何時可用。圖 5-3 將這一順序畫成時間線。
例 5-2:為什麼提交耗時、加速器耗時與完整呼叫耗時不同? 輸入已在主機準備好。CPU 在 0–3 μs 內提交全部任務,第一項加速器工作從 3 μs 開始;H2D、kernel、D2H 分別用 8、20、4 μs,加速器按依賴連續執行。
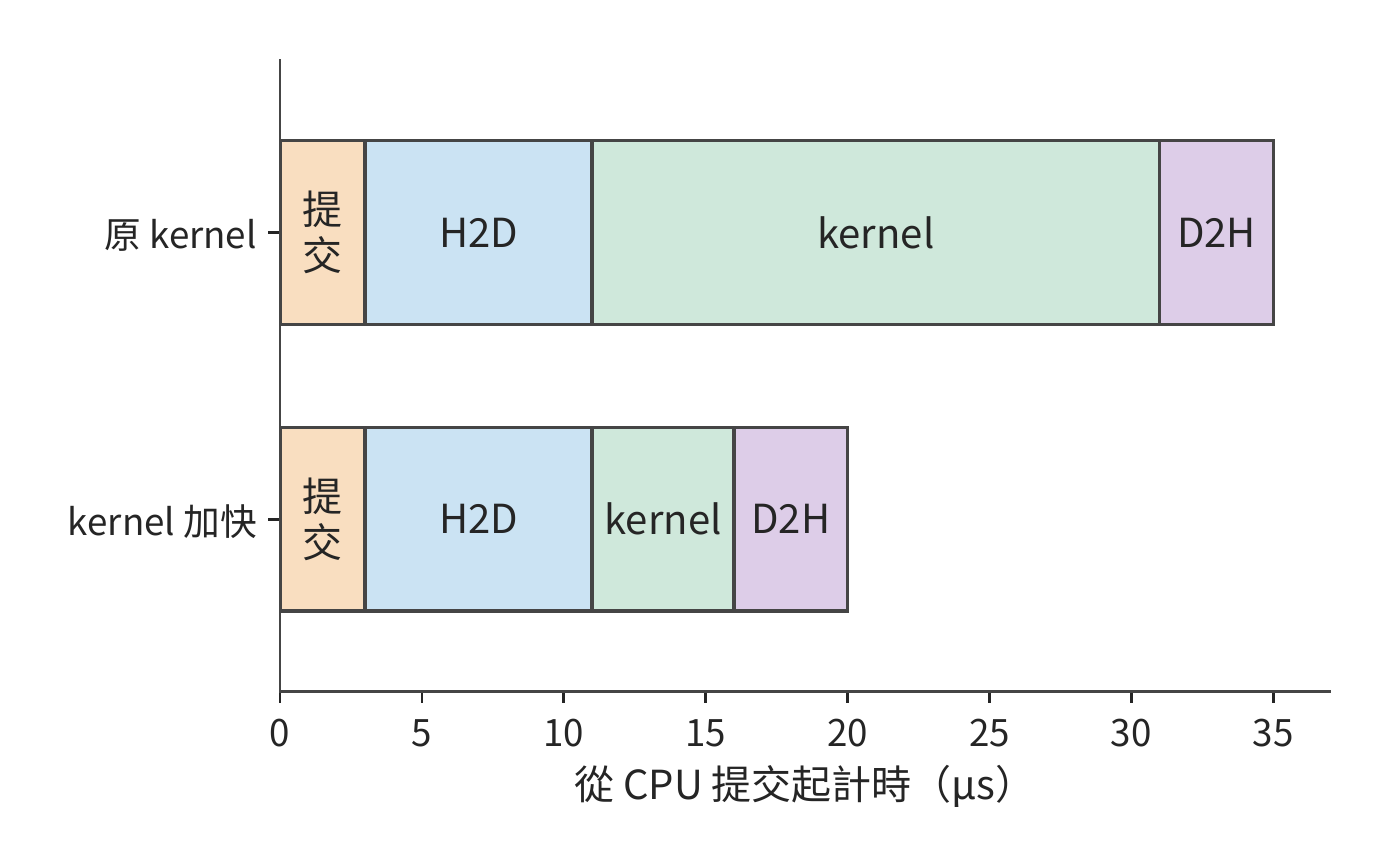
圖 5-3:CPU 提交、H2D 輸入複製、kernel 執行與 D2H 結果回傳依次發生。上方 kernel 執行 20 μs,結果在第 35 μs 可用;下方 kernel 執行 5 μs,結果在第 20 μs 可用。
CPU 提交任務用時 3 μs,kernel 執行用時 20 μs,CPU 到第 35 μs 才能使用結果。若把 kernel 的執行時間從 20 μs 縮短到 5 μs,結果就能在 \(3+8+5+4=20\) μs 時使用。kernel 速度提高到原來的四倍,整次執行則從 35 μs 降至 20 μs,加速比約為 1.8;剩餘 15 μs 由提交和複製構成。
例 5-2 問到的三種耗時,正對應三種計時位置。測量結果取決於在什麼位置開始和結束計時。在非同步呼叫前後讀取 CPU 時鐘,測得提交所用的時間;若在結束計時前等待結果,則測得從發起到完成的時間。CUDA event 在加速器任務序列中標出起止位置,測得加速器執行這段任務所用的時間。效能分析工具(profiler)把主機呼叫、加速器計算和複製畫在同一條時間線上,提交之後的排隊、依賴等待和執行就能逐段看清。
圖 5-3 的時間線從輸入準備好開始。若程式尚未編譯,時間線之前還要加上一次準備工作:首次呼叫可能需要編譯程式碼或分配工作區。假設首次編譯用 100 ms,隨後每次執行 1 ms,呼叫一次共 101 ms,呼叫 100 次共 200 ms,平均每次 2 ms。呼叫次數越多,平均分攤的編譯時間越少,而每次執行所需的 1 ms 保持不變。第 5.5 節將用同一方法判斷分桶(把輸入補齊到少數代表形狀)和特化(為具體形狀生成專門程式)需要重複多少次才值得。
5.1.5 一個 kernel 在 SM 上如何執行
圖 5-3 把 kernel 畫成一段 20 μs 的整體;它能否縮短到 5 μs,取決於這段時間裡 SM 上發生了什麼。本節固定一個 kernel,沿執行緒、駐留、訪存、矩陣指令和同步五步,推導其在一個 SM 上如何執行。kernel 取第 4.3.2 節的乘加塊:輸出塊 128×128,沿 K 每步 64;BF16 的 A 塊與 W 塊各 16 KiB,FP32 累加器 64 KiB,三者都放在共享記憶體中,構成工作集(計算期間必須同時留在區域性儲存中的資料),共 96 KiB。一個執行緒塊負責一個輸出塊,含 256 個執行緒。硬體取 H100 的一個 SM:最多同時駐留 2048 個執行緒(即 64 個 warp,warp 在下文解釋)和 32 個執行緒塊,暫存器 64K 個(每個 32 位),共享記憶體 228 KB(CUDA 文件的寫法,即 233,472 bytes)。kernel 每執行緒用 128 個暫存器,每條載入指令每執行緒取 16 bytes,每個 warp 最多掛起 4 條未完成的載入,矩陣指令形狀為 16×8×16,視訊記憶體延遲取 600 ns。29
warp:一起發射的 32 個執行緒。 SM 不逐個執行緒發射指令,而是把 32 個執行緒編成一組,一起發射,這一組稱為 warp。同一 warp 的 32 個執行緒執行同一條指令,各自處理不同的資料;一條載入指令因此一次給出 32 個地址。256 個執行緒的執行緒塊含 8 個 warp。第 5.2.3 節分析共享記憶體 bank(儲存體,共享記憶體中可獨立服務請求的分割槽)時所說的 32 個 lane,就是一個 warp 中的 32 個執行緒:它們同時給出的 32 個地址落在多少個 bank 上,決定這條指令要佔用共享記憶體介面幾輪。
駐留與佔用率。 執行緒塊要在 SM 上駐留,即留在 SM 上隨時可被排程執行,必須同時分到執行緒槽(每個執行緒佔一個)、暫存器和共享記憶體。每類資源能容納的執行緒塊數,等於資源總量除以每塊需求後向下取整;駐留塊數取各類中的最小值:
| 資源 | SM 總量 | 每個執行緒塊的需求 | 可容納的執行緒塊數 |
|---|---|---|---|
| 執行緒槽 | 2048 | 256 | 8 |
| 暫存器 | 64K 個 | 256 × 128 = 32K 個 | 2 |
| 共享記憶體 | 228 KB(233,472 bytes) | 96 KiB 工作集 + 每塊預留 1 KiB = 97 KiB | 2 |
| 執行緒塊數上限 | 32 | 1 | 32 |
暫存器與共享記憶體都只允許 2 塊,因此 SM 上駐留 2 個執行緒塊,即 16 個 warp。佔用率(occupancy)指駐留 warp 數佔 SM 最大駐留 warp 數的比例,這裡為 16/64 = 25%。圖 5-4 把三類資源畫成三根橫條:兩個執行緒塊把暫存器恰好填滿,把共享記憶體填到只剩 34 KiB,執行緒槽卻只用了四分之一。
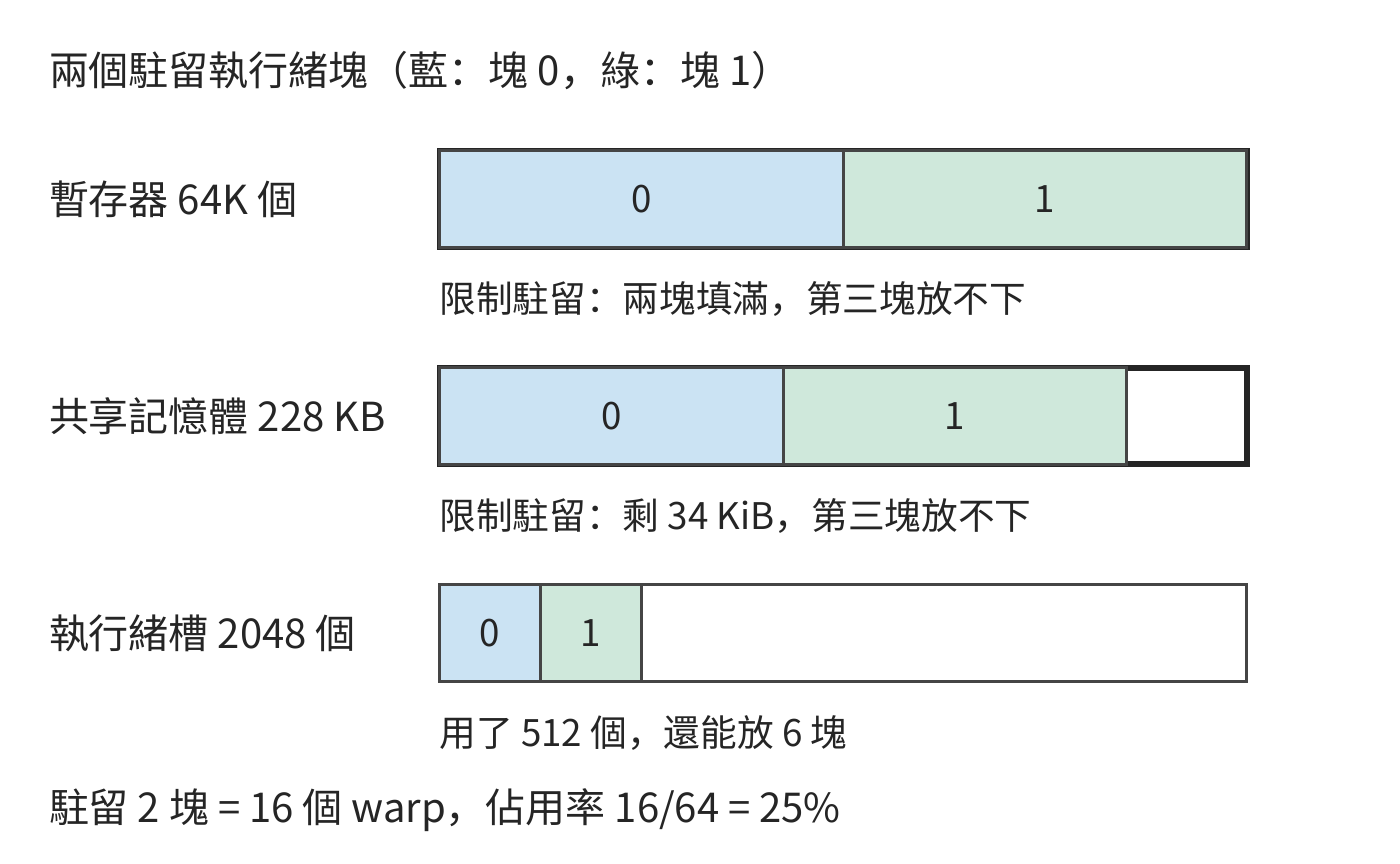
圖 5-4:三條分別表示 SM 的暫存器、共享記憶體與執行緒槽總量,藍、綠為兩個駐留執行緒塊的佔用。暫存器恰好填滿,共享記憶體剩餘 34 KiB 放不下第三塊的 97 KiB,兩者同時限制駐留;執行緒槽只用了 512 個。每塊 256 執行緒、每執行緒 128 個暫存器、96 KiB 共享記憶體,另加每塊 1 KiB 預留。
改哪項資源才有用,取決於哪項限制最緊。把 64 KiB 累加器從共享記憶體挪進暫存器,每個執行緒要多儲存 64 個 FP32 值,即多用 64 個暫存器。每塊的共享記憶體需求隨之降到 32 KiB,可容納 6 塊;但若每執行緒原來只用 64 個暫存器,加上累加器就是 128 個,暫存器仍只允許 2 塊。駐留塊數不變,限制項只是從兩項變成暫存器一項。要讓第三塊駐留,必須同時壓低每執行緒暫存器和每塊共享記憶體,或者縮小每塊的工作集。
延遲隱藏:駐留的 warp 提供在途請求。 佔用率之所以重要,是因為獨立的訪存請求都來自駐留的 warp:在途請求足夠多,一個請求等待回傳時,介面仍被其他請求佔滿,這稱為延遲隱藏。第 4.3.3 節的 Little 定律給出維持頻寬所需的在途位元組數:頻寬 × 延遲。取 H100 視訊記憶體頻寬 3.35 TB/s、延遲 600 ns,整卡需要約 2.01 MB 在途,平攤到 132 個 SM,每個 SM 要保持約 15.2 KB 在途。再計算駐留的 warp 能提供多少:一個 warp 的一條載入指令讓 32 個執行緒各取 16 bytes,共 512 bytes;每個 warp 最多掛起 4 條未完成的載入;16 個 warp 合計 32 KiB。
可用在途位元組是需求的 2.15 倍,只駐留 8 個 warp(一個執行緒塊)也已足夠。第 5.2.2 節會遇到「大塊少讀資料卻可能變慢」的現象,這裡給出它的定量形式:工作集越大,駐留塊越少,可用的在途位元組越少;一旦低於需求,有效頻寬就降為可用在途位元組除以延遲,介面頻寬再高也用不上。
矩陣指令的粒度。 第 4.2.1 節說明矩陣單元按固定形狀的塊執行。這裡一條矩陣乘加指令(MMA)的形狀為 16×8×16:A 片 16×16,W 片 16×8,一條指令完成 2×16×8×16 = 4096 次浮點操作。一個 128×128×64 的塊要發 (128/16) × (128/8) × (64/16) = 8 × 16 × 4 = 512 條指令,與塊的 2,097,152 FLOPs 相符。這 512 條由 8 個 warp 平分:輸出塊含 8 × 16 = 128 個 16×8 的輸出片,每個 warp 負責其中 16 片,沿 K 四步共發 64 條。MMA 指令在暫存器中累加,本節的塊把累加結果放在共享記憶體裡,每個 K 步前後要在暫存器與共享記憶體之間搬移這 16 片;上一段把累加器挪進暫存器的方案,省掉的正是這筆搬移。
MMA 有兩種發出方式。warp 級指令由一個 warp 單獨發出,運算元要先裝進該 warp 的暫存器;Hopper 的 warpgroup 級指令由 4 個相鄰 warp(合稱一個 warpgroup)聯合發出,可以直接從共享記憶體取運算元,並且非同步執行:發出指令的 warp 在等待結果的同時可以做其他工作。FlashAttention-3 正是利用這種指令安排計算重疊。10
同步:非同步複製與柵欄。 第 4.4.2 節用兩個輸入槽讓載入與計算重疊,前提是知道「槽已填滿」和「槽已用完」兩個時刻。在 SM 上,這兩個時刻由柵欄(barrier)給出。柵欄是共享記憶體中的一個計數器:參與者完成自己的一步後到達柵欄,計數達到預定值時,等在柵欄上的執行緒被放行。非同步複製(發出後由硬體在後臺完成、發出者不必等待的複製)完成時同樣到達柵欄,並按搬入的位元組數計數。每個槽配一對柵欄:「滿」柵欄由複製完成觸發,計算等它;「空」柵欄由計算結束觸發,下一次複製等它。
有了柵欄,warp 可以分工:一個 warp 只發複製(生產者),其餘 warp 只做計算(消費者),這種安排稱為 warp specialization。生產者 warp 發出塊 j+1 的複製後不必等它完成,轉而等「空」柵欄,準備寫入塊 j+2;消費者 warp 每等到一次「滿」柵欄,就接著計算下一塊。
先計算複製和計算各自的耗時。把 H100 的視訊記憶體頻寬 3.35 TB/s 與 BF16 稠密矩陣峰值 989.4 TFLOP/s 平分到 132 個 SM,每個 SM 約得 25.4 GB/s 和 7.50 TFLOP/s,下面按該執行緒塊獨佔該 SM 的份額計算。一個 K 塊的 A、W 共 32 KiB,複製約需 1.29 μs;塊乘為 2,097,152 FLOPs,計算約需 0.28 μs。複製比計算慢約 4.6 倍,原因是該塊每搬 1 byte 只做 64 次浮點運算,而 H100 的矩陣峰值與視訊記憶體頻寬之比約為 295 FLOP/byte。圖 5-5 按這兩個時間畫出兩個槽上的四個 K 塊。
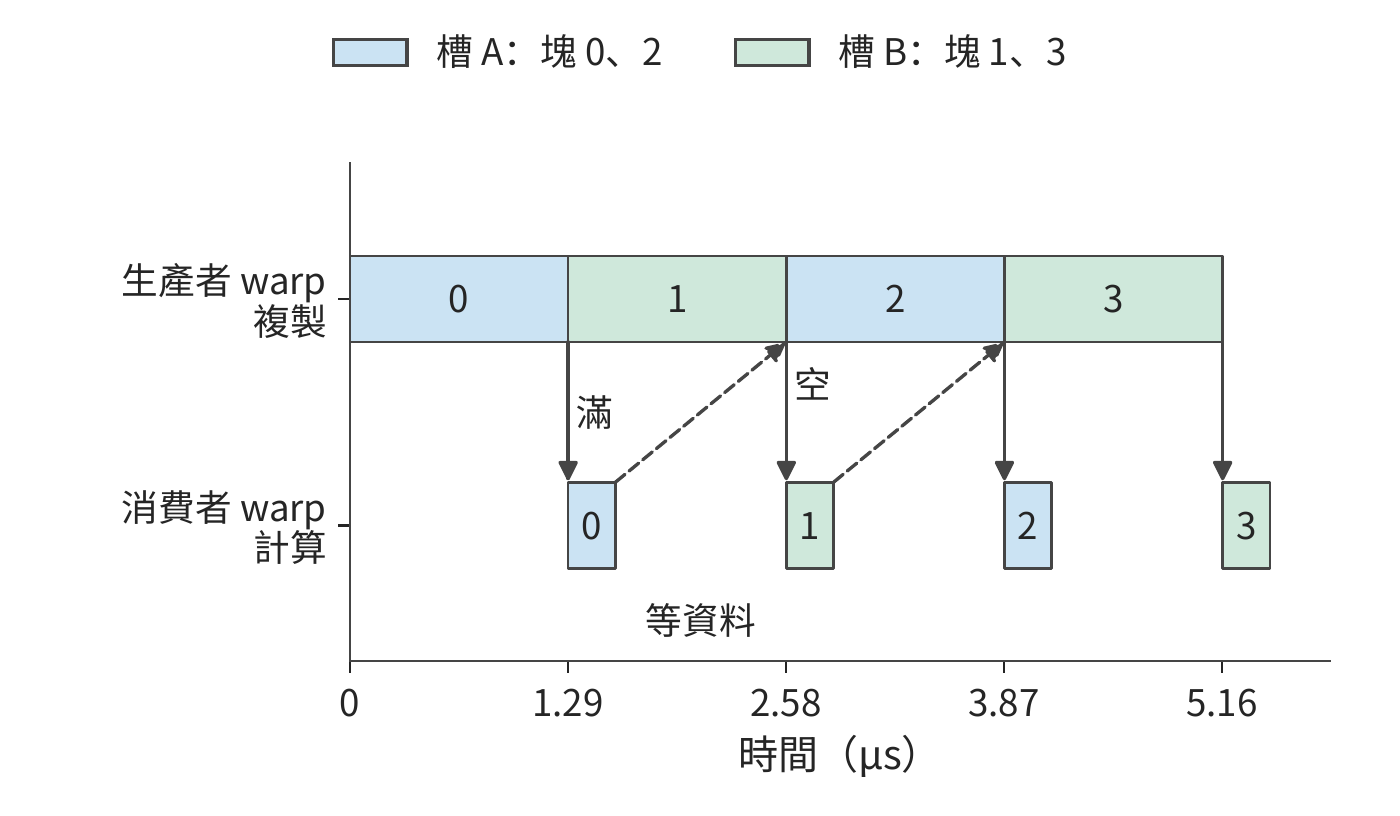
圖 5-5:上行是生產者 warp 發出的非同步複製,下行是消費者 warp 的計算;藍、綠分別為槽 A、B。實線箭頭為「滿」柵欄,複製完成後計算才能開始;虛線箭頭為「空」柵欄:塊 0 在 1.57 μs 用完槽 A,塊 2 的複製到 2.58 μs 才開始,生產者不必等槽。H100 一個 SM 上每塊複製 1.29 μs、計算 0.28 μs;複製首尾相接,消費者每算完一塊就等下一次「滿」柵欄。
這種分工是第 4.2.3 節流水的軟體實作。那裡的三種資源是矩陣單元、共享記憶體介面與指數單元;這裡生產者 warp 驅動複製,佔用共享記憶體介面,消費者 warp 驅動矩陣與指數運算,柵欄讓雙方只在資料交接處等待。FlashAttention-3 按此設計:生產者 warpgroup 發 K、V 塊的複製,兩個消費者 warpgroup 交替做矩陣乘和 Softmax,一個在算指數時,另一個在做矩陣乘。第 5.3.2 節將沿用這裡每塊複製 1.29 μs、計算 0.28 μs 的取值推導流水總時間,第 5.3.3 節再展開 FlashAttention 的分塊。10
非同步批次複製對資料佈局還有一項要求。第 5.2.3 節將用 padding 在每行末尾補一個字來分散 bank;非同步批次複製按張量描述符(記錄張量形狀與步長的結構)整塊搬移,不能在行間插入填充,於是改為按固定規則置換塊內的地址,這種做法稱為 swizzle:資料總量不變,同一列的請求仍落到不同 bank。
對應到昇騰。 本節討論的執行緒、駐留、訪存、矩陣指令與同步這五步,在昇騰上對應第 4.2.3 節與第 4.6.2 節的另一組部件:
| 本節的機制 | NVIDIA GPU | 昇騰 |
|---|---|---|
| 發射與分工 | warp 是 32 個執行緒的發射單位,生產者與消費者 warp 在同一 SM 內分工 | AIC、AIV 各是獨立的核而不是 warp:矩陣工作在 AIC 上執行,向量工作在 AIV 上執行,各有自己的指令流 |
| 駐留與容量 | 暫存器、共享記憶體、執行緒槽決定每個 SM 駐留的執行緒塊數 | L0、L1 與統一緩衝的容量決定每個核一次容納的塊 |
| 搬移與同步 | 非同步複製到達柵欄,warp 等柵欄 | MTE/NDDMA 搬移,BufferID 標識緩衝並組織交接 |
上文「在途位元組足夠」的結論,依賴 600 ns 延遲與每 warp 4 條未完成載入。翻轉條件:延遲升到 1000 ns、每個 warp 只能掛起 2 條載入時,每個 SM 需要 25.4 KB 在途,16 個 warp 只能提供 16 KiB,覆蓋率(可用在途位元組與需求之比)降為 0.65;補齊缺口至少要 25 個 warp,即 4 個執行緒塊,而暫存器與共享記憶體只允許 2 塊。此時 25% 的佔用率不再足夠:要麼縮小工作集,換取更多駐留塊;要麼改用非同步批次複製,讓一個執行緒一次請求整塊資料,在途位元組按塊大小計,不再依賴 warp 數。
練習 5-1 · 延伸:把輸出塊縮為 64×64,佔用率由哪項資源決定
保持 256 個執行緒、每執行緒 128 個暫存器,把輸出塊改為 64×64,K 步長仍為 64,累加器仍放在共享記憶體中。求每塊的共享記憶體需求、四類資源各自允許的執行緒塊數與佔用率,指出哪項限制最緊。再把每執行緒暫存器降為 64 個重算一次,說明限制轉移到了哪項;最後按 600 ns 延遲與每 warp 4 條載入,檢查在途位元組是否仍能覆蓋需求。
5.2 單個運算子的分塊、佈局與實際訪存
大矩陣計算可以像切豆腐一樣分塊:先分成適合處理的小塊,再逐塊完成。不過,切成什麼形狀,要同時看計算單元能處理什麼,以及其附近能容納多少資料。第 4 章已經說明,硬體矩陣指令支援有限的形狀;整個加速器上的多個計算單元可以同時處理許多塊,每份工作內部仍要組織成硬體能夠執行的小步。
分塊還要讓搬來的資料多用幾次。沿用第 4 章的工作臺比喻,當前輸入和尚未算完的部分和要放在計算單元附近,用完才能騰出空間。輸出塊太小,同一份輸入可能要為不同的輸出塊反覆搬移;塊太大,又會佔用更多區域性儲存,擠掉其他可以同時執行的任務。下面先跟蹤一個輸出需要哪些資料,再把多個輸出組織成塊,分析塊大小、存取順序和區域性容量如何共同影響複用。
5.2.1 矩陣形狀與重複讀取
以下用 A 表示章首的輸入 X,投影寫作 \(C=AW\),其中 \(M=1024,K=4096,N=12288\)。A、W、C 採用 BF16,大小分別為 8、96、24 MiB。若 A、W 各讀一次,C 寫一次,只需傳輸 128 MiB。要解釋一種分塊實作為何產生約 3 GiB 的存取,先看單個輸出如何算出。
計算 C[i,j] 時,取 A 的第 i 行和 W 的第 j 列,將對應元素相乘,再沿 K 維求和。接著計算右邊的 C[i,j+1],W 換成相鄰一列,A 卻仍是同一行。圖中兩次計算的藍色部分完全相同。
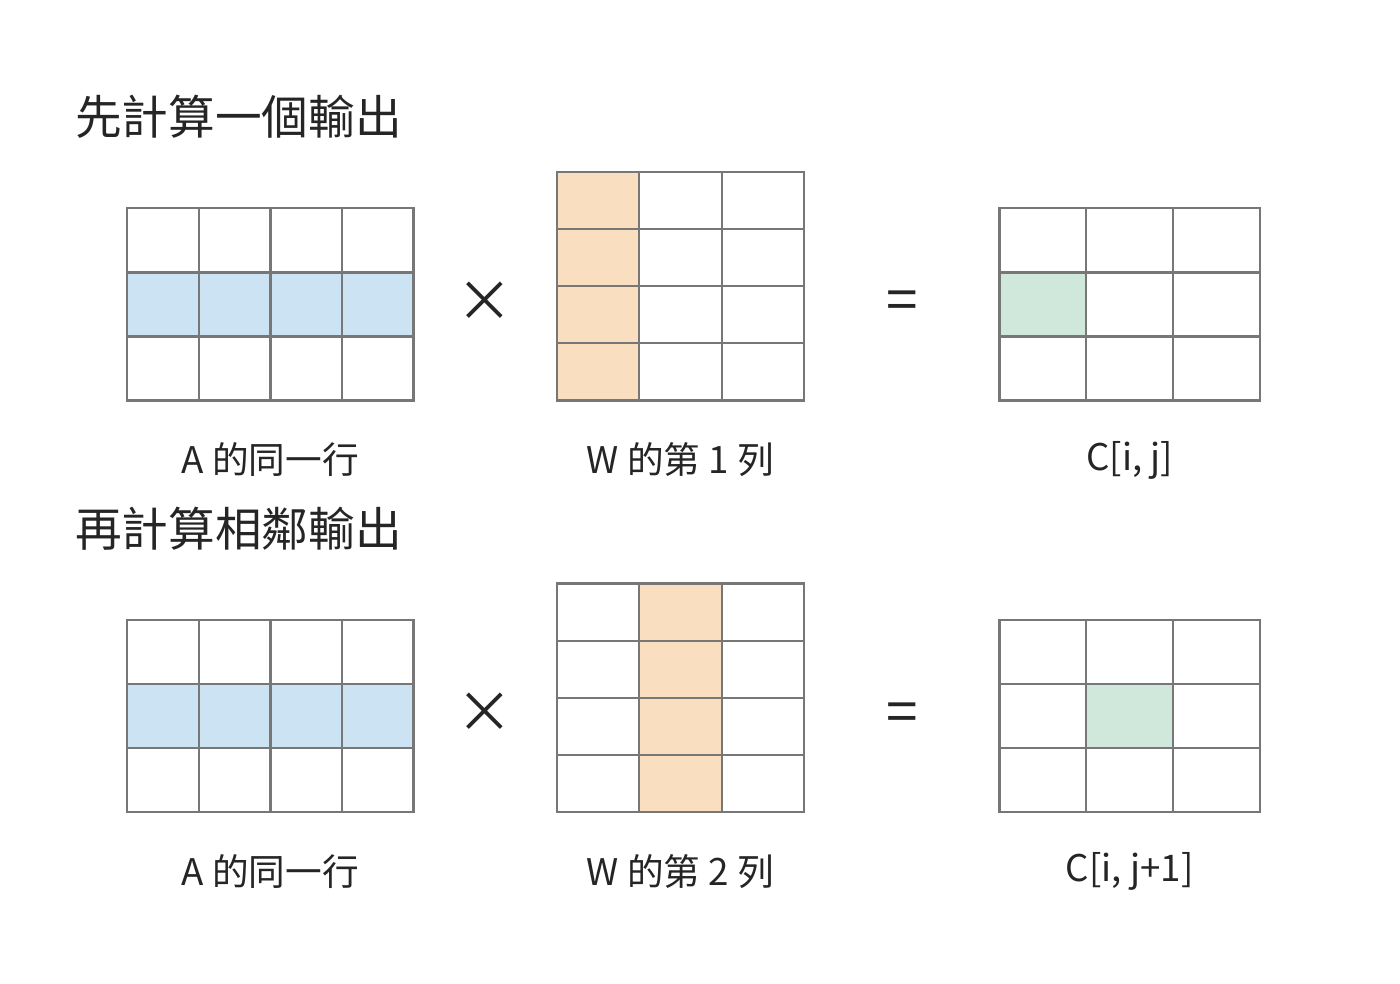
圖 5-6:先算一個輸出,再算相鄰輸出。藍色表示所用的 A 行,橙色表示所用的 W 列,綠色表示本次得到的輸出元素。圖中矩陣縮小為示意尺寸,實際算例的 K 為 4096。
如果這行 A 在兩次使用之間仍留在區域性儲存或快取中,就能直接複用;若已被替換,就需要再次向下一級儲存請求資料。轉到下一行輸出時,W 中的元素也會再次使用。同一份資料在數學運算中需要反覆使用。程式如何安排這些運算,決定了這份資料要經過儲存介面多少次。
本節以工作緩衝和下一級儲存之間的介面為計數位置,累計程式每次讀入與寫出的位元組數。下文約 3 GiB 的存取量,也按這一介面計算。2
把圖中的逐元素計算寫成迴圈,就是:
for i in range(M):
    for j in range(N):
        acc = 0.0
        for k in range(K):
            acc += A[i, k] * W[k, j]
        C[i, j] = acc
內層 k 迴圈每執行完一遍,得到一個輸出。一次乘加計兩個 FLOPs,計算全部輸出所需的運算量為:
比較的基準是三份 BF16 矩陣各經過介面一次的讀寫量:
其中 MiB 為 \(2^{20}\) bytes。以各輸入讀一次、輸出寫一次為基準,下文據此計算分塊增加了多少重複存取。
迴圈順序還決定每次存取的地址。W 按行連續儲存時,上面的內層迴圈依次讀取 W[k,j]、W[k+1,j],地址相差 N 個元素。若改成 i、k、j 的順序,內層便依次讀取 W[k,j]、W[k,j+1],同時將 A[i,k] 用於多個輸出。這樣一次連續傳輸取得的資料能立即參與計算。
不過,新順序也要同時儲存一段輸出的累加結果。若區域性儲存容納不下這些結果,每輪更新都可能增加對下一級儲存的讀寫。接下來用分塊限制同時保留的資料量,讓輸入複用與輸出儲存相互配合。
5.2.2 容量約束下的分塊複用
先選 C 的一小塊作為當前要完成的輸出,為該 \(m\times n\) 輸出塊分配累加緩衝區。每次沿 K 維讀入一對輸入塊:A 塊為 \(m\times k\),W 塊為 \(k\times n\)。兩塊相乘,更新同一份輸出累加器;換入下一對輸入塊時,已經得到的部分和繼續保留。直到沿 K 完成全部累加,才把結果轉為 BF16 並寫出。這裡的塊是軟體為複用資料而組織的,其內部還可以分解為多次硬體矩陣指令。分塊本身不要求先把原矩陣複製成許多獨立的小矩陣,具體搬移由執行程式安排。
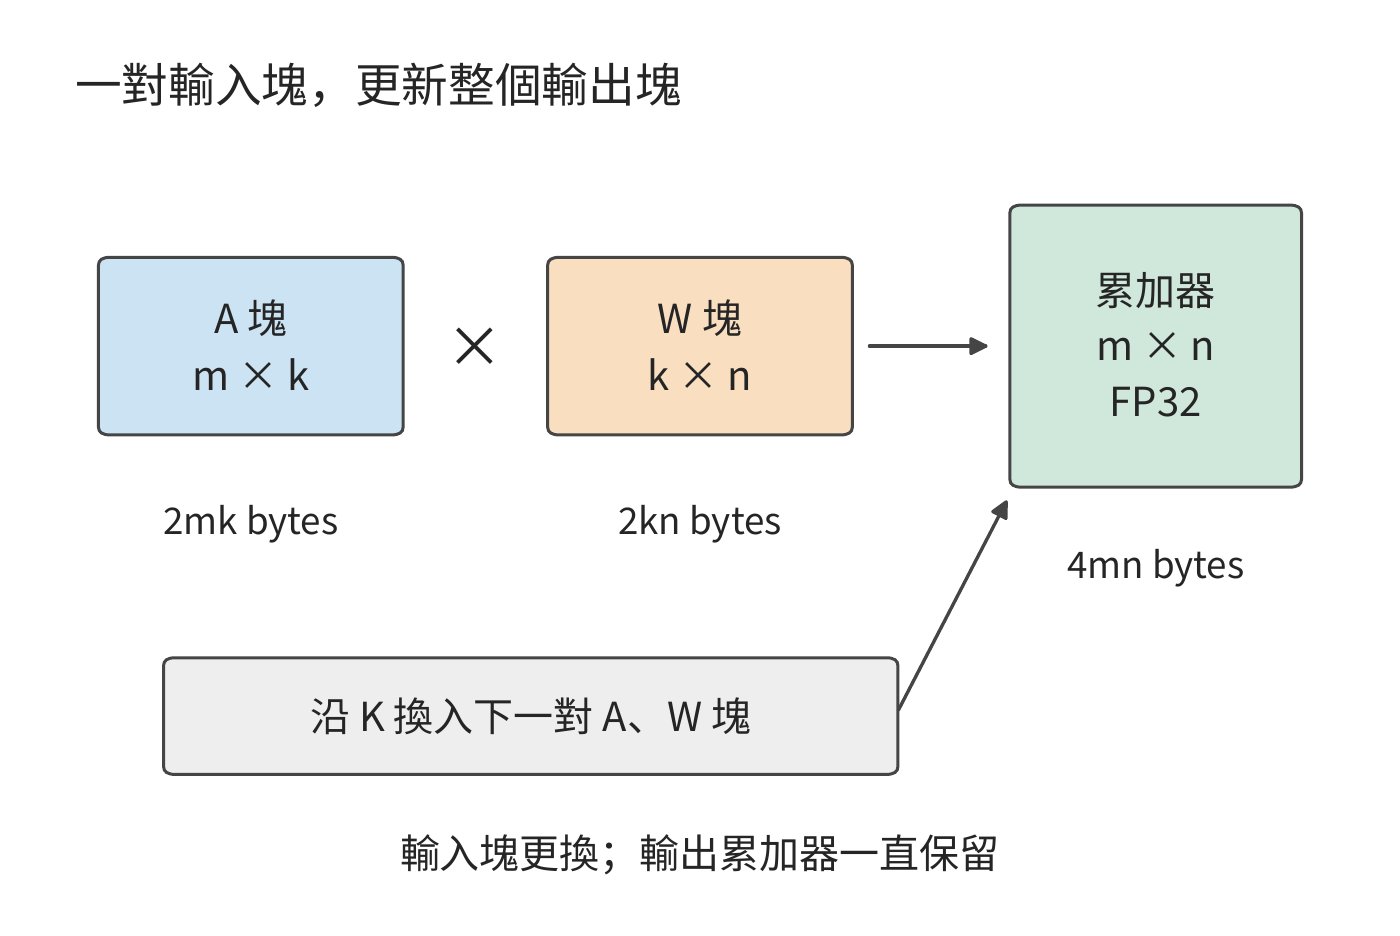
圖 5-7:固定當前 m×n 輸出塊,沿 K 依次搬入對應的 A、W 塊,反覆更新同一份部分和,全部累加結束後才寫回。A、W 輸入為 BF16,累加器為 FP32。圖示為軟體分塊,一次塊乘可包含多次硬體矩陣指令;尺寸符號表示形狀,方框面積不按位元組數縮放。
A 塊中的每個元素可用於 n 列輸出,W 塊中的每個元素可用於 m 行輸出。擴大輸出塊,就能讓一次讀入的資料參與更多乘加;同時也要儲存更多輸入和輸出部分和。
例 5-3:擴大矩陣輸出塊能減少多少輸入讀取? 圖中的 A 輸入塊、W 權重塊和輸出累加器分別佔 \(2mk\)、\(2kn\) 和 \(4mn\) bytes。只使用一組輸入緩衝時,區域性儲存需求為:
取 \(k=32\),先用 64×64 輸出塊。A 塊和 W 塊各佔 4 KiB,累加器佔 16 KiB,合計 24 KiB。把輸出塊擴大到 128×128 後,兩份輸入各佔 8 KiB,累加器佔 64 KiB,合計增至 80 KiB。輸入複用增多,輸出累加器卻增長得更快。
接著計算全矩陣的讀寫。假設每個輸出塊獨立讀取自己的輸入,不考慮不同輸出塊之間的快取複用。N 方向有 N/n 個列塊,每個列塊都要遍歷 A;M 方向有 M/m 個行塊,每個行塊都要遍歷 W。最終 C 只寫出一次,因此:
64×64 輸出塊將輸出劃為 16 個行塊、192 個列塊。192 個列塊各讀一遍 8 MiB 的 A,共 1536 MiB;16 個行塊各讀一遍 96 MiB 的 W,也是 1536 MiB。加上 24 MiB 輸出,總量為 3096 MiB。這就是本節開頭約 3 GiB 的來源。
改成 128×128 後,行塊數從 16 減到 8,列塊數從 192 減到 96,兩份輸入的讀取均減半。輸出大小不變,總量降至 \(768+768+24=1560\) MiB。圖 5-8 把這項收益與佔用的區域性儲存放在一起比較。
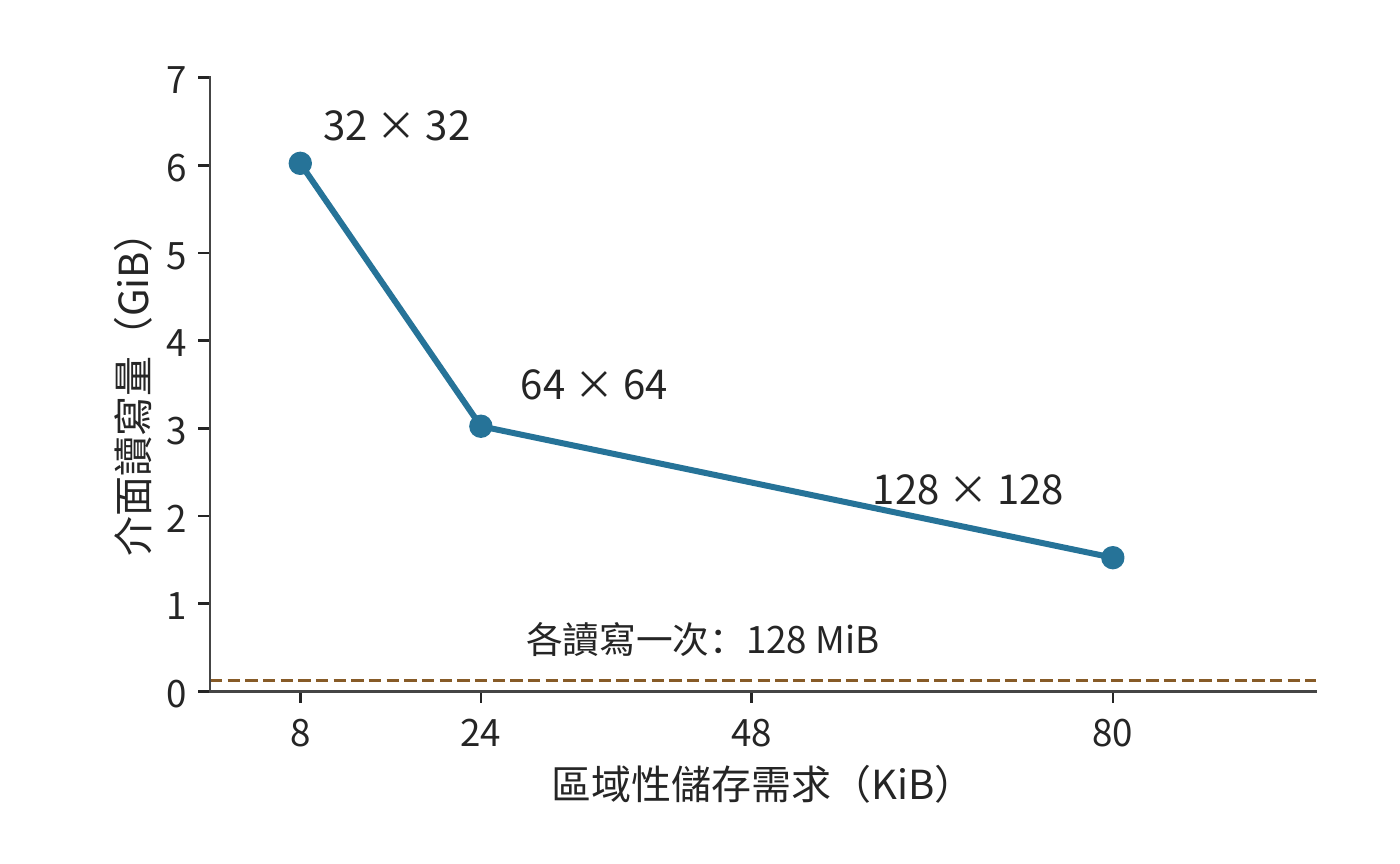
圖 5-8:每個點標出輸出塊形狀。擴大輸出塊能減少跨介面的重複讀取,但需要更多區域性儲存。虛線為三份矩陣各經過一次的 128 MiB;比較條件為 k=32、單組輸入緩衝、各輸出塊獨立讀取輸入。
完整數值如下,算術強度用同一矩陣乘的 FLOPs 除以上述介面位元組數計算:
| 輸出塊 | 區域性儲存需求 | 工作緩衝與下一級儲存之間的存取 | 算術強度 |
|---|---|---|---|
| 32×32 | 8 KiB | 6168 MiB | 15.9 FLOP/byte |
| 64×64 | 24 KiB | 3096 MiB | 31.7 FLOP/byte |
| 128×128 | 80 KiB | 1560 MiB | 63.0 FLOP/byte |
三種輸出塊的算術強度都遠低於第 5.1.5 節給出的 H100 矩陣峰值與視訊記憶體頻寬之比 295 FLOP/byte。只看這一級介面的流量,三種分塊都處於頻寬受限一側,矩陣單元的 MFU 上限分別只有 5%、11% 和 21%。擴大輸出塊能把算術強度推向交點,但單靠這一級分塊還越不過交點,其餘的複用要靠更靠近計算單元的儲存層次。
存取量接近減半,時間是否隨之減半,還要看加速器能同時安排多少工作。GPU 上,輸入緩衝放在共享記憶體中,累加器可以放在共享記憶體或暫存器中。這裡沿用第 5.1.5 節的做法:每個執行緒塊負責一個輸出塊,輸入緩衝與累加器都放在共享記憶體中。硬體取 RTX PRO 6000 的一個 SM:該卡屬於計算能力 12.x,每個 SM 的共享記憶體上限為 100 KB(即 102,400 bytes),每個執行緒塊另佔 1 KiB 預留。33
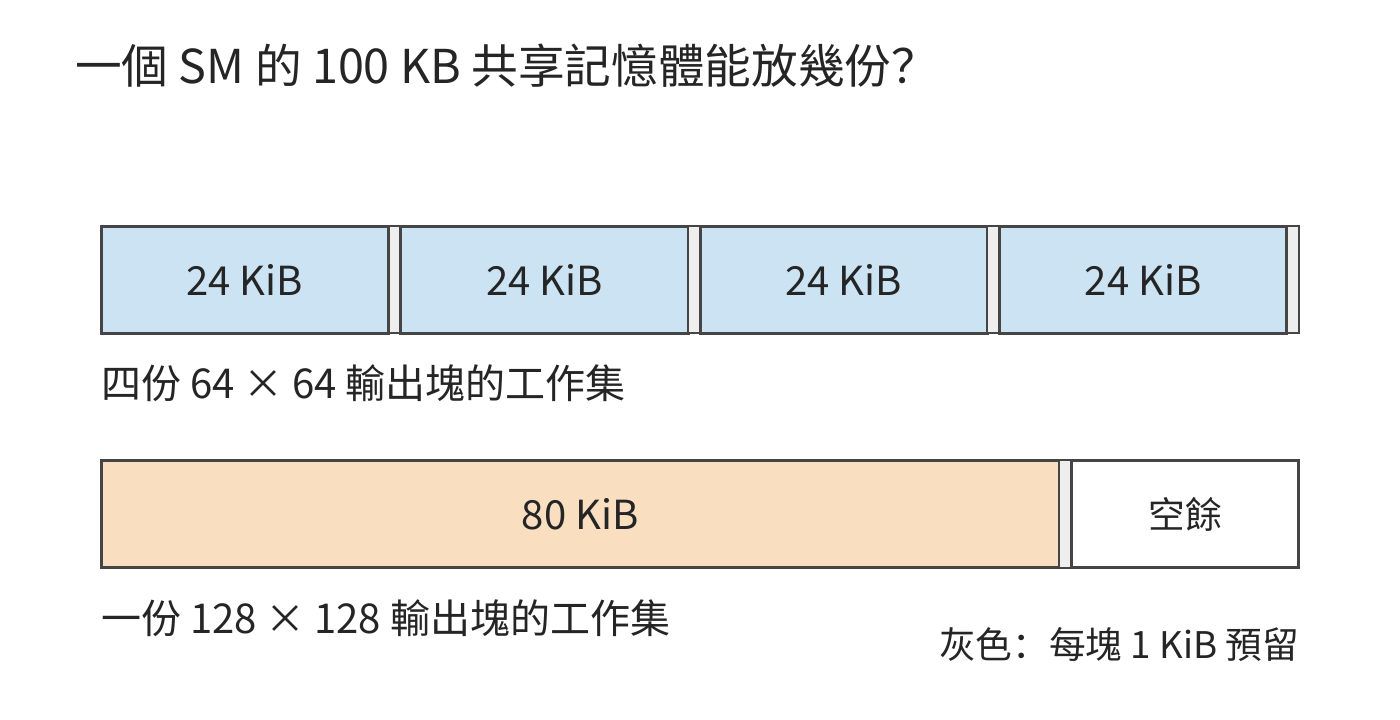
圖 5-9:條形總長均表示 RTX PRO 6000 一個 SM 的 100 KB 共享記憶體。24 KiB 的工作集連同每塊 1 KiB 預留,恰好放下四份;80 KiB 的只能放一份。
同時駐留的執行緒塊可以交錯發起訪存:一些塊等待資料時,另一些塊繼續工作。同時駐留的工作集從四份減為一份,等待訪存期間能執行的其他計算也就少了。因此,大塊雖然少讀資料,實際獲得的頻寬卻可能下降。第 5.1.5 節已經算過這一點:駐留的 warp 提供在途訪存請求,在途位元組不足時,有效頻寬就低於介面頻寬。
假設兩種實作都受這一層的頻寬限制,有效頻寬分別為 \(B_{64}\) 和 \(B_{128}\),則:
若頻寬相同,時間接近減半;若大塊只能獲得原來四成的頻寬,時間比約為 \(0.504/0.4=1.26\),耗時反而增加約 26%。可以先按容量排除容納不下的方案,再按存取量縮小比較範圍,最後測量實際執行效率。第 5.4 節將把這一過程交給編譯器。
5.2.3 資料佈局:讓並行請求分散到不同 bank
上一小節中,大塊雖然少讀資料,卻可能因並行度下降而變慢。並行度不僅取決於駐留多少執行緒塊,也取決於這些執行緒發出的讀取請求能否同時得到服務。先看區域性儲存的佈局。考慮 32×32 的 FP32 暫存塊,其所在的區域性儲存分成 32 個 bank;每個 bank 每輪提供一個 32-bit 字,bank 號就是字地址對 32 取模的結果。第 5.1.5 節已經介紹,一個 warp 的 32 個執行緒就是 32 個 lane;32 個 lane 各讀取同一行中的一個字時,請求分散到 32 個 bank;讀一列時,行跨度為 32 個字,所有地址集中到同一 bank,需要 32 輪。
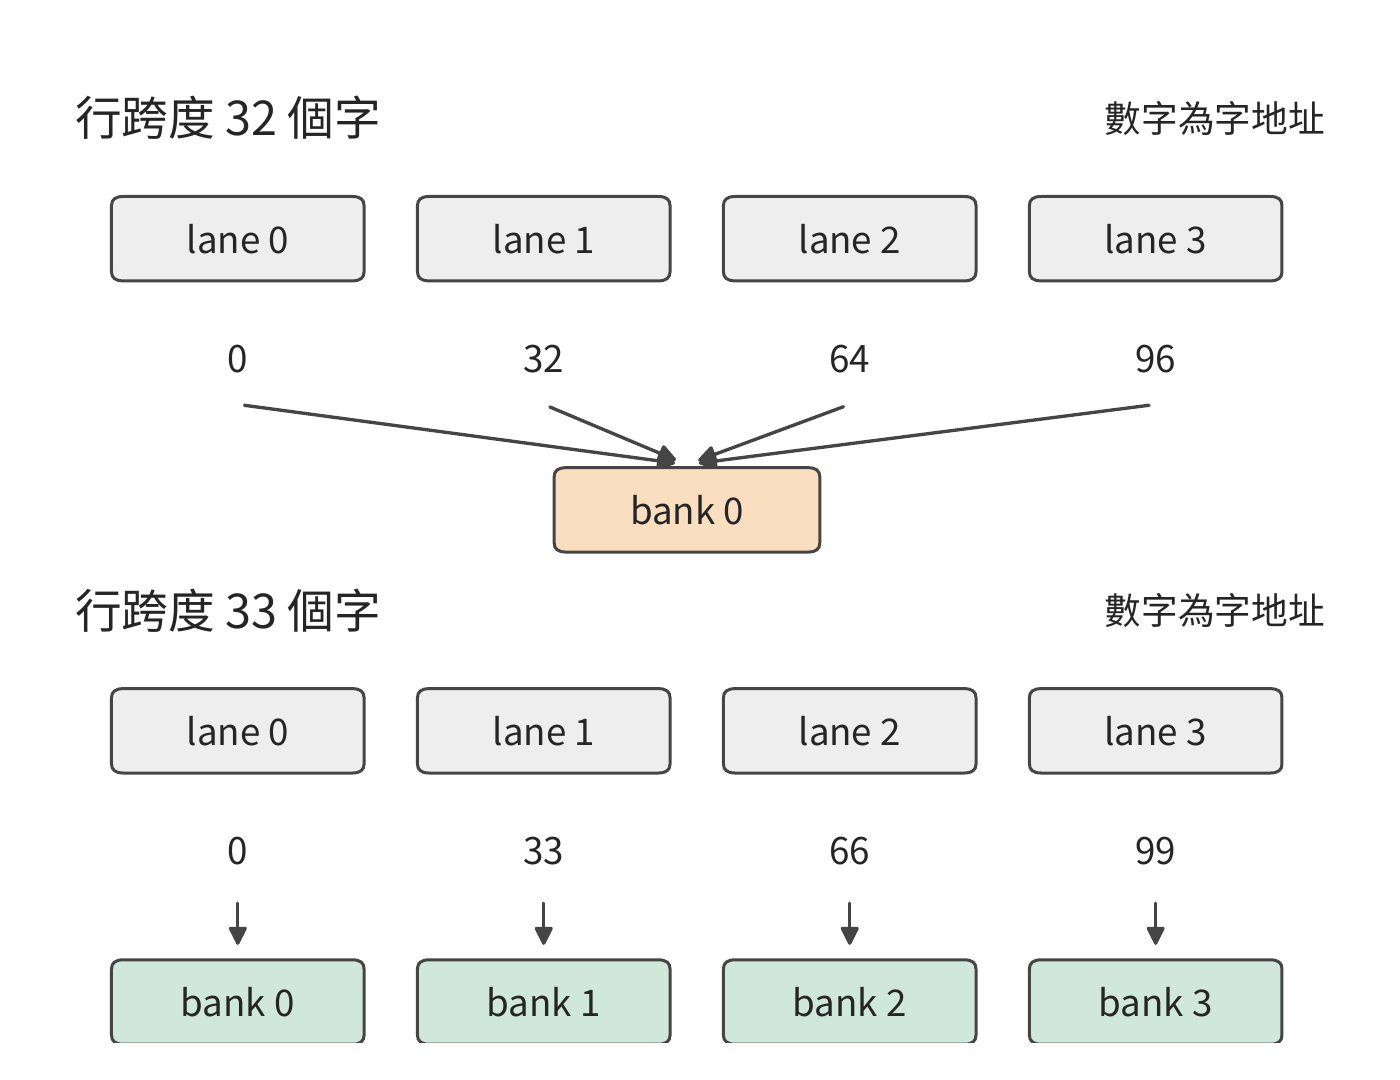
圖 5-10:同一列的 32 個不同字由 32 個 lane 同時請求。上半圖行跨度為 32 個字,請求集中到同一 bank;下半圖補齊為 33 個字,請求分散到 32 個 bank。圖中畫出前四個請求;假設每個 bank 每輪提供一個 32-bit 字,不計廣播。
在每行末尾補一個字,行跨度變為 33。同一列相鄰行的 bank 號便依次加一,32 次請求分散到 32 個 bank,一輪即可完成。所佔空間由 4096 bytes 增至 4224 bytes,只多約 3.1%。有效資料和讀取次數都沒有變化,但原本需要分 32 輪完成的列讀取,現在可以在一輪內完成。
行末補的這個字就是 padding,它不改變計算本身,只讓已有的並行請求分散到不同 bank。
padding 用多佔的位元組換來分散。也可以不增加位元組,只改變存放位置:把第 \(r\) 行第 \(c\) 列的元素放到第 \(c\oplus r\) 列,\(\oplus\) 為按位異或。行跨度仍是 32 個字,讀一列時,32 個 lane 取到的列號是 \(c\oplus r\) 隨 \(r\) 變化的 32 個不同取值,bank 號因此互不相同,同樣一輪完成。NVIDIA 的矩陣乘法模板庫 CUTLASS 把這種改變存放位置的做法稱為 swizzle。swizzle 節省了補齊的空間,代價是每次存取都要先按公式算出列號。
5.2.4 沿哪個維度切分:並行任務與部分和
padding 解決的是請求能否同時得到服務。如果程式本來就只安排了少量任務,改變地址佈局還不夠,還要把計算拆開。以 RMSNorm 為例:先根據一行元素的均方值計算共同的縮放因子,再縮放這一行。求縮放因子是一次歸約:它來自整行平方和;隨後每個元素乘以該因子和對應的可學習參數 gamma。對 \([1024,4096]\) BF16 輸入,一組處理一行,可以獨立安排 1024 組;而在 decode 階段,單請求每次只生成一個 token,同樣的分法只產生一組,加速器的大量執行資源就會空閒。
把每行分成八個 512 元素片段,可以增加第一階段的並行任務。完整歸約隨之變成三個階段:每個片段產生區域性平方和,合併八個區域性和得到行縮放因子,再用該因子歸一化輸入。前兩階段只需傳遞很少的數,但最後一階段要重新讀取原始資料。
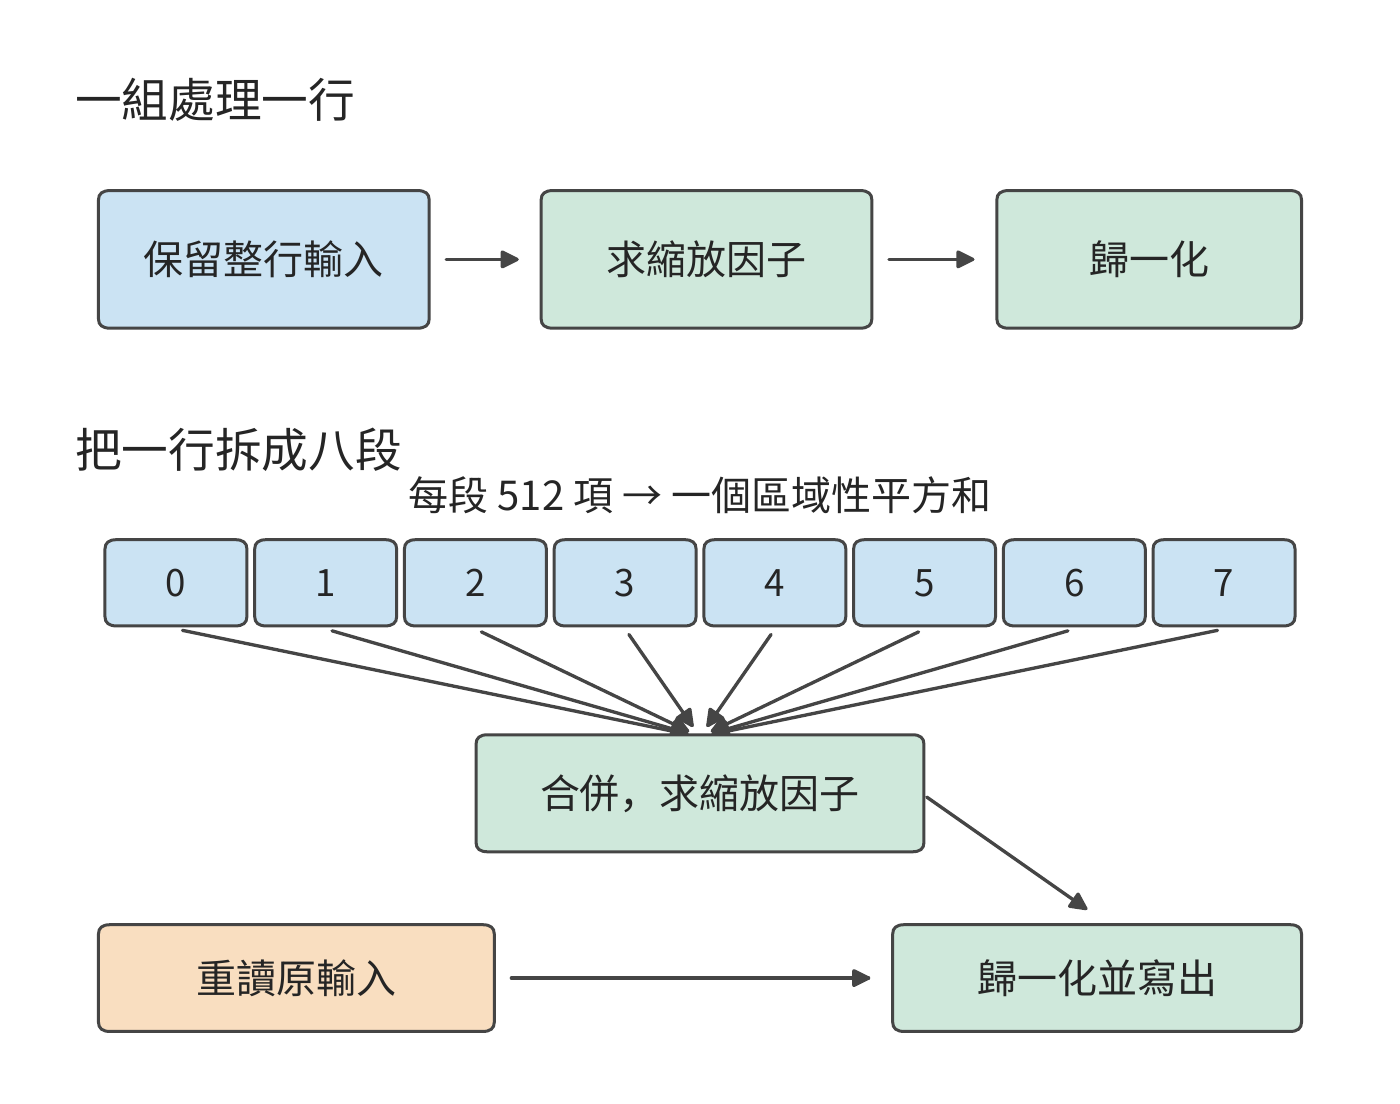
圖 5-11:上行由一組處理完整一行,輸入保留到歸一化結束;下行把一行分為八段,先求區域性和,再合併,最後重讀輸入並歸一化。每行 4096 個 BF16 元素;圖中僅畫一行,推廣到 1024 行時,第一階段任務數由 1024 增至 8192。橙色框表示增加的原輸入讀取。
沿著圖 5-11 的箭頭計數,就能求出增加並行任務所付出的訪存代價。仍取 1024 個 token,每個 token 的特徵向量佔輸入矩陣的一行。第一階段的並行任務從 1024 組增到 8192 組;8192 個 FP32 區域性和佔 32 KiB,1024 個 FP32 縮放因子佔 4 KiB。一組一行的程式在區域性保留輸入,讀入 8 MiB 輸入,每行再讀取一份 BF16 gamma,累計 8 MiB,最後寫出 8 MiB 結果,總存取量為 \(8+8+8=24\) MiB。拆分後,最後的歸一化階段重讀 8 MiB 輸入;區域性和、縮放因子的寫出與讀取再增加約 0.1 MiB,總量為 32.1 MiB,kernel launch 次數從一次增至三次。4
圖中每組只處理一行的八分之一,還帶來另一項收益:需要儲存的臨時資料隨之減少。以 FP32 儲存完整一行需要 16 KiB,儲存其中八分之一隻需 2 KiB。原來因暫存器不足而寫入較遠儲存的臨時資料,可以因此保留在暫存器中。拆分歸約的收益來自兩處:並行任務變多,每組的臨時資料變少;代價則是多讀一遍輸入,以及階段之間要傳遞資料。
RMSNorm 的拆分沿的是歸約維:一行的平方和分成八個區域性和,必須再合併一次。矩陣乘也有同樣的選擇。對 \(C_{M\times N}=A_{M\times K}W_{K\times N}\),可以沿三個維度中的任何一個把工作分給不同的執行者。圖 5-12 畫出三種切法各自需要什麼輸入、得到什麼結果。
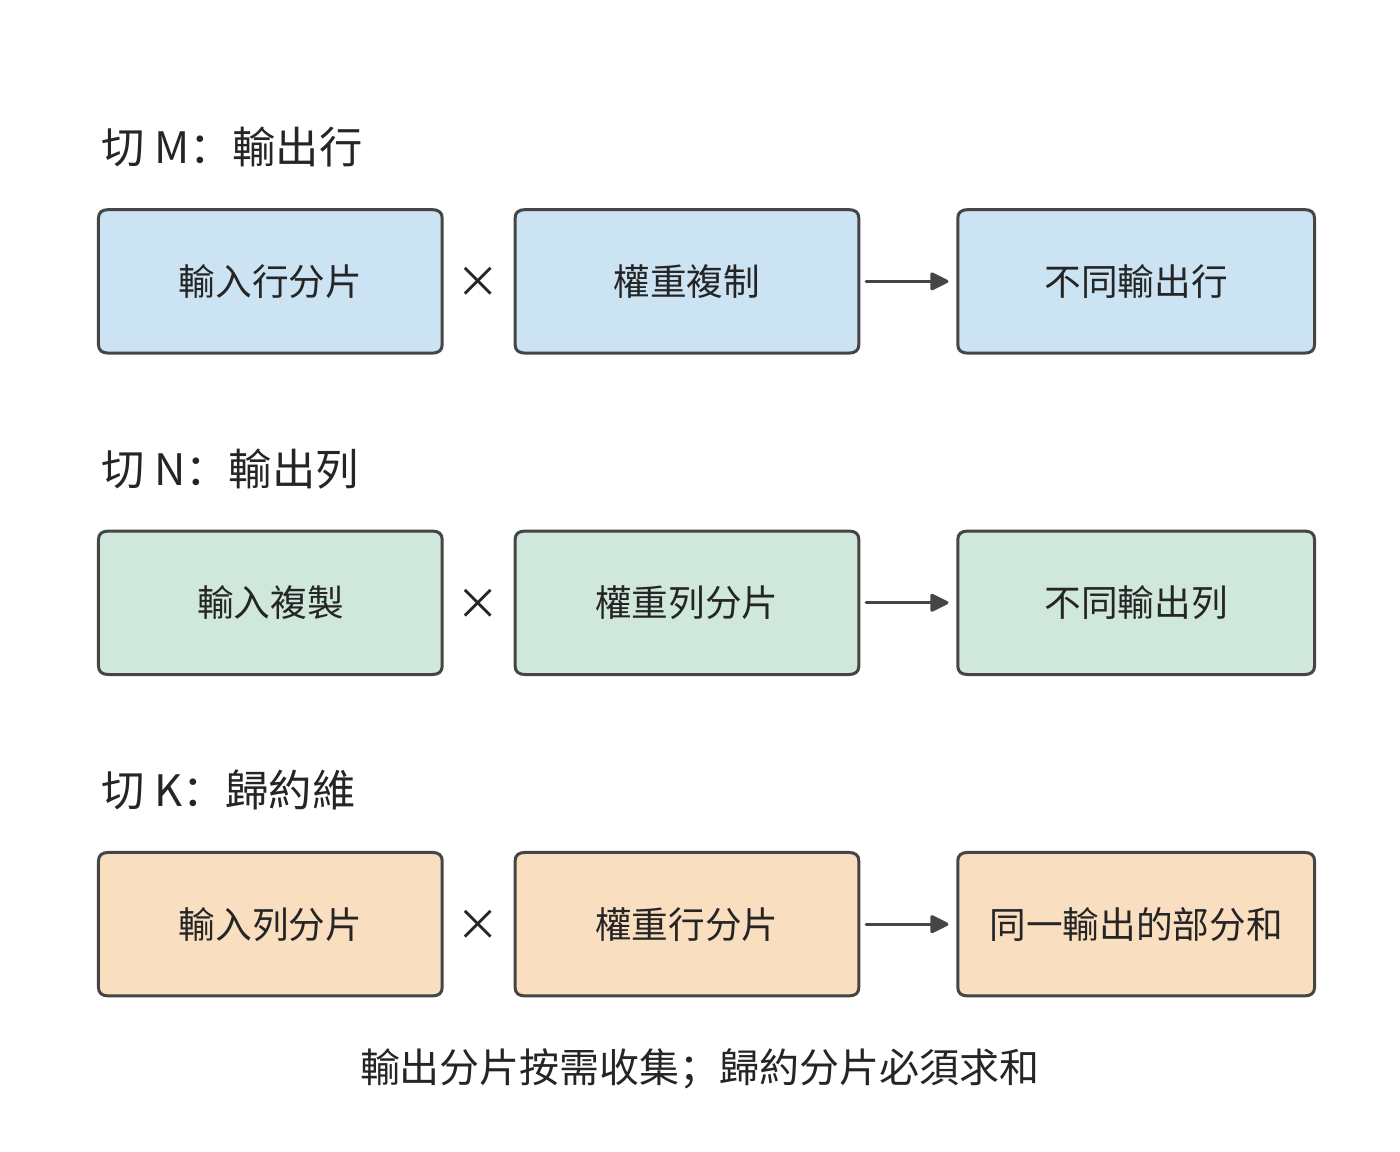
圖 5-12:切輸出行 \(M\) 或輸出列 \(N\),各執行者得到不同位置的完整結果,需要時再拼起來;切歸約維 \(K\),各執行者得到同一輸出的部分和,必須相加後才能使用。方框表示資料歸屬,不按矩陣元素數繪製。
前兩種切法只要求輸入按需複製或分片,輸出可以一直保持分片,直到後續運算子需要完整資料;第三種切法省下了輸入的複製,卻像 RMSNorm 的區域性和一樣,多出一次匯合。第 5.2.2 節的輸出塊正是同時沿 \(M\) 和 \(N\) 切分,再沿 \(K\) 逐塊累加:累加器留在一個執行緒塊內,匯合部分和不需要跨越任何邊界。
合併的次序也會改變結果。浮點加法不滿足結合律:用 FP32 計算 \(1+2^{-24}+2^{-24}\),先加前兩項,和仍是 1,再加第三項也仍是 1;先加後兩項得到 \(2^{-23}\),與 1 相加就得到 \(1+2^{-23}\)。兩種次序的結果相差一個 ULP(unit in the last place,同一指數下相鄰兩個浮點數的間距)。一次舍入丟掉的位無法恢復,之後每一次加法都在已經舍入過的數上繼續。
本小節的 RMSNorm 可以算出這一差別有多大。取一行 4096 個 BF16 元素,每個元素的平方在 FP32 中都能精確表示,因此下面幾種做法的差別只來自加法的先後。圖 5-13 的上半部分比較 1、2、4、8、16、32 段這六種切分算出的平方和,橫軸為它們與精確值的距離。一組處理一整行時,累加器逐步增長到 2038 附近,每次加入的一項卻只有 0.5 左右,末位反覆被捨去,最後比精確值小 175.2 個 ULP。分成八段之後,每個累加器只增長到 255 左右,最後再把八個區域性和相加一次,結果與精確值只差 9.2 個 ULP。兩條路徑相差 166 個 ULP,相對差約 \(9.9\times10^{-6}\)。可見拆分改變的不只是並行任務數,還有精度。
下半部分固定這八個區域性和,只改合併的次序。40,320 種次序只得到三個不同的 FP32 結果,彼此相差一個 ULP。如果用原子加把區域性和累加到同一個地址,到達的先後由排程決定;同一份輸入、同一個程式,兩次執行得到的結果就可能不同。改成先把八個區域性和寫入緩衝,等它們全部寫完,再由一個執行者按固定順序相加,每次都得到同一個結果。代價有兩項:多一次寫出與讀回;合併要等最慢的那一段算完才能開始,而原子加按到達順序累加,不必等待全部就緒。
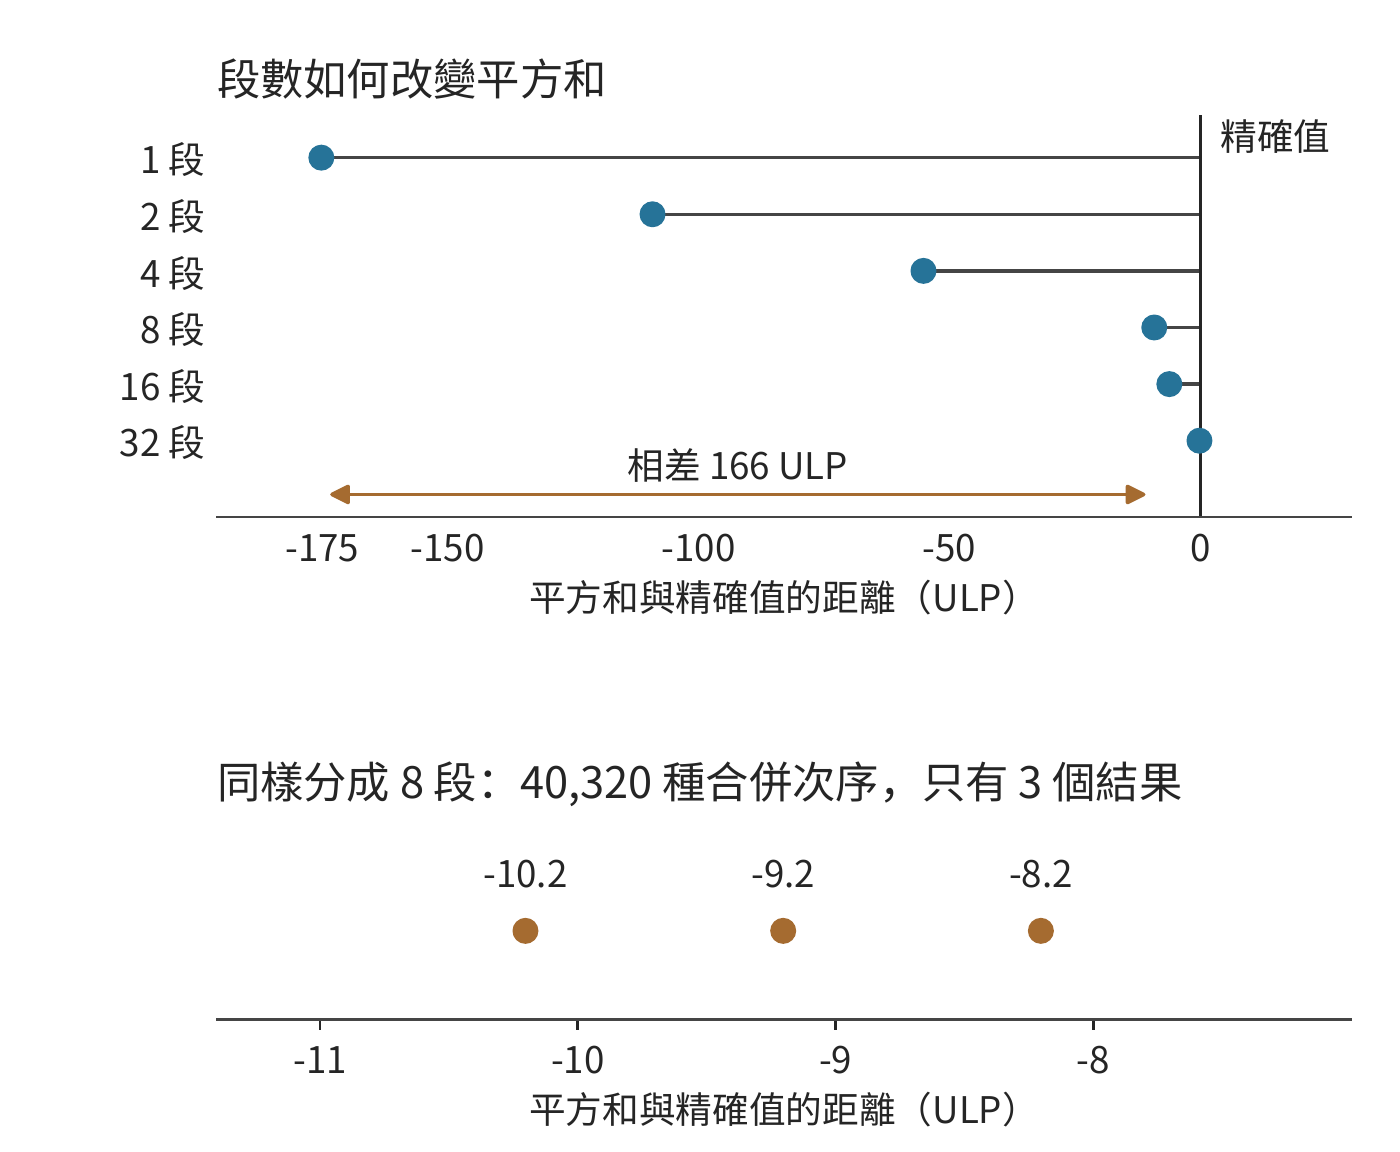
圖 5-13:同一行 4096 個 BF16 元素的平方和與精確值的距離,橫軸單位為 FP32 的 ULP。上半圖比較 1 到 32 段的六種切分;下半圖固定八個區域性和,列出全部合併次序得到的結果。精確值用有理數算得,只作比較基準。
差別並不止於平方和這一步。按 Qwen3-8B 的 rms_norm_eps 繼續計算,兩條路徑的縮放因子相差 59 個 ULP,這一行的第一個輸出元素相差 50 個 ULP,並一起進入下一層。3
切分方式因此不只是速度問題。本小節開頭已經說明,切成幾段取決於能安排出多少並行任務:1024 行時一組一行已足夠,decode 只有一行時必須拆開。同一個 kernel 於是會隨 batch 大小改變段數,同一行輸入在不同 batch 下算出不同的輸出。要讓輸出只由輸入決定,段數和合並次序就都不能隨 batch 變化,代價是小 batch 下並行度退回到拆分之前。第 10.5.3 節正是用這一點解釋:生成端和訓練端載入的是同一份權重,同一個字首算出的 logprob 卻仍然可能不同。
分塊還可以越過一張卡的邊界。單卡中,這些塊的計算由執行緒塊、共享記憶體和區域性歸約協作完成;分到多卡後,切輸出維的執行者要各自取得輸入,切歸約維的執行者要把部分和送到一起相加,這些搬移都要經過卡間互聯。數學依賴沒有改變,變的是搬移資料的距離和代價。
排程則是在分塊之後決定執行順序、放置、緩衝和重疊。例如沿 \(K\) 切分後,是等全部輸入到齊再算,還是邊接收邊累加,會改變儲存佔用和實際等待的時間。模型中的樣本、序列、特徵、層和專家提供更多分工方向;其中層是計算圖上的順序階段,專家是由路由選擇的分支。第 6.1.4 節將把這些分工方向與這裡的三種切法對應起來,第 6.2 節再逐一推導各自的通訊。
矩陣分塊、bank padding 和歸約拆分都在重新安排同一批數學工作。分塊讓多個輸出複用輸入,padding 將讀取請求分散到不同 bank,拆分歸約則增加能夠並行執行的任務。分析程式時,既要分別算清這些變化帶來多少收益和開銷,也要看它們是否改變了浮點結果。配套實驗中的連續存取與寬行歸約對照提供了對應的執行記錄。5
5.3 相鄰運算子的融合、緩衝與流水執行
單運算子內部可以利用區域性儲存複用輸入。相鄰運算子之間也有同樣的機會:前一個運算子的輸出,往往立即成為後一個運算子的輸入。如果後一個運算子能直接讀取區域性儲存中的結果,就能省去一次寫回和重讀。為此,需要確定後一個運算子要用哪些資料,以及這些資料何時全部算好。
5.3.1 中間張量與融合邊界
下面將算例擴充到 FFN 的兩支投影。令 \(G=XW_g\)、\(U=XW_u\),活化運算鏈計算 \(Z=\operatorname{SiLU}(G)\odot U\),再把 Z 交給 down 投影,把結果降回隱藏寬度。G、U、Z 的形狀均為 \([1024,12288]\),以 BF16 儲存時各佔 24 MiB。
SiLU 和 \(\odot\) 都是逐元素運算。Z[i,j] 只依賴 G[i,j] 與 U[i,j],不同位置之間沒有歸約。因此,讀入同一位置的兩個元素後,就能直接算出該位置的最終結果,不必先算出全部 SiLU 結果。
先比較中間結果 \(T=\operatorname{SiLU}(G)\) 的去向。分開執行時,完整 T 要寫到下一級儲存,再由乘法讀回;融合後,一小塊 SiLU 結果可以直接交給同一個 kernel 中的乘法,用完就釋放區域性空間。這就像把工作臺上剛處理好的材料直接交給下一道工序,省去送回遠處再取出的往返。對應到這裡,省去的是中間結果的寫回與重讀,兩步運算仍然都要完成。
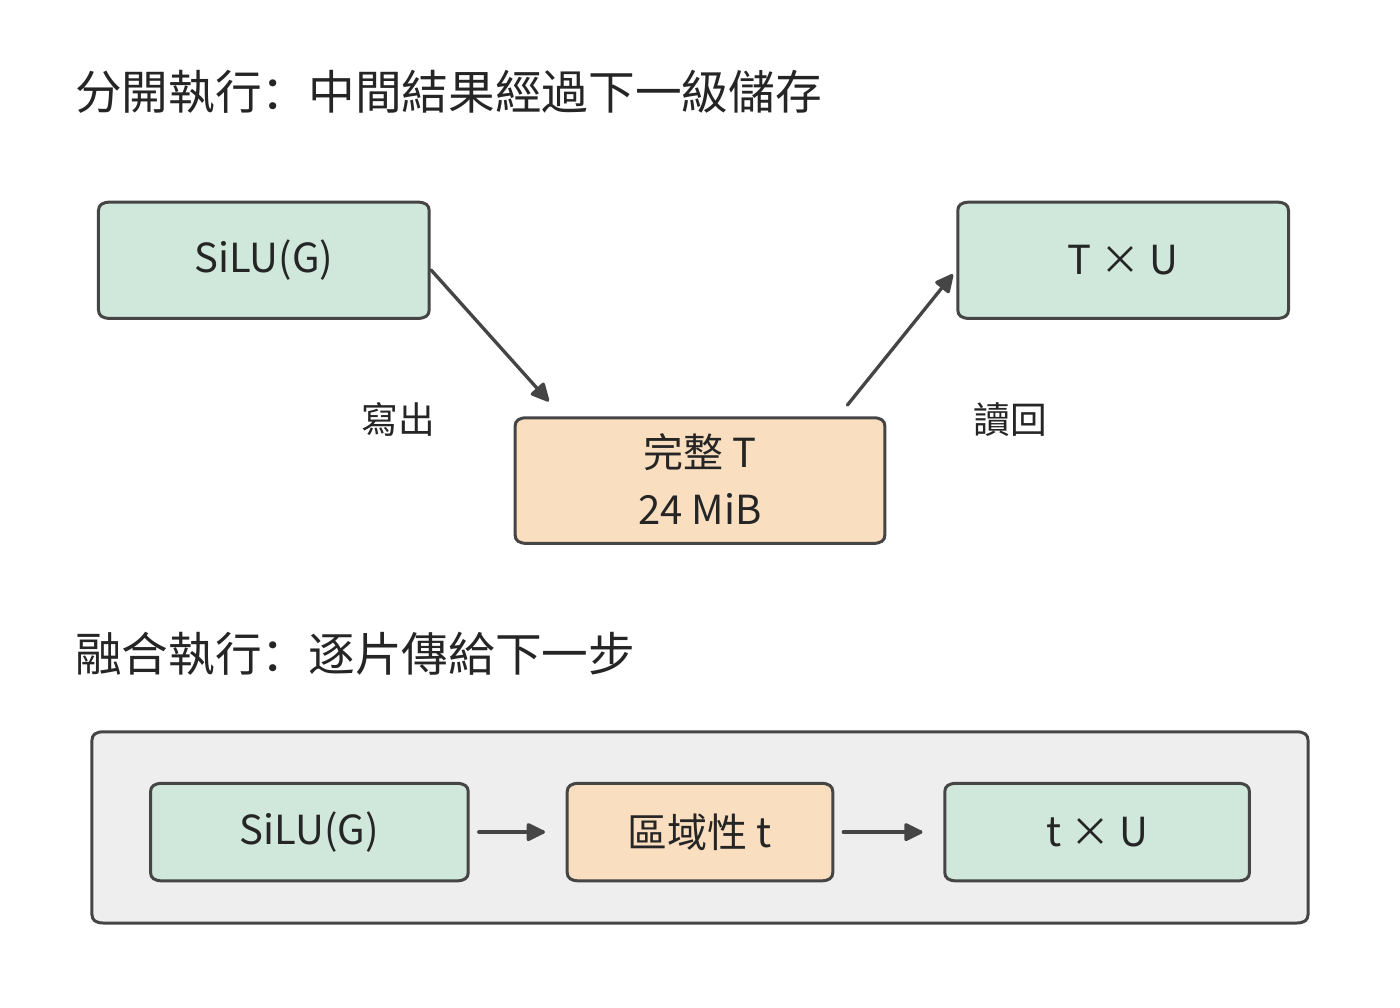
圖 5-14:上半圖的完整 T 經過一次寫出與一次讀回;下半圖中區域性片段 t 直接傳給乘法。兩種方式仍讀取 G、U 並寫出 Z,圖中省略這些共同的輸入輸出邊。融合後仍保留原有的中間結果舍入規則。
例 5-4:活化運算子融合如何減少中間張量讀寫? 分開執行時,先計算 \(T=\operatorname{SiLU}(G)\),讀取 G、寫出 T,共 48 MiB;再計算 \(Z=T\odot U\),讀取 T、U,寫出 Z,共 72 MiB。總讀寫量為 120 MiB。將兩步融合,每次讀取 G、U 的一片,在區域性完成 SiLU 和乘法,寫出 Z,只需 72 MiB。
節省的 48 MiB 正是 T 的一次寫回和一次讀取。沿用上一節的頻寬模型,取兩種程式的有效頻寬相同,時間比為 \(72/120=0.6\),加速約 1.7 倍。實測的活化運算鏈從約 14.2 μs 降到 7.7 μs,加速比約為 1.8。理論計算與實測結果都說明了同一個收益來源:省去完整 T 的寫回和重讀。7
接下來將 Z 按固定 scale 量化,使每個元素只佔 1 byte。獨立轉換需讀取 24 MiB 的 Z,寫出 12 MiB 量化結果,增加 36 MiB。三步完全分開的總量為 156 MiB;融合前兩步為 108 MiB;三步全部融合為 \(24+24+12=60\) MiB。圖 5-15 將必需的輸入輸出讀寫畫在每條柱形的左側,再依次加上兩個中間量的讀寫。
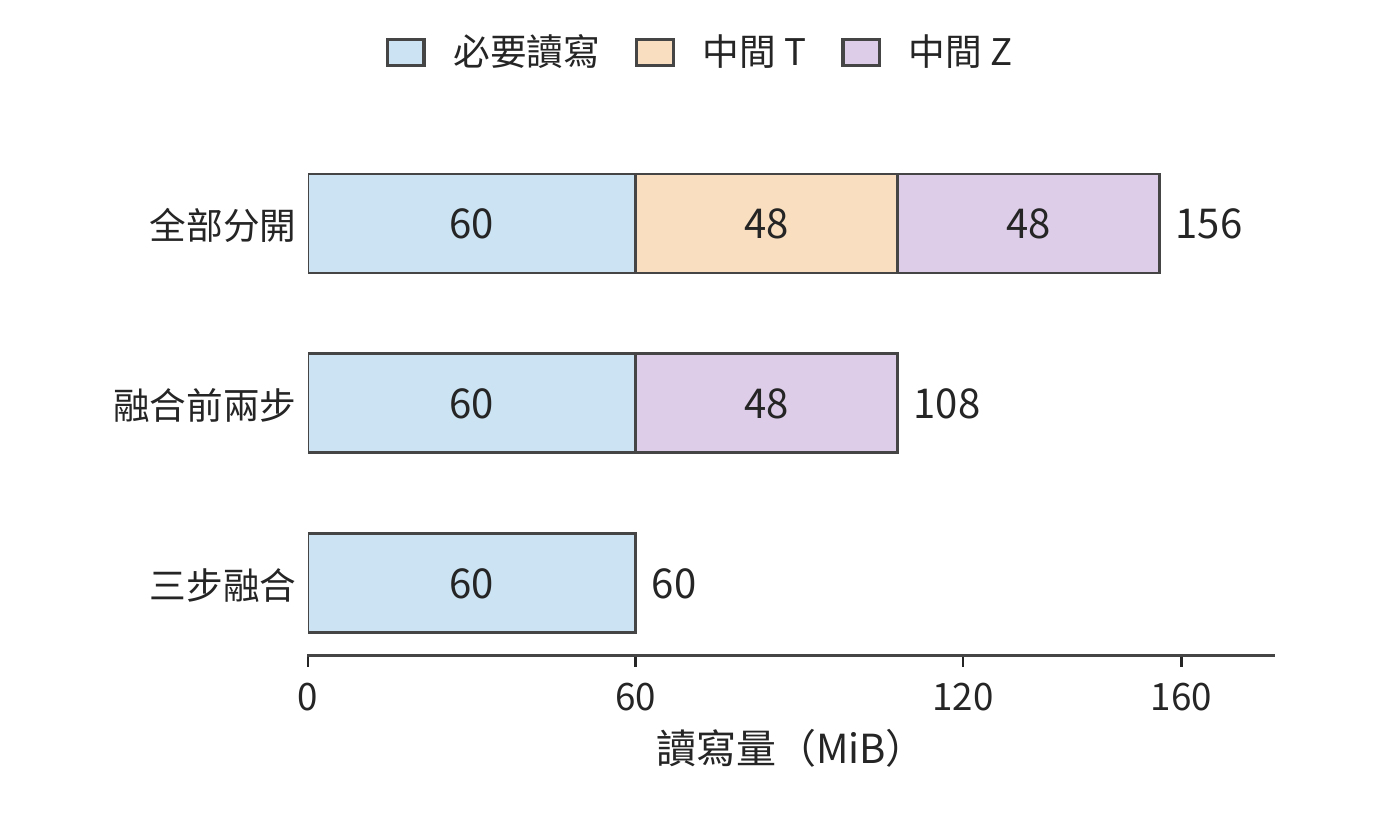
圖 5-15:每少儲存一個 24 MiB 中間量,就少一次寫出和一次讀入,共 48 MiB。G、U 為 BF16,最終輸出佔 1 byte/元素,量化 scale 預先給定。各方案採用相同的運算與舍入順序。
中間張量的容量與存取量在這裡是兩回事。設每步先分配輸出,完成後釋放已用完的輸入。獨立執行 SiLU 時,G、U、T 同時佔用記憶體,峰值為 72 MiB;三步融合時,G、U 與最終輸出同時佔用記憶體,峰值為 60 MiB。讀寫減少 96 MiB,峰值卻只減少 12 MiB,因為同一塊儲存空間可以反覆讀寫。6
逐元素運算的每個輸出只依賴對應位置的輸入,因此可以在讀入後立即計算,減少中間結果的儲存。要讓這種複用順利發生,還需要前後兩步使用彼此相容的資料佈局,並保證緩衝在最後一次讀取結束前不會被覆蓋。下面沿著一個資料塊的使用過程,分析這兩個條件。
5.3.2 佈局轉換、緩衝複用與雙緩衝
相鄰運算子有時使用不同佈局。前一個運算子適合按行寫出,後一個運算子卻需要按另一種塊順序讀取。若另建一份 24 MiB 重排結果,就要讀原結果、寫新結果,共 48 MiB。也可以讓前一個運算子直接按後續計算所需的佈局寫出,省去單獨的重排。比較「計算後再重排」與「計算時直接按新佈局寫出」的總時間,就能判斷哪種方式更快。
緩衝還決定兩個階段能否重疊執行。設搬移器把塊 0 放入槽 A,計算單元隨後讀取 A。計算單元讀取 A 期間,搬移器把塊 1 放入槽 B;計算轉向 B 後,就可以把塊 2 載入到 A。這樣兩個槽交替使用,計算單元讀當前塊時,搬移器就可以寫下一塊。
注意,槽 A 的「資料已經搬完」與「資料已經用完」是兩個時刻。搬移結束後,計算才開始讀取;只有最後一次讀取結束,才能將下一塊資料寫入槽 A,覆蓋原有內容。沿用第 5.1.5 節 H100 一個 SM 上的數值:每塊搬移 1.29 μs、計算 0.28 μs,搬移器和計算單元獨立工作。圖 5-16 展示三個時段中各槽位的狀態,圖 5-17 據此畫出完整的搬移與計算時間線。
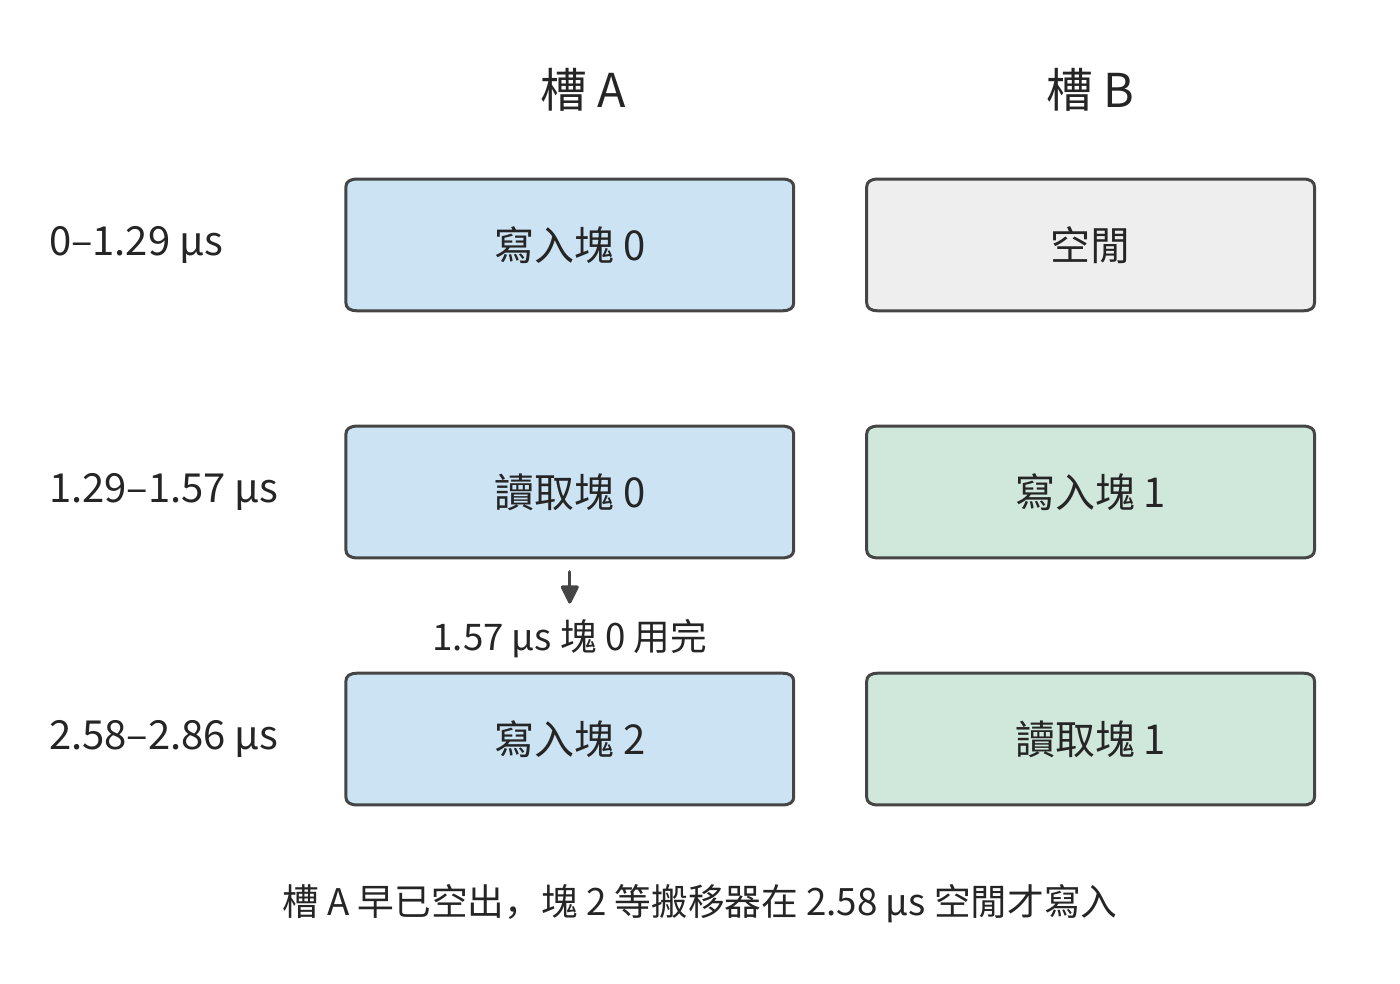
圖 5-16:塊 0 在 1.29–1.57 μs 使用槽 A,此後槽 A 已經空出;塊 2 要等搬移器在 2.58 μs 搬完塊 1,才開始寫入 A。圖中抽取三個時段;1.57–2.58 μs 兩個槽裡都沒有可算的資料,計算單元空等。顏色固定表示槽 A、B,文字說明當前讀寫的是哪個塊。
例 5-5:雙緩衝如何重疊資料搬移與計算? 每塊搬移 1.29 μs,計算 0.28 μs。搬移器和計算單元獨立工作,事件開銷記為零。依序執行四塊需要 \(4\times(1.29+0.28)\approx6.28\) μs。
採用兩個槽後,0–1.29 μs 搬入塊 0,1.29–1.57 μs 計算塊 0;塊 1 同時在 1.29–2.58 μs 搬入。塊 0 在 1.57 μs 就已算完,槽 A 隨即空出,但搬移器要到 2.58 μs 才搬完塊 1、開始寫塊 2。此後搬移器連續工作,每 1.29 μs 送來一塊,計算單元每次只忙 0.28 μs。第四塊於 5.44 μs 完成,時間只減少約 13%。
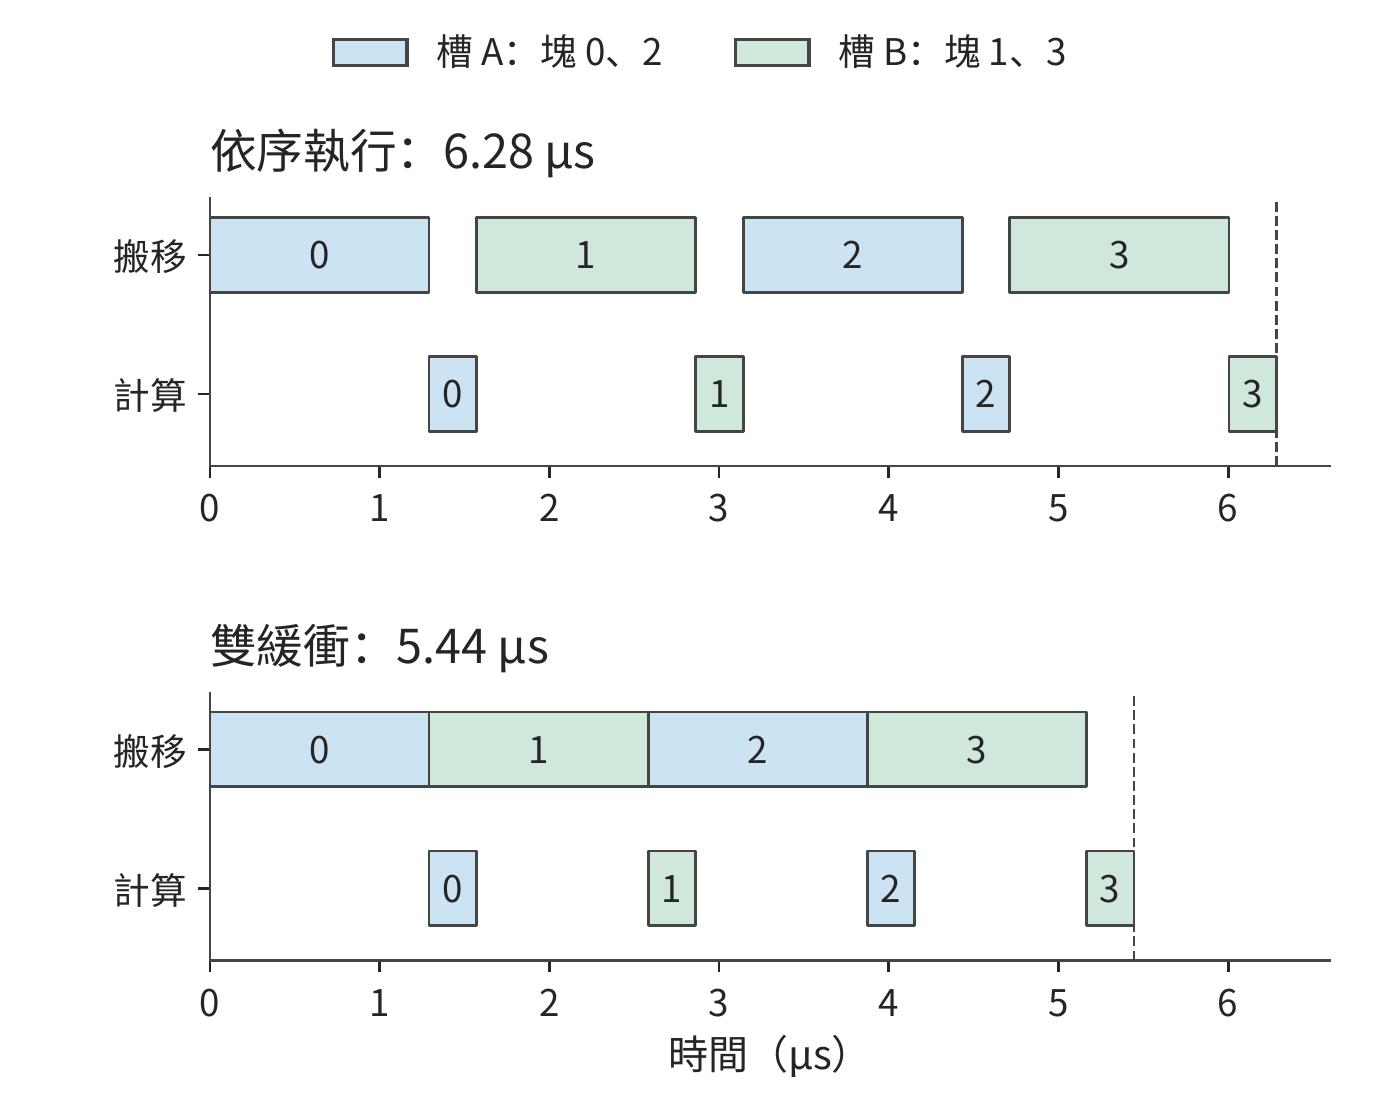
圖 5-17:兩個輸入槽交替複用,讓搬移與計算重疊。H100 一個 SM 上每塊搬移 1.29 μs、計算 0.28 μs,資源獨立,忽略同步開銷;同一顏色表示同一槽。重疊只藏住了計算,完成時間由首尾相接的搬移決定。
將四塊推廣到 n 塊。首塊要先搬移,隨後每隔較慢階段所需的時間完成一塊,末塊還需完成計算。因此:
其中 \(t_m\) 為每塊搬移時間,\(t_c\) 為每塊計算時間。在剛才的例子中,\(t_m>t_c\),搬移器從 0 連續忙到 5.16 μs,總時間為 \(4\times1.29+0.28\approx5.44\) μs,計算單元只有約兩成時間在工作。增加第三個槽無濟於事:兩個槽已讓搬移器沒有空閒,更多的槽不能加快搬移;加快計算同樣無濟於事。兩個槽是能重疊起來的最小設定;把槽數加到 \(n\)、讓搬移提前 \(n-1\) 塊開始,在 CUTLASS 中稱為 \(n\) 個 stage。本例中搬移器已經連續工作,增加的 stage 只會多佔容量;只有當每塊的搬移時間不穩定,或一次搬移的延遲長於一塊的計算時間時,額外的 stage 才能補上空檔,而所需容量隨 stage 數成比例增長。要繼續縮短時間,只能減少每塊要搬的位元組,例如按第 5.2.2 節擴大輸出塊,讓每個輸入位元組參與更多乘加,或讓同時執行的執行緒塊在 L2 中共用輸入塊;再就是換用視訊記憶體頻寬更高的卡。
回到本小節開頭的重排情形:兩個階段的存取順序不同時,緩衝要儲存更多尚未使用的資料。三個排隊的 16 KiB 塊佔 48 KiB,再加 32 KiB 重排空間,共需 80 KiB。RTX PRO 6000 一個執行緒塊最多可用 99 KB 共享記憶體,單獨駐留時可以容納;若一個 SM 要同時駐留兩個這樣的執行緒塊,每塊最多隻能分到 49 KiB(100 KB 扣除兩塊各 1 KiB 預留後平分)。扣掉 32 KiB 重排空間,只剩一個 16 KiB 的排隊槽:寫入第二塊之前,搬移器必須等計算單元用完並釋放該槽。這種下游來不及處理、使上游暫停的機制稱為背壓(backpressure)。選擇共同佈局能夠減少排隊,擴大緩衝則能容納更多已經寫入但尚未使用的資料。8
第 5.1 節的主機輸入也可以按此組織。複製流傳入下一批,計算流處理當前批;計算流等待「複製完成」事件後讀取新輸入,複製流等待「計算完成」事件後覆蓋舊緩衝。這兩種事件分別保證輸入已準備好和舊資料已用完,時間收益則來自兩種資源同時工作。
5.3.3 FlashAttention:分塊與線上 Softmax
第 5.3.1 節融合的逐元素運算,每個輸出只依賴對應位置的輸入;注意力中的 Softmax 卻要用到整行分數。計算一行注意力輸出時,可以先把各位置的分數變成尚未歸一化的權重,用這些權重對值求加權和,最後除以權重總和。可以先處理一塊,記下它對加權和與權重總和的貢獻,再處理下一塊;只要能正確合併貢獻,就不必一直保留已處理過的全部分數。困難在於 Softmax 要根據分數求指數,後面出現更大的分數時,還要調整前面累計結果所用的數值基準。
FlashAttention 圍繞這一逐塊計算過程安排儲存,減少長序列注意力中間矩陣的視訊記憶體讀寫。該方法由斯坦福大學的 Tri Dao 等研究者與紐約州立大學布法羅分校的合作者於 2022 年提出。10
讀到 FlashAttention 時,筆者想起了自己在 2019 年做 AKG 的一段經歷。當時為了融合 Softmax 運算子,筆者四處尋找合適的線上演算法,後來找到 NVIDIA 在 2018 年發表的研究,才得以結合 AKG 的分塊與融合能力,把前面的矩陣乘法和後面的 Softmax 接在一起計算。筆者那時甚至還不瞭解注意力機制,後來才意識到,自己偶然摸到了 FlashAttention 的一條核心思路。從這一步走到完整的 FlashAttention,還需要把後續與 V 的加權求和也納入線上更新,並圍繞完整注意力安排片上儲存和資料搬移。下面的推導會說明,這一看似區域性的演算法變化如何消除大塊中間矩陣。
回到注意力計算本身。標準注意力先計算 \(S=QK^\mathsf{T}/\sqrt d\),再計算 \(P=\operatorname{softmax}(S)\),最後計算 \(O=PV\)。
把這三個運算分別交給通用運算子,可以直接按公式組合程式,運算子之間透過中間張量交換結果。掌握完整注意力計算的資料依賴後,便可以採用另一種編譯與執行方式:利用 Softmax 的歸約關係,跨過獨立運算子的邊界,在小塊資料上連續計算。下面先算出原來完整儲存中間張量的開銷,再推導逐塊計算所需儲存的狀態。
取一個頭,序列長度 \(L=8192\),頭維度 \(d=128\),對全部 token 計算注意力。Q、K、V、O 使用 BF16,各佔 2 MiB;完整 S、P 使用 FP32,各佔 256 MiB。Q、K、V 各讀一次,O 寫一次,共 8 MiB;S、P 各寫一次、讀一次,卻要傳輸 1 GiB 資料。中間矩陣的大小隨序列長度的平方增長,因而造成了大量讀寫。9
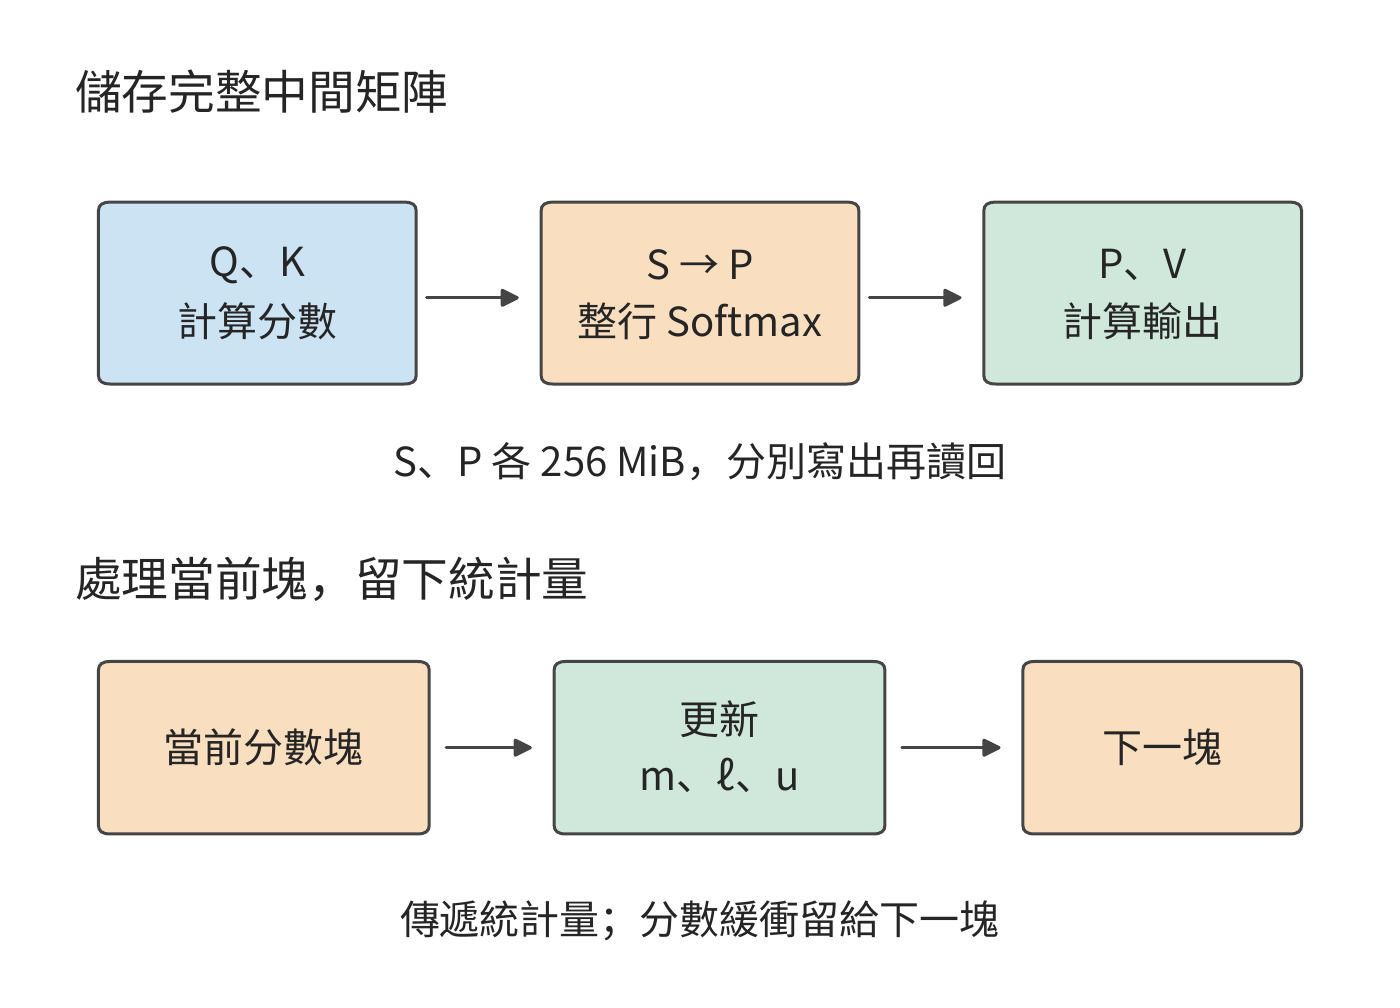
圖 5-18:上半圖儲存完整 S、P,兩份 FP32 矩陣各佔 256 MiB,寫出與讀回合計 1 GiB。下半圖只傳遞已處理部分的最大值 m、指數和 ℓ、加權值 u;每處理完一個塊,其分數緩衝即可複用。箭頭概括處理順序,完整計算還需讀入 Q、K、V。
要省去這 1 GiB 的中間讀寫,可以沿用第 5.3.1 節的思路;但直接套用逐元素融合會遇到一個障礙:Softmax 的分母是整行指數和。只讀到前一塊時,既不知道最終分母,也不知道後面是否會出現更大的分數。
要丟棄已經處理過的分數,需要保留三個量:最大分數 m,以 m 為基準的指數和 \(\ell\),以及相同指數權重下的值之和 u。這裡 u 通常是向量,先用標量值的小例子看清更新過程。
例 5-6:線上 Softmax 如何合併分塊結果並保持歸一化? 分數為 \([0,\ln2]\),對應值為 \([1,3]\),每塊只含一個元素。第一塊得到 \(m=0,\ell=1,u=1\)。處理第二塊後,最大值增至 \(\ln2\),將原來的 \(\ell\) 和 u 都乘以 \(r=1/2\);新元素的指數為 1,於是 \(\ell'=1/2+1=1.5\),\(u'=1/2+3=3.5\),結果為 \(7/3\)。一次處理整行時,兩個權重正比於 1 和 2,結果同樣為 \((1+2\times3)/3=7/3\)。
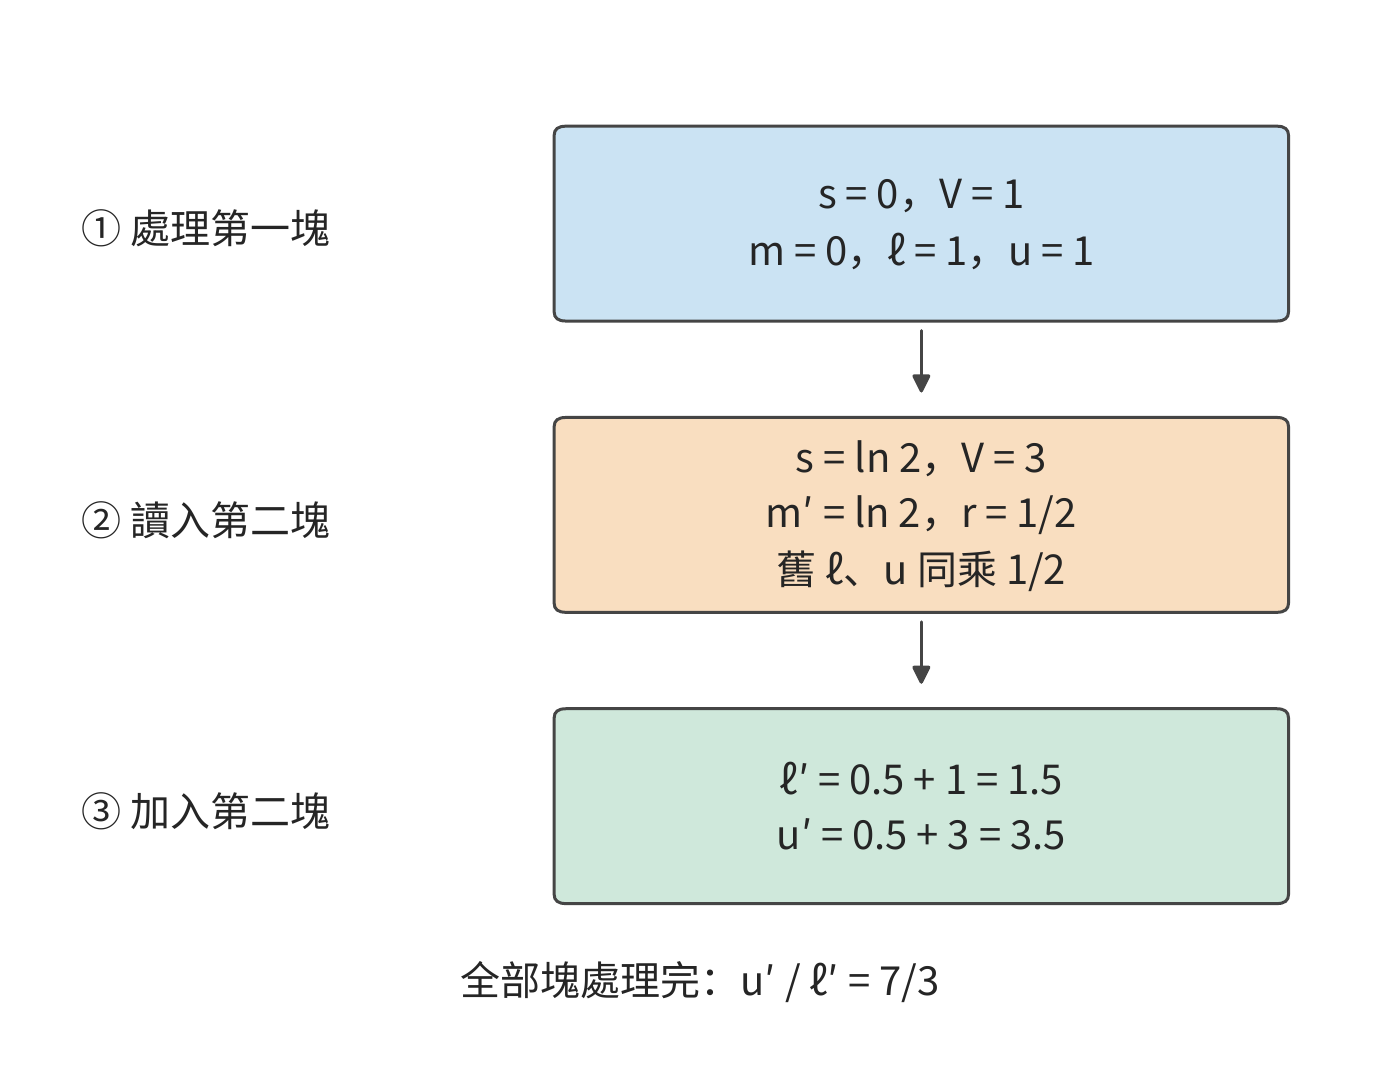
圖 5-19:兩個塊的分數分別為 0、ln 2,值分別為 1、3。最大值增大後,將舊指數和與舊加權值同時乘以 1/2,再加上新塊的貢獻,最後才做除法。箭頭傳遞的是統計量,舊分數無需保留。m 是已處理分數的最大值,ℓ 是以 m 為基準的指數和,u 是對應的值向量加權和,r 是更換最大值基準時的縮放係數。
小例子中,第二塊把最大值從 0 提高到 ln 2。舊項原來的指數為 1,換到新基準後變成 1/2;分母中的舊貢獻和分子中的舊貢獻必須同時縮小,才能保持它們的相對權重不變。
推廣到一行分數,減去共同最大值可避免指數溢位。令 \(\ell=\sum_j\exp(s_j-m)\)、\(u=\sum_j\exp(s_j-m)V_j\),最終輸出為 \(u/\ell\)。新塊到來後,把舊狀態改到新的最大值基準,再加上新塊貢獻:
右側求和只遍歷新塊中的 j,舊塊的全部貢獻已經儲存在 \(\ell\) 與 u 中,無需重新讀回舊分數。
FlashAttention 正是利用這一遞推關係省去了完整 S 和 P 的儲存。每處理完一塊,就更新 m、\(\ell\) 和 u;該塊的分數和機率用完即可丟棄,其緩衝可以留給下一塊。在相同注意力範圍內,查詢與鍵的匹配、值的加權仍然都要算;改變的是計算順序與中間結果的儲存方式,浮點執行還會有舍入差異。
這樣就把儲存完整分數矩陣的問題,變成了在快速儲存中安排當前塊的問題。接下來確定一次處理多少行 Q、多少行 K/V,才能更好地利用這塊空間。取 RTX PRO 6000 一個執行緒塊可用的 99 KB 共享記憶體(101,376 bytes)作快速緩衝,一次保留 a 行 Q 與 FP32 輸出累加器,分數塊大小為 a×b。K 與 V 按階段複用同一個 b×d 輸入槽,分數和機率複用一個 a×b 槽,另為逐行統計和更新暫存分配三個 FP32 向量。區域性儲存需求為:
K/V 塊越小,其自身和分數塊佔用越少,就能容納更多 Q 行。更多 Q 行共享一次 K/V 掃描,整份 K/V 被重讀的次數隨之減少。取 b=64,能容納 a=82 行 Q,需要 \(\lceil8192/82\rceil=100\) 次完整掃描。每次讀 4 MiB 的 K/V,另有一次 Q 讀取和 O 寫回,共 \(100\times4+4=404\) MiB。
將 b 縮為 1,能容納 a=128 行 Q,掃描次數降為 64,存取量降至 \(64\times4+4=260\) MiB。但每次掃描從 128 個 K/V 塊變成 8192 個塊,線上狀態必須更頻繁地更新。
| K/V 塊行數 b | 可容納的 Q 行數 a | K/V 完整掃描次數 | 緩衝與下一級儲存之間的存取 | Q 塊與 K/V 塊之間的狀態更新次數 |
|---|---|---|---|---|
| 1 | 128 | 64 | 260 MiB | 524288 |
| 64 | 82 | 100 | 404 MiB | 12800 |
| 128 | 53 | 155 | 624 MiB | 9920 |
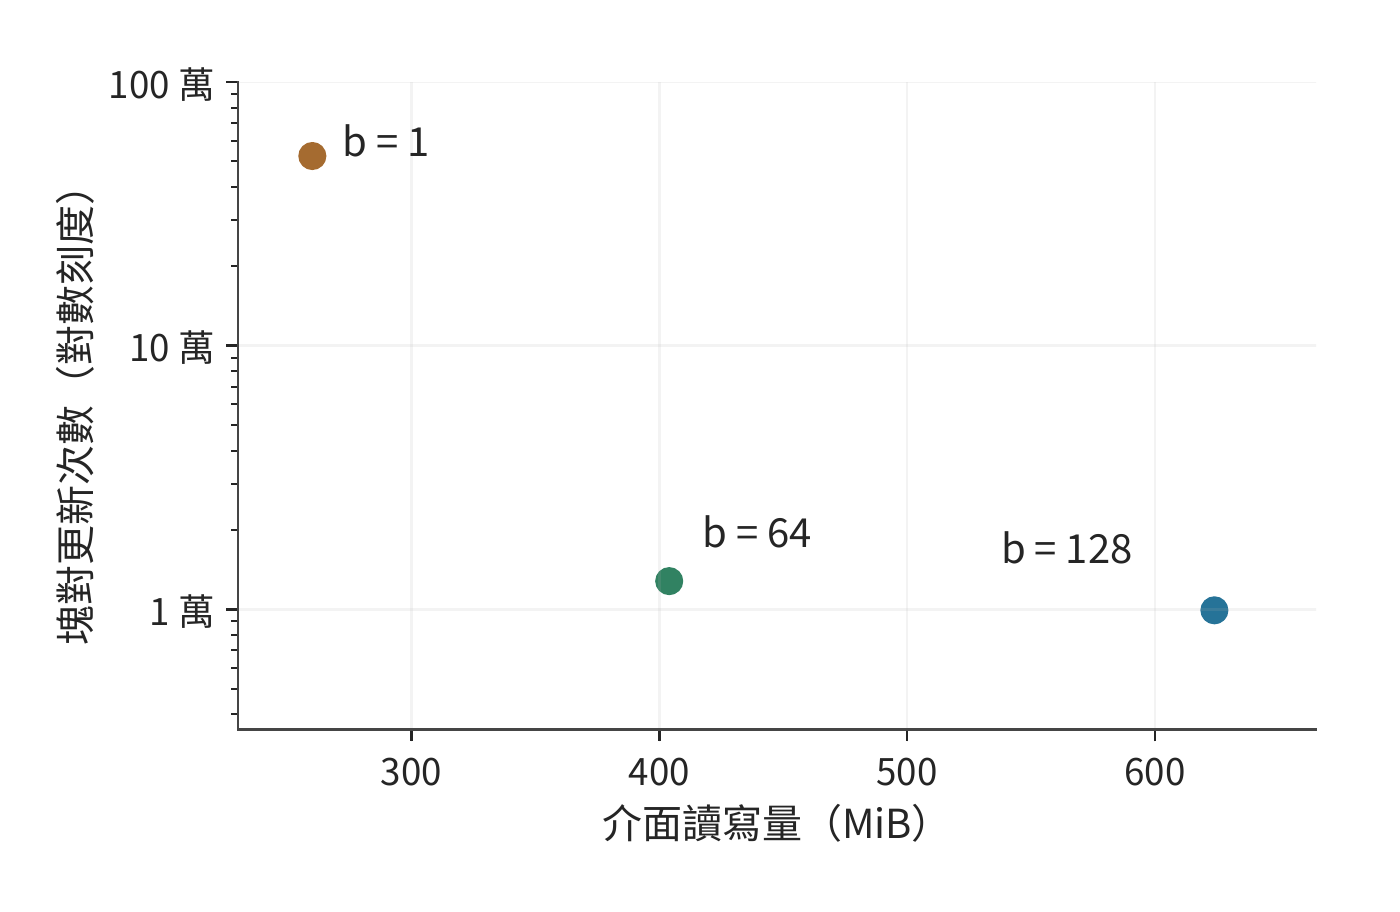
圖 5-20:快速緩衝為 RTX PRO 6000 一個執行緒塊的 99 KB 共享記憶體,序列長 8192、頭維度 128,無掩碼;每個點對應正文表格的一種 K/V 塊大小。橫軸為緩衝與下一級儲存之間的存取量,縱軸為線上更新次數,採用對數刻度。從 b=64 的點移到 b=1 的點,讀取減少,更新次數卻約增至 41 倍。b 表示一個 K/V 塊中包含的 token 數。
圖 5-20 把兩項代價放在同一平面上,越靠左表示少讀資料,越靠下表示少做更新。從 64 行塊縮到 1 行塊,少讀 144 MiB,卻把狀態更新從 12800 次增至 524288 次,約為原來的 41 倍。每次更新都要執行迴圈控制、最大值比較、指數與輸出縮放;每次只處理一行 K/V,也使矩陣乘的一個維度過小,難以充分利用矩陣計算單元。較小的 K/V 塊能減少讀取,卻會增加更新次數;較大的塊則有利於矩陣計算,並減少迴圈開銷。因此,選擇塊大小時,需要同時比較這兩類開銷。
線上歸約消除了完整中間矩陣的讀寫,但塊內的矩陣乘、指數計算和統計量更新仍要執行。後續最佳化便轉向這些剩餘工作。FlashAttention-2 改進了執行緒之間的任務分配,減少中間資料交換和非矩陣運算;FlashAttention-3 利用非同步執行,讓搬移、矩陣乘和 Softmax 相互重疊。省去巨大的中間矩陣之後,這些改進進一步縮短了剩餘的計算和搬移時間。10
為了檢驗這些機制在實際程式中的效果,配套實驗比較了 PyTorch 中同一個注意力介面的兩種實作。這裡的後端(backend),指框架在介面內部實際選用的計算程式:呼叫者給出相同的 Q、K、V,框架可以用不同程式完成注意力計算。
數學後端(SDPBackend.MATH)按注意力公式組合矩陣乘、Softmax 等通用運算,儲存完整的分數和機率中間矩陣。FlashAttention 後端(SDPBackend.FLASH_ATTENTION)採用前面介紹的分塊與線上歸約方法,避免儲存完整的中間矩陣。實驗分別指定這兩個後端,比較它們完成同一次注意力計算的時間與新增視訊記憶體。
實驗用 RTX PRO 6000 Blackwell,輸入輸出為 BF16,一次處理一個序列、一個注意力頭,頭維度為 128。序列長為 8192 個 token;採用因果注意力,即每個位置只使用自身及此前的位置。預熱後,使用 CUDA Graph 將一組 GPU 操作預先記錄並重復執行,以免每次由主機提交造成干擾。按每次注意力計算統計,儲存完整中間矩陣的數學實作約需 2.6 ms,採用分塊與線上歸約的 FlashAttention 實作約需 80 μs,後者的加速比約為 33。11
再比較一次普通呼叫的新增視訊記憶體佔用峰值。輸入 Q、K、V 預先駐留視訊記憶體,計量範圍為輸出與臨時工作區:數學實作約為 848 MiB,FlashAttention 實作約為 22 MiB。
這組完整實作的對照說明了分塊、線上歸約和融合如何配合:分塊使當前資料能放入快速儲存,線上歸約使 Softmax 可以逐塊計算,融合省去塊內中間結果的寫回。三者共同改變了執行時間與中間儲存需求。
5.4 編譯器:表達、變換與選擇
前兩節透過手工分析選擇了迴圈、塊大小、緩衝和運算子邊界。實際模型會使用多種輸入形狀和運算子組合,每種加速器也有不同的儲存層級和執行資源。編譯器的任務,是用程式表示這些實作方式,根據依賴關係排除錯誤的變換,再比較其餘實作的執行開銷。
5.4.1 為什麼要比較多種實作
回顧逐元素鏈:SiLU 對每個數執行非線性變換,再與另一輸入對應相乘,最後量化成低位寬表示。兩處相鄰運算子之間,都可以選擇分開執行或融合執行,共有四種劃分:三步獨立、融合前兩步、融合後兩步、三步融合。如果一條鏈包含十個運算子,就有 \(2^9=512\) 種相鄰邊界劃分。每一種劃分還可以選擇塊大小、區域性佈局和流水深度。
這些選擇會相互影響。合併兩步可以消除中間寫回,但也會增加同一時刻需要儲存的值;臨時資料增多,又會改變能夠採用的塊大小。因而,編譯器要同時表達計算內容、執行順序和資料存放位置。只記錄一個運算子名,無法推導這些代價。
編譯器可以按三個步驟選擇實作。首先,把數學運算表示為迴圈和陣列存取,明確可以變換的迴圈及其讀寫關係;其次,根據讀寫依賴和數值規則檢查合法性;最後,結合容量和實測時間比較執行成本。下面先用可讀的迴圈展示前兩步,再說明自動運算子程式碼生成系統 AKG 如何透過多面體編譯(用線性約束描述迴圈迭代與陣列存取的編譯方法)組織整個過程。
5.4.2 用迴圈變換表達分塊與融合
第 5.2 節決定了每次處理多大一塊,還要決定這些塊按什麼順序計算。同樣切好的資料,若剛用過就換走,隨後又要重新搬回,仍然會產生不必要的存取。迴圈變換讓程式表達這些安排:split 將迴圈拆成「第幾塊」和「塊內第幾個位置」;reorder 調整遍歷順序,讓即將再次使用的資料有機會留在區域性儲存中。再選擇在哪一層迴圈儲存或使用中間結果,就能明確它要留下多久。
取 \(Y=\operatorname{SiLU}(AW)\),沿用 \(M=1024,K=4096,N=12288\),矩陣乘用 FP32 累加,結果舍入為 BF16 後再計算活化函數。最直接的程式先生成完整 C,再遍歷 C 生成 Y:
for i in range(M):
    for j in range(N):
        acc = 0.0
        for k in range(K):
            acc += A[i, k] * W[k, j]
        C[i, j] = round_to_bf16(acc)

for i in range(M):
    for j in range(N):
        Y[i, j] = silu(C[i, j])
第一項變換是拆分(split)。把 i 拆成塊號 \(i_o\) 與塊內座標 \(i_i\),令 \(i=64i_o+i_i\)。原來的 1024 行就成為 16 個塊,每塊 64 行。對 j 同樣處理,得到 192 個列塊。同時拆分兩個輸出維度,就形成 64×64 的 tile。
拆分首先改變了索引的表示方式。要連續完成一個 tile,還需要重排(reorder):在外層迴圈中遍歷輸出塊,在內層迴圈中遍歷塊內元素。再把 K 按 32 拆成 128 個歸約塊。程式先選定一個輸出 tile,逐塊載入所需 A、W,累加到同一個輸出塊中。
採用這種迴圈結構後,就能確定輸入塊需要保留多久。A、W 的當前塊各佔 4 KiB,在一次歸約塊計算後即可替換;4096 個 FP32 累加器佔 16 KiB,要一直保留到全部 128 次歸約塊計算結束。因此,兩類緩衝應在不同的迴圈層分配和釋放。
最後調整活化函數的計算位置。一個輸出 tile 完成全部 K 歸約後,其 4096 個 C 值已經全部算好,可以立即做 SiLU 並寫出 Y;其他輸出 tile 尚未完成也不影響這一片結果。這樣只需在區域性儲存當前輸出塊的結果,不再需要完整 24 MiB 的 C,也就省去了 48 MiB 寫回與重讀。
for io in range(ceil_div(M, BM)):
    for jo in range(ceil_div(N, BN)):
        acc = zeros_fp32(BM, BN)
        for ko in range(ceil_div(K, BK)):
            a = load_tile(A, io, ko, BM, BK)
            w = load_tile(W, ko, jo, BK, BN)
            matmul_accumulate(acc, a, w)
        c = round_to_bf16(acc)
        store_tile(Y, io, jo, silu(c))
這裡 load_tile 和 matmul_accumulate 分別表示成塊讀取和矩陣累加;最後一個不足整塊的 tile 用掩碼標出有效位置。虛擬碼的縮排清楚地標出了這些先後關係:輸入塊在 ko 迴圈內更新,累加器在整個 ko 迴圈期間始終保留,活化函數計算在 ko 迴圈結束後執行。
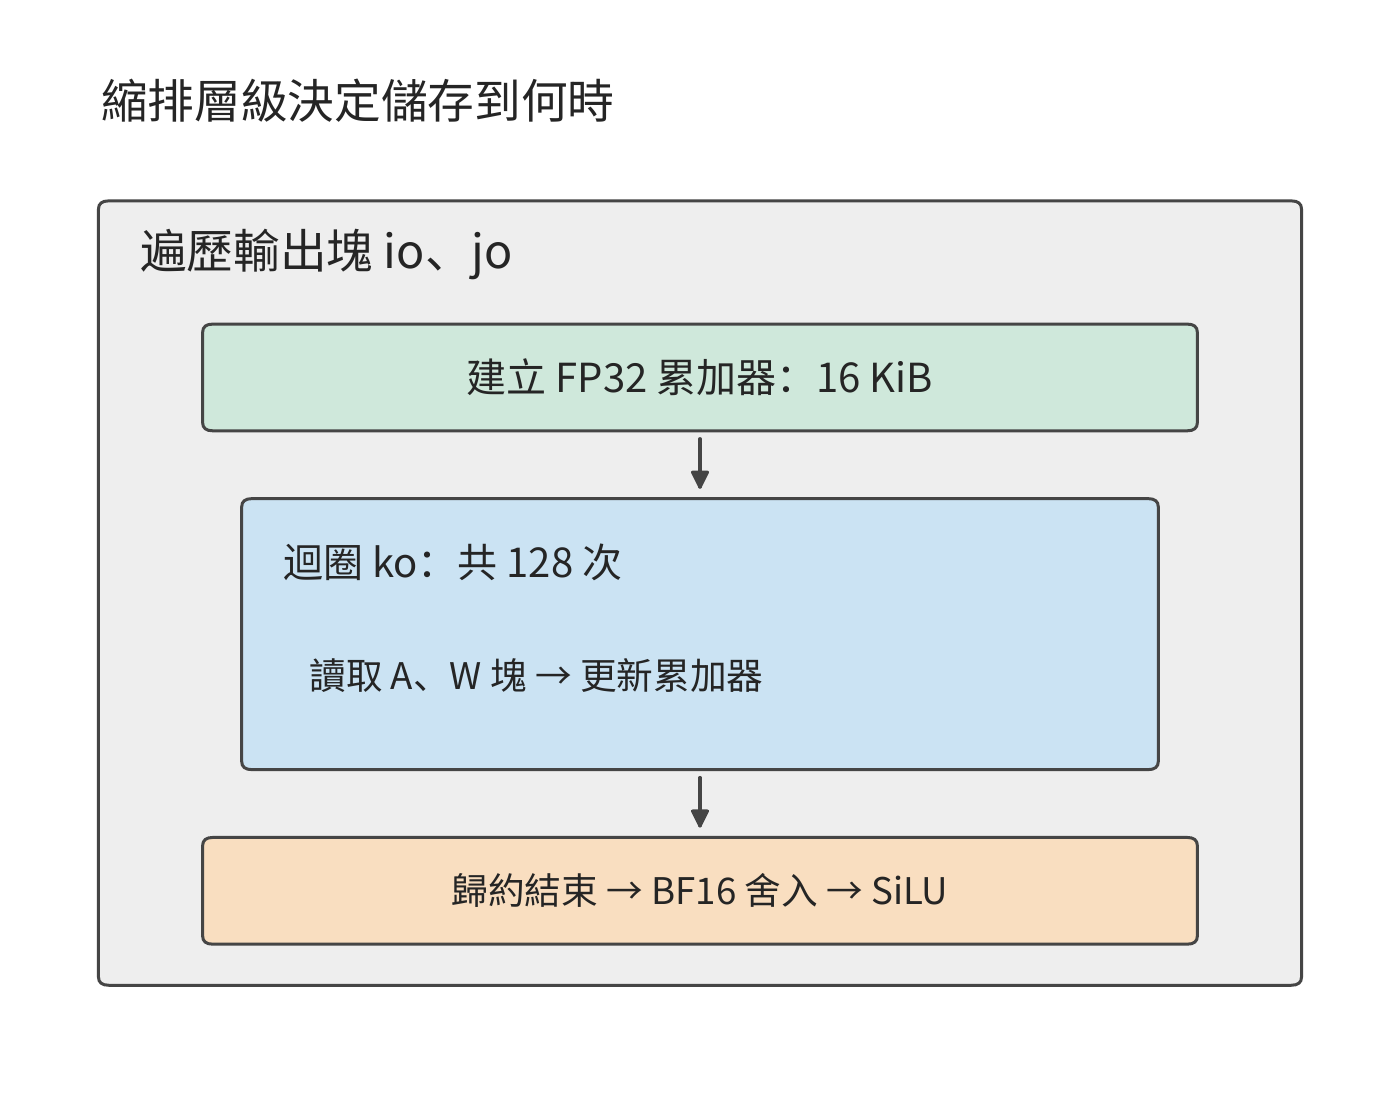
圖 5-21:迴圈層次決定臨時資料需要儲存多久。外層選輸出塊,建立 16 KiB 累加器;內層 ko 反覆讀取 A、W 塊,全部歸約結束後再舍入並計算活化函數。
這些排程動作在程式設計系統中有對應的表達。Halide 是把「計算什麼」和「如何排程」分開表達的程式設計系統,程式設計師用 split、tile、reorder 等動作改變執行方式。這裡把生成中間結果的運算子稱為生產者,使用該結果的運算子稱為消費者。compute_at 指定生產者在消費者的哪一層迴圈內執行。TVM 是面向張量計算的編譯系統,也透過排程指定計算位置和快取讀寫,讓相鄰運算子在同一塊資料上連續計算。14
計算位置同時決定複用和重算。把生成中間結果的計算放在最外層,會先算出完整結果,供所有後續計算讀取;放到後續計算的分塊迴圈內,就只算當前需要的部分。如果多個輸出塊需要同一部分中間結果,在每個塊內計算就會造成重複。編譯器因此要比較兩種做法:先儲存中間結果供多次讀取,或在每次使用前重新計算。
迴圈中的 fuse 還可以把多個迭代維合成一個維度。例如,可以將 16×192 個輸出塊的二維座標轉換為 0 到 3071 的一維編號,再分配給加速器工作組。這改變了遍歷輸出塊和分配任務的方式;將 SiLU 緊接在矩陣乘的 tile 後面,則省去了中間矩陣的寫回和重讀。兩者可以在同一份排程中組合使用。
5.4.3 依賴與舍入如何限制變換
上一小節把活化函數移入輸出 tile,但仍安排在 ko 迴圈結束後執行,原因可以用兩個數說明。設一個輸出的兩個部分和為 1 與 −1,完整和為 0,SiLU(0)=0。若在每個部分和之後先做 SiLU,再相加,結果為 \(\operatorname{SiLU}(1)+\operatorname{SiLU}(-1)\approx0.4621\)。把活化函數計算移到完整求和之前,已經改變了運算。
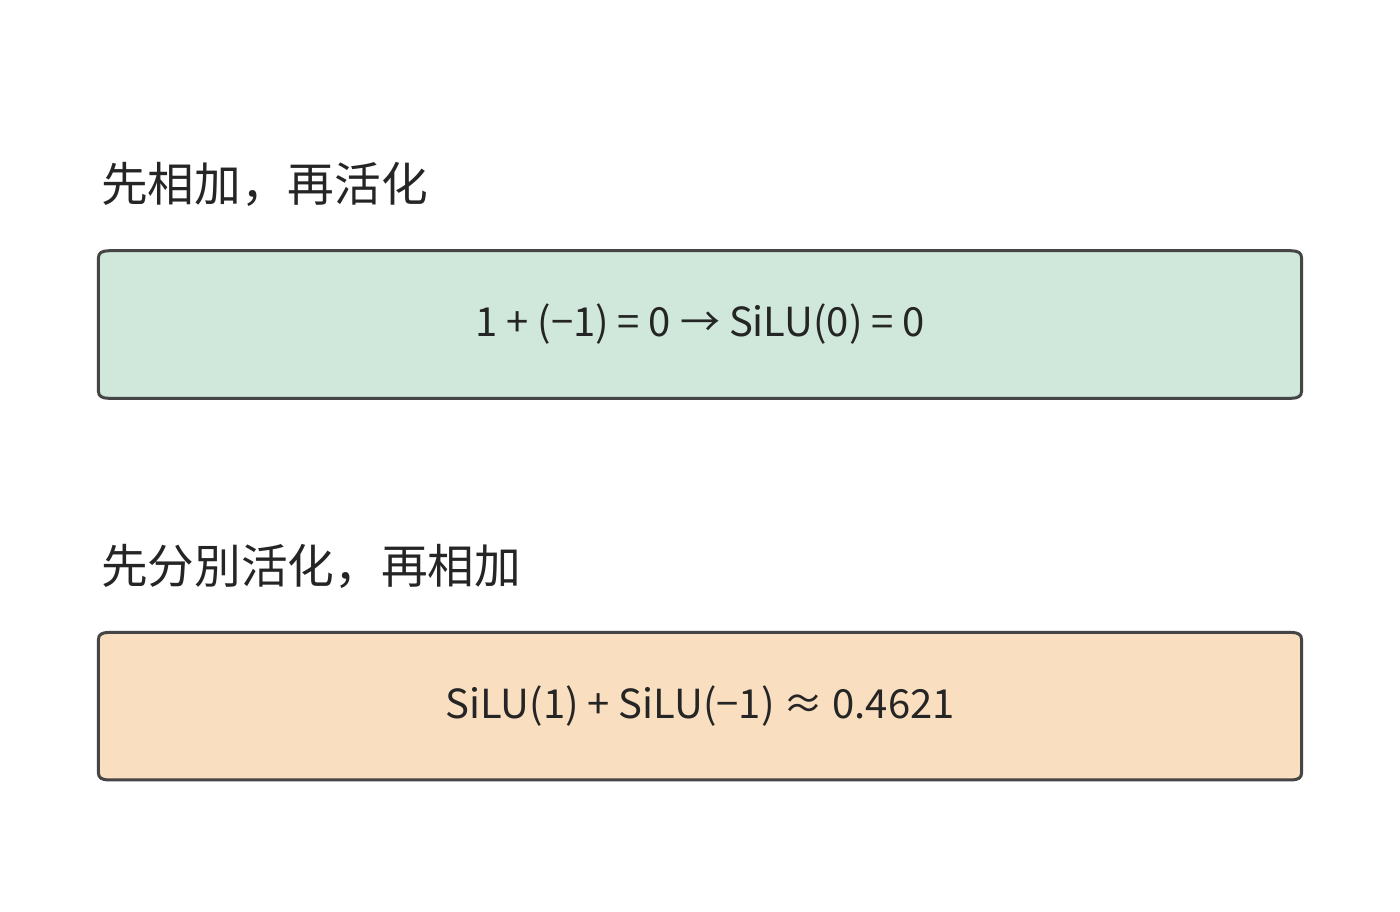
圖 5-22:同樣兩個部分和,先相加得到零,再做 SiLU 仍為零;先對各部分做 SiLU 再相加,得到約 0.4621。兩個數說明把活化函數計算移到求和之前會改變結果。
編譯器需要遵守的依賴關係因此有兩個層次:同一輸出的部分和要按歸約規則合併,後續運算子要等所需的結果算好。不同輸出可以平行計算;同一輸出的歸約和後續運算則必須按依賴順序執行。
分塊歸約同樣受這條依賴約束。第 5.3.3 節的 FlashAttention 能逐塊完成計算,是因為它保留了 m、\(\ell\)、u,並在最大值改變時,同時調整之前累加的指數和與加權值。若只保留每塊已經歸一化的輸出,就丟失了各塊分母的相對大小。例如兩個塊各自只有一個值,分別為 1 和 3,塊內輸出仍是 1 和 3;僅憑這兩個輸出,無法判斷整行 Softmax 應給它們分配 1:2 還是 2:1 的權重。因此,分塊歸約必須儲存足夠的統計量,才能正確合併各塊的結果。
浮點舍入進一步限制了變換。原程式將 FP32 累加結果舍入為 BF16,再計算活化函數,融合後的程式也要在活化函數運算之前執行 round_to_bf16。中間值可以從暫存器直接傳給活化函數,但這次舍入仍然存在。資料存放位置與數值格式是兩項獨立選擇。
例 5-7:整行量化 scale 如何約束分塊計算順序? 一行包含 256 個元素,分成兩個塊,每塊各含 128 個元素,兩個塊的首個元素分別為 1 和 10,其餘為零。量化使用 E4M3FN 格式:一種含符號位、四位指數和三位尾數的八位浮點表示,最大有限值為 448。scale 由整行最大絕對值決定;隨後做點積,權重僅第一個元素為 1。因此結果完全取決於第一個元素如何量化。
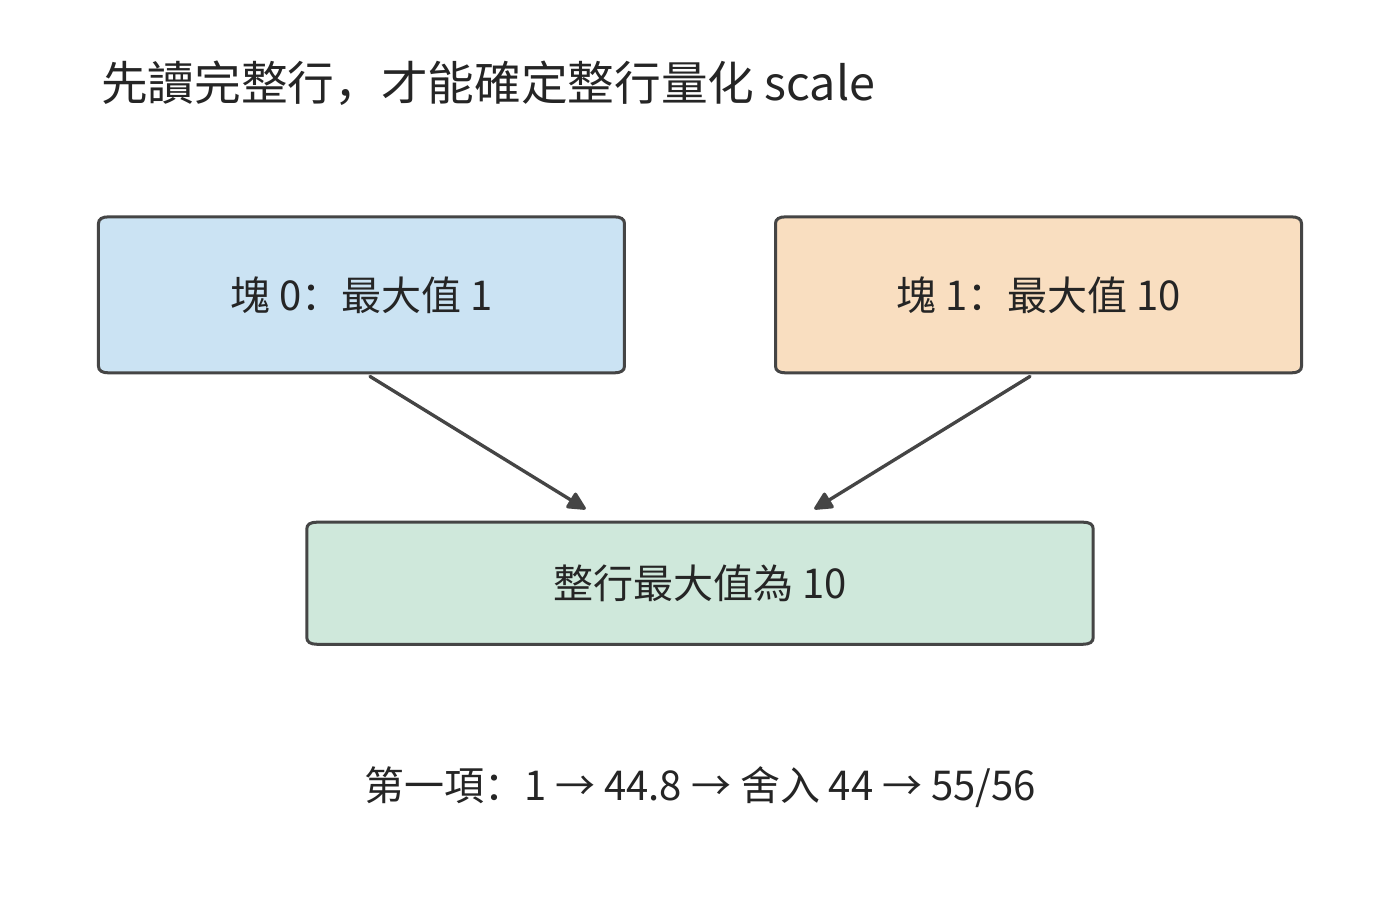
圖 5-23:一行分成兩個塊,後一塊中的 10 決定整行 scale。第一項要先按這一 scale 對映,再舍入到格式允許的值,最後反量化。
先讀完整行,最大值為 10。第一項縮放為 \(1\times448/10=44.8\),舍入到該格式可表示的 44,反量化結果為 \(44\times10/448=55/56\)。若讀完第一塊就量化,當時最大值為 1,第一項可表示為 448,反量化結果恰好為 1。
讀到後一塊中的 10 後,即使調整後續計算所用的 scale,第一項也不可能重新經歷 44.8→44 的舍入。兩種做法的結果相差 \(1/56\),約 1.8%。因此,按整行最大值確定 scale 時,應先讀完一行求出最大值,再量化。15
這些例子說明了哪些變換可以做,哪些運算順序必須保留。輸出之間可以交換執行順序,輸入可以分塊快取,算好的結果可以直接供後續運算使用;歸約的合併方式和量化的舍入位置則屬於運算定義,需要在變換中保留。
5.4.4 AKG:用多面體編譯組織迴圈與儲存
AKG 是面向張量運算子的自動程式碼生成與最佳化系統,其核心技術是多面體編譯(Polyhedral Compilation)。該方法把規則迴圈表示為三類資訊:有哪些迭代要執行,每次迭代讀寫哪些陣列元素,以及哪些讀寫必須保持先後順序。迴圈邊界和規則下標可以用線性約束描述,這就是「多面體」名稱的來源。藉助這種表示,編譯器能夠推導迭代之間的依賴,並據此調整執行順序。12
以矩陣乘為例,編譯器可以確定不同 i、j 對應不同輸出,沿 k 的更新則指向同一個累加結果。選定 64×64×32 的 tile 後,還可以由陣列存取推導當前需要的 A、W 區域:A 為 64×32,W 為 32×64。這樣既能確定迴圈的執行順序,也能確定需要讀入哪些資料,以及這些資料要儲存多久。
AKG 從張量表示式生成多面體表示,將分塊與分層融合結合起來:在外層安排完整運算子的執行順序,在內層安排各塊的連續計算和區域性快取。儲存管理根據這些區域分配片上空間、插入搬移,程式碼生成再將計算對映到硬體執行方式,調優階段選擇塊形狀等參數。前文手工完成的「拆分迴圈—確定讀取區域—保留累加結果—完成歸約後執行活化函數」,在這裡成為相互聯絡的編譯步驟。
將計算和儲存一起分析,也能解釋融合為什麼會增加訪存。前面的逐元素鏈透過融合少讀了中間值;若中間結果採用位數更少的表示,又要供後續計算反覆讀取,保留它反而可以減少讀取。
例 5-8:量化單獨執行還是融合進矩陣乘,哪種方式讀寫更少? 取 \([4096,4096]\) 的 FP16 輸入 A,佔 32 MiB,量化為 FP8 後佔 16 MiB;FP8 權重為 \([4096,1536]\),佔 6 MiB,FP16 輸出佔 12 MiB。輸出按 128×128 分塊,共有 32 個行塊、12 個列塊。各輸出塊獨立讀取所需資料,量化 scale 來自整行最大值。
先看單獨執行量化的做法。每處理一行,就用 8 KiB 區域性空間儲存該行輸入,求出 scale 後再量化。全部輸入共讀入 32 MiB,量化結果共寫出 16 MiB。隨後,12 個輸出列塊各讀取一遍 FP8 輸入,共 192 MiB。因此,與輸入有關的讀寫量為 \(32+16+192=240\) MiB。
把量化合併到矩陣乘中後,先讀取 32 MiB 原輸入求出每行的 scale;12 個列塊隨後各讀一次原來的 32 MiB 輸入,並在本地量化。輸入相關存取為 \(32+12\times32=416\) MiB。雖然省去了 16 MiB 量化結果的寫出,但每個列塊讀取的輸入從 16 MiB 增至 32 MiB,12 次讀取增加了 192 MiB。
兩種方案都由 32 個行塊各讀取 6 MiB 權重,再寫出 12 MiB 輸出,共 \(32\times6+12=204\) MiB。因此總存取量分別為 \(240+204=444\) MiB 與 \(416+204=620\) MiB,融合後增加約 40%。
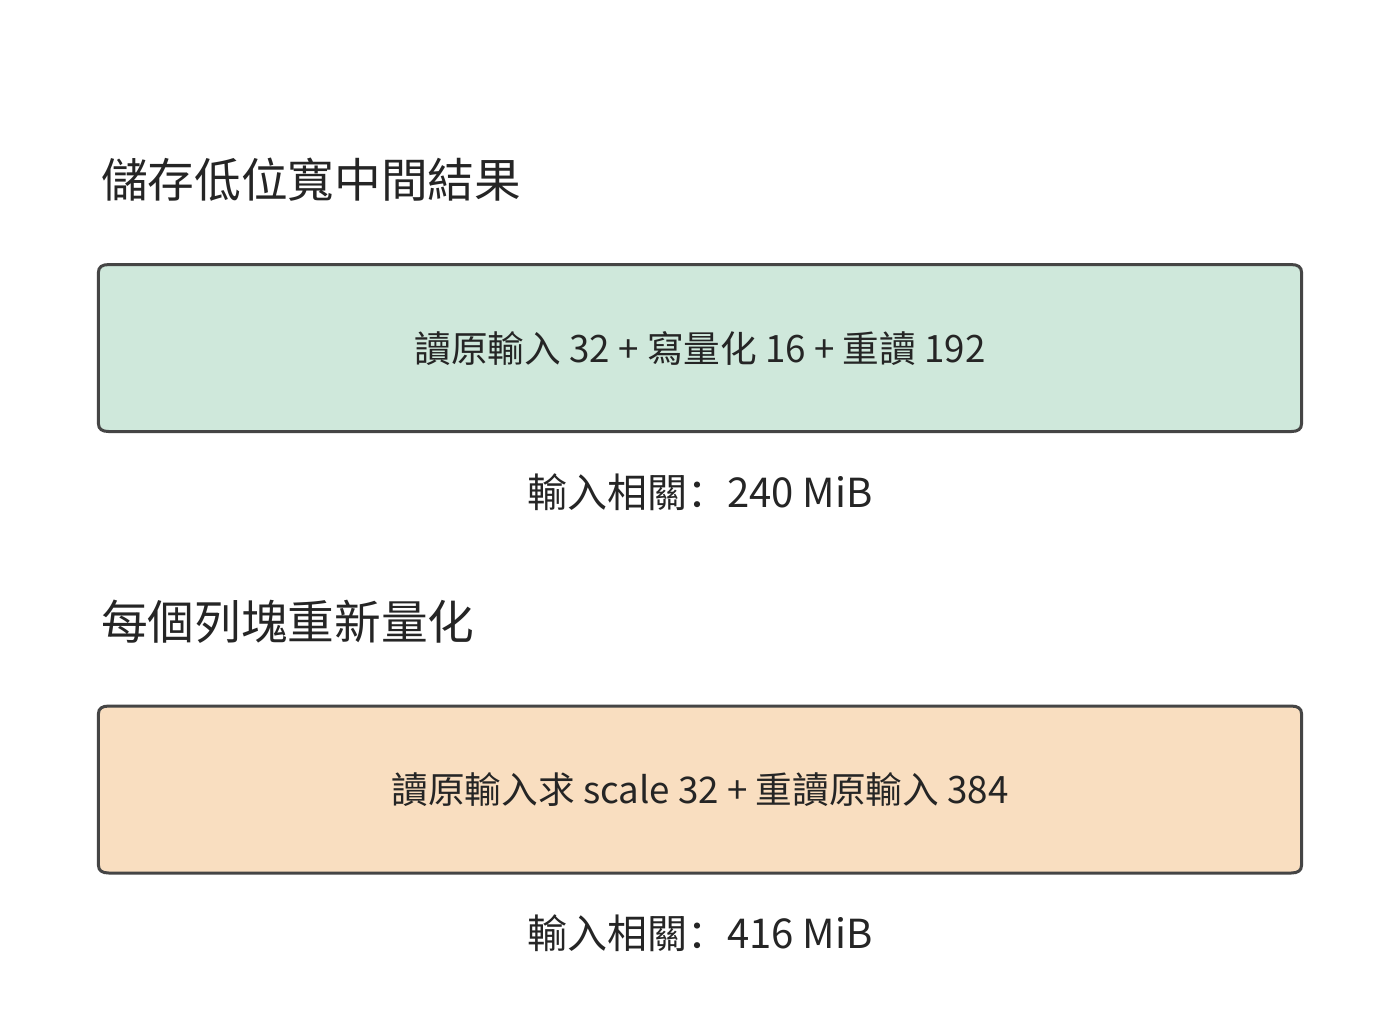
圖 5-24:兩種方案都先讀完整輸入以確定每行的 scale。儲存 FP8 結果後 12 個列塊合計重讀 192 MiB;融合方案重讀 FP16 輸入 384 MiB。權重與輸出另有相同的 204 MiB。
圖 5-24 中,決定差距的是通向 12 個列塊的重複讀取:每次讀取的資料量相差一倍。輸出列塊數因而直接決定兩種做法的訪存量差異。每增加一個列塊,保留量化結果的方案多讀 16 MiB,融合方案多讀 32 MiB。將 1536 個輸出列放入同一塊,可消除這種跨列塊重複;相應輸出累加器也從 128 列擴大為 1536 列,需要 12 倍空間。因此,選擇是否融合量化時,仍要比較第 5.2 節討論過的區域性儲存佔用與資料複用。15
AKG 將融合與分塊共同考慮,正是為了處理這樣的相互作用。中間結果的計算位置改變後,各輸出塊讀取哪些資料、讀取多少次都會改變;緩衝需求隨之變化,又影響能夠採用的塊大小。
5.4.5 成本估計與實測選擇
例 5-8 已經能夠按讀寫量比較兩種實作。面對更多分塊與融合組合,編譯器也按同樣的思路逐步縮小範圍:先檢查依賴和數值規則,再排除區域性儲存不足以容納的實作,最後估計執行開銷,決定優先測試哪些實作。第 5.2 節已給出一種估計:用存取量和有效頻寬比較兩個 tile。編譯器還可以加入矩陣指令利用率、暫存器需求和啟動成本,確定各實作的測試順序。
沿用第 5.2 節的矩陣與 RTX PRO 6000 的共享記憶體,選擇過程可以整理成下面的表。該節把輸入緩衝和累加器都放在每個 SM 的 100 KB 共享記憶體裡;若把累加器改放暫存器,就要像第 5.1.5 節那樣分別檢查共享記憶體與暫存器,兩類容量不能互相借用。若把兩個候選改成雙緩衝,輸入佔用翻倍,工作集分別變為 32 KiB 和 96 KiB,每個 SM 可駐留的執行緒塊從 4 塊、1 塊變為 3 塊、1 塊。
| 選擇步驟 | 本章矩陣算例要填的內容 | 排除或比較的依據 |
|---|---|---|
| 固定目標 | 輸入形狀、精度、誤差、呼叫頻數 | 比較同一項數學工作和同一負載 |
| 列出候選 | tile、迴圈次序、緩衝數、融合範圍 | 編譯器與硬體是否支援 |
| 檢查可行性 | 共享記憶體、暫存器、執行緒、對齊和依賴 | 編譯資源報告及正確性檢查 |
| 估計時間 | 計算量、實際讀寫量、啟動與佈局轉換 | 各資源服務時間與關鍵路徑 |
| 實測並選擇 | 代表形狀的時間、波動及完整運算子鏈 | 最小化工作負載成本,並保留相近候選 |
先用資源報告排除容量不足的候選,再測剩餘候選的有效頻寬、計算時間與完整運算子鏈。若暫存器溢位、矩陣邊緣補齊或併發下降抵消了複用收益,就回到候選表改變塊形狀或緩衝數。第 6 章採用同樣過程,只把 tile 的放置擴充到多張卡,並把跨塊依賴換算成集合通訊(多張卡按固定模式交換或彙總資料的通訊操作)。
實測環節可以用配套實驗 5-5 的矩陣轉置程式說明:同一程式在 RTX PRO 6000 Blackwell 上採用 16×16 塊約需 7.9 μs,採用 32×32 塊約需 2.9 μs,加速比約為 2.7。塊的每個維度增至兩倍,內部元素數就增至四倍,儲存佈局和執行緒協作也一起改變。17
TVM 的自動調優根據硬體實測結果搜尋分塊、迴圈順序等排程方案;讓能夠呼叫編譯和測試工具的 Agent 修改排程或 kernel 程式碼,還可以嘗試原有排程模板之外的實作。兩種搜尋都以編譯後的程式為評價物件,通過數值檢查篩選正確實作,再以執行時間評價排程。評價之所以針對編譯後的程式,是因為編譯器可以將原始碼中分開表達的運算子融合為一個 kernel。16 搜尋方法還要解決另一個問題:用什麼負載評價這些實作。
例 5-9:輸入形狀的呼叫比例如何改變運算子實作的選擇? 某個運算子有 A、B 兩種輸入形狀,原實作處理它們都需要 10 μs。新實作處理 A 需要 5 μs,處理 B 需要 20 μs:A 的耗時減半,B 的耗時翻倍。若兩種形狀各出現一次,總時間從 20 μs 增至 25 μs,新實作的耗時增加 25%;若 A 呼叫 100 次、B 呼叫一次,總時間從 1010 μs 降至 520 μs,新實作的加速比約為 1.9。
令輸入形狀為 A 的呼叫佔比為 p。原實作的平均執行時間為 10 μs,新實作的平均執行時間為:
要使新實作平均時間更短,需滿足 \(20-15p<10\),即 \(p>2/3\)。圖 5-25 的交點說明,只有當 A 佔全部呼叫的比例超過 2/3 時,新實作才更快。
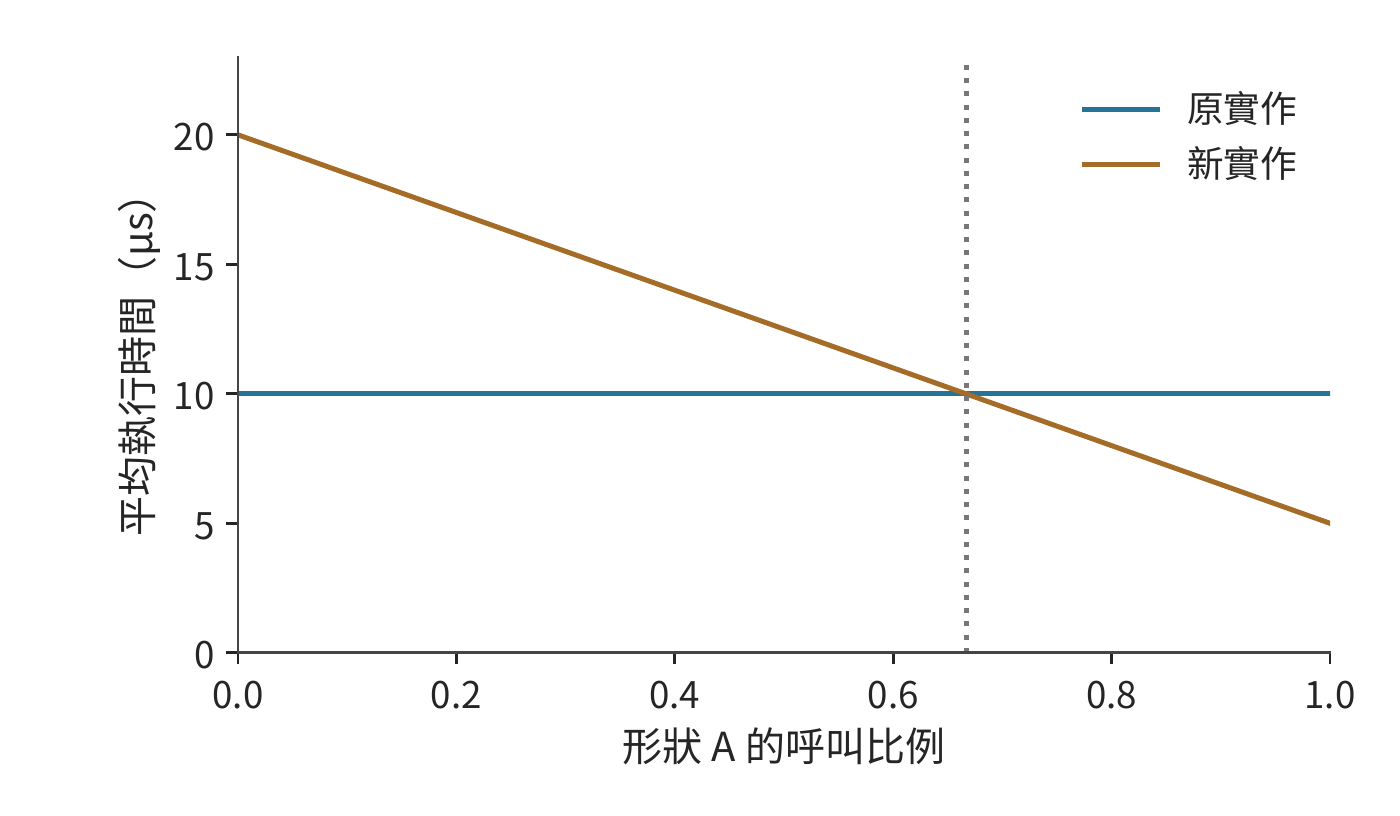
圖 5-25:形狀 A 佔比超過 2/3 時,新實作的總執行時間更短。A、B 原耗時均為 10 μs,新實作分別為 5、20 μs;呼叫依序進行,圖中比較穩態執行。交點由兩種實作的平均時間相等確定。
因此,調優可以按形狀分別選擇實作,也可以按實際呼叫頻數選擇一種綜合成本較低的方案。搜尋本身消耗的編譯與測量時間,則屬於準備成本。配套的 Agent 實驗保留了程式碼生成、重複提交和測量記錄;下一節將結合呼叫次數,計算節省的執行時間需要多久才能抵消搜尋開銷。18
5.5 執行時:提交、重放與動態形狀
編譯器選出加速器程式後,執行時還要反覆準備輸入、選擇程式、提交任務並管理緩衝。即使使用同一份 kernel 程式碼,改變提交方式或複用已有的準備結果,也會改變總時間。本節接著第 5.1 節的時間線,分析這些主機工作。
5.5.1 主機準備與加速器計算的重疊
第 5.1 節區分了 CPU 提交時間與加速器執行時間,第 5.3 節又說明兩類資源可以重疊工作。把這兩點用於模型的一次前向計算:CPU 為下一階段檢查形狀、準備參數或後設資料,GPU 執行當前階段。如果下一階段的準備可以提前,兩側便形成流水;若 CPU 一直等到 GPU 完成才開始準備,加速器會在兩個階段之間停下來。
例 5-10:加速器加速後,主機為何成為瓶頸? 設有 100 段工作,每段的主機準備和加速器計算各需 20 μs。準備下一段所需的資料均已知,緩衝足夠,兩類資源獨立。嚴格依序執行需要 \(100\times(20+20)=4000\) μs;採用流水後,先完成第一段的準備,隨後每 20 μs 完成一段,總時間為 \(20+100\times20=2020\) μs。
將加速器計算縮短至 5 μs,主機仍每 20 μs 才準備好一段。流水變成 \(100\times20+5=2005\) μs,只比原來少 15 μs。CPU 提交任務的速度沒有提高,GPU 算得越快,等待下一項任務的時間就越長。再把主機準備時間縮短至 5 μs,兩側才能每 5 μs 完成一段工作,完成時間降為 \(5+100\times5=505\) μs。19
圖 5-26 畫出前四段在三種情況下的時間線。
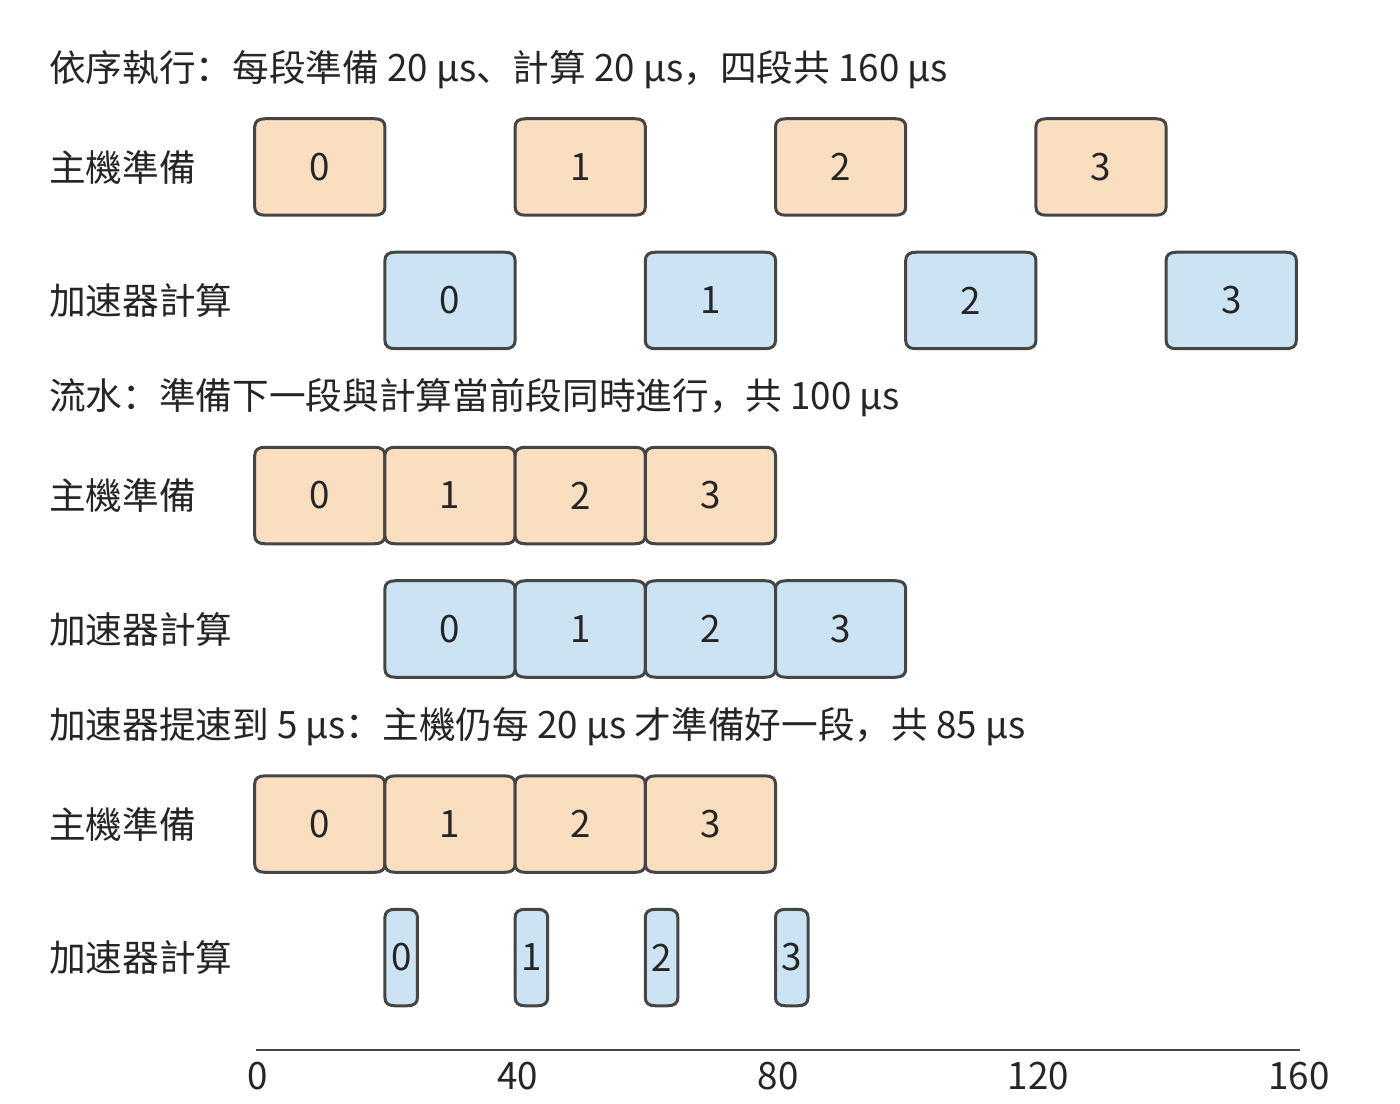
圖 5-26:每段主機準備 20 μs。依序執行時兩種資源輪流工作;流水後主機準備下一段時加速器計算當前段,每 20 μs 完成一段;加速器提速到 5 μs 後,每段仍要等主機準備好,加速器大部分時間空閒。圖中只畫前四段,正文算例為 100 段。
這一例子說明了主機最佳化的兩個方向。一是減少準備工作,例如重複使用已經確定的形狀和執行計劃(根據請求長度、快取佈局等條件事先確定的 kernel 選擇、任務劃分與工作區安排);二是把準備移到前一段加速器執行期間,例如非同步處理上一輪輸出。兩者分別減少流水中的工作量和階段之間的空隙。
在自迴歸生成中,能否提前準備,取決於所需的資料是否已經算好。下一步計算需要用到上一輪選出的 token;組建 batch、更新語法狀態(限定輸出格式時,記錄已生成內容匹配到語法的哪一步)和判斷是否停止,也各自需要相應的結果。執行時可以提前執行不依賴這些結果的工作,減少兩輪計算之間的等待。vLLM 等引擎的非同步執行與排程演進圍繞這一問題展開。21
專用加速器把模型執行縮短到遠短於主機每輪準備的時間後,穩定流水的步間隔下界便由主機準備決定。此時進一步縮短步間隔,需要把動態 batch(每步都可能加入或移出請求的 batch)準備、地址更新與提交一起最佳化。
vLLM 在 2024 年 9 月釋出的 v0.6.0 就是主機開銷佔據步間隔的實例。釋出前的剖析顯示,單張 H100 執行 Llama 3 8B 時,一步之中 API 伺服器佔 33%,排程佔 29%,加速器執行只佔 38%:API 伺服器與推理引擎執行在同一個 Python 行程裡,兩者的協程爭用 GIL(全域直譯器鎖),加速器只能空等主機。v0.6.0 把 API 伺服器移到單獨行程,與引擎之間用訊息佇列通訊,避開了 GIL 爭用;又引入多步排程,一次排程後連續執行多步,不再重複準備輸入;再把輸出處理改為非同步,與下一步執行重疊。三項改動合計,Llama 3 8B 的吞吐提高到 v0.5.3 的 2.7 倍,70B 提高到 1.8 倍。20 這些改動沒有觸及任何 kernel,也沒有更換硬體。按第 1.3.4 節的判據,主機側的軟體抽象開銷一旦佔到步間隔的六成,去掉這部分開銷,比換一塊更快的加速器有效得多。
除了同一請求的相鄰兩輪,不同呼叫之間也有可以複用的準備工作。兩次呼叫可以分別要求模型解釋程式碼和檢查測試,輸入內容不同,卻仍經過同一組模型層。長度與 batch 落在已有執行計劃支援的範圍內時,執行時可以複用程式,更新 token、位置索引和狀態地址;遇到新的形狀或控制路徑時,則選擇另一份執行計劃。應用透過上下文表達變化,執行時利用穩定的執行結構減少重複準備。下面分別計算圖重放與形狀特化這兩種複用的收益。
5.5.2 CUDA Graph:提交收益與輸入複製開銷
上一小節中,GPU 提速後仍在等待主機。模型反覆執行相似的任務序列時,其中許多提交工作可以複用:先把加速器任務及其依賴記錄成圖,再重複提交。使用 CUDA Graph 時,主機每次只需發起一次圖重放,不必重新逐個準備和提交 kernel。加速器仍然執行圖中的各個節點,減少的是主機的重複工作。圖 5-27 用一次 FFN 的六個 kernel 說明兩種提交方式的區別。
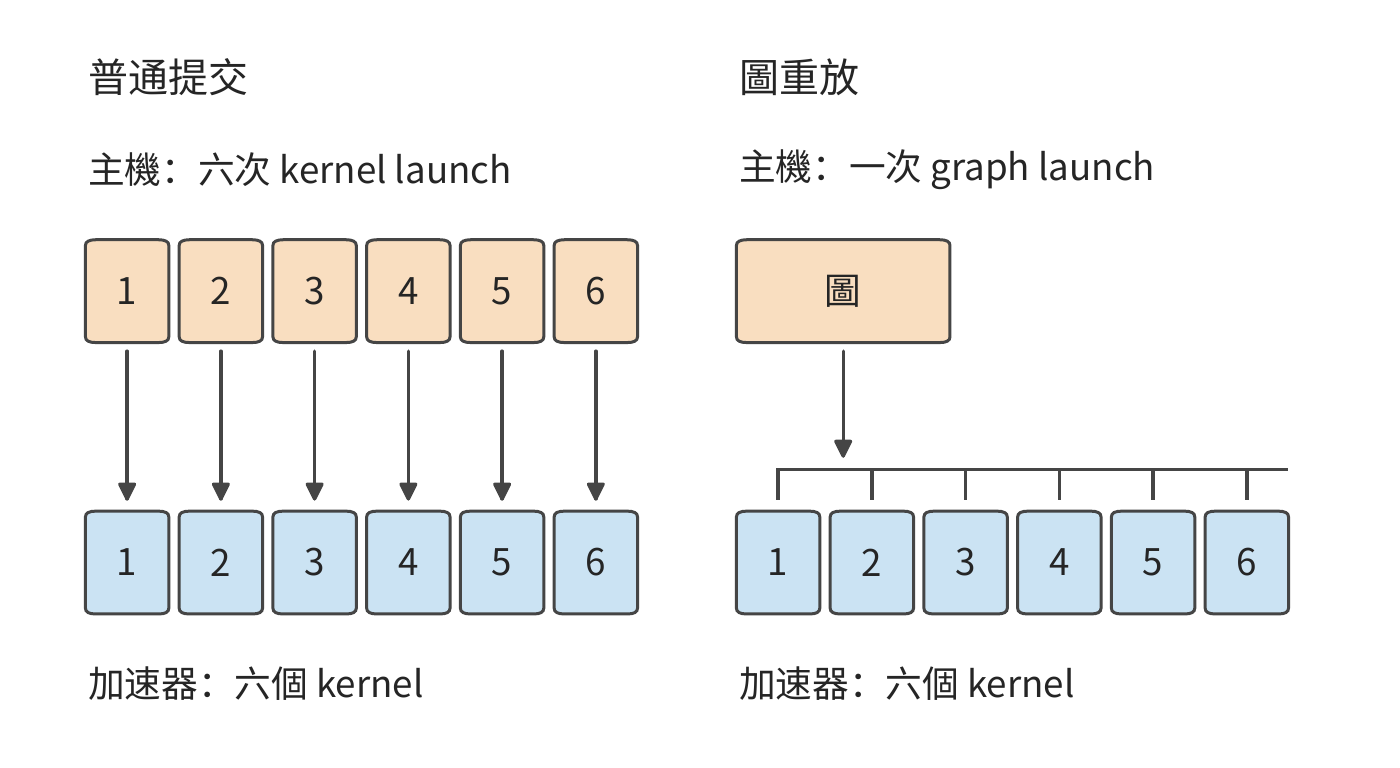
圖 5-27:普通提交時,主機為每個 kernel 發起一次 launch;圖重放時,主機只發起一次 graph launch,加速器仍然執行圖中記錄的六個 kernel。要減少 kernel 的數量,靠的是融合,不是圖重放。
圖 5-28 取 3 次 FFN 執行作對照。普通提交產生 18 次主機 kernel launch 和 18 個加速器 kernel;圖重放改為 3 次 graph launch,加速器仍執行 18 個 kernel。將活化運算鏈融合後,加速器 kernel 減至 15 個;再使用圖重放,主機仍只需 3 次 graph launch。融合將多個運算子的計算合併到同一個 kernel 中,圖重放減少了主機逐個準備和提交任務的工作。25
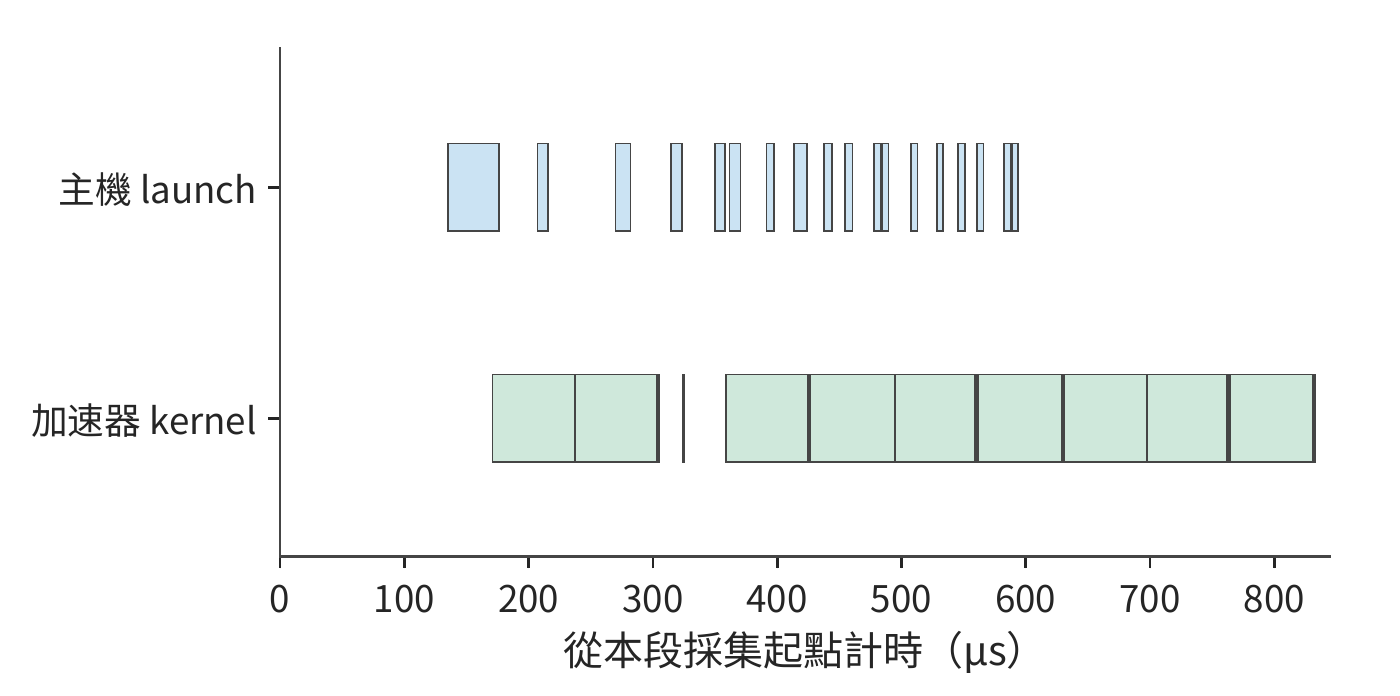
圖 5-28:普通提交的 3 次 FFN 實測。上行為主機 kernel launch API,下行為加速器 kernel;橫軸從本段標記起點計時。18 次 kernel launch 對應 18 個加速器 kernel。
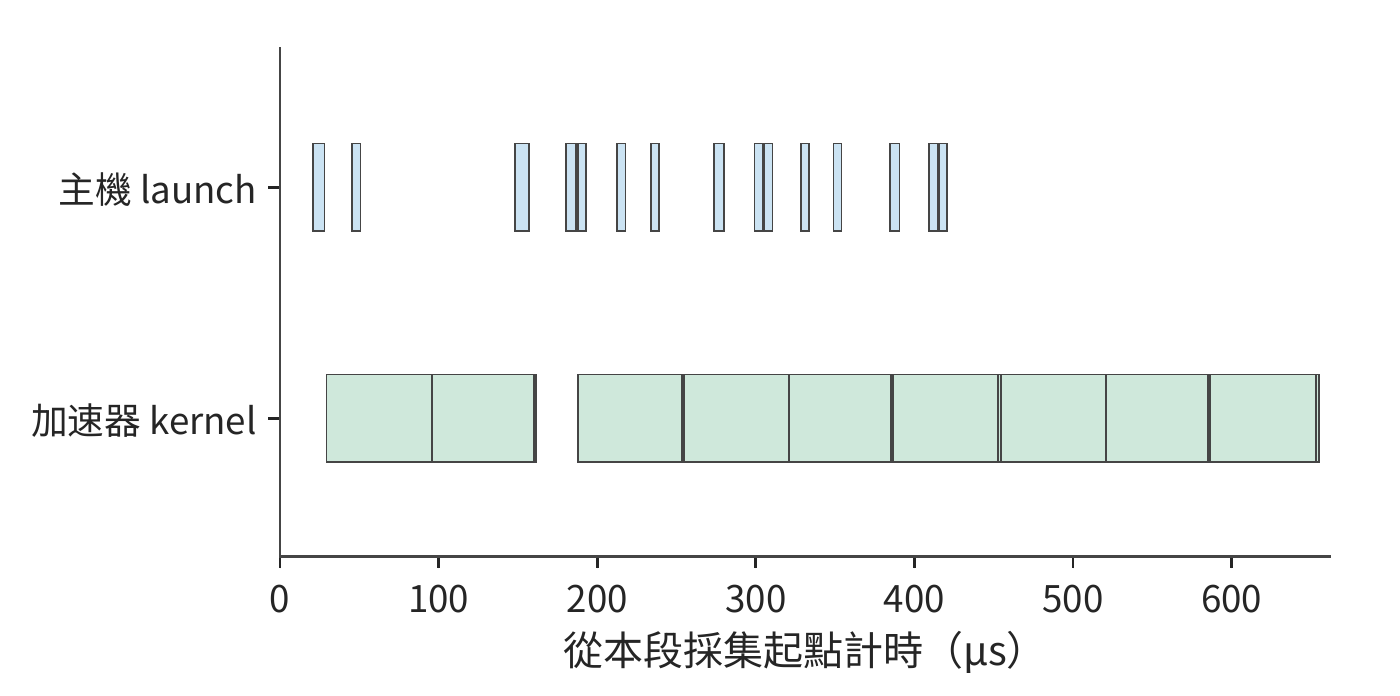
圖 5-29:3 次 FFN 融合活化運算鏈後,主機 kernel launch 15 次,加速器相應執行 15 個 kernel。資料來自與前圖相同的實驗中單獨標記的採集區間。
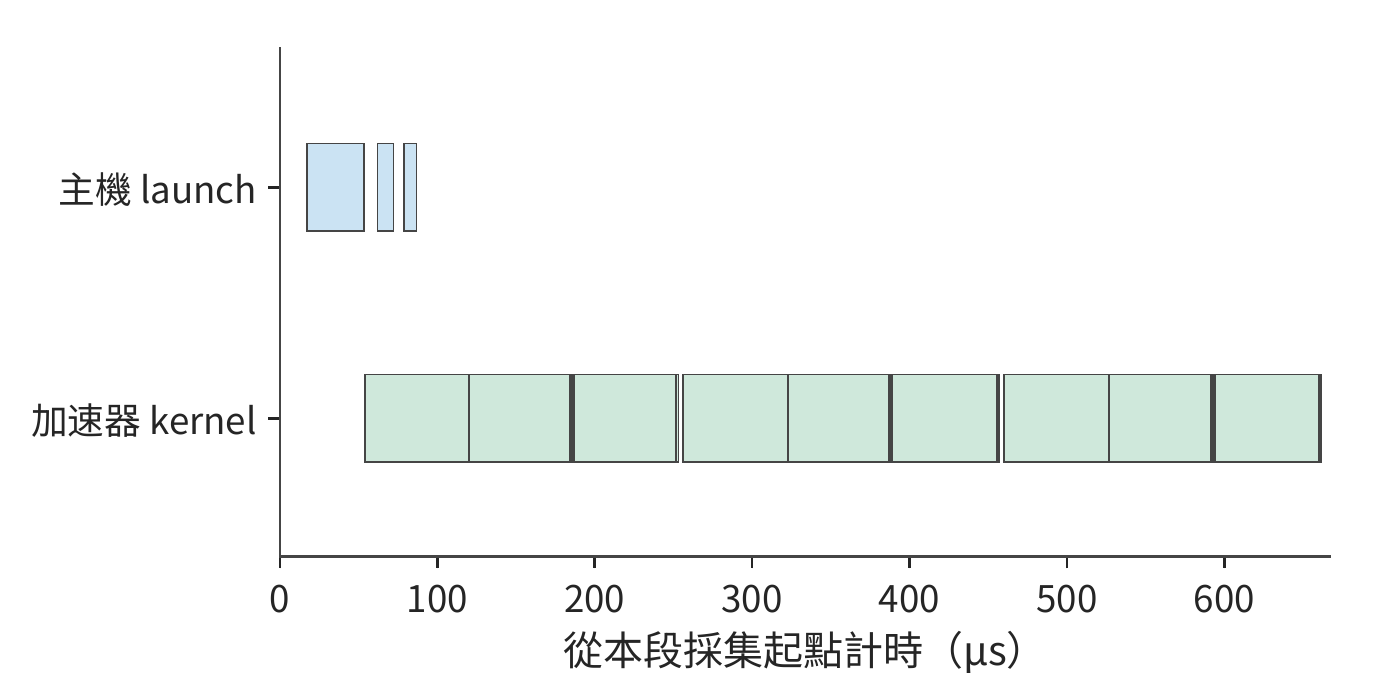
圖 5-30:3 次 graph launch 對應 18 個加速器 kernel。圖重放減少主機提交次數,加速器仍執行原圖各節點;本圖按自身採集範圍標出真即時間。
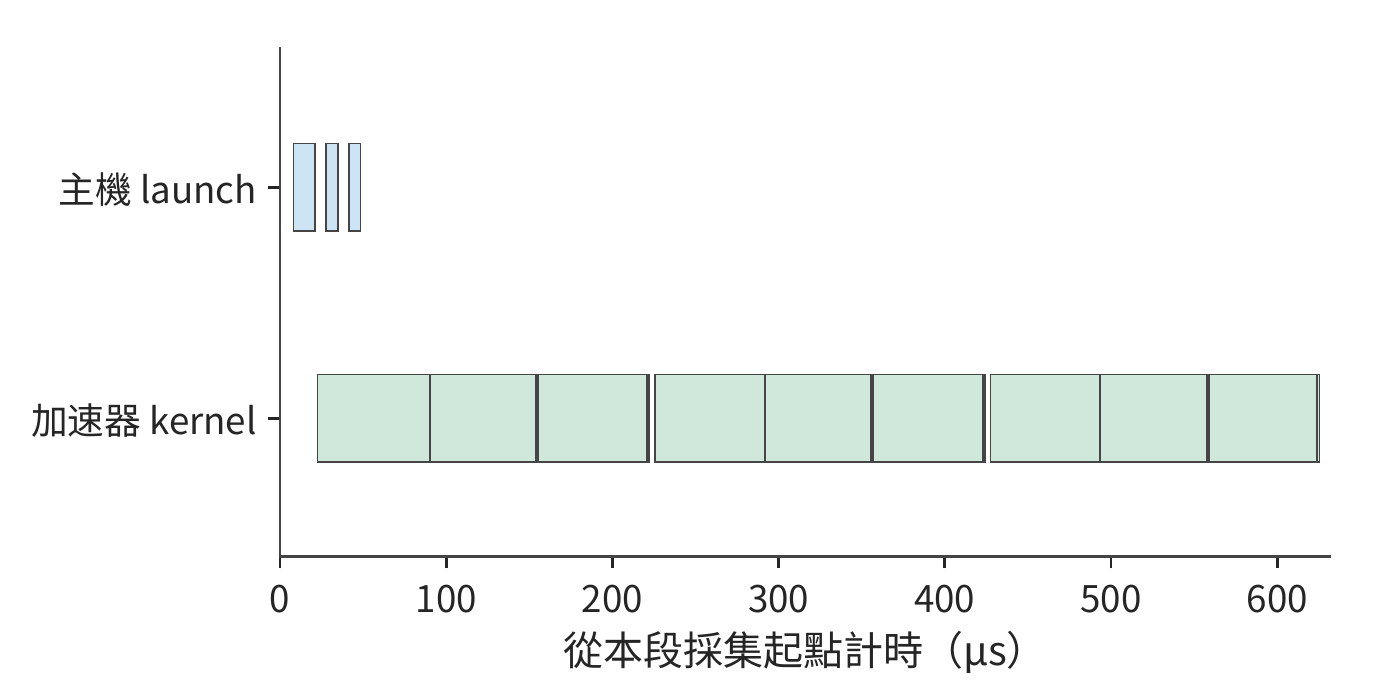
圖 5-31:先融合再重放,主機發起 3 次圖執行,加速器執行 15 個 kernel。融合減少加速器 kernel 數,圖重放減少主機提交次數。
圖重放前,還要把新輸入放到圖所記錄的地址。典型實作為圖預留固定緩衝區,上游每次將新資料寫到這裡,圖按已記錄的地址讀取。若上游輸出位於另一份張量中,就在圖執行前增加一次複製;若上游直接寫固定緩衝,這次複製便可省去。
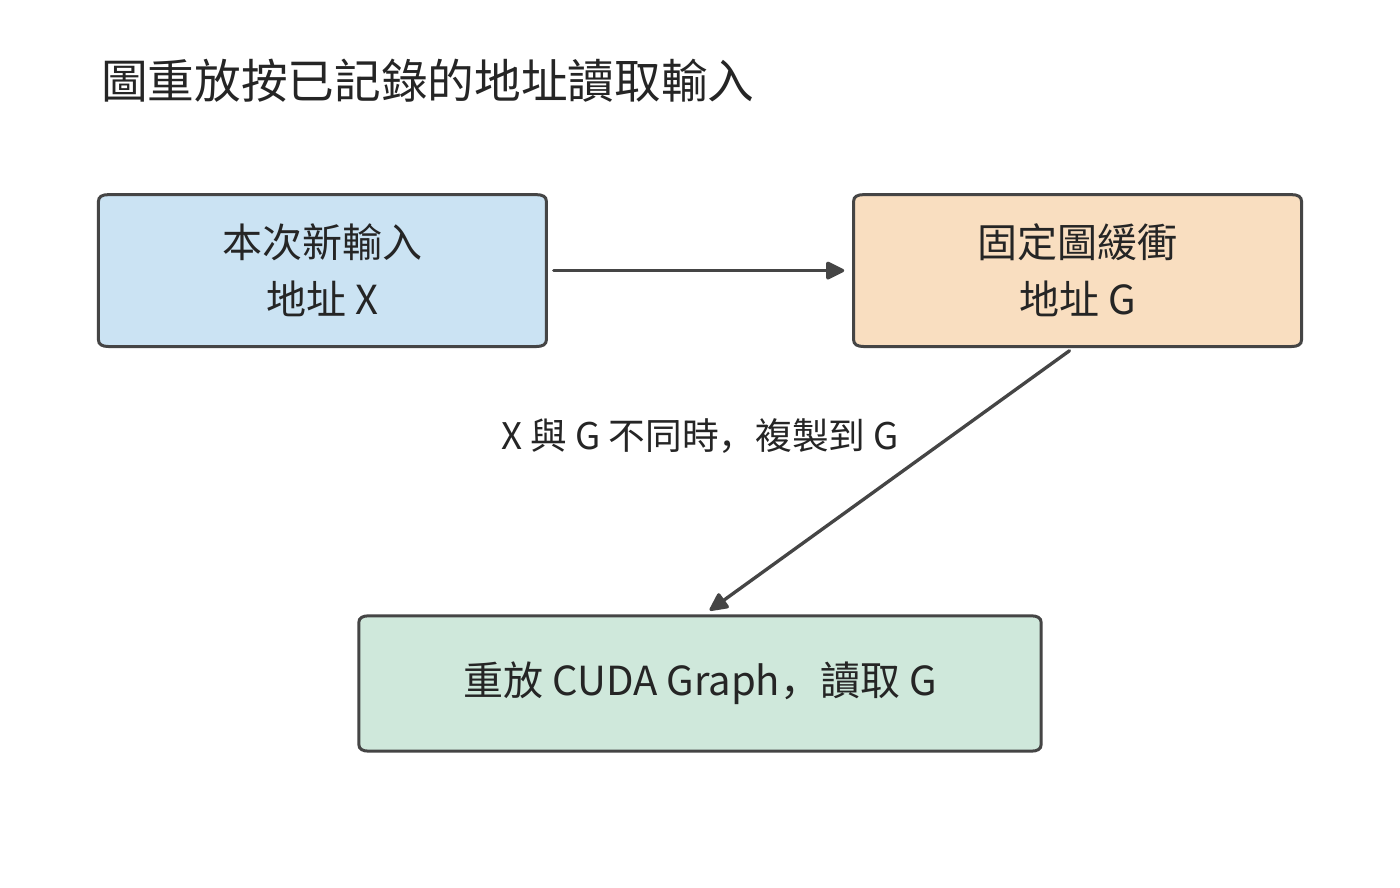
圖 5-32:圖執行時讀取記錄的地址 G。新輸入位於 X 時先複製到 G;上游直接寫 G 時沿用同一緩衝,省去中間複製。
例 5-11:輸入複製何時抵消圖重放的收益? 普通執行的加速器計算為 20 μs,加速器等待主機提交任務的時間為 20 μs,共 40 μs。圖重放與後設資料準備為 5 μs,加速器計算保持 20 μs。圖原本可以節省 15 μs。
取圖執行所需的 BF16 輸入為 \([256,4096]\),資料量為 2 MiB。複製同時讀取源和寫入目標,讀寫量合計為 4 MiB;按 RTX PRO 6000 的視訊記憶體頻寬 1792 GB/s 計(讀與寫共用這一頻寬),複製約需 2.3 μs,圖執行的總時間約為 27.3 μs,比普通執行少約 12.7 μs。
保持計算與準備時間不變,把輸入擴大至 2048 行,資料量增為 16 MiB。複製讀寫增為 32 MiB,用時約 18.7 μs,圖執行的總時間約為 43.7 μs。這次複製已超過原本節省的 15 μs。
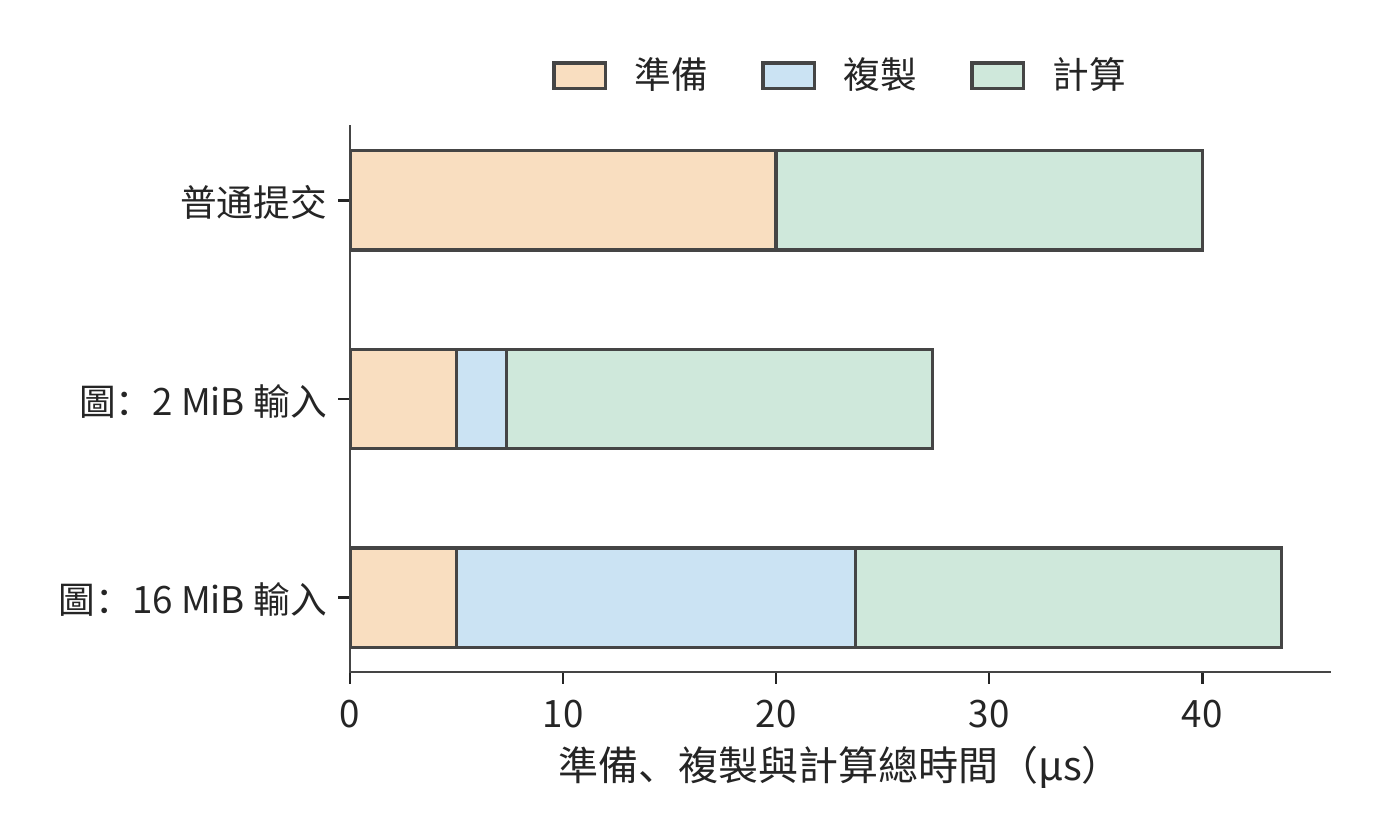
圖 5-33:橙色為準備,藍色為額外輸入複製,綠色為加速器計算。普通方式 40 μs;圖的 2 MiB 輸入約 27 μs,16 MiB 輸入約 44 μs。複製按 RTX PRO 6000 的視訊記憶體頻寬 1792 GB/s 計。
圖 5-33 中,圖重放節省的準備時間是一段固定長度;表示複製時間的條形卻隨輸入增大而變長。兩者長度相等時,圖重放恰好不再節省時間。令輸入資料量為 X,複製頻寬為 B,圖執行更快的條件為 \(2X/B<15\ \mathrm{\mu s}\)。代入 B=1792 GB/s 得:
2 MiB 低於這一臨界值,16 MiB 則超過。讓前一個運算子直接將結果寫入圖緩衝,或者從輸入張量較小的位置開始捕獲,都能減少複製開銷。因此,選擇哪些操作組成一張圖時,需要同時比較節省的主機提交時間與增加的輸入複製時間。22
圖重放複用了提交序列,同一思路還可以用於生成這些任務之前的準備工作。例如,執行計劃可以供多個模型層共同使用。推理運算子庫 FlashInfer 把計劃生成(plan)與執行(run)分開:plan 根據本步各請求的長度和 KV 在視訊記憶體中的存放位置選擇 kernel、劃分任務、安排工作區,並把這些後設資料複製到 GPU;run 按計劃執行注意力。同一步的 36 層請求長度相同,KV 的存放方式也相同,可以共用一份計劃;若每層都重新 plan,就要做 36 次相同的準備工作。在 RTX PRO 6000 上的兩組對照中,改為只 plan 一次後,36 層注意力呼叫的時間從約 2.0、2.4 ms 降至 0.72、0.75 ms,主機到 GPU 的複製從 144 次降至 4 次,加速器 kernel 數保持不變。反過來,請求長度改變後必須重新 plan,沿用舊計劃會按舊長度計算,結果出錯。23
5.5.3 動態形狀與編譯開銷
多個模型層共享計劃,利用的是計算結構相同;不同呼叫共享編譯後的程式,還要處理輸入形狀的變化。輸入行數變化時,執行時可以選擇三種方式。通用程式根據當前形狀計算索引和邊界;分桶將輸入補齊到少數代表形狀,複用這些形狀的程式;特化則利用已知的輸入條件生成專門的實作,這裡指為每個常見形狀分別編譯程式。越充分地利用已知形狀,越有機會簡化加速器工作,但也需要編譯和儲存更多程式。
例 5-12:重複執行多少次,特化才值得? 取 10 次 FFN 為一組:8 次為 256 行,1 次為 1536 行,1 次為 2048 行,共 \(8\times256+1536+2048=5632\) 行。採用 512、2048 兩個桶時,實際處理 \(8\times512+2048+2048=8192\) 行,多算約 45%。圖 5-34 畫出每種形狀被補齊到哪個桶。
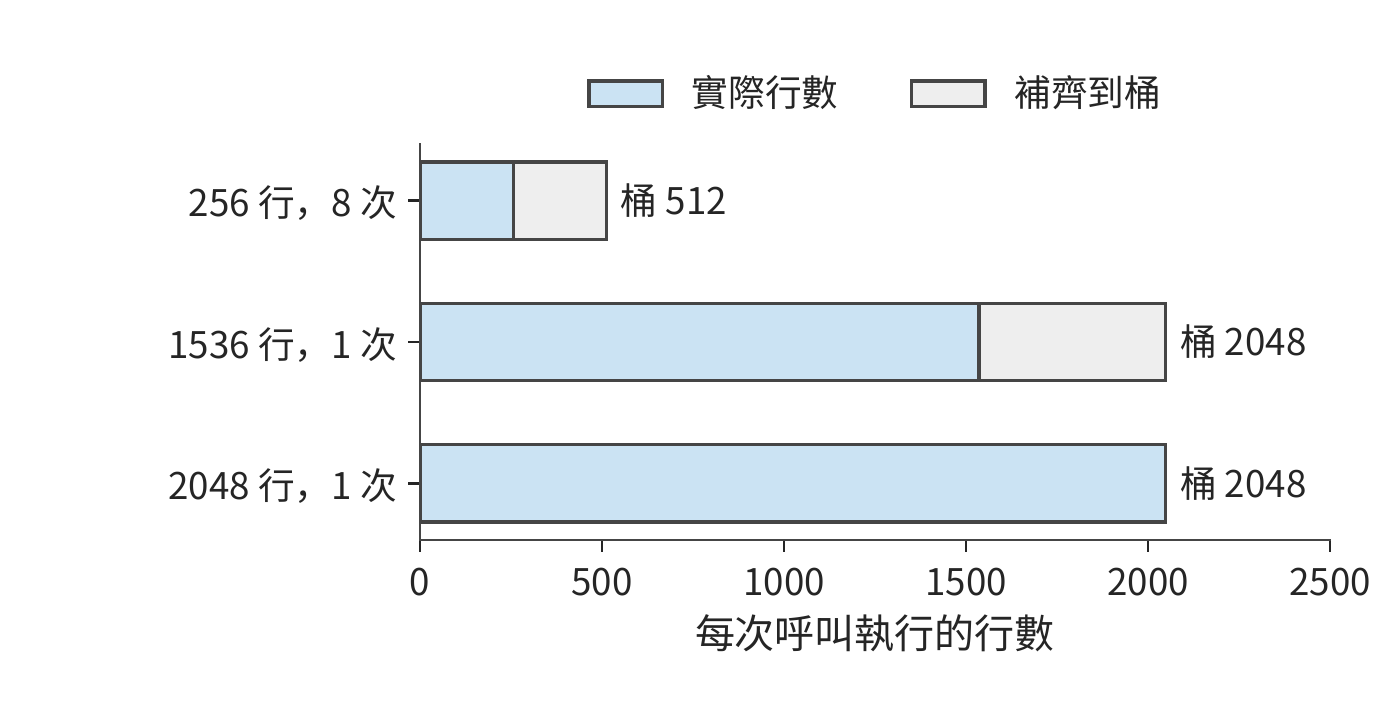
圖 5-34:256 行的呼叫補齊到 512 行的桶,1536 行的呼叫補齊到 2048 行的桶,2048 行恰好落在桶的邊界上。灰色部分是補齊後多算的行;10 次呼叫合計實際 5632 行,執行 8192 行。
完整 FFN 的三個投影每行共需 \(6HF\) FLOPs。在 RTX PRO 6000 上,取通用、分桶、特化實作分別達到 BF16 稠密峰值 503.8 TFLOP/s 的約 20%、40%、50%,即 MFU 為 20%、40%、50%,有效矩陣處理率為 100、200、250 TFLOP/s,則每組時間分別約為 17.0、12.4、6.8 ms。分桶雖然多算 45%,處理率卻翻倍,仍比通用實作更快。再設它們的準備時間分別為 100、400、900 ms,得到下表。24
| 策略 | 一次性準備 P | 每組執行 T | 形狀處理方式 |
|---|---|---|---|
| 通用 | 100 ms | 17.0 ms | 按實際 5632 行執行 |
| 分桶 | 400 ms | 12.4 ms | 補至兩個桶,執行 8192 行 |
| 逐形狀特化 | 900 ms | 6.8 ms | 三個形狀分別生成程式 |
執行 r 組的總時間為 \(T_{\mathrm{total}}=P+rT\)。圖 5-35 中,每條線的截距表示準備時間,斜率表示每組執行時間。本例中,每組執行越快的方案,直線越平緩,但起點也越高,因為它需要更長的準備時間。
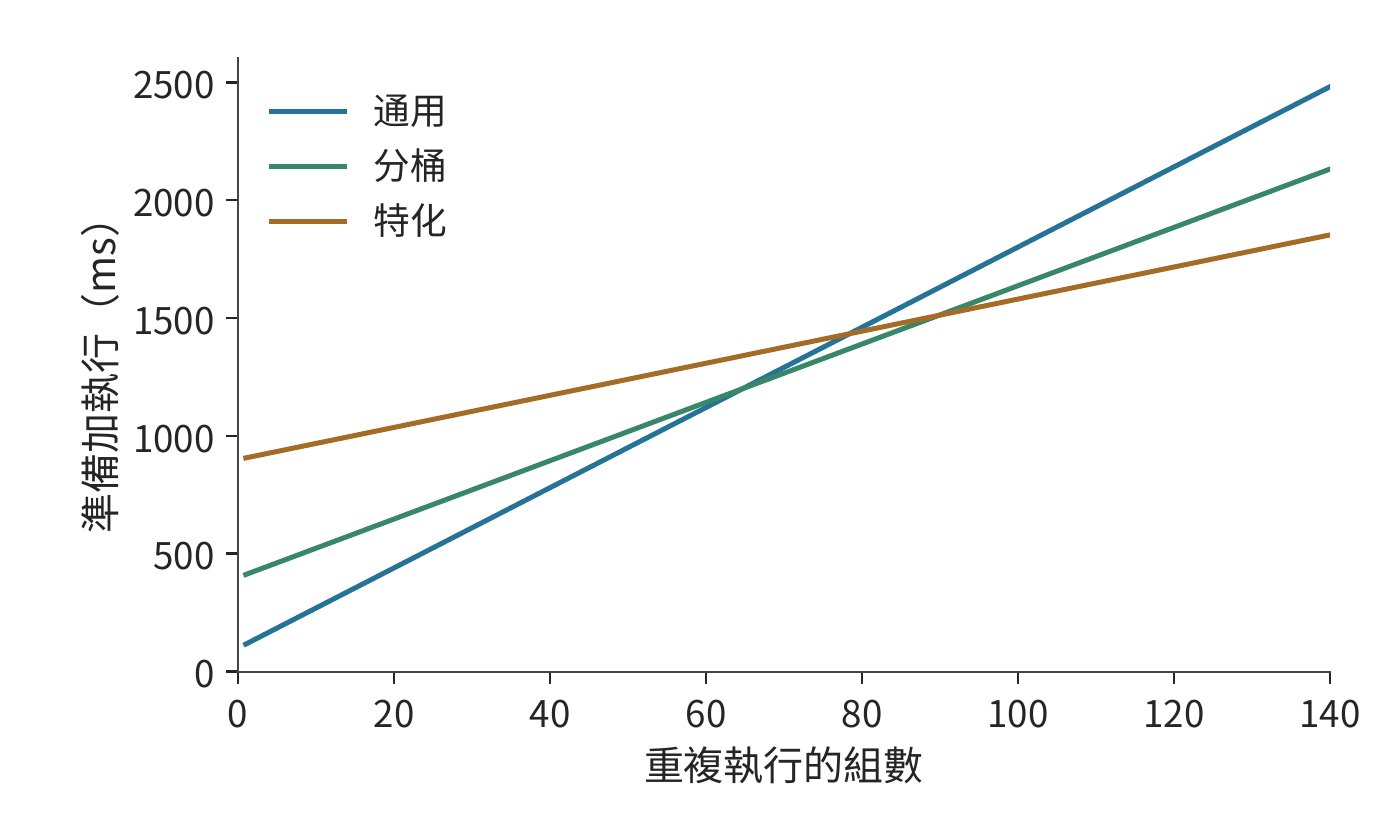
圖 5-35:同一組呼叫反覆執行時,最省時的策略隨複用次數變化。曲線採用例 5-12 的形狀、處理率和準備時間,不同策略適用的整數呼叫次數範圍使用未經四捨五入的數值計算。「通用」使用同一執行方案處理所有形狀;「分桶」將相近形狀歸組;「特化」為具體形狀選擇專用方案。
分桶比通用方案多用 300 ms 準備,每組卻能節省約 4.6 ms,執行約 65 組後就能抵消這部分開銷。特化比分桶再多用 500 ms 準備,每組再省約 5.6 ms,需要執行約 90 組。由完整數值求得,1–64 組通用最省,65–89 組分桶最省,90 組起特化最省。
如果實例只執行 70 組,總時間分別約為 1.29、1.27、1.38 s。分桶用時最短,是因為節省的執行時間已經超過增加的準備時間;特化雖然每組執行得更快,但累計節省的時間還不足以抵消額外的準備開銷。若三種程式均已快取,本次準備成本為零,特化從第一組起就用時最少。執行時的選擇因而同時依賴形狀頻數與程式是否已經編譯並快取。
同樣可以計算自動調優需要多少次呼叫才能抵消準備開銷。若搜尋耗時 10 分鐘,每次使用新實作省 5 μs,以累計節省時間抵消搜尋時間,需要 \(600/(5\times10^{-6})=1.2\times10^8\) 次呼叫。每秒 10,000 次約需 3.3 小時,每秒 100 次約需 14 天。調優耗時越長,就越應優先最佳化呼叫頻繁、能夠長期使用的形狀。
第 8 章將結合請求到達情況和動態批處理,進一步討論如何選擇和快取程式。如果某種形狀在短時間內反覆出現,保留對應的編譯結果可以減少重複準備;如果長期不再使用,就可以刪除該快取,為其他形狀騰出空間。
5.5.4 Persistent Kernel:按資料塊排程任務
圖重放和程式快取減少了主機的重複準備,加速器上還有另一類等待:對於有依賴關係的兩個 kernel,後一個通常仍要等前一個全部完成後才能開始。如果後一個運算子只需要前一個運算子的一塊結果,就可以把等待條件縮小到資料塊:第一塊算好後,立即開始後續運算,同時繼續計算其餘資料塊。
persistent kernel 一直駐留在加速器上執行,從佇列中取出任務,透過事件確認所需資料是否準備好。這樣既減少主機反覆 kernel launch 的工作,也讓相鄰運算子能按塊重疊執行。Mirage Persistent Kernel/MPK 是採用這種任務排程方式的研究系統。26
仍以 Qwen3-8B 的 up 投影后接 SiLU 活化函數為例,取 512 個 token 的特徵向量,每 64 個 token 的向量組成一個資料塊,共八塊。每塊投影為 \(2\times64\times4096\times12288\approx6.44\) GFLOPs,按 RTX PRO 6000 的 BF16 稠密峰值 503.8 TFLOP/s 約需 12.8 μs;每塊活化運算需處理 \(64\times12288\) 個 BF16 元素,每個元素讀 2 bytes、寫 2 bytes,按 1792 GB/s 的視訊記憶體頻寬約需 1.76 μs。設矩陣與向量資源獨立、緩衝充足,每次 kernel launch 需要 5 μs。等全部投影完成再開始執行活化函數,共需 \(2\times5+8\times(12.8+1.76)\approx126\) μs。
現在將計算分為八個投影任務和八個活化運算任務,每個任務增加 0.5 μs 排程時間、0.2 μs 完成通知時間。每塊投影變為 13.5 μs,活化運算變為 2.46 μs。一次 kernel launch 後,八塊投影首尾相接,每塊投影完成後立即執行活化,最後一塊活化運算在投影全部結束後收尾,完成時間為 \(5+8\times13.5+2.46\approx115\) μs,加速比約為 1.1。
這裡較慢的階段是投影。節省的約 11.0 μs 有兩個來源:少了一次 5 μs 的 kernel launch,七塊活化運算約 12.3 μs 隱藏在投影時間內;任務開銷又在關鍵路徑上加回 6.3 μs。活化運算每塊只需 1.76 μs,按塊提前開始,能隱藏的時間也僅限於此。兩個階段的耗時越接近,按塊重疊節省的時間越多;一個階段遠長於另一個時,收益基本只剩少一次 kernel launch。
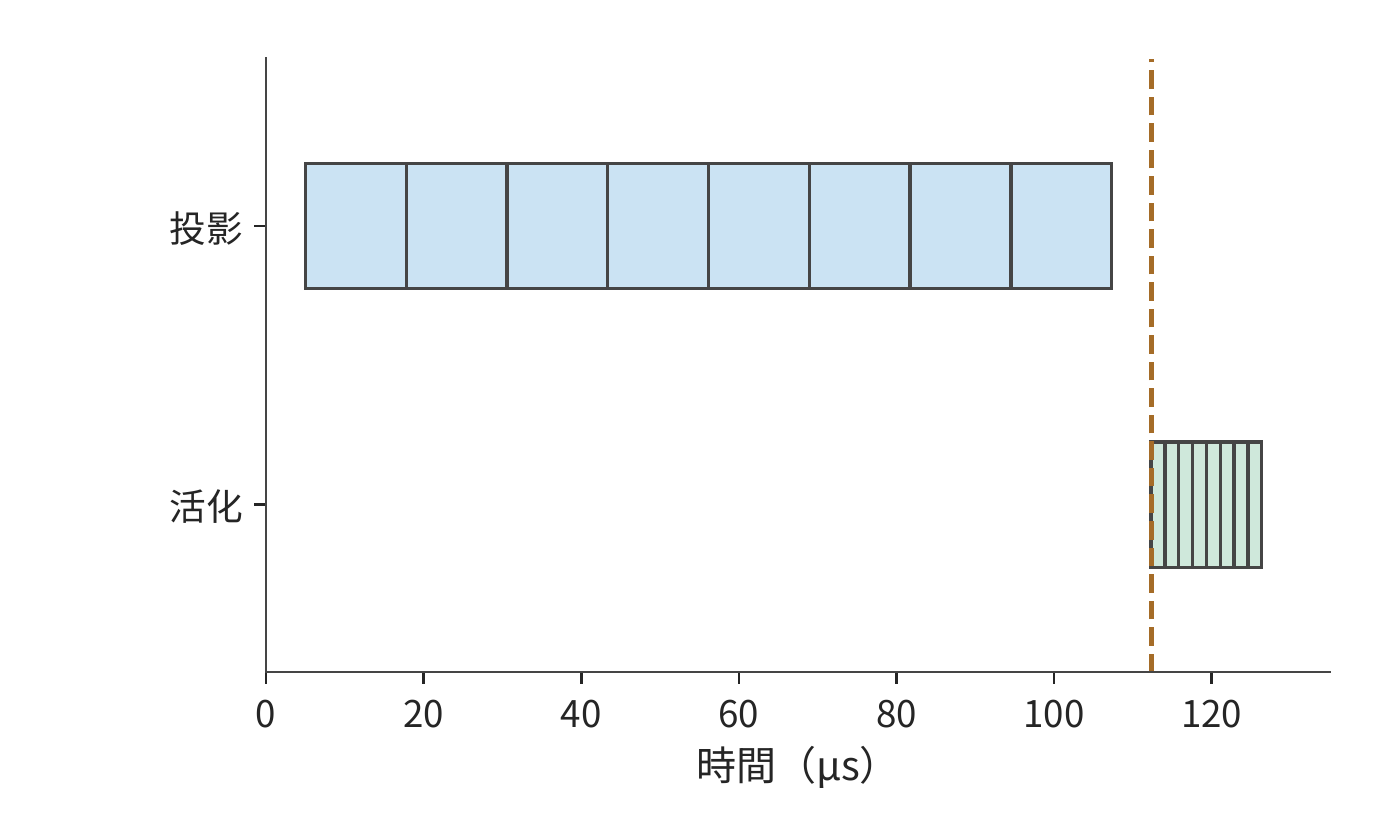
圖 5-36:粗粒度執行先完成八塊投影,再啟動八塊活化運算。按 RTX PRO 6000 的矩陣峰值與視訊記憶體頻寬,每塊投影約 12.8 μs、活化運算約 1.76 μs,兩次 kernel launch 各 5 μs;豎線為活化運算開始。
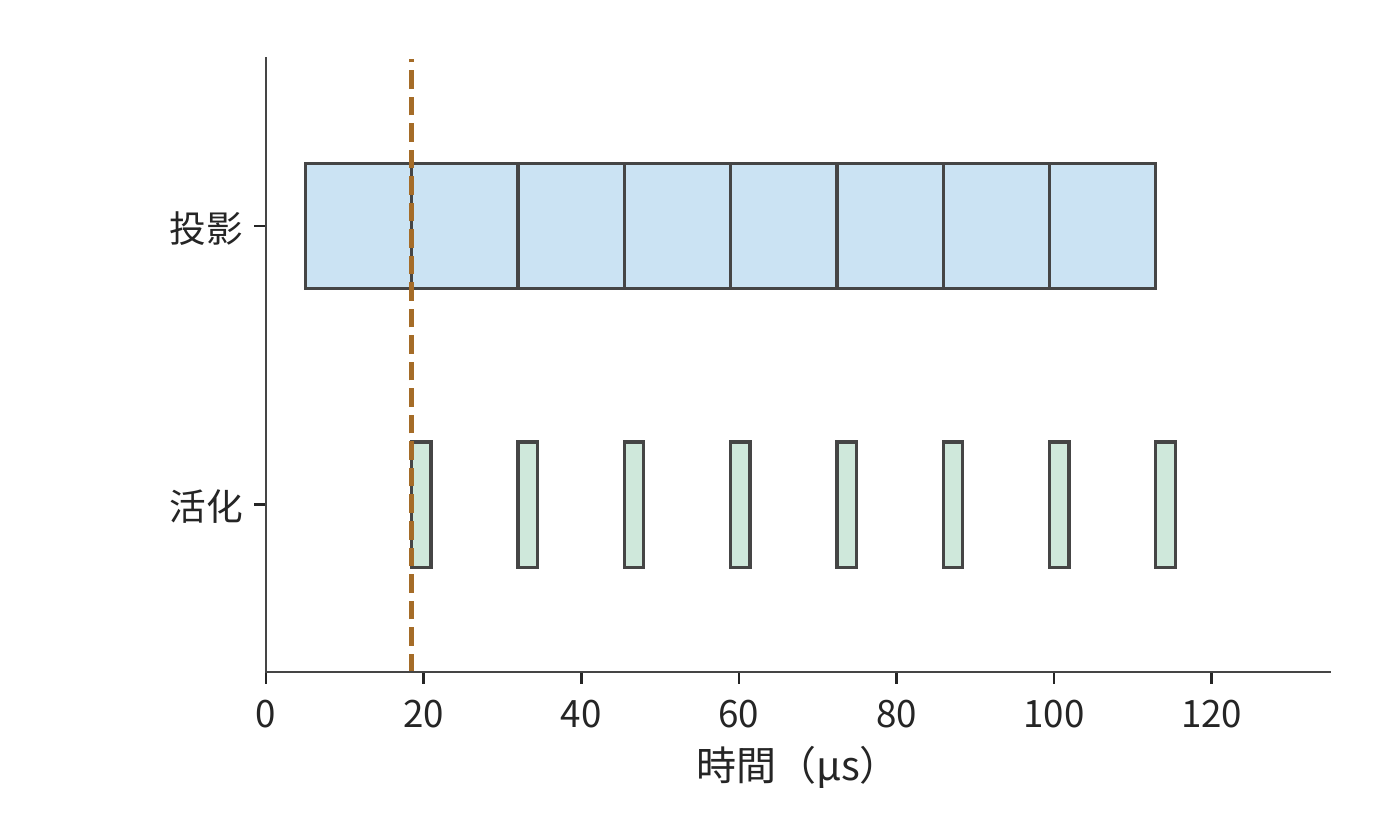
圖 5-37:矩陣與向量資源獨立、緩衝充足。每個任務另計 0.7 μs 排程與通知,首塊投影完成後即可執行活化;投影首尾相接,活化運算只在每塊投影之後短暫工作,八塊流水約 115 μs 結束。
沿著圖 5-37 的投影時間線看,八塊投影首尾相接,中間沒有空隙。這與雙緩衝是同一個規律:第一塊先完成前一階段,之後每隔較慢階段所需的時間完成一塊;這裡較慢的是投影,正如第 5.3.2 節較慢的是搬移,流水的節拍由它決定。每個緩衝槽從投影開始一直被佔用到活化運算結束;沒有空槽時,投影任務就要等待。因此,任務佇列、完成事件和空閒緩衝共同決定下一塊何時能夠開始。
5.6 從區域性最佳化到完整請求
前面每項最佳化都有明確的作用物件:分塊減少輸入重讀,融合減少中間讀寫,執行時最佳化減少準備和等待。但完整請求還包含其他工作,區域性節省的時間只佔其中一部分。本節先說明如何從區域性加速推算請求時間,再分析 Qwen3-8B 的實際請求。
5.6.1 熱點佔比決定加速空間
設請求由依序執行的階段構成,其他階段時間保持不變,熱點佔原時間的比例為 f,熱點的加速比為 s。將原請求時間歸一化為 1,新時間為 \((1-f)+f/s\),整體加速為:
若熱點佔 20%,速度提高到原來的兩倍後,總時間變為 \(0.8+0.2/2=0.9\),加速比約為 1.11。繼續把熱點加快到十倍,總時間為 0.82;即使熱點耗時降到零,其他階段仍需原總時間的 0.8,整體加速上限為 1.25 倍。
這就是第 1 章介紹的 Amdahl 定律。該定律解釋了最佳化收益逐漸縮小的原因:熱點耗時越短,其他階段在總時間中所佔的比例就越高。
5.6.2 並行分支與關鍵路徑切換
在 Amdahl 關係中,時間按依序執行的階段耗時相加。若請求中有兩個分支同時執行,縮短一個分支後,還可能需要等待另一個分支;此時應沿依賴圖尋找決定完成時間的最長路徑。設準備 10 μs 後,同時啟動熱點 A 和分支 B,分別需 60、40 μs;收尾需 10 μs,並等待兩條分支都完成。原請求時間為:
將 A 加快四倍至 15 μs,B 仍需 40 μs,新時間為 \(10+\max(15,40)+10=60\) μs。A 節省 45 μs,請求卻只節省 20 μs,因為 B 接替 A 成為關鍵路徑。
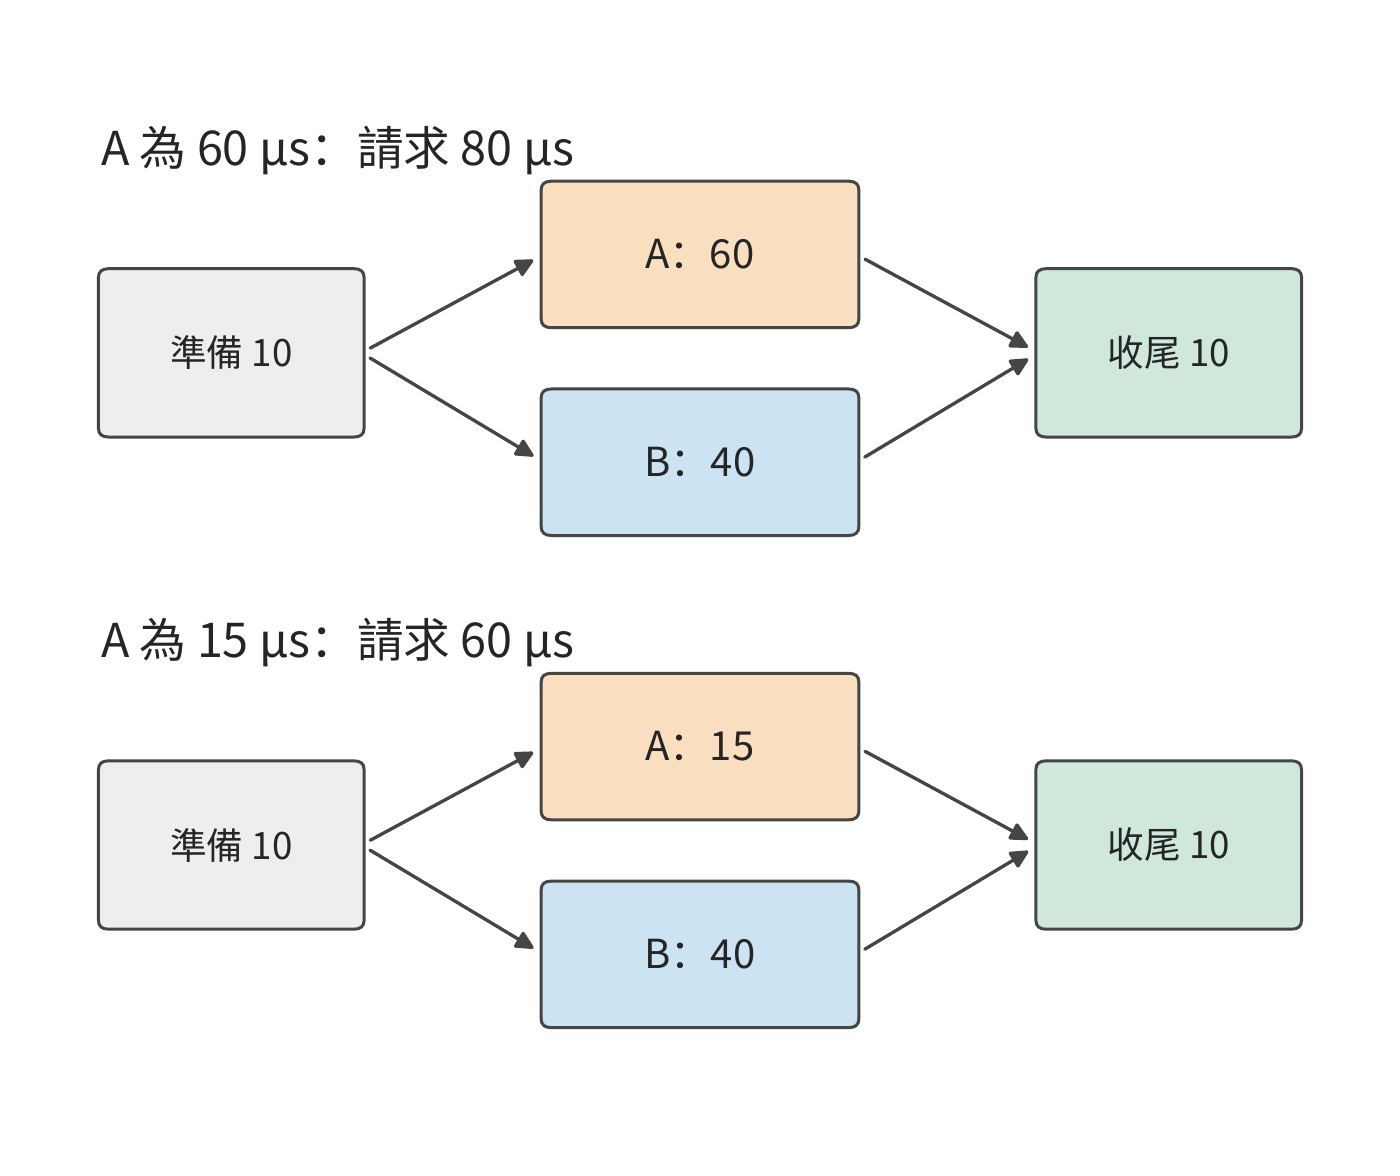
圖 5-38:收尾等待 A、B 兩條分支。A 從 60 μs 縮短至 15 μs 後,較慢分支由 A 切換為 B,請求從 80 μs 降至 60 μs。準備和收尾各為 10 μs,兩條分支使用獨立資源。
A 縮至 40 μs 時,恰好與 B 同時結束;繼續只最佳化 A,完成時間便停在 60 μs。該交點給出了單獨最佳化 A 所能獲得的最大收益。若要繼續縮短請求,應最佳化 B,或減少準備和收尾。
共享資源還會改變分支自身的時間。設 A 的新實作大量佔用頻寬,使並行執行的 B 耗時增至 90 μs,請求就變成 \(10+\max(15,90)+10=110\) μs。B 多用的時間超過了 A 節省的計算時間,整個請求反而變慢。27
關鍵路徑說明,一個分支節省的時間要放回整張依賴圖,才知道請求能快多少。儲存上的節省也要這樣放回整個執行過程:一份狀態少佔的容量,未必等於每步少讀的位元組,因為每步讀取多少,取決於有多少層讀它、每層讀哪些條目。第 2.3.6 節的 V4.1 會話已經給出 8K 條件下的一組數字:V4.1 讓 38 個全域注意力層共享 4 份全域 KV,駐留降到 V4-Flash 的約四分之一,逐層邏輯讀取卻只少約 9%,並且超過了駐留量。共享狀態不必每層各存一份副本,但用到它的每一層仍要讀取它,容量的節省不會原樣變成讀取的節省。31
上下文變長後,仍需執行的索引掃描也會帶來更多開銷。128K 時,兩代模型的全域歷史狀態與索引的邏輯讀取量分別約為 65.085 與 33.422 MiB。V4.1 後續層的索引只存取候選池,初始索引仍需遍歷全域。因此,即使後續層索引的存取範圍固定,整個 decode 的開銷仍會隨上下文長度增長。
改變開銷的不只是資料從哪裡取得,程式是否真正省去了計算也有影響。候選池把後續索引的搜尋範圍縮小,工作量隨之減少。公開參考實作先對完整索引快取執行點積,再遮蔽候選池之外的位置;論文中的生產實作直接減少後續索引掃描的條目。前者已經完成了池外點積,後者在發起計算時就省去這部分工作。同一選擇規則由此對應兩種執行成本。
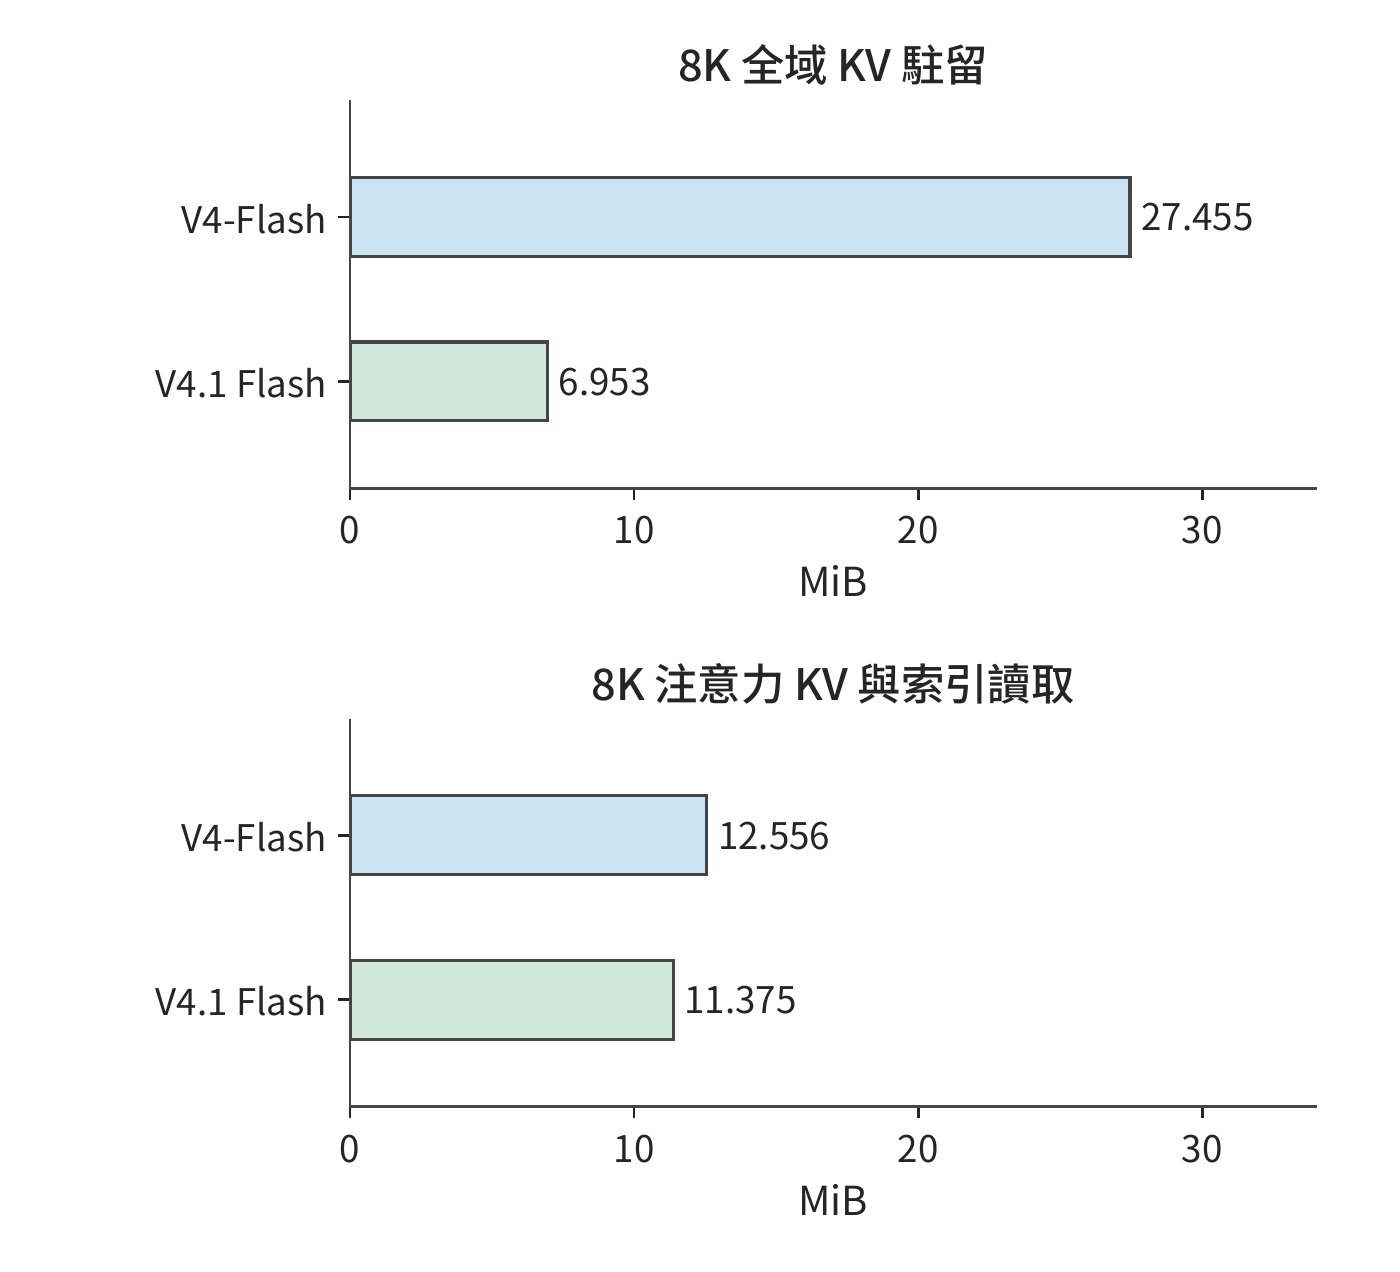
圖 5-39:全域駐留與逐層邏輯讀取分開比較。上方僅計全域 KV 容量,下方讀取包含全域條目、區域性視窗和索引;兩欄各自採用相同橫軸尺度。數值按生產佈局計算。
5.6.3 綜合案例:一次 Qwen3 請求的最佳化選擇
將這一方法用於 RTX PRO 6000 上的 Qwen3-8B。請求輸入 7239 個 token,生成 32 個輸出 token,併發為 1,採用 BF16 與 eager 執行;這裡的 eager 表示由主機按程式順序逐項提交加速器工作。模型有 36 層,先做一次 prefill 產生首輸出,再做 31 次 decode。每層每步執行一次 SwiGLU 的活化運算部分,即第 5.3.1 節的 \(Z=\operatorname{SiLU}(G)\odot U\),共有 \(36\times32=1152\) 次呼叫,其中 prefill 36 次,decode 1116 次。
兩類呼叫承擔不同工作。同一請求的 prefill 在 36 個模型層中分別對 7239 個輸入 token 執行該運算子,共處理 \(36\times7239=260604\) 個 token 表示;31 步 decode 在每層處理一個新 token,共執行 \(36\times31=1116\) 次單 token 運算子呼叫。這裡按「層數 × token 數」累計運算子工作,同一個 token 在不同層參與計算會被重複計數。decode 的呼叫數是 prefill 的 31 倍,處理的行數卻小得多。這正是本章反覆遇到的形狀差異:大矩陣提供較多並行工作,小矩陣的計算時間較短,kernel launch 和任務分配的開銷更突出,也更難充分利用加速器。
在同一引擎中,將 36 層 SwiGLU 替換為一個採用不同排程方案的 kernel,執行記錄確認 1152 次呼叫均使用了替換後的 kernel。階段計時如下。28
| SwiGLU 階段 | 呼叫形狀與次數 | 原 kernel | 替換後的 kernel |
|---|---|---|---|
| Prefill | 7239 行,36 次 | 約 11.2 ms | 約 11.2 ms |
| Decode | 1 行,1116 次 | 約 2.4 ms | 約 0.92 ms |
替換後的 kernel 主要縮短了一行輸入的 decode 活化運算時間,加速比約為 2.6,decode 部分合計節省約 1.45 ms。prefill 的活化運算耗時基本相同,替換後反而多約 0.03 ms。軌跡中的這些活化運算與其他加速器工作順序執行。原 kernel 的活化運算總計約為 13.6 ms,佔約 851 ms 採集區間的 1.6%;保持其他工作不變,即使省去全部活化運算,也最多節省 13.6 ms。目前只縮短了 decode 部分,活化運算總時間從 13.6 ms 降到 12.2 ms,因此整個請求預計減少約 1.4 ms。
在客戶端交錯測量替換前後的請求,共得到 11 對結果。替換前後的首 token 時間均約 436 ms,完整請求中位數分別約為 817 ms、815 ms。對每輪計算「替換前用時減去替換後用時」,配對時間差的中位數約為 1.3 ms,約佔原請求耗時的 0.16%,與約 1.4 ms 的預期相符。圖 5-40 列出每輪差值,其中 9 對在替換後耗時縮短,2 對在替換後耗時增加。
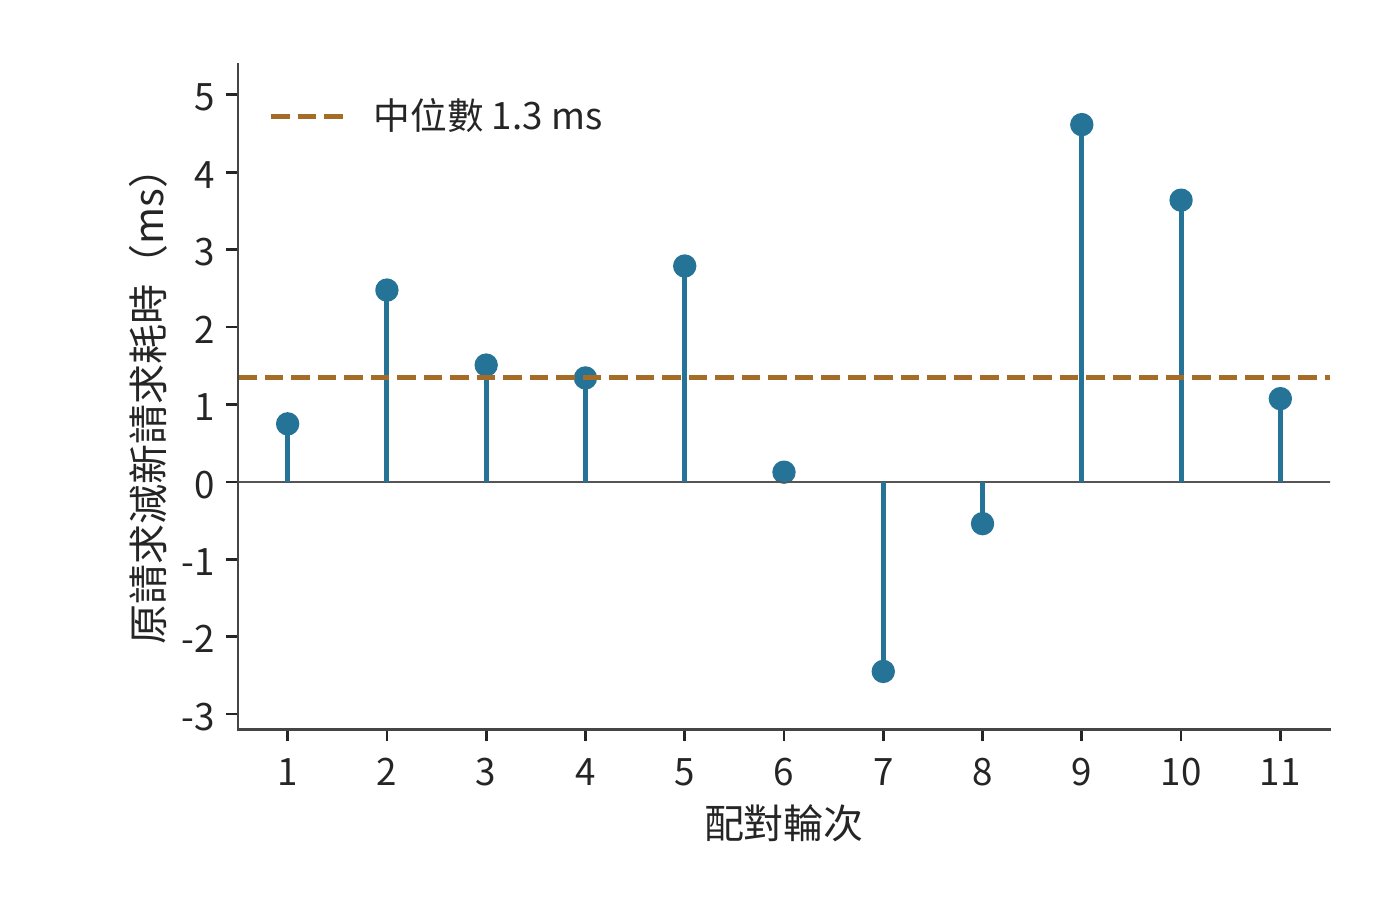
圖 5-40:同輪替換前的請求時間減去替換後的請求時間,正值表示替換後更快。RTX PRO 6000 上的 Qwen3-8B,7239 個 token 的輸入、強制 32 個 token 的輸出,併發 1,BF16、eager,關閉字首快取;11 對交錯計時,輪內順序隨機,期間有其他駐留服務。虛線為配對時間差的中位數約 1.3 ms。階段表來自單獨採集的效能分析記錄。
decode 的改進發生在首輸出之後,因此當前長輸入請求的首 token 時間仍由 prefill 中的計算與等待決定。輸出越長,一行輸入的活化運算重複執行的次數越多,單步節省的時間也就累積得越多。
分析完整請求時,首先統計各種形狀的呼叫次數,再計算每次呼叫節省的時間,最後根據依賴關係判斷這些節省能否縮短整個請求。這樣,就能把 kernel 的加速比、各階段的耗時和使用者實際等待的時間聯絡起來。
常見誤區
誤區:僅憑 kernel 數量判斷執行成本。 圖重放將 3 次 FFN 的主機提交從 18 次降到 3 次,加速器仍執行 18 個 kernel;融合才把加速器 kernel 減到 15 個。主機提交和加速器計算應分別沿各自的時間線解釋。
誤區:存取量最小的實作一定最快。 注意力的 K/V 塊從 64 行縮到 1 行,存取量減少 144 MiB,狀態更新次數卻增至約 41 倍。讀取、狀態更新與矩陣處理率共同構成執行成本。
誤區:增加緩衝就能提高吞吐率。 H100 一個 SM 上每塊搬移 1.29 μs、計算 0.28 μs,兩個槽已讓搬移器連續工作,四塊在 5.44 μs 完成。第三個槽不能讓搬移更快,加快計算也不行;要縮短時間,就要減少每塊搬移的位元組,或者提高頻寬。
誤區:穩態執行最快,總耗時就最短。 執行 70 組呼叫時,分桶約需 1.27 s,逐形狀特化約需 1.38 s。特化每組執行得更快,但節省的時間尚不足以抵消額外的準備開銷。
習題與配套實驗
以下題目沿本章算例逐步改變條件。先完成紙面推導,再用配套程式碼或執行記錄解釋差異;實驗入口保留原編號,設定、操作步驟和完整記錄見對應材料。
實驗 5-1 · 延伸:矩陣塊大小如何改變區域性儲存與讀取量
將例 5-3 的輸出塊改為 64×128,歸約塊仍為 32,求區域性儲存需求、A/W 各自的讀取次數與總存取量。與 64×64 方案相比,64×128 方案的有效頻寬至少要達到前者的多少,才能使訪存時間更短?再比較兩種迴圈次序的執行記錄,解釋連續存取如何影響處理率。5
實驗 5-2 · 核心:活化運算子融合能減少多少訪存與視訊記憶體佔用
對 G、U 各 24 MiB 的活化運算鏈,分別畫出三個運算子獨立執行和完全融合時,各張量的分配、使用與釋放順序,推導 156 MiB、60 MiB 的存取量,以及兩種方案的視訊記憶體佔用峰值。若融合實作每次增加 5 μs 固定開銷,介面頻寬取 RTX PRO 6000 的視訊記憶體頻寬 1792 GB/s,輸入行數至少達到多少時,融合節省的訪存時間才能超過這項開銷?再結合配套實驗結果,解釋存取量減少的比例與耗時縮短的比例之間的關係。7
實驗 5-3 · 延伸:分塊歸約與預取如何改變注意力計算和訪存
在例 5-6 的輸入中再加入一個元素,其分數為 \(\ln4\)、對應值為 5,更新 m、\(\ell\)、u,並與一次處理三個元素比較。保持注意力緩衝的總容量為 99 KB(101,376 bytes),從中額外劃出一個 b×d 的 BF16 預取槽,取 b=64,求新的最大 Q 行數、掃描次數與存取量。解釋預取緩衝為何會改變資料的重複讀取次數。11
實驗 5-4 · 延伸:運算子融合會改變計算結果還是執行成本
在第 5.4.2 節的虛擬碼中,分別將 SiLU 移到 ko 迴圈內、刪除中間 BF16 舍入、將量化計算移入每個輸出列塊的迴圈。說明各自改變了數學運算、數值舍入還是執行成本,並給出一個可區分前後結果或存取量的輸入。16
實驗 5-5 · 延伸:分塊迴圈如何改變存取順序與臨時儲存
用塊號與塊內座標寫出 i-k-j 的分塊迴圈,標出輸入快取和累加器在程式中的建立、最後使用與釋放位置。再對照配套轉置程式採用兩種塊大小時的執行過程,比較存取連續性、同步操作和臨時資料量,並據此解釋執行時間的差異。17
實驗 5-6 · 延伸:輸入形狀的呼叫比例如何影響調優收益
採用例 5-9 的兩種輸入形狀,令形狀 A 的呼叫佔比分別為 1/2、2/3、9/10,計算原實作和新實作的平均時間。若根據形狀選擇實作,每次多花 1 μs,對 A 使用新實作、對 B 使用原實作,何時優於始終使用原實作?再根據配套搜尋記錄,統計搜尋的總耗時,並計算找到的實作在重複呼叫中能節省多少執行時間。18
實驗 5-7 · 延伸:特化需要重複執行多少次才有收益
畫出例 5-12 中準備與執行的完整時間線。將每組中小形狀的呼叫次數從 8 次改為 4 次,其他兩種形狀仍各呼叫一次。對三種方案兩兩比較,求各對方案總耗時相等時的重複次數。再假設兩個分桶對應的程式已編譯並快取,求準備時間改變後,各方案總耗時最短時對應的重複次數範圍。24
實驗 5-8 · 核心:圖重放與運算子融合分別減少哪些開銷
閱讀圖 5-28,分別統計四種方式下的主機提交次數與加速器 kernel 數量。把例 5-11 換到 RTX 4090 上,複製頻寬取其視訊記憶體頻寬 1008 GB/s,求輸入資料增大到多少時,複製開銷恰好抵消圖重放節省的時間;再讓上游直接寫入圖緩衝,分別在輸入大小為 2 MiB 和 16 MiB 時,比較普通提交與圖重放的完成時間。25
實驗 5-9 · 核心:kernel 加速如何改變請求耗時與關鍵路徑
根據配套的 11 對請求記錄,先計算每對請求的耗時差,再取這些差值的中位數。解釋它與分別取兩組請求耗時的中位數後再相減有何區別。採用本章綜合案例的條件,保持 prefill 不變,把 decode 步數從 31 增至 127,假設每步節省的時間不變,估算活化運算總共能節省多少時間。再將圖 5-38 中 A 的執行時間逐步縮短,求完整請求時間不再隨之縮短時 A 的執行時間。28
歷史與進一步閱讀
Halide 將演算法與排程分離,使分塊、重排和計算位置成為程式設計師可組合的動作;TVM 將張量計算、後端生成與自動調優聯結起來;AKG 則將多面體排程、分層融合與片上儲存安排結合,用於神經處理器程式碼生成。沿三者的原始材料閱讀,可以進一步追蹤表達方式如何影響編譯器能夠自動完成的變換。1412
FPGA 是可設定邏輯元件,高層次綜合(HLS)將較高層程式轉換為硬體資料通路。筆者早期的 FPGA/HLS 工作,也經歷過從介面封裝轉向程式碼變換的過程:為了形成所需流水,必須識別原語和讀寫依賴,改變生成的資料通路。這段經歷說明,研究重點從簡化程式設計轉向了改進執行方式。
運算子編排最佳化系統 Korch 提供了另一個有啟發性的例子:其中一個歷史案例裡,子圖原本由三個 kernel 執行,合計耗時約 91 μs;調整為四個 kernel 後,合計耗時約 69 μs。重新拆分和組合運算子縮短了加速器執行時間,足以抵消額外的 kernel launch 和資料傳遞開銷。13 這一方向與本章的融合反例一起,說明了最佳化應比較整個計算過程的開銷。
本章小結
本章從一次矩陣投影出發,討論了儲存存取、運算子融合、編譯與執行時,最後分析完整請求。各節反覆使用了三個基本判斷。
第一,複用需要空間。更大的輸出 tile 讓同一輸入參與更多乘加,也需要更多累加儲存;保留量化結果讓多個列塊讀取位寬更低的資料,也需要中間儲存。判斷這部分儲存是否值得,應看它能減少多少重讀或重算。在 SM 上,這份空間還決定能駐留多少執行緒塊,從而決定有多少在途訪存請求可以隱藏延遲。
第二,資料依賴決定計算順序。逐元素運算可以在一個位置的輸入準備好後直接完成,歸約則要儲存部分和或線上統計。編譯器根據依賴移動計算位置,執行時透過事件確認資料是否就緒、緩衝區能否釋放。融合和流水都以這些依賴關係為基礎。
第三,總時間取決於各項工作的執行順序。頻寬決定傳輸一批資料需要多久,較慢階段決定流水線中相鄰兩塊的完成間隔,複用次數決定後續節省的執行時間能否抵消首次準備時間,關鍵路徑決定區域性改進能否縮短請求。因此,既要計算減少了多少工作,也要確定這些工作原本是否影響了最終完成時間。
下一章將這些關係推廣到多個加速器。一片結果何時就緒、誰需要讀取、要儲存多久,將決定通訊何時開始以及兩端需要多少緩衝。
-
切成幾段與合併次序的浮點復算。教學用的這一行由給定公式生成後舍入到 BF16,不是採集到的活化值;每個平方在 FP32 中都精確,各條路徑的差別只來自加法次序。精確值用有理數算得,只作比較基準;列舉合併次序覆蓋原子加可能出現的先後,不代表某個後端的實際分佈。 ↩
-
RMSNorm 三階段拆分計算。輸入和 gamma 為 BF16,gamma 每行讀取;一組一行保留輸入,三階段方案在應用階段重讀輸入。 ↩
-
實驗 5-2 的原始條件、資料與分析。RTX PRO 6000、共享 GPU、熱快取與圖重放;原始中位數為 14.20/7.68 μs,僅測活化運算子鏈。 ↩↩
-
注意力分塊與線上狀態;99 KB 緩衝下的塊大小與存取量。容量模型採用單頭、無掩碼、K/V 複用輸入槽和 S/P 複用臨時槽;每個執行緒塊 99 KB 的共享記憶體上限取自 CUDA 程式設計指南的計算能力表(計算能力 12.x 列)。 ↩
-
實驗 5-3。RTX PRO 6000 熱快取單頭對照:2.64 ms/79.5 μs;新增分配峰值約 848/22.2 MiB,包括各後端分配的臨時量。 ↩↩
-
Zhao 等,2021,AKG: Automatic Kernel Generation for Neural Processing Units using Polyhedral Transformations。 ↩↩
-
Korch 的編排案例:論文 V100/FP32 子圖,三 kernel 為 38.7、24.2、28.2 μs,四 kernel 為 7.6、18.4、7.5、35.7 μs。 ↩
-
融合合法性、FP8 舍入和量化投影;RedFuser 後端閱讀。444/620 MiB 計數包括 A、W 與輸出;行 scale 的輔助讀寫另見配套計算。 ↩↩
-
實驗 5-6 的搜尋與測量記錄;評測與部署計算。已記錄兩輪共 12 次 Agent 呼叫,未產生新的更快實作。 ↩↩
-
vLLM v0.6.0 釋出公告歸檔;收益歸因的辨析見 token 成本調研 第 8.2 節。公告的吞吐在請求同時到達、
--num-scheduler-steps 10的條件下測得,2.7 倍是三項改動的合計收益,不能全部歸於 GIL;多步排程在低負載下可能延長首個 token 的等待。 ↩ -
裝置任務組織與 MPK;八塊任務計算。投影按 RTX PRO 6000 的 BF16 稠密峰值 503.8 TFLOP/s 推得,活化運算按 1792 GB/s 視訊記憶體頻寬與每元素 4 bytes 讀寫(448 G 元素/s)推得,兩項取自硬體表;獨立資源、任務開銷和緩衝條件採用例中設定。 ↩
-
實驗 5-9 的 kernel 實作、執行記錄與 11 對請求。vLLM 0.23,替換後的 kernel 採用 block256/4-warps 排程,11 對輸出 token 一致。客戶端中位數為 816.640/815.406 ms,配對時間差的中位數 1.343 ms,首 token 中位數 435.674/436.353 ms。單獨採集的效能分析記錄中,prefill 為 11.218659/11.244366 ms,decode 為 2.369803/0.920376 ms。原 kernel 耗時 13.588462 ms,替換後 12.164742 ms,採集區間 850.848989 ms;各熱點與其他觀測 GPU 工作的時間交集為零。 ↩↩
-
SM 駐留、延遲隱藏與 MMA 指令數、累加器放入暫存器、延遲 1000 ns 與每 warp 2 條載入。SM 限制取自 CUDA 程式設計指南的計算能力表(計算能力 9.0 列)與 Hopper 調優指南,佔用率定義取自程式設計指南的 kernel 編寫一節,非同步複製、柵欄、warp 分工與 swizzle 取自非同步資料複製一節,3.35 TB/s 取自 H100 產品頁,132 個 SM 與 BF16 稠密矩陣峰值 989.4 TFLOP/s 取自 H100 架構白皮書(表 3)。每執行緒暫存器數、視訊記憶體延遲、每 warp 未完成載入數與載入寬度、MMA 指令形狀是本節選定的取值。 ↩
-
CUDA 執行模型;CUDA Runtime API 的同步語義;CUDA stream 管理與event 管理;PyTorch 鎖頁記憶體與非同步複製教程。主機複製與緩衝複用另見本章引用的本地計算材料。 ↩↩
-
DeepSeek V4.1 官方技術報告,第 1、2、3 節與第 6 節;跨章會話的固定條件與復算。 ↩
-
RTX PRO 6000 Blackwell 工作站版規格列出系統介面為 PCIe 5.0 x16;NVIDIA H100 規格給出 PCIe Gen5 x16 為 128 GB/s,是收發兩個方向的合計,每個方向 64 GB/s。 ↩
-
RTX PRO 6000 Blackwell 為 SM120 架構(見實驗 5-2 的執行環境),即計算能力 12.0;CUDA 程式設計指南的計算能力表給出該列每個 SM 的共享記憶體上限 100 KB、每個執行緒塊上限 99 KB,兩者之差即每塊的 1 KiB 預留。 ↩