Глава 9. Распределённый инференс¶
В главе 8 рассматривалось, как повысить эффективность инференса на заданном наборе вычислительных ресурсов с помощью пакетной обработки, диспетчеризации запросов, кэширования и спекулятивного декодирования. Эти методы применимы как к одной карте, так и к экземплярам, совместно выполняемым на нескольких картах. В этой главе подробнее исследуется размещение вычислений и состояния: какие этапы и операторы выполняют разные вычислительные ресурсы, как распределяются веса и KV, а также как передаются данные, распределяется работа и обрабатываются сбои между местами выполнения. С увеличением контекста состояние может стать больше весов: в примере из раздела 9.2.3 при batch size, равном 32, KV занимает в сумме 43,5 ГБ — примерно в 2,7 раза больше весов Qwen3-8B. Поэтому размещение и передача состояния не менее важны, чем распределение вычислений.
В этой главе P обозначает этап prefill, а D — этап decode. При разделении PD эти два этапа передаются разным ресурсам. При разделении AF внимание и сеть прямого распространения каждого слоя, включая сеть экспертов, передаются разным ресурсам.
В связи с размещением вычислений и состояния в этой главе рассматриваются четыре основных способа организации. Добавление полных реплик позволяет разным группам ресурсов обрабатывать запросы независимо. Разделение prefill и decode позволяет отдельно выделять вычислительные ресурсы для каждого этапа; разделение вычислений внимания и экспертов позволяет использовать вычислительные возможности и возможности хранения данных разных ресурсов; совместное использование KV позволяет запросам применять состояние, оставленное в других местах выполнения. Эти способы организации могут применяться как внутри одного экземпляра инференса, так и для соединения нескольких независимо диспетчеризируемых пулов сервисов.
Проектная задача этой главы такова: один сервер оснащён четырьмя A100 80GB SXM, другой — четырьмя H20 SXM5 96GB. Как этим восьми картам обрабатывать 3,5 запроса, поступающих каждую секунду? Каждый запрос содержит 8192 входных токена и 1025 выходных токенов и предполагает рассуждение: модель сначала генерирует достаточно длинные рассуждения, а затем выдаёт ответ. Используется модель Qwen3-8B; веса и KV хранятся в формате BF16 по 2 байта на элемент. Каждая карта вмещает полную модель, поэтому одна карта представляет собой один исполнитель (worker). Между двумя серверами нет NVLink, и обмен данными возможен только через сетевые адаптеры RDMA. Далее последовательно определяется, как распределить вычисления, где передавать контекст, когда имеет смысл сохранять кэш и за какое время после запуска удастся устранить накопившуюся очередь. В разделе 9.7 эти результаты будут объединены для выбора схемы развёртывания на данном наборе ресурсов. Для сравнения в разделе 9.2 также анализируется однородный кластер из восьми A100.
Другой пример, рассматриваемый в разделах 9.3 и 9.4, использует Qwen3-235B-A22B и исследует размещение весов экспертов. При одних и тех же 512 назначениях экспертов в зависимости от результатов назначения может потребоваться считать веса множества экспертов либо многократно использовать веса небольшого числа часто востребованных экспертов. На этой основе определяется, где следует выполнять вычисления экспертов — на CPU или GPU, а затем рассматривается, почему при концентрации часто востребованных экспертов на одной карте необходимы их реплики. В обоих примерах применяется один и тот же метод анализа: сначала определяется объём работы и состояния, необходимый для каждого запроса, а затем оценивается скорость, с которой различные типы процессоров могут выполнить эту работу, а системы хранения — предоставить необходимые данные.
9.1 Способы распределения вычислений и состояния¶
9.1.1 Вычислительные ресурсы, экземпляры инференса и реплики сервиса¶
Сначала разграничим организацию оборудования и организацию сервиса. Ускорители, такие как GPU и NPU, а также CPU предоставляют вычислительные мощности и соответствующие ресурсы хранения; процессы выполняют на этих устройствах модель и коммуникационную логику. Каждый процесс в коммуникационной группе имеет свой rank. Один экземпляр инференса может совместно выполняться несколькими такими процессами. Полная реплика сервиса обладает весами и вычислительными возможностями, необходимыми для выполнения всего инференса модели, и может обрабатывать запросы независимо от других реплик.
На рис. 9-1–9-4 показаны четыре способа организации. В первых двух случаях выполняется полная модель; различие состоит в том, что группа из восьми совместно работающих карт обрабатывает один и тот же пакет запросов, а несколько полных реплик независимо принимают запросы. В следующих двух случаях разделение задач меняется ещё сильнее: PD разделяет их по этапам генерации, а AF — по операторам внутри слоя. У каждого способа организации есть собственный планировщик, управляющий закреплёнными за ним вычислениями.
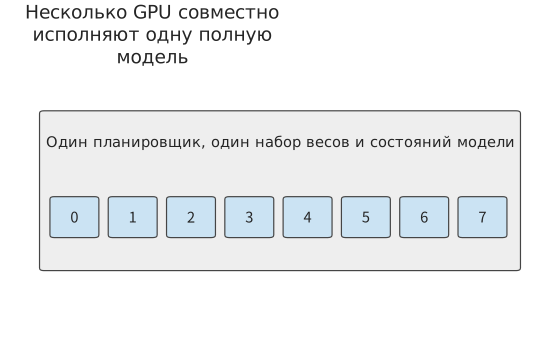
Рис. 9-1. Восемь карт совместно выполняют один полный экземпляр инференса и принимают один и тот же пакет запросов. Номера карт обозначают участников группы.
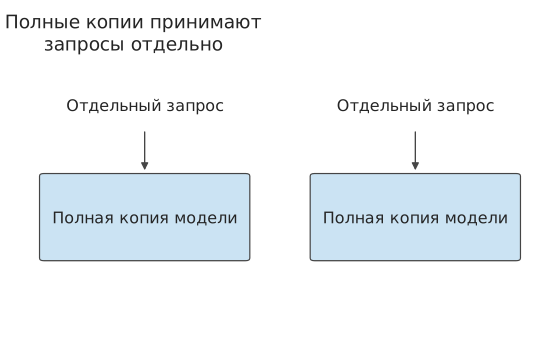
Рис. 9-2. Каждая реплика способна выполнить инференс целиком и может независимо принимать запросы. Сама реплика также может состоять из нескольких карт.
Полные реплики разделяют работу по запросам; на рис. 9-3 один и тот же запрос последовательно проходит через два пула сервисов. Если проследить стрелку от P к D, передаётся контекстный KV, оставшийся после обработки входных данных, а каждый из двух пулов по-прежнему выполняет полную модель для соответствующего этапа.
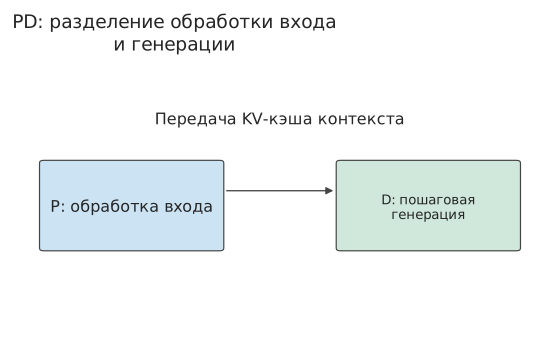
Рис. 9-3. P обрабатывает входные данные, D продолжает генерацию. Два пула сервисов планируются независимо, а контекстный KV передаётся от P к D.
На рис. 9-4 граница разделения перенесена внутрь слоя модели: активации, созданные на стороне attention, передаются на сторону feed-forward, после чего результат возвращается обратно. В отличие от однократной передачи между этапами, данные проходят по этому пути снова и снова на каждом слое и каждом шаге генерации.
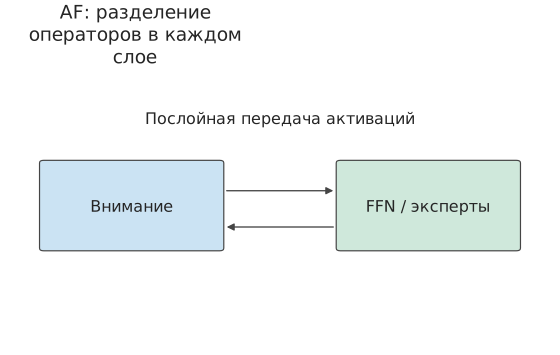
Рис. 9-4. Attention и FFN/эксперты выполняются раздельно, а скрытое состояние в виде активаций передаётся между двумя сторонами туда и обратно. Такая передача требуется на каждом слое.
При сравнении этих способов развёртывания сначала следует использовать конфигурацию выполнения и скорость обработки, полученные в главе 8, а затем изменять распределение работы между вычислительными ресурсами. Способ, при котором P и D обрабатываются одной и той же группой исполнительных ресурсов, называется совместным размещением. Рассмотрим уже оптимизированный экземпляр с совместным размещением. Длина входа запроса равна \(L\), а полная длина выхода — \(G\); prefill вычисляет logits для последнего входного токена, из которых затем сэмплируется первый выходной токен. В соответствии с принятым в этой главе соглашением о генерации последующих вызовов decode будет \(G-1\): последний возвращённый токен ещё не был передан модели, поэтому число выходных токенов на единицу больше числа последующих вызовов decode.
Для заданного распределения запросов обозначим через \(d_r\) среднее время обслуживания одного запроса на ресурсе \(r\), а через \(n_r\) — число независимо работающих единиц ресурсов этого типа. Интенсивность поступления запросов и время занятости ресурсов должны удовлетворять условию
где \(\lambda\) — интенсивность поступления запросов. Если несколько операций используют один ресурс, сначала следует сложить время, в течение которого каждая из них занимает этот ресурс; если операции используют независимые друг от друга ресурсы, ограничение следует записать отдельно для каждого типа ресурсов. Объём использования ресурса рассчитывается как «число ресурсов × количество секунд занятости»; в этой главе ресурсом служит GPU, поэтому это произведение измеряется в GPU-секундах. Например, если каждую секунду поступает четыре запроса и каждый занимает 0,5 GPU-секунды, потребуются два непрерывно работающих GPU. Если карт ровно две, дополнительные запросы из всплеска нагрузки будут продолжать накапливаться, поскольку обе карты заняты непрерывно поступающими последующими запросами; ликвидировать накопившуюся после всплеска очередь можно только после добавления GPU.
Пусть prefill и decode одного запроса занимают на реплике данного типа соответственно \(d_P\) и \(d_D\) секунд, а два этапа выполняются на этой реплике последовательно. Тогда верхний предел интенсивности обработки запросов для \(N\) одинаковых реплик с совместным размещением равен
В разделе 9.2.3 время обслуживания на каждом этапе для двух типов карт, упомянутых в начале главы, будет выведено из пиковых значений в таблице данных. Один A100 выполняет prefill для 8192 токенов примерно за 0,86 секунды, а 1024 вызова decode одного запроса в сумме занимают около 1,76 GPU-секунды; на одном H20 prefill занимает около 1,81 секунды, а decode — лишь около 0,88 GPU-секунды. Каждая полная реплика должна выполнять оба этапа, поэтому на один запрос A100 расходует 2,62 GPU-секунды, а H20 — 2,68 GPU-секунды. Восемь карт в совокупности выполняют примерно 3,02 запроса в секунду, что ниже интенсивности поступления в 3,5 запроса в секунду, поэтому очередь растёт примерно на 0,5 запроса каждую секунду. Теперь задача сформулирована чётко: позволит ли иное распределение работы между теми же восемью картами устранить дефицит в 0,5 запроса/с.
Реплика может состоять из нескольких совместно работающих карт. Например, один из вариантов развёртывания Qwen3-235B-A22B с TP2×EP4, где TP делит матрицу экспертов на две части, а EP распределяет экспертов по четырём группам, использует восемь карт для обработки одного и того же пакета запросов: каждые две карты делят между собой матрицу экспертов, а четыре группы EP содержат разные наборы экспертов. Attention и KV реплицируются в каждой из четырёх групп EP, поэтому контекст одного запроса длиной 8192 токена занимает во всём экземпляре 5,875 GiB — в четыре раза больше одной логической копии KV. Эти восемь карт совместно образуют один экземпляр инференса; для добавления реплики, способной независимо обрабатывать запросы, потребуется отдельно разместить ещё один полный набор весов и состояния.1
9.1.2 Разделение вычислений и совместное использование состояния¶
Добавление полных реплик изменяет распределение запросов; разделение PD изменяет место выполнения prefill и decode; разделение AF изменяет место выполнения attention, FFN и экспертов; совместное использование KV изменяет область хранения и чтения контекстного состояния. Эти способы развёртывания изменяют разные части системы: их можно вводить по отдельности или комбинировать.
| Способ развёртывания | Ожидаемая выгода | Новые основные ограничения |
|---|---|---|
| Добавление полных реплик | Обработка большего числа независимых запросов, распределение очереди | Копирование модели, разрозненные кэши, запуск и поддержание работы экземпляров |
| Разделение PD | Независимая настройка мощности двух этапов | Передача KV, одновременное использование памяти на обеих сторонах, две очереди |
| Разделение AF | Использование операторами подходящих вычислительных ресурсов и ресурсов хранения | Передача активаций туда и обратно на каждом слое, синхронизация, балансировка нагрузки между этапами конвейера |
| Совместное использование KV | Повторное использование контекста между экземплярами, сокращение повторных prefill | Идентификация кэша, чтение, уведомление о готовности, инвалидация и освобождение пространства |
При выборе способа развёртывания сначала следует проанализировать потребности текущей нагрузки в ресурсах. Если потребности двух этапов в ресурсах близки, полные реплики уже могут обеспечивать сбалансированное обслуживание, а разделение способно лишь добавить накладные расходы на передачу. Если многие запросы используют общий длинный префикс, межэкземплярный кэш может оказаться полезнее дальнейшего разделения вычислений. Раздельный расчёт занятости ресурсов и времени передачи позволяет определить, что сейчас требуется: добавить реплики, разделить этапы или организовать совместное использование состояния.
9.1.3 Путь выполнения одного запроса и время пребывания состояния¶
После выбора способа разделения работы следует проследить временную шкалу одного запроса: через какие этапы он проходит и какое состояние оставляет. На рис. 9-5 этапы вычисления многораундового запроса и время пребывания состояния показаны на одной временной шкале. При наличии визуального входа этап кодирования E преобразует изображение в признаки, используемые моделью, а EC сохраняет результаты кодирования для повторного использования. P обрабатывает результаты кодирования и текст, D пошагово генерирует выходные данные; после возврата результата инструментом в новом раунде P обрабатывает добавленную информацию. Веса обычно сохраняются между запросами, активации в основном передаются между соседними операторами, а KV растёт по мере увеличения числа обработанных позиций. На время ожидания инструмента вычисления можно приостановить, но контекстное состояние при этом всё равно может занимать память.
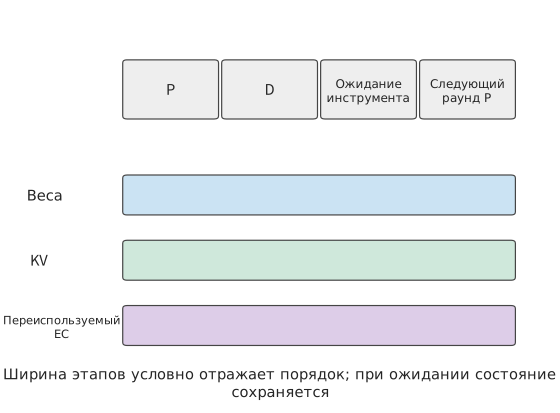
Рис. 9-5. Во время приостановки вычислений состояние всё равно необходимо сохранять. Показано время пребывания состояния одного запроса от prefill и decode до ожидания инструмента и следующего раунда; горизонтальная ось упорядочена по этапам и не означает равную длительность, EC присутствует только при наличии визуального входа. E — визуальное кодирование, EC — сохранённый результат визуального кодирования, P — prefill, D — decode.
На примере используемой в этой главе Qwen3-8B одна копия контекстного KV в формате BF16 для 8192 токенов занимает 1,125 GiB. Если инструмент выполняется 10 секунд, GPU может обрабатывать другие запросы, но этот контекстный KV всё равно занимает 1,125 GiB памяти, а произведение объёма на время использования составляет 11,25 GiB·с; десять одновременно ожидающих таких сеансов займут 11,25 GiB. После приостановки вычислений состояние всё равно необходимо сохранять — именно эту задачу решают общий кэш и стратегии выгрузки.
Если затем этот запрос вернёт 1025 токенов, P сначала создаст первый выходной токен, после чего 1024 вызова decode обработают первые 1024 сгенерированных токена. В этот момент непрерывный KV охватывает \(8192+1024=9216\) токенов, а последний возвращённый токен ещё не передан обратно модели. Следующий раунд продолжается после этих 9216 токенов: сначала обрабатываются ещё не записанный в KV последний токен и новые входные данные, после чего генерация возобновляется с этой позиции.
9.2 Разделение Prefill–Decode и распределение ресурсов¶
9.2.1 Зачем разделять Prefill и Decode¶
Prefill может за один вызов обработать множество новых токенов, а крупные матричные вычисления обычно позволяют эффективнее переиспользовать веса. На этапе decode каждый запрос за один шаг обычно обрабатывает лишь один новый токен, поэтому приходится многократно считывать веса и состояние контекста. При совместном выполнении двух этапов длительный prefill может задержать вывод следующего токена для уже обрабатываемых запросов, а чрезмерный приоритет decode увеличивает время ожидания новых запросов.
В разделе 8.2 блочный prefill уже применялся для сокращения блокировки decode длинным вводом. В этом разделе при тех же модели и запросах дополнительно изменяется место выполнения. Разделение PD размещает два этапа в разных пулах обслуживания с независимыми очередями, пакетной обработкой и распределением ресурсов. DistServe и Splitwise — системы инференса, исследующие раздельное развёртывание P и D. В однородном кластере из восьми A100 разделение устраняет влияние планирования одного этапа на другой благодаря независимым очередям. В гетерогенном кластере из A100 и H20 каждый тип карт может выполнять только тот этап, для которого он подходит лучше всего.2
Такое разделение труда похоже на ситуацию, когда один человек сначала полностью читает материал, а затем передаёт его другому для продолжения работы: принимающей стороне нужны уже накопленные рабочие записи. Для модели из этого примера передаваемой записью служит контекстный KV-кэш. P и D обрабатывают разные этапы одного запроса, причём на каждом этапе выполняется полный прямой проход. P для Qwen3-8B обрабатывает 8192 входных токена, после чего D вызывается 1024 раза; каждый вызов проходит через attention и feed-forward network. Поэтому обоим пулам нужны полные веса модели, а KV-кэш передаётся от P к D. Выигрыш от независимой пакетной обработки прежде всего должен компенсировать эту дополнительную передачу.
Приложение одним вызовом запрашивает полный инференс модели, тогда как внутри сервиса разные ресурсы могут назначаться по этапам. Зависимости данных модели определяют точку разделения этапов, KV-кэш задаёт состояние, которое необходимо передать между ними, а соотношение нагрузок определяет требуемый объём ресурсов каждого пула. Используя эти сведения, сервис может за единым интерфейсом вызова отдельно выбирать batch и вычислительные ресурсы для обработки ввода и пошаговой генерации.
9.2.2 Передача KV-кэша и потребление памяти на обеих сторонах¶
После завершения обработки ввода на P этапу D требуется получить контекстный KV-кэш, чтобы продолжить генерацию. В GQA несколько голов запросов используют общий набор ключей и значений, а для каждого токена контекста сохраняются полные ключи и значения. Пусть число слоёв равно \(n\), длина контекста — \(L\), число KV-голов — \(h_{kv}\), размерность одной головы — \(d_h\), а размер одного элемента — \(b\) байт. Тогда логический размер состояния равен
Коэффициент 2 соответствует K и V. Фиксированная конфигурация Qwen3-8B содержит 36 слоёв, 8 KV-голов и размерность головы 128. KV-кэш в формате BF16 занимает 144 KiB на токен; для 8192 токенов он занимает
Пример 9.1. Сколько времени занимает передача KV-кэша между prefill и decode? Сервер A100 и сервер H20 соединены сетевой картой RDMA на 200 Gbit/s, однонаправленная пропускная способность полезной нагрузки принимается равной 25 GB/s, а состояние передаётся целиком напрямую. Время передачи только полезной нагрузки равно
После добавления 5 μs на запуск и синхронизацию общее время по-прежнему составляет около 48.3 ms: для полного объёма этих KV-данных фиксированные накладные расходы составляют лишь около одной десятитысячной, поэтому увеличение пропускной способности полезной нагрузки эффективнее сокращает время ожидания. Однако при послойной передаче AF небольшими объёмами доля фиксированных накладных расходов будет выше.3
Приведённый выше размер состояния обусловлен способом хранения в GQA. MLA (раздел 2.3.2) сохраняет не развёрнутые ключи и значения, а латентные переменные до повышающей проекции: для каждого токена на каждом слое хранятся только одна латентная переменная размерности \(d_c\) и одна позиционная ветвь размерности \(d_r\). Размер состояния равен
Фиксированная конфигурация DeepSeek-V3 содержит 61 слой, \(d_c=512\) и \(d_r=64\). В формате BF16 каждый токен занимает \(61\times576\times2=70{,}272\) байт, или около 68.6 KiB; контекст из тех же 8192 токенов занимает 549 MiB. При использовании канала 25 GB/s из примера 9.1 передача только полезной нагрузки занимает около 23.0 ms; при увеличении скорости канала до 50 GB/s — 11.5 ms; состояние GQA по тому же каналу передаётся за 24.2 ms.
| Передаваемое состояние | На токен | 8192 токена | 25 GB/s | 50 GB/s |
|---|---|---|---|---|
| Qwen3-8B, BF16 GQA | 144 KiB | 1.125 GiB | 48.3 ms | 24.2 ms |
| DeepSeek-V3, компактное BF16 MLA | 68.6 KiB | 549 MiB | 23.0 ms | 11.5 ms |
Состояние MLA меньше, поскольку кэш размещается по другую сторону линейного преобразования: GQA сохраняет развёрнутые \(K\) и \(V\) для каждой KV-головы, а MLA — только латентную переменную до повышающей проекции. Благодаря ассоциативности повышающую проекцию можно перенести на сторону текущего запроса. Если также хранить в развёрнутом виде 128 голов DeepSeek-V3, каждый токен будет занимать \(61\times128\times(192+128)\times2\) байт, или около 4.77 MiB, что в 71 раз больше компактного представления; при этом компактное MLA занимает лишь 0.48 от объёма GQA в Qwen3-8B, где всего 8 KV-голов. Далее везде, где в формулы входит объём KV-кэша в байтах, параллельно приводятся результаты для обоих состояний.6
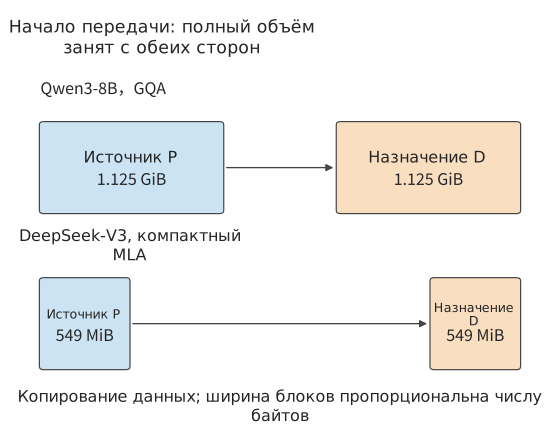
Рисунок 9-6. Источник P сохраняет полное состояние, а получатель D одновременно выделяет приёмный буфер того же размера. Состояние GQA занимает по 1.125 GiB на каждой стороне, всего 2.25 GiB во время передачи; компактное состояние MLA занимает по 549 MiB, всего 1.07 GiB. Ширина прямоугольников пропорциональна числу байтов.
При передаче всего состояния с двойной буферизацией источник сохраняет его полностью до окончания передачи, а получатель выделяет полный приёмный буфер. На рисунках 9-6–9-8 последовательно показаны три момента: начало передачи, её завершение и освобождение памяти источника. После записи всей полезной нагрузки на стороне получателя P отправляет маркер завершения, и D считывает состояние только после получения этого маркера (рисунок 9-7). P освобождает исходный буфер лишь после передачи управления D (рисунок 9-8). При блочной передаче источник может заранее освободить блок после того, как получатель подтвердит его получение, сократив время дублирующего размещения на двух сторонах; по маркерам завершения получатель определяет, какие последовательные блоки уже доступны. Если данные передаются через основную память, состояние последовательно занимает буферы источника, основной памяти и получателя, а копирование из основной памяти в GPU становится новой зависимостью.
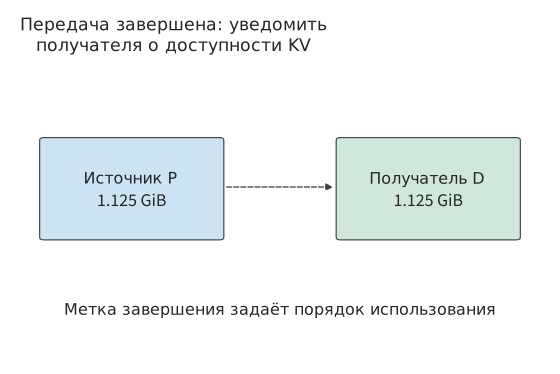
Рисунок 9-7. Полная полезная нагрузка объёмом 1.125 GiB уже записана на стороне получателя, после чего P отправляет маркер завершения. Сам маркер больше не перемещает данные, а лишь задаёт порядок: сначала завершить запись, затем использовать данные. D считывает состояние только после получения маркера.
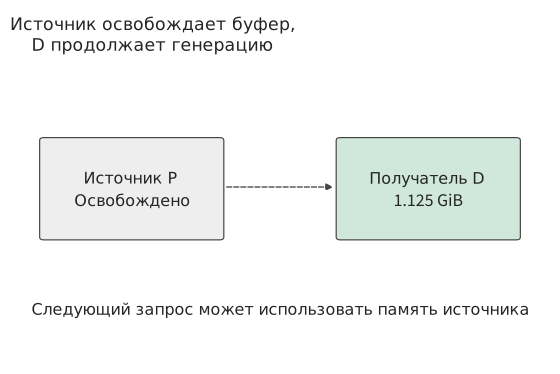
Рисунок 9-8. В этом примере исходный буфер P освобождается после передачи управления D, а D сохраняет контекст и продолжает генерацию. Память источника используется для последующих запросов.
При непрерывном поступлении запросов пропускная способность канала ограничивает как число состояний, которые можно передать за секунду, так и время передачи каждого состояния. Для 8 таких передач в секунду требуется около 9.7 GB/s, а для 16 — около 19.3 GB/s. Порт 100 GbE (Ethernet 100 Gbit/s) обеспечивает 12.5 GB/s в каждом направлении и удовлетворяет средней потребности в первом случае, однако каждый запрос всё равно должен дождаться завершения передачи. Во втором случае ситуация иная: даже при наличии свободных вычислительных ресурсов в обоих пулах сетевая очередь будет непрерывно расти. В первом случае передача каждого состояния занимает около 96.6 ms, а во втором каждую секунду будет накапливаться около 6.8 GB данных, ожидающих передачи. Время передачи определяет минимальное ожидание отдельного запроса, а разность между скоростью поступления данных и скоростью их передачи — темп роста очереди. Для компактного состояния MLA объёмом 549 MiB 8 и 16 передач в секунду требуют лишь около 4.6 и 9.2 GB/s соответственно. Один порт 100 GbE удовлетворяет средней потребности в обоих случаях, а передача каждого состояния занимает около 46.1 ms. Рост очереди совместно определяется числом байтов состояния и пропускной способностью канала: при смене представления контекста модели вывод для того же канала может стать противоположным.
9.2.3 Производительность этапов и соотношение числа экземпляров¶
Перед сравнением скорости обработки на разных этапах следует сначала вычислить объём работы, который один запрос требует на каждом из них. Пусть запрос содержит \(L_{new}\) новых токенов, которые должен обработать P, и \(G-1\) вызовов decode. Эффективная производительность worker определённого типа равна соответственно \(r_P\) новых токенов/s и \(r_D\) вызовов decode/s. Тогда требуемое этому worker время на один запрос равно
Это время занятости ресурсов можно складывать напрямую; показатели входных токенов/s и выходных токенов/s сначала необходимо преобразовать в потребности одного и того же запроса. Когда несколько запросов в batch совместно используют один вызов decode, завершённый шаг decode следует учитывать для всех запросов, но время занятости ресурсов учитывается один раз — по единственному пакетному выполнению.
Значения \(r_P\) и \(r_D\) для двух типов карт можно вывести из таблицы характеристик. Модель Roofline из главы 4 задаёт нижнюю границу времени каждого этапа как максимум из времени вычислений и времени доступа к памяти. В следующей таблице приведены пиковые показатели двух карт. Вычислительная производительность H20 составляет менее половины производительности A100, но пропускная способность видеопамяти примерно вдвое выше. Именно поэтому H20 хорошо подходит для decode и плохо — для prefill.
| Карта | Плотная производительность BF16 | Пропускная способность видеопамяти | Объём видеопамяти |
|---|---|---|---|
| A100 80GB SXM | 312 TFLOP/s | 2039 GB/s | 80 GB |
| H20 SXM5 96GB | 148 TFLOP/s | 4096 GB/s | 96 GB |
Реальные kernel не достигают пиковых показателей. В разделе 8.6.3 две эффективности были откалиброваны по последовательным замерам на RTX PRO 6000: эффективность использования пропускной способности при decode возрастает с 33% при batch size 1 до 65% при batch size 64, а при batch size 32 интерполяция между измеренными значениями даёт около 49%; эффективность использования вычислительной производительности при prefill стабильно составляет 58%–62%. В этой главе для обоих показателей принимается 50% от пикового значения: на стороне decode это соответствует интерполяции для batch size 32, а на стороне prefill примерно на одну десятую ниже измеренного значения. При таком допущении эффективные вычислительная производительность и пропускная способность A100 равны 156 TFLOP/s и 1020 GB/s, а H20 — 74 TFLOP/s и 2048 GB/s.
Принять 50% означает задать MFU и MBU из раздела 1.2.2 равными 0.5: половина возможностей оборудования не преобразуется в вычисления модели. Согласно критериям раздела 1.3.4, у этой половины есть два источника. Первый — работа, не учтённая моделью первого порядка в этой главе, например нулевые строки, которыми kernel дополняет данные до размера tile, или коммуникации, не перекрытые вычислениями. Второй — устранимые накладные расходы на стороне хоста, например последовательный запуск отдельных kernel, пересоздание коммуникационных групп и графов выполнения перед переключением. По одному примеру приведено в разделах 9.4.3 и 9.6.2.
Подставим эти две группы эффективных характеристик в запрос из начала главы. Prefill обрабатывает 8192 входных токена, требуя 133.6 TFLOPs матричных вычислений, но лишь однократно считывает около 15 GB весов, поэтому ограничен вычислительной производительностью. На A100 требуется 0.856 секунды, что соответствует примерно 9570 новым токенам в секунду; на H20 — 1.81 секунды и около 4540 токенов в секунду. Один шаг decode генерирует по одному токену для каждого из 32 запросов в batch. Если принять средний контекст в процессе генерации равным \(8192+512=8704\) токенам, за один шаг считывается около 15.1 GB весов и 41.1 GB KV-кэша, а объём матричных вычислений составляет лишь 0.65 TFLOPs, поэтому этап ограничен пропускной способностью видеопамяти. На A100 один шаг занимает 55.1 ms, что соответствует примерно 580 вызовам decode в секунду; на H20 — всего 27.4 ms и около 1166 вызовов в секунду. Сильные и слабые стороны двух карт прямо противоположны: A100 выполняет prefill более чем вдвое быстрее H20, а H20 выполняет decode вдвое быстрее A100. При batch size 32 к концу генерации KV-кэш всех запросов занимает 43.5 GB, а вместе с весами — около 59.9 GB, что помещается на обоих типах карт.5
Сначала рассмотрим однородный сценарий: восемь A100 выполняют одну и ту же модель. При совместном размещении на один запрос каждая карта расходует \(0.856+1.764=2.62\) GPU-секунды, а суммарная производительность восьми карт составляет 3.05 запроса/s. После разделения два пула можно формировать только из целого числа карт: три карты для P обеспечивают 3.50 запроса/s, а пять карт для D — 2.83 запроса/s. Верхний предел равен 2.83 запроса/s, что на 7% ниже совместного размещения. В этом расчёте потребность каждого этапа в GPU-секундах на запрос до и после разделения принята неизменной, поэтому само разделение не повышает расчётный предел пропускной способности; выбранное целочисленное разбиение также не позволяет точно уравнять производительность пулов, и часть мощности остаётся неиспользованной. Этот вывод относится к условиям примера, а не к любому однородному кластеру: независимый выбор batch size и параллелизма для P и D может изменить потребность этапов в GPU-секундах, и её нужно оценивать заново. Кроме общей пропускной способности (throughput), следует отдельно сравнивать goodput — производительность при соблюдении заданных SLO: изоляция очередей может улучшить её даже без роста общего throughput.4
Уточнение русского издания: у автора — «Каждый запрос до и после разделения расходует одинаковое число GPU-секунд, поэтому однородное разделение не может повысить пропускную способность». Вывод ограничен условиями данного расчёта, а не всеми однородными кластерами; отдельно указано различие между throughput и goodput. Источники: расчёт по округлённым данным примера — \(8/(0.856+1.764)=3.05\) против \(\min(3/0.856,5/1.764)=2.83\) запроса/s; DistServe, где независимо выбираются ресурсы и параллелизм двух этапов для выполнения ограничений TTFT и TPOT.
Взамен однородное разделение обеспечивает стабильность задержки. При совместном размещении без разбиения на блоки один prefill длиной 8192 токена монопольно занимает A100 примерно на 0.86 секунды, останавливая генерацию всех находящихся в обработке запросов на этой карте, что эквивалентно пропуску примерно 16 шагов decode длительностью 55 ms. Если эти восемь карт принимают 2.5 запроса в секунду, на каждой карте такой prefill в среднем приходится вставлять раз в 3.2 секунды. После разделения каждый шаг на картах D стабильно занимает 55 ms; карты P специализируются на обработке ввода, а время до первого токена складывается из 0.86 секунды prefill и передачи KV-кэша.
Блочный prefill из раздела 8.2 — альтернативный разделению подход. На A100 доступ к памяти при одном шаге decode занимает 55.1 ms, а матричные вычисления — лишь 4.2 ms, поэтому вычислительные ресурсы в оставшееся время простаивают. При производительности 156 TFLOP/s этого простоя достаточно для обработки примерно 490 токенов prefill. Ввод из 8192 токенов можно разделить на 17 блоков и обработать попутно за 17 шагов decode. Время до первого токена составит около 0.94 секунды, что сопоставимо с разделением, а интервал вывода для уже обрабатываемых запросов не изменится. Если попутные вычисления полностью скрываются временем доступа к памяти, верхний предел производительности восьми совместно используемых A100 возрастает до 4.50 запроса/s, значительно превышая 2.83 при разделении. Фактический объём скрываемых вычислений зависит от того, могут ли одновременно выполняемые блочный prefill и decode полностью задействовать вычислительные ресурсы и пропускную способность; это следует определять по измеренному времени смешанного шага. Поэтому в однородном кластере обычно сначала применяют блочный prefill. Ценность разделения состоит в возможности независимо выбирать способ параллелизма и batch size для двух этапов, а также полностью изолировать их очереди друг от друга.
Пример 9.2. Как распределение этапов в гетерогенном кластере определяет верхний предел пропускной способности? Используются 8192 входных токена и 1025 выходных токенов. Производительность этапов для четырёх A100 и четырёх H20 выводится описанным выше способом и приведена в следующей таблице; при последующем изменении состава запросов расчёт аналогично повторяется с новым объёмом работы.
| Карта | Производительность P, новых токенов/s | Производительность D, вызовов/s | GPU-секунд P на запрос | GPU-секунд D на запрос |
|---|---|---|---|---|
| A100 80GB SXM | 9566 | 580 | 0.856 | 1.764 |
| H20 SXM5 96GB | 4538 | 1166 | 1.805 | 0.878 |
При совместном размещении один запрос занимает 2.62 GPU-секунды на одной A100 и 2.68 GPU-секунды на одной H20, а восемь карт в сумме обеспечивают 3.02 запроса/s. Если назначить четыре A100 пулу P, а четыре H20 — пулу D, пул P обеспечит \(4/0.856\approx4.67\) запроса/s, а пул D — \(4/0.878\approx4.55\) запроса/s. На каждый запрос передаётся 1.125 GiB. Если между двумя серверами установлена одна сетевая карта на 200 Gbit/s, пропускная способность 25 GB/s позволяет передавать около 20.7 состояния в секунду. Тогда общий верхний предел пропускной способности равен
Здесь \(\mu_P\) и \(\mu_D\) — верхние пределы частоты запросов пулов P и D, а \(B_{net}\) — пропускная способность канала передачи между двумя пулами.
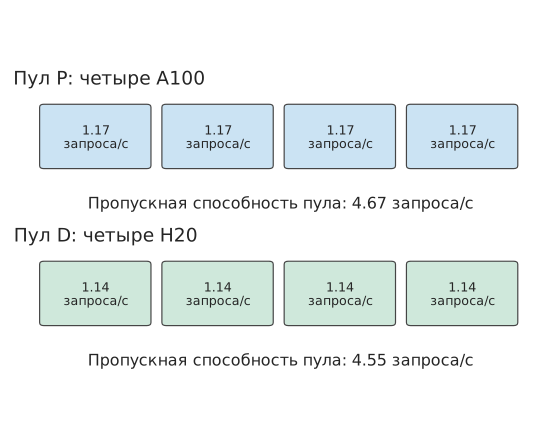
Рисунок 9-9. Каждая A100 обеспечивает около 1.17 запроса/s на этапе P, а каждая H20 — около 1.14 запроса/s на этапе D. Производительность пула P равна 4.67 запроса/s, пула D — 4.55 запроса/s; обе ниже пропускной способности сетевой карты, составляющей около 20.7 запроса/s в пересчёте на передачу состояний.
После разделения оба типа карт избегают более медленного для себя этапа, и верхний предел частоты запросов возрастает с 3.02 до 4.55 запроса/s, то есть в 1.51 раза относительно совместного размещения, превышая скорость поступления 3.5 запроса в секунду. Модель по-прежнему обрабатывает те же 8192 входных токена и 1024 вызова decode; меняется лишь исполнитель. Если поменять роли местами, назначив H20 для P, а A100 для D, производительность пула P составит всего 2.22 запроса/s, то есть верхний предел составит менее половины уровня при правильном распределении.
Попутный блочный prefill, рассмотренный выше для однородного кластера, на H20 даёт ограниченный эффект: свободной вычислительной производительности за один шаг decode хватает лишь примерно на 85 токенов prefill. Даже при идеальном попутном выполнении верхний предел для четырёх A100 и четырёх H20 при совместном размещении составляет 4.17 запроса/s, что по-прежнему ниже 4.55 при разделении. Выигрыш гетерогенного кластера обусловлен различиями самого оборудования, поэтому блочное выполнение не может заменить разделение.
Ещё одно изменяемое условие — само передаваемое состояние. При переходе на компактное состояние MLA слагаемое канала в \(\mu_{PD}\) возрастает с 20.7 до 43.4 запроса/s, а при канале 50 GB/s — с 41.4 до 86.9 запроса/s. Верхний предел по-прежнему определяется пулом D с производительностью 4.55 запроса/s, поэтому распределение четырёх A100 для P и четырёх H20 для D не меняется. Канал становится ограничивающим фактором при \(B_{net}<\mu V_{KV}\): при 4.55 запроса/s состояние GQA требует не менее примерно 5.5 GB/s, а компактное состояние MLA — всего около 2.6 GB/s. Выше этого значения дальнейшее увеличение пропускной способности не меняет общий предел; ниже него все ячейки на рисунке 9-10 со значением выше \(B_{net}/V_{KV}\) ограничиваются каналом до одного и того же уровня.7
Компактный путь экономит байты, но не устраняет всю работу. Согласно ассоциативности из раздела 2.3.2, повышающая проекция переносится на сторону запроса: для каждого токена запроса каждый слой DeepSeek-V3 должен дополнительно выполнить одно преобразование запроса размером \(128\times128\times512\) и одно восстановление значения того же размера. В сумме это 33.5 MFLOPs, а для 61 слоя — 2.05 GFLOPs, что совпадает с объёмом операций повышающей KV-проекции (kv_b_proj) для одного токена в таблице 2-3. Объём этих вычислений линейно растёт с числом запросов в batch: если один вызов decode обслуживает \(B\) запросов, добавляется \(2.05B\) GFLOPs. При эффективной вычислительной производительности H20 в 74 TFLOP/s это добавляет 27.7 μs на каждый шаг каждого запроса, или 28.3 ms за 1024 шага. Если эти вычисления нельзя скрыть временем доступа к памяти, затраты пула D на один запрос возрастут с 0.878 до примерно 0.907 GPU-секунды, а производительность пула D снизится с 4.55 до примерно 4.41 запроса/s, по-прежнему превышая скорость поступления 3.5 запроса в секунду. Пятая карта D потребуется лишь тогда, когда дополнительные вычисления на каждом шаге каждого запроса превысят примерно 258 μs. Компактный путь меняет положение узкого места экземпляра D: объём чтения на токен сокращается с 4.77 MiB развёрнутого состояния до 68.6 KiB, но вычислительная составляющая растёт вместе с batch size, поэтому экземпляр D становится ограничен вычислениями, а не чтением, уже при меньшем batch size. Значение \(r_D\) в примере 9.2 выведено для batch size 32; после перехода на компактное MLA его необходимо пересчитать с учётом новой точки перехода между режимами.
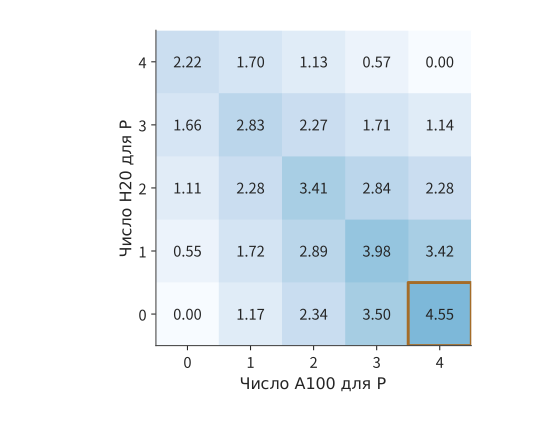
Рисунок 9-10. Влияние распределения этапов на ограничение частоты запросов. Используются четыре A100 и четыре H20, производительность этапов приведена в примере 9.2; по горизонтальной оси отложено число A100, назначенных пулу P, по вертикальной — число H20, назначенных пулу P, остальные карты назначены пулу D. В каждой ячейке берётся минимум из производительности двух пулов и частоты передачи состояний через сетевую карту с пропускной способностью 25 GB/s, без учёта очередей; интенсивность цвета обозначает устойчивую частоту запросов, единица измерения — запрос/s, рамкой выделены оптимальные распределения.
На рисунке 9-10 также показано изменение пропускной способности при отклонении от оптимального распределения. Если перенести одну A100 из P в D, производительность P снизится с 4.67 до 3.50 запроса/s, а D возрастёт с 4.55 до 5.12 запроса/s; в результате система будет ограничена P, и её производительность снизится до 3.50. Если перенести одну H20 из D в P, производительность P возрастёт до 5.22 запроса/s, но D снизится до 3.42 запроса/s, поэтому система также замедлится. При оптимальном распределении производительности двух пулов близки. После изменения распределения избыточные ресурсы одного пула не могут выполнить работу другого.
9.2.4 Границы выигрыша при разных запросах и нагрузках¶
В примере 9.2 состав запроса был фиксирован. Теперь изменим только одно условие — попадание в кэш префикса. P уже кэшировал первые 6144 токена, поэтому ему нужно обработать лишь оставшиеся 2048. Число новых токенов сокращается в четыре раза, время prefill на A100 снижается с 0.856 до 0.238 секунды, а производительность P на одной A100 возрастает с 1.17 до 4.20 запроса/s. Если по-прежнему выделять P четыре A100, вместе они смогут обрабатывать 16.8 запроса/s, тогда как D останется ограничен 4.55 запроса/s.
Если перенести две A100 в D, оставшиеся две обеспечат производительность P в 8.41 запроса/s; D на двух A100 и четырёх H20 обеспечит \(2/1.764+4/0.878\approx5.69\) запроса/s. Общий верхний предел пропускной способности возрастёт до 5.69 запроса/s. Если перенести ещё одну A100, производительность P снизится до 4.20 запроса/s, и система, наоборот, замедлится. Предполагается, что D не кэшировал этот префикс, поэтому при обоих распределениях по-прежнему требуется передавать полные 1.125 GiB. Объём вычислений P сократился более чем на 70%, но размер передаваемого D KV-кэша не изменился.
Теперь восстановим исходный ввод, но сократим вывод до 129 токенов, то есть рассмотрим обычный диалог без процесса рассуждения. Число вызовов D снизится с 1024 до 128, а производительность D на одной H20 возрастёт примерно до 9.46 запроса/s, поэтому D почти перестанет быть узким местом. Оптимальным становится распределение четырёх A100 и трёх H20 для P и одной H20 для D; пул P обеспечивает \(4\times1.168+3\times0.554\approx6.33\) запроса/s. При совместном размещении производительность уже составляет 5.84 запроса/s, поэтому разделение повышает её лишь на 8.5%.
На рисунке 9-11 три варианта показаны для одного и того же набора вычислительных ресурсов. Каждый прямоугольник обозначает одну исходную карту; меняется только выполняемый ею этап. После попадания префикса в кэш объём работы P сокращается, поэтому можно высвободить две A100; после сокращения вывода объём работы D уменьшается, и три H20 переходят к P.
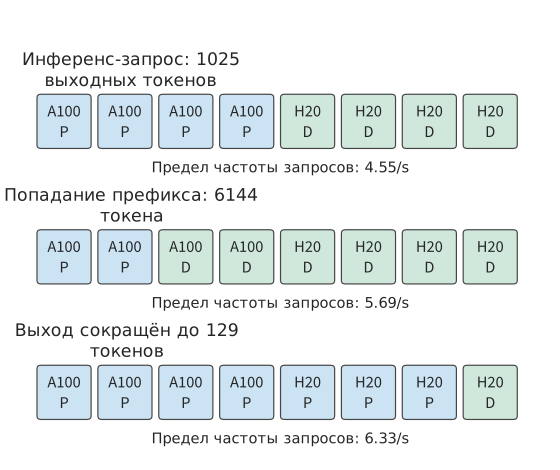
Рисунок 9-11. Изменение распределения ресурсов в зависимости от состава запросов. Используются четыре A100 и четыре H20, производительность этапов рассчитана методом из примера 9.2; первая строка соответствует запросу на рассуждение с 8192 входными и 1025 выходными токенами, во второй строке сокращён только новый ввод для P, а в третьей восстановлен полный ввод и вывод сокращён до 129 токенов. Прямоугольники обозначают карты, под каждой строкой указан соответствующий верхний предел пропускной способности. P — пул prefill, D — пул decode.
Для этих трёх видов запросов оптимальное число карт P равно соответственно четырём, двум и семи. Попадание префикса в кэш сокращает новую работу P и смещает ресурсы к D; сокращение вывода уменьшает повторяющуюся работу D и смещает ресурсы к P. Чем длиннее вывод запроса на рассуждение, тем выше доля D и тем ценнее карты наподобие H20 с высокой пропускной способностью, но низкой вычислительной производительностью. Поэтому планирование можно разделить на два временных масштаба: при поступлении запроса выбирать очередь, а при устойчивом изменении распределения нагрузки корректировать размеры пулов. Распределение по очередям определяет текущее ожидание, а размеры пулов — способность накопившейся очереди сокращаться в долгосрочной перспективе.
9.3 Разделение механизма внимания и FFN и гетерогенное выполнение¶
9.3.1 Границы выполнения механизма внимания, FFN и экспертов¶
AF означает разделение задач между механизмом внимания и сетью прямого распространения. В отличие от PD, однократно разделяющего два этапа генерации, AF разделяет вычисления внутри слоя модели: механизм внимания создаёт скрытое состояние, сеть прямого распространения или выбранный эксперт обрабатывает его, после чего результат возвращается для использования последующими операторами. Следующий слой обычно должен ждать этого результата, поэтому запуск передачи небольших объёмов данных и синхронизация повторяются многократно.
MoE особенно хорошо подходит для такого разделения: общий объём весов экспертов велик, но каждый токен выбирает лишь их часть. Если большинство экспертов хранится в основной памяти, можно либо передавать выбранные веса на GPU, либо выполнять вычисления на CPU с локальными весами, передавая активации меньшего размера. Первый путь расходует пропускную способность канала ради вычислительной мощности GPU, второй — вычислительную мощность CPU ради уменьшения трафика по каналу. Выбор зависит от числа токенов, назначенных одному эксперту в текущем распределении: вектор признаков каждого токена занимает одну строку входной матрицы эксперта, и эти строки повторно используют один и тот же набор весов эксперта.
9.3.2 Совместная работа CPU и GPU¶
Два пути из предыдущего подраздела выдают одинаковый результат и различаются тем, что передаётся по каналу: на рис. 9-12 передаются веса, а на рис. 9-13 — входные и выходные данные. В разделе 8.4.3 используется первый путь: веса временно хранятся в основной памяти и при необходимости переносятся на GPU. KTransformers — реальная система, использующая второй путь: GPU обрабатывает механизм внимания и часть постоянно размещённых экспертов, а CPU — назначенных ему экспертов; после отправки работы на CPU GPU продолжает выполнять ветви, допускающие параллельное выполнение, а в конце результаты синхронизируются и объединяются. Для горячих и общих экспертов, а также этапа prefill можно применять различное распределение вычислительных ресурсов. В точке слияния ветвей следующий слой может начать работу лишь после завершения обеих сторон.8
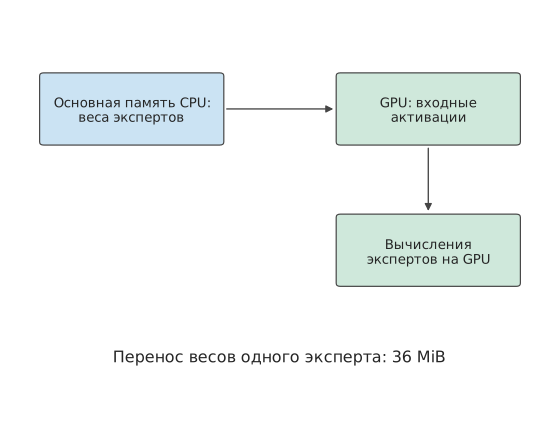
Рис. 9-12. Набор весов эксперта размером 36 MiB передаётся из основной памяти на GPU, после чего GPU считывает локальные входные данные и выполняет вычисления.
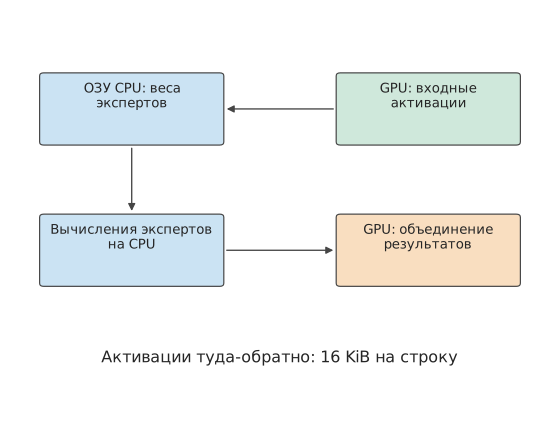
Рис. 9-13. Входные данные передаются с GPU на CPU, CPU выполняет эксперта с весами из основной памяти, а результат возвращается на GPU. При каждом назначении токена эксперту суммарный размер входящего и исходящего векторов признаков составляет 16 KiB; результаты объединяются после завершения параллельной ветви постоянно размещённых на GPU экспертов.
Затраты обоих путей зависят от размера набора весов одного эксперта. В Qwen3-235B-A22B эксперт содержит три матрицы с общим числом параметров \(3\times4096\times1536=18874368\). В формате BF16 веса занимают 36 MiB.
Пример 9.3. Как повторное использование весов эксперта меняет выбор между выполнением на CPU и GPU? Возьмём экспериментальную машину из статьи о KTransformers: два Intel Xeon Platinum 8452Y по 36 ядер и 1 TB DDR5 каждый, подключённые по PCIe 4.0 к одной A100 40GB PCIe. С помощью утилиты тестирования памяти Intel MLC авторы статьи измерили пропускную способность памяти в пределах одного сокета CPU: 220 GB/s. При выполнении слоя MoE на одном CPU ядро PyTorch на основе AVX-512, 512-битного набора векторных инструкций, достигало максимум 1.8 TFLOP/s, а ядро KTransformers на основе матричных инструкций AMX, Advanced Matrix Extensions, — максимум 21.3 TFLOP/s. Для GPU возьмём 50% от пиковых значений A100 40GB PCIe, равных 312 TFLOP/s и 1555 GB/s, то есть 156 TFLOP/s и 778 GB/s. Теоретическая пропускная способность PCIe 4.0 x16 равна 32 GB/s; для передачи примем 25 GB/s и 5 μs на каждый запуск. Ширина активации BF16 равна 4096. Восемь экспертов выполняются последовательно, поэтому общее время равно сумме времени всех экспертов, а веса считываются один раз на batch. Когда каждый эксперт получает вектор признаков только одного токена, CPU напрямую считывает веса из локальной основной памяти, избегая переноса 36 MiB по более медленному каналу. По мере увеличения числа входных строк каждого эксперта стоимость однократного переноса весов распределяется на большее число строк, тогда как CPU раньше достигает предела вычислительной мощности.
Сначала рассмотрим восемь горячих экспертов, каждый из которых обрабатывает один токен: суммарный размер весов составляет 288 MiB. Их чтение из основной памяти с пропускной способностью 220 GB/s занимает около 1.37 ms, а весь путь CPU с передачей активаций — около 1.46 ms. Для пути с переносом на GPU одна только передача весов занимает около 12.1 ms, а вместе с запусками и вычислениями GPU — около 12.5 ms. При слабом повторном использовании избежать переноса большого блока весов важнее, чем увеличить производительность матричных вычислений.
Если каждый из этих восьми экспертов обрабатывает по 128 токенов, размер весов по-прежнему равен 288 MiB, но объём вычислений возрастает в 128 раз. С ядром AVX-512 время пути CPU увеличивается примерно до 22.2 ms, а путь GPU по-прежнему занимает около 12.5 ms, поэтому вычисления на GPU становятся быстрее. На рис. 9-14 показан промежуточный процесс: когда число входных токенов на эксперта возрастает с 71 до 72, GPU начинает опережать CPU. С ядром AMX при 128 токенах путь CPU занимает лишь около 2.57 ms — примерно пятую часть времени пути с переносом весов, а точка пересечения сдвигается до 689 токенов на эксперта. На одной и той же машине при обработке одного batch выбор набора инструкций CPU определяет, на какой стороне следует разместить эксперта. Каждый дополнительный токен, обрабатываемый экспертом, увеличивает время вычислений CPU сильнее, чем GPU, тогда как затраты на перенос весов остаются неизменными, поэтому после точки пересечения преимущество получает GPU.9
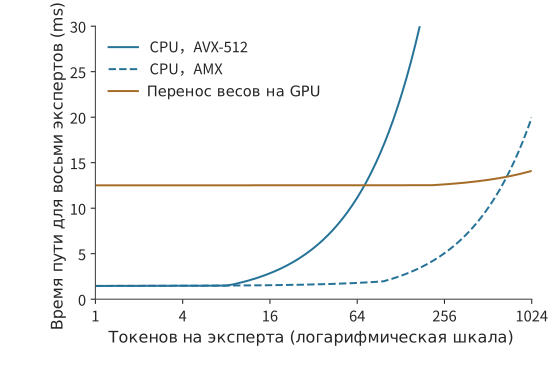
Рис. 9-14. Повторное использование экспертов меняет выбор места выполнения. Каждый из восьми экспертов имеет 36 MiB весов BF16. CPU — один Xeon Platinum 8452Y: для ядер AVX-512 и AMX используются измеренные в статье значения 1.8 и 21.3 TFLOP/s соответственно, а для памяти в пределах одного сокета — 220 GB/s. GPU — A100 40GB PCIe: 50% от пиковых значений, то есть 156 TFLOP/s и 778 GB/s. Передача по PCIe — 25 GB/s с запуском по 5 μs. Горизонтальная ось логарифмическая; кривые рассчитаны по примеру 9.3 для пути экспертов одного слоя без преобразования форматов.
Запишем приведённые числа в общем виде. Обозначим число параметров эксперта через \(P_e\), размер весов в байтах — через \(W_e\), ширину входа — через \(h\), а число байтов на элемент — через \(b\). Если один эксперт получает в текущем batch \(m\) токенов, объём его матричных вычислений составляет \(F_e(m)=2mP_e\) FLOPs, а веса необходимо прочитать как минимум один раз. Пусть эффективная вычислительная мощность CPU и пропускная способность DRAM равны соответственно \(C_C,B_D\), а вычислительная мощность GPU и пропускная способность HBM — \(C_G,B_H\); пропускную способность канала передачи обозначим через \(B_L\). Предположим, что веса и активации уже преобразованы в необходимый для выполнения формат, передача и вычисления эксперта происходят последовательно, а время оператора определяется максимумом времени вычислений и чтения весов. Тогда время выполнения одного эксперта двумя способами соответственно равно
В первой формуле складывается время трёх этапов: передачи входных данных, вычисления эксперта на CPU и передачи выходных данных. Во второй сначала переносится один набор весов, а затем выполняются вычисления на GPU. Величина \(\alpha\) в формулах — фиксированная стоимость каждой передачи. Входная активация сначала поступает на CPU, а после вычисления выходная активация возвращается, поэтому два запуска и передача полезной нагрузки туда и обратно в формуле соответствуют этим двум рёбрам зависимостей.
Влияние изменений аппаратного обеспечения можно оценивать теми же формулами. В архитектуре NUMA поток, читающий память другого CPU, должен обращаться к ней через межпроцессорное соединение. В статье измеренная межсокетная пропускная способность этой машины составила лишь 125 GB/s. Время пути CPU определяется большей из двух величин: временем чтения весов и временем матричных вычислений. На рис. 9-15 эти величины показаны рядом для случая 128 токенов на эксперта. При использовании ядра AVX-512 вычисления намного продолжительнее чтения, поэтому сокет, в памяти которого размещены данные, почти не имеет значения. При переходе на ядро AMX время вычислений сокращается почти до времени чтения в пределах одного сокета, а при межсокетном чтении именно чтение становится более продолжительной операцией. Выгодность локальных вычислений определяется текущим основным узким местом: при ограничении скоростью чтения помогает повышение пропускной способности основной памяти, а при ограничении вычислениями — повышение пропускной способности матричных операций. Формат квантования одновременно изменяет обе величины: размер весов в байтах уменьшается, а эффективная пропускная способность матричного ядра также меняется.10
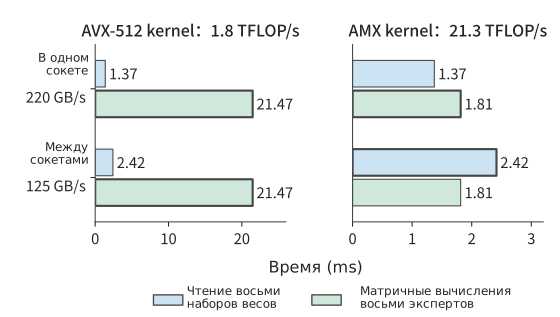
Рис. 9-15. Два компонента времени на одном Xeon Platinum 8452Y при обработке 128 токенов каждым из восьми экспертов Qwen3-235B-A22B: чтение восьми наборов весов BF16 общим размером 288 MiB и матричные вычисления объёмом 38.7 GFLOPs. Толстой рамкой выделен более продолжительный компонент, задающий нижнюю границу времени этого пути. Масштабы горизонтальных осей на левом и правом графиках различаются; вычислительная мощность ядер AVX-512 и AMX, а также пропускная способность памяти внутри сокета и между сокетами взяты из измерений статьи.
9.3.3 Влияние ёмкости, параллелизма и повторного использования экспертов на возможности обслуживания¶
Возможность разместить веса и возможность своевременно обработать запрос — две разные задачи. В Qwen3-235B-A22B все 128 экспертов BF16 одного слоя занимают 4.5 GiB. Если на GPU постоянно размещать по 32 эксперта каждого слоя, один слой займёт 1.125 GiB, а все 94 слоя — около 106 GiB. Даже если предоставить экспертам все 80 GB видеопамяти A100 80GB, то есть около 74.5 GiB, разместить такой набор постоянно находящихся на GPU экспертов не удастся: потребуется распределить их между несколькими картами или сократить число размещённых экспертов на слой. Если уменьшить это число до 16, соответствующий объём весов снизится примерно до 53 GiB, но больше экспертов придётся выполнять на стороне основной памяти. Таким образом, выбор ёмкости напрямую меняет путь выполнения запроса.
То, что один токен выбирает восемь экспертов, не означает, что один batch также обращается лишь к восьми экспертам. В разделе 6.3.2 это распределение уже было рассчитано: 64 токена выбирают по восемь экспертов, что даёт 512 назначений. При равномерном распределении по 128 экспертам каждый эксперт обрабатывает четыре строки, а при концентрации на восьми экспертах — 64 строки. В обоих случаях полезный объём матричных вычислений экспертов равен \(512\times2\times18874368\), то есть около 19.3 GFLOPs. Но если каждый набор весов эксперта считывается в пределах batch только один раз, объёмы чтения весов составляют соответственно 4.5 GiB и 288 MiB — различие в 16 раз. При пропускной способности основной памяти 220 GB/s из примера 9.3 одно только чтение весов занимает соответственно около 22.0 ms и 1.37 ms: объём вычислений одинаков, а время чтения различается на порядок.
Общее число экспертов определяет, сколько весов необходимо разместить, число назначений — полезный объём матричных вычислений текущего batch, а множество экспертов внутри batch — к каким весам потребуется обратиться. На рис. 9-14 уже показано, что число входных строк определяет, какая сторона, CPU или GPU, будет быстрее. Необходимо учесть и ещё одну величину: к скольким экспертам фактически обратится batch запросов. Только зная это число, результат для одного эксперта можно распространить на весь batch.
Помимо случаев полностью равномерного распределения и полной концентрации можно проанализировать среднее число экспертов, задействованных при случайной маршрутизации. Согласно выводу из раздела 6.3.2, если каждый токен независимо и равномерно выбирает \(K\) различных экспертов из \(E\), то математическое ожидание числа активных экспертов для batch из \(M\) токенов равно
Подставив \(E=128,K=8,M=64\), получим ожидаемое значение около 126 экспертов и идеальный объём чтения весов около 4.43 GiB, что близко к описанному выше случаю равномерного покрытия. При дальнейшем увеличении batch size число различных задействованных экспертов достигает максимума 128 и перестаёт расти, тогда как число назначений продолжает увеличиваться линейно. Поэтому всё больше новых токенов повторно используют уже считанные веса.
Этот анализ также показывает, что серверы с основной памятью большой ёмкости и небольшим числом GPU лучше подходят для нагрузок с малым числом входных строк на эксперта. Для опубликованной конфигурации DeepSeek V4-Flash с одной RTX 5090 требуется не менее 200 GB основной памяти, а для конфигурации Kimi K2 с групповой квантизацией Q4_K_M, преимущественно 4-битной, но с более высокой разрядностью для части тензоров, — около 600 GB. Основная память решает задачу размещения всего набора весов, однако с увеличением batch size запросов узкое место всё равно может сместиться с чтения весов на матричные вычисления CPU. Точка пересечения на рис. 9-14 соответствует именно этому изменению: увеличение параллелизма одновременно амортизирует стоимость чтения весов и постепенно исчерпывает вычислительные возможности CPU.11
9.3.4 Межсерверное AF, разделение экспертов и конвейер микробатчей¶
В двух предыдущих подразделах задачи всё ещё распределялись между CPU и GPU одного сервера. В MoE маршрутизируемых экспертов также можно вынести в отдельный пул ресурсов, которому воркер, сохраняющий механизм внимания и KV, отправляет активации и от которого получает результаты экспертов. Это называется разделением экспертов (Expert Disaggregation), а также часто разделением EP. В этой книге термин «разделение экспертов» обозначает границу развёртывания, а EP — степень параллелизма экспертов. Разделение экспертов представляет собой одну из форм рассматриваемого в этом разделе распределения задач между механизмом внимания и экспертными вычислениями; для конкретной системы также необходимо указать, на какой стороне размещены общие эксперты, маршрутизатор, а также предшествующая и последующая проекции.
На примере двух серверов HGX H100 из главы 7 рассмотрим выполнение одного слоя MoE с разделением экспертов (рис. 9-16). Четыре карты A0–A3 сервера A выполняют механизм внимания и хранят KV соответствующих запросов; четыре карты B0–B3 сервера B содержат по четверти маршрутизируемых экспертов. Внутри слоя последовательно выполняются четыре шага. На первом карты A завершают вычисление механизма внимания, после чего маршрутизатор выбирает для каждого токена восемь экспертов. Второй шаг — описанный в разделе 6.2.6 dispatch: карты A группируют скрытые состояния каждого токена по картам, на которых находятся выбранные эксперты, и отправляют их соответствующим картам B. Каждая из четырёх карт A отправляет каждой из четырёх карт B различный объём данных, образуя операцию All-to-All. На третьем шаге карты B получают входные данные от всех источников, переставляют входные строки по экспертам и выполняют матричные умножения экспертов. Четвёртый шаг — combine: выходные данные экспертов по обратному маршруту возвращаются на карту A, которой принадлежит токен. Карта A должна получить все восемь результатов экспертов для токена и вычислить их взвешенную по весам маршрутизации сумму, прежде чем перейти к механизму внимания следующего слоя.
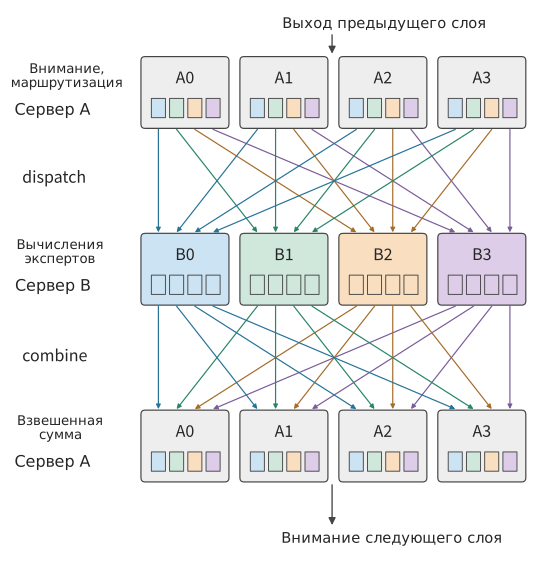
Рис. 9-16. Порядок выполнения одного слоя MoE между двумя серверами; время направлено сверху вниз. A0–A3 выполняют механизм внимания и маршрутизацию, B0–B3 — экспертов. Маленький прямоугольник обозначает группу входных данных, которую одна карта A отправляет одной карте B; цвет показывает целевую карту B. Dispatch доставляет прямоугольники картам B соответствующего цвета, а combine возвращает результаты исходным картам A. Оба обмена представляют собой All-to-All размером 4×4.
На схеме есть две точки ожидания. Обычно карта B должна дождаться входных данных от всех источников, прежде чем начать вычисления, а карта A — результатов всех экспертов выбранного токена, прежде чем вычислить сумму. Если одна карта B получает больше данных и вычисляет медленнее, она одновременно задерживает собственные вычисления и возврат результатов, а также все карты A, ожидающие эти результаты. Именно через эти две точки ожидания обсуждаемый в разделе 9.4 skew влияет на время выполнения всего слоя.
Большой EP означает, что одна группа параллелизма экспертов охватывает много карт. Благодаря большому EP каждая карта хранит лишь небольшое число экспертов и собирает входные данные от нескольких воркеров механизма внимания, обеспечивая экспертам достаточно большой матричный batch. Большой EP не обязательно требует отдельного пула экспертов: одна карта может одновременно выполнять механизм внимания и размещённых на ней экспертов. Отдельный пул экспертов также не обязательно состоит только из одной большой группы EP. В опубликованном отчёте об инференсе DeepSeek-V3/R1 указаны соответственно EP32 для prefill и EP144 для decode, то есть степени параллелизма экспертов 32 и 144, а также используются избыточные эксперты, дополнительные копии экспертов с высокой нагрузкой, и несколько видов балансировки нагрузки. Это подтверждает практическую применимость большого EP, но сам по себе такой масштаб не доказывает, что механизм внимания и эксперты распределены между двумя наборами устройств.34
Расширение EP не увеличивает batch size каждого эксперта автоматически. Если текущий batch содержит \(n\) токенов, каждый токен выбирает \(k\) экспертов, а общее число логических экспертов равно \(E\), то при равномерной маршрутизации на одного эксперта в среднем приходится лишь \(nk/E\) строк. Например, при \(n=1024,k=8,E=256\) получается 32 строки. Если просто распределить те же 256 экспертов по 128 картам вместо 32, среднее значение останется равным 32, а уменьшится лишь число экспертов на карту. Увеличить batch каждого эксперта можно только за счёт объединения большего числа входных данных, однако при этом также расширяются область коммуникации и область синхронизации: две точки ожидания на рис. 9-16 должны охватывать каждую карту группы EP. Сокращение числа экспертов на карту также увеличивает межкарточный skew; в разделе 9.4.1 на тех же значениях \(n,k,E\) рассчитывается его рост при увеличении EP.
Пул экспертов позволяет независимо наращивать число копий, выбирать другое соотношение вычислительной мощности и памяти и собирать задачи от нескольких воркеров механизма внимания. Цена этого решения состоит в том, что входные данные экспертов, которые ранее можно было обрабатывать локально, теперь также приходится передавать между пулами, а сеть становится общим ресурсом обоих пулов. Отдельными репликами сервиса, способными независимо принимать задачи, являются лишь несколько независимых групп EP, каждая из которых хранит полный набор экспертов. Простое добавление карт, содержащих часть экспертов, не позволяет каждому запросу произвольно обходить занятых экспертов. Очередью, видеопамятью, версией модели и политикой допуска общего пула экспертов необходимо управлять как единым целым.
После расширения AF с одного сервера на несколько сильнее проявляется влияние времени запуска каждой передачи, пропускной способности канала и разницы во времени начала выполнения на разных узлах. MegaScale-Infer — распределённая система инференса с разделением вычислений механизма внимания и экспертов. В ней микробатчи чередуются между узлами механизма внимания и узлами экспертов, образуя попеременный конвейер: пока один микробатч выполняет механизм внимания, другой выполняет вычисления экспертов. В идеальном случае, если два этапа требуют для каждого микробатча времени \(t_A,t_F\), то без учёта передачи обработка \(q\) независимых микробатчей двухэтапным конвейером занимает \(t_A+t_F+(q-1)\max(t_A,t_F)\). Первый микробатч требует \(t_A+t_F\), после чего один микробатч завершается каждый период обслуживания более медленного этапа. При переходе между слоями возвращаемые активации связывают конец предыдущего слоя с началом следующего.
Эксперименты MegaScale-Infer дают практические доказательства эффективности такого развёртывания. В статье 2025 года использовались Mixtral-8×22B, DBRX и Scaled-MoE размером 317B, а веса, активации и KV имели формат BF16. Медианная длина входа и выхода производственных запросов составляла соответственно 571 и 159 токенов. Ограничение оценки требовало TPOT не более 150 ms. В однородном кластере из восьми узлов с восемью GPU Ampere 80 GB на каждом пропускная способность decode на один GPU для Scaled-MoE достигла уровня, в 1.90 раза превышающего показатель фреймворка инференса NVIDIA TensorRT-LLM. Этот результат включает совокупный эффект раздельного размещения, выбора параллелизма, конвейера и коммуникационной библиотеки, поэтому его нельзя считать универсальным ускорением от одного лишь включения разделения EP. В статье также явно указано, что избыточные копии размещаются в соответствии с популярностью экспертов, а стоимость наиболее загруженного узла минимизируется; следовательно, отдельный пул экспертов всё равно должен учитывать skew.37
Рассчитаем этот конвейер на конкретном примере: пусть этапы механизма внимания и экспертов занимают для каждого микробатча соответственно 2 ms и 3 ms. Последовательное выполнение четырёх микробатчей занимает 20 ms, причём в каждый момент работает только один узел. Идеальному двухэтапному конвейеру требуется лишь \(2+3+3\times3=14\) ms, что экономит 6 ms (рис. 9-17). Если после уменьшения микробатчей фактическое время обслуживания каждого этапа увеличится или не перекрываемая вычислениями передача туда и обратно займёт больше 6 ms, преимущество исчезнет. Следовательно, конвейерное выполнение будет быстрее лишь в том случае, если суммарные дополнительные затраты из-за коммуникации и снижения эффективности вычислений останутся меньше 6 ms.12
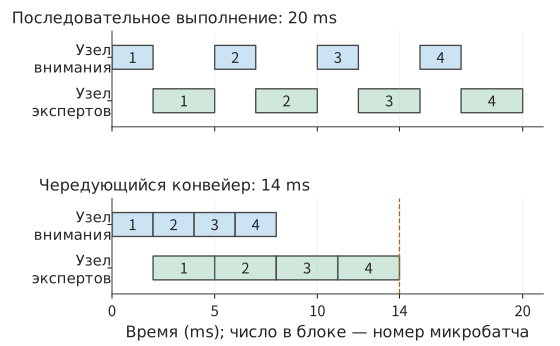
Рис. 9-17. Четыре микробатча выполняются между узлами механизма внимания и экспертов; для каждого микробатча механизм внимания занимает 2 ms, а эксперты — 3 ms, без учёта передачи. На верхней схеме выполнение последовательное, поэтому два узла поочерёдно простаивают. На нижней схеме выполнение чередуется: пока микробатч 1 проходит вычисления экспертов, микробатч 2 выполняет механизм внимания. После стабилизации конвейера узел экспертов работает непрерывно, завершая один микробатч каждые 3 ms.
Пример 9.4. Насколько послойная передача между механизмом внимания и сетью прямого распространения увеличивает коммуникационные затраты? В примере развёртывания Qwen3-8B все 36 слоёв плотной сети прямого распространения размещены на другой стороне. На каждом слое туда отправляется полный вектор скрытого состояния BF16, а обратно возвращается результат того же размера. Объём одной однонаправленной передачи равен \(4096\times2=8192\) bytes; за один шаг decode выполняется в сумме 72 передачи объёмом 576 KiB. При использовании сетевой карты с пропускной способностью 25 GB/s из примера 9.1 передача полезной нагрузки занимает около 23.6 μs, а 72 запуска по 5 μs — в сумме 360 μs. Последовательная передача занимает около 0.384 ms.
Это время меньше времени одной передачи PD из примера 9.1, но объём соответствующей работы различается: PD выполняет передачу для каждого запроса лишь один раз, тогда как AF делает это на каждом шаге decode. Если prefill для 8192 входных токенов также использует передачу плотного AF для всего batch, объём активаций составляет 4.5 GiB, а одна только передача занимает около 193 ms плюс затраты на запуск. Однократная передача PD растёт вместе с длиной контекста, тогда как послойные передачи туда и обратно в AF дополнительно повторяются с каждым шагом генерации. На первый путь прежде всего влияет перенос большого блока KV, а на второй — затраты на запуск передачи небольших объёмов данных и зависимости между операциями.
Послойная передача AF не зависит от представления KV: передаётся скрытое состояние размерности 4096, не связанное с числом голов KV или шириной латентного представления, поэтому один шаг decode по-прежнему требует 72 передач общим объёмом 576 KiB. Меняется сторона PD. Приравняем последовательное время одной передачи PD ко времени одного шага передачи AF:
где \(V_{AF}\) — суммарная полезная нагрузка передачи AF за один шаг, равная 576 KiB, а \(B\) — пропускная способность канала. Если время запуска меньше \(\alpha^*\), передача AF за один шаг быстрее одной передачи PD; если оно больше \(\alpha^*\), суммарные затраты 72 запусков уже превышают время передачи всего состояния. Для состояния GQA \(\alpha^*\approx680\) μs при 25 GB/s и 340 μs при 50 GB/s; для компактного состояния MLA — соответственно 324 и 162 μs. Чем меньше состояние и быстрее канал, тем меньше допустимый бюджет каждого запуска. Время запуска 5 μs намного меньше всех четырёх критических значений, поэтому, если рассматривать передачу за один шаг, AF во всех случаях оказывается быстрее. Однако для запроса целиком вывод иной: суммарное время передач AF за 1024 шага составляет около 393 ms — в 8.1 раза больше одной передачи PD для GQA длительностью 48.3 ms и в 17 раз больше одной передачи PD для компактного MLA длительностью 23.0 ms. PD выполняет передачу лишь один раз, и MLA вдвое сокращает её стоимость; AF выполняет передачу на каждом шаге, а ширина скрытого состояния остаётся неизменной, поэтому ни одного байта не экономится. Чем длиннее выход, тем больше разница.
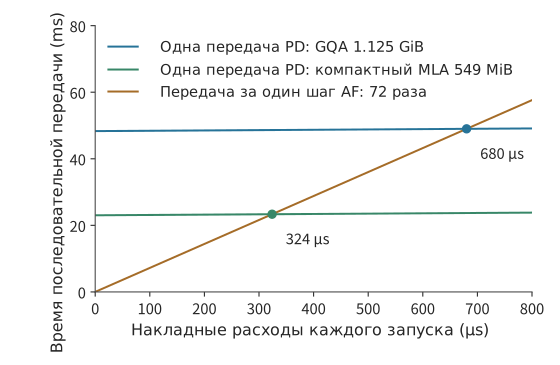
Рис. 9-18. Зависимость последовательного времени одной передачи PD и одного шага передачи AF от затрат на каждый запуск при канале 25 GB/s. PD запускается лишь один раз, поэтому наклон равен 1; один шаг AF требует 72 запусков, поэтому наклон равен 72. Две линии PD соответствуют состоянию GQA размером 1.125 GiB и компактному состоянию MLA размером 549 MiB; точки их пересечения с линией AF задают критическое время запуска 680 и 324 μs. Для канала 50 GB/s точки пересечения смещаются к 340 и 162 μs.
В следующем разделе рассматривается передача активаций в MoE: каждый вход может отправляться в несколько мест выполнения, а перед объединением необходимо дождаться результатов от всех выбранных им экспертов.
9.4 Размещение и репликация экспертов, балансировка нагрузки¶
9.4.1 Перекос вычислений и коммуникаций при большом EP¶
В предыдущем разделе централизованное повторное использование уменьшило объём чтения весов. Однако если все эти горячие эксперты размещены на одной карте, остальные карты не могут разделить нагрузку. В этом разделе мы продолжим отслеживать те же 512 назначений и рассмотрим, когда каждая карта завершает вычисления. Даже если общий объём вычислений во всей системе не меняется, самая загруженная карта может задержать завершение всего слоя. Для карты \(r\) обозначим объём матричных вычислений через \(F_r\), объём считываемых весов в байтах — через \(W_r\), а эффективную вычислительную мощность и пропускную способность — через \(C_r\) и \(B_r\) соответственно. Время, необходимое этой карте для завершения вычислений и чтения весов, составляет не менее \(\max(F_r/C_r,W_r/B_r)\); при объединении результатов всех карт необходимо ждать завершения самой медленной.
Если распределить 512 назначений из предыдущего раздела по восьми картам, проявится другая сторона централизованной маршрутизации. Если каждая карта получает ровно 64 задачи, она выполняет примерно 2,42 GFLOPs; если все восемь горячих экспертов находятся на одной карте, эта карта выполняет все примерно 19,3 GFLOPs. Возьмём сервер HGX H100 из главы 7 с восемью картами и для каждой H100 SXM примем 50% от пиковой производительности плотных вычислений BF16, равной 989,4 TFLOP/s, то есть 494,7 TFLOP/s. Если учитывать только вычисления, время обслуживания самой загруженной карты увеличивается примерно с 4,9 μs до 39,1 μs, то есть в восемь раз.
На рис. 9-19 длина каждой полосы показывает время, необходимое соответствующей карте для завершения вычислений. Перейти к следующему слою можно лишь после объединения всех результатов, поэтому момент завершения определяется самой длинной полосой, а не средним значением восьми полос.
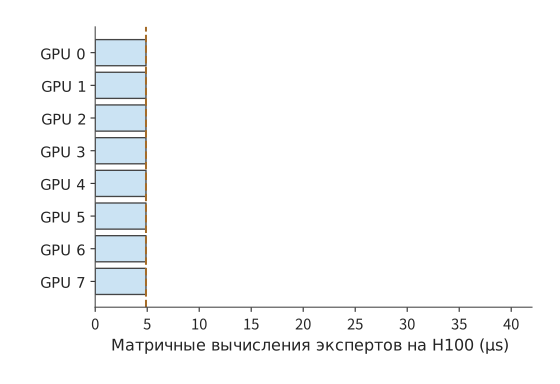
Рис. 9-19. В общей сложности 512 назначений экспертов равномерно распределены по восьми картам, по 64 назначения на карту; пунктирная линия обозначает момент, когда все вычисления завершены и результаты можно объединить.
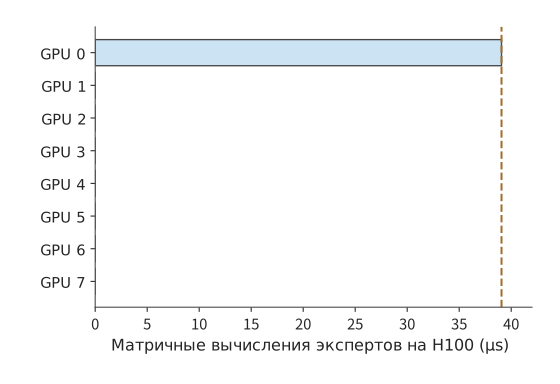
Рис. 9-20. Все 512 назначений попадают на карту 0, остальные карты простаивают. При том же общем объёме вычислений приходится ждать завершения карты 0; в обоих рисунках используется одинаковая шкала времени.
Централизованная маршрутизация уменьшает объём считываемых весов с 4,5 GiB до 288 MiB, но может увеличить вычислительную нагрузку самой загруженной карты в восемь раз. Первое полезно при выполнении, ограниченном чтением, второе вредно при выполнении, ограниченном вычислениями. Поэтому стратегия балансировки должна сначала определить узкое место и лишь затем выбирать между повторным использованием и распределением работы.
Даже при неизменном общем объёме работы большой EP усиливает такое ожидание. Возьмём параметры из раздела 9.3.4: \(n=1024,k=8,E=256\) — в каждом слое DeepSeek-V3 также есть 256 маршрутизируемых экспертов, а для каждого токена выбираются 8. Всего в пакете 8192 назначения, в среднем по 32 строки на эксперта. Предположим, что один эксперт горячий и получает 128 строк, то есть в четыре раза больше среднего; оставшиеся 8064 строки равномерно распределяются между другими 255 экспертами, примерно по 31,6 строки на каждого. Если равномерно распределить 256 экспертов по номерам между картами группы EP, то карта с горячим экспертом должна обработать его 128 строк, а также строки остальных экспертов на этой карте. При EP8 на каждой карте размещено 32 эксперта, поэтому горячая карта обрабатывает около 1108 строк — лишь на 8% больше среднего значения 1024 строки на карту. При EP32 на каждой карте размещено 8 экспертов, поэтому горячая карта обрабатывает около 349 строк — на 36% больше среднего значения 256 строк. При EP256 на каждой карте остаётся лишь один эксперт, поэтому горячая карта обрабатывает 128 строк — в четыре раза больше среднего значения 32 строки. Один и тот же горячий эксперт при малом EP теряется на фоне других экспертов той же карты, а при большом EP единолично занимает карту, из-за чего дисбаланс между экспертами без изменений превращается в дисбаланс между картами (рис. 9-21).
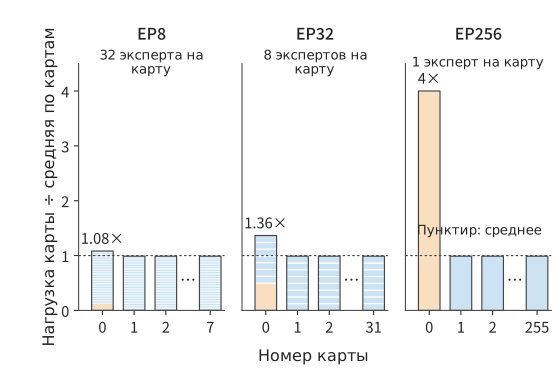
Рис. 9-21. Перекос нагрузки между картами, создаваемый одним горячим экспертом при трёх масштабах EP. Из 256 экспертов каждый из 1024 токенов выбирает 8, а эксперт 0 получает 128 строк — в четыре раза больше среднего. Каждый столбец соответствует одной карте, каждый сегмент столбца — одному эксперту на этой карте, оранжевым обозначен горячий эксперт; по вертикальной оси отложено отношение числа строк на карте к среднему числу строк на карту. На каждом графике показаны только карты 0, 1, 2 и последняя карта; остальные карты эквивалентны карте 1.
Число строк на карте одновременно определяет три вида работы: объём байтов, принимаемых на этапе dispatch, объём байтов, отправляемых на этапе combine, и время матричных вычислений эксперта, когда они ограничены вычислительной мощностью. При 8 KiB на строку и сетевой пропускной способности 50 GB/s для каждой карты горячая карта в EP256 должна принять 1 MiB, что занимает около 21 μs, тогда как средняя карта принимает лишь 256 KiB примерно за 5,2 μs. Если batch мал и вычисления эксперта ограничены чтением весов, время матричных вычислений на карте в основном зависит от количества наборов весов экспертов, которые нужно прочитать, и слабо связано с числом строк, однако объём байтов при обоих обменах всё равно пропорционален числу строк. При переходе от EP8 к EP256 среднее число строк на карту уменьшается в 32 раза, тогда как число строк на самой загруженной карте снижается лишь с 1108 до 128, примерно в 8,7 раза. Время всего слоя определяется самой загруженной картой, поэтому в EP256 средняя карта три четверти времени этого этапа проводит в ожидании.
Даже без горячих экспертов увеличение EP также усиливает перекос. Предположим, что каждый токен независимо и равномерно случайно выбирает 8 экспертов; тогда число строк у каждого эксперта всё равно будет случайно колебаться около 32. Чем больше экспертов размещено на одной карте, тем лучше эти колебания компенсируют друг друга; чем больше карт, тем выше вероятность появления в одном пакете особенно загруженной карты. При моделировании 1000 пакетов с фиксированным seed самая загруженная карта в EP8 в среднем превышает среднюю нагрузку на карту лишь на 4%, а в EP256 — на 52% (рис. 9-22). Обе причины сводятся к одному: чем больше EP, тем меньше экспертов на каждой карте могут компенсировать колебания друг друга и тем больше карт приходится ждать. В опубликованной конфигурации DeepSeek для decode используется EP144, причём на каждой карте размещено лишь 2 маршрутизируемых эксперта, что соответствует области около правого края кривой. Поэтому система добавляет 32 избыточных эксперта и корректирует реплики по нагрузке — именно этот приём рассматривается в разделе 9.4.2.36
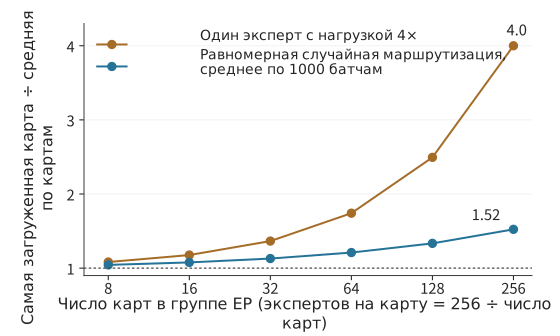
Рис. 9-22. Зависимость отношения числа строк на самой загруженной карте к среднему числу строк на карту от количества карт в группе EP. Оранжевая линия соответствует одному горячему эксперту с четырёхкратной нагрузкой без случайных колебаний и вычисляется вручную; синяя линия соответствует равномерной случайной маршрутизации и показывает среднее по 1000 пакетам при фиксированном seed. 256 экспертов равномерно распределены по номерам, реплики отсутствуют; горизонтальная ось логарифмическая.
Объём коммуникаций также зависит от того, на какой карте изначально находился токен. В конфигурации TP2×EP4 из раздела 9.1 каждая группа EP обрабатывает один и тот же пакет запросов, а участники каждой группы EP уже содержат одинаковые входные скрытые состояния, поэтому dispatch между группами EP может отсутствовать, а результаты объединяются редукцией частичных сумм. В другой конфигурации каждая карта содержит собственные входные токены, поэтому активации необходимо отправлять удалённым экспертам через dispatch, как на рис. 9-16. Если входы уже реплицированы, коммуникации сосредоточены на объединении результатов; если входы распределены между разными картами, перед выполнением добавляется удалённый dispatch. Объём коммуникаций совместно определяется исходным расположением токенов, расположением экспертов и местом назначения результатов.
Перекос при большом EP необходимо рассматривать как минимум на трёх уровнях. Частота выбора логических экспертов определяет эффективное число строк каждого эксперта; размещение экспертов и выбор реплик преобразуют эти строки в нагрузку на каждую карту; источник токенов, назначение и сетевой путь затем преобразуют нагрузку карты в трафик каждого направления. Неравномерная востребованность экспертов не обязательно приводит к неравномерности между картами, а равномерные вычисления на картах не обязательно обеспечивают равномерную нагрузку на общие каналы. Повторное использование внутри пакета из раздела 6.3.2 объясняет чтение весов, а здесь мы продолжим рассчитывать вычисления, коммуникации и время завершения для каждой карты.
Пусть \(a_{ij}\) — число назначений «токен — эксперт», отправляемых источником \(i\) группе экспертов \(j\), а размеры каждой входной и выходной порции данных равны соответственно \(d_D,d_C\) байт. Для схемы с передачей по назначениям, без устранения дубликатов и предварительной редукции:
Здесь \(R\) — число принимающих групп экспертов, а \(\sum_jm_j=nk\). Значение \(s_{\mathrm{expert}}=1\) означает баланс эффективных задач между группами; лишь для однотипных экспертов с одинаковой точностью и без учёта padding оно приблизительно равно перекосу вычислительной нагрузки. Для коммуникационного этапа \(X\in\{D,C\}\), если учитывать матрицу по отправителям, получателям и физическим сечениям сети, получим:
Здесь \(V^X_{\mathcal C}\) и \(B_{\mathcal C}\) — соответственно нагрузка, проходящая через физическое сечение \(\mathcal C\), и пропускная способность его каналов. Это нижняя граница времени передачи нагрузки, не учитывающая запуск, очереди и позднее поступление данных. Параллельный трафик одного физического направления необходимо суммировать: нельзя делить каждый поток на полную пропускную способность и предполагать, что все потоки завершатся одновременно. Под перекосом пропускной способности здесь понимается неравномерность спроса или использования разных карт и каналов; номинальная пропускная способность оборудования не меняется.
Пример 9.5. Почему при одинаковом общем объёме коммуникаций горячая точка замедляет оба обмена? Возьмём из раздела 7.2.3 1024 токена, выбор 8 экспертов для каждого токена и вектор размером 8 KiB и разместим их на двух серверах HGX H100 с рис. 9-16. Четыре источника — это четыре карты сервера A, выполняющие attention, а каждая из четырёх групп экспертов выполняется одной картой сервера B; все назначения проходят между серверами. Каждая карта отправляет и принимает данные через собственную сетевую карту ConnectX-7 400 Gbit/s с пропускной способностью 50 GB/s в каждом направлении; коммутируемая сеть между двумя серверами обеспечивает \(4\times50=200\) GB/s в каждом направлении. Каждый из четырёх источников отправляет 2048 порций, общий объём dispatch составляет 64 MiB, как и объём combine. При равномерном распределении каждая группа принимает 2048 порций, то есть 16 MiB; при горячем распределении \([5120,1024,1024,1024]\) группа 0 принимает 40 MiB, а остальные три — по 8 MiB. Общий объём коммуникаций и общий объём полезных вычислений у двух распределений одинаков, но перекос экспертов увеличивается с 1 до 2,5.
Для каждого назначения объём вычислений эксперта примем равным \(6\times4096\times1536\) FLOPs, как в примере Qwen3 MoE, а эффективную вычислительную мощность каждой H100 — 494,7 TFLOP/s. Пока не учитывая чтение весов, padding, запуск и очереди, получаем следующую таблицу. Последний столбец применим только к выполнению с барьером всего пакета между тремя этапами и равен сумме трёх нижних границ; при перекрытии необходимо отдельно рассчитывать критический путь.35
| Распределение и путь | Нижняя граница dispatch | Нижняя граница вычислений самой загруженной карты | Нижняя граница combine | Общая нижняя граница с барьерами между этапами |
|---|---|---|---|---|
| Четыре равномерные группы, между серверами | 0,336 ms | 0,156 ms | 0,336 ms | 0,827 ms |
| Горячая группа, между серверами | 0,839 ms | 0,391 ms | 0,839 ms | 2,068 ms |
| Четыре равномерные группы, между двумя пулами остался лишь один канал 400 Gbit/s | 1,342 ms | 0,156 ms | 1,342 ms | 2,841 ms |
| Горячая группа, dispatch переведён на FP8 | 0,419 ms | 0,391 ms | 0,839 ms | 1,649 ms |
| Горячая группа, оба пула находятся в одном HGX (NVLink) | 0,093 ms | 0,391 ms | 0,093 ms | 0,577 ms |
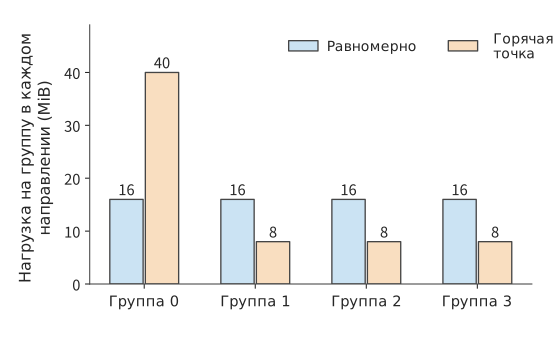
Рис. 9-23. Нагрузка, которую четыре группы экспертов принимают на этапе dispatch и отправляют на этапе combine. Общий объём в каждом направлении при равномерном и горячем распределении равен 64 MiB; горячая группа в обоих этапах обрабатывает 40 MiB. Высота столбца обозначает требуемое число байтов, а не измеренную мгновенную пропускную способность.
При обмене между серверами два коммуникационных этапа составляют 80% общей нижней границы с барьерами между этапами, а вычисления самой загруженной карты — лишь 20%: вычисление одного назначения эксперта на H100 занимает около 76 ns, тогда как передача одной активации размером 8 KiB через сетевую карту — около 164 ns. Горячая точка одновременно удлиняет приём, вычисление и возврат, и каждый из трёх этапов становится в 2,5 раза дольше. Если распределить горячую нагрузку, но оставить между двумя пулами лишь один канал 400 Gbit/s, в каждом направлении всё равно потребуется не менее 1,342 ms. Это показывает, что добавление карт экспертов не заменяет пропускную способность между пулами. Перевод только dispatch на FP8 также не обеспечивает пропорционального сокращения BF16 combine или вычислений экспертов; в таблице предполагается, что квантование не меняет время вычислений, а метаданные масштаба игнорируются, чтобы отдельно рассмотреть влияние каждого фактора. Если разместить оба пула в одном HGX, NVLink с пропускной способностью 450 GB/s в каждом направлении сокращает оба обмена до 0,093 ms, и самым длинным этапом становятся вычисления горячей карты длительностью 0,391 ms. В этом случае уменьшение вычислительной нагрузки горячей карты эффективнее дальнейшего увеличения пропускной способности; именно на такую ситуацию рассчитаны реплики экспертов из следующего раздела.
9.4.2 Реплики экспертов, размещение и динамическая корректировка¶
Сосредоточение работы на нескольких картах на рис. 9-20 указывает направление улучшения: разместить реплики горячих экспертов на свободных картах, чтобы они также могли обрабатывать горячие задачи. Репликация эксперта создаёт для одного логического эксперта несколько физических реплик, между которыми планировщик может распределять задачи. Если веса реплик одинаковы, веса маршрутизации применяются правильно, а результаты объединяются без ошибок, репликация не требует изменять правило выбора для каждого токена \(k\) экспертов с максимальными оценками (top-k). Изменение правила выбора экспертов меняет поведение модели, поэтому эти два подхода следует оценивать раздельно. Механизмы балансировки нагрузки экспертов (EPLB) в vLLM и SGLang корректируют расположение реплик логических экспертов и распределение задач на основе статистики маршрутизации.
Реплики экспертов занимают видеопамять, вытесняя KV и буферы. Добавление на каждую карту одного эксперта размером 36 MiB для каждого из 94 слоёв требует в сумме 3384 MiB, то есть около 3,30 GiB. Если добавить по одной реплике только для восьми наиболее перегруженных слоёв, потребуется лишь 288 MiB. Эти объёмы различаются почти в 12 раз. CRAFT — исследовательская система обслуживания, посвящённая репликации экспертов и распределению видеопамяти. Она решает именно задачу распределения памяти между слоями: пространство следует выделять слоям, где оно сильнее всего сокращает ожидание, а не механически создавать одинаковое число реплик в каждом слое.13
Пример 9.6. Сколько пакетов требуется реплике горячего эксперта, чтобы окупить стоимость копирования? Восемь карт образуют один сервер HGX H100. Все 128 токенов пакета выбирают восемь горячих экспертов на карте 0, что даёт в общей сложности 1024 назначения. Скопируем по одной реплике семи из этих экспертов на карты с 1 по 7, всего 252 MiB. Каждой из семи принимающих карт требуется дополнительно 36 MiB, что помещается в доступные 64 MiB. Для каждой H100 примем эффективную вычислительную мощность 494,7 TFLOP/s, равную 50% пиковой, и пропускную способность видеопамяти 1675 GB/s. Карта 0 использует планирование по tile и для каждого пакета читает и записывает в видеопамять около 921 MB, поэтому ограничена её пропускной способностью. После репликации на карте 0 остаётся лишь 576 назначений, и время на пакет сокращается примерно с 0,550 ms до 0,309 ms, то есть экономится около 0,240 ms. Все семь реплик последовательно отправляются с карты 0 через NVLink с пропускной способностью 450 GB/s в каждом направлении; на запуск каждой передачи дополнительно отводится 5 μs, поэтому копирование занимает около 0,622 ms. При использовании неокруглённого времени выполнения минимальное число пакетов, после которого экономия превышает время копирования, удовлетворяет условию:
В пределах одного сервера стоимость копирования реплик окупается на третьем пакете: если горячая нагрузка сохраняется 16 пакетов, чистая экономия составляет около 3,2 ms, а если 64 пакета — около 14,8 ms. Если исходная реплика горячего эксперта находится на другом сервере, копирование проходит через сетевую карту ConnectX-7 400 Gbit/s с пропускной способностью 50 GB/s в каждом направлении. Время подготовки увеличивается примерно до 5,32 ms, и затраты окупаются лишь на 23-м пакете: если горячая нагрузка сохраняется только 16 пакетов, чистая потеря составляет около 1,5 ms, а при 64 пакетах чистая экономия достигает примерно 10,1 ms. На рис. 9-24 единовременные затраты и выгода от каждого пакета показаны на одном графике. Если на принимающей карте свободно лишь 32 MiB, она не вместит даже одного эксперта размером 36 MiB. Тогда независимо от длительности горячей нагрузки сначала необходимо изменить размещение или освободить память.14
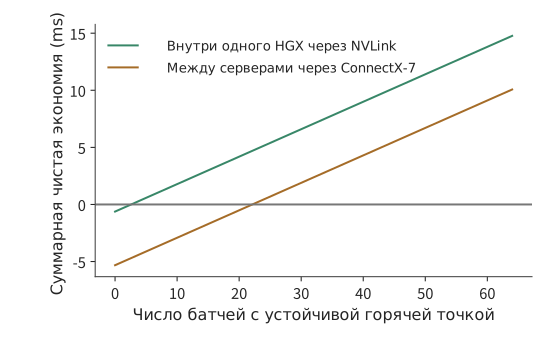
Рис. 9-24. Как долго должна сохраняться горячая нагрузка, чтобы репликация экспертов была оправданна. Каждый пакет экономит около 0,240 ms; однократное копирование внутри одного HGX H100 через NVLink занимает около 0,622 ms и начинает давать чистую выгоду с третьего пакета; копирование между серверами через сетевую карту ConnectX-7 занимает около 5,32 ms и начинает давать чистую выгоду с 23-го пакета. Кривые рассчитаны по неокруглённым значениям времени из примера 9.6; каждой из семи принимающих карт дополнительно требуется 36 MiB, а горячая нагрузка предполагается неизменной.
Измерения CRAFT также показывают, что выгода репликации зависит от слоя. В этом исследовании на основе SGLang v0.4.8 модели DeepSeek-R1 и Kimi K2 в BF16 запускались на кластере A100 80GB из восьми узлов AWS p4de.24xlarge. Распределение реплик экспертов по слоям в пределах бюджета видеопамяти сравнивалось с существующими стратегиями репликации. Согласно статье, сквозная пропускная способность в среднем достигала 1,14-кратного контрольного значения, а максимум — 1,2-кратного. Это показывает, что бюджет реплик следует в первую очередь выделять слоям с высокой выгодой, но не означает, что произвольная репликация горячих экспертов даст такой же прирост. Экспериментальные условия, включая разбиение входа на блоки по 4096 токенов и фиксированную длину выхода 256 токенов, а также точку перегиба ёмкости, определённую через полезную пропускную способность (goodput), нельзя напрямую подставлять вместо производственных показателей p99.37
Стратегия репликации должна предсказывать, как долго сохранится горячая нагрузка. При копировании между серверами каждое новое размещение реплик занимает 5,32 ms, поэтому частая миграция реплик вслед за горячей нагрузкой откладывает окупаемость. Внутри одного сервера копирование занимает лишь 0,622 ms, поэтому время почти не является ограничением; число реплик ограничивается объёмом видеопамяти, который можно освободить на каждой карте. Выделение памяти прежде всего постоянно перегруженным слоям позволяет накопленной экономии времени ожидания превысить затраты на подготовку.
Стратегия балансировки также должна выбирать объект управления с учётом полного пути. На стороне источников нужно балансировать число токенов и время готовности attention; на стороне экспертов — число эффективных строк, фактическое время GEMM и объём принимаемых данных; на стороне сети — проверять общие исходящие каналы, межстоечный трафик и обратное направление. Именно поэтому в опубликованном отчёте DeepSeek балансировка prefill, decode и нагрузки EP рассматривается раздельно. При decode с длинным контекстом даже при одинаковом числе запросов на карту объём чтения KV для attention может различаться, что приводит к разным моментам запуска dispatch.34
В независимом пуле экспертов также необходимо контролировать очереди от разных источников. Несколько attention worker могут одновременно выбрать одного горячего эксперта. Даже если их собственные небольшие batch выглядят сбалансированными, объединённый поток может превысить пропускную способность обслуживания этого эксперта. Если пул принимает \(\lambda\) пакетов в секунду, а каждый пакет в среднем создаёт на карте экспертов \(j\) вычислительную нагрузку \(\mathbb E[F_j]\) FLOPs, то для стабильной работы как минимум необходимо \(\lambda\mathbb E[F_j]<C_j\); для каждого канала \(\ell\) также должно выполняться \(\lambda\mathbb E[V_\ell]<B_\ell\). Соответствие средней нагрузки этим условиям лишь необходимо: всплески и входные данные с тяжёлыми хвостами всё равно могут создавать длинные очереди. Общий пул иногда позволяет объединять batch и сглаживать колебания разных источников, а иногда усиливает коррелированные горячие точки, поэтому нельзя автоматически считать, что разделение устранит перекос.
Реплики горячих экспертов следует размещать там, где одновременно имеется запас вычислительной мощности и пропускной способности каналов. Сообщение dispatch в этом разделе представляет собой вектор скрытого состояния одного токена: 8 KiB для BF16 и 4 KiB для FP8. Это значительно больше точки пересечения около 0,93 KB, рассчитанной в разделе 7.2.4 для сетевой карты 50 GB/s. Поэтому горячая карта сначала исчерпывает пропускную способность, а не скорость запуска запросов сетевой картой. Запас по способности сетевой карты запускать около 54 миллионов запросов в секунду необходимо учитывать только при поштучной отправке управляющих сообщений размером менее 1 KB. При динамическом выборе реплик необходимо учитывать очередь и путь, а также сохранять используемое текущим batch отображение маршрутизации до завершения combine; перед миграцией или удалением старой реплики необходимо дождаться завершения задач в пути. Квоты приёма для горячих точек и ограничение числа операций в пути от одного источника предотвращают исчерпание буфера всего пула. При увеличении ёмкости пула необходимо соответствующим образом корректировать квоты приёма и обратное давление. Отбрасывание токенов при переполнении, изменение top-k или замена логического эксперта меняют поведение модели и не могут считаться прозрачной балансировкой ресурсов.
9.4.3 Перекрытие распределения входов, вычислений и объединения результатов¶
Расчёты в двух предыдущих подразделах не различали prefill и decode, хотя концентрация назначений влияет на эти этапы по-разному. В работе «Demystifying the Mixture of Experts Serving Tax» это различие объясняется микробенчмарками каждого этапа: вычислительный дисбаланс при prefill заставляет весь пакет ждать самую медленную карту, тогда как концентрация экспертов при decode может уменьшать затраты на доступ к памяти благодаря сокращению объёма активных весов и padding. Это согласуется с анализом повторного использования в разделе 6.3.2. В статье Mixtral и Qwen2 MoE выполняются на восьми A100, DeepSeek-V3 — на восьми B200, а для коммуникационных микробенчмарков отдельно используются 8 или 16 H200. Эти результаты нельзя объединять в единый показатель сквозного ускорения между кластерами. Представленные в статье данные показывают, что маршрутизацию, фактическую форму матриц, коммуникации и доступ к памяти необходимо измерять совместно.37
Влияние фактической формы матриц главным образом обусловлено дополнением. Grouped GEMM объединяет матричные умножения нескольких экспертов в одном запуске kernel, причём строки каждой матрицы дополняются до размера tile. Например, восемь локальных экспертов получают \([32,16,8,4,2,1,1,0]\) токенов, то есть всего 64 назначения «токен — эксперт», соответствующие 64 полезным строкам входной матрицы. Если каждый непустой эксперт дополняется до 32 строк, потребуется 224 строки; если все восемь экспертов дополняются до максимального размера, потребуется 256 строк. Фактически выполняется соответственно в 3,5 и 4 раза больше строк, чем полезных. Это объясняет, почему при одинаковом числе полезных задач время матричных вычислений всё равно может различаться: оборудование обрабатывает дополненные матрицы, тогда как требуемым моделью вычислениям экспертов соответствуют только 64 полезные строки; дополненные нулевые строки не связаны с реальными токенами.
Дополнение влияет только на вычислительную составляющую; общая длительность трёх этапов также зависит от возможности их перекрытия. Возьмём равномерное распределение между серверами из раздела 9.4.1: нижние границы времени dispatch, вычислений экспертов и combine равны соответственно 0,336, 0,156 и 0,336 ms, а полностью последовательное выполнение занимает 0,827 ms. Если работу можно равномерно разделить на два micro-batch, время каждого этапа уменьшится вдвое. Идеальное выполнение трёхэтапного конвейера равно сумме трёх этапов одного micro-batch плюс ещё один самый длинный этап, то есть 0,581 ms, что даёт экономию 0,246 ms. Здесь самым длинным этапом являются коммуникации, поэтому темп конвейера определяется сетевой картой. Если DMA сетевой карты конкурирует за HBM с одновременно выполняемым GEMM и из-за этого dispatch и combine каждого micro-batch замедляются примерно на 49%, время того же конвейера возвращается к 0,827 ms: коммуникации действительно перекрываются, но весь пакет не ускоряется. И наоборот, вычисления экспертов должны замедлиться в 3,1 раза, чтобы свести на нет тот же выигрыш.15
Дополнение и конкуренция за ресурсы — две основные причины, по которым MFU не достигает пикового значения: из-за дополнения матричные блоки вычисляют нулевые строки, которым не соответствует ни один токен, а из-за конкуренции коммуникации и вычисления замедляют друг друга. Обе причины находятся на уровне реализации, тогда как пиковые характеристики оборудования не меняются. Подбор tile, лучше соответствующего фактическому числу строк, и разнесение обращений DMA и GEMM к HBM позволяют вернуть часть потерянной производительности.
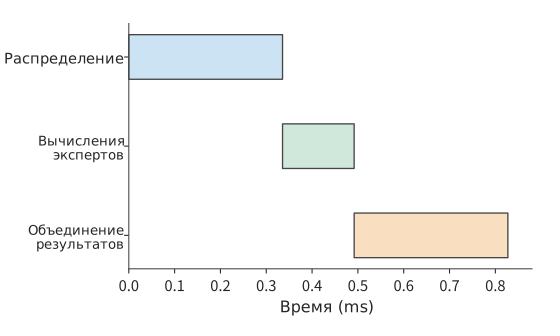
Рис. 9-25. Для всего пакета последовательно выполняются dispatch длительностью 0,336 ms, вычисления длительностью 0,156 ms и combine длительностью 0,336 ms; общее время составляет 0,827 ms. Значения взяты из строки равномерного межсерверного распределения в таблице раздела 9.4.1.
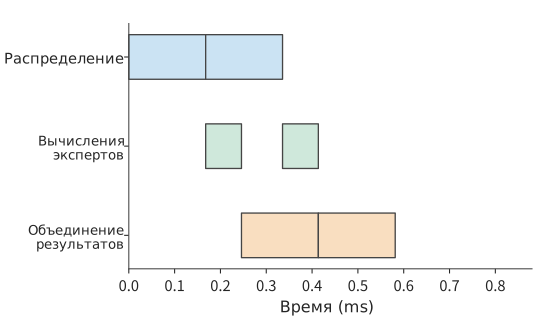
Рис. 9-26. Время каждого этапа для одного micro-batch уменьшается вдвое, а три дорожки используют независимые ресурсы. Пока вычисляется первый micro-batch, можно выполнять dispatch второго, поэтому общее время сокращается до 0,581 ms.
На временной шкале рис. 9-26 видно, что когда выполняется combine первого micro-batch, вычисления второго micro-batch уже начались. Dispatch первого пакета заполняет конвейер, а combine последнего пакета завершает его работу; эти два участка представляют собой последовательное время вне установившейся части конвейера.
В описанном конвейере предполагается, что два micro-batch имеют одинаковый размер. При реальном разделении экспертов путь одного токена всё равно имеет вид «dispatch → вычисление выбранных экспертов → combine»: вычисления экспертов находятся между двумя коммуникационными этапами. Перекос готовности данных для dispatch обусловлен временем завершения attention и очередью отправки; перекос вычислений экспертов затем превращается в перекос готовности отправки для combine. Даже если объёмы байтов в двух обменах полностью симметричны, этап возврата может затянуться из-за поздней готовности данных.
Для токена \(t\) обозначим множество выбранных экспертов через \(\mathcal E(t)\), а суммарную длину пути от начала текущего слоя через эксперта \(e\), включающего ожидание в очереди, dispatch, вычисление и возврат, — через \(L_{t,e}\). Тогда момент завершения объединения удовлетворяет условию:
Здесь каждый путь включает ожидание в очередях общих ресурсов, поэтому нельзя напрямую подставить время изолированного выполнения каждого этапа и предположить отсутствие взаимного влияния. Если две ветви одного токена возвращаются соответственно через 0,5 ms и 1,4 ms, объединение возможно лишь после 1,4 ms; сокращение времени быстрой ветви до 0,3 ms не изменит момент завершения. При продвижении по отдельным токенам или блокам токены, не выбравшие медленного эксперта, могут продолжить выполнение раньше; при барьере всего пакета они ждут вместе со всеми. Дальность распространения ожидания определяется тем, действительно ли среда выполнения поддерживает мелкозернистое продвижение и требуют ли последующие матричные операции повторного накопления batch.
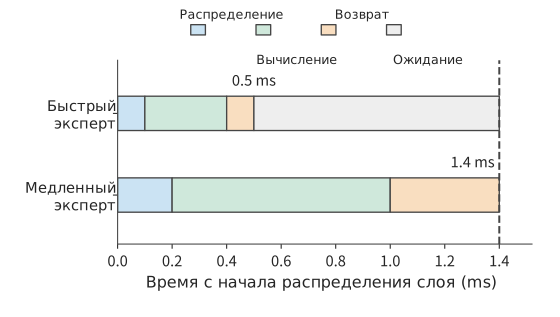
Рис. 9-27. Две ветви экспертов, выбранные одним токеном, имеют условную длительность 0,5 ms и 1,4 ms. Каждая последовательно проходит dispatch, вычисление и combine; токен должен дождаться обоих результатов. Время локального взвешенного объединения на рисунке не учитывается. Серым показано время ожидания после поступления результата быстрой ветви.
Это также объясняет, почему период конвейера пула экспертов не всегда можно предсказать формулой \(\max(t_A,t_F)\). Она требует стабильного времени этапов, независимых ресурсов и непрерывной подачи работы; реальный период также ограничивается самым загруженным экспертом, каналами прямого и обратного пути, буферами возврата и межслойными зависимостями. Если один пул экспертов обслуживает несколько слоёв или моделей, необходимо суммировать занятые ими ресурсы. Первый micro-batch всё равно несёт полную задержку прямого и обратного пути, поэтому увеличение установившейся пропускной способности не означает сокращения времени ответа для отдельного токена.
Оба коммуникационных этапа, dispatch и combine, реализуются коммуникационной библиотекой. NCCL предоставляет универсальные примитивы коллективных и двухточечных коммуникаций, тогда как специализированные библиотеки коммуникаций EP совместно реализуют маршрутизацию, упаковку, передачу и объединение. DeepEP поддерживает dispatch и combine для MoE, а также передачу с низкой точностью. В опубликованном интерфейсе V2 используется ElasticBuffer, в основе лежит NCCL Gin — backend NCCL для запуска сетевых коммуникаций с GPU, — а присутствовавший в V1 низколатентный коммуникационный путь EP, который не занимал SM и напрямую отправлял и принимал данные через RDMA, был удалён. Это показывает, что даже одинаковое название библиотеки не позволяет опускать условие о версии. При сравнении реализаций следует зафиксировать версию, форму данных, точность и топологию, отдельно записывать число отправленных и принятых байтов, число строк expert GEMM, padding, события готовности и завершения каждого этапа, а затем измерять p50 и p99 времени всего слоя и полного запроса. Отдельно измеренная пропускная способность коммуникаций объясняет лишь часть результата.34
При повторном расчёте этого раздела можно сначала сохранить неизменным общее число назначений и менять только распределение экспертов; затем зафиксировать распределение и менять общий исходящий канал и точность dispatch; наконец, в трассировке изменить время готовности одного источника или эксперта. Первые три пункта напрямую воспроизводятся сопутствующими расчётами, а в последнем необходимо наблюдать на временной шкале выполнения, как распространяется ожидание. Только так можно различить перекос трафика, перекос вычислений и ожидание, вызванное простым опозданием данных, не приписывая любые медленные коммуникации недостаточной пропускной способности сети.35
9.5 Распределение и совместное использование KV, маршрутизация запросов¶
9.5.1 Идентификаторы кэша, область совместного использования и доступность¶
В двух предыдущих разделах время обработки текущего запроса сокращалось за счёт изменения места выполнения и распределения задач. Другой способ сэкономить вычислительные ресурсы — позволить последующим запросам напрямую использовать KV, оставшиеся после предыдущих вычислений. В разделе 8.3 уже описаны механизмы разбиения на страницы, сопоставления префиксов, совместного использования и вытеснения. Теперь рассмотрим, как при распределении состояния между разными местами выполнения подтвердить совпадение, найти данные и передать их. Ценность кэширования префиксов заключается в устранении повторных вычислений, но «одинакового текста» недостаточно для однозначного определения всего состояния, пригодного для повторного использования. При вычислении идентификатора кэша могут учитываться версии модели и adapter, последовательность токенов, индексы позиций, формат состояния и необходимые настройки кодирования. Например, одни и те же токены с разными adapter после проекции дают разные K и V; один и тот же суффикс после разного предшествующего текста также получает разный контекст для attention. Ключ кэша должен вдоль всей цепочки префикса идентифицировать вычисления, создавшие это состояние. Состояние скользящего окна или рекуррентное состояние дополнительно должно содержать соответствующий индекс позиции токена и момент обновления, чтобы вычисления можно было продолжить с того же состояния.
После подтверждения взаимозаменяемости двух состояний необходимо определить, где хранится состояние и как другие экземпляры смогут его прочитать. Суммирование объёмов само по себе не создаёт общий кэш. Если у двух экземпляров есть по 4 GiB частного кэша в памяти хоста, один и тот же префикс размером 1,125 GiB будет храниться в обоих местах и в сумме займёт 2,25 GiB, причём ни один экземпляр не сможет использовать копию другого. Если оба экземпляра подключены к одному общему бэкенду хранилища, то есть к сервису, принимающему и предоставляющему объекты кэша, один объект сможет обслуживать оба экземпляра, но каждому из них перед генерацией, возможно, придётся получить его локальную копию. Иерархический кэш HiCache в SGLang, многоуровневый путь кэша в vLLM и система управления KV-кэшем LMCache предлагают разные варианты организации; от того, проходит ли получение через CPU, зависит время пути, рассматриваемое в следующем разделе.16
После создания состояние необходимо сохранить и опубликовать, и лишь затем другие экземпляры смогут найти, получить и использовать его. События кэша, которыми пользуется маршрутизатор, обычно содержат только метаданные вроде места хранения и идентификатора кэша, но не полный KV. Когда копия на GPU вытеснена, копия в памяти CPU может по-прежнему существовать. Каталог хранит соответствие между идентификаторами кэша и местами хранения, а объект — фактические байты KV; при восстановлении отображение каталога и данные объекта проверяются отдельно. Пропущенное или задержанное событие либо освобождение пространства кэша может сделать ранее записанное место хранения недоступным.
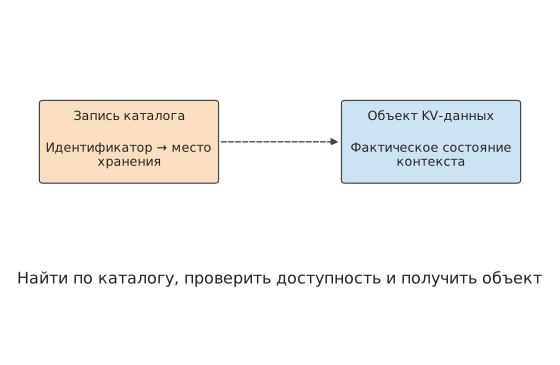
Рис. 9-28. Пунктиром показан поиск местоположения объекта по идентификатору. Каталог используется для поиска, а фактический объект KV — для восстановления вычислений; перед маршрутизацией также необходимо проверить версию и доступность объекта.
9.5.2 Многоуровневое хранилище¶
В разделе 8.3.4 на одной карте сравнивались сохранение, выгрузка и повторное вычисление. В масштабе целого сервера один и тот же KV может храниться в четырёх местах: HBM, памяти хоста, локальном SSD и удалённом пуле хранения. Чем ниже уровень, тем больше ёмкость и тем дальше он находится от GPU. Рассмотрим DGX A100: 8 карт A100 80GB, 2 TB памяти хоста, 8 накопителей U.2 NVMe SSD по 3,84 TB и 8 сетевых карт по 200 Gbit/s; значения ниже рассчитаны как доля, приходящаяся на каждую GPU. В качестве SSD выбран Solidigm D7-P5520 3,84 TB с максимальной пропускной способностью последовательного чтения и записи 7,1 GB/s и 4,2 GB/s соответственно. Хранимый объект по-прежнему представляет собой префикс Qwen3-8B из 8192 токенов общим размером 1,125 GiB.17
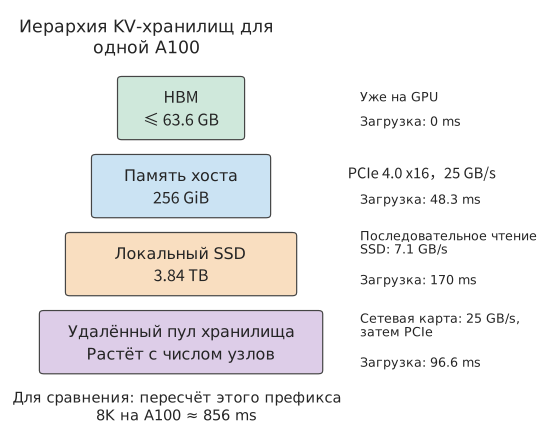
Рис. 9-29. Четыре уровня хранения, приходящиеся на каждую A100 в DGX A100. Ширина прямоугольников показывает только порядок ёмкостей; справа указаны путь от соответствующего уровня до GPU и время получения префикса размером 1,125 GiB. При удалённом получении данные сначала передаются по сети в память хоста, а затем по PCIe на GPU; эти два этапа выполняются последовательно.
| Уровень | Ёмкость на GPU | Путь до GPU | Получение префикса 8K |
|---|---|---|---|
| HBM | ≤ 63,6 GB | Уже на GPU | 0 |
| Память хоста | 256 GiB | PCIe 4.0 x16, 25 GB/s | 48,3 ms |
| Локальный SSD | 3,84 TB | Последовательное чтение SSD, 7,1 GB/s | 170 ms |
| Удалённый пул хранения | Растёт с количеством узлов | Сетевая карта 25 GB/s, затем PCIe | 96,6 ms |
| Для сравнения: повторное вычисление на A100 | — | 50% от пиковой производительности | 856 ms |
В строке HBM указан верхний предел, полученный вычитанием 16,4 GB весов BF16 из 80 GB, без учёта активаций и рабочего пространства. Время получения на всех четырёх уровнях значительно меньше 856 ms, необходимых для повторного вычисления, поэтому для однократного получения любой уровень хранения состояния быстрее повторного вычисления. Реальные ограничения связаны с тремя другими факторами: сохранится ли кэш до следующего использования, можно ли перекрыть чтение вычислениями и насколько дорого обходится запись на каждый уровень.
Ёмкость определяет продолжительность хранения кэша. Одна A100, непрерывно выполняющая prefill для запросов 8K без попаданий в кэш, каждые 0,856 s создаёт KV размером 1,125 GiB, то есть скорость создания составляет \(r\approx1{,}41\) GB/s. Если все новые KV записываются на один уровень и вытесняются в порядке записи, уровень ёмкостью \(C\) сможет хранить KV, созданные примерно за последние \(C/r\) секунд: HBM — около 45 s, память хоста — около 195 s, SSD — около 2722 s, то есть 45 минут. И наоборот, если интервал между двумя использованиями одного префикса равен \(T\), то для попадания всех повторных запросов, поступивших в пределах интервала \(T\), ёмкость этого уровня должна удовлетворять условию
В исследовании Alibaba Cloud на основе трассировок рабочих запросов было измерено время до повторного использования для двух типов нагрузки: в диалоговой нагрузке для индивидуальных пользователей 80% повторных использований происходили в течение 10 минут, а в корпоративной API-нагрузке — в течение 10 секунд. Для интервала в 10 секунд требуется всего 14,1 GB, что помещается в HBM; для интервала в 10 минут нужно 846 GB, что превышает 275 GB памяти хоста на карту, поэтому для полного покрытия потребуется добавить SSD.18
Рис. 9-30. Требуемая ёмкость линейно растёт с интервалом повторного использования. Наклонная линия соответствует \(C=rT\), где \(r\approx1{,}41\) GB/s — скорость создания KV одной A100 при непрерывном выполнении prefill для запросов 8K без попаданий; три пунктирные линии показывают ёмкость трёх уровней хранения на GPU; две вертикальные линии обозначают временные диапазоны, в которых происходит 80% повторных использований для двух типов нагрузки. Обе оси имеют логарифмический масштаб.
Условие \(C\ge rT\) также показывает, когда SSD не требуется. В том же исследовании для диалоговой нагрузки необходимая ёмкость кэша Llama3-70B примерно в четыре раза превышала доступную HBM; на сервере с 8 картами A100 и 1 TB памяти хоста на каждую карту приходилось по 128 GB, чего уже было достаточно без добавления SSD или удалённого уровня. Различие заключается в \(r\): в исследовании она вычислялась по фактической частоте запросов каждого экземпляра, а сами запросы были короче — в среднем 973 токена для одного раунда и 5953 токена для нескольких раундов; здесь же предполагается, что GPU непрерывно выполняет prefill для запросов 8K. Чем больше попаданий по префиксу и чем меньше размер KV на токен, например при MLA, тем ниже \(r\). Значение \(T\) зависит от того, кто инициирует следующий раунд: в диалоге с человеком интервал измеряется минутами, а при программных вызовах — секундами.
С увеличением ёмкости прирост доли попаданий замедляется. Ёмкость позволяет сохранять только состояния, которые будут повторно использованы в будущем, но некоторые состояния больше не понадобятся. Mooncake опубликовал часовую выборку трассировки рабочего сервиса Kimi с блоками по 512 токенов. При вытеснении по алгоритму LRU (первым вытесняется блок, к которому дольше всего не обращались) увеличение кэша с 1000 до 50 000 блоков повышает долю попаданий с 30% до 50%; даже при неограниченной ёмкости она составляет лишь 51%. В пересчёте на Qwen3-8B 50 000 блоков занимают около 3,77 TB, что сопоставимо с одним SSD на 3,84 TB. В этой трассировке более половины блоков никогда не использовались повторно, тогда как к некоторым другим обращались более десяти тысяч раз; в трассировке Alibaba Cloud наблюдалась такая же концентрация: 10% блоков обеспечивали 77% повторных использований.19
Рис. 9-31. С ростом ёмкости доля попаданий приближается к насыщению. Данные показывают долю попаданий при вытеснении LRU в часовой выборке трассировки Mooncake с блоками по 512 токенов; горизонтальная ось переведена в байты из расчёта 144 KiB на токен для Qwen3-8B. Это лишь выборка одного фрагмента трафика; необходимая ёмкость реального сервиса растёт пропорционально объёму трафика.
Однократное получение или удалённое чтение на каждом шаге. Существует три типичных способа использования общего KV: локальное повторное выполнение prefill, однократное удалённое получение с последующим локальным размещением и удалённое чтение на каждом шаге decode. Во всех трёх случаях используется один и тот же контекст, но частота передачи данных совершенно различна.
Для префикса размером 1,125 GiB и используемой в этой главе сетевой карты 200 Gbit/s (25 GB/s) однократное получение полезной нагрузки занимает около 48,3 ms. Если при каждом из 100 вызовов decode неизменный префикс заново считывается из удалённого хранилища, суммарное время занятости канала составит около 4,83 s. Если эти 100 чтений должны завершиться за одну секунду, только для этого контекста потребуется около 121 GB/s — в 4,8 раза больше пропускной способности заданного канала. Параллельное выполнение чтения и вычислений также не позволит каналу 25 GB/s передать все эти байты за одну секунду. Для компактного префикса MLA размером 549 MiB одно получение занимает около 23,0 ms, а 100 чтений — около 2,30 s; для завершения за секунду всё равно потребуется примерно 57,6 GB/s, то есть в 2,3 раза больше пропускной способности канала. Уменьшение состояния вдвое лишь вдвое снижает это превышение: удалённое чтение на каждом шаге остаётся непрактичным.
Однократное получение с локальным размещением снижает частоту передачи с «одного раза на шаг» до «одного раза на повторное использование», но занимает локальную HBM. Если состояние имеет размер \(V\) байт и хранится локально в течение \(\tau\) секунд, произведение занимаемой ёмкости на время равно \(V\tau\) и измеряется в байт-секундах. При одинаковом хранении в течение 10 секунд больший объект занимает больше ресурсов; при одинаковом размере объекта это произведение увеличивается с продолжительностью хранения. Для сеанса из раздела 9.1.3 во время десятисекундного выполнения инструмента состояние GQA занимает 11,25 GiB·s, а компактное состояние MLA — 5,36 GiB·s, поэтому та же локальная ёмкость может вместить примерно вдвое больше ожидающих сеансов. Следовательно, неактивные сеансы можно размещать удалённо, получать при возобновлении и оставлять локально на время непрерывного decode. Тогда передача данных происходит преимущественно при возобновлении и приостановке сеанса.
Предположим, что состояние будет повторно использовано в будущем \(k\) раз, и пока не будем учитывать ни время ожидания в очереди, ни вытеснение другого содержимого кэша из-за занятого им пространства. Сохранение с последующим получением будет быстрее повторного вычисления при условии
Рассмотрим префикс Qwen3-8B из 8192 токенов: повторное вычисление на A100 занимает около 0,856 секунды, то есть время prefill из раздела 9.2.3, а сохранение и получение через сетевую карту 25 GB/s — примерно по 48,3 ms. При одном повторном использовании сохранение и получение вместе занимают около 96,6 ms — менее одной восьмой времени повторного вычисления. Поэтому сохранять состояние выгодно, если оно будет использовано хотя бы ещё один раз. При замедлении канала вывод меняется: при пропускной способности примерно от 1,41 до 2,82 GB/s состояние должно быть повторно использовано не менее двух раз, чтобы компенсировать стоимость сохранения, причём чем ближе скорость к 1,41 GB/s, тем больше требуется повторных использований; ниже примерно 1,41 GB/s даже однократное получение медленнее повторного вычисления, а с ростом числа повторных использований потери увеличиваются. Пропускная способность 10 GbE в каждом направлении составляет всего 1,25 GB/s, поэтому одно получение занимает около 966 ms; в этом случае следует выполнить повторное вычисление либо заранее завершить получение, убрав его с критического пути. Размер состояния входит только в \(T_{write}\) и \(T_{read}\), тогда как \(T_{recompute}\) определяется стоимостью prefill модели. Для компактного состояния MLA однократные запись и получение через ту же сетевую карту вместе занимают лишь около 46,1 ms, поэтому левая часть неравенства уменьшается пропорционально количеству байтов KV.
Критическая пропускная способность 1,41 GB/s в точности совпадает с приведённой выше скоростью создания KV \(r\): получение \(V\) байтов занимает \(V/B\), а повторное вычисление — \(V/r\), поэтому при пропускной способности канала \(B\), превышающей скорость создания этого KV на GPU, получение будет быстрее повторного вычисления. Скорости записи и чтения локального SSD выше \(r\): запись занимает около 288 ms, чтение — около 170 ms, а их сумма при одном повторном использовании составляет примерно 458 ms, что по-прежнему меньше 856 ms повторного вычисления.
Перекрытие чтения вычислениями. После попадания запросу остаётся вычислить только 256 новых токенов, что при принятой в разделе 9.2.3 производительности 50% от пикового значения A100 занимает около 30,9 ms. Если исторический KV находится в памяти хоста и перед началом вычислений целиком считывается на GPU, общее время составляет 48,3 + 30,9 = 79,2 ms, причём чтение длится дольше вычисления. CachedAttention использует послойную предварительную загрузку: Transformer выполняет вычисления по слоям, а слою \(i\) нужен только KV слоя \(i\), поэтому одновременно с вычислением слоя \(i\) на GPU по PCIe можно считывать последующие слои. Исторический KV каждого слоя Qwen3-8B занимает 32 MiB; чтение одного слоя занимает 1,34 ms, а вычисление новых токенов для слоя — всего 0,857 ms. Вычисления каждого слоя вынуждены ждать чтения, поэтому общее время составляет около 49,2 ms и по-прежнему определяется чтением. Для дальнейшего сокращения времени необходимо загрузить несколько слоёв ещё до начала выполнения запроса: за время выполнения предыдущего batch можно считать первые 14 слоёв (448 MiB) в зарезервированный буфер HBM, после чего чтение остальных 22 слоёв будет полностью скрыто вычислениями, а общее время снизится до собственно времени вычисления — 30,9 ms. Буфер должен вмещать именно тот объём байтов, на который чтение превосходит вычисление:
где \(B\) — пропускная способность канала, \(T_{read}\) — время чтения всего исторического KV, а \(T_{new}\) — время вычисления новых токенов. Подстановка 25 GB/s, 48,3 ms и 30,9 ms даёт около 437 MB, то есть немного больше 13 слоёв; после округления вверх до целого слоя получается 14 слоёв. При \(T_{new}\ge T_{read}\) буфер не требуется: когда новый ввод достигает примерно 400 токенов, вычисления могут скрыть чтение из памяти хоста; для последовательного пути из удалённого пула хранения требуется около 800 токенов, а для локального SSD — около 1400. В измерениях CachedAttention на LLaMA-13B при 1K исторических и 100 новых токенах послойная предварительная загрузка сократила время prefill на 35%, а после добавления буфера на 15 слоёв — на 61%.20
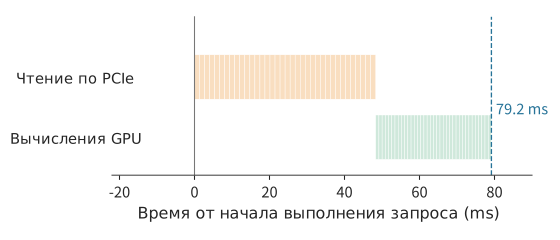
Рис. 9-32. Сначала весь исторический KV размером 1,125 GiB считывается из памяти хоста, затем вычисляются 256 новых токенов; общее время составляет 79,2 ms. Оранжевым показано чтение по PCIe, зелёным — вычисление на GPU; каждый небольшой сегмент соответствует одному слою.
Рис. 9-33. Послойная предварительная загрузка. Пока GPU вычисляет один слой, по PCIe считываются последующие; чтение каждого слоя занимает 1,34 ms, вычисление — 0,857 ms. Вычисления каждого слоя вынуждены ждать чтения, поэтому общее время 49,2 ms определяется чтением.
Рис. 9-34. До начала выполнения этого запроса за время выполнения предыдущего batch предварительно считываются первые 14 слоёв (448 MiB); чтение остальных 22 слоёв полностью скрыто вычислениями, и общее время равно собственно времени вычисления — 30,9 ms. Горизонтальная ось одинакова на всех трёх рисунках.
Предварительное чтение с SSD во время ожидания в очереди. Чтение одного слоя с локального SSD занимает 4,73 ms — в 5,5 раза больше вычисления слоя, поэтому послойная предварительная загрузка может скрыть лишь небольшую часть времени. Если к началу выполнения запроса состояние всё ещё находится на SSD, этот этап даже при послойном чтении займёт около 171 ms, тогда как собственно вычисление — лишь 30,9 ms. Можно использовать время ожидания в очереди: пока запрос находится в очереди, планировщик уже знает, какой префикс ему нужен, и может заранее считать его с SSD в память хоста. Если время ожидания не меньше 170 ms, чтение уйдёт с критического пути, а после начала выполнения данные можно будет послойно считывать из памяти хоста описанным выше способом. Это то же соотношение \(T_{first}=\max(Q,R)+C\), которое рассматривается в разделе 9.5.4: предварительное чтение перекрывает время готовности состояния \(R\) временем ожидания \(Q\).
Количество сеансов, помещающихся в памяти хоста, определяет, для какого максимального числа первых запросов в очереди планировщик может выполнить предварительное чтение: 256 GiB вмещают около 227 префиксов 8K, поэтому достаточно предварительно считывать данные только для первых 227 запросов. При нехватке памяти хоста и необходимости выгрузки также учитывается очередь: состояния, которые вскоре понадобятся этим запросам, выгружать нельзя; среди остальных первым выгружается состояние с наиболее поздним следующим использованием. LRU и FIFO учитывают только прошлые обращения и не могут использовать сведения о предстоящих запросах в очереди. CachedAttention воспроизводил многораундовые диалоги из ShareGPT, набора пользовательских диалогов с ChatGPT, на 4 картах A100 с 128 GB памяти хоста и SSD на 10 TB: при предварительном чтении и выгрузке с учётом очереди общая доля попаданий составила 86%, причём более 99,6% попаданий пришлись на память хоста; при LRU и FIFO доля попаданий составляла лишь 58% и 48% соответственно, а на память хоста приходилось менее 1% попаданий, поэтому почти каждое попадание требовало чтения с SSD.20
Рис. 9-35. В памяти хоста есть четыре места хранения: одно оставлено свободным для принимаемых данных, а остальные три предназначены для следующих в очереди J2—J4. Состояние J3 всё ещё находится на SSD и считывается в свободное место, пока запрос ожидает в очереди; J6 расположен после этих трёх запросов и будет использован позже всех, поэтому первым выгружается на SSD.
Срок службы SSD ограничивает объём записи. Запись также следует убирать с критического пути. KV, послойно создаваемый во время prefill, можно записывать параллельно с вычислением, а при decode на каждом шаге добавляется KV только одного токена. Запись со скоростью \(r\approx1{,}41\) GB/s занимает лишь 5,6% пропускной способности PCIe и 34% пропускной способности последовательной записи SSD. Настоящим ограничением SSD является ресурс записи: для D7-P5520 заявлена одна полная перезапись в день в течение пяти лет (1 DWPD), поэтому диск на 3,84 TB в среднем допускает запись лишь 44,4 MB в секунду. Если записывать на SSD все новые KV, объём записи превысит эту норму в 31,7 раза, и пятилетний ресурс будет исчерпан менее чем за два месяца. В долгосрочной перспективе на SSD можно записывать лишь около 3,2% новых KV. В обеих упомянутых трассировках повторное использование концентрировалось на небольшом числе блоков, а в трассировке Mooncake более половины блоков никогда не использовались повторно. Поэтому перед записью на SSD необходим контроль допуска — например, записывать только уже повторно использованные префиксы или ещё не завершённые многораундовые сеансы. При записи в пределах этой нормы SSD сможет хранить ровно тот объём KV, который создаётся за последние сутки.
Такую связь между ёмкостью и попаданиями можно наблюдать и экспериментально. В серии экспериментов с двумя движками на одной карте из 12 возможностей повторного использования префикса общий CPU-пул размером 4 GiB обеспечил 5 полных попаданий, а пул размером 8 GiB — все 12. Дополнительные 4 GiB сохранили семь полных префиксов, которые иначе были бы вытеснены; если состояние для повторного запроса уже находится локально, его не требуется получать снова. Поэтому пользу общей ёмкости необходимо оценивать по тому, как долго она сохраняет данные, сколько повторных вычислений предотвращает и сколько дополнительных перемещений создаёт.21
9.5.3 Персистентность, checkpoint и частичное повторное вычисление¶
В предыдущем разделе предполагалось, что сохранённое состояние можно получить полностью. После перезапуска экземпляра записи каталога, данные на диске и непрерывный префикс, пригодный для повторного использования, могут не совпадать, поэтому при восстановлении необходимо заново проверить, какие результаты вычислений действительно сохранены. Персистентность позволяет состоянию оставаться доступным после перезапуска экземпляра или приостановки задачи. Полное сохранение уменьшает объём повторных вычислений при восстановлении, периодический checkpoint сокращает объём записи ценой дополнительной работы при восстановлении, а частичное повторное вычисление дополняет недостающие части с использованием сохранённого префикса. В checkpoint необходимо сохранять всё состояние, требуемое для продолжения вычислений: для полного GQA — K и V контекста; состояние DeepSeek V4 дополнительно включает результаты сжатия, окно и незавершённый блок сжатия. После восстановления вычисление продолжается с последнего полного обновления, записанного в checkpoint.22
Персистентное состояние сохраняется постранично и так же постранично считывается при восстановлении. Сначала рассмотрим полную страницу GQA. В Qwen3-8B логическая страница, содержащая 16 токенов, занимает 2,25 MiB. Если фрагменты K и V каждого слоя перемещаются отдельно, образуется множество небольших непрерывных сегментов; если же они собираются по страницам, меняются число передач и необходимые преобразования раскладки. После разделения логической страницы по K и V 36 слоёв получается 72 непрерывных сегмента по 32 KiB; при сборке по страницам получается один объект размером 2,25 MiB. Первый вариант сильнее зависит от ограничения числа операций в секунду, а во втором больше времени расходуется на передачу непрерывной полезной нагрузки.
После перезапуска некоторый запрос считал 64 страницы, покрывающие 1024 токена, но непрерывный префикс, пригодный для повторного использования, содержал только 1008 токенов, то есть 63 страницы. Лишняя считанная страница заняла 2,25 MiB, но не позволила избежать соответствующего повторного вычисления. Для этого запроса объём чтения составил 144 MiB, а эффективно повторно использованный объём — около 142 MiB; ещё нагляднее сформулировать это так: «считано 64 страницы, использовано 63». Ограничение здесь возникает после чтения: заменить вычисление могут лишь успешно сопоставленные страницы, образующие непрерывное продолжение существующего контекста. Ускорение чтения с диска сократит его продолжительность, но не изменит необходимость обработки последней страницы этого запроса.23
Рис. 9-36. Не все считанные страницы обязательно становятся префиксом, пригодным для повторного использования. После штатного перезапуска этот запрос считал 64 страницы по 16 токенов, но повторно использовал только первые 63; последнюю страницу всё равно пришлось обработать. Каждая страница занимает 2,25 MiB, а граница сопоставления для этого запроса находится на 1008 токенах.
При отсутствии страницы необходимо сравнить длительность дальнейшего ожидания с длительностью повторного вычисления. Повторное вычисление полного префикса из 8192 токенов на A100 занимает около 0,856 секунды, то есть время prefill из раздела 9.2.3; если ожидание недоступного объекта уже длится одну секунду, оно превысило время повторного вычисления всего префикса. В реальном эксперименте с усечённой страницей запрос с безусловным ожиданием так и не завершился в пределах 60-секундного окна наблюдения, а после разрешения прекратить ожидание получил результат путём повторного вычисления. После завершения текущего запроса повреждённую страницу необходимо изолировать или исправить, иначе следующий запрос столкнётся с тем же ожиданием.24
9.5.4 Привязка к кэшу и маршрутизация запросов¶
После подтверждения возможности повторного использования кэша всё ещё требуется решить, на какую машину отправить запрос. Машина с нужным кэшем может быть занята, тогда как другая машина, хотя ей придётся получить состояние или вычислить его повторно, может завершить запрос раньше. Поэтому при маршрутизации нужно сравнивать время завершения запроса. Пусть \(Q\) — самый ранний момент, когда GPU сможет начать выполнение, \(R\) — момент готовности состояния, отсчитываемый от поступления запроса, а \(C\) — оставшийся объём работы после подготовки состояния. Если выполнение начинается только после получения всего состояния, а получение можно перекрыть ожиданием GPU, время до первого токена равно
Если получение может начаться лишь после освобождения GPU, время ожидания и время получения складываются; при послойном конвейере требуется более подробный граф выполнения. Например, если \(Q=80\) ms, получение занимает 60 ms, а оставшееся вычисление — 10 ms, при параллельной подготовке общее время составит 90 ms; если запускать получение только после освобождения GPU, потребуется 150 ms. Объём вычислений и число передаваемых байтов одинаковы, но из-за разных зависимостей время отличается на 60 ms.
Пример 9.7. Как попадание в кэш и ожидание в очереди совместно определяют маршрутизацию запроса? A и B — два экземпляра A100. Запрос содержит префикс из 8192 токенов и 256 новых входных токенов. В HBM экземпляра A есть этот префикс, но ожидание в очереди составляет 250 ms; B ожидает всего 20 ms, но нужного кэша у него нет. По принятому в разделе 9.2.3 допущению используется 50% пиковой производительности A100, то есть 156 TFLOP/s: полное повторное вычисление 8448 токенов требует около 138,4 TFLOPs матричных операций и занимает примерно 887 ms; после попадания нужно вычислить только 256 новых токенов — около 4,81 TFLOPs и 30,9 ms. B также может получить префикс из удалённого хранилища: фиксированные накладные расходы поиска составляют 10 ms, а весь объект размером 1,125 GiB сначала передаётся по сети в память хоста, затем по PCIe 4.0 x16 на GPU; как и в примере 9.3, используется скорость 25 GB/s, что даёт около 48,3 ms.
| Путь | Время до первого токена |
|---|---|
| A: локальное попадание | \(250+30{,}9\approx281\) ms |
| B: прямое повторное вычисление | \(20+887\approx907\) ms |
| B: удалённое получение по 50 GbE (6,25 GB/s) | Около 282 ms |
| B: удалённое получение по 200 GbE (25 GB/s) | Около 137 ms |
Рис. 9-37. У A уже произошло попадание в локальный кэш, но перед вычислением продолжительностью 30,9 ms GPU ожидает в очереди 250 ms, поэтому первый токен возвращается через 281 ms. Серым показано ожидание, зелёным — вычисление.
Рис. 9-38. B освобождается через 20 ms, после чего повторное вычисление на A100 занимает 887 ms; первый токен возвращается через 907 ms.
Рис. 9-39. Сначала выполняется поиск в течение 10 ms, затем 1,125 GiB считываются по 50 GbE со скоростью 6,25 GB/s в память хоста и в конце передаются на GPU по PCIe со скоростью 25 GB/s. Вычисление ожидает готовности и данных, и GPU; первый токен возвращается примерно через 282 ms, приблизительно на 1,6 ms позже, чем на A.
Рис. 9-40. После замены удалённого канала на 200 GbE (25 GB/s) первый токен возвращается примерно через 137 ms. Оранжевым показано удалённое чтение, синим — передача из памяти хоста на GPU; отсчёт на всех четырёх рисунках начинается с момента поступления запроса, горизонтальные оси одинаковы.
На первой схеме маршрутизации данные A уже находятся на GPU, но вычисление не может начаться раньше 250 ms. B освобождается через 20 ms; прямое повторное вычисление может начаться немедленно, но 887 ms вычисления дольше любого пути получения, тогда как при удалённом получении приходится продолжать ждать данные. Увеличение пропускной способности удалённого канала сокращает оранжевый сегмент, но поиск, передача из памяти хоста на GPU и заключительное вычисление сохраняются.
Чтобы B вернул результат раньше A с его 281 ms, состояние должно быть готово за 250 ms после вычитания 30,9 ms вычисления при попадании. После дополнительного вычитания 10 ms поиска и примерно 48,3 ms передачи из памяти хоста на GPU для удалённого чтения остаётся около 191,7 ms. Деление 1,125 GiB на этот бюджет даёт пропускную способность, при которой получение на B сравняется с локальным попаданием на A, — около 6,30 GB/s: скорость 50 GbE, равная 6,25 GB/s, немного ниже этого значения, а 200 GbE — значительно выше. Пропускная способность, при которой получение сравняется с повторным вычислением, составляет лишь около 1,48 GB/s, поэтому на A100 повторное вычисление префикса 8K почти всегда будет самым медленным вариантом.
Таким образом, один и тот же сеанс можно перераспределять с учётом местонахождения состояния и вычислительных ресурсов. Приложение сохраняет непрерывный контекст, а сервис выбирает между продолжением с локальным состоянием, миграцией состояния и повторным вычислением в зависимости от того, когда каждый из этих трёх путей позволит начать последующее выполнение модели. В главе 8 пригодный для повторного использования префикс определялся по содержимому; в этом разделе решение о маршрутизации дополнительно учитывает время ожидания и пропускную способность канала.
После перехода на 200 GbE получение для одного запроса явно выигрывает, но 16 получений в секунду требуют около 19,3 GB/s, то есть занимают примерно 77% пропускной способности канала 25 GB/s. Всплески запросов увеличат время ожидания передачи. Поэтому после расчёта требуемой пропускной способности для одного запроса необходимо также вычислить суммарный трафик при непрерывном поступлении запросов.25
В предыдущем сравнении предполагалось, что местонахождение кэша известно, а данные доступны. Обычно маршрутизатор прогнозирует местонахождение по событиям кэша, однако задержка событий или вытеснение объекта могут сделать прогноз ошибочным. Чтобы увидеть влияние такой ошибки на время ответа, изменим время ожидания A на 80 ms и предположим, что кэш действительно доступен лишь с вероятностью \(p\). При попадании время составляет 110,9 ms, а при отказе всех уровней и вынужденном повторном вычислении — 967,2 ms, поэтому математическое ожидание равно
Чтобы среднее значение было лучше 907 ms прямого повторного вычисления на B, достаточно \(p>7{,}0\%\). При \(p=0{,}9\) среднее составляет около 196,5 ms, но 10% запросов по-прежнему выполняются за 967 ms, поэтому p99 такого двухточечного распределения равен 967 ms и значительно превышает целевые 220 ms. Чтобы p99 достиг 220 ms, в этой двухточечной модели вероятность попадания должна составлять не менее 99%; значение 90% уже значительно улучшает среднее, но всё ещё отправляет каждый десятый запрос по медленному пути длительностью 967 ms.26
Нагрузочный стресс-тест с одновременным выполнением двух задач ещё нагляднее показывает компромисс между приоритетом кэша и приоритетом свободного экземпляра. При приоритете кэша целевой запрос завершается примерно за 1,38 секунды, и к этому же моменту завершаются обе задачи; после переноса целевого запроса на свободный экземпляр он завершается примерно за 0,33 секунды, но обе задачи заканчиваются лишь примерно через 1,54 секунды. Целевой запрос ускоряется примерно на 1,05 секунды, тогда как момент завершения всех задач сдвигается примерно на 0,16 секунды. Перед принятием решения о маршрутизации необходимо определить, что именно оптимизируется: время ответа целевого запроса или время завершения всех задач.27
После включения описанного в главе 8 восстановления состояния в решение о маршрутизации необходимо одновременно сравнивать момент освобождения экземпляра и момент готовности состояния. Рассмотрим состояние сеанса DeepSeek V4.1: пусть экземпляр A сохранил глобальный KV и состояние SWA энкодера, но имеет очередь, а экземпляр B может начать выполнение немедленно, однако должен получить глобальный KV и восстановить состояние SWA энкодера. Преимущество A — возможность повторно использовать состояние, преимущество B — немедленная доступность вычислительных ресурсов; маршрутизатор должен сравнивать ожидаемое время завершения на обоих экземплярах, а не только проверять признак попадания в кэш.
Предположим, что дальнейшая обработка нового ввода, воспроизведение окна декодера и генерация занимают на обоих экземплярах одинаковое время, а подготовительные операции выполняются последовательно. Передача глобального состояния B по расчёту из главы 7 занимает 4,666 ms, а восстановление состояния SWA энкодера, по предположению, — 8 ms, итого 12,666 ms. A сохранил оба состояния, поэтому его подготовительное время равно времени ожидания в очереди: при ожидании 10 ms A раньше начинает обработку нового ввода, а при увеличении ожидания до 20 ms раньше начинает B. Таким образом, 12,666 ms становится в этом примере порогом времени ожидания, при котором меняется выбор маршрута.33
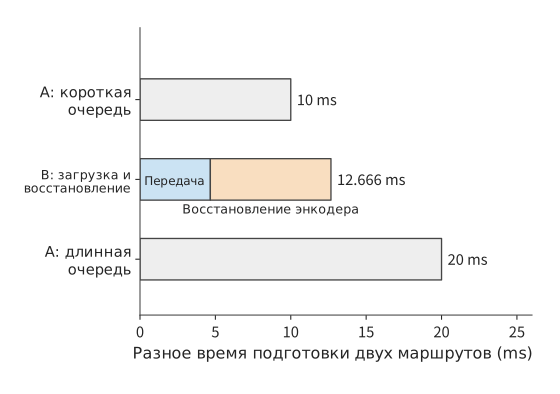
Рис. 9-41. Сравнение привязки к кэшу со свободным местом выполнения. A сохранил глобальный KV и SWA энкодера; B требуются 4,666 ms на передачу глобального состояния и предполагаемые 8 ms на восстановление энкодера. Общие для обоих вариантов последующие операции, включая воспроизведение декодера, опущены; сравнивается только разное время последовательной подготовки. Когда время ожидания A возрастает с 10 до 20 ms, более быстрым вариантом вместо A становится B. Серым показано ожидание в очереди, а остальные цветные блоки соответствуют передаче глобального состояния и восстановлению локального состояния энкодера.
9.6 Запуск сервиса, масштабирование и восстановление после сбоев¶
В разделах 9.2–9.5 сравнивалось, кому передавать запросы и где хранить состояние. Теперь рассмотрим изменения самих экземпляров: сколько времени занимают запуск и прогрев новых реплик, как передаётся состояние при изменении способа распараллеливания во время работы и как после отказа части ускорителей продолжить обслуживание, используя сохранённое состояние и журнал вывода.
9.6.1 Затраты на запуск и прогрев¶
При сравнении маршрутизации в разделе 9.5.4 предполагалось, что доступные экземпляры уже существуют. При масштабировании или восстановлении после сбоя новый экземпляр сначала должен запуститься, а ожидающие запросы тем временем продолжают поступать. Поэтому здесь запуск и восстановление состояния рассматриваются в рамках одной временной шкалы обслуживания. Новая реплика также должна завершить инициализацию процесса и токенизатора (tokenizer — компонента, преобразующего текст в номера токенов), чтение и шардирование весов, компиляцию, определение ёмкости KV и захват графа (запись шагов выполнения в CUDA Graph из раздела 5.5.2). Суммарное время этой подготовки определяет, когда новая реплика начнёт принимать часть запросов. Если первый пробный запуск инициирует компиляцию, время компиляции уже входит во время пробного запуска, поэтому общее время следует вычислять с учётом последовательности зависимостей. Поэтапный анализ исторических версий vLLM в исследовании затрат на запуск Breaking the Ice демонстрирует эту проблему; если раскрыть отношения вложенности, полное время запуска определяется самым длинным путём зависимостей от создания процесса до готовности принимать запросы.28
Предположим, что подготовка графа выполнения увеличивает время запуска на \(T_s\), но затем позволяет экономить \(\delta\) на каждом шаге выполнения. Чистая выгода после \(N\) шагов составит \(N\delta-T_s\). Если запуск удлиняется на 10 секунд, а каждый шаг экономит 0,2 мс, равновесие наступит только через 50 000 шагов, и лишь начиная с 50 001-го шага накопленная экономия времени превысит дополнительные затраты на запуск. Если на каждом шаге 32 запроса генерируют по одному токену, то 50 000 шагов соответствуют примерно 1,6 миллиона выходных токенов. Время экономится один раз на каждое выполнение batch, поэтому накопленную выгоду следует рассчитывать по числу выполнений batch.
Поступающие во время запуска запросы также образуют очередь. Если исходный сервис полностью недоступен, интенсивность поступления остаётся равной \(\lambda\), а время запуска составляет \(T_s\), то к его завершению накопится примерно \(\lambda T_s\) запросов. Если после готовности пропускная способность сервиса равна \(\mu>\lambda\), то в идеальной модели непрерывного потока дополнительное время опустошения очереди составит
Рассмотрим гетерогенный кластер из этой главы: запуск занимает 10 секунд, в течение которых поступает 3,5 запроса в секунду, поэтому к моменту готовности накапливается 35 запросов. После готовности прямое PD-разделение может обслуживать примерно 4,55 запроса в секунду, но 3,5 из них приходится на новые запросы, поэтому фактически за секунду обрабатывается лишь около 1,05 накопленного запроса. Для полного опустошения очереди потребуется ещё примерно 33 секунды, то есть она исчезнет на 43-й секунде от начала запуска. При верхней границе 4,17 запроса/с для совместного размещения с идеальным блочным совмещением за секунду можно обрабатывать лишь около 0,67 накопленного запроса, поэтому очередь исчезнет только на 63-й секунде. При совместном размещении без разбиения пропускная способность составляет всего 3,02 запроса/с, и очередь будет непрерывно расти. Все три кривые показаны на рис. 9-42.
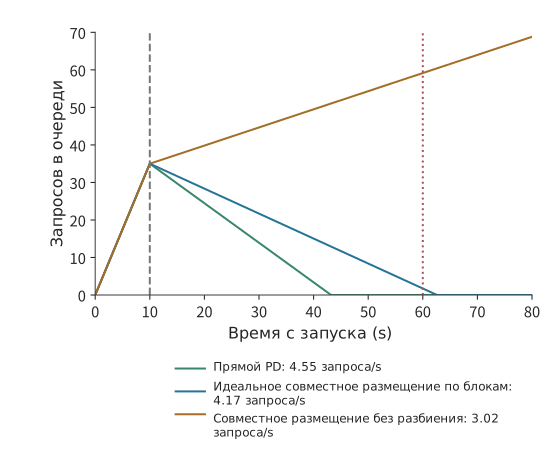
Рис. 9-42. Резерв пропускной способности сервиса определяет скорость сокращения накопившейся при запуске очереди. В модели непрерывного потока поступает 3,5 запроса в секунду, и после 10 секунд запуска накапливается 35 запросов. После готовности скорости обслуживания составляют соответственно 4,55 запроса/с для прямого PD-разделения, 4,17 запроса/с для совместного размещения с идеальным блочным совмещением и 3,02 запроса/с для совместного размещения без разбиения. В первых двух случаях очередь опустошается на 43-й и 63-й секундах от начала запуска, а в последнем продолжает расти. Крайний срок опустошения очереди в примере 9.8 — 60-я секунда.
После готовности накопившиеся запросы зачастую поступают одновременно, и тогда конкурентная предварительная выборка может изменить порядок начала их выполнения. Когда один запрос длиной 1024 токена выполнялся отдельно, он повторно использовал 1008 токенов. Когда одновременно поступили восемь запросов, первые четыре зарегистрировали предварительную выборку по 1024 токена каждый, суммарно заняв 4096 токенов, а для остальных запросов предварительная выборка не была зарегистрирована из-за превышения лимита ёмкости. Первым завершился как раз один из последних запросов: он не получил ни одного попадания в кэш и сразу начал prefill; поскольку ему не пришлось ждать кэш, он раньше попал в очередь выполнения. Таким образом, даже при наличии объекта в кэше запрос сначала должен получить пространство, необходимое для предварительной выборки, и лишь затем сможет воспользоваться этим кэшем. Когда пространство для предварительной выборки заканчивается, последующие запросы сразу выполняют вычисления заново, тогда как запросы с уже начатой предварительной выборкой продолжают ждать данные.29
При масштабировании необходимо также учитывать соответствие версий модели оборудованию. Если веса зафиксированы на неизменяемом носителе, добавление ускорителей той же модели позволяет масштабировать обслуживание той же версии; для развёртывания новых весов необходимо подготовить ускорители, поддерживающие новую версию. Маршрутизатор распределяет запросы по версиям модели, а при планировании ресурсов следует предусматривать одновременную работу старой и новой версий и замену ускорителей. Чем дольше работает сервис с фиксированной версией и чем выше спрос, тем на большее число запросов распределяются затраты на развёртывание.
9.6.2 Реконфигурация во время работы и передача состояния¶
Запуск определяет, когда новый экземпляр станет доступен; при миграции во время работы целевой экземпляр должен также продолжить выполнение с достигнутой исходным экземпляром точки. Изменение степени тензорного параллелизма, экспертного параллелизма или размера пула обслуживания требует перераспределить веса и состояние запросов. Получение параметров целевыми ускорителями — лишь первый этап: может также потребоваться создать коммуникационные группы, подготовить новый граф выполнения, преобразовать раскладку и возобновить приём запросов. У этой подготовки и переноса данных есть последовательные зависимости, совместно определяющие момент, когда новые запросы можно будет передать целевому экземпляру.
При плановой миграции можно воспользоваться тем, что исходный экземпляр продолжает работать: сначала в фоновом режиме копируется уже неизменяемый контекст, а исходный экземпляр продолжает генерацию; затем он ненадолго останавливается, копируется состояние, добавленное за время миграции, и право выполнения передаётся целевому экземпляру. Рассмотрим перенос D worker с одного H20: средняя длина контекста для 32 запросов в batch составляет 8704 токена, а общий объём KV — около 41,1 GB. Исходный экземпляр выполняет примерно 1166 вызовов decode в секунду, каждый из которых добавляет KV одного токена (144 KiB), поэтому состояние растёт лишь примерно на 0,172 GB в секунду. Целевой экземпляр копирует данные через сетевую карту 200 Gbit/s из этой главы со скоростью 25 GB/s, и отставание сокращается примерно на 24,8 GB/s. Копирование завершается приблизительно через 1,65 секунды, а за это время добавляется около 0,28 GB состояния; при наличии лишь одного порта 50 GbE (6,25 GB/s) потребуется около 6,76 секунды. Скорость добавления KV при decode значительно ниже пропускной способности сетевой карты, поэтому время наверстывания почти полностью определяется исходными 41,1 GB. Как только скорость копирования сравняется со скоростью роста состояния, отставание перестанет сокращаться. Последняя точка передачи одновременно фиксирует версию состояния и право выполнения, чтобы целевой экземпляр не пропустил последние обновления исходного.
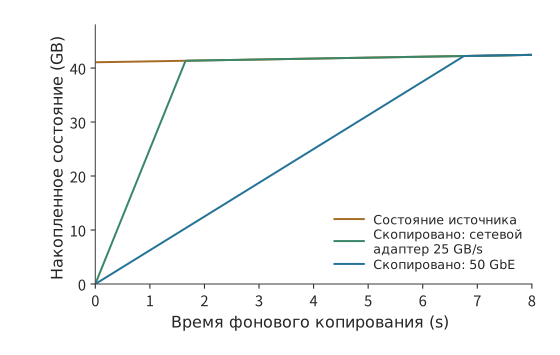
Рис. 9-43. Фоновое копирование должно догнать продолжающее расти состояние. Вначале необходимо скопировать 41,1 GB состояния, а исходный экземпляр добавляет примерно 0,172 GB в секунду. Целевой экземпляр догоняет его примерно за 1,65 секунды через сетевую карту со скоростью 25 GB/s и примерно за 6,76 секунды через 50 GbE со скоростью 6,25 GB/s. До пересечения кривых расстояние между ними по вертикали равно объёму ещё не скопированных данных; после пересечения целевому экземпляру остаётся лишь следовать за новым состоянием исходного.
На рис. 9-43 кривая исходного экземпляра также поднимается, поэтому скорость наверстывания равна разности наклонов двух кривых; в этом примере рост при decode очень медленный, поэтому кривая исходного экземпляра почти горизонтальна. Если скорость копирования в точности равна скорости роста состояния, линии параллельны и исходное отставание не сокращается. Окончательную передачу необходимо выполнять в момент, когда целевой экземпляр уже догнал исходный и состояния обеих сторон совпадают.
Другой вид изменения во время работы, помимо миграции, — переключение способа распараллеливания: реорганизация одной и той же группы ускорителей в TP или SP×TP. В данном случае TP разделяет внутрислойные матрицы, а SP распределяет часть вычислений и промежуточного состояния по позициям токенов. ArcticInference, плагин инференса для vLLM с открытым исходным кодом от Snowflake, и соответствующие примеры vLLM демонстрируют этот подход: переключение изменяет набор участвующих в каждом шаге ускорителей и распределение токенов, а также требуемые раскладки весов и KV и граф выполнения. Предварительное хранение весов и графов выполнения для обоих режимов сокращает ожидание при переключении, но дополнительные веса и графы уменьшают пространство, доступное для KV. При эластичном экспертном параллелизме (Elastic EP — изменении во время работы числа ускорителей в группе экспертного параллелизма) новые ускорители при расширении группы сначала должны получить веса экспертов и лишь затем смогут выполнять назначенные им задачи; для обработки запросов целиком также требуется соответствующее состояние внимания.30
Данные на обеих сторонах совпадут лишь после того, как целевой экземпляр догонит обновления состояния исходного. Кроме того, целевой экземпляр должен завершить подготовку коммуникационных групп и графа выполнения. Ниже объём данных остаётся неизменным, меняется только пропускная способность передачи. В примере миграции Qwen3-8B при переключении с TP4 на TP8 по сети необходимо передать около 16,4 GB, а для локального построения целевых тензоров — прочитать и записать ещё около 4,7 GB данных. Передача одной и той же сетевой нагрузки через один порт 50 GbE (6,25 GB/s) и сетевую карту 200 Gbit/s (25 GB/s) из этой главы занимает соответственно около 2,63 и 0,66 секунды — разница четырёхкратная.
Однако если дополнительно предположить, что последовательное создание коммуникационных групп, подготовка графа выполнения и возобновление приёма запросов после передачи занимают 9 секунд, общее время составит примерно 11,6 и 9,7 секунды, то есть сократится лишь приблизительно на 17%. Если все восемь ускорителей находятся в одном сервере 8×A100 и миграция выполняется через NVLink, то при пропускной способности каждого A100 300 GB/s в каждом направлении ускоритель с наибольшим объёмом отправки должен передать около 4,7 GB, что займёт лишь примерно 15,7 мс, но общее время всё равно составит около 9,0 секунды. Эти 9 секунд ограничивают пользу от дальнейшего увеличения пропускной способности: даже если время сетевой передачи стремится к нулю, общее время может приблизиться лишь к 9 секундам. Если заранее создать коммуникационные группы и подготовить графы выполнения, ожидание во время миграции можно дополнительно сократить.31
На этом этапе сам перенос уже близок к физическому нижнему пределу канала, а всё оставшееся время уходит на подготовку программного обеспечения. Согласно критерию из раздела 1.3.4, такой разрыв нельзя устранить более быстрым каналом — необходимо перестроить программное обеспечение: заранее создавать коммуникационные группы, предварительно захватывать графы выполнения, отделить процессы от планирования и выполнять подготовку параллельно с передачей.
9.6.3 Частичные сбои и восстановление потоковой генерации¶
При плановой миграции исходный экземпляр ещё может предоставить последнее обновление; после сбоя его данные могут оказаться недоступны для чтения, и тогда остаётся полагаться лишь на заранее сохранённое состояние и журнал вывода. Сначала при восстановлении необходимо определить, какую часть вывода пользователь уже получил. После сбоя возможны три цели: восстановить достаточно состояния для продолжения decode; заново выполнить prefill по уже определённым токенам; повторно сэмплировать часть вывода. В первых двух случаях генерация продолжается после уже полученной пользователем последовательности, а в третьем случайный выбор выполняется заново, поэтому суффикс может отличаться. Для rollout в RL это также меняет процесс генерации образца.
Предположим, что исходный ввод содержит 8192 токена, пользователю уже возвращено 1025 выходных токенов, но последний сохранённый KV охватывает лишь исходный ввод. Если эти выходные токены надёжно записаны, при восстановлении достаточно подать первые 1024 выходных токена в модель в рамках одного prefill, заново построить KV для 9216 токенов, а затем обработать 1025-й выходной токен и продолжить генерацию. Если уже имеется совместимый KV, охватывающий 9216 токенов, повторное воспроизведение этих 1024 токенов можно пропустить.
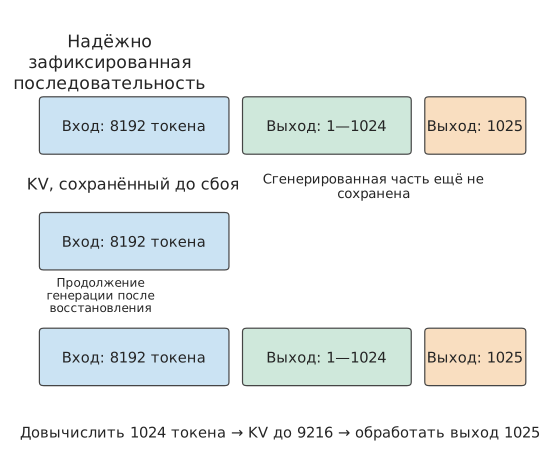
Рис. 9-44. Журнал вывода определяет, какую последовательность следует продолжить, а checkpoint KV — с какого места нужно повторить вычисления. Предполагается, что все 1025 выходных токенов надёжно записаны, но KV сохранён лишь для исходного ввода. В нижней части отдельно показаны исходный ввод, первые 1024 выходных токена и 1025-й выходной токен; ширина сегментов не пропорциональна числу токенов.
На рис. 9-44 концы двух записей показаны раздельно. Если вывод уже возвращён пользователю, это не означает, что соответствующий KV сохранён. Используя при восстановлении записанные токены для повторного вычисления, можно воссоздать тот же префикс без повторного сэмплирования этих выходных токенов.
Журнал упреждающей записи (write-ahead log, WAL) надёжно сохраняет операции или результаты, необходимые для восстановления, до их внешнего подтверждения. В данном случае WAL на уровне токенов хранит уже определённую выходную последовательность, а KV — результаты уже выполненных для этой последовательности вычислений. Первый определяет, какую последовательность вывода следует продолжить после восстановления, а второй — какой объём работы ещё предстоит повторить. Сервис генерации DeepSeek V4 использует подобный механизм; при восстановлении также необходимо обеспечить согласованность версии весов, индексов позиций токенов и состояния decode.22
Область воздействия сбоя определяется группой синхронизации. Потеря одного ускорителя в группе тензорного или экспертного параллелизма может остановить обработку запросов на всём совместно работающем экземпляре, тогда как другие неповреждённые реплики продолжат обслуживание. Восстановление после сбоя последовательно проходит через обнаружение, реконструкцию экземпляра и восстановление запросов; производительность после восстановления определяет, сколько времени потребуется для завершения накопившихся запросов. В главе 10 дополнительно анализируется влияние этих вариантов на образцы RL и ход обучения, а в главе 11 рассматривается восстановление задач, использующих инструменты и окружения.
9.7 Комплексное сравнение схем развёртывания¶
9.7.1 Сочетание реплик, PD, AF и общего KV-кэша¶
В этом разделе результаты предыдущих разделов применяются к описанному в начале главы сервису на восьми картах: сначала определяется способ передачи состояния, а затем проверяется, способен ли сервис в целом справиться с интенсивностью поступления запросов и уложиться в срок восстановления. Созданный P KV-кэш можно передать непосредственно D либо сначала поместить в общий пул, откуда его затем получит D. Если вновь созданное D состояние потребуется для следующего цикла P, необходимо также убедиться, что оно сохранено и опубликовано. При прямой передаче и чтении через пул может передаваться одно и то же содержимое, однако задействованные каналы и буферы различаются.
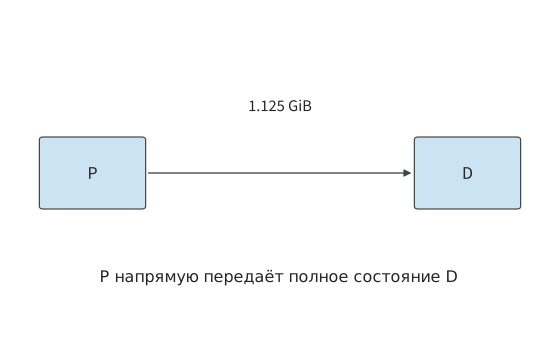
Рисунок 9-45. P напрямую передаёт D контекстный KV-кэш объёмом 1.125 GiB, выполняя лишь одну прямую передачу. P выполняет prefill, а D — последующий decode по одному токену.
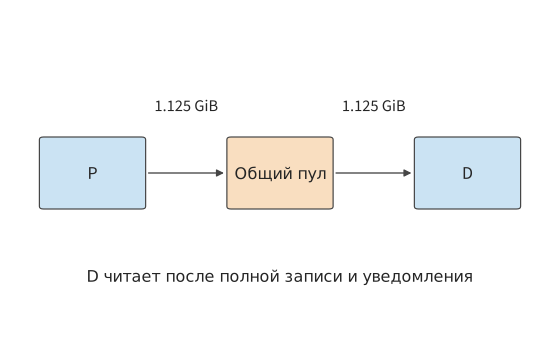
Рисунок 9-46. P сначала записывает в пул полный объект объёмом 1.125 GiB и публикует его, после чего D получает тот же объект; итого выполняются две передачи: запись и получение. Последующие экземпляры также могут повторно использовать объект из пула. P выполняет prefill, а D — последующий decode по одному токену.
В случае рассматриваемого в этой главе контекстного KV-кэша объёмом 1.125 GiB при прямой передаче P→D данные перемещаются один раз, а при передаче через пул — по одному разу на каждом из рёбер P→пул и пул→D, поэтому суммарная полезная нагрузка составляет 2.25 GiB. Если пропускная способность обоих рёбер равна 25 GB/s, а чтение можно начать только после полной записи объекта, ожидание при передаче через пул составит около 96.6 ms — примерно на 48.3 ms больше, чем при прямой передаче.
Если D использует это состояние только один раз, передача через пул не даёт преимуществ повторного использования. Если позднее обработку того же сеанса продолжит другой экземпляр, появляется возможность заменить примерно 856 ms повторного вычисления временем чтения около 48.3 ms — 856 ms составляет время prefill из раздела 9.2.3. Сэкономленное вычислительное время с избытком компенсирует дополнительное время передачи; в разделе 9.7.3 эта выгода рассчитывается для нагрузки из примера 9.8. Общий пул позволяет использовать результат вычислений, оставшийся от одного запроса сеанса, в последующих запросах; AF же изменяет место выполнения каждого слоя текущего запроса. Эти механизмы влияют на разные участки временной шкалы.
Те же правила применимы и к визуальному вводу. Создаваемый E кэш EC имеет идентификатор, отличный от идентификатора языкового KV-кэша, и занимает другой объём. Попадание в кэш изображений может сократить работу E, но не устраняет автоматически последующую стадию P языковой модели. В графе выполнения E→P→D попадание в EC снижает нагрузку на E, а попадание языкового префикса сокращает работу P; распределение ресурсов также корректируется вслед за изменением объёма работы на каждой стадии.
9.7.2 Сравнение схем при одинаковом качестве и одинаковых ограничениях по ресурсам¶
Пример 9.8. Какая схема развёртывания инференса способна непрерывно обслуживать запросы и вовремя устранить очередь, накопившуюся при запуске? Используем ресурсы и нагрузку из начала главы: четыре A100 80GB SXM и четыре H20 SXM5 96GB; каждую секунду поступает 3.5 независимого запроса, в каждом запросе 8192 входных токена и 1025 выходных токенов. Производительность стадий берётся из примера 9.2; если обе стадии выполняются на одной карте, они занимают её последовательно. Между двумя серверами имеется общий канал полезной нагрузки с пропускной способностью 25 GB/s, и все передачи используют одну и ту же полосу этого канала. В пределах сравниваемого окна модель и настройки генерации одинаковы, а нужные запросам префиксы не переиспользуются. Сервис запускается из остановленного состояния, и все три схемы развёртывания готовы через 10 секунд; после готовности очередь обрабатывается по модели непрерывного потока. Цель — непрерывно обрабатывать новые запросы и устранить накопившуюся при запуске очередь не позднее чем через 60 секунд после начала запуска.
Необходимо проверить и ограничение по ёмкости. После 1024 итераций decode KV-кэш каждого запроса охватывает 9216 токенов и занимает около 1.27 GiB. Одна H20 при batch size 32 хранит состояния активных запросов общим объёмом около 40.5 GiB; если добавить один приёмный буфер объёмом 1.125 GiB и примерно 15.3 GiB весов, получится около 56.9 GiB, что помещается в 96 GB видеопамяти, то есть примерно 89.4 GiB. При использовании компактного состояния MLA каждый экземпляр занимает около 618 MiB, а 32 экземпляра вместе с одним приёмным буфером объёмом 549 MiB — около 19.8 GiB. На стороне A100 достаточно одновременно хранить два состояния — вычисляемое и отправляемое, всего 2.25 GiB. Схема с общим пулом дополнительно располагает 64 GiB для состояний. Для ещё не запущенных запросов сохраняются только входные данные; вычисление начинается после выделения места в кэше.
В следующей таблице сравниваются полные реплики, PD с прямой передачей и PD с передачей через общий пул. При использовании общего пула чтение начинается только после полной записи объекта, поэтому данные каждого запроса дважды проходят через общий канал; как при записи в пул, так и при чтении из него может использоваться вся пропускная способность этого канала.
| Схема развёртывания | Организация P и D | Нагрузка на канал на запрос | Вычислительная производительность, запросов/s | Производительность канала, запросов/s | Общая пропускная способность после запуска, запросов/s |
|---|---|---|---|---|---|
| Восемь полных реплик | Каждая карта выполняет P и D | 0 | 3.02 | — | 3.02 |
| Прямой PD | Четыре A100 выполняют P, четыре H20 — D | 1.125 GiB | 4.55 | 20.7 | 4.55 |
| PD с передачей через общий пул | То же распределение P и D, P→пул→D | 2.25 GiB | 4.55 | 10.3 | 4.55 |
| Прямой PD, компактное состояние MLA | Четыре A100 выполняют P, четыре H20 — D | 549 MiB | 4.55 | 43.4 | 4.55 |
| PD с передачей через общий пул, компактное состояние MLA | То же распределение P и D, P→пул→D | 1.07 GiB | 4.55 | 21.7 | 4.55 |
Полные реплики могут завершать лишь 3.02 запроса в секунду, что постоянно ниже интенсивности поступления в 3.5 запроса в секунду, поэтому этот вариант исключается первым. Производительность канала в обеих схемах PD значительно выше 4.55 запроса/s, поэтому обе ограничены вычислительным пулом. При входной нагрузке 3.5 запроса в секунду прямая передача потребляет около 4.2 GB/s, а передача через пул — около 8.5 GB/s; на стадии устранения очереди при 4.55 запроса/s им требуется соответственно около 5.5 и 11.0 GB/s. Для компактного состояния MLA эти четыре значения составляют соответственно 2.0, 4.0, 2.6 и 5.2 GB/s. Производительность канала удваивается, но вывод не меняется.
У обеих схем одинаковая пропускная способность в установившемся режиме, однако для этой группы запросов лучше подходит прямой PD. Последующие запросы не переиспользуют префиксы этой группы, тогда как передача через пул удваивает объём данных в канале и добавляет каждому запросу около 48.3 ms ожидания. Общий пул объёмом 64 GiB вмещает не более 56 полных префиксов по 1.125 GiB, а при компактном состоянии MLA — 119 префиксов; при данной нагрузке ни один сохранённый экземпляр больше не будет использован. Прямая передача выполняет ту же работу, оставляет больший запас пропускной способности канала и сокращает ожидание передачи. Поэтому в этом примере выбираются четыре A100 для P, четыре H20 для D и прямая передача P→D.
Теперь проверим, сможет ли эта схема вовремя обработать запросы, накопившиеся за время запуска. Согласно расчёту устранения очереди из раздела 9.6.1, прямой PD устраняет очередь из 35 запросов, накопленную за 10 секунд запуска, примерно через 43 секунды после начала запуска и тем самым укладывается в целевые 60 секунд. У полных реплик после готовности очередь продолжает расти примерно на 0.5 запроса в секунду, поэтому к 60-й секунде она увеличивается с 35 примерно до 59 запросов. Даже при идеальной обработке блоками с производительностью 4.17 запроса/s совместное размещение устранит очередь лишь к 63-й секунде и также не уложится в срок.
Можно также рассчитать минимальную производительность сервиса, необходимую для соблюдения этого срока. Запуск занимает 10 секунд, а за оставшиеся 50 секунд требуется устранить очередь из 35 запросов, продолжая при этом обрабатывать по 3.5 нового запроса в секунду. Следовательно, необходимо:
Производительность прямого PD, равная 4.55 запроса/s, превышает этот минимум примерно на 8%. Если фактическая эффективность kernel составляет лишь 90% от значения, принятого в примере 9.2, производительность пула D снижается примерно до 4.10 запроса/s. В установившемся режиме он по-прежнему способен обрабатывать непрерывно поступающие запросы, но очередь будет сокращаться лишь примерно на 0.60 запроса в секунду и исчезнет только приблизительно к 68.5-й секунде, то есть позже установленного срока. Наклон двух нисходящих линий на рисунке 9-42 представляет именно чистую скорость устранения очереди, равную разности между производительностью сервиса и интенсивностью поступления запросов.
Убедившись, что очередь будет устранена вовремя, можно перейти к сравнению стоимости. При расчёте стоимости вычислительного сервиса необходимо учитывать и способ тарификации ресурсов. Пусть восемь карт зарезервированы с почасовой оплатой и их суммарная стоимость составляет восемь юаней в час. Если фактически завершается 3.5 запроса в секунду, за час будет завершено 12600 запросов, а стоимость составит около 0.63 юаня за тысячу запросов. Если интенсивность поступления остаётся равной 3.5 запроса в секунду, производительность 4.55 запроса/s не создаёт дополнительные запросы из ничего; избыточная производительность используется для обработки всплесков и очереди, накопившейся при запуске.
При сравнении количества запросов, обрабатываемых под полной нагрузкой, производительности 3.02 и 4.55 запроса/s соответствуют стоимости около 0.74 и 0.49 юаня за тысячу запросов. Если бизнес дополнительно устанавливает срок завершения, а у второй схемы ему соответствует лишь четверть запросов, число соответствующих требованиям запросов снижается примерно до 1.14 в секунду, а стоимость тысячи соответствующих требованиям запросов возрастает примерно до 1.95 юаня. В общем виде:
Числитель зависит от вычислительных ресурсов, оперативной памяти, сети и поддерживаемых в рабочем состоянии резервных экземпляров, а знаменатель — от фактического числа поступивших и успешно завершённых запросов. Например, агент может завершить работу досрочно, сгенерировав меньше токенов и использовав меньше ресурсов, но не выполнить задачу; такой выход не учитывается в числе успешно завершённых задач, соответствующих требованиям.32
9.7.3 Корректировка развёртывания после изменения нагрузки¶
Теперь изменим условие примера 9.8, согласно которому префикс больше не переиспользуется. Пусть другой экземпляр один раз переиспользует оставшийся после каждого запроса контекстный KV-кэш объёмом 1.125 GiB. Повторное вычисление этих 8192 токенов на A100 занимает 0.856 секунды, а получение состояния — всего 48.3 ms. Дополнительные 48.3 ms, ранее затраченные на передачу через пул, вместе с 48.3 ms последующего получения составляют около 96.6 ms, что значительно меньше 856 ms повторного вычисления. Поэтому даже одно последующее переиспользование даёт чистую экономию около 760 ms. У общего пула появляется конкретное назначение: заменять повторные вычисления более быстрым чтением.
Эта выгода одновременно повышает требования к каналу. При исходной передаче выполняются одна запись и одно чтение, а при последующем переиспользовании — ещё одно чтение, поэтому всего передаётся 3.375 GiB. При поступлении 3.5 таких пар запросов в секунду требуется около 12.7 GB/s; канал способен обслуживать не более примерно 6.9 пары запросов/s. Для компактного состояния MLA три передачи составляют в сумме 1.61 GiB, а 3.5 пары запросов в секунду требуют около 6.0 GB/s; канал способен обслуживать не более примерно 14.5 пары запросов/s. По сравнению с однократной передачей последующее переиспользование увеличивает объём чтения и потребляет имевшийся запас пропускной способности. Общий пул устраняет повторные вычисления, но одновременно снижает максимальную пропускную способность канала по парам запросов.
Общий пул изменяет число передач. Далее предположим, что у D нет кэша, и будем изменять только объём входных данных, который должен повторно вычислить P, чтобы проверить, требуется ли скорректировать распределение ресурсов. Допустим, P локально нашёл в кэше 6144 токена, а кэш D по-прежнему пуст. Согласно расчётам из раздела 9.2.4, суммарная производительность полных реплик составляет около 4.90 запроса/s, исходная конфигурация с четырьмя A100 для P и четырьмя H20 для D по-прежнему обеспечивает 4.55 запроса/s, а конфигурация с двумя A100 для P и оставшимися шестью картами для D — 5.69 запроса/s. При тех же 10 секундах запуска и интенсивности поступления 3.5 запроса/s эти три конфигурации устранят очередь соответственно примерно к 35.1-й, 43.2-й и 26.0-й секунде после начала запуска. После попадания префикса в кэш полные реплики устраняют очередь даже раньше исходной конфигурации PD, поэтому прежнее распределение больше не подходит. Для этой нагрузки оптимально использовать две A100 для P, а остальные шесть карт — для D.
Теперь вернёмся к входным данным без попаданий в кэш и увеличим выход до 4097 токенов, то есть рассмотрим запрос с более длительным процессом инференса. Оптимальным становится распределение с двумя A100 для P и оставшимися шестью картами для D, но даже оно обеспечивает лишь около 1.26 запроса/s. При любом изменении соотношения числа P и D исходных восьми карт недостаточно для обработки 3.5 запроса в секунду. Три копии такого восьмикарточного развёртывания обеспечивают суммарно около 3.78 запроса/s, чего едва хватает для непрерывной обработки поступающих запросов. Если требуется также соблюдать прежние сроки запуска и устранения очереди, необходимая производительность составляет не менее 4.2 запроса/s, а четыре копии обеспечивают около 5.04 запроса/s, поэтому потребуется четыре группы. При масштабировании исходной комбинации вычислительных ресурсов целыми группами для непрерывной обработки поступающих запросов нужны 24 карты, а для соблюдения срока восстановления — 32 карты. Дополнительные вычислительные ресурсы используются для ускоренного сокращения очереди.
Отсюда следует и порядок применения приведённых в этой главе расчётов к новой системе. Сначала объём работы на запрос преобразуется в требования к каждому виду ресурсов. Затем при целочисленном распределении ресурсов определяется наиболее загруженный пул ресурсов или исполнительный модуль. После этого в порядке выполнения учитываются время передачи состояния и объём занимаемой памяти. Наконец, остаточная производительность, равная разности между производительностью сервиса и интенсивностью поступления запросов, используется для вычисления продолжительности всплеска нагрузки или очереди, накопившейся при запуске. Если узким местом является D, добавление P не сократит очередь. Если узким местом является общий канал, добавление вычислительных реплик лишь приведёт к тому, что больше запросов будут ожидать получения данных.
Здесь пример PD на восьми картах пересекается с примером экспертов MoE. В первом случае разные стадии назначаются вычислительным ресурсам, лучше подходящим для этих стадий. Во втором повторное использование внутри batch сокращает чтение весов, а реплики экспертов распределяют работу наиболее загруженных исполнительных модулей. Общий KV-кэш сохраняет уже вычисленные результаты для повторного использования следующим запросом, а запуск и восстановление определяют, когда эти вычислительные ресурсы смогут начать обслуживание. Выбор схемы развёртывания основывается на том, насколько все эти подходы в совокупности изменяют объём вычислений и время ожидания, а также сколько времени потребуется для устранения очереди.
Ускорение отдельной стадии также изменяет соотношение экземпляров. Пусть пропускной способности канала достаточно, каждый экземпляр P обрабатывает 20 запросов в секунду, а каждый экземпляр D завершает 5 таких же запросов в секунду. При одном P на четыре D производительность обоих пулов одинакова. Если ускорить стадию D в четыре раза и сохранить прежнее соотношение, производительность пула D возрастёт до 80 запросов/s, тогда как производительность пула P останется равной 20. При переходе к одному P на один D оба пула обеспечат 20 запросов/s, а три экземпляра D освободятся. Таким образом, выигрыш от ускорения одной стадии выражается в сокращении ресурсов, необходимых для выполнения той же работы.
Упражнения¶
Упражнения последовательно охватывают повторение расчётов, изменение условий и самостоятельное проектирование. Первые две задачи устанавливают общую единицу измерения запросов, в задачах с третьей по девятую поочерёдно меняются условия вычислений, коммуникации и состояния, десятая посвящена проектированию новой рабочей нагрузки, а в одиннадцатой состояние, передаваемое между этапами, заменяется на MLA и оценка выполняется заново. Задачи с пометкой «ключевая» охватывают несколько уровней ресурсов.
9-1. Число вызовов и передача состояния для трёх вариантов развёртывания инференса. Для запроса с 8192 входными и 1025 выходными токенами изобразите полную реплику, PD и общий KV-кэш, отдельно указав число вызовов на запрос, место создания KV и передачу состояния между экземплярами. Затем измените длину вывода на 1 токен и укажите, какие операции больше не требуется выполнять. Наконец, рассмотрите продолжение генерации после однократного вызова инструмента и отметьте позицию последнего уже возвращённого токена, для которого соответствующий KV ещё не создан.
9-2. Как узкое место канала и состав запросов изменяют соотношение PD. Повторите расчёт 25 целочисленных вариантов распределения из примера 9.2 и задайте эффективную пропускную способность канала равной величине, необходимой для передачи ровно одного снимка размером 1.125 GiB в секунду, то есть примерно 1.21 GB/s. Найдите новый верхний предел общей пропускной способности; когда интенсивность поступления запросов в точности равна этому пределу, однократно добавьте ещё десять запросов и определите изменение очереди во времени. Затем повторно проверьте сценарии с попаданием в префиксный кэш и со 129 выходными токенами. Наконец, измените предположение об эффективности этапов с 50% до 40% от пиковой производительности, заново выведите возможности двух типов ускорителей по prefill и decode и определите, по-прежнему ли конфигурация из четырёх A100 для P и четырёх H20 для D обеспечивает пропускную способность выше интенсивности поступления 3.5 запроса/s.
9-3. Как batch size эксперта, набор инструкций и разрядность весов изменяют узкое место выполнения на CPU. Используя форму эксперта из примера 9.3, отдельно для kernel на AVX-512 и AMX определите число токенов, поступающих каждому эксперту в точке перехода выполнения на CPU от ограничения чтением к ограничению вычислениями; затем замените пропускную способность памяти на межсокетную, равную 125 GB/s, и пересчитайте обе критические величины. Сравните время выполнения при поступлении каждому эксперту 1 и 128 токенов. Измените размер весов на один байт на элемент, сохранив эффективную вычислительную производительность CPU, заново найдите точку пересечения времени чтения и вычисления и объясните направление её смещения.
9-4. Объём передачи, число запусков и перекрытие коммуникации для PD и AF (ключевая). Используйте Qwen3-8B, задайте эффективную пропускную способность передачи состояния равной 25 GB/s и при накладных расходах запуска 1, 5 и 20 μs сравните одну передачу объёмом 1.125 GiB с 72 передачами того же суммарного объёма. Затем используйте фактический размер полезной нагрузки AF из примера 9.4 и вычислите суммарное время передачи состояния для полного запроса с 8192 входными и 1025 выходными токенами.
Дополнительно рассмотрите четыре независимых micro-batch, для каждого из которых вычисления на стороне attention и feed-forward занимают соответственно 2 ms и 3 ms. Сравните полное время полностью последовательного выполнения с идеальным двухэтапным конвейером, после чего определите, насколько суммарно могут увеличить время критического пути дополнительные коммуникации и снижение эффективности вычислений, чтобы конвейерная схема всё ещё оставалась быстрее последовательной.
9-5. Ограничения ёмкости весов и вычислительной производительности CPU при гетерогенном инференсе. По сохранённой конфигурации DeepSeek V4-Flash или Kimi K2 восстановите размещение весов, размер буфера GPU и требования к оперативной памяти. После увеличения конкурентности запросов отдельно спрогнозируйте число задействованных экспертов, количество задач каждого эксперта и наиболее загруженный NUMA-узел. Затем сконструируйте условия поступления запросов, при которых суммарные веса помещаются в доступную память, но интенсивность поступления превышает вычислительную производительность CPU, и выведите скорость роста очереди.
9-6. Ограничения ёмкости реплик экспертов и окупаемость копирования. Пусть восемь экспертов получают соответственно \([32,16,8,4,2,1,1,0]\) строк входных данных. Сравните объём вычислений в трёх случаях: обрабатываются только фактические строки; входы непустых экспертов дополняются до 32 строк; входы всех экспертов дополняются до 32 строк. Затем при условиях примера 9.6 найдите минимальное число батчей, после которого накопленная экономия времени впервые превысит время копирования; измените дополнительную доступную ёмкость каждого ускорителя на 32 MiB и объясните, почему сначала следует исключить нереализуемые варианты репликации. Если горячие точки меняются со временем, объясните, как на основе нагрузки в окне наблюдения спрогнозировать накопленную выгоду после репликации и сравнить её с затратами на миграцию.
9-7. Условия выгодности сохранения, извлечения и повторного вычисления KV (ключевая). Дан префиксный KV размером 1.125 GiB, который последующие запросы должны суммарно использовать 100 раз. Сравните полное время для трёх вариантов: однократное повторное вычисление с последующим резидентным хранением, однократное извлечение с последующим резидентным хранением и удалённое чтение при каждом использовании. Дополнительно учтите время записи и срок хранения кэша между двумя запросами и выведите условие, при котором сохранять KV выгоднее, чем вычислять его повторно; разработайте пример, в котором после изменения доступной ёмкости HBM состояние требуется вытеснить из HBM. Используя имеющиеся записи двух движков, объясните, какие возможности повторного использования сохранились при увеличении общего CPU-пула с 4 GiB до 8 GiB.
Затем выполните расчёт для конфигурации одной GPU в DGX A100 из раздела 9.5.2: если интервал между двумя использованиями одного префикса составляет 5 минут, какой минимальный объём кэша требуется каждой GPU и какие уровни хранения придётся задействовать? Если новый вход содержит соответственно 128 и 512 токенов, каково суммарное время послойной предварительной загрузки из памяти хоста и сколько слоёв необходимо загрузить до начала вычислений, чтобы чтение полностью перекрывалось вычислениями? Наконец, исходя из ресурса D7-P5520 в 1 DWPD, определите долю новых KV, которую SSD способен принимать длительное время; какой станет эта доля при 50-процентном попадании в префиксный кэш, когда скорость создания новых KV уменьшается вдвое?
9-8. Выбор способа восстановления при отсутствии страниц KV и несовместимости версий. Объясните различие между двумя способами учёта, когда прочитан KV для 1024 токенов, но повторно использован KV только для 1008 токенов. Для отсутствующей страницы, усечённой страницы и несовместимой версии предложите условия выбора между дальнейшим ожиданием, частичным повторным вычислением и отказом от кэша. Отдельно опишите, как проверить возможность завершения запроса, восстановление данных кэша и совпадение вывода с вариантом без использования кэша.
9-9. Точки пересечения по пропускной способности при маршрутизации кэша и хвостовая задержка первого токена. Выведите значения пропускной способности, при которых удалённое извлечение по пути B занимает столько же времени, сколько локальное попадание по пути A и локальное повторное вычисление по пути B в примере 9.7. Для \(p=0.5,0.9,0.99\) вычислите среднее время до первого токена при выборе пути A, а также p99, определённый через обратную функцию распределения. Затем предположите, что при недоступности реплики в HBM реплика на CPU остаётся доступной, а извлечение может перекрываться с ожиданием в очереди длительностью 80 ms. Проверьте, остаётся ли применимой исходная модель двухточечного распределения.
9-10. Масштабирование PD и очереди при смешанной нагрузке с короткими и длинными выводами (ключевая). Используйте условия примера 9.8: из 3.5 запроса в секунду половина выводит 1025 токенов, а другая половина — 4097 токенов; все запросы имеют 8192 входных токена и не попадают в префиксный кэш; производительность внутри пула распределяется по долгосрочной средней рабочей нагрузке. Сначала по методу примера 9.2 найдите число D GPU-секунд для двух типов ускорителей при обеих длинах вывода и получите среднюю потребность в D на запрос, после чего переберите все варианты распределения восьми ускорителей между этапами P и D. Разрешая копировать одинаковую конфигурацию из восьми ускорителей, отдельно найдите минимальное число групп для двух целей: непрерывной обработки новых поступающих запросов; очистки очереди до 60-й секунды после начала запуска при длительности запуска 10 секунд. Наконец, сконцентрируйте поступление запросов с длинным выводом в первых десяти секундах каждой минуты, изобразите изменение очереди и объясните, какой временной интервал определяет выбор ёмкости при неизменной средней потребности.
9-11. Выбор между PD и AF для MLA и GQA. Замените передаваемое в этой главе состояние компактным представлением MLA из DeepSeek-V3: 61 слой, \(d_c=512\), \(d_r=64\), BF16. Оставьте без изменений производительность этапов из примера 9.2, полезную нагрузку AF из примера 9.4 и накладные расходы запуска 5 μs. Сначала найдите размер состояния в байтах для 8192 токенов и время одной передачи PD при 25 и 50 GB/s; затем найдите канальную составляющую \(\mu_{PD}\) и укажите верхнее значение пропускной способности, при котором канал остаётся ограничивающим фактором. По формуле \(\alpha^*=(V_{KV}-V_{AF})/(71B)\) найдите критическое время запуска для обоих каналов и укажите, во сколько раз суммарные передачи AF за 1024 и 4096 шагов превышают одну передачу PD при выводе соответственно 1025 и 4097 токенов. Наконец, учтите в пуле D преобразование запросов стоимостью 2.05 GFLOPs на шаг, по эффективной производительности H20 в 74 TFLOP/s найдите изменение производительности пула D и определите, по-прежнему ли достаточно четырёх H20.
Пример решения: при каком batch size выполнение эксперта на CPU переходит от ограничения чтением к ограничению вычислениями? Когда составляющие чтения и вычисления для пути одного эксперта на CPU равны,
Здесь каждый параметр BF16 занимает два байта, а на каждую строку и параметр приходится по две операции с плавающей точкой, поэтому оба коэффициента в точности сокращаются. Для kernel на AVX-512 значения 1.8 TFLOP/s и 220 GB/s дают \(m\approx8.2\): когда каждый эксперт получает менее девяти токенов, основное время уходит на ожидание весов, а при большем числе токенов — на вычисления. Для kernel на AMX с производительностью 21.3 TFLOP/s точка равенства смещается примерно к 97 токенам. Когда поток читает память другого сокета, пропускная способность снижается до 125 GB/s, а обе точки равенства смещаются примерно к 14 и 170 токенам соответственно; время чтения весов при выполнении одной строки увеличивается примерно на 76%, однако при 128 строках kernel на AVX-512 всё ещё ограничен вычислениями.
Точки равенства здесь и границы 71/72 и 688/689 строк на рис. 9-14 отвечают на разные вопросы. Первые отделяют режим ограничения CPU пропускной способностью от режима ограничения вычислениями; вторые сравнивают полные пути CPU и GPU с учётом переноса весов. Пройдя точку равенства, CPU уже ограничен вычислениями, но всё ещё может превосходить путь GPU, которому сначала требуется перенести веса, пока накопленная стоимость вычислений не превысит стоимость этого переноса.
Итоги главы¶
Распределённый инференс распределяет вычисления и состояние одного запроса между несколькими узлами. Для PD, AF, размещения экспертов и совместного использования KV необходимо сопоставлять преимущества локального выполнения с дополнительными передачами данных; пригодность развёртывания совместно определяется ёмкостью, скоростью обслуживания, запуском и восстановлением. Маршрутизация не только выбирает свободные вычислительные ресурсы, но и определяет, какие состояния можно использовать повторно. Одни и те же расчёты дают разные результаты для различных представлений контекста: после замены передаваемого состояния GQA на компактное MLA время передачи PD сокращается вдвое, связанная с каналом составляющая \(\mu_{PD}\) удваивается, послойная передача AF не изменяется, а критическое время запуска соответственно сокращается.
После изменения аппаратной конфигурации сначала зафиксируйте запрос и схему развёртывания, определите новое узкое место, а затем заново распределите ресурсы между этапами. В следующей главе мы перейдём к обучению и рассмотрим непрерывное обновление параметров и состояния обучения, а также продвижение процесса обучения.
-
Принадлежность весов, состояния и коммуникации одного MoE-запроса. TP2×EP4, обработка одной и той же группы запросов и формат передачи FP32 являются явно заданными учебными условиями для конкретной демонстрации принадлежности коммуникации. ↩
-
Архивные материалы по DistServe, Splitwise и размещению этапов приведены в материалах расширения этой главы и исследовании разделения этапов и передачи состояния. ↩
-
Расчёт передачи PD/AF для Qwen3-8B с фиксированными официальной формой модели, числом байтов и предположениями о запуске. Для построения графика используется одноимённый JSON. Для 25 GB/s применяются десятичные единицы, а для 1.125 GiB — двоичные; точный объём полезной нагрузки составляет 1207959552 bytes, чистое время передачи — 48.31838208 ms, а с добавлением 5 μs — 48.32338208 ms. Суммарная передача AF за 1024 шага decode одного запроса приведена в соответствующем результате. ↩
-
Целочисленное распределение гетерогенных P и D, однородный вариант с восемью A100, однородный вариант с восемью H20, попадание в префиксный кэш, 129 выходных токенов, 4097 выходных токенов. Поле
derived_stage_ratesкаждого результата отдельно для каждой GPU перечисляет объём вычислений и чтения на этапах prefill и decode, обе временные составляющие Roofline и ограничивающий ресурс. ↩ -
Производительность этапов выводится расчётом pd-pool из таблицы оборудования и пооперационного учёта прямого прохода Qwen3-8B. Пиковое значение для A100 80GB SXM взято из спецификации NVIDIA A100. NVIDIA не публиковала спецификацию H20; модель и объём памяти взяты из документации AI Enterprise vGPU, а вычислительная производительность BF16 и пропускная способность памяти — из таблицы 3 на странице 8 MegaScale-Infer, где строки A800 и H800 согласуются со спецификациями NVIDIA. Калибровка в 50% взята из раздела 8.6.3 и записей эффективности по итерациям эксперимента 8-1. ↩
-
Расчёт передачи PD/AF для компактного состояния MLA, а также сравнение MLA и GQA на канале 50 GB/s; число байтов на токен согласуется со строкой deepseek-v3 в расчёте кэша для разных моделей. Значения \(d_c=512\) и \(d_r=64\) взяты со страницы 12 статьи DeepSeek-V2; V3 использует ту же конфигурацию attention. Точный объём полезной нагрузки составляет 575,668,224 bytes, чистое время передачи при 25 GB/s — 23.02672896 ms, а критическое время запуска — 23003136/71 ns. ↩
-
Целочисленное распределение P и D с компактным состоянием MLA, вариант с каналом 50 GB/s и сравнение с состоянием GQA при 50 GB/s. Дополнительные 2,046,820,352 FLOPs на шаг компактного пути указаны в поле
mla_compact_pathрезультата передачи MLA и на каждом слое совпадают со строкой kv_b_proj в таблице операторов одного шага decode V3. ↩ -
Выгрузка весов и место выполнения, а также описание версии реализации. ↩
-
Kernel на AVX-512, 1 токен на эксперта, 128 токенов, kernel на AMX, 1 токен, 128 токенов; поле
locality_reuse_regionsкаждого результата содержит две точки пересечения: 71/72 и 688/689. Пропускная способность kernel CPU приведена на страницах 4 и 6 статьи KTransformers, а пропускная способность памяти и конфигурация PCIe — на странице 10; пиковое значение A100 40GB PCIe приведено в таблице оборудования. ↩ -
Публичные записи экспериментов KTransformers. Учебная платформа использует два 6454S и 4090, а платформа из статьи — два 8452Y; опубликованные результаты Expert Deferral включают как повышение, так и снижение качества. ↩
-
Записи конфигураций DeepSeek V4-Flash и Kimi K2. Верхние пределы конкурентности в таблице взяты из конфигурации развёртывания. ↩
-
Межмашинное выполнение и эволюция фреймворков, а также основания для расширенного описания AF. ↩
-
Исследовательские заметки о MoE Serving Tax, CRAFT и запуске. ↩
-
Расчёты окупаемости копирования внутри одного HGX через NVLink и копирования между серверами через ConnectX-7. В примерах зафиксированы маршрутизация и дополнительное доступное пространство на каждой GPU, а время подготовки рассчитано для последовательного копирования. Значения 989.4 TFLOP/s и 3350 GB/s для H100 SXM приведены в таблице оборудования и используются с эффективностью 50%; пропускная способность NVLink в каждом направлении 450 GB/s приведена в спецификации NVIDIA H100, а пропускная способность сетевого адаптера в каждом направлении 50 GB/s — в спецификации ConnectX-7. Время подготовки составляет соответственно 0.62220256 ms и 5.31982304 ms, экономия на один батч — 402784256/1675 ns, то есть примерно 0.2404682 ms; минимальные количества батчей — 3 и 23 — вычислены по значениям без округления. ↩
-
Спецификация DGX A100: 8×A100 80GB, 2 TB памяти хоста, 8×3.84 TB U.2 NVMe и восемь однопортовых сетевых адаптеров 200 Gbit/s; краткое описание Solidigm D7-P5520: последовательное чтение/запись блоками 128K со скоростью до 7,100/4,200 MB/s и ресурс 1 DWPD в течение 5 лет. Ёмкость, длительность хранения, время извлечения и записи, число послойно предварительно загружаемых слоёв и допустимый объём записи SSD для этого раздела приведены в расчёте многоуровневого хранения KV; для повторения расчёта выполните
python3 calculations/calc.py kv-tiers. Память хоста объёмом 2 TiB поровну распределена между восемью GPU, а скорость чтения и записи SSD принята равной максимальному значению из спецификации. ↩ -
Wang и др., KVCache Cache in the Wild, USENIX ATC 2025, раздел 3.4: Trace A представляет диалоговую нагрузку индивидуальных пользователей, Trace B — нагрузку API; вывод о необходимой ёмкости относится к модели GQA и получен по максимальной интенсивности запросов каждого экземпляра. ↩
-
Раздел 4 и таблица 1 технического отчёта Mooncake: часовой trace с 23,608 запросами и средним входом в 7590 токенов; степень концентрации trace Alibaba Cloud приведена в статье из предыдущего примечания. ↩
-
Gao и др., Cost-Efficient Large Language Model Serving for Multi-turn Conversations with CachedAttention, USENIX ATC 2024: в разделах 3.2–3.3 описаны послойная предварительная загрузка, асинхронное сохранение, а также предварительная выборка и вытеснение по очереди; в разделах 4.3.2–4.3.3 приведены измерения буфера предварительной загрузки и доли попаданий. ↩↩
-
Материалы о персистентности состояния и сервисе генерации из технического отчёта DeepSeek V4, а также заметки по чтению для этой главы. ↩↩
-
Расчёт чтения страниц при перезапуске и фактического повторного использования: прочитано 144 MiB, эффективно повторно использовано 141.75 MiB. Прочитаны 64 страницы для 1024 токенов, из которых повторно использованы 63 страницы для 1008 токенов. ↩
-
Сравнение стратегий предварительной выборки усечённых страниц; окно наблюдения в эксперименте составляет 60 секунд. ↩
-
Расчёты маршрутизации кэша при извлечении через 50 GbE и через 200 GbE, включая полный последовательный путь удалённое хранилище → память хоста → GPU; время вычислений при повторном вычислении и после попадания получено делением FLOPs матриц на 50% от производительности A100 80GB SXM, равной 312 TFLOP/s. Суммарная пропускная способность PCIe 4.0 для приёма и передачи у A100 составляет 64 GB/s, см. спецификацию A100 80GB. ↩
-
События кэша и решения о маршрутизации, двухточечное распределение при инвалидации кэша. ↩
-
Парный расчёт реальной нагрузки на маршрутизатор, различающий время завершения целевого запроса и полной пары задач; исходные условия сохранены вместе с результатом. ↩
-
Обзор исследования Breaking the Ice; в исследовании используется vLLM v0.10.1.1. ↩
-
Наблюдение ветвей запросов HiCache, где цепочка событий с одним ID запроса объясняет лимит и эффективное попадание. В исходной записи лимит предварительной выборки составлял 3289 токенов, а зарегистрированный занятый объём — 4096 токенов; клиент отправил восемь запросов одновременно, но на GPU одновременно выполнялся не более чем один запрос. ↩
-
Динамический параллелизм и условия состояния, распределение экспертов и масштабирование. ↩
-
Расчёты последовательной миграции через 50 GbE, через сетевой адаптер 200 Gbit/s и через A100 NVLink, задающие нижнюю границу времени миграции по объёму полезной нагрузки, пропускной способности канала и девяти последовательным операциям подготовки длительностью по 1 секунде. Суммарная пропускная способность NVLink для приёма и передачи у A100 SXM составляет 600 GB/s, см. спецификацию A100 80GB. Число байтов KV для фонового копирования и интенсивность вызовов decode взяты из
derived_stage_ratesдля H20 в целочисленном распределении гетерогенных P и D. ↩ -
Ёмкость, общий канал, время запуска, цель очистки очереди и стоимость в примере 9.8, а также доля выполнения целевого уровня обслуживания (SLO), являются учебными предположениями для вывода последствий изменения условий. Удельная стоимость вычисляется делением полной часовой стоимости на 3600×эффективную интенсивность запросов. В примере миграции последовательное время подготовки принято равным 9 секундам. ↩
-
Официальный технический отчёт DeepSeek V4.1, разделы 1, 2, 3 и 6; фиксированные условия и повторный расчёт сквозного межглавного сценария. ↩
-
Инженерный отчёт о системе инференса DeepSeek-V3/R1: большой EP, три типа балансировки нагрузки и точность коммуникации; снимок материалов по DeepEP V2. Границы источников и версий. ↩↩↩
-
Фиксированные входные данные для большого EP и перекоса при разделении экспертов, скрипт расчёта, результат повторного расчёта. Пропускная способность сетевых адаптеров и NVLink приведена в спецификации HGX H100, спецификации NVIDIA H100 и спецификации ConnectX-7; производительность H100 принята равной 50% от пиковой величины из таблицы оборудования. Результат вычислений является нижней границей для приведённой модели выполнения; конвейер для двух micro-batch и коэффициент достижения равенства из раздела 9.4.3 также получены из этого результата. ↩↩
-
Фиксированные входные данные для масштаба EP и нагрузки наиболее занятой GPU, скрипт расчёта, результат повторного расчёта. Для сценария с горячими точками используются точные доли, а для случайного сценария зафиксирован seed; учитываются только фактические строки, без padding, чтения весов и коммуникации. EP144 при развёртывании decode DeepSeek, 32 резервных эксперта и 2 маршрутизируемых эксперта на GPU описаны в инженерном отчёте о системе инференса DeepSeek-V3/R1. ↩
-
Zhu и др., MegaScale-Infer, arXiv:2504.02263v1: Load balance в §6, условия экспериментов и пропускная способность в §7.1–7.2; CRAFT, MLSys 2026, аннотация и §3–5; Demystifying the Mixture of Experts Serving Tax, MLSys 2026, §3–5. Выдержки из оригиналов, охват прочитанных материалов и условия применимости чисел приведены в записях этого исследования. ↩↩↩